Tag Archives: General

2023-11-11 откъде започват в наши дни junior администраторите?

Post Syndicated from Vasil Kolev original https://vasil.ludost.net/blog/?p=3469

От време на време задавам тоя въпрос (и си мислех, че вече съм го блогвал, ама не откривам къде) – в наши дни, откъде започват junior системните администратори? Говорим за съвсем начинаещи, първа работа, горе-долу знаят как се държи клавиатура, и имат желание…

Едно време се започваше от support в близкото ISP. Там имаше всякакви мрежови и клиентски проблеми, човек научаваше, че user-ите лъжат (особено като ги питаш “нещо променяно ли е”), и малко по малко се попиваше от по-старшите и админите, така че да може да се научи къде да рови, какво да очаква и как да оправя разни по-дълбоки проблеми. Понеже работата никога не беше малко, почваха да се дават на човека по-сложни и по-сложни задачи, и така.
(“наградата за добре свършената работа е още работа” не е нещо лошо 🙂 )

Също имаше достатъчно места (малки фирмички на някой роднина/познат на роднини), дето имаше нужда някой да им поддържа компютрите и където имаше достатъчно потребители, на чиито гръб да се научиш.

В наши дни май не е така, или поне аз не знам. Има от време на време някакви junior обяви, но като съм имал някакви такива интервюта и разговори, не мога да кажа на хората къде е добре за тях да отидат, ако нямат предишен опит.
(support-а в isp-тата в наши дни са хора, дето четат сценарий стъпка по стъпка и ако не беше толкова модерно заменянето на хора с AI, щяха да са ги заменили със shell script)

Една идея, която давам на хората, е да правят неща сами вкъщи. Може би аз съм в някаква изкривена среда, но повечето ми колеги имат нещо вкъщи, с което си играят, едно-две-три съвърчета, малка мрежа, собственоръчно правен rack… Това дава доста възможности да се научат някакви неща, основно на собствен гръб (или на хората, живеещи с човека).
От друга страна, не всички имат възможност, и не всички могат съвсем самостоятелно да започнат. До някакъв момент си мислех, че всички хора са/трябва да са такива, но с годините се поразубедих (и няма как да очаквам, че всички биха били като мен).

Липсва ми и това, че при мен няма такъв вариант. Естеството на работата за момента изглежда такова, че няма как да учим някой от нулата – няма капацитет и подходяща работа. От нещата, които искам да променя е, само дето още не съм измислил как…

Та, откъде в наши дни могат да почнат junior администраторите, дайте идея.

2023-09-21

Post Syndicated from Vasil Kolev original https://vasil.ludost.net/blog/?p=3467

Има дни, които започват с намирането, ремонтирането и report-ването на бъг в мобилното приложение на rocketchat, минават през срещи и гасене на 3 пожара паралелно, и завършват с


MariaDB [opennebula]> update vm_pool set short_body=replace(short_body,'80','33') where oid=39;
Query OK, 1 row affected (0.002 sec)
Rows matched: 1 Changed: 1 Warnings: 0

Един ден трябва да направя лекция за opennebula и за кандидатурата им за най-невъзможна за докарване в консистентно състояние база данни на тоя свят. Онова по-горе (редактиране на XML в базата със string операции, което теорията твърди, че е идиотщина, и аз съм съгласен) се налага, понеже има същите данни в 2 различни полета на същата таблица, с малка редакция, и понякога не са синхронизирани.

Имам чувството, че съм почнал да гледам на целия свят като някакъв проблем за дебъгване.

2023-06-02 Взимане на решения в екип

Post Syndicated from original https://vasil.ludost.net/blog/?p=3466

От няколко места виждам вариации на темата, та ми се стори уместно да напиша нещо.

Ще започна с нещо от Камил Галеев, който на моменти има много добри обяснения. Важният момент в това е, че хората, които са на власт/в позиция да взимат решения/вършат нещо, не могат да имат крайни позиции. Вършенето на работа в екип с някого изисква компромиси, и е далеч по-лесно да работиш с хора, които са съгласни с теб и с които може да си сглобиш обща цел, отколкото с такива, които трябва да бъдат насилвани.

От това има няколко посоки на изводите:

Първо, хората/организациите с крайни позиции са такива, които никога не са стигали до свършване на нещо реално. Неспособността да направиш някакъв компромис и да се промениш/пренасочиш, за да се справиш с някаква промяна в обстановката води до това да си по-зле от тези, които намират вариант и да “отпаднеш” по някакъв начин.
(тук има огромна скоба и малко примери, понеже може да се разбира по грешния начин…

Опциите за компромис и промяна на посоката винаги са повече от една. Първи пример, някой на база на горното може да каже “Това значи ли, че Украйна трябва да направи компромис с Русия?” и отговорът там е, че те са направили много компромиси със западния свят/ЕС, за да могат да продължат да се бият. Дали тези ще са им достатъчни, е отделен въпрос.

Друг пример, на скоро обяснявах нуждата от “черна каса” и бях гледан с огромно учудване, че това се налага в наши дни. Моето твърдение е, че на практика няма организация, в която да няма нещо подобно, просто защото има неща, които не могат да се случат без подобен фонд за плащания, които нямат насрещен документ. Имам някакво количество примери от моята практика, за които по очевидни причини няма да разкажа, и само ще отбележа, че всяка достатъчно голяма организация от едно ниво нагоре има нещо подобно, известно като “discretionary фондове”, с които определени хора разполагат по собствено усмотрение за благото на организацията. С тях се злоупотребява, но ползите от тях надминават загубите.
Чувал съм твърдение, че има организации без такива, но тогава тези неща се случват, като определени хора поемат тези разходи от собствения си джоб. В повечето НПО-та е така и за това в счетоводството на доста от тях може да се намери “и за <нещоси> на тоя член му платихме толкова пари”, като нещото е от типа на “да стои и да изглежда добре”
край на скобата)

Второ, съвсем нормално и здравословно в една организация е да има някакво количество спорове и да се достига до решение с дискусия. Мисля си, че сме супер повредени от много години на “един спасител, който знае всичко”, но очакването да има един-единствен диктатор/ръководител/авторитет и той да е прав за всичко е идиотщина и като цяло сбъркано. Смислените лидери (думата не ми харесва, но не ми хрумва по-добра) не взимат решенията ей-така, без да се консултират, и дори в повечето случаи работата им не е да вземат решението, а например да решат кога има някакъв приблизителен консенсус или достатъчно голямо мнозинство за някакво решение, и да прекратят дискусията.
Много полезна е идеята за rough consensus, дошла от IETF. Може да се каже дори, че организации работещи на еквивалента за тях на “rough consensus and running code” (щото не всички живеят на код) са по-здрави и работещи от тези, които не го правят.

За това и аз лично много се зарадвах на записа от заседанието на ПП, на което обсъждат правителството с ГЕРБ – понеже е пример за всичките неща по-горе и за смислен процес по взимане на решение (въпреки че чисто практически изтичането на записа има неприятни последици). Може би след някакво количество години подобни записи ще се използват за обучителни материали 🙂

(изобщо, може да не съм от ПП, но от време на време Кирил Петков свършва нещо, с което ми се издига в очите, което като цяло е огромна рядкост за български политик)

2023-02-28 video-streaming (“видео-наблюдение”) на изборите

Post Syndicated from original https://vasil.ludost.net/blog/?p=3465

Тия дни от Дневник ме разпитваха някакви неща за видео streaming-а (“видеонаблюдението”) на изборите и решиш да доразкажа някакви подробности, ако на някой му е интересно.

Моят опит с тези неща идва от няколко места – генералното ми занимаване със сервиране на файлове и видеа, streaming-а на конференции (OpenFest и най-вече FOSDEM), и накрая – инфраструктурата и схемата, която сглобявах за tibroish.bg за излъчване на предишните избори.
(предишните видео-наблюдения бяха саботирани там, където вероятно ще бъдат и тези, на ниво секция, и на практика имаше твърде малко stream-ващи, може би около 1%. Съответно, цялостната схема не е минала пълен тест в production, но не успявам да намеря причина да не работи.)

(код на всичкото на tibroish)

Според мен, подобна система може да се реализира с почти подръчни средства. В нея няма нито един много специализиран, сложен или невиждан досега компонент. От друга страна, точно това не е правено особено много и има много интеграционна и тестова работа, която не намалява с идването на изборите, та най-големият проблем всъщност са сроковете.

Ще тръгна по потока на данните и ще обясня моето виждане (и как в общи линии работеше системата за streaming в tibroish, която за тези избори е спряна).

Самото заснемане се прави с телефон.
– Хардуерът на модерните телефони е доста добър, и като качество на картината, и като звук;
– в тях има хардуерен encoder за видео, който може да го сдъвче доста добре на хубаво качество;
– два варианта за свързаност (мобилна мрежа и wifi, като в този случай само мобилната мрежа вероятно ще се ползва);
– място за събиране на записи – на повечето телефони 6-часовия, 2.7GiB запис на 1mbps ще се събере във вътрешната памет и няма да има нужда от SD карта;
– самия телефон си има поддържаща операционна система и готови библиотеки;
– вграден UPS;
– ако трябва да се осигурят 12000 устройства за нещо и да се изпрограмират, телефоните нямат равни, понеже като цяло имат подобно производство.

Конкретно в tibroish нямахме особен избор, и задачата беше допълнително затруднена от това, че трябваше да поддържаме random телефони, което ако някоя фирма прави цялостното решение, няма да е проблем.

Приложението на tibroish има в себе си и video streaming, и е open-source, съответно може да се използва тази му част като основа.

Първата задача на приложението е да се оторизира пред зададен централен сървър и да разбере къде да си изпраща видео потока. Подобни системи и схеми има в най-различни видове и са нещо, което почти всеки е правил. Това е услуга с малко натоварване, свястна база данни и сравнително защитена от атаки (по темата сигурност ще пиша отделно).

След като получи информацията, приложението започва да записва и ако може, да stream-ва. Ако може, понеже в някакво количество секции internet няма и няма достатъчно мобилно покритие, за да излъчи 1Mbps видео.

Стойността 1Mbps идва от някакъв опит и проби/грешки, за повечето нужди в 1Mbps на 1280×720 (720p) може да се смести картина с четим текст и като цяло всичко да е добре различимо, при подходящ H.264 профил. Не съм успявал да докарам поносимо видео на по-малка разделителна способност, а 2Mbps ще е доста сложно за мобилната мрежа. Като опция, вероятно може да се записва на различен bitrate, но това ще увеличи доста натоварването на телефона.

Stream-ването го бяхме реализирали по RTMP. В момента опциите за подобно нещо са:
– WebRTC базирано – генерира UDP/RTP трафик и като цяло губи пакети, понеже е ориентирано за комуникация с ниска латентност. Голямото му предимство е сериозната поддръжка в телефоните и като цяло, понеже се използва много, но е доста по-сложно и като цяло неподходящо.
– Нещо файлово-базирано – например да генерира на телефона HLS фрагменти и да ги качва директно един по един – това би било страхотно решение и изисква най-малко от инфраструктурата, но не съм виждал такова.
– RTMP(S) – стандартен протокол в/у TCP, от ерата на Flash-а. Все още стандартът за stream-ване (всичките платформи като twitch, youtube и facebook май само него поддържат) и има добра open-source поддръжка. Аз все още ползвам nginx-rtmp за повечето streaming и стига да не се подава странно видео, работи добре.

Тук задачата в крайна сметка е да има видео и да изглежда добре, латентност от 5-10-30 секунди е поносима.

Този поток от данни с всички останали се праща до приемащ сървър. Сметките всеки може да си ги направи, при 1Mbps на поток и като цяло 12Gbps, ако се раздели на 50 виртуалки (както аз го бях направил), натоварването става поносимо и се издържа от и събира на почти всякаква машина в някаква cloud услуга. Единият път за tibroish използвах Hetzner, но има и други, които могат да свършат работа. За конкретния случай дори комбинация от няколко български доставчика ще свърши работа, и вероятно дори самите мобилни оператори могат да предоставят подобна мижава инфраструктура.
(по моя опит, нужната инфраструктура за това не стига размерите дори на среден cloud provider, може би е като един малък такъв. 12 Gbps и 30 TiB данни за записите би трябвало да не са нещо особено за когото и да било)

От гледна точка на сигурност, адресът на приемащия сървър се дава на приложението от централния, малко преди да е започнал streaming-а. Това се прави да се ограничи периодът, в който ще може да се подготви и засили DDoS атака, понеже такава ще има, както всяка година има спрямо сайта на ЦИК. Доколкото знам, ИО са отработили система за защита, и поне според мен може да се направи уговорка с мобилните оператори точно този трафик да не излиза никъде от мрежите им и да върви по трасета, които няма как да се DDoS-нат отвън.

След като трафикът стигне на приемните машини, от там те могат да генерират HLS потоци (за които няма нужда от reencode-ване, т.е. просто се препакетира трафика, което не яде почти никакъв процесор, от моите експерименти – бях пускал няколко-стотин потока към един сървър, докато сгъне) и може да се гледа. Като цяло гледането ще е по-малката част от трафика, и HLS се проксира доста лесно, та в tibroish просто ползвахме CloudFlare за proxy/филтър пред гледането. Мисля, че това е опция и за всеки друг, който го прави.

И на последно място, някъде трябва да има една красива страница, от която да се вижда къде има работещ stream и да може да се избере/гледа stream. Това се сглабя сравнително лесно (и пак го има в tibroish), като цяло начини да показваш видео – бол…

Няколко проблема, които не съм споменал горе:

– Цялото нещо има нужда минимум от DDoS защита. Може да се очаква да бъде блъскано усилено, ако се намери къде е, за това аз бих разчитал на елемента на изненадата (да не се вижда къде е докато не започне събитието), random имена на сървърите (и всичко в dns зоната, което не е тези сървъри, сочи към някакви blackhole-нати адреси, да затруднява допълнително), подходяща DDoS защита с подходящ капацитет и почистване на трафика, и различни, големи доставчици за проксиране, които да могат да издържат.

– Не сме правили запис, и не мога да кажа какви мотики може да се ударят там. Според мен и сметка на салфетка вътрешния storage на телефоните ще се справи, за удобство може да се пише И на SD карта, там е основно въпрос на логистика. Проблемът на SD картата е, че доста по-лесно изчезва…

– ЦИК има изискването да могат да се четат номерата на бюлетините. Това изисква най-вече добро осветление и поставяне на камерата, което не е от най-простите неща за обясняване (камерата има почти второстепенна роля). Според мен 1Mbps ще се справи със задачата.

– Не е ясно дали може да се записва звук или не. В tibroish го бяхме спрели директно, понеже юристите не можаха да се произнесат, според мен би бил страхотна идея да се записва и stream-ва, колкото и да е зле.

Та, технически може да стане. Практически – времето е малко и ще е сложно, и както обикновено, ще бъде саботирано в секциите. Ако няма конкретни глоби и наказания за липса на видео-наблюдение, може да се очаква поне 20% от него да не работи и да няма запис. Честно казано, ако видя да се случи от 50% от секциите, ще го броя за чудо.

Приемам всякакви идеи и корекции, че това ми е brain dump от една ранна сутрин 🙂

2023-01-21 процес на наемане на хора

Post Syndicated from original https://vasil.ludost.net/blog/?p=3464

Отдавна се каня да опиша нашия процес на наемане на хора, и защо е такъв – случва се от време на време хора да ме питат “а как си намирате хора”.

(това е бая важно като задача в една фирма, и почти навсякъде, където съм бил съм гледал да имам участие в процеса, за да не се наложи после да работя с хора, които не стават)

Прескачайки “откъде влизат cv-та” (jobs.bg и подобни сайтове), стъпките нататък са:

1) Базов преглед на CV-то. Ако в него няма нещо наистина притеснително, или не е тотално не подходящо, даваме нататък.
Някои хора гледат внимателно CV-та и на база на тях канят кандидатите на интервю. Всичкия ми опит с това е, че се губи много време, и на интервюиращите, и на кандидатите, понеже CV-то не показва много неща, хората лъжат и т.н.. В някои изключителни случаи (при много senior CV), може да направим първо интервю с човека предварително, но иначе, следваща стъпка:

2) Пращаме едни стандартни задачи на човека. Те са събрани от моята и фирмената практика, и като цяло не са от типа на “сферичен кон във вакуум”, и имат няколко цели:
– да видят на кандидата колко му се занимава
– да се види как мисли и за какви неща се усеща
– да дадат теми за разговор на интервюто 🙂
В предишни фирми това се заместваше от това да напишат един fizzbuzz на лист на интервюто, но понеже няма fizzbuzz еквивалент за админи, и понеже да каниш хората само за да ги изгониш като не решат задачата си е бая загуба на време. Задачите са повечко и е добре хората да могат да си ги решат на спокойствие, а и няма изискване да се решат всички, а е по избор на канидата.
Както и с fizzbuzz-а, случвало се е да се наемат някакви хора, които да не могат да ги минат тия неща, и това винаги е било голям провал.
Има и хора, дето казват “тия какво ще ме занимават, ще ида при някой друг” (това съм го чувал и от първа ръка) и в общи линии това е търсен ефект, понеже почти във всички случаи аз не искам хора, дето това хем им е голямо усилие, хем не им е достатъчно интересно, че да се хванат и да решат едно-две неща.
В много редки случаи сме филтрирали хора на тази стъпка, заради наистина ужасяващи решения.

3) Правим едно техническо интервю. От наша страна гледаме да сме до 3ма човека (повече от това почва да изглежда притеснително).
Първите 5-10 минути обясняваме ние с какво се занимаваме и какво представлява работата (една от първите реплики е “май ти го разказва това предния път, та сега съм аз”). Това е полезно за да си изгради кандидата контекст и да знае защо задаваме някакви въпроси.
(това май е рядко срещано, и аз не го правех преди)
После, имаме набор от теми, по които разпитваме човека. Започваме от задачите, минаваме през някакви мрежови, linux-ки неща, инструменти, но най-интересното е да разкаже нещо, което е правил сам. Особено хората с повече опит почти задължително имат нещо такова, и от там може да се види всъщност доколко способен е човека.
В тази част има нещо, което често се пропуска, че интервюто трябва да е полезно и за двете страни – ако кандидатът не знае нещо, му го обясняваме/разказваме.
Също така, целта на голяма част от въпросите е да изясни доколко работата ще е интересна за кандидата и доколко като цяло му харесва. Хора, които не са мотивирани, не са заинтересувани и това го работят между другото, като цяло не стават за при нас.
(това е доста видимо при почти всички кандидати, които се появяват от СофтУни)
Последните 10-15 минути гледаме да оставим за въпроси от кандидата към нас, всякакви неща свързани с работата.

Към края на интервюто обясняваме, че ще се свържем с кандидата до около седмица, без значение какво ни е решението – т.е. никого не оставяме без отговор и да се чуди какво става. Това важи и за предишната стъпка – който ни е пратил решение на задачите, е получавал отговор от нас.

4) Срещаме кандидата с целия екип. Това е разговор в сравнително свободен формат, двете страни да се запознаят и да решат дали им се работи заедно. Това винаги е доста забавно, и помага на кандидата да види в какво се забърква.

5) Прави се “човешко” интервю с кандидата, което е с CEO-то на фирмата, да се види дали не сме пропуснали, че човекът е психопат или нещо подобно (както се вижда, аз това тотално не го разбирам и вероятно не го описвам правилно 🙂 ).

6) Правим оферта на човека, и ако приеме, почва при нас.

7) Месец след като е започнал, правим post-onboarding интервю. Тази идея дойде от Dan Luu, та хващаме и разпитваме човека какво не ни е наред, преди да е свикнал с нещата при нас.
(Дори файлът, в който водим бележките, се казва “Какво не е наред”)
(разбира се, onboarding-а продължава много повече, те само базовите неща са поне един месец, но е важно да се направи тоя разговор преди човекът да е привикнал с процесите)

Това са нещата по самия процес, в общи линии. Извън него има като цяло изграждането на имидж на фирмата (с появяване по конференции и т.н.), които не са ми по специалността. Само мога да кажа, че са важни (поне двама от екипа ми са дошли през конференции).

2023-01-01 равносметъчно

Post Syndicated from original https://vasil.ludost.net/blog/?p=3463

> Отказвам да имам очаквания за идващата година. Някои хора казват, че поне supply chain проблема може да почне да се пооправя към края ѝ, а дано.

(аз, в началото на годината)

Явно решението да нямам очаквания е било съвсем правилно.

От по-интересните неща, които се случиха:

– Малките зверове растат – весели, здрави и все толкова опасни 🙂

– Направихме пак online FOSDEM, и ще е последния такъв. Имам билети, подготвили сме се, идващия ще е на живо, в гадния студен и мокър Брюксел, в кривия университет. И съм сигурен, че много ще му се радваме.

– Направихме един хубав OpenFest на живо, на който дори успях да изнеса една лекция (още ми е трудно да повярвам колко хора гласуваха за нея, въпреки малоумното заглавие). Следващия OpenFest ще се случва без мен, както писах, от всички органиизрани досега не съм бил в организацията само на 4-5…

– Успяхме да си попълним екипа тая година, изглежда, че ходенето по разни конференции помага. Даже имах време да посъбера нов списък от “мотики”, та със сигурност в момента има материал поне за една лекция. Ако имам възможност, ще драсна една-две тук.

– Започнахме да си организираме (в екипа) сбирка на всички в офиса да работим заедно, за по една седмица на около два месеца. Аз, както не съм особено социален все пак го намирам за много полезно и приятно, и определено ще се запази.

– ИББ изглежда се възстановява.

Имам голямото желание (и) тази година да пиша малко повече, например отдавна се каня да напиша нещо за наемането на хора, да видим докъде ще стигна.

2022-12-29 ИББ

Post Syndicated from original https://vasil.ludost.net/blog/?p=3462

Public service announcement: разни хора са възродили ИББ – пак така, всяка сряда, само че в бирария “Дондуковъ” (на бул. Дондуков 14, пак на ъгъла с “Будапеща”, ама диаметрално противоположно спрямо старото “Криво”). Масите са запазени на името на “ИББ”.

Мястото не е лошо, яденето става, бирата става, няма от спирта, дето аз харесвам.

2022-12-24 нов лаптоп

Post Syndicated from original https://vasil.ludost.net/blog/?p=3460

Аз май не съм писал от известно време, та преди стандартния равносметъчен post да пробвам нещо по-малко скучно.

Преди има-няма 4 години си взех едно ново дъно от китайски оптимисти за T60. Машинката, в която го пъхнах ми случи вярно доста години, но вече взе да и идва много, да не мога да и намирам батерия и самата и пластмаса да сдава багажа. Като добавим и проблемите, които винаги съм имал с видео картата, си стана време за ново желязо.

Един друг оптимист беше тръгнал да прави ново дъно и да може да сглобява цели машини, ама lockdown-а му се отрази бая зле и в крайна сметка май нищо няма да излезе.

Та, реших да намеря нещо, което да е максимално поносимо, и стигах до thinkpad t14 gen3. Има средно поносима клавиатура, не е 16:9, а 16:10 (което е малко по-поносимо), и твърди, че батерията му държи над няколко часа. Взех го в петък, и сравнително лесно го инсталирах.

След няколко часа точене (да живее гигабитовата мрежа и nvme/ssd-тата, че правеха по 120MB/s) си пренесох данните, и с още половин ден ръчкане си пренесох работната среда (в момента пиша от него и не може да се познае, че е нещо друго). compiz-а си работи като слънце, след един BIOS update и външните монитори почнаха да се виждат, и определено е по-тих от старото желязо.

Най-голямото забавление беше един бъг на xfce. В началото, като го закачах тестово на docking станцията, то я разпозна като 52″ монитор, и нещо в xfce-то запомни, че дисплея е невероятно широк, съответно всичките кутийки на workspace switcher-а бяха станали ужасно широки, дотолкова, че на екрана се събираха само 3-4. Рових, рових, не намерих някой друг със същия проблем (или това, дето намерих се твърдеше, че е оправено), та накрая свалих source на xfce4-panel, намерих къде смята съотношението на височина към ширина и го hardcode-нах на 1 (тъкмо ще пасва на квадратния монитор). Та 20 минути работа по кода (с компилирането) реши проблем, на който бях отделил поне два часа ровене и четене. После как чукчата да не е писател…

Остана да видим как ще се разбере с носенето м/у вкъщи и офиса и смяната на монитори, но това вероятно няма да е голяма болка (famous last words)…

2022-10-28 post-OpenFest 2022

Post Syndicated from original https://vasil.ludost.net/blog/?p=3459

Мислех да пиша recap на OpenFest 2022, но ми е твърде уморено. Направихме един работещ фест след няколко години online и малки събития, получи се с нормалното количество проблеми, съвсем накратко 🙂

Вместо това, за да съм сигурен, че няма да си променя решението, го пиша тук – мисля догодина, ако имам изобщо роля в организацията, да е минимална. Освен, че имам нужда от почивка и че комбинацията от работа, деца и организация на подобно събитие не изглежда поносима за мен, би трябвало да е и крайно време по-нови и млади хора да се заемат 🙂

Така като си погледна архивите, като изключим 2003, 2012 и 2020, съм участвал във всички останали, като в последните 10 години – като един от основните координатори. Ако продължа да се занимавам, вероятно ще тръгна да правя побъркани неща като 10gbps wireless и т.н., а си мисля, че моите идеи за какво е хубаво да се прави/случва може вече да не са съвсем правилни 🙂

Нямам особено притеснение за самия фест – има сериозен екип, който може да се справя с организирането, имаме изградена система за почти всичко, така че съм съвсем спокоен, че всичко може да се случи и без мен.

Все пак, крайно време е да ида един път на OpenFest като обикновен посетител, не ми се е случвало от 2003 🙂

Deploying containers to AWS using ECS and CodePipeline 

Post Syndicated from Jessica Veljanovska original https://www.anchor.com.au/blog/2022/10/deploying-containers-to-aws/

Deploying containers to AWS using ECS and CodePipeline 

In this post, it will look at deploying containers to AWS using ECS and CodePipeline. Note that this is only an overview of the process and is not a complete tutorial on how to set this up. 

Containers 101 

However, before we look at how we can deploy Containers onto AWS, it is first worth looking at why we want to use containers, so what are containers?

Containers provide environments for applications to run in isolation. Unlike virtualisation, containers do not require a full guest operating system for each container instance, instead, they share the kernel and other lower-level components of the host operating system as provided by the underlying containerization platform (the most popular of which is Docker, which we will be using in examples from here onwards). This makes containers more efficient at using the underlying hardware resources to run applications. Since Containers are isolated, they can include all their dependencies separate from other running Containers. Suppose that you have two applications that each require specific, conflicting, versions of Python to run, they will not run correctly if this requirement is not met. With containers, you can run both applications with their own environments and dependencies on the same Host Operating system without conflict. 

Containers are also portable, as a developer you can create, run, and test an image on your local workstation and then deploy the same image into your production environment. Of course, deploying into production is never that simple, but that example highlights the flexibility that containers can afford to developers in creating their applications. 

This is achieved by using images, which are read-only templates that provide the containerization platform the instructions required to run the image as a Container. Each image is built from a DockerFile that provides the specification on how to build the image and can also include other images. This can be as simple or as complicated as it needs to be to successfully run the application.

FROM ubuntu:22.04 

COPY . /app 

RUN make /app 

CMD python /app/app.py

However, it is important to know that each image is made up of different layers, which are created based on each line of instruction in the DockerFile that is used to build the image. Each layer is cached by Docker which provides performance benefits to well optimised DockerFiles and the resulting images they create. When the image is run by Docker it creates a Container that flips the layers from the image and adds a runtime Read-Write layer on top, which can be used for logging and any other activity that the application needs to perform and cannot be read from the image. You can use the same image to run as many Containers (running instances of the image) as you desire. Finally, when a Container is removed, the image is retained and only the Read-Write layer is lost. 


Elastic Container Service 

Elastic Container Service or ECS is AWS’ native Container management system. As an orchestration system it makes it easy to deploy and manage containerized applications at scale with built in scheduling that can allow you to spin up/down Containers at specific times or even configure auto-scaling. ECS has three primary modes of operation, known as launch types. Elastic Container Service or ECS is AWS’ native Container management system. As an orchestration system it makes it easy to deploy and manage containerized applications at scale with built in scheduling that can allow you to spin up/down Containers at specific times or even configure auto-scaling. ECS has three primary modes of operation, known as launch types. The first launch type is the AWS EC2 launch type, where you run the ECS agent on EC2 instances that you maintain and manage. The available resource capacity is dependent on the number and type of EC2 instances that you are using. As you are already billed for the AWS resources consumed (EC2, EBS, etc.), there are no additional charges for using ECS with this launch type. If you are using AWS Outposts, you can use also utilise that capacity instead of Cloud-based EC2 instances. 

The second launch type is the AWS Fargate launch type. This is similar to the EC2 launch type, however, the major difference is that AWS are managing the underlying infrastructure. Because of this there are no inherent capacity constraints, and the billing models is based on the amount of vCPU and memory your Containers consume. 

The last launch type is the External launch type, which is known as ECS Anywhere. This allows you to use the features of ECS with your own on-premises hardware/infrastructure. This is billed at an hourly rate per managed instance. 

ECS operates using a hierarchy that connects together the different aspects of the service and allows flexibility in exactly how the application is run. This hierarchy consists of ECS Clusters, ECS Services, ECS Tasks, and finally the running Containers. We will briefly look at each of these services. ECS Clusters 

ECS Clusters are a logical grouping of ECS Services and their associated ECS Task. A Cluster is where scheduled tasks can be defined, either using fixed intervals or cron expression. If you are using the AWS EC2 Launch Type, it is also where you can configure Auto-Scaling for the EC2 instances in the form of Capacity Providers. 

ECS Services 

ECS Services are responsible for running ECS Tasks. They will ensure that the desired number of Tasks are running and will start new Tasks if an existing Task stops or fails for any reason in order to maintain the desired number of running Tasks. Auto-Scaling can be configured here to automatically update the desired number of Tasks based on CPU and Memory. You can also associate the Service with an Elastic Load Balancer Target Group and if you do this you can also use the number of requests as a metric for Auto-Scaling. 

ECS Tasks 

ECS Tasks are running instances of an ECS Task Definition. The Task Definition describes one or more Containers that make up the Task. This is where the main configuration for the Containers is defined, including the Image/s that are used, the Ports exposed, Environment variables, and if any storage volumes (for example EFS) are required. The Task as a whole can also have Resource sizing configured, which is a hard requirement for Fargate due to its billing model. Task definitions are versioned, so each time you make a change it will create a new revision, allowing you to easily roll back to an older configuration if required.


Elastic Container Registry 

Elastic Container Registry or ECR, is not formally part of ECS but instead supports it. ECR can be used to publicly or privately store Container images and like all AWS services has granular permissions provided using IAM. The main features of ECR, besides its ability to integrate with ECS, is the built-in vulnerability scanning for images, and the lack of throttling limitations that public container registries might impose. It is not a free service though, so you will need to pay for any usage that falls outside of the included Free-Tier inclusions.

ECR is not strictly required for using ECS, you can continue to use whatever image registry you want. However, if you are using a CodePipeline to deploy your Containers we recommend using ECR purely to avoid throttling issues preventing the CodePipeline from successfully running. 


CodePipeline 

In software development, a Pipeline is a collection of multiple tools and services working together in order to achieve a common goal, most commonly building and deploying application code. AWS CodePipeline is AWS’ native form of a Pipeline that supports both AWS services as well as external services in order to help automate deployments/releases.

CodePipeline is one part of the complete set of developer tools that AWS provides, which commonly have names starting with “Code”. This is important as by itself CodePipeline can only orchestrate other tooling. For a Pipeline that will deploy a Container to ECS, we will need AWS CodeCommit, AWS CodeBuild, and AWS CodeDeploy. In addition to running the components that are configured, CodePipeline can also provide and retrieve artifacts stored in S3 for each step. For example, it will store the application code from CodeCommit into S3 and provide this to CodeBuild, Code Build will then take this and will create its own artifact files that are provided to CodeDeploy. 

AWS CodeCommit 

AWS CodeCommit is a fully managed source control service that hosts private Git repositories. While this is not strictly required for the CodePipeline, we recommend using it to ensure that AWS has a cached copy of the code at all times. External git repositories can use actions or their own pipelines to push code to CodeCommit when it has been committed. CodeCommit is used in the Source stage of the CodePipeline to both provide the code that is used and to trigger the Pipeline to run when a commit is made. Alternatively, you can use CodeStar Connections to directly use GitHub or BitBucket as the Source stage instead.

AWS CodeBuild 

AWS CodeBuild is a fully managed integration service that can be used to run commands as defined in the BuildSpec that it draws its configuration from, either in CodeBuild itself, or from the Source repository. This flexibility allows it to compile source code, run tests, make API calls, or in our case build Docker Images using the DockerFile that is part of a code repository. CodeBuild is used in the Build stage of the CodePipeline to build the Docker Image, push it to ECR, and update any Environment Variables used later in the deployment.

The following is an example of what a typical BuildSpec might look like for our purposes. 

version: 0.2
  
  
  phases:
  
    pre_build:
  
      commands:
  
        - echo Logging in to Amazon ECR...
  
        - aws --version
  
        - aws ecr get-login-password --region $AWS_DEFAULT_REGION | docker login --username AWS --password-stdin $ACCOUNTID.dkr.ecr.$AWS_DEFAULT_REGION.amazonaws.com
  
    build:
  
      commands:
  
        - echo Build started on `date`
  
        - echo Building the Docker image...
  
        - docker build -t "$REPOSITORY_URI:$IMAGE_TAG-$CODEBUILD_START_TIME" .
  
        - docker tag "$REPOSITORY_URI:$IMAGE_TAG-$CODEBUILD_START_TIME" "$REPOSITORY_URI:$IMAGE_TAG-$CODEBUILD_START_TIME"
  
    post_build:
  
      commands:
  
        - echo Build completed on `date`
  
        - echo Pushing the Docker images...
  
        - docker push "$REPOSITORY_URI:$IMAGE_TAG-$CODEBUILD_START_TIME"
  
        - echo Writing image definitions file...
  
        - printf '{"ImageURI":"%s"}'" $REPOSITORY_URI:$IMAGE_TAG-$CODEBUILD_START_TIME"  > imageDetail.json
  
        - echo $REPOSITORY_URI:$IMAGE_TAG-$CODEBUILD_START_TIME
  
        - sed -i 's|<APP_NAME>|'$IMAGE_REPO_NAME'|g' appspec.yaml taskdef.json
  
        - sed -i 's|<SERVICE_PORT>|'$SERVICE_PORT'|g' appspec.yaml taskdef.json
  
        - sed -i 's|<AWS_ACCOUNT_ID>|'$AWS_ACCOUNT_ID'|g' taskdef.json
  
        - sed -i 's|<MEMORY_RESV>|'$MEMORY_RESV'|g' taskdef.json
  
        - sed -i 's|<IMAGE_NAME>|'$REPOSITORY_URI'\:'$IMAGE_TAG-$CODEBUILD_START_TIME'|g' taskdef.json
  
        - sed -i 's|<IAM_EXEC_ROLE>|'$IAM_EXEC_ROLE'|g' taskdef.json
  
        - sed -i 's|<REGION>|'$REGION'|g' taskdef.json
  
  artifacts:
  
    files:
  
      - appspec.yaml
  
      - taskdef.json
  
      - imageDetail.json

Failures in this step are most likely caused by an incorrect, non-functioning DockerFile or hitting throttling from external Docker repositories. 

AWS CodeDeploy 

AWS CodeDeploy is a fully managed deployment service that integrates with several AWS services including ECS. It can also be used to deploy software to on-premises servers. The configuration of the deployment is defined using an appspec file. CodeDeploy offers several different deployment types and configurations. We tend to use the `Blue/Green` deployment type and the `CodeDeployDefault.ECSAllAtOnce` deployment configuration by default. 

The Blue/Green deployment model allows for the deployment to rollback to the previously deployed Tasks if the deployment is not successful. This makes use of Load Balancer Target Groups to determine if the created Tasks in the ECS Service are healthy. If the health checks fail, then the deployment will fail and trigger a rollback.  

In our ECS CodePipeline, CodeDeploy will run based on the following example appspec.yaml file. Note that the place holder variables in <> are updated with real configuration by the CodeBuild stage.

version: 0.0 

Resources: 

  - TargetService: 

      Type: AWS::ECS::Service 

      Properties: 

        TaskDefinition: <TASK_DEFINITION> 

        LoadBalancerInfo: 

          ContainerName: "<APP_NAME>" 

          ContainerPort: <SERVICE_PORT> 

You may have noticed a lack of configuration regarding the actual Container we will be running up to this point. As we noted earlier, ECS Tasks can use a taskdef file to configure the Task and Containers, which is exactly what we are doing here. One of the files the CodeBuild configuration above expects to be present is taskdef.json. Below is an example taskdef.json file, ss with the appspec.yaml file there are placeholder variables as indicated by <>.


{ 

  "executionRoleArn": "<IAM_EXEC_ROLE>", 

  "containerDefinitions": [ 

    { 

      "name": "<APP_NAME>", 

      "image": "<IMAGE_NAME>", 

      "essential": true, 

      "memoryReservation": <MEMORY_RESV>, 

      "portMappings": [ 

        { 

          "hostPort": 0, 

          "protocol": "tcp", 

          "containerPort": <SERVICE_PORT> 

        } 

      ], 

      "environment": [ 

        { 

          "name": "PORT", 

          "value": "<SERVICE_PORT>" 

        }, 

        { 

          "name": "APP_NAME", 

          "value": "<APP_NAME>" 

        }, 

        { 

          "name": "IMAGE_BUILD_DATE", 

          "value": "<IMAGE_BUILD_DATE>" 

        }, 

      ], 

      "mountPoints": [] 

    } 

  ], 

  "volumes": [], 

  "requiresCompatibilities": [ 

    "EC2" 

  ], 

  "networkMode": "bridge", 

  "family": "<APP_NAME>" 

Failures in this stage of the CodePipeline generally mean that there is something wrong with the Container that is preventing it from starting successfully and passing its health check. Causes of this are varied and rely heavily on having good logging in place. Failures can range from the DockerFile being configured to execute a command that does not exist, to the application itself erroring out when starting for whatever reason might be logged, such as pulling incomplete data from RDS or failing to connect to an external service. 

Summary 

In summary, we have seen what Containers are, why they are useful, and what options AWS provides with its Elastic Container Service (ECS) for running them. Additionally, we looked at what parts of AWS CodePipeline we would need to use in order to deploy our Containers to ECS using CodePipeline.

For further information on the services used, I would highly recommend looking at the documentation that AWS provides. 

For a more hands-on guided walkthrough on setting up ECS and CodePipeline, AWS provide the following resources, there is also plenty of third party material you can find online. 

The post Deploying containers to AWS using ECS and CodePipeline  appeared first on Anchor | Cloud Engineering Services.

Using CodePipeline to Host a Static Website

Post Syndicated from Jessica Veljanovska original https://www.anchor.com.au/blog/2022/10/using-codepipeline-to-host-a-static-website/

There are a variety of ways in which to host a website online. This blog (post) explores how to simply publish and automate a statically built website. Hugo is one such example of a system which can create static websites and is popularly used for blogs.

The final website itself, will consist and contain; HTML, CSS, Images and JavaScript. During this process, (Anchor’s cloud experts) have listed the AWS Services in order to achieve our goal. These include:

  • Cloudfront
  • CodeBuild
  • CodePipeline
  • IAM
  • Amazon S3
  • CodeCommit

This Solution should be well below $5 per month as most of the items are within the Always Free Tier, except the AWS S3 Storage (Which only has valid free-tier for the first 12 month) depending on the traffic.   

In order to keep this simple, the below steps are done via the console, although I have also published a similar simplified project using Terraform which can be found on Github. 

Setup the AWS Components
Setup S3 

To begin with, you will need to setup some storage for the website’s content, as well as the pipeline’s artifacts. 

Create the bucket for your Pipeline Files. Ensure that Block all public access is checked. It’s recommended you also enable Server-side encryption by default with SSE-S3. 

Create a bucket for your Website Files. Ensure that block all public access is NOT checked. This bucket will be open to the world as it will need to be configured to host a website. 


When the Website Files bucket is created. Go to Properties tab and Edit Static website hosting. Set it to Enable, and select the type as Host a static website. Save Changes. Note the URL under Bucket website endpoint.Go to Permissions tab and Edit the Bucket policy. Paste in a policy such as the sample below. Update ${website-bucket-name} accordingly to match the name of the bucket. 

<{ "Version": "2012-10-17", "Statement": [ { "Sid": "", "Effect": "Allow", "Principal": { "AWS": "*" }, "Action": "s3:GetObject", "Resource": "arn:aws:s3:::${website-bucket-name}/*" } ] } >


Setup IAM Users

You will need to first create an IAM Role which your CodePipeline and CodeBuild will be able to assume. Some of the below permissions can be drilled down further, as they are fairly generic. In this case we are merging the CodePipeline/CodeBuild into one user.  Create a Role in IAM with a unique name based on your project. You will need to setup the below trust policy.  


<{ "Version": "2012-10-17", "Statement": [ { "Effect": "Allow", "Principal": { "Service": [ "codebuild.amazonaws.com", "codepipeline.amazonaws.com" ] }, "Action": "sts:AssumeRole" } ] } >

Create a Policy. Paste in a policy such as the below sample. Update ${website-bucket-name} and ${pipeline-bucket-name} accordingly. Attach the policy to the role you created in the step prior. 


<{ "Version": "2012-10-17", "Statement": [ { "Sid": "", "Effect": "Allow", "Action": "s3:*", "Resource": [ "arn:aws:s3:::${pipeline-bucket-name}/*", "arn:aws:s3:::${pipeline-bucket-name}", "arn:aws:s3:::${website-bucket-name}/*", "arn:aws:s3:::${website-bucket-name}" ] }>,

<{ "Sid": "", "Effect": "Allow", "Action": [ "codebuild:*", "codecommit:*", "cloudfront:CreateInvalidation" ], "Resource": "*" }>,

< { "Sid": "", "Effect": "Allow", "Action": [ "logs:Put*", "logs:FilterLogEvents", "logs:Create*" ], "Resource": "*" } ] } >

Setup CloudFront

  • Access Cloudfront and select Create distribution.
    Under Origin domain – select the S3 Bucket you created earlier.
  • Under Viewer protocol policy, set your desired actions. If you have a proper SSL you can set it up later and use Redirect HTTP to HTTPS.
  • Under Allowed HTTP methods, select GET, HEAD.
  • You can setup Alternate domain name here, but make sure you have an ACM Certificate to cover it, and setup Customer SSL certificate if you wish to use HTTPS.
  • Set the Default root object to index.html. This will ensure it loads the website if someone visits the root of the domain.
  • Leave everything else as default for the moment and click Create distribution.
  • Note down the Distribution ID, as you will need it for the Pipeline.

Setup the Pipeline

Now that all the components have been created, let’s setup the Pipeline to Tie them all Together.
Setup CodeCommit 
Navigate in to CodeCommit, and select Create Repository
You can use git-remote-codecommit in order to checkout the repository locally. You will need to check it out to make additional changes.  

You will need to make a sample commit, so create a directory called public and a file called index.html within it with some sample content, and push it up. 

$ cat public/index.html 
This is an S3-hosted website test 

After this is done, you should have a branch called “master” or “main” depending on your local configuration. This will need to be referenced during pipeline creation.
Setup buildspec in Repository 

Add a buildSpec.yml file to the CodeCommit Repo in order to automatically upload your files to AWS S3, and Invalidate the Cloudfront Cache. Note that ${bucketname} and ${cloudfront_id} in the examples below need to be replaced with the real values.  


version: 0.2

phases: 

  install: 

    commands: 

      - aws s3 sync ./public/ s3://${bucketname}/ 

      - aws cloudfront create-invalidation --distribution-id ${cloudfront_id} --paths "/*" 

Setup CodePipeline 

In our example, we’re going to use a very simple and straightforward pipeline. It will have a Source and Deployment phase. 

Navigate in to CodePipeline, and select Create Pipeline. Enter your Pipeline name, and select the role you created earlier under Service role. 

Under Advanced Settings, set the Artifact Store to Custom Location and update the field to reference the pipeline bucket you created earlier on. 

Click next, and move to Adding a Source Provider. Select the Source provider, Repository name and Branch name setup previously, and click next leaving everything else as default. 

On the Build section, select Build provider as AWS CodeBuild, and click Create Project under Project name 

This will open a new window. Codebuild will need to be created through this interface, otherwise it doesn’t support the artifacts, and source configuration correctly. 

Under Environment, select the latest Ubuntu Runtime for codebuild, and under Service role select the IAM role you created earlier. Once that’s all done, click Continue to CodePipeline and it will close out the window and your project will now be created. 

Click Next, and then Skip deploy stage (we’re doing it during the build stage!). Finally, click on create the pipeline and it will start running based on the work you’ve done so far.  

The website so far should now be available in the browser! Any further changes to the CodeCommit repository will result in the website being updated on S3 within minutes! 

The post Using CodePipeline to Host a Static Website appeared first on Anchor | Cloud Engineering Services.

2022-10-15 Лекция от OpenFest 2022, “Голям monitoring”

Post Syndicated from original https://vasil.ludost.net/blog/?p=3458

Това е подготвения текст за лекцията, доста се разминава с това, което
говорих, но би трябвало поне смисъла да е същия 🙂


Ще ви разкажа за една от основните ми задачи в последните 5 години.

Преди да започна в StorPool, monitoring-ът представляваше нещо, което
периодично се изпълняваше на всяка машина и пращаше mail, който не беше съвсем
лесен за разбиране – нямаше начин да се види едно обща картина. За да мога да
се ориентирам, сглобих нещо, което да ми помогне да виждам какво се случва.
Лекцията разказва за крайния резултат.

Ще го повторя няколко пъти, но няма нищо особено специално, магическо или ново
в цялата лекция. Правя това от няколко години, и честно казано, не мислех, че
има смисъл от подобна лекция, понеже не показва нещо ново – не съм направил откритие
или нещо невероятно.

Имаше учудващо голям интерес към лекцията, за това в крайна сметка реших да я
направя.

Та, как пред ръководството да оправдаем хабенето на ресурси за подобна система
и да обясним, че правим нещо смислено, а не се занимаваме с глупости?

Ако нещо не се следи, не работи. Това е от типа “очевидни истини”, и е малка
вариация на максима от нашия development екип, които казват “ако нещо не е
тествано, значи не работи”. Това го доказваме всеки път, когато се напише нов
вид проверка, и тя изведнъж открие проблем в прилична част от всички
съществуващи deployment-и. (наскоро написахме една, която светна само на 4
места, и известно време проверявахме дали няма някаква грешка в нея)

Monitoring-ът като цяло е от основните инструменти за постигане на situational
awareness.

На кратко, situational awareness е “да знаеш какво се случва”. Това е различно
от стандартното “предполагам, че знам какво се случва”, което много хора правят
и което най-хубаво се вижда в “рестартирай, и ще се оправи”. Ако не знаеш къде
е проблема и действаш на сляпо, дори за малко да изчезне, това на практика нищо
не значи.

Та е много важно да сме наясно какво се случва. И по време на нормална работа,
и докато правим проблеми, т.е. промени – важно е да имаме идея какво става.
Много е полезно да гледаме логовете докато правим промени, но monitoring-а може
да ни даде една много по-пълна и ясна картина.

Да правиш нещо и изведнъж да ти светне alert е супер полезно.

(По темата за situational awareness и колко е важно да знаеш какво се случва и
какви са последствията от действията ти мога да направя отделна лекция…

А всичко, което забързва процеса на откриване на проблем и съответно решаването
му, както и всяко средство, което дава възможност да се изследват събития и
проблеми води до това системите да имат по-нисък downtime. А да си кажа, не
знам някой да обича downtime.

Да започнем с малко базови неща, които трябва да обясня, като говоря за monitoring.

Едното от нещата, които се събират и се използват за наблюдаване на системи са
т.нар. метрики. Това са данни за миналото състояние на системата – може да си
ги представите най-лесно като нещата, които се визуализират с grafana.
Най-честата им употреба е и точно такава, да се разглеждат и да се изследва
проблем, който се е случил в миналото (или пък да се генерират красиви картинки
колко хубаво ви работи системата, което маркетинга много обича).

Друго нещо, за което са много полезни (понякога заедно с малко статистически
софтуер) е да се изследват промени в поведението или как определена промяна е
повлияла. Това до колкото знам му казват да сте “data driven”, т.е. като
правите нещо, да гледате дали данните казват, че сте постигнали това, което
искате.

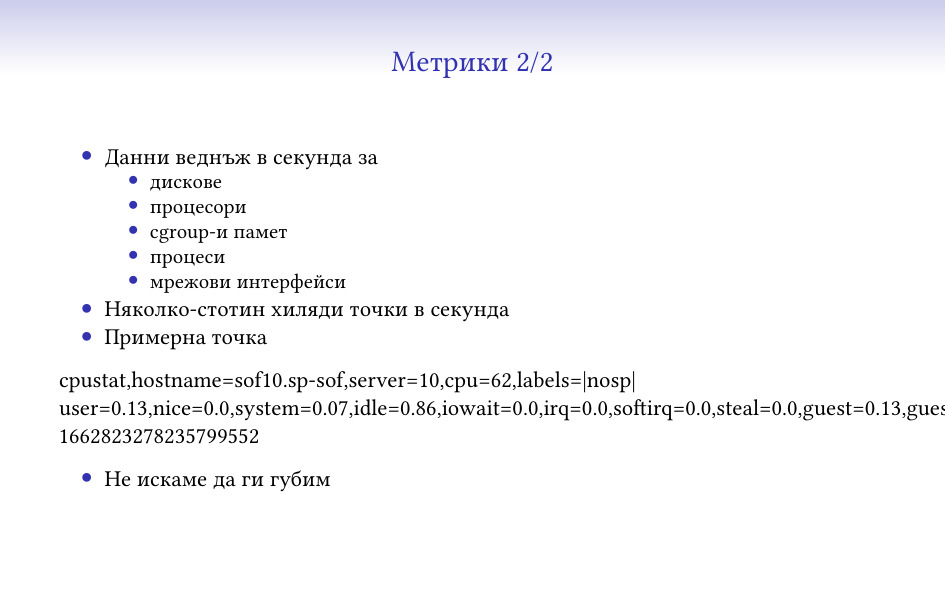
Метриките, които аз събирам са веднъж в секунда, за много различни компоненти
на системата – дискове, процесори, наши процеси, мрежови интерфейси. В момента
са няколко-стотин хиляди точки в секунда, и тук съм показал една примерна –
показва данните за една секунда за един процесор на една машина, заедно с малко
тагове (че например процесорът не се използва от storage системата, та за това
там пише “nosp”) и с timestamp.

Метриките са нещо, което не искаме да се изгуби по пътя или по някаква друга
причина, защото иначе може да се окаже, че не можем да разберем какво се е
случило в даден момент в системата. В някакъв вид те са като “логове”.

Метриките се събират веднъж в секунда, защото всичко друго не е достатъчно ясно
и може да изкриви информацията. Най-простия пример, който имам е как събитие,
което се случва веднъж в минута не може да бъде забелязано като отделно такова
на нищо, което не събира метрики поне веднъж на 10 секунди.

Също така, събития, които траят по секунда-две може да имат сериозно отражение
в/у потребителското усещане за работа на системата, което пак да трябва да е
нещо, което да трябва да се изследва. В 1-секундните метрики събитието може да
е се е “размазало” достатъчно, че да не е видимо и да е в границите на
статистическата грешка.

Имам любим пример, с cron, който работеше на една секунда и питаше един RAID
контролер “работи ли ти батерията?”. Това караше контролера да блокира всички
операции, докато провери и отговори, и на минутните графики имаше повишение на
латентността на операциите (примерно) от 200 на 270 микросекунди, и никой не
можеше да си обясни защо. На секундните си личеше, точно на началото на всяка
минута, един голям пик, който много бързо ни обясни какво става.

(отказвам да коментирам защо проверката на статуса на батерията или каквото и
да е, което питаме контролера отвисява нещата, най-вече защото не знам къде
живеят авторите на firmware)

Та това се налага да го обяснявам от време на време, и да се дразня на системи
като Prometheus, където практически по-добра от 3-секундна резолюция не може да
се постигне.

Също така, не знам дали мога да обясня колко е готино да пускате тестове, да
сте оставили една grafana да refresh-ва веднъж в секунда и почти в реално време
да може да виждате и да показвате на хората как влияят (или не) разлини
действия на системата, от типа на “тук заклахме половината мрежа и почти не се
усети”.

Другото нещо, което се следи е текущото състояние на системата. Това е нещото,
от което се смята статуса на системата в nagios, icinga и други, и от което се
казва “тук това не работи”. Системите, които получават тази информация решават
какви проблеми има, кого и дали да известят и всякакви такива неща.

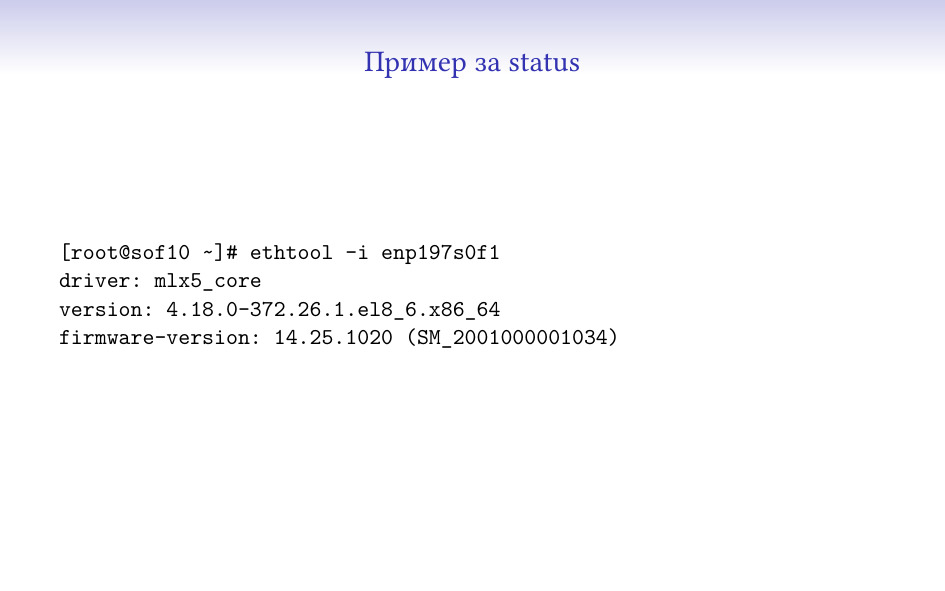
Статусът е нещо по-общо, и май нямам пример, който мога да събера на един слайд
и да може да се разбере нещо. Много често той носи допълнителна информация,
от която може да дойде нещо друго, например “мрежовата карта е с еди-коя-си
версия на firmware”, от което да решим, че там има известен проблем и да
показваме алармата по различен начин.

Метриките са доста по-ясни като формат, вид и употреба – имат измерение във
времето и ясни, числови параметри. Останалите данни рядко са толкова прости и
през повечето време съдържат много повече и различна информация, която не
винаги може да се представи по този начин.

Един пример, който мога да дам и който ми отне някакво време за писане беше
нещо, което разпознава дали дадени интерфейси са свързани на правилните места.
За целта събирах LLDP от всички сървъри, и после проверявах дали всички са
свързани по същия начин към същите switch-ове. Този тип информация сигурно може
да се направи във вид на метрики, но единствено ще стане по-труден за употреба,
вместо да има някаква полза.

А какъв е проблема с цялата тази работа, не е ли отдавна решен, може да се питате…

Като за начало, ако не се постараете, данните ви няма да стигнат до вас. Без
буфериране в изпращащата страна, без използване на резервни пътища и други
такива, ще губите достатъчна част от изпращаните си данни, че да имате дупки в
покритието и неяснота какво се случва/се е случило.

Данните са доста. Написал съм едни приблизителни числа, колкото да си проличи
генералния обем на данните, налагат се някакви трикове, така че да не ви удави,
и определено да имате достатъчно място и bandwidth за тях.

Дори като bandwidth не са малко, и хубавото на това, че имаме контрол в/у двете
страни, e че можем да си ги компресираме, и да смъкнем около 5 пъти трафика.
За това ни помага и че изпращаните данни са текстови, CSV или JSON – и двете
доста се поддават на компресия.

Няма някой друг service при нас, който да ползва сравнимо количество internet
bandwidth, дори някакви mirror-и 🙂

Идващите данни трябва да се съхраняват за някакво време. Добре, че фирмата
се занимава със storage, та ми е по-лесно да си поискам хардуер за целта…

За да можем все пак да съберем всичко, пазим само 2 дни секундни данни и 1
година минутни. InfluxDB се справя прилично добре да ги компресира – мисля, че
в момента пазим общо около двайсетина TB данни само за метрики. За
monitoring данните за debug цели държим пращаните от последните 10 часа, но
това като цяло е лесно разширимо, ако реша да му дам още място, за момента
се събират в около 1.6TiB.
(Това е и една от малкото ми употреби на btrfs, защото изглежда като
единствената достъпна файлова система с компресия… )

Ако погледнем още един път числата обаче, тук няма нищо толкова голямо, че да
не е постижимо в почти “домашни” условия. Гигабит интернет има откъде да си
намерите, терабайтите storage дори на ssd/nvme вече не са толкова
скъпи, и скорошните сървърни процесори на AMD/Intel като цяло могат да вършат
спокойно тая работа. Та това е към обясненията “всъщност, всеки може да си го
направи” 🙂

Системите, които наблюдаваме са дистрибутирани, shared-nothing, съответно
сравнително сложни и проверката дали нещо е проблем често включва “сметка” от
няколко парчета данни. Като сравнително прост пример за някаква базова проверка
– ако липсва даден диск, е проблем, но само ако не сме казали изрично да бъде
изваден (флаг при диска) или ако се използва (т.е. присъства в едни определени
списъци). Подобни неща в нормална monitoring система са сложни за описване и
биха изисквали език за целта.

Имаме и случаи, в които трябва да се прави някаква проверка на база няколко
различни системи, например такива, които регулярно си изпращат данни – дали
това, което едната страна очаква, го има от другата. Понякога отсрещните страни
може да са няколко 🙂

Статусът се изпраща веднъж в минута, и е добре да може да се обработи
достатъчно бързо, че да не се натрупва опашка от статуси на същата система.
Това значи, че monitoring-ът някакси трябва да успява да сдъвче данните
достатъчно бързо и да даде резултат, който да бъде гледан от хора.

Това има значение и за колко бързо успяваме да реагираме на проблеми, защото
все пак да се реагира трябва трябва да има на какво 🙂

И имаме нужда тази система да е една и централизирана, за можем да следим
стотиците системи на едно място. Да гледаш 100 различни места е много трудно и
на практика загубена кауза. Да не говорим колко трудно се оправдава да се сложи
по една система при всеки deployment само за тази цел.

Това има и други предимства, че ако наблюдаваните системи просто изпращат данни
и ние централно ги дъвчем, промяна в логиката и добавяне на нов вид проверка
става много по-лесно. Дори в модерните времена, в които deployment-а на хиляда
машини може да е сравнително бърз, пак трудно може да се сравнява с един локален
update.

И това трябва да работи, защото без него сме слепи и не знаем какво се случва,
не го знаят и клиентите ни, които ползват нашия monitoring. Усещането е като
донякъде да стоиш в тъмна стая и да чакаш да те ударят по главата…

От какво е сглобена текущата ни система?

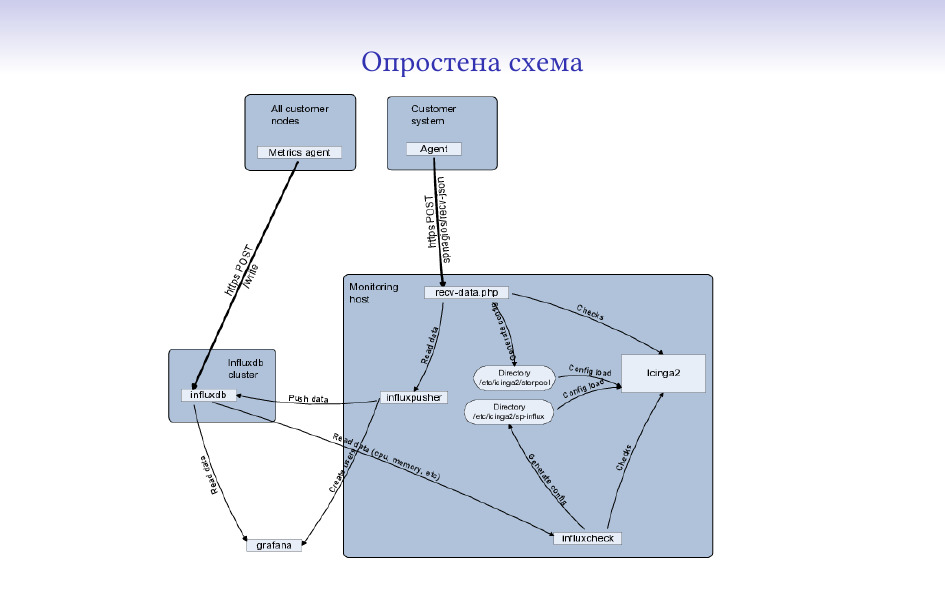
За база на системата използвам icinga2. В нея се наливат конфигурации, статуси
и тя решава какви аларми да прати и поддържа статус какво е състоянието в
момента.

Беше upgrade-ната от icinga1, която на около 40% от текущото натоварване умря и
се наложи спешна миграция.

InfluxDB, по времето, в което започвах да пиша системата беше най-свястната от
всичките съществуващи time series бази.

Като изключим доста осакатения език за заявки (който се прави на SQL, но е
много далеч и е пълен със странни ограничения), и че не трябва да се приема за
истинска база (много глезотии на mysql/pgsql ги няма), InfluxDB се справя добре
в последните си версии и не може да бъде crash-ната с някоя заявка от
документацията. Основното нещо, което ми се наложи да правя беше да прескоча
вътрешния механизъм за агрегиране на данни и да си напиша мой (който не помня
дали release-нахме), който да може да върши същото нещо паралелно и с още малко
логика, която ми трябваше.

От някакво време има и версия 2, която обаче е променила достатъчно неща, че да
не мога още да планирам миграция до нея.

Както обясних, проверките по принцип са не-елементарни (трудно ми е да кажа
сложни) и логиката за тях е изнесена извън icinga.

В момента има около 10k реда код, понеже се добавиха всякакви глезотии и
интересни функционалности (човек като има много данни, все им намира
приложение), но началната версия за базови неща беше около 600 реда код, с
всичко базово. Не мисля, че отне повече от няколко дни да се сглоби и да се
види, че може да върши работа.


Ако ползвате стандартен метод за активни проверки (нещо да се свързва до
отсрещната страна, да задава въпрос и от това да дава резултат), никога няма да
стигнете хиляди в секунда без сериозно клъстериране и ползване много повече
ресурси.

Дори и да не ползвате стандартните методи, пак по-старите версии на icinga не
се справят с толкова натоварване. При нас преди няколко години надминахме
лимита на icinga1 и изборът беше м/у миграция или клъстериране. Миграцията се
оказа по-лесна (и даде някакви нови хубави функционалност, да не говорим, че се
ползваше вече софтуер от тоя век).

Основният проблем е архитектурен, старата icinga е един процес, който прави
всичко и се бави на всякакви неща, като комуникация с други процеси,
писане/четене от диска, и колкото и бърза да ни е системата, просто не може да
навакса при около 20-30к съществуващи услуги и няколко-стотин статуса в
секунда. А като му дадеш да reload-не конфигурацията, и съвсем клякаше.

Изобщо, технически това един бивш колега го описваше като “десет литра лайна
в пет литра кофа”.

Новата например reload-ва в отделен процес, който не пречи на главния.

Признавам си, не обичам Prometheus. Работи само на pull, т.е. трябва да може да
се свързва до всичките си крайни станции, и като го пуснахме за вътрешни цели с
около 100-200 машини, почна да му става сравнително тежко при проверка на 3
секунди. Също така изобщо няма идеята да се справя с проблеми на internet-а,
като просто интерполира какво се е случило в периода, в който не е имал
свързаност.

Върши работа за някакви неща, но определен е далеч от нашия случай. Според мен
е и далеч от реалността и единствената причина да се ползва толкова е многото
натрупани готови неща под формата на grafana dashboard-и и exporter-и.


Компонентите са в общи лини ясни:

Агентите събират информация и се стараят да ни я пратят;

Получателите я взимат, анализират, записват и т.н.;

Анализаторите дъвчат събраната информация и на база на нея добавят още
проверки.

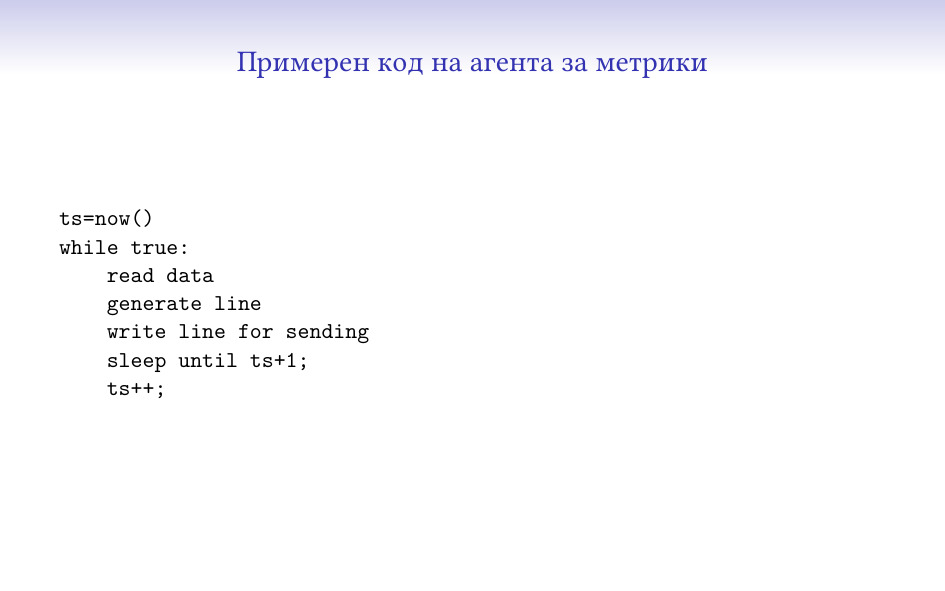
Тук не измислих как да го покажа, но това е един thread, който събира данни (от
няколко такива), и има един който изпраща данните и се старае да стигнат. Пак е
сравнително малко код и може да бъде сглобен почти от всеки.

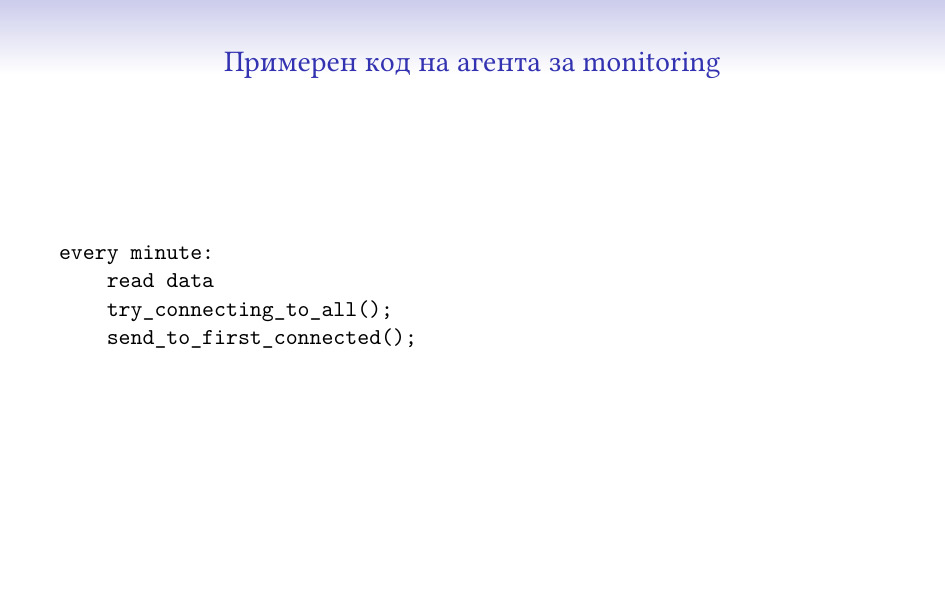
За данни, за които повече бързаме да получим и не буферираме, има друг
интересен трик – да имате няколко входни точки (при нас освен нашия си интернет
имаме един “домашен”, който да работи дори да стане някакво бедствие с
останалия), съответно агентът се опитва да се свърже едновременно с няколко
места и което първо отговори, получава данните.

Понеже това е писано на perl по исторически причини, беше малко странно да се
направи (понеже select/poll на perl, non-blocking връзки и подобни неща не са
съвсем стандартни), но сега мога да го похваля, че работи много добре и се
справя вкл. и с IPv6 свързаност.

И всичкия код, който получава/прави анализи си е тип ETL
(extract-transform-load). Взима едни данни, дъвче, качва обратно.

В нашия случай това, което връща са състояния и конфигурации (ще го покажа
по-долу).

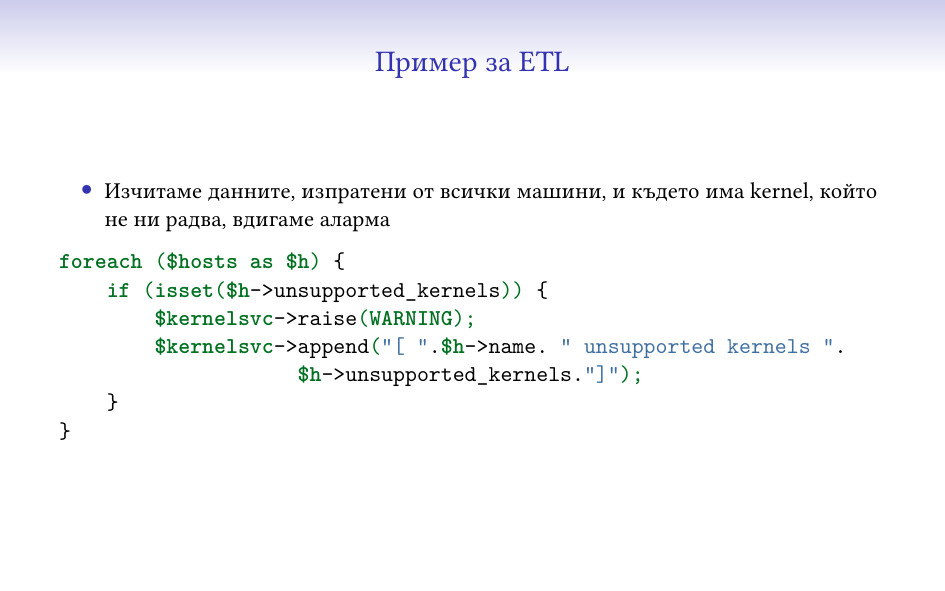
И един елементарен пример, почти директно от кода – обикаля данните за набор от
машини, проверява дали в тях има нещо определено (kernel, за който нямаме
качена поддръжка) и го отбелязва.

Има и по-интересни такива неща (анализи на латентности от метриките, например),
но нямаше да са добър пример за тук 🙂

“Липсата на сигнал е сигнал” – можем да знаем, че нещо цялостно или част от
него не ни говори, понеже имаме контрол в/у агентите и кода им, и знаем
кога/как трябва да се държат.

Някой би казал, че това се постига по-добре с активна проверка (“тия хора
пингват ли се?”), но това се оказва много сложно да се прави надеждно, през
интернета и хилядите firewall-и по пътя. Също така, не може да се очаква
интернета на всички да работи добре през цялото време (заради което и всичките
агенти са направени да се борят с това).

Както казах по-рано, Интернета не работи 🙂

Един от най-важните моменти в подобна система е колко работа изисква за
рутинните си операции. Понеже аз съм мързел и не обичам да се занимавам с
описване на всяка промяна, системата автоматично се конфигурира на база на
пристигналите данни, решава какви системи следи, какви услуги, вижда дали нещо
е изчезнало и т.н. и като цяло работи съвсем сама без нужда от пипане.

Има функционалност за специфична конфигурация за клиент, която изисква ръчна
намеса, както и изтриването на цялостни системи от monitoring-а, но това като
цяло са доста редки случаи.

Системата се грижи всичко останало да се случва съвсем само.

Това, което според мен е най-важното за тази и подобни системи – няма нищо
особено сложно в тях, и всеки, който се нуждае от нещо такова може да си го
сглоби. Първоначалната ми версия е била около 600 реда код, и дори в момента в
10-те хиляди реда човек може да се ориентира сравнително лесно и да добави
нещо, ако му се наложи.

Като пример, дори python програмистите при нас, които считат, че php-то трябва
да се забрани със закон, са успявали да си добавят функционалност там
сравнително лесно и със съвсем малко корекции по стила от моя страна.

Самото php се оказва много удобно за подобни цели, основно защото успява да се
справи и с объркани данни (което се случва при разни ситуации) и не убива
всичко, а си се оплаква и свършва повечето работа. Разбира се, това не е
единствения подходящ език, аз лично писах на него, защото ми беше лесен – но
ако искате да сглобите нещо, в наши дни може да го направите почти на каквото и
си искате и да работи. Python и js са някакви основни кандидати (като езици,
дето хората знаят по принцип), само не препоръчвам shell и C 🙂

Така че, ако ви трябва нещо такова – с по-сложна логика, да издържа повече
натоварване, да прави неща, дето ги няма в други системи – не е особено сложно
да го сглобите и да тръгне, нещо минимално се сглабя за няколко дни, а се
изплаща супер бързо 🙂

Monitoring системата се налага да се следи, разбира се. Всичкият софтуер се
чупи, този, който аз съм правил – още повече. По случая други колеги направиха
нещо, което да следи всичките ни вътрешни физически и виртуални машини, и това
между другото следи и големия monitoring 🙂

Изглежда по коренно различен начин – използва Prometheus, Alertmanager и за
база VictoriaMetrics, което в общи линии значи, че двете системи рядко имат
същите видове проблеми. Също така и допълнителния опит с Prometheus ми показа,
че определено е не е бил верния избор за другата система 🙂

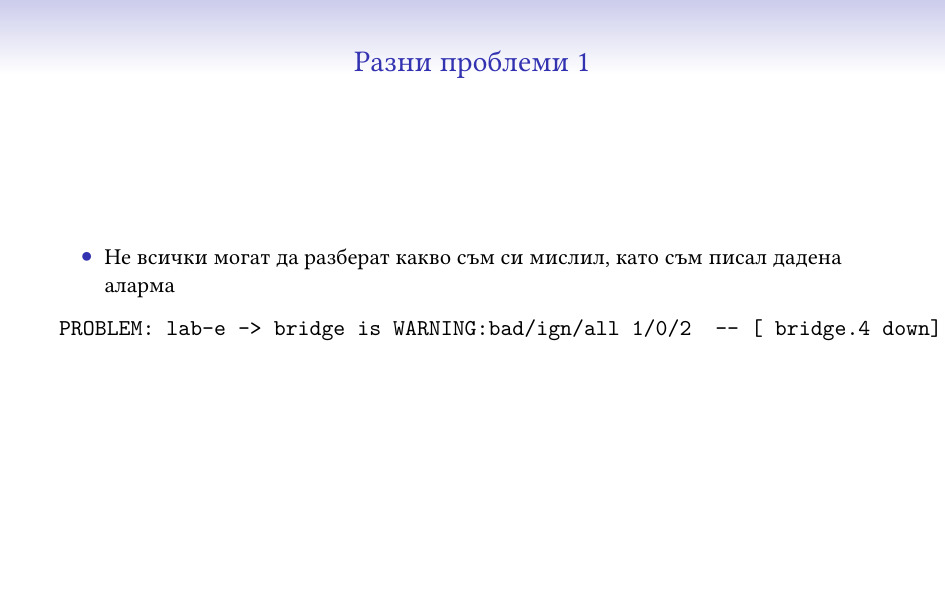
Може би най-големият проблем, който съм имал е да обясня какво значи текста на
дадена аларма на други колеги. Тук например съм казал “има малък проблем (за
това е WARNING), в услугата bridge, има един счупен, нула игнорирани (по разни
причини) и 2 общо, и този на машина 4 е down” – и това поне трима различни
човека са ми казвали, че не се разбира. Последното ми решение на проблема е да
карам да ми дадат как очакват да изглежда и да го пренаписвам. От една страна,
съобщенията станаха по-дълги, от друга – не само аз ги разбирам 🙂

Няколко пъти се е случвало системата да изпрати notification на много хора по
различни причини – или грешка в някоя аларма, или просто има проблем на много
места. Като цяло първото може доста да стресне хората, съответно вече (със
съвсем малко принуда) има няколко staging среди, които получават всички
production данни и в които може да се види какво ще светне, преди да е стигнало
до хора, които трябва да му обръщат внимание.

Изобщо, ако човек може да си го позволи, най-доброто тестване е с production
данните.

Основна задача за всяка такава система трябва да е да се намалят алармите до
минимум. Би трябвало фалшивите да са минимален брой (ако може нула), а едно
събитие да генерира малко и информативни такива. Също така, трябва да има лесен
механизъм за “умълчаване” на някаква част от алармите, когато нещо е очаквано.

Това е може би най-сложната задача, понеже да се прецени кога нещо е проблем и
кога не е изисква анализ и познаване на системата, понякога в дълбини, в които
никой не е навлизал.

Решението тук е да се вземат алармите за един ден, и да се види кое от тях е
безсмислено и кое може да се махне за сметка на нещо друго, след което мноооого
внимателно да се провери, че това няма да скрие истински проблем, вероятно с
гледане на всички останали задействания на неприемливото съобщение. Което е
бавна, неблагодарна и тежка работа 🙂

Не исках да слагам този slide в началото, че сигурно нямаше да остане никой да
слуша лекцията. Оставям го да говори сам за себе си:)

OpenFest 2022 призиви

Post Syndicated from original https://vasil.ludost.net/blog/?p=3454

Добрутро.

Ще има пак OpenFest, 20-то издание, пак в София Тех Парк.
Изданието е юбилейно (поне в десетичната бройна система), та събираме желаещи да говорят, да правят работилници (т.е. workshop-и), както и да помагат. Както обикновено, записването е на cfp.openfest.org, срокът за лекции и т.н. е до 1.09.2022.

Чакаме с нетърпение 🙂

2022-03-07 война

Post Syndicated from original https://vasil.ludost.net/blog/?p=3453

От няколко дни си мисля колко много не искам да пиша тоя post.

За всички, които са живели под камък – преди 12 дни Русия нападна Украйна. Последиците от това безумие ще ги усещаме дълго време…

Да започна с краткото описание на руската пропаганда – мисля, че обяснява повечето лъжи, разпространявани по темата. Особено много ме дразни обяснението, че Путолини (някои хора ползват “Путлер”, ама определено се справя по-зле с blitzkrieg-а) нямал избор. Винаги има избор, и можеше вместо 30 години да си крадат усилено страната, да направят нещо смислено…
А вместо това някаква част от окрадените пари отидоха за информационна война. Която, да не се лъжем, в общи линии губехме. Достатъчно е да видим огромното одобрение за Путолини в България, всякаквото плюене против LGBT и ваксините и крайния ефект от това (най-слабо ваксинираната държава, най-голяма смъртност на глава от населението от COVID-19).
Колкото до свързаността на по-горните, много добре си личи кой започна да се изказва в подкрепа на войната, след като започнаха да режат различните източници на пропаганда. Дори и в нашите медии си личи, въпреки че доста от тях сериозно се уплашиха и леко промениха линията.
(няма да коментирам “националистите” предатели в парламента като Копейкин)

… а нас ни чака още една Северна Корея, само че по-близо до нас, и в която има наши близки. В момента самата Русия се опитва да се изолира от света, като се кани да се отреже от глобалния интернет (малко информация по темата), не могат да се случват разплащания (което се спира и от двете страни) и със спирането на полетите пък самите руснаци, които искат да се махнат от там, не могат. И докато там хората ще страдат заради изперкалия си “водач”, Европа (и в това число България) ще трябва да преосмисли зависимостите си и кой ни ги насади, и да направи нещо по въпроса.
(поне има сериозен шанс да намалее много влиянието на Русия в нашата политика и като цяло тяхната пропаганда, като не могат да плащат)

Но, в крайна сметка има значение какво правим, не какво говорим. Супер се радвам как доброволците от OpenFest почти моментално се навиха/захванаха да помагат за бежанците, и как се задвижиха организациите по темата. Не настигаме Полша, и не сме толкова желана дестинация (най-вече заради високия рейтинг на Путолини и като цяло голямото руско влияние тук), но все пак до преди няколко дни са пристигнали 20000 бежанци, и ще идват още. Можем да им помогнем, можем да помогнем на организациите, можем да спрем да купуваме руски газ най-накрая, и да измъкнем и хората от Русия/Беларус, останали там под управлението на малоумници.

Можем още неща, давайте предложения.

А аз ще се опитам да не си представям всеки път като си играя с децата какво ли се случва с децата в Украйна.

(защото може да не сме в списъка на следващите за нападане, но определено сме в списъка на по-следващите)

2021-12-29 равносметъчно

Post Syndicated from original https://vasil.ludost.net/blog/?p=3452

Някаква равносметка.

(чудех се дали да го пусна догодина, че да имам поне един post за тогава, но сега имам малко време)

Та, поред на случките:

– Случихме online FOSDEM (и догодина пак ще е online);
– Случихме един малък OpenFest в парка, присъствено, да се видят разни хора, че се бяха забравили. Не умряхме от жега, и се получи прилично събитие. Огромното ми желание е догодина да случим истинското, в голяма зала, както си трябва, ама да видим;
– Успяхме да си вземем апартамент и да го ремонтираме дотолкова, че да се нанесем (има неща за довършване, ама доколкото знам това винаги си е така). Зверовете са много щастливи 🙂
– Лятото успях да изкарам една двойна пневмония, от която май още имам някакви последствия, но като цяло съм добре.
– Работата е as usual много, но си остава интересна. Продължаваме да си търсим хора (както и всички останали), ако на някой му е скучно, може да пише.

Годината мина като някой натоварен работен ден – от тоя тип, в който си правил толкова много неща, че накрая не може да се сетиш за нито едно. Кога почна, кога свърши, тотално не е ясно, ако не растяха децата, можеше да не се усетя, че нещо се е променило 🙂

Отказвам да имам очаквания за идващата година. Някои хора казват, че поне supply chain проблема може да почне да се пооправя към края ѝ, а дано.

2021-10-18 vivacom

Post Syndicated from original https://vasil.ludost.net/blog/?p=3451

Има неща, дето не трябва да ме учудват, но все пак успяват.

Днес по някое време ми спря Internet-а. По принцип ползвам Comnet София, които се отделиха от Comnet, и които в последствие бяха купени от Vivacom. След известно гледане видях, че в лога на pppd-то има съобщение “Neplatena smetka”.

Звъннах по телефона, където бях пренасочен към call центъра на Vivacom. След някакво чакане (над 10 минути, не ми се беше случвало скоро) и ходене по менюта стигнах до някакви хора, които да видят какво става. Оказа се, че последното ми плащане е изтекло на 15.10, и днес, на 18ти, са ми спрели услугата. Не бях получил известие от epay, защото явно тази част вече е спряна. Питайки как мога да го платя online ми казаха – не може, нямате още клиентски номер, трябва в магазин.

Отидох до близкия техен магазин, където ме намериха по ЕГН и ми обясниха, че мога да си платя за 6 месеца или 1 година. Обясних, че този договор винаги е бил месец по месец, и за мен няма особен смисъл да плащам толкова време, при условие, че до месец ще съм се изнесъл. Гледаха, мислиха, обадих се и на техния call center пак, и след половин час изводът си беше все тоя – те такава услуга нямат, няма начин. От друга страна, води се предплатена, няма прекратяване или каквото и да е друго и не им дължа нищо.
(явно и не трябва да връщам ONT-то, дето Comnet ми дадоха).

Та, теглих им една учтива майна, и ще карам седмица-две-три на 3G, докато се пренеса.

Също така, не знам това дали е от некадърност или съвсем нарочно, да се опитат да издоят максимално всичките клиенти, дето са купили, но много се надявам никой да не им се върже.