Post Syndicated from LastWeekTonight original https://www.youtube.com/shorts/jJMKvH-LMN4
Why Soldiers Can Struggle to Return to Civilian Life
Post Syndicated from The Atlantic original https://www.youtube.com/shorts/bbCuypFou5w
A Better Way To Be A Man
Post Syndicated from The Atlantic original https://www.youtube.com/watch?v=ipmz9LzPA7E
Time to replace hundreds of batteries
Post Syndicated from Matt Granger original https://www.youtube.com/shorts/D3uop1GJR4Q
The Christian Nationalists Have a Plan
Post Syndicated from The Atlantic original https://www.youtube.com/shorts/hNuA6SvZdzQ
Announcement from the Wizards’ Guild
Post Syndicated from Oglaf! -- Comics. Often dirty. original https://www.oglaf.com/wizards-guild/

How to Land 4,000 Planes During a Ground Stop
Post Syndicated from The Atlantic original https://www.youtube.com/shorts/YMBZ5KaUxDI
Анти-примери в озеленяването – сградата на Блъсков в Дианабад
Post Syndicated from Боян Юруков original https://yurukov.net/blog/2026/ozelenyavane-5/
Поредният пример от поредицата ми за нередности в задължителното озеленяване е тази на Блъсков в Дианабад. За разлика от предишният пример, който е буквално отсреща на улицата, тази сграда е готова от години. Аналогично дава ярки примери за пълно незачитане на нормативните разпоредби, нарушения при приемането на обектите и какво неизменно следва веднага като мине акт 16. Разликата с описаното в предишните статии може би е, че там инвеститорите развяват претенции за лукс, качество и най-вече всеобхватна зеленина и екологичност на строежите. Твърдения в рязък контраст с наблюдаваното както в проектната документация, така и на място в строежите. Блъсков и близките му замесени в този строеж поне не се крият какви са.
Както на много други строежи, озеленяването е навярно най-малкия проблем. Този конкретно стана злощастно известен със схемата, в която Фандъкова направи заменка на имот на един от синовете на Блъсков с това място, което трябваше да стане разширение на детската градина. Повече за това и протестите ще намерите в Mediapool и Капитал. Бях на протестите тогава и станах свидетел колко нагло се държа Блъсков и колко лъга. В крайна сметка схемата му успя и прибра значителна печалба с подаръка от същото икономическо мнозинство, което държи и сега СОС.
Част от тази печалба беше възможна именно, защото приложи масовата схема да застрои сградата значително повече от разрешеното. Формално кинтът е спазен, но това е възможно единствено, защото са спестили значително от озеленяването. Преди дни получих от ДНСК протокола на приемателната комисия и ще споделя какви са изводите им. Първо нека разгледаме какво се вижда на място.
Сегашно състояние
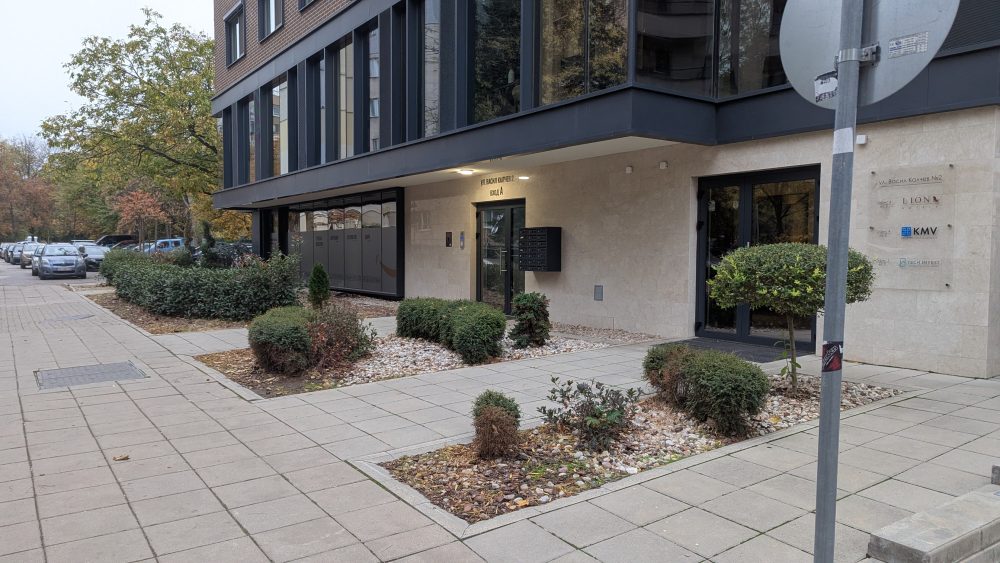
Сградата е върху два парцела – 68134.803.3950 и 68134.803.3951. На практика е една и съща и е свързана. На първата снимка виждате южната страна, където с вкопани няколко саксии с храсчета, а останалото, което би следвало да се е зелена площ, винаги е било запълнено с декоративни камъни и трици. Под него на съвсем плитко е бетон та дори трева не би оцеляла.
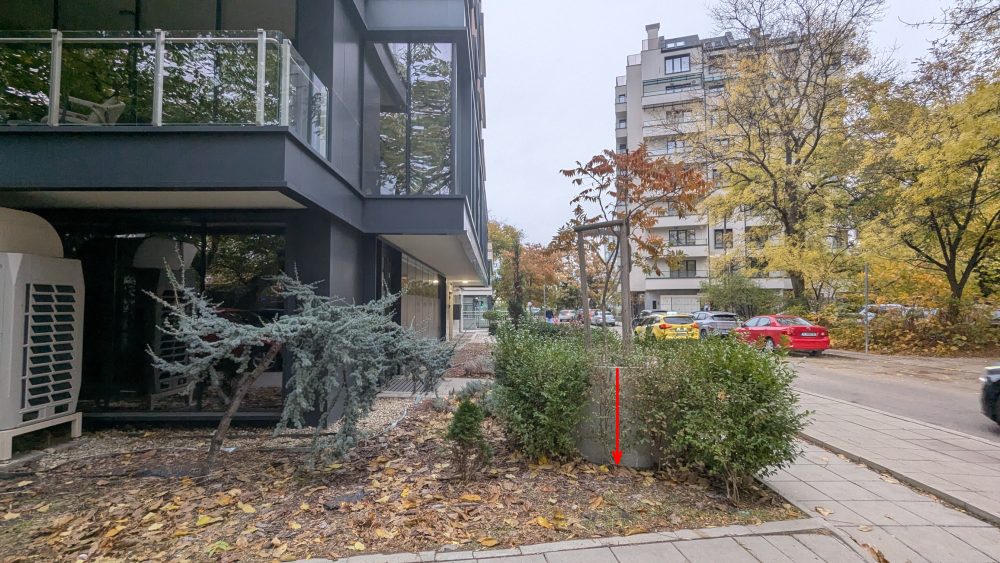
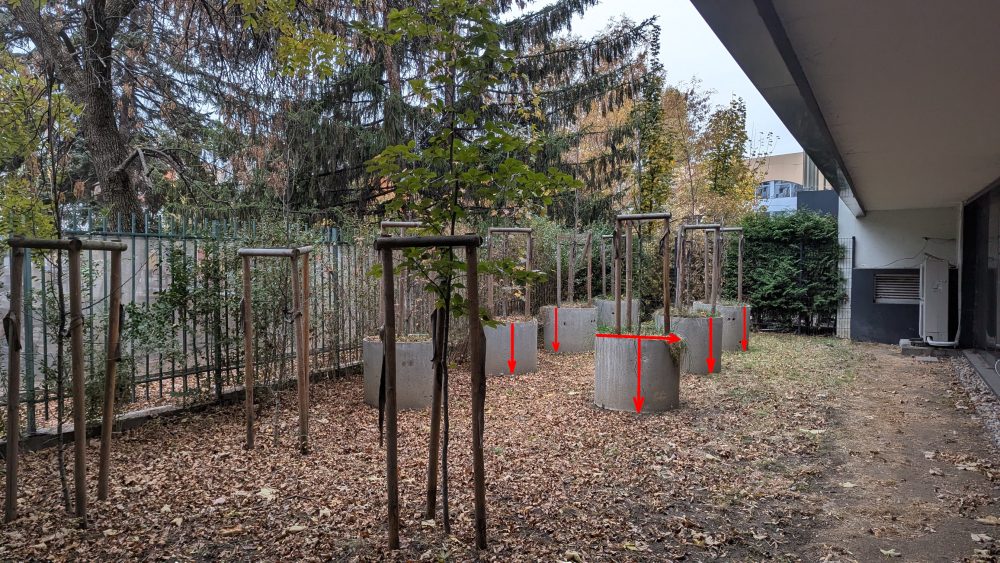
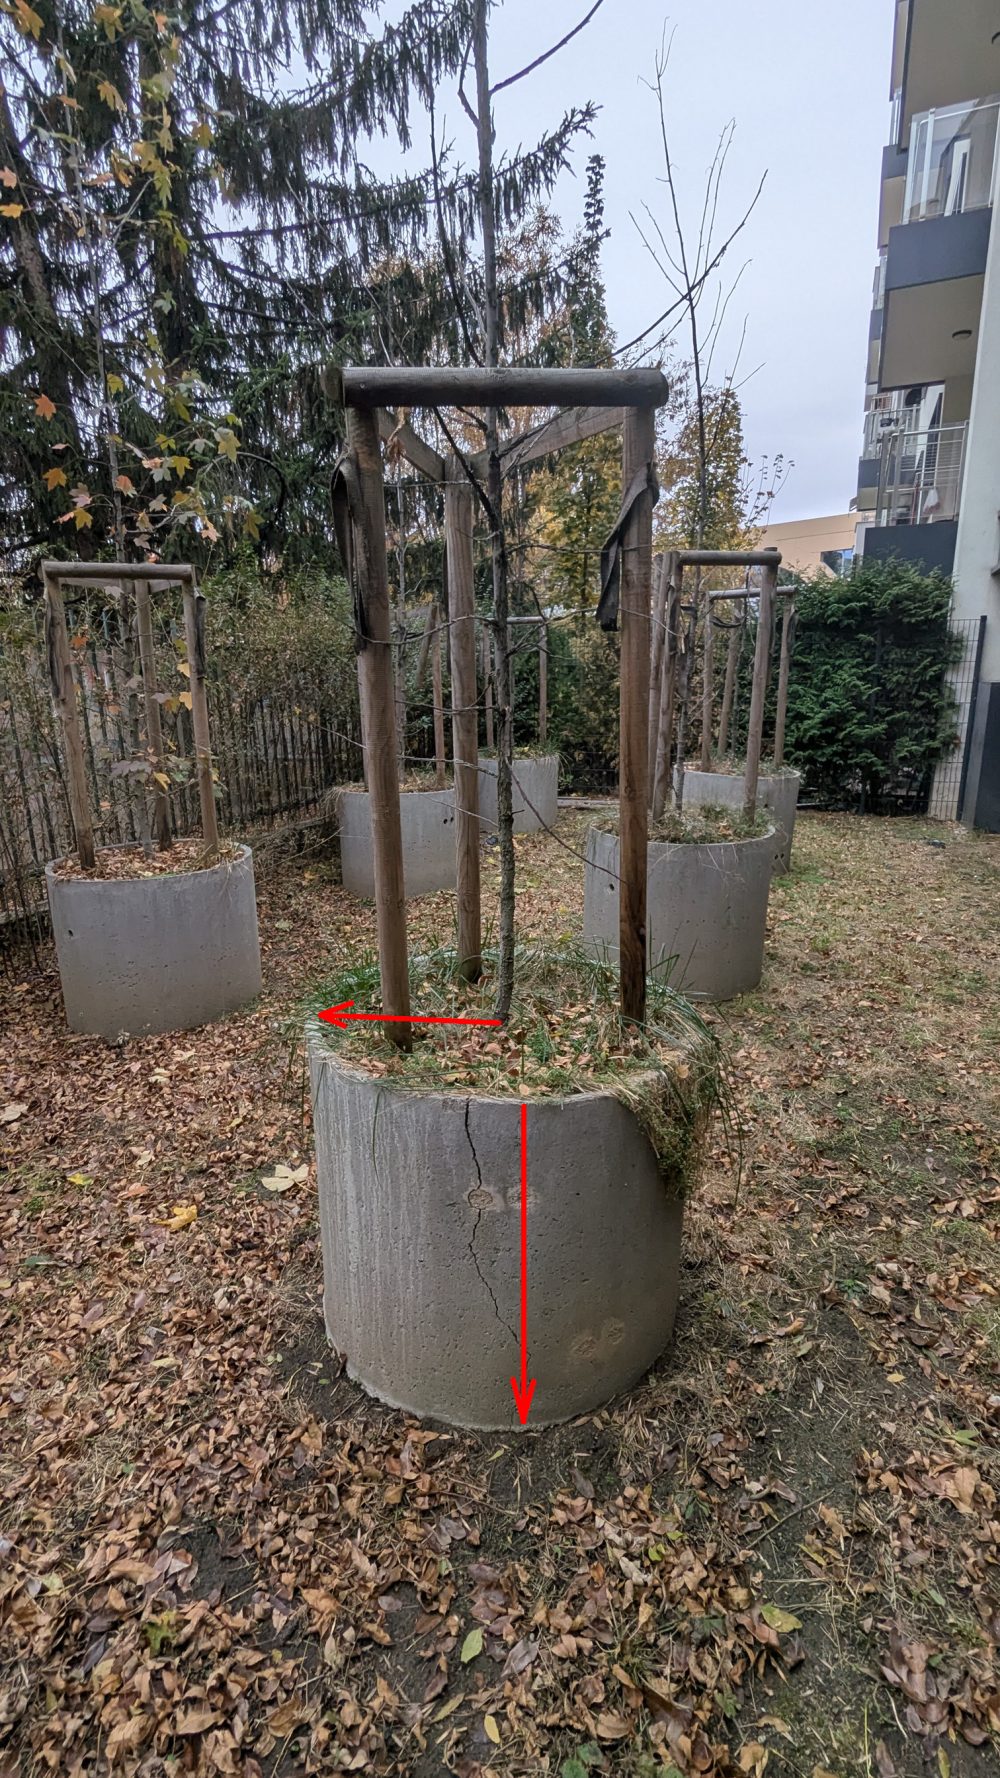
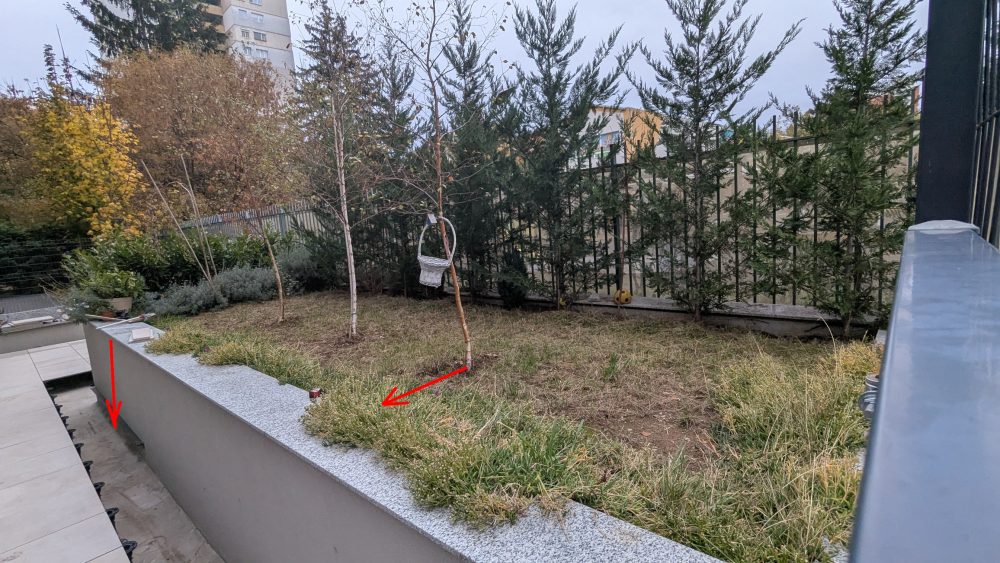
На втората снимка виждате другата страна на южната част където се вижда първото дърво. Както всички останали, които ще видите, то е в „кашпа“ представляваща бетонен елемент за тръба с диаметър и височина 80 см. За почти четири години дървото е с дебелина от два сантиметра. Причината е, че няма дори теоретична възможност да порасне. Изискванията за почвен слой са минимум 120 см., а при кашпа трябва да има поне един кубичен метър почва. Всяка от тези тръби побира най-много 0.4 кубични метра. С други думи нито тази, нито която и от другите подобни дървета не отговаря на нормативните изисквания нито сега, нито когато е била завършена сградата. До него се виждат още едно декоративно дърво, което е практически под стряхата и също не отговаря на изискванията.
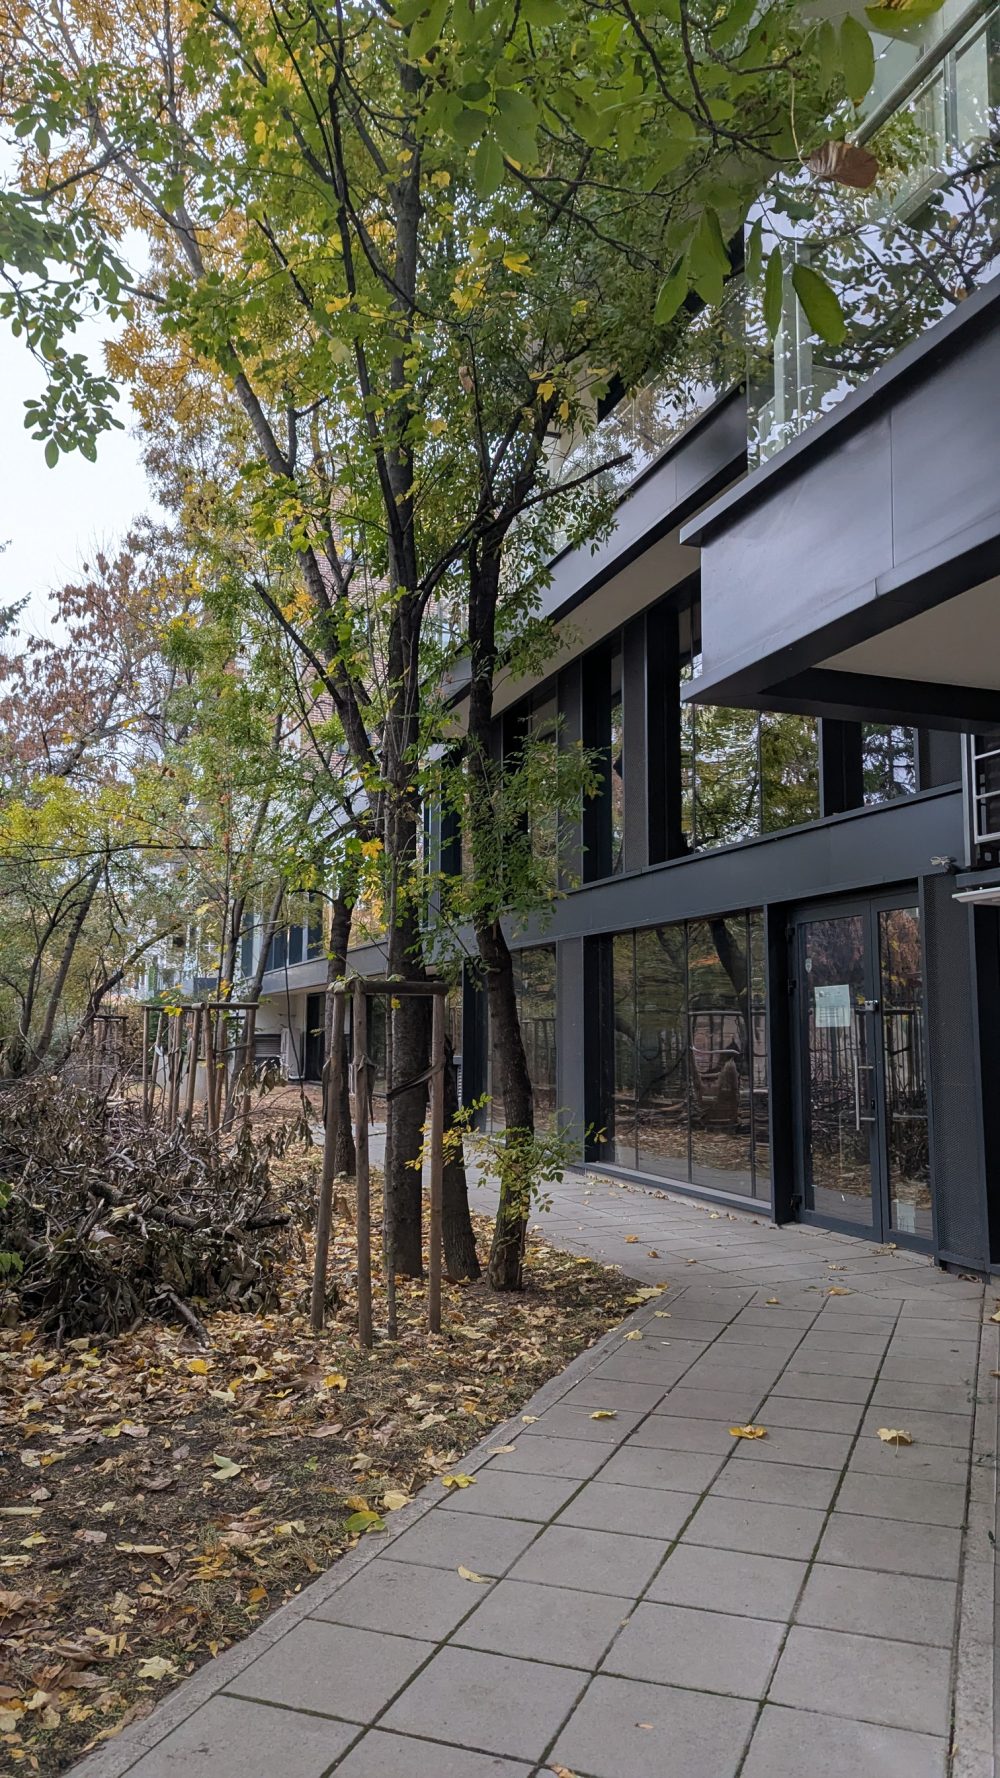
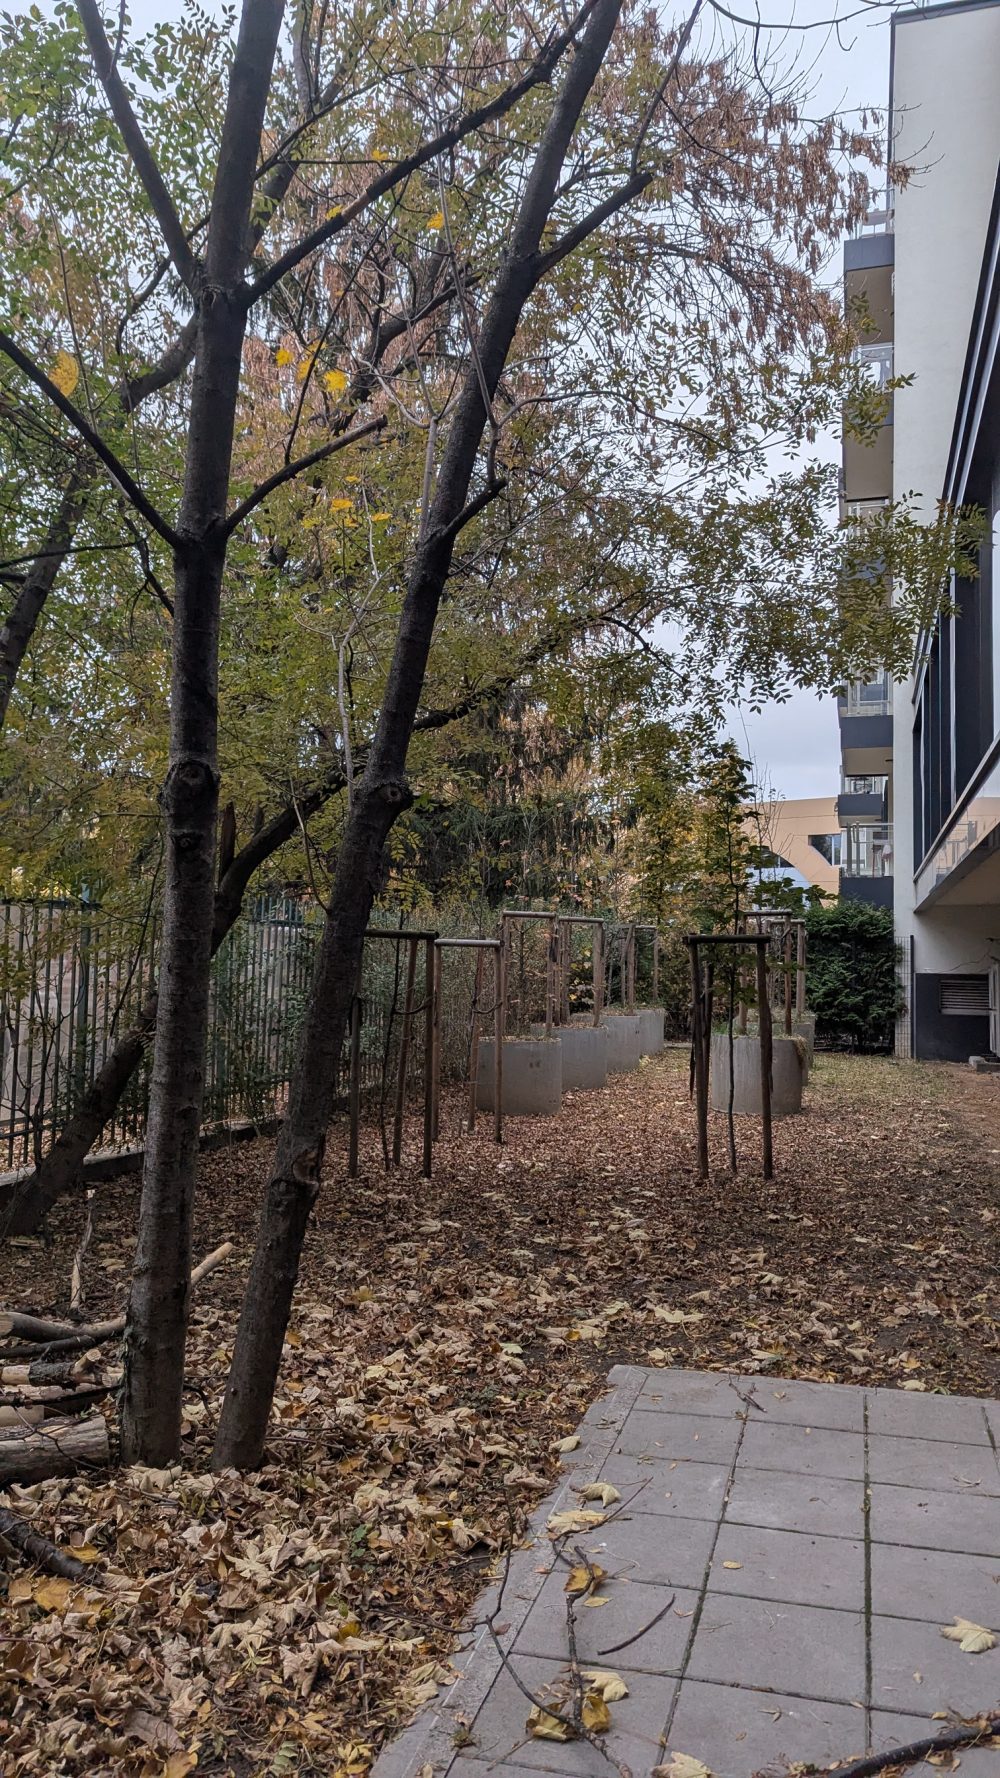
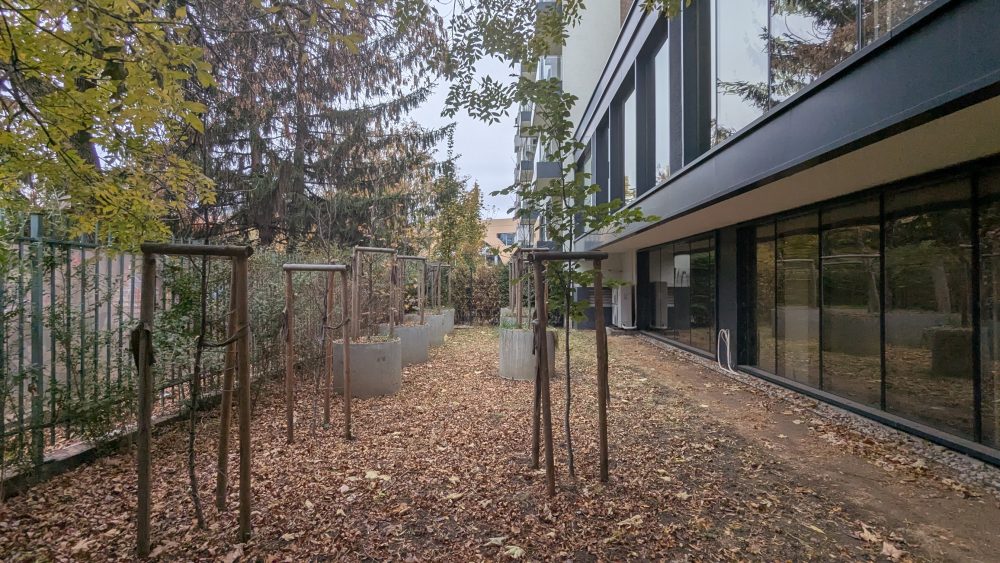
На третата снимка се вижда алеята между сградата и детската градина. Има няколко дървета останали от преди строежа. Преди строежа отсякоха много дървета в имота – най-вероятно без разрешение. Зад няколкото оцелели на снимки четири до седем се виждат седем дървета в кашпи подобни на предишната и още три дървета засадени в земята. Всички са останали тънки вейки след четири години в земята. Нито едно от седемте кашпи не отговаря на изискванията. В протокола на приемателната комисия твърдят, че някои от дърветата са с 140 см. почвен слой. Предвид видяното на място и схемите за подземните гаражи това не изглежда да е вярно.
-

Южната част от сградата. Повечето в лехите не е почва. -
Вижда се първата кашпа-тръба. Дървото е на четири години. -

Няколко от оцелелите от преди строежа дървета. -
Задният двор, няколко посадени дървета и кашпи. -
Вижда се ясно размерът на кашпите. -
Изглед от отстоянията до фасадата и колко са малки дървета на 4 г. -
Пръчка в бетонен пръстен. -
Градинка до входа. Вижда се къде е плочата на входа на гаражите. -
Същата градинка две седмици по-късно -
Зелена леха във вътрешния двор. Вижда се генератор и плочи за паркомясто. -
Вече бетонирани зелени лехи част от задължителното озеленяване. -
Вече бетонирани зелени лехи част от задължителното озеленяване. -
Вече бетонирани зелени лехи част от задължителното озеленяване. -
Оцеляло дърво под стреха -
Плитка зелена леха -
Още паркоместа с изчезнало озеленяване. -
Вертикално озеленяване с дървета на 4 г.
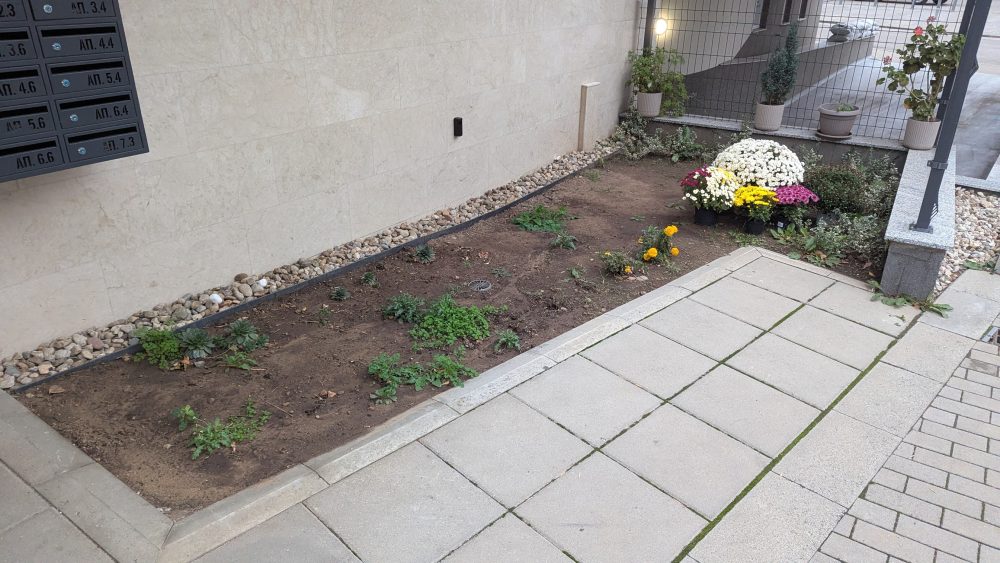
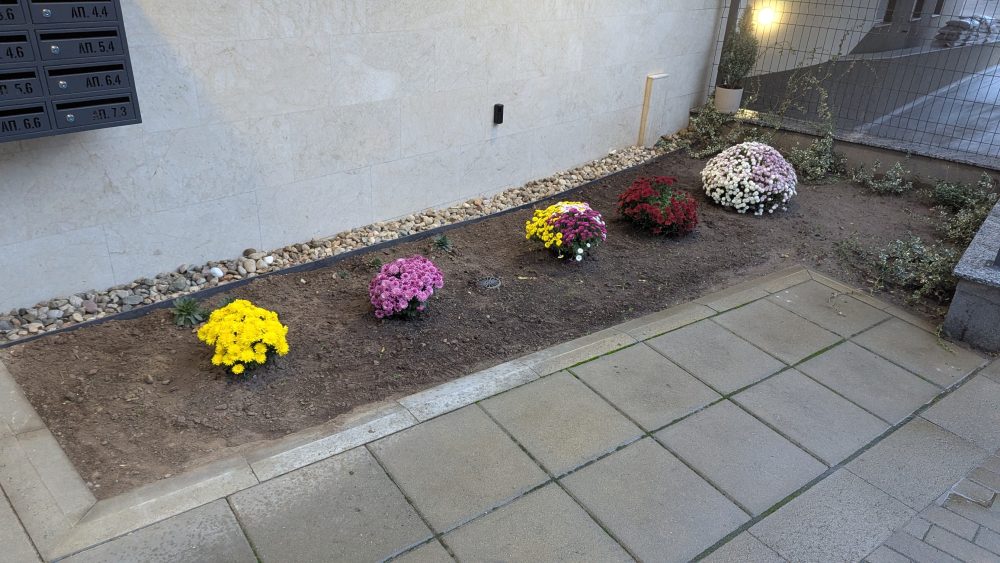
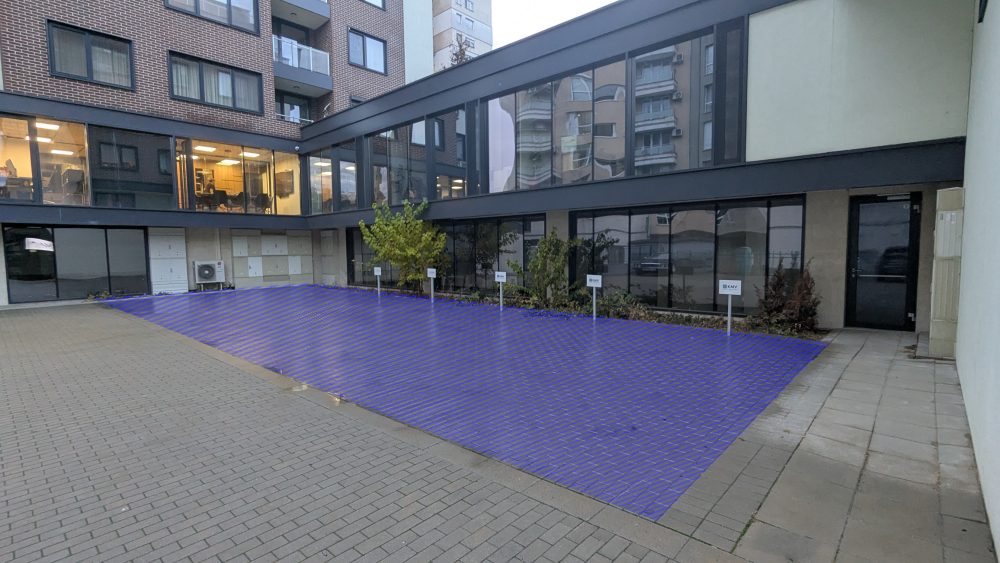
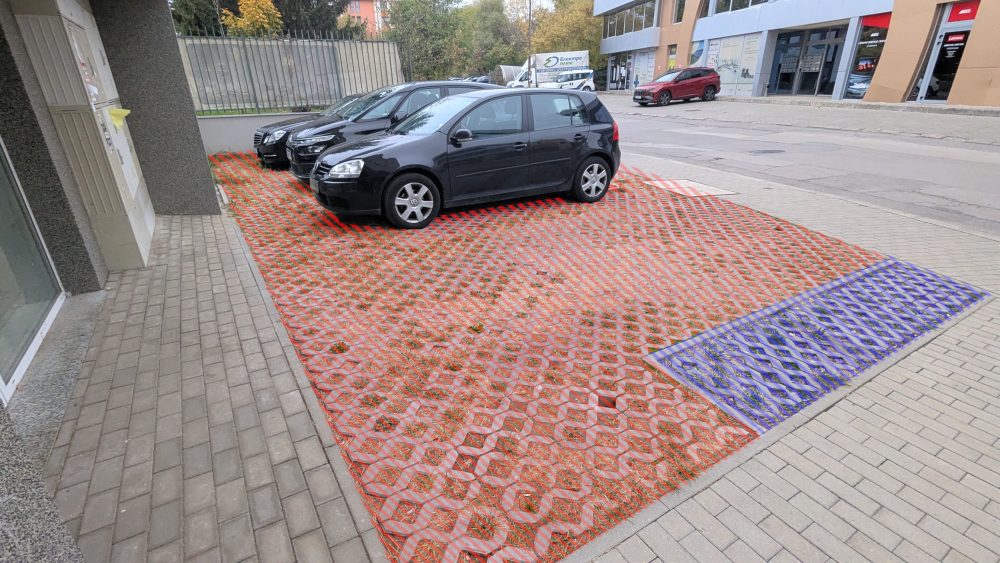
На осма снимка се вижда малка градинка, с която според протокола са заменили зелен хълм в плана за озеленяване. Тя е изцяло под навес на фасадата, няма дървета и храсти, но поне явно някой се занимава да я поддържа. Това личи и на девета снимка, която направих две седмици по-късно. Вижда се, че са засадили нови цветя и махнали други растения. Причината вероятно е, че лехата е крайно недостатъчна, за да оцелеят храсти и по-сериозна растителност.
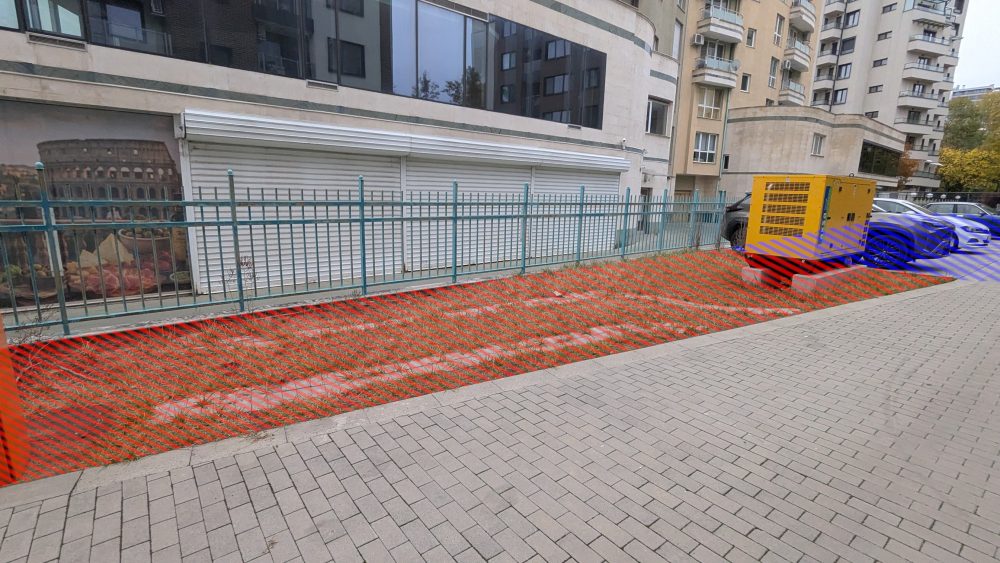
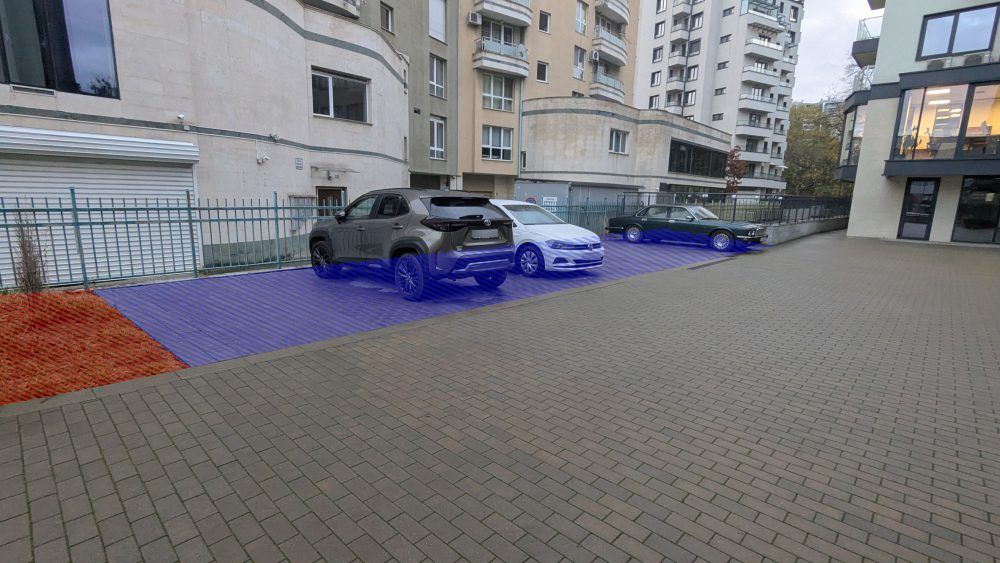
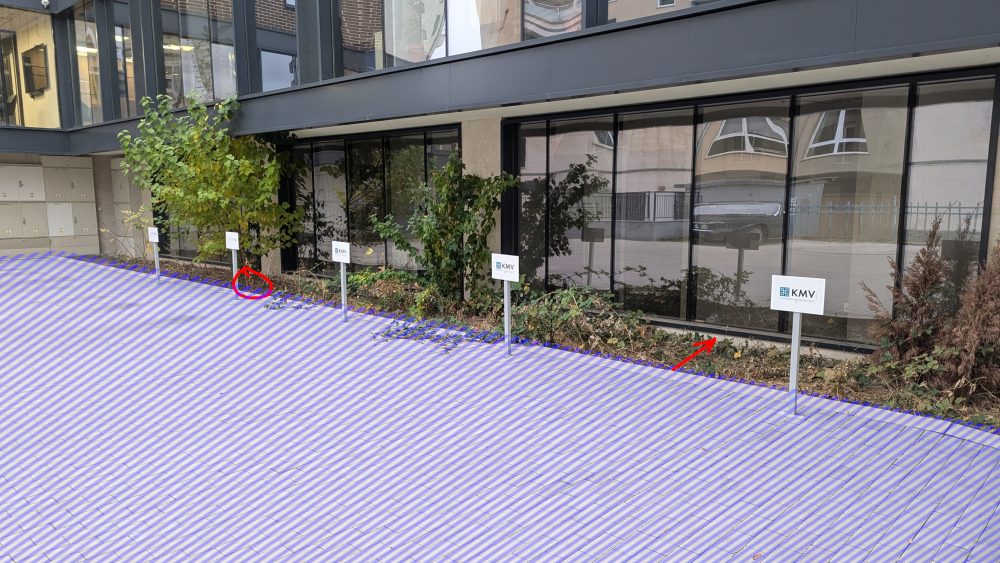
Не това може да се каже за вътрешния двор. На снимка десет се вижда зелена площ, която е почти изцяло покрита с плочи или техника. Почвеният слой е под 5 см., което значи, че не може да се зачита към индекса за задължителното озеленяване. В синьо на същата снимка виждате паркоместа зад нея, които според акт 16 е зелена площ на ивици с дървета. По-добре се вижда мястото на снимка единадесет. Същото важи за снимки 12 и 13 – в синьо може да си мислите, че виждате паркоместа върху паваж, но всъщност е зелена площ на ивици, отново с дървета засадени между тях.
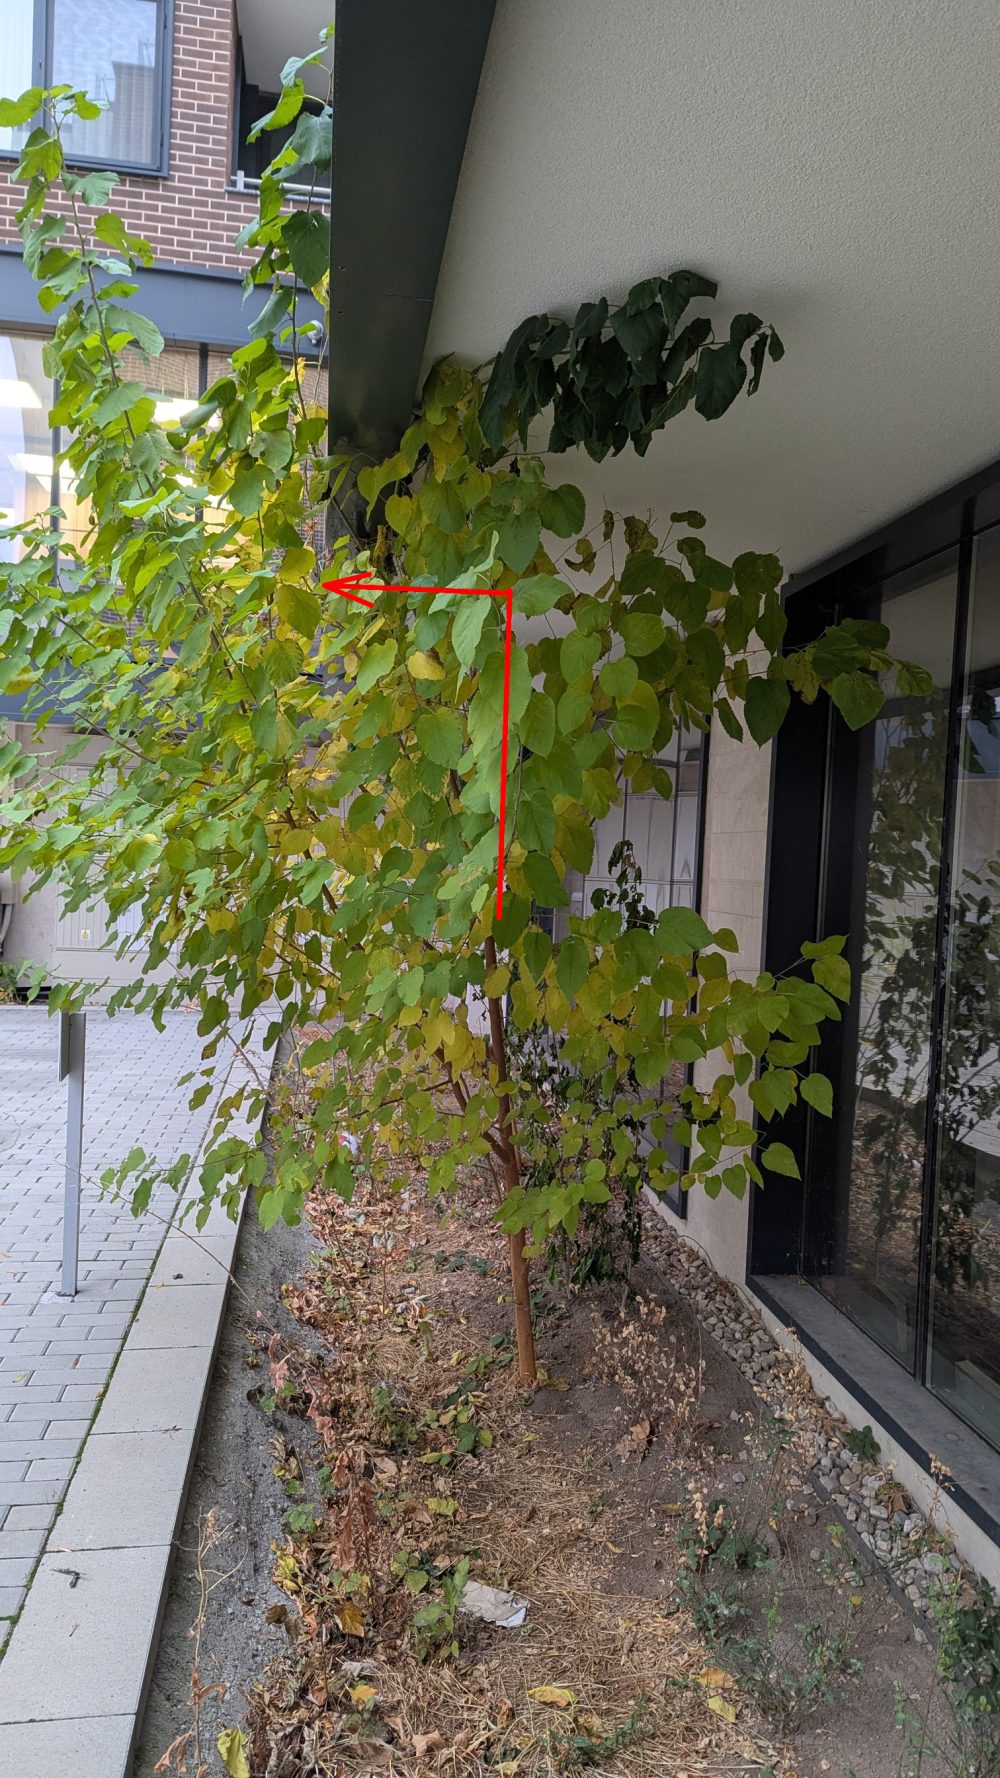
Зад паркоместата до фасадата виждаме малкото оцеляла зеленина. Виждаме я на снимка 14. Тя е изцяло под стреха и има 1-2 дървета, едно от които буквално удря в тавана. Изискването е да е на поне метър от навеса, но навън, не навътре. Виждаме, че и почва почти няма в лехата, което ни позволява да наблюдаваме чест проблем – половината всъщност е бетонирана. Когато се мерят подобни лехи по размерите до бордюра се пропуска, че буквално сантиметри надолу е бетон под ъгъл, за да държи на място въпросния бордюр. Така често в поне 30% от площта зелените площи не може да говорим за нужната дълбочина на почвения слой. Това обаче не е регламентирано в наредбата. Всъщност, дори регламентираните неща в нея не се спазват масово, което показвам с тази поредица.
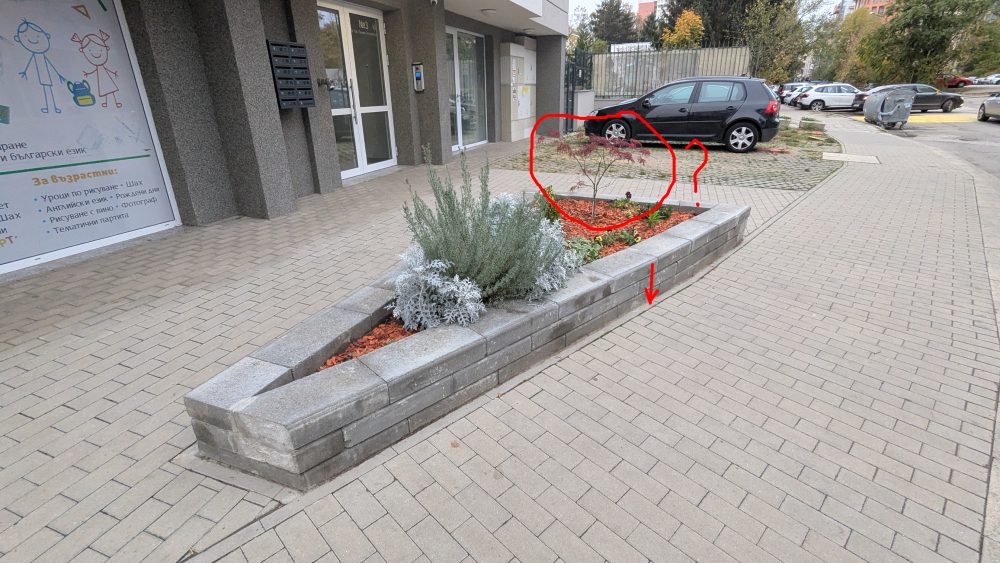
Снимка 15 показва малка леха от северната страна. Там са заболи един клен, който бере душа. Почвеният слой е колкото саксия на балкон. На 16-та снимка се виждат още паркоместа, които се водят за озеленяване. Всъщност, маркираното в синьо е било леха с предполагаемо дърво, но веднага е бетонирано, защото явно е пречело. На последната снимка 17 се вижда издигната леха, която се води за „вертикално озеленяване“ според проекта. Почвеният слой, отстоянията от бордюра и всичко не отговарят на изискванията. Затова и онова, което се води за дървета е изсъхнало.
Промени през времето
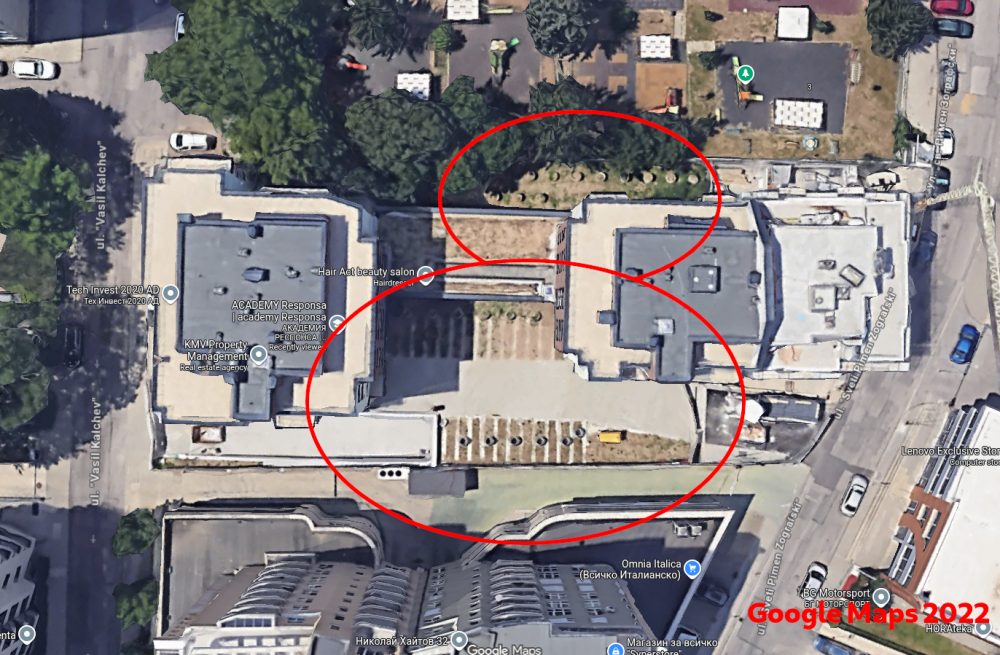
Както видяхме при Диамант 2 на Артекс, зелените площи стават паркоместа веднага след като мине приемателната комисия. На снимката долу виждате сателитна снимка от Google Maps на обсъжданата сграда докато още се строеше през 2022 г. Виждат се зелените площи на лехи където сега има бетон и паркоместа. Същите се виждат горе в снимките отбелязани в синьо. Виждат се храсти, но не и дървета. В горната част се виждат 12 „кашпи“ и предполагаемо дървета, а не 7 както сега. На този етап сградата се довършваше и подготвяше за проверка.
Следващата снимка е от последните сателитни данни на КАИС. МРРБ се похвалиха с тях първо твърдейки, че са от 2026, но след критиката ми се поправиха и стана ясно, че София е заснета през лятото на 2023 г. Това значи, че лехите са оцелели около шест месеца. Все още не се виждат дървета където сега има паркоместа и където акт 16 настоява, че са били някак открити.
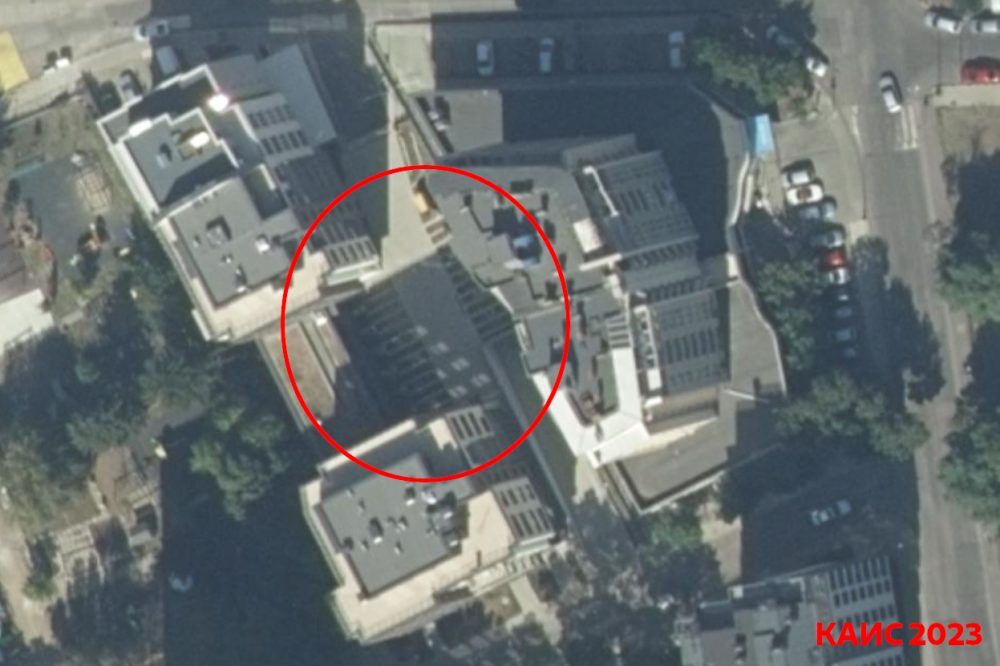
В iSofMap имаме снимки от 2024 и там вече се вижда, че лехите са бетонирани изцяло и имотът е вече в сегашното състояние.
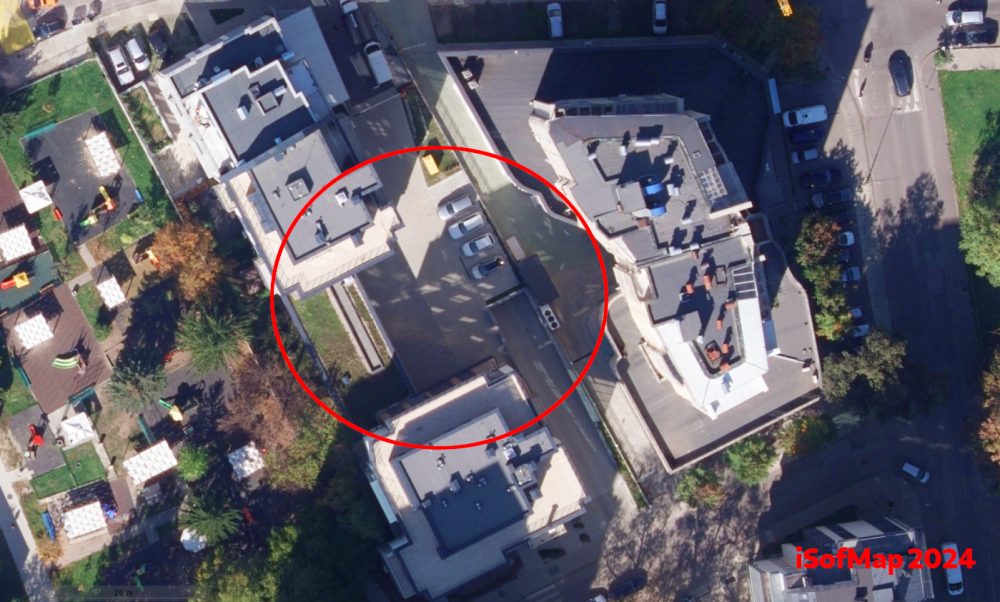
Сателитните снимки показват, че е имало промени в озеленяването между края на 2022 г. и 2024 г. Отделно снимките от лятото на 2023 г. и тези преди това показват, че никога не е имало дървета в лехите между или под паркоместата. Бетонната плоча над гаражите прави най-малкото невъзможно това.
Какво казва акт 16?
На 22 декември 2022 има заседание на приемателна комисия назначена със заповед на ДНСК три дни по-рано – РД-19-706/19.12.2022. Още на следващия ден – последен преди коледните празници – е извадено разрешение за ползване СТ-05-714/23.12.2022 за основната сграда. Това показва изключителна експедитивност за придвижване на документи и строеж видимо пълни с нарушения. Шест месеца по-късно има вече разрешение и за малката част – СТ-05-310/21.06.2023. Първото още не е достъпно сканирано, но второто ще намерите на страницата на ДНСК.
Получих протокола от приемателната комисия на голямата сградата след запитване по ЗДОИ до ДНСК (и споменаване на двете дела за идентичен документ, които спечелих). В него се забелязват няколко интересни факта. Първо, според декларираното в протокола зелените площи са изпълнени според всички изисквания, между паркоместата има бетонни пръстени и засети дървета. Твърди се че там почвения слой достига 140 см.
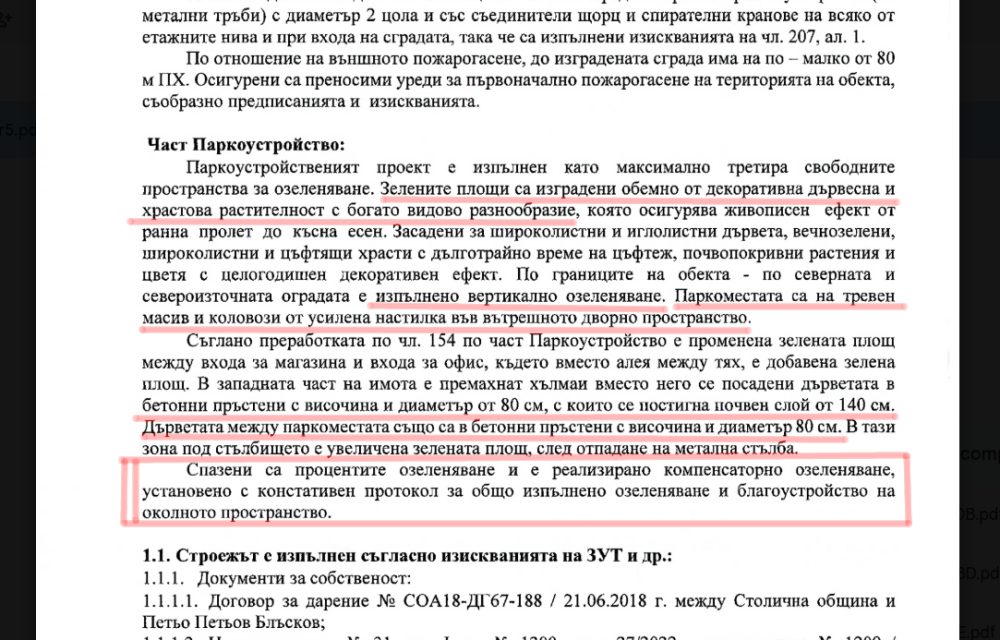
Изброеното е не само невярно, но и невъзможно. При паркоместата има бетонна плоча на сантиметри под тогавашните лехи и сегашните павета. Най-фрапантното е, че в протокола се описват въпросните бетонни пръстени с височина и диаметър 80 см. Изискването през 2022-ра също както сега е дърветата в кашпи да имат поне един кубичен метър почва. Така описани бетонните пръстени осигуряват 0.4 кубични метра. Дори да беше вярно това с дълбочината от 1.4 метра, това прави 0.7 кубика.
Това означава не само, че дърветата не могат да се развиват и ще умрат, но и че не може да се причисляват към изисканията за озеленяване според наредбата на Столична община. Доколкото в протокола са споменати промени спрямо планът за паркоустройство, от описаното и видяното на място става ясно, че изначално е било заложено бутафорно озеленяване с цел бетониране на паркоместата, липса на достатъчен почвен слой, никакъв шанс зеленината да оцелее или да е изпълнена заложената в изискванията цел.
Такова мнение може да си направим от думите на комисията и видяното на място. Противното може да се докаже единствено от архитектурните планове за конструкцията и паркоустройството. В протоколът е споменат архитектът отговорен за последното. По една странна и откровено лобистка дефиниция на закона за авторското право не мога да публикувам тези части от строителните книжа. Затова ще поискам да бъдат публикувани от арх. Василева или да даде разрешение да го сторя. Ако се окаже, че са изрядни и сградата е построена грешно, то значи протоколът лъже по различен начин и други хора следва да носят отговорност.
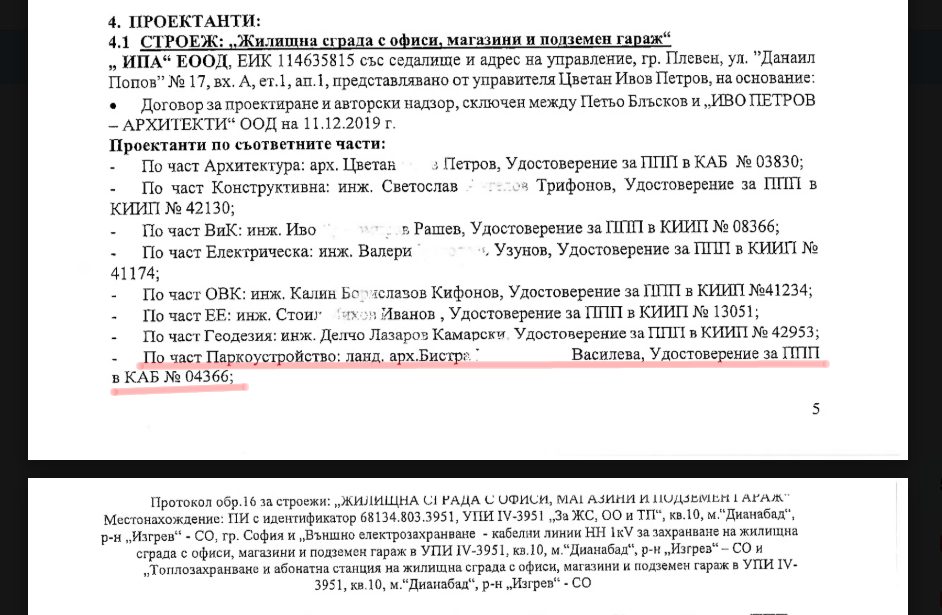
Независимо от това, вижда се ясно на място, както и от сателитни снимки малко и преди комисията, че дървета е нямало, почвеният слой не се различава от сегашния и не отговаря на изискванията. Дори от самия протокол разбираме, че кашпите не е следвало да се приемат. Конкретно за приемане на озеленяването отговаря районната община. В протокола пише, че от район Изгрев за това се е подписал арх. Горанов. Т.е. на база описаното сградата никога не е следвало да бъде пускана в експлоатация най-малкото заради озеленяването и този подпис неправомерно е позволил това.
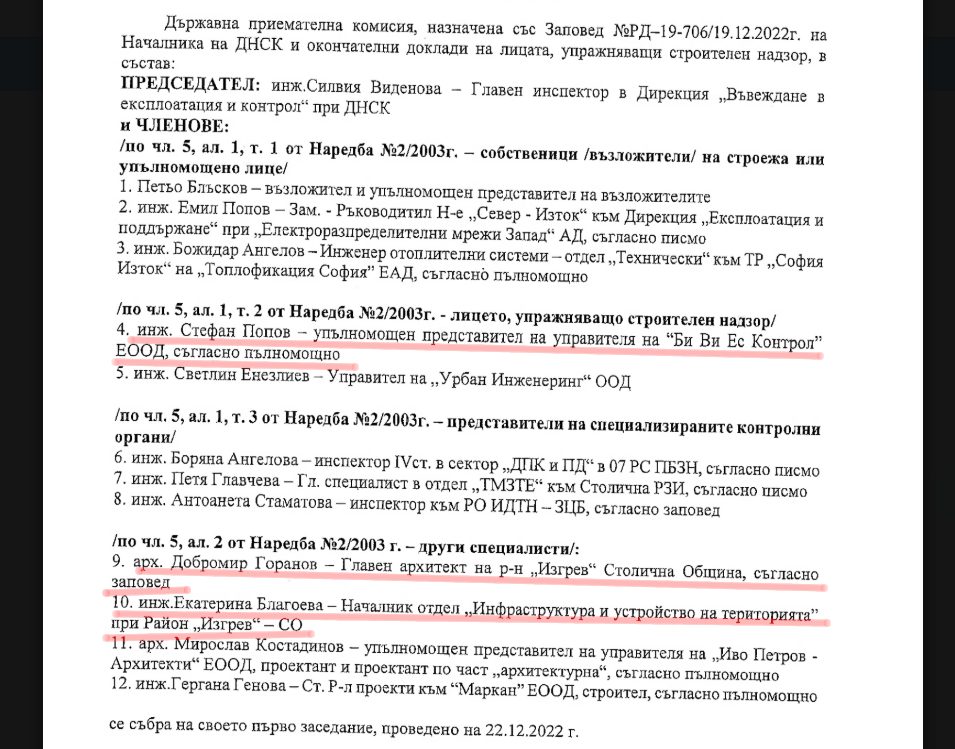
Този протокол се отнася до имот 68134.803.3951 и първото разрешение за ползване. Описват параметрите на застрояване. Според тях са постигнали поне 40% озеленяване. На място премерих не повече от 25% включвайки зеления покрив. Включвайки бетонираните паркоместа трудно би минало 35%. Тук следва да се вземе предвид, че повечето от тези зелени площи не следва въобще да се включат в сметката заради малкия почвен слой, липсата на отстояния и други несъответствия.
От същата страница научаваме, че само в голямата част от сградата са предвидили 53 паркоместа и още 138 за колелета. Доколкото е трудно да се прецени колко коли са побрали в подземните гаражи без да се влезе там, убеден съм, че няма място за дори 20 колелета. Според изискванията, трябва да имат поне 79.
Какво следва?
Разрешенията за ползване са съответно от декември 2022 и юни 2023. Това значи, че районната администрация е длъжна да проверява дали озеленяването отговаря на тогавашните изисквания до декември 2027 и юни 2028. При аналогични сигнали за сграда на Артекс районният кмет на Изгрев години наред настояваше, че не вижда нередности, после като откри такива отказа да провери цялата сграда, а като все пак получих плана за озеленяване и описах несъответствията, отсече, че то хубаво, ама тъкмо бил изтекъл срокът и вече не можело нищо да направи.
В този случай не очаквам нещо по-различно. Всъщност, още няма действия по сигналите ми за хотела на 4-ти км. където освен незаконния видео билборд се оказа, че поне половината задължително озеленяване липсва. Очаквам същите проблеми когато ДНСК разреши ползване на новата сграда на Артекс и тази на Тинтява 80 въпреки, че по аналогични на горния пример причини озеленяването никога не може да отговаря на изискванията с такава интензивност на застрояване и къде е излят бетонът. Може да прочетете повече защо е важно озеленяването и за тази серия от статии.
Това не значи, че няма да предам откритото като сигнал до районната община. Най-малкото, за да се документира отказът им и/или липсата на действие. Истината тук е, че процесът на контрол е счупен, а изискванията са крайно недостатъчни и меко дефинирани. Знам, че според някои архитекти и всички инвеститори са дори прекомерни, но в действителност не са достатъчни, за да осигурят заложените в тях целите. Отделно дори това, което е ясно разписано не се спазва, отчасти заради оставените вратички.
Затова следва да се разширят значително като параметри – почвен слой, отстояния и да се прецизират като изисквания. Следва да се промени ЗУТ и да се махне ограничението от 5 години за последващи проверки и промяната да важи за вече построени сгради независимо кога са били завършени. С последното няма да се нарушава правата на собствениците, тъй като никъде в закона няма презумпция, че след 5 години (или както е по-често – 5 дни) могат да разкарат всички кашпи и да бетонират всички лехи. Срокът ограничава възможността за контрол, а не дава имплицитно разрешение за неразрешени по архитектурен план промени.
Още по-важно е да се документират всички дървета в градската среда и приоритетно в тези регистри да влизат дърветата установени при приемане на строежи, компенсиращото залесяване и съществуващите дървета в частни имоти. Следва да се облекчи и автоматизира режимът на подаване на сигнали и налагане на глоби на база свидетелски показания с цел намаление на административната тежест и покриване на хилядите строежи никнещи всяка година. Трябва да започне да се прилага европейският регламент диктуващ, че дърветата и зелените площи в градска среда не може да намаляват. Това трябва да стане чрез отказ от премахване на дървета за нови строежи и значително увеличаване на изискванията за компенсиращо залесяване в рамките на самия имот.
Не на последно място, трябва да въведем принципа на виртуалното дърво – ако някой отсече неправомерно или умъртви дърво, това трябва да се документира и точното местоположение да се отбележи запазено за бъдещо такова в следващите поне 15 години. Често извършителят остава неизвестен въпреки хилещите се наблизо ръководители на бъдещия строеж. Местната администрация даже не се занимава да документира или глобява. За тази цел не трябва да има значение чия е земята и кой е извършителят – имало ли е дърво, мястото трябва да остане незастроено и в поне радиус от 4 метра около или под него не следва да има бетон, фасади или други конструкции. Мястото да бъде определено за залесяване от общината и да се посади същият или аналогичен вид дърво. Промени на тези обстоятелства да стават единствено с решение на общинския съвет.
Често обаче дърветата не са в регистър и се изсичат през почивните дни, премахват се пъновете и се маха всякаква следа. При липса на преки доказателства или документация, трябва да се приемат сведения от трима живущи в района като достатъчно доказателство. Т.е. да може трима съседи да се подпишат носейки отговорност за думите си, че на това място до скоро е имало дърво. Тогава да се определя това място като „виртуално дърво“ с цел защита срещу бъдещо бетониране, за да се засади ново и да получи шанс да порасне до размерите на отсеченото. Щом трима свидетели са достатъчни за възстановяване на земя чрез реституция заради спомени, че някой я е бил орал преди десетилетия, то същият принцип не пречи да се приложи за едно дърво и събития случили се преди дни.
Това е единственият шанс да се вдигне реалната цена на незаконно унищожено дърво. Глобите са недостатъчни и не се налагат. Когато премахнато дърво поставя под риск цял инвестиционен проект, може би ще започне да се мисли повече за зеленината в градската среда също от страна на строителите. Разбира се, очаквам веднага да креснат с аргументи за цената на жилищата, които отдавна бяха оборени.
Тази и предишните мерки следва да се приложат не само в София, но и за цялата страна. Аналогични проблеми има във всички градове и всеки от нас може да даде примери. Тези, с които илюстрирам казуса в тази поредица, срещам всеки ден пътувайки из града. Някои са само на хвърлей камък един от друг и демонстрират фрапантни нарушения сам по себе си.
А за тази конкретно сграда ще видим. Никой няма надежда, че в следващите 12 до 18 месеца местната администрация ще започне да взима мерки дори в рамките на сегашните си правомощия. Доколкото отчасти е несъмнено въпрос на липсващ административен капацитет и скъпа съдебна процедура, в случая е въпрос на липса на желание от страна на районната администрация отговорна за всички сгради описани до тук. Документите показват, че може да става въпрос и за съучастие. Скоро ще разкажа за протоколите за сградата на Артекс и хотелът на Тиков и ще се разбере дали същото ще изскочи и там.
AMD Launches EPYC Embedded 9006: Venice Gets an Early Start in Embedded
Post Syndicated from Ryan Smith original https://www.servethehome.com/amd-launches-epyc-embedded-9006-venice-gets-an-early-start-in-embedded/
With its new Zen 6 “Venice” silicon in hand, AMD has launched its next-generation EPYC Embedded 9006 platform for the embedded market, aiming to bring the performance benefits of the new platform to the long term stability-focused market segment
The post AMD Launches EPYC Embedded 9006: Venice Gets an Early Start in Embedded appeared first on ServeTheHome.
Sean Duffy: Last Week Tonight with John Oliver (HBO)
Post Syndicated from LastWeekTonight original https://www.youtube.com/watch?v=GC0dAsRl0ao
Confessions of a Bad Texter
Post Syndicated from The Atlantic original https://www.youtube.com/shorts/x85osj0pteM
Upcoming Speaking Engagements
Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/11/upcoming-speaking-engagements-62.html
This is a current list of where and when I am scheduled to speak:
- I’m speaking at the Catalyst Summit in Brampton, Ontario, Canada, on Wednesday, November 18, 2026.
- I’m speaking at QT Qonference 2026 in Toronto, Ontario, Canada, on Thursday, November 19, 2026.
The list is maintained on this page.
Why Inflation Is Crushing Young Homebuyers | The David Frum Show
Post Syndicated from The Atlantic original https://www.youtube.com/watch?v=7qL7qAVMoAU
In 2026 I swapped my TV for a UST projector – I had reasons
Post Syndicated from Techmoan original https://www.youtube.com/watch?v=kHB6bxxEZW8
Седмицата (9–14 ноември)
Post Syndicated from Светла Енчева original https://www.toest.bg/sedmitsata-9-14-noemvri/
Ако четете този бюлетин, светът не е свършил на вчерашния 13 ноември, петък, както са предвидили учени през 1960 г. На 10 ноември, точно 37 години след падането на тоталитарния режим обаче, светът свърши за 12 души, пътуващи по магистрала „Тракия“ в посока Бургас.
И нека не се оставяме да ни приспят с оправданието, че мъглата е виновна. Това не е мъглата от разказа на Борис Виан, а най-нормална есенна мъгла, за каквато пътищата в България би трябвало да са подготвени. Тя може да доведе до фатални последици само в комбинация с други фактори – некачествена пътна настилка, шофьори, които карат като на рали, липса на светлинни табели, липса на адекватен контрол…
Но трагедията показа също, че в България гражданското общество може да бъде активно. Поне в някои случаи. На призивите за кръводаряване се отзоваха стотици. Не забелязах обаче редом с призивите да се разпространява и информация кои хора може и кои не трябва да даряват кръв. Затова съставих неизчерпателен списък в кои случаи кръводаряването поставя в риск вас или хората, които се нуждаят от кръвопреливане. Не трябва да дарявате кръв, ако:
- сте под 18 или над 65 години;
- тежите под 50 кг;
- хемоглобинът ви е нисък;
- кръвното ви налягане е ниско;
- имате 5 диоптъра или повече късогледство;
- страдате от определени заболявания (инфекциозни, сърдечни, белодробни);
- пили сте лекарства преди по-малко от 48 часа;
- ваксинирани сте наскоро (срокът зависи от ваксината);
- претърпели сте операция или сте си направили татуировка или пиърсинг преди по-малко от половин година;
- били сте скоро на зъболекар (срокът зависи от процедурата – за почистване на зъбен камък е 24 часа, но ваденето на зъб си е операция).
На фона на вълната от обществена солидарност обаче се намери кой да посочи външен враг за трагедията. Понеже по същото време председателката на Европейската комисия Урсула фон дер Лайен беше в България, Костадин Костадинов рече: „Урсула донесе смърт на България.“ Че кой да ни е виновен, ако не ЕС?
Лов на европейски вещици изглежда да е и налагането на космически висока глоба на Kaufland, съчетано със затварянето за няколко часа на магазин на Lidl във Видин – заради развален фризер, който по същото време е бил поправян. Тази тема беше толкова важна за Емилия Милчева, че тя предложи статия за нея още в сряда, а не в петък, както обикновено. Емилия прави паралел между похода на българските институции срещу търговските вериги (ама немските, не балканските) и аналогични репресивни санкции в Унгария по времето на Орбан. В това отношение България следва утвърден модел. Но както наложените от режима на Орбан глоби са довели не до плащането им, а до съдебни дела и влошен бизнес климат, така ще стане и тук.
По бухалките ще ги познаете. Как Радев копира санкциите на Орбан
Когато цените растат, най-лесно е да обвиниш магазините. В Унгария Виктор Орбан превърна тази рецепта в държавна политика, а сега правителството на Румен Радев, изглежда, посяга към същата „готварска книга“. Емилия Милчева сравнява мерките, глобите и съдебните им последици.
Ала докато България върви по пътя на Орбан, самата Унгария се движи в обратната посока. След победата на Петер Мадяр тя все повече се връща към европейската си идентичност. Знак за това е решимостта на правителството на Унгария да ратифицира Истанбулската конвенция. По нашите ширини няма шанс в скоро време Конвенцията да престане да се възприема като плашило и да се използва за подхранване на хомофобията и трансфобията.
Не са големи надеждите и парламентът скоро да отмени забраната на т.нар. ЛГБТ пропаганда в училище. Въпреки че – както показва скорошно национално изследване на ЛГБТИ+ учениците в България, резултатите от което споделих – в резултат на закона тези младежи са изложени на все по-голям тормоз и срещат все по-малко подкрепа, а психичното им здраве се влошава. 58,5% от респондентите обмислят или дори планират самоубийство. Това би трябвало да е червена лампа за институциите, но уви.
ЛГБТИ+ учениците и вредата от забраната на несъществуващи неща
Законът срещу несъществуващата „ЛГБТ пропаганда“ има съвсем реални последици. Ново изследване показва все по-враждебна училищна среда, задълбочаваща се изолация и тревожен ръст на суицидните мисли сред ЛГБТИ+ младежите. Светла Енчева анализира цената на политическата омраза.
Изобщо, списъкът от измислени врагове расте. Наред с ЛГБТИ+ хората и търговските вериги в него вече се нареждат и чуждите езици, особено английският. Според „Възраждане“ българският език трябва да бъде защитен от тях и затова партията предлага специален закон. Но според Павлина Върбанова жанрът на внесения от „Възраждане“ документ е по-скоро декларация. В статията си „Език свещен, почти узаконен“ тя показва не само защо предлаганият закон е неприложим, а и защо е написан неграмотно. Ако се питате колко грешки е открила в законопроекта и приложенията към него – отговорът е 57. Излиза, че хората, които искат да защитят българския език, не могат да го използват правилно. Каква ирония, а?
Език свещен, почти узаконен
Павлина Върбанова разглежда законопроекта за българския език, внесен от „Възраждане“, и обяснява защо той е не само неясен и неприложим, но и пълен с езикови грешки. Зад декларираната грижа за езика прозира неразбиране на неговата същност и опит за налагане на ограничения.
Избраният за вицепрезидент Кирил Вълчев, все още председател на БТА, също брани българския език, конкретно кирилицата. На фона на политическия му възход Дарина Сарелска разсъждава по темата нужна ли е на обществото БТА, каквато е в момента? Реформирана отвън, но останала по дух в 80-те години на миналия век. Уж медия, а всъщност ретранслатор на официални позиции. И безсрамна демонстрация на това, че в България връзката между (определени) медии и власт често е причинно-следствена. А журналистическата етика отива на кино.
Светият синод на БТА
Кой има нужда от един зле реформиран псевдомедиен мастодонт от времето на соца, се пита Дарина Сарелска. За БТА говорим, да не се обърка някой, че то едно ли е…
Отиването на кино в буквалния смисъл обаче може и да е хубаво нещо. Ето, тази седмица започна „Киномания“, която се провежда от 40 години. Кой може да ни я представи по-добре от Нева Мичева? В тазгодишното издание е включен късометражният филм на Мисирков и Богданов „Киномания: началото“, който, както става ясно от заглавието му, е посветен на възникването на фестивала. От статията на Нева научих, че в програмата е и един от любимите ми филми – „Един особен ден“ на Еторе Скола, със София Лорен и Марчело Мастрояни. Ако не сте го гледали, препоръчвам ви го от сърце.
„Киномания“ – глътката свеж въздух, която трае 40 години
На 12 ноември фестивалът „Киномания“ се завръща за 40-ти път в София, Пловдив, Варна, Бургас и Стара Загора с изчерпателна подборка от най-новите филми, за които говори светът, но и със събития, честващи важни моменти от историята на десетата муза. Нева Мичева набелязва някои от най-интересните.
И понеже вече стигнах до препоръките, за ваша изненада, този път няма да ви препоръчам да ни подкрепите. Вместо това предпочитам да ви призова да се включите в дарителската кампания на Манол Пейков за подпомагане на жертвите от катастрофата на магистрала „Тракия“ и техните семейства. Може да се включите по следните начини:
- По сметка: Фондация „Манол Пейков и приятели“, IBAN: BG09DEMI92405000310141, „Търговска банка Д“ АД
- В PayPal: [email protected]
Основание за плащане: За пострадалите от катастрофата на магистрала „Тракия“ и техните семейства.
Разбира се, ако много искате да подкрепите „Тоест“ с месечно дарение, няма да ви се разсърдим и няма да ви спрем.
The Rise of IRL Influencers
Post Syndicated from The Atlantic original https://www.youtube.com/shorts/gMa_aYWzryo
I Did the Math on the Starlink Mini 2’s Battery Life (It’s Not What They’re Saying)
Post Syndicated from Crosstalk Solutions original https://www.youtube.com/shorts/x01nfl3I8uc
Friday Squid Blogging: Pacific Flying Squid Populations Dropping in Korean Waters
Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/11/friday-squid-blogging-pacific-flying-squid-populations-dropping-in-korean-waters.html
Climate change is the issue.
As usual, you can also use this squid post to talk about the security stories in the news that I haven’t covered.
Understanding span queries in Amazon OpenSearch Service
Post Syndicated from Jon Handler original https://aws.amazon.com/blogs/big-data/understanding-span-queries-in-amazon-opensearch-service/
Amazon OpenSearch Service is a fully managed service for deploying, scaling, and operating OpenSearch in the AWS Cloud. OpenSearch is an open source software suite for search, analytics, and observability, licensed under the Apache License V2.0. Among the OpenSearch query types, span queries give you precise control over where terms appear in a document and how they relate to one another. Most applications get good results from match and phrase queries, but certain workloads require exact term placement that simpler queries cannot express. These include legal search, regulatory compliance, scientific and patent search, and contract analysis. Span queries fill that gap.
In this post, you will learn how span queries work, when to use them instead of phrase queries, and how to compose them to express precise structural constraints on your text.
When phrase queries fall short
The phrase query matches a contiguous sequence of terms in order. The match_phrase query accepts a slop parameter that loosens this constraint by allowing some number of position swaps between terms. A user searching for “star wars iv” expects to find the movie “Star Wars: Episode IV — A New Hope.” However, the exact phrase doesn’t appear in the title because of the intervening word “Episode.” Setting slop to 1 allows OpenSearch to swap one term position and find the match.
To explore this, create an index with a single text field:
Index two documents:
A match_phrase query for “star wars iv” with slop: 1 matches the first document. Change the query to “star wars hope” with slop: 4, and the query matches both documents:
The match against “Hope for Star Wars: The Prequel Series” is unexpected. The order of terms in that document is different from the query. Phrase slop performs an edit-distance match, swapping terms within the edit window regardless of order. When you need to enforce term order, position within a field, or structural relationships between terms, phrase queries lack the expressiveness.
What span queries provide
Span queries are compound queries that give you precise control over the position of terms relative to one another. Span queries only contain other span queries. You can’t mix them with non-span queries inside the same compound expression. OpenSearch supports several span query types:
- span_term: Matches a single term. This is typically the leaf of a compound span query.
- span_multi: Wraps a multi-term query (prefix, regex, wildcard) so it can be used inside a span query.
- span_first: Matches spans at the start of a field, within a specified number of positions.
- span_near: Matches a set of span clauses within a specified
slop, similar tomatch_phrasebut operating on spans. - span_not: Excludes specific terms from a span match.
- span_or: Unions multiple span clauses.
- span_field_masking: Uses a
span_termfrom another field, masked to appear as the primary field. - span_containing: Matches spans that contain other spans.
- span_within: Matches spans that are contained within other spans.
span_withinis the mirror ofspan_containing.
All span queries accept an in_order parameter that controls whether sub-spans must appear in the order of the query clauses.
Anchoring a term to a position
To find “A New Hope” in the index, you can require “star” at the beginning of the title and “hope” within 12 terms after it:
This query matches only “Star Wars: Episode IV — A New Hope.” The span_first clause requires “star” within the first two positions of the title. The enclosing span_near then requires “hope” within 12 positions, in the specified order. The second document doesn’t match because “star” isn’t at the start of the title.
Spans within spans
With span_containing and span_within, you can express structural constraints by matching one span inside another. Both take a big and a little clause: the little span must be contained by the big span. The difference is which span the query returns. span_containing returns the big matches, and span_within returns the little matches.
For example, to find documents where the phrase “episode iv” appears within a span containing both “star” and “hope”:
The little clause matches “episode iv” as an exact phrase (slop is 0, in_order is true). The big clause matches a span containing “star” and “hope” within 12 terms of one another, in either order. The span_containing query then requires the little phrase to fall within a big match. Only “Star Wars: Episode IV — A New Hope” satisfies both constraints.
When to use span queries
Span queries are useful any time you need to express constraints that phrase queries cannot. In legal and regulatory search, statutes and contracts often require specific phrases to appear in proximity. One example is finding documents where “force majeure” appears within five terms of “termination.” Span queries give you the precise control to express that requirement.
In patent and scientific search, claims and papers frequently require terms to appear in specific structural positions relative to one another. Compliance and audit workflows that must enforce exact term placement to satisfy regulatory definitions benefit from the same precision. More generally, when your text doesn’t have an explicit structured model but you need to express constraints about where terms appear within a field, span queries provide a query-time alternative to reshaping your data.
Conclusion
Span queries trade simplicity for precision. Span queries are more verbose than phrase queries and require careful composition. In return, you can use them to express constraints that phrase queries can’t: exact ordering, position within a field, and containment relationships. For applications where term placement carries meaning, span queries are the right tool.
For more information, see the OpenSearch span query documentation and the Amazon OpenSearch Service documentation.
About the author
Optimizing PySpark UDFs on AWS Glue 6.0 with native Arrow UDFs
Post Syndicated from Iván Fernández Perea original https://aws.amazon.com/blogs/big-data/optimizing-pyspark-udfs-on-aws-glue-6-0-with-native-arrow-udfs/
The AWS Prescriptive Guidance topic Optimize user-defined functions explains that Python UDFs in PySpark can degrade performance because data must be serialized between the Java Virtual Machine (JVM) and the Python runtime. It recommends, in order of preference: use built-in Spark SQL functions, implement UDFs in Scala or Java, or use Apache Arrow-based UDFs (also known as vectorized or pandas UDFs) for vectorized workloads.
That guidance is based on a concise example: the operation a + b over 10 million rows, comparing a standard Python UDF, a vectorized UDF, and Spark SQL. In this post we extend that example to answer a few practical questions we hear from customers:
- Does the ranking hold as data volume grows, from 10 million to 100 million rows?
- Does it hold for a more compute-intensive operation, not only
a + b? - AWS Glue 6.0 (Apache Spark 4.1.1) adds two newer Arrow-based options: the Arrow-optimized Python UDF (
useArrow=True) and the native Arrow UDF (arrow_udf, from Apache Spark 4.1.0). Where do they fit relative to a vectorized (pandas) UDF? - Can we attribute the difference to the data transport, the computation, or both?
We ran each variant as an AWS Glue 6.0 job and share the results, the methodology, and a controlled experiment that clarifies why the vectorized UDF performs the way it does.
Solution overview
We ran a parameterized benchmark harness as an AWS Glue 6.0 job. The job generates a Parquet dataset once, writes it to Amazon Simple Storage Service (Amazon S3), and then runs each UDF variant against the same files, so that every approach reads identical data. We measured across three data volumes (10M, 50M, and 100M rows, where M = million) and three workloads of increasing per-row cost.
The following image shows the workflow of the benchmark.
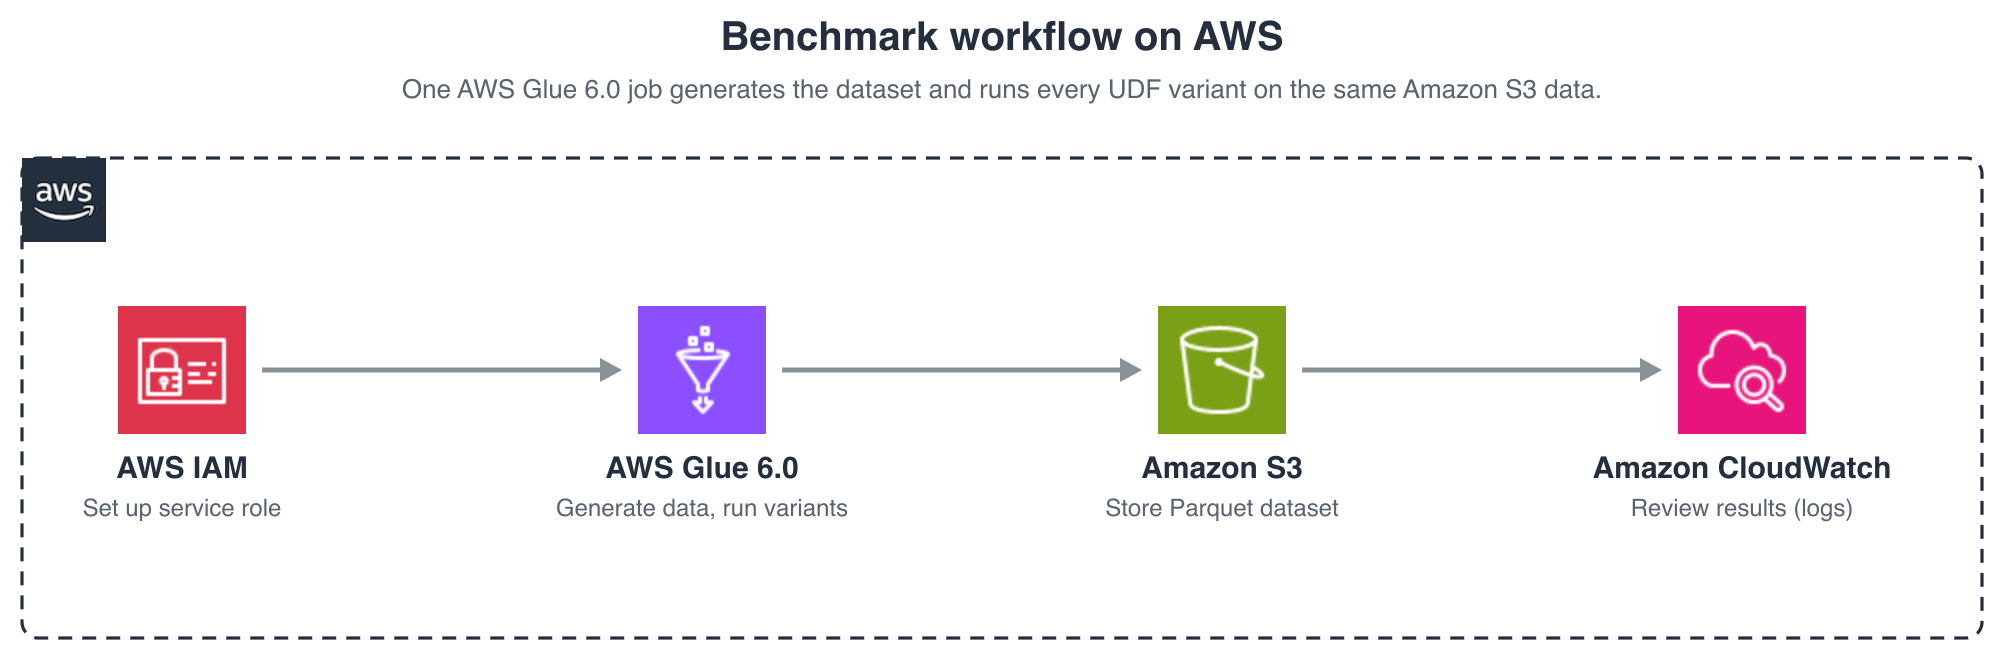
Figure 1: Benchmark workflow running each UDF variant as an AWS Glue 6.0 job
The high-level steps are:
- Set up the prerequisite AWS Identity and Access Management (IAM) role and Amazon Simple Storage Service (Amazon S3) bucket.
- Deploy and run the AWS Glue 6.0 job, which generates the dataset and runs the variants.
- Review the results, emitted to the job logs and optionally written back to Amazon S3.
The approaches we compared
All variants compute the same result. They differ in how data crosses the JVM–Python boundary and how the per-row logic runs.
| Approach | Transport (JVM–Python) | Computation |
| standard Python UDF | Pickle, one row at a time | Python, per row |
Arrow-optimized Python UDF (useArrow=True) |
Apache Arrow, columnar batch | Python, per row |
| vectorized UDF (pandas UDF) | Apache Arrow, columnar batch | NumPy, per batch (through a pandas conversion) |
native Arrow UDF (arrow_udf, Apache Spark 4.1) |
Apache Arrow, columnar batch | PyArrow compute, per batch (no pandas conversion) |
| Spark SQL (built-in) | None — runs on the JVM | JVM, per batch |
The vectorized UDF and the Arrow-optimized Python UDF both use Apache Arrow for transport, so both show ArrowEvalPython in the physical plan. The difference is the computation:
- A vectorized UDF (pandas UDF) receives a
pandas.Series(a batch of rows), so the computation can be expressed with NumPy and runs on the whole batch in native code. It involves a pandas conversion on top of Arrow. - An Arrow-optimized Python UDF is a scalar UDF: the function receives one value per call. Arrow makes the transport efficient, but the Python code still runs one row at a time.
- A native Arrow UDF (the
arrow_udfdecorator, introduced in Apache Spark 4.1 and available in AWS Glue 6.0) receives and returns apyarrow.Arrayand computes with PyArrow compute kernels. It operates directly on Arrow data, without the pandas conversion that a vectorized UDF performs.
The following image summarizes how each variant crosses the boundary.
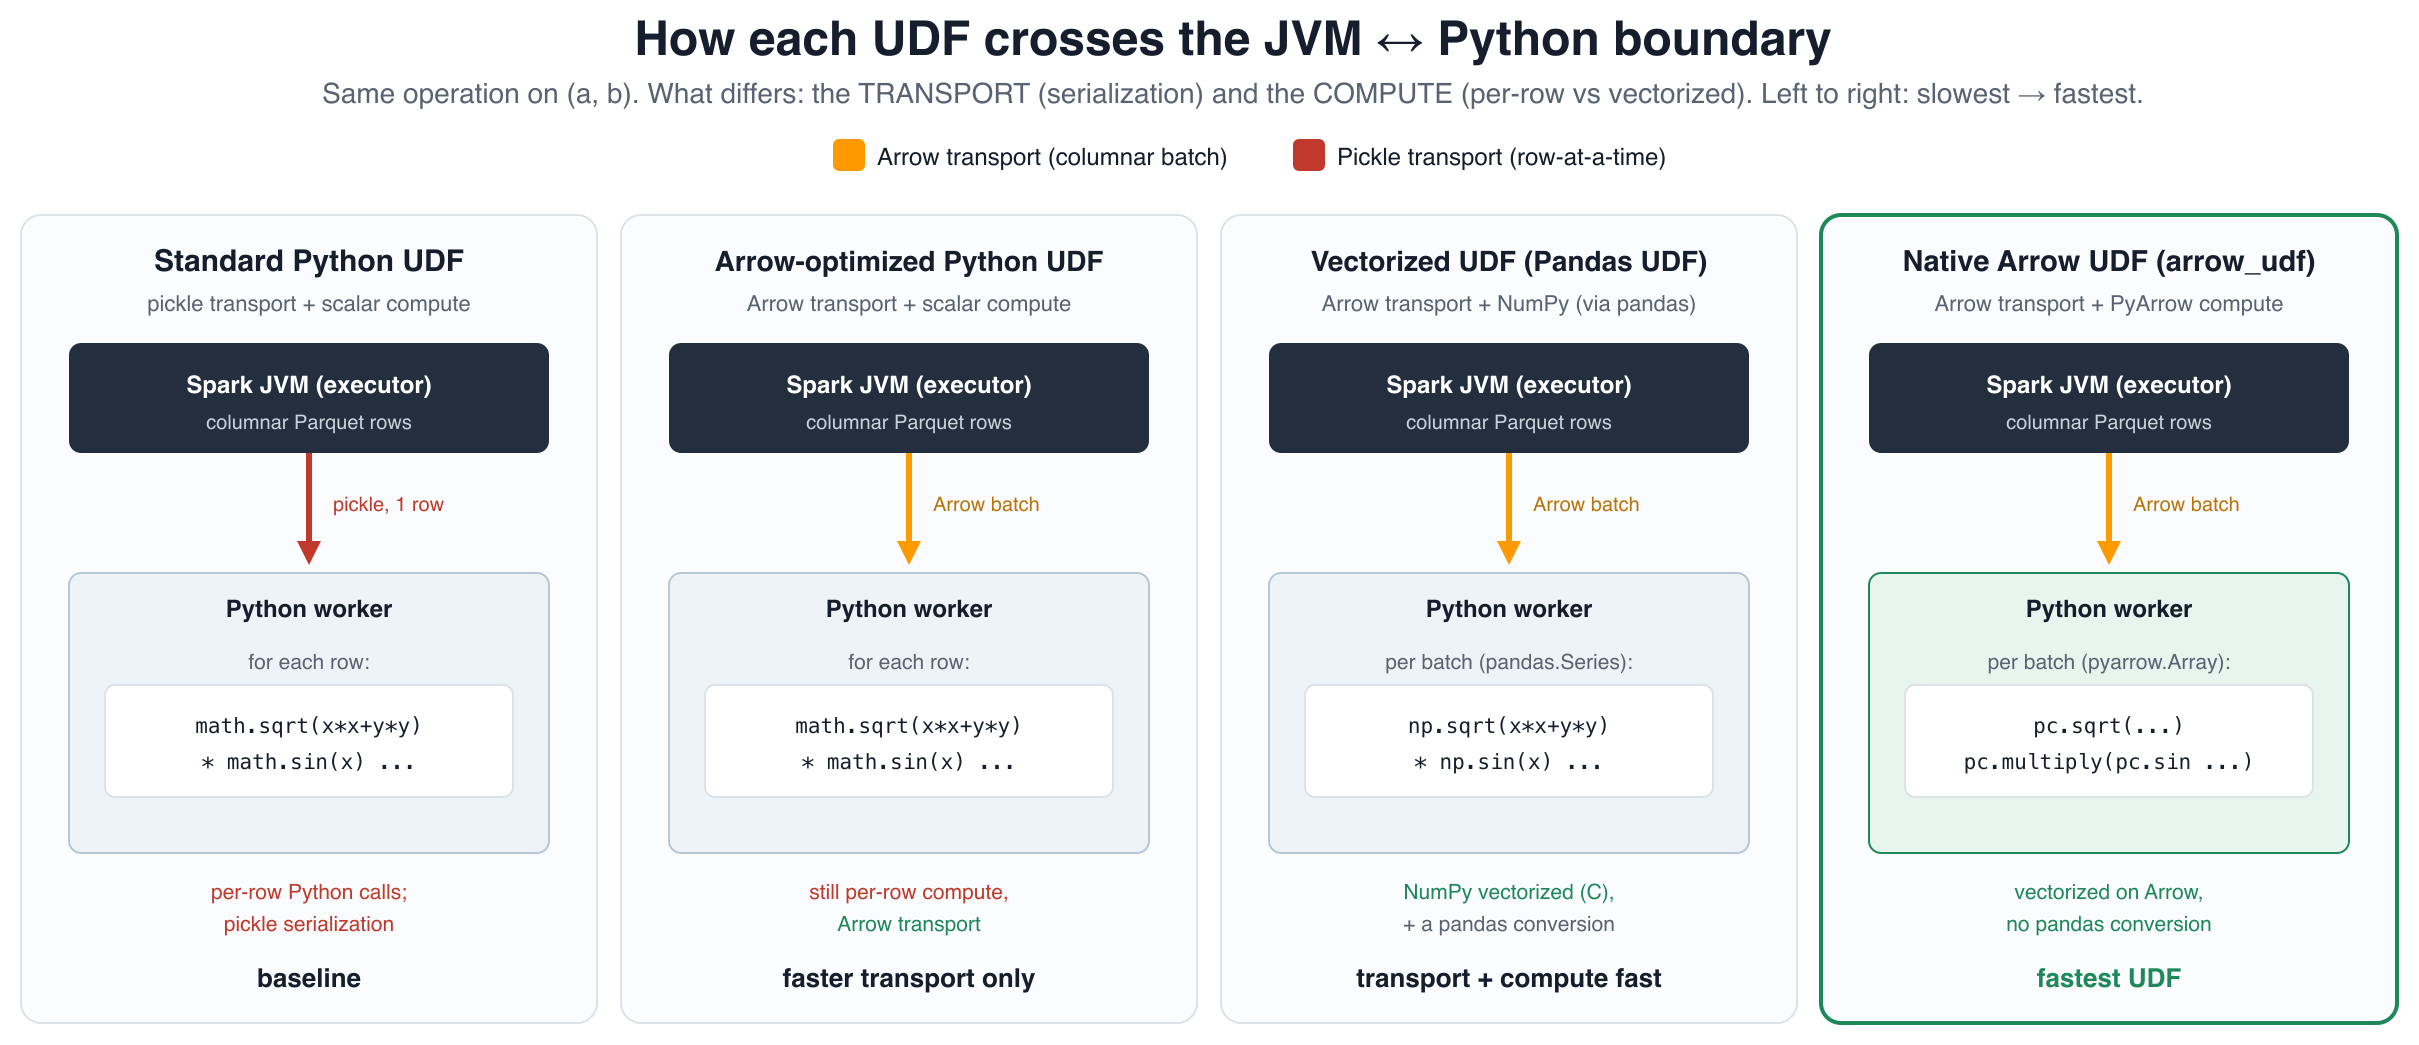
Figure 2: How each UDF variant crosses the JVM to Python boundary
The code difference reflects that distinction. The registration shape is similar, but the computation differs:
Environment and setup
- Runtime: AWS Glue 6.0 (Apache Spark 4.1.1, Python 3.13, Scala 2.13), 10 × G.1X executors plus the driver, in the US East (N. Virginia) AWS Region (us-east-1).
- Data: A Parquet dataset with two
bigintcolumns (a,b), written once to Amazon S3 and read back by every variant so all approaches read identical files. - Volumes: 10M, 50M, and 100M rows. Two dimensions are combined in every run: the workload (the per-row operation) and the query shape (how that operation is aggregated). Each of the three workloads was run under both query shapes, for every approach and volume.
Workloads (the per-row operation)
We chose three operations of increasing cost, to show how the results change as the per-row work shifts from “almost nothing” to “Python-only.”
| Workload | Per-row operation | Why it’s included | Applicable approaches |
arith |
a + b |
The operation used in the AWS Prescriptive Guidance example. The computation is trivial, so serialization dominates the runtime. | All five |
mathheavy |
sqrt(x² + y²) · sin(x) + ln(y) |
Transcendental math with a meaningful per-row cost. It can be written in SQL, with PyArrow compute kernels, in NumPy, and in scalar Python, so all five approaches apply and compete. | All five |
pyheavy |
A bounded iterative loop (Collatz-style step count) | Data-dependent control flow that can’t be expressed in SQL or with PyArrow compute kernels. This is the case where a Python UDF is the only option. | Python UDF approaches only (no Spark SQL, no native Arrow UDF) |
The progression matters. arith isolates the transport cost. mathheavy adds real computation, so vectorization can help. All five approaches apply, including the native Arrow UDF, because the math maps onto PyArrow compute kernels. pyheavy is the opposite extreme: an iterative loop that maps onto neither SQL nor PyArrow compute kernels, so Spark SQL and the native Arrow UDF don’t apply and only the Python-based UDFs remain.
Query shapes (how the operation is aggregated)
Each workload is measured under two query shapes, because they exercise different execution paths in the engine:
- Streaming:
sum(op(a, b))— A full scan of every row, reduced to a single value. This isolates the per-row cost with minimal aggregation overhead. - Stateful:
GROUP BY cast(op(a, b) AS bigint) % 1,000,000— A full scan followed by a high-cardinality aggregation (about one million groups), which adds a shuffle and a large hash table.
Both shapes apply to all three workloads. To keep the tables readable, the following results report the streaming shape. We measured the stateful shape too and found the same ranking, with representative stateful figures given in the Results section.
Methodology
Two decisions had a material effect on the results.
Warm-up and best-of-N. The first run of each variant is dominated by cluster, JVM, and Python worker start-up. We ran one warm-up iteration that we discard, then N timed iterations, and report the best (and mean).
Reading fresh on every iteration. Our first attempt reused a cached DataFrame, and Spark cached the Parquet blocks and pruned the plan for a scalar count(). As a result the UDF timings didn’t scale with data size, and Spark SQL appeared slower than the UDFs. That was the opposite of the expected result. We corrected this by clearing the cache and re-reading the Parquet on every timed iteration, and by using sum(...) so the optimizer can’t prune the per-row work.
After this correction, the ranking matched the AWS Prescriptive Guidance recommendation and remained consistent across volumes. In short: if a UDF benchmark doesn’t scale with row count, it’s likely measuring the cache rather than the computation.
Results
The following tables report the streaming query shape for each workload. We verified the stateful shape as well, and it produces the same ranking. For example, on mathheavy at 100M rows the stateful order matched streaming (Spark SQL 1.59 seconds, vectorized UDF 4.22 seconds, Arrow-optimized Python UDF 11.02 seconds, and standard Python UDF 14.33 seconds). The pyheavy table that follows shows the streaming and stateful columns side by side. The stateful figures run somewhat slower than streaming because of the added shuffle and hash aggregation, but the relative order of the approaches doesn’t change.
Workload 1: arith (a + b)
Best of seven iterations, warm-up excluded, streaming:
| Approach | 10M | 50M | 100M | Relative to standard Python UDF (100M) |
| Spark SQL | 0.53s | 0.75s | 0.99s | 11.8× faster |
native Arrow UDF (arrow_udf) |
0.76s | 1.79s | 2.81s | 4.2× faster |
| vectorized UDF (pandas UDF) | 0.90s | 1.98s | 3.13s | 3.7× faster |
| Arrow-optimized Python UDF | 1.47s | 4.82s | 8.94s | 1.3× faster |
| standard Python UDF | 2.01s | 6.20s | 11.68s | baseline |
The recommended ranking holds, and the advantage of the vectorized UDF over the standard Python UDF widens with volume (from about 2.2× at 10M to 3.7× at 100M), because the standard Python UDF’s per-row serialization cost grows with the number of rows. For this trivial operation the native Arrow UDF and the vectorized UDF are close, because there is little computation to vectorize. Their advantage over the scalar approaches comes mainly from the columnar transport.
Workload 2: mathheavy
Best of 7 iterations, streaming:
| Approach | 10M | 50M | 100M |
| Spark SQL | 0.52s | 0.84s | 1.22s |
native Arrow UDF (arrow_udf) |
0.72s | 1.87s | 3.13s |
| vectorized UDF (Pandas UDF) | 0.79s | 2.21s | 3.83s |
| Arrow-optimized Python UDF | 1.57s | 5.79s | 11.01s |
| standard Python UDF | 1.80s | 7.19s | 13.82s |
Among the UDF approaches, the native Arrow UDF was the fastest. It ran about 18 percent faster than the vectorized UDF at 100M (3.13 seconds versus 3.83 seconds) because it computes on Arrow data directly and avoids the pandas conversion. The timings scale approximately linearly across 10M, 50M, and 100M, and the ranking is stable at every volume. The following chart shows the approaches across volumes on a log-log scale.
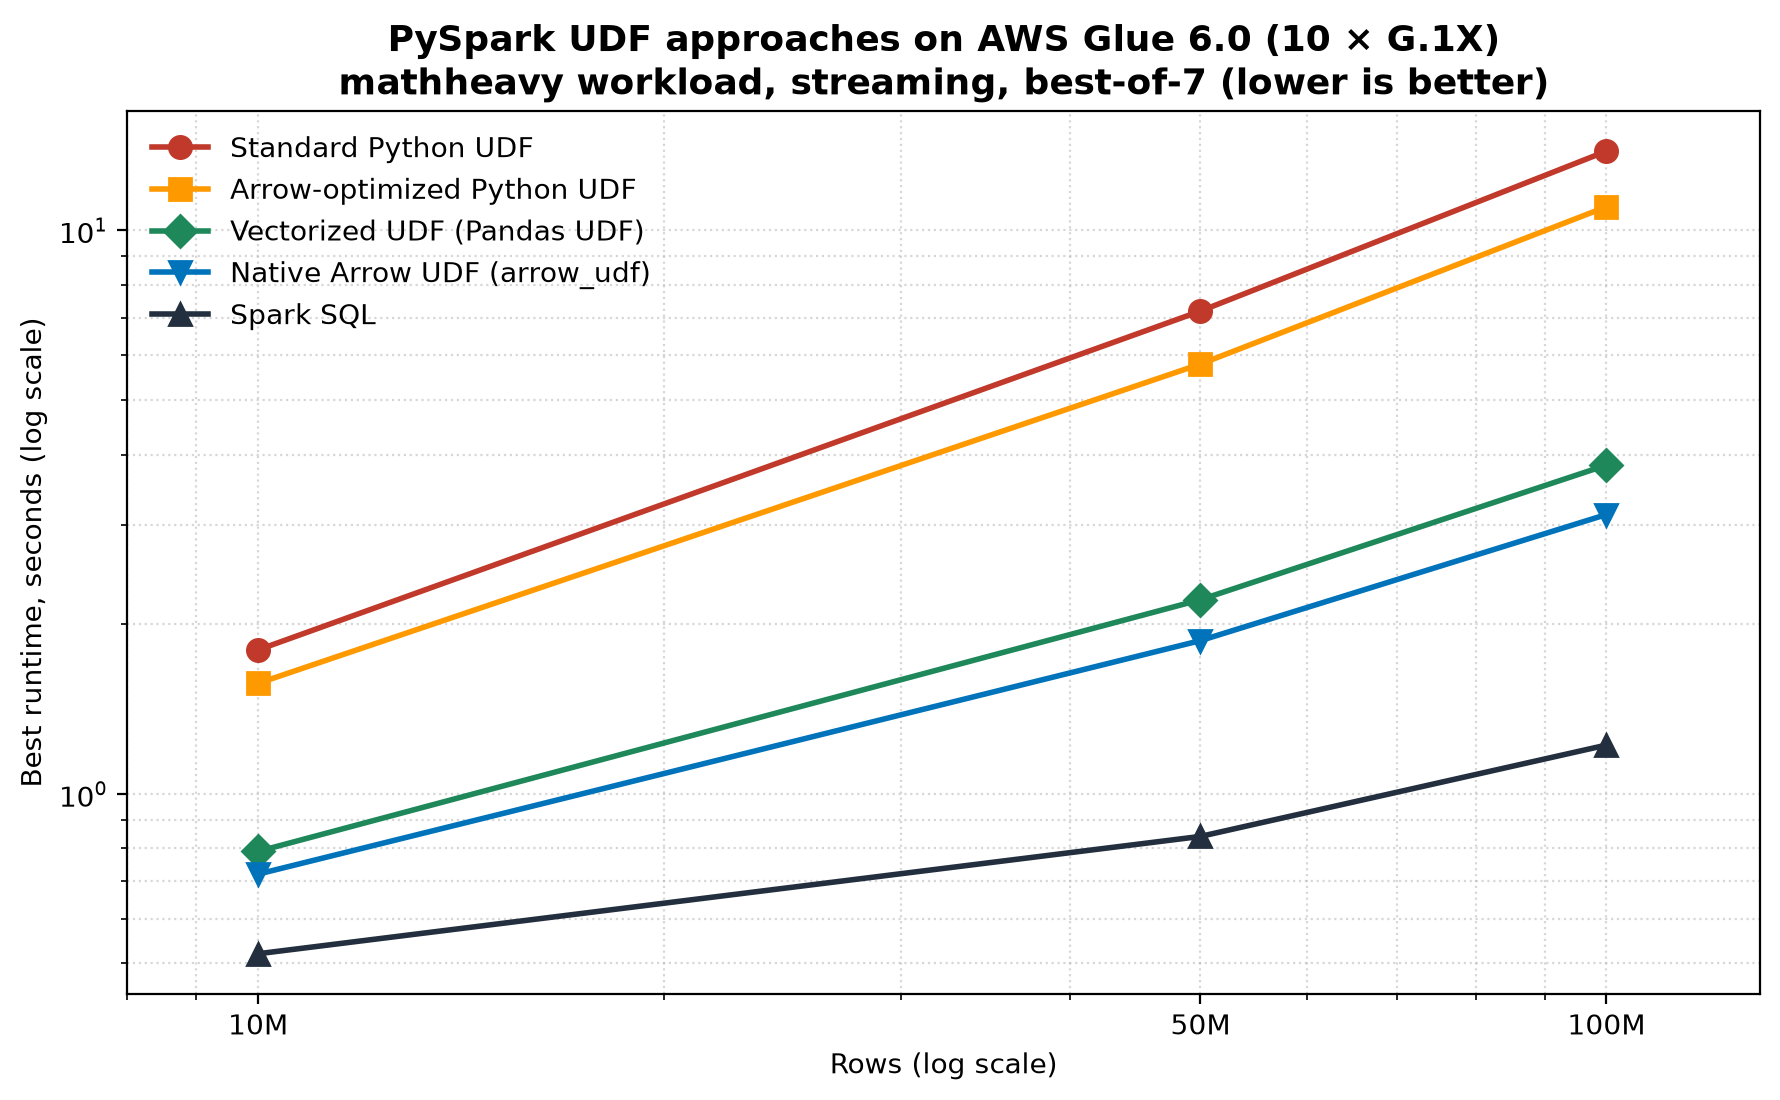
Figure 3: Runtime of each approach on the mathheavy workload across data volumes, on a log-log scale
Workload 3: pyheavy (no SQL equivalent)
This workload runs a per-row iterative loop with no closed-form equivalent. For each row it derives an integer from a and b and repeatedly applies the Collatz step (halve if even, otherwise 3n + 1) until the value reaches 1, counting the number of steps. To keep every row’s runtime predictable, the loop is bounded: it stops after at most 1,000 iterations even if it has not reached 1, so no single row can dominate the benchmark.
This kind of data-dependent control flow can’t be expressed as a SQL scalar expression or with PyArrow compute kernels, so neither Spark SQL nor the native Arrow UDF applies, and only the Python-based UDF approaches are compared. The table shows both query shapes, at 10M, 50M, and 100M rows, to illustrate that the ranking is consistent across shapes and scales:
| Approach | 10M streaming | 10M stateful | 50M streaming | 50M stateful | 100M streaming | 100M stateful |
| vectorized UDF (pandas UDF) | 0.67s | 0.72s | 1.76s | 1.85s | 2.99s | 3.01s |
| Arrow-optimized Python UDF | 1.33s | 1.36s | 4.85s | 4.86s | 8.98s | 8.71s |
| standard Python UDF | 1.50s | 1.55s | 6.05s | 6.28s | 11.42s | 11.73s |
We report pyheavy up to 100M rows. Because Spark SQL and the native Arrow UDF don’t apply here, the only remaining options are the Python-based UDFs, whose timings scale near-linearly and whose relative order is already stable across both shapes by 100M.
This workload represents the case where a UDF is unavoidable. Examples include an iterative algorithm or a call into a Python library with no SQL counterpart that doesn’t map onto PyArrow compute kernels either. Here the vectorized UDF is the most effective available option: about 2.2× faster than the standard Python UDF at 10M, widening to about 3.8× at 100M.
A controlled experiment: Transport or computation?
The vectorized UDF consistently outperforms the Arrow-optimized Python UDF. To test whether the difference comes from the transport (both use Arrow) or the computation (only the vectorized UDF uses NumPy on a batch), we constructed the missing combination (NumPy computation with pickle transport, no Arrow) using RDD.mapPartitions.
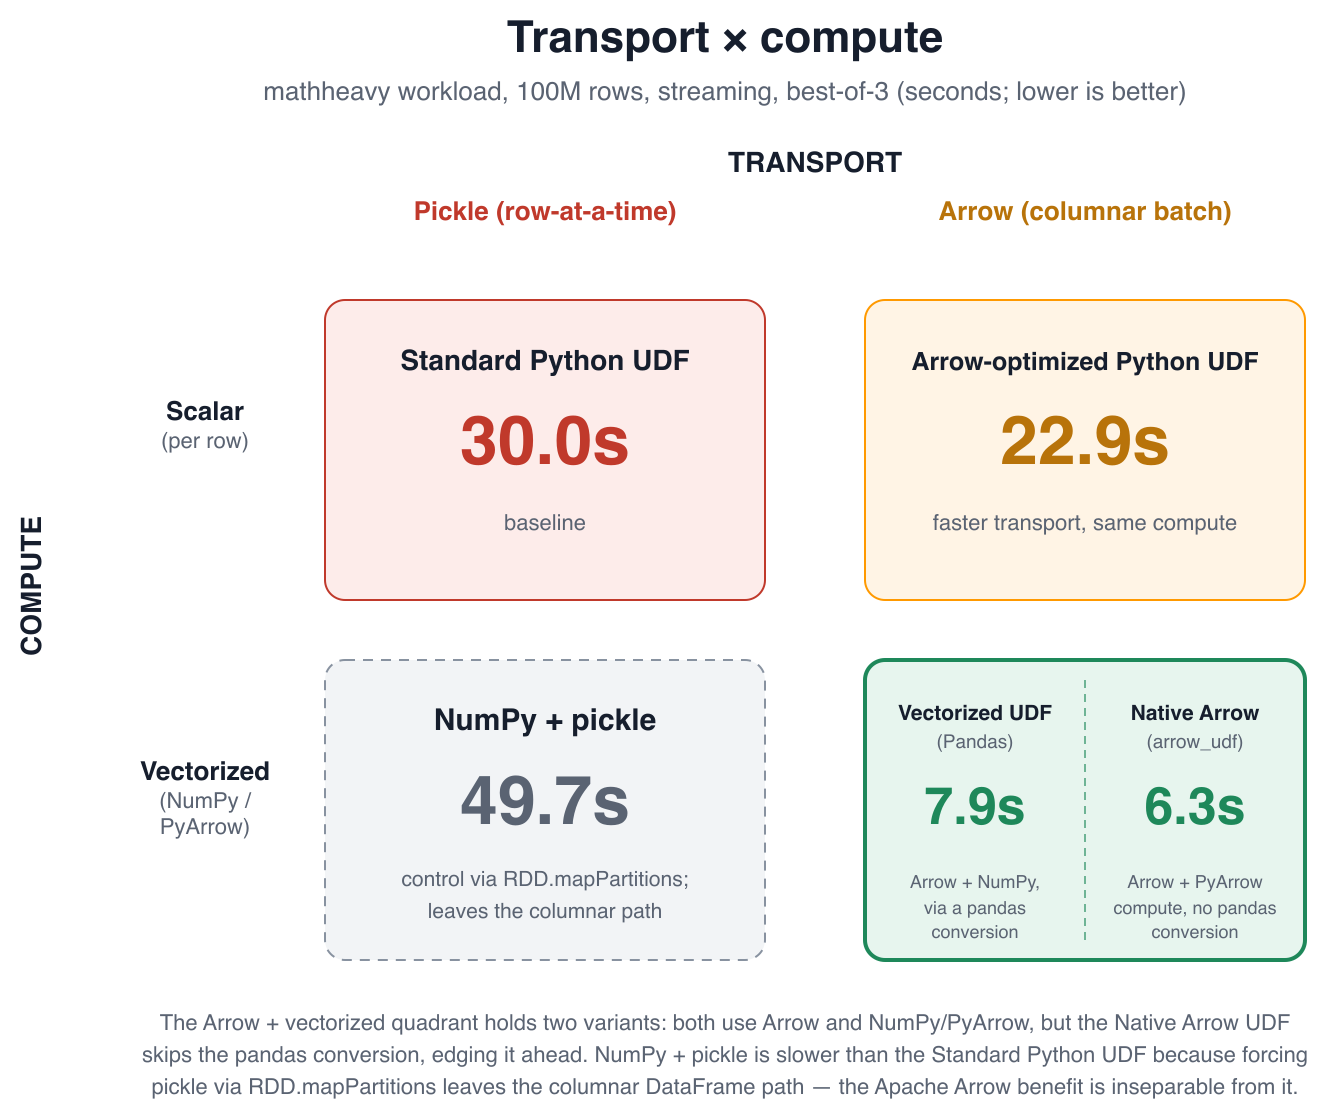
Figure 4: Transport and computation compared as a 2×2 experiment
The NumPy-with-pickle variant was the slowest of all (21.07 seconds at 100M, slower than the standard Python UDF at 13.82 seconds). The reason is that forcing pickle transport requires leaving the DataFrame API for RDD.mapPartitions, which changes two things at once. It materializes each row as a Python object before a NumPy array can be built, and it bypasses the optimized DataFrame execution engine that the vectorized UDF benefits from.
The practical conclusion is that the benefit of a vectorized UDF is not the Arrow transport in isolation. It’s Apache Arrow integrated into the vectorized DataFrame execution path. That path combines columnar transport and NumPy computation. Reproducing only the NumPy portion outside that path doesn’t yield the same benefit.
Code comparison: Arrow-optimized Python UDF and vectorized UDF
These two approaches are often confused: both use Apache Arrow for transport and both show ArrowEvalPython in the physical plan, so it’s worth seeing them side by side. The following two definitions compute the same mathheavy operation. The registration is almost identical. The difference is the function body and the type of its arguments.
The following code is an Arrow-optimized Python UDF (useArrow=True), where the function receives scalar values and runs once per row:
The following code is a vectorized UDF (pandas UDF), where the function receives a pandas.Series (a batch) and computes with NumPy over the whole batch:
The following code is a native Arrow UDF (arrow_udf), where the function receives and returns a pyarrow.Array and computes with PyArrow compute kernels, operating directly on Arrow data with no pandas conversion:
The Arrow-optimized Python UDF and the vectorized UDF differ in two lines that matter:
- Argument type – In the Arrow-optimized UDF,
aandbare scalars, so the body usesmath.sqrtandmath.sinand runs once per row. In the vectorized UDF,aandbarepandas.Series, so the body usesnp.sqrtandnp.sinand runs once per batch. - Where the computation runs – The Arrow-optimized UDF still executes Python per row. The vectorized UDF executes the batch in NumPy’s native code.
This difference in where the computation runs is what separates the three at scale. On the mathheavy workload at 100 million rows, the Arrow-optimized UDF ran in 11.01 seconds, the vectorized UDF in 3.83 seconds, and the native Arrow UDF fastest at 3.13 seconds. The native Arrow UDF edges ahead because it vectorizes the computation through PyArrow compute kernels without the pandas conversion the vectorized UDF performs. However, it requires the logic to be expressible with those kernels, where the vectorized UDF remains the more flexible choice.
Recommendations
These results align with the AWS Prescriptive Guidance recommendation and add a few practical points:
- Prefer built-in Spark SQL functions when the operation can be expressed in SQL – The computation runs on the JVM, and the advantage grows with data volume.
- When a UDF is required and the logic can be expressed with PyArrow compute kernels, consider a native Arrow UDF (
arrow_udf) – In our tests it was the fastest UDF approach, because it vectorizes the computation on Arrow data without a pandas conversion. It’s available in AWS Glue 6.0 (Apache Spark 4.1). - Otherwise, use a vectorized UDF (pandas UDF) – It outperformed the standard Python UDF by 2.2–3.8× in our tests. It’s the more flexible option when the logic is easier to express with pandas or NumPy than with PyArrow compute kernels.
- Arrow-optimized Python UDFs (
useArrow=True) improve the transport but not the computation – They are faster than the standard Python UDF, but a vectorized or native Arrow UDF is faster whenever the per-row work is non-trivial. Consider the Arrow-optimized Python UDF when you want a minimal change to an existing scalar UDF. - Stay in the DataFrame API to keep Arrow’s benefit – As the controlled experiment showed, the speedup doesn’t come from Arrow serialization alone. It comes from Arrow integrated into the vectorized DataFrame execution path. Applying the same NumPy logic through
RDD.mapPartitionswas the slowest approach of all, because it leaves that path. Implement vectorized logic as a vectorized or native Arrow UDF within the DataFrame API rather than dropping to the RDD API. - For iterative or data-dependent logic (the
pyheavycase), the vectorized UDF is the fallback – When the operation maps onto neither SQL nor PyArrow compute kernels, both Spark SQL and the native Arrow UDF are unavailable, and among the remaining Python UDF approaches the vectorized UDF was the most efficient. - Decide whether the rewrite is worth the effort – Moving a scalar UDF to a vectorized or native Arrow UDF is a small code change, but it still has to be written and tested. As a rule of thumb, it pays off when the per-row work is non-trivial and the data is large or the job runs often. The speedup (and the per-second cost saving) scales with row count and with how frequently the job runs, while the rewrite is a one-time cost. For a trivial operation on a small, infrequent dataset, the standard Python UDF might be perfectly adequate. For a compute-heavy transform on hundreds of millions of rows that runs daily, the rewrite typically repays itself in the first few runs.
- The exact numbers depend on your cluster – All results here use a fixed configuration (10 × G.1X workers) on AWS Glue 6.0. The ranking of approaches is a property of how each UDF crosses the JVM–Python boundary and is not expected to change with cluster size. However, the absolute timings and any crossover with alternatives will shift with worker count, worker type, and data layout. Treat the figures as a guide to relative behavior and validate against your own configuration.
- Methodology affects the outcome – Warm-up handling and cache management changed our ranking. A UDF benchmark whose timings don’t scale with row count is likely measuring the cache.
Conclusion
The choice of UDF strategy has a measurable and recurring impact on both runtime and cost. On our compute-intensive workload at 100 million rows, the gap between the fastest UDF approach (the native Arrow UDF at 3.13 seconds) and the standard Python UDF (13.82 seconds) was about 4.4×, for identical output. Because AWS Glue bills by the second, that difference translates directly into spend on every job run.
These results extend the AWS Prescriptive Guidance recommendation with volume scaling from 10 million to 100 million rows, a compute-intensive workload, and the newer Arrow-based UDF options available in AWS Glue 6.0 (Apache Spark 4.1). As a methodology note, warm-up handling and cache management materially affected the ranking. A UDF benchmark whose timings don’t scale with row count is likely measuring the cache rather than the computation.
To learn more, see Optimize user-defined functions in AWS Prescriptive Guidance and the AWS Glue documentation.