Post Syndicated from LastWeekTonight original https://www.youtube.com/watch?v=JqwBYI5YmZQ
Забелязва се спад в раждаемостта след пандемията и може би не засяга България
Post Syndicated from Боян Юруков original https://yurukov.net/blog/2025/spad-rajdaemost/
Вчера, когато привършвах текста ми за картата на Евростат, се замислих над още нещо. Защо забелязваме спад в тоталния индекс на плодовитостта сред повечето европейски държави в последните две години? Поне това на пръв поглед се виждаше взирайки се в данните им. Реших да се задълбая повече и излязоха няколко интересни наблюдения. Ще се опитам да дам свое обяснение за тях, макар несъмнено за всяка държава те и други имат различна тежест.
Каква е динамиката?
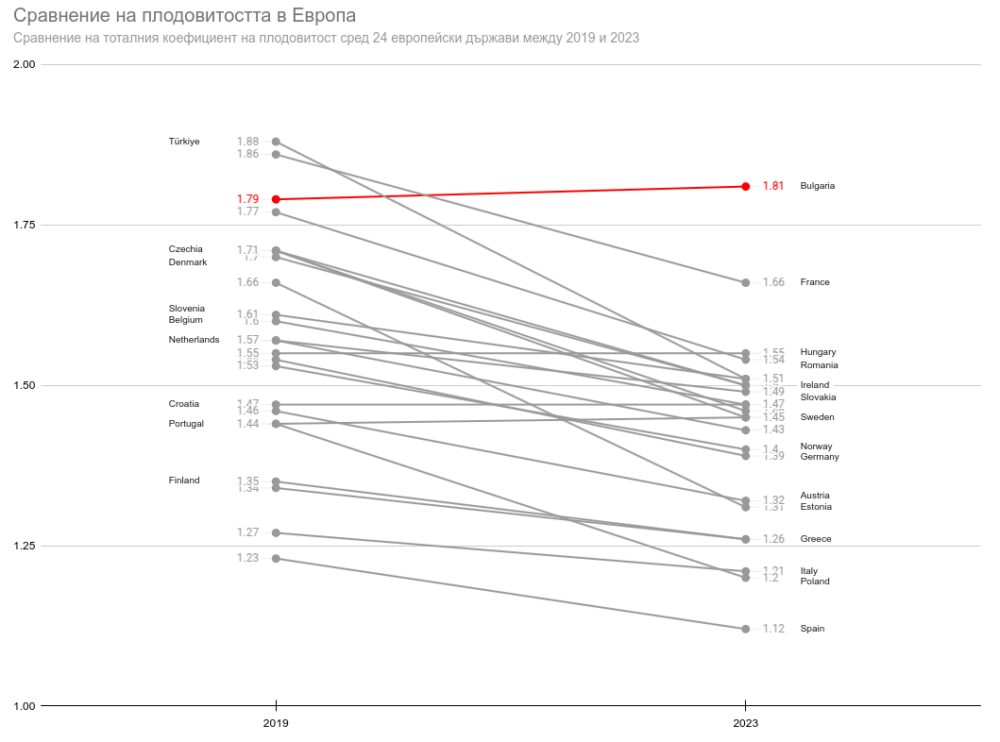
Тъй като говорим за доста числа и държави, реших да разгледам две конкретни години – 2019 и последната известна 2023-та. С други думи – преди и след пандемията. Защо избрах тях и защо не трябва да избързваме с изводите ще обясня по-нататък, но ето първо графиката. Тук сравнявам 24 държави включени в данните на Евростат. При 18 има спад от над 9% за пет години, което е сериозно. При Унгария, Хърватия и Португалия практически няма промяна, а при Сърбия и Македония има съответно увеличение от 6.6% и 18%. Тях ще разгледаме след малко. Най-голям спад има при Турция от 20%, както и при Полша, Швеция, Грузия, Естония, Латвия и Литва от между 15% и 21%.
Интересното е, че сред държавите от ЕС една от трите без намаление е България. При това е с най-голямо увеличение от 1.12%. Както коментирах в предишната статия, плодовитостта не трябва да се разглежда в изолация или дори кратък период, макар в определени случаи да е неизбежно. В случая дори да сравним 2023-та със средната стойност за същите държави между 2017 и 2019-та, картината не се променя. България дори скача с 3.82%. Тук важна бележка е, че изключвам държави като Кипър и Люксембург заради малкото население.
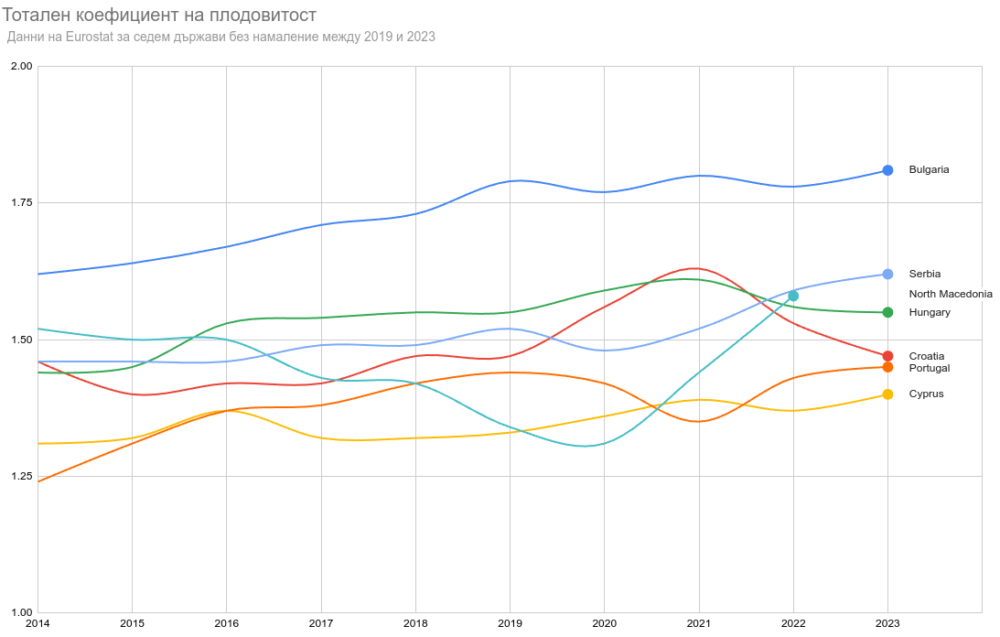
Държавите, където няма намаление за този период, са България, Сърбия, Македония, Унгария, Хърватия, Португалия и Кипър. Кривите им за последните десет години са добро начало, за да разберем условностите им, което да ни даде и идея за тези с голямо намаление.
Виждаме голяма вариация и в зависимост коя година вземем, получаваме различен ръст. При България, например, практически липсва промяна след 2018-та, след като до тогава има постоянно подобрение на плодовитостта. Въпреки това, се виждат леки пикове през 2019-там, 2021 и 2023-та, което прави сравнението горе подходящо. При Сърбия и Македония се отчита значително повишение след кризата. При Унгария и Хърватия виждаме първоначален скок от 1-2 години, след което рязък спад. При Португалия виждаме пък спад и после възстановяване, а при Кипър ситуацията в по-скоро като България. С други думи, при всички изброени с изключение на Сърбия и Македония виждаме по-скоро еднократни ефекти. Вижда се ясно обаче, че България има значително по-висока плодовитост от останалите дори с положителна тенденция и това е силен сигнал, който не трябва да се пренебрегва.
Възможни обяснения
Още в началото на пандемията, когато се разбра, че няма да свърши за няколко месеца, имаше твърдения, че тя ще доведе до сериозно увеличение на раждаемостта, а от там и плодовитостта. В това имаше някаква логика. От една страна, историята показва, че след кризи и войни има скок в раждаемостта като форма на компенсиране. От друга, много хора бяха затворени вкъщи продължително без много какво да правят.
Тези твърдения обаче се базират на повърхностно разбиране на поведението на хората, още повече в днешното общество. Голямата несигурност и смърт всъщност намалява шансовете двойки да се решат на деца. Видяхме го през 90-те в България. Това е още по-вярно във време, когато поне някаква част от населението има някаква здравна и сексуална култура и възможност да се предпазят от бременност. В тази връзка, не се забеляза увеличение на абортите нито според данните на НЗОК, нито според оценките на организации занимаващи се с темата. Има дори постоянно намаление – както в абсолютен брой, така и спрямо брой жени и брой раждания.
Както виждаме горе, забелязва се спад в раждаемостта в много държави. Средното за целия Европейски съюз (без Великобритания) е 9.8% надолу между 2019 и 2023-та. Една причина за това може да е продължаващата политическа и икономическа несигурност. Водещ фактор си остава застаряващото население, повишаващата се средна възраст на раждане и променящата се възрастова структура на жените в детеродна възраст. По време на пандемията пък навярно изолацията е имала ефект – когато не излизаш продължително време или общо страниш от групи, не срещаш нови хора, не заформяш връзки и семейства и от тях – деца. Това е феномен наблюдаван от много време в Япония и е основен проблем в демографията им, но по културни причини.
В държави крайно зависещи от имиграция за закрепване на демографското си положение като Италия, Германия и Франция пандемията доведе до намаляване на този поток. Като допълним затварянето на границите, паника подтикната от нативистични и националистически настроения, засилването на радикалните партии и общите негативни настроения срещу чужденците, разбираемо е защо притокът на деца и млади семейства, които да раждат такива би намалял, а тези вече на място биха отложили такова решение.
В България може би е имало отчасти положителен ефект от този процес. Шовинизма, расизма и сегрегацията са все още твърде сериозно заложени в обществото ни и работната среда и в комбинация с корупция и мудна бюрокрация никога не сме успявали да привлечем значително количество външни работници. Така временен спад не би се отразил толкова, но означава и че дългосрочно сами ограничаваме възможностите си като общество и икономика. От друга страна, имаше от рано сигнали подкрепени от последвали данни, че доста българи се върнаха в рамките на пандемията и останаха в България. Някои от тях навярно вече имат деца и са помогнали за наблюдаваното леко увеличение на плодовитостта. Аз съм сред тях, макар връщането ми в България да беше планирано доста преди самата пандемия.
Да не бързаме с изводите
Не трябва обаче да се взираме прекалено в тези отделни числа, защото те се влияят твърде силно от много фактори. В Унгария, например, широко тиражираните мерки за стимулиране на раждаемостта и брака сред семействата имаха еднократен и скромен успех. Причината за това е липсата на разбиране за мотивацията на хората и същността на проблемите, но и също, че бяха диктувани от религиозни, националистически и консервативни догми.
В други страни локализирани проблеми, кризи и несигурност имат голямо влияние върху числата. Пример за прибалтийските републики и заплахата от агресия от страна на Русия. Дори неща като инфлацията, която видяхме в Европа и освен всичко подпомогна изкачването на анти-системни партии, може да е фактор.
Но основен фактор според мен е вътрешната демографска динамика в самите държави, която съвсем очаквано не върви в синхрон. Често предупреждавам да не се сравнява така механично метрики между държавите, особено такива в конкретен момент във времето. Всяка метрика има своя смисъл, обяснение и приложение, но имаме склонност да ги изкарваме от контекст без особено разбиране. За тоталният коефициент на плодовитост навярно това важи в най-голяма степен.
В различните държави в детеродна възраст влизат и излизат различен брой жени. У нас в последните години влизат доста заради повишената раждаемост преди 15 години. Също така, различни социални фактори като възраст на завършване на училищата, практики за започване на университет, социална и трудова защита, достъпност до помощ и финансиране за подпомагане на репродуктивното здраве и промени в тези мерки и възможност в последните години могат да имат еднократен ефект, който за се види като сигнал в тези данни. Понякога дори продължителна липса на медикамент важен за хора с трудности в зачеването може да създаде ефект съизмерим с онези, които виждаме горе.
Не на последно място, данните за някои от изброените държави са предварителни и подлежат на корекция. Докато повечето деца родени през 2023-та са били заченати в условията на пандемията и още в началото на войната в Украйна, когато се смяташе, че ще свърши бързо, не може да знаем колко тази несигурност им се е отразила. Трябва да изчакаме окончателните данни за 2024-та и дори 2025-та, за да видим дали обсъжданото е имало по-сериозен ефект и какъв.
Затова е важно да четем с разбиране, да поставяме нещата под въпрос и в контекст, да сме запознати с методологията и ограниченията на данните и да не търсим гръмки твърдения и още по-малко – обяснения на ефект, който ни се ще да видим. Най-големият проблем на които да е данни е не в тях самите, а в презумпциите, с които подхождаме.
The post Забелязва се спад в раждаемостта след пандемията и може би не засяга България first appeared on Блогът на Юруков.
Inside a 100G SR4 QSFP28 Module A Quick Teardown
Post Syndicated from Rohit Kumar original https://www.servethehome.com/inside-a-100g-sr4-qsfp28-module-a-quick-teardown/
We take apart a 100G SR4 QSFP28 module so you can see what goes inside these extremely common optical modules
The post Inside a 100G SR4 QSFP28 Module A Quick Teardown appeared first on ServeTheHome.
Stable kernel 6.6.82
Post Syndicated from corbet original https://lwn.net/Articles/1013476/
The 6.6.82 stable kernel has been
released. “All i386 users of the 6.6 kernel series must upgrade (as
“
they skipped the last release.) All other arches can skip this one as it
should not affect them.
Aqara G5 Pro – Camera You DON’T Need
Post Syndicated from digiblur DIY original https://www.youtube.com/watch?v=vfhOFwr97_8
Viva Las Vegas
Post Syndicated from The History Guy: History Deserves to Be Remembered original https://www.youtube.com/watch?v=w92IsCXRsp8
Comic for 2025.03.09 – Gregnant
Post Syndicated from Explosm.net original https://explosm.net/comics/gregnant
New Cyanide and Happiness Comic
buttercream
Post Syndicated from Oglaf! -- Comics. Often dirty. original https://www.oglaf.com/buttercream/


My highlights from CP+ 2025
Post Syndicated from Matt Granger original https://www.youtube.com/watch?v=vRiZVy9SdfU
How to Reset a HPE iLO Administrator Password From the OS Using ipmitool
Post Syndicated from E Lopez original https://www.servethehome.com/how-to-reset-a-hpe-ilo-administrator-password-from-the-os-using-ipmitool/
We have a quick guide to resetting a HPE iLO Administrator Password using ipmitool or adding a new administrator user to iLO
The post How to Reset a HPE iLO Administrator Password From the OS Using ipmitool appeared first on ServeTheHome.
Картата на Евростат за плодовитостта и какво всъщност ни показва?
Post Syndicated from Боян Юруков original https://yurukov.net/blog/2025/eurostat-data/
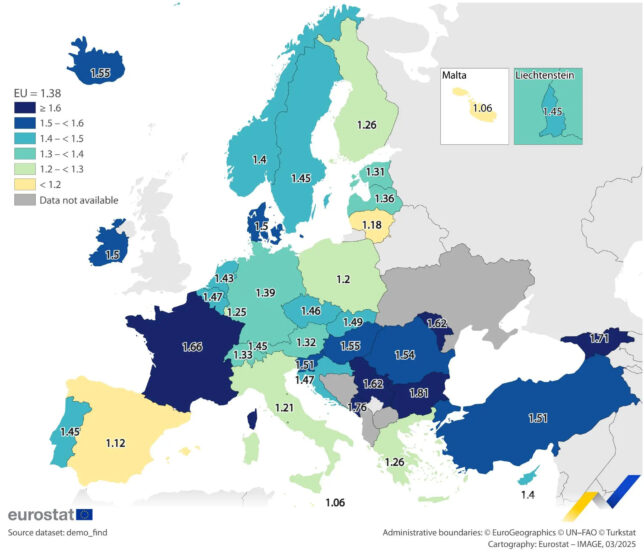
Горната снимка обиколи мрежата в петък, когато Eurostat обнови данните си за раждаемостта в Европа. Тя беше посрещната с разнопосочни реакции, но най-честата беше радост, че сме на първо място в България по брой деца на жена в детеродна възраст – 1.81. Доколкото това изглежда е вярно, има няколко важни подробности, които бяха пропуснати по веригата.
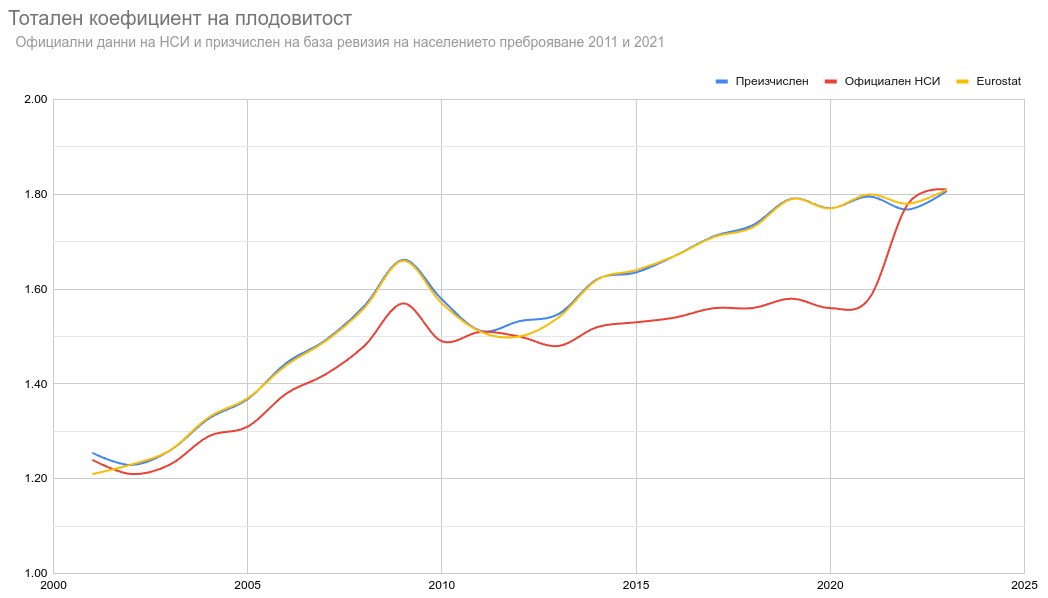
Първо, препоръчвам да прегледате статията ми обясняваща подробно каква е разликата между плодовитост и раждаемост и защо всъщност е нямало скок в първото преди три години. В графиката илюстрирам как и защо коригирам населението след последните две преброявания и как това се отразява на този индекс.
Имаше критика към преизчисляването на коефициента в същата статия, която пуснах през август 2024-та. От дискусиите се виждаше, че причината е предимно това, че показваше практически застой в последните седем години и неизбежните изводи за промяната на условията на живот в годините преди 2018-та и влиянието им за решенията на двойките. Данните публикувани на 7-ми март 2025-та от Евростат обаче съвпадат почти идеално с моите корекции. Голямата разлика е през 2012-та, когато те взимат числото на НСИ като базова точка, а аз го преизчислявам. Отклонението в другите години е под 0.7% и се дължи на това, че аз имам данни за ражданията само по възрастови групи, а не по отделни възрасти на майките. Все пак са доста точки и потвърждават моите изводи шест месеца по рано.
Много по-важно в случая обаче е, че макар да виждаме добри сигнали, трябва да ги поставим в контекст. Макар да имаме тази година най-висок показател в Европа, плодовитостта има значение единствено ако се разглежда в продължителен период от време, защото тогава проличават истинският ефект върху населението и обществото. Краткосрочен скок или спад носи само шумни заглавия, но само толкова. Притеснителен е застоя в последните години, макар по-долу ще покажа, че на фона на Европа може и да е добра новина. Въпреки това фактът, че е под 2.1 остава проблем. Зад това число има много детайли и съм ги обсъждал често. Най-важното е, че се използва премного за консервативана пропаганда целяща намаляване правата на жените без обаче да показват особено разбиране или работещи решения. Също така, плодовитостта е само един от многото параметри на демографията, не съществува в изолация и свеждането му до едно число, макар удобно, скрива много важни детайли като възрастовото разпределение на майките, еднократни ефекти, здравеопазване, реална смъртност на жени и новородени и прочие.
Забелязва се също разминаване с данните за други държави като Турция с официалните такива за 2023-та. Това може да се обясни с преизчислението, което правят за всички на база оценките за населението и дали имат достъп до окончателни данни. Всъщност, имаше разминаване и с данните на НСИ. Ще забележите че в статията ми от август миналата година за 2023-та съм посочил плодовитостта от НСИ да е 1.79. Тъй като пазя всичко, което свалям като данни, виждам, че това е показвал порталът Инфостат, когато свалих справката на 29-ти април 2024. Днес числото е коригирано на 1.81, което съвпада точно с моята оценка и тази на Евростат.
Предупрежавам, че трябва да се много внимателни когато сравняваме показатели между държави, особено такива зависещи от възрастовата структура на населението като смъртност, рак или заболевамост. В случая тези стойности могат да се сравняват като имаме едно наум, че има голяма вариация в средната възраст на раждане и разпределението по възрасти. Затова нека направим няколко сравнения.
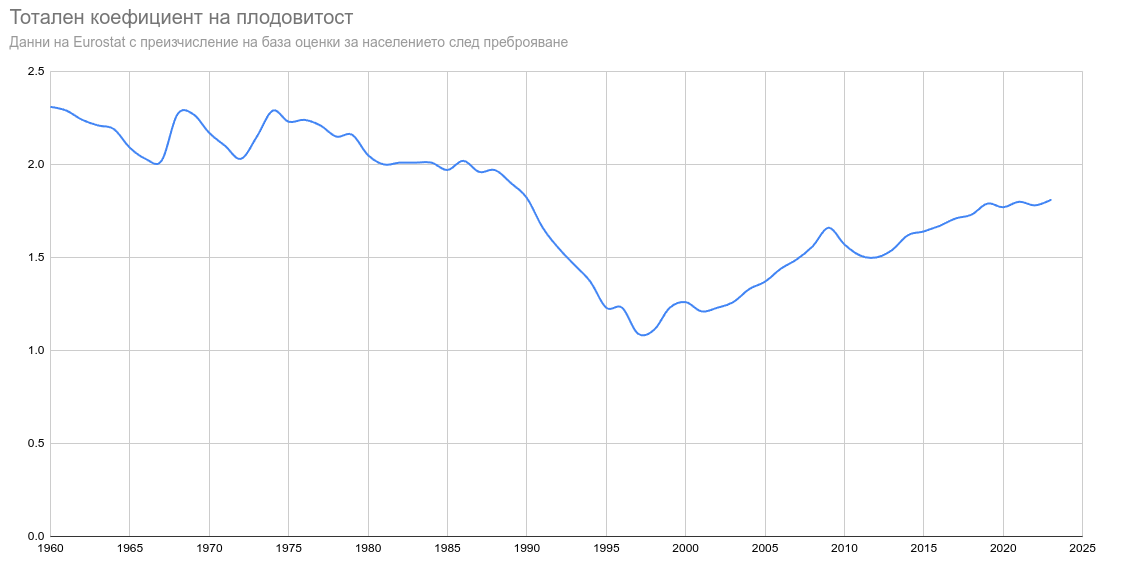
Първо тук виждате коефициентът на плодовитост на България от 1960 до 2023-та по данни и оценки на Евростат. След резкия спад през 90-те виждаме бързо покачване. Вижда се спирането на растежа в последните седем години. На практика през 2018-та сме стигнали нивото, което е имала България преди голямата миграция от една трета от младото тогава поколение. След това обаче България на практика е спряла в демографското си развитие по този показател.
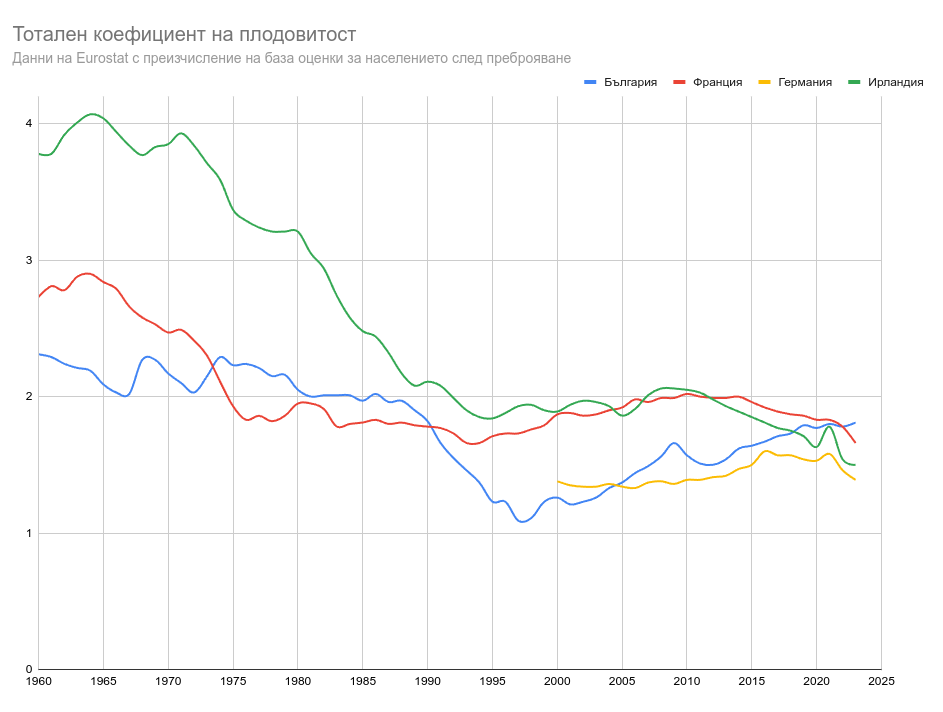
В следващите две графики ще видите сравнение за същия период между за България и няколко други европейски държави. Вижда се, че след възстановяването от кризата през 90-те сме задминали Германия преди 20 години. Повишението при тях в последните 10 години се дължи изцяло на външна миграция. В последните няколко години сме задминали дори шампионите демографски – Ирландия и Франция. Франция е интересен случай, защото има ниска раждаемост в последните 200 години и често се използва като ранен пре-индустриален пример за изследване на демографски преход. Ирландия пък показва много висока плодовитост през 60-те, но аналогичен на нас спад след това, но траещ 25 години вместо 10 и по други причини.
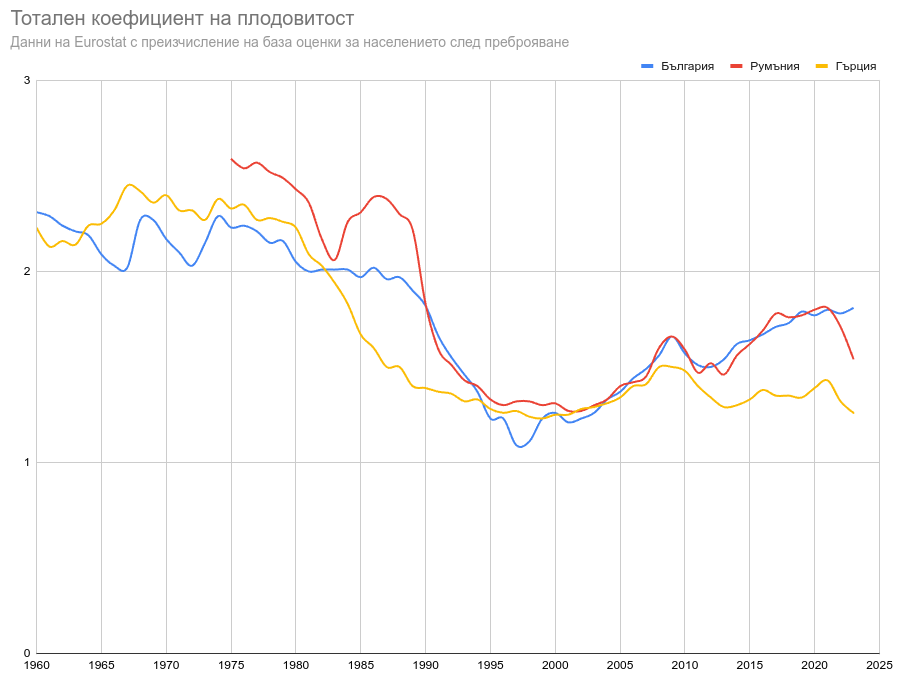
Тук виждаме сравнение със съседите ни. Демографския преход при всички съвпада с икономически крах и напускане на сериозна част от младите. Виждаме, че при Гърция в започнал 10 години по-рано и все още остава доста нисък. Плодовитостта в България и Румъния върви практически в унисон до пандемията, което може да даде индикации, че се диктува основно от външни фактори и общи черти и промени на ситуацията в двете държави. След пандемията обаче виждаме сериозен спад в Румъния, както и в Гърция, докато в България нещата остават непроменени.
За пълните данни препоръчвам да погледнете статията на Евростат и таблицата им, както и таблицата в Инфостат на НСИ, а тук ще намерите последните справки, карта и методологията им
The post Картата на Евростат за плодовитостта и какво всъщност ни показва? first appeared on Блогът на Юруков.
Седмицата (3–8 март)
Post Syndicated from Йовко Ламбрев original https://www.toest.bg/sedmitsata-3-8-mart/

Скандалната среща между Зеленски и Тръмп в Белия дом от края на миналата седмица в голяма степен предопредели събитията и от настоящата. След нея тревожността поизмести прагматизма от коментарите и анализите както в сериозните медии, така и в изявленията на политиците. По целия свят.
И някак естествено идва да се запитаме дали не можем да обясним всичко, което се случва, чрез тази толкова човешка и първична емоция – страха. Според Искрен Иванов отговорът е „да“. В текста си „Медът и жилото на САЩ, или за разговора между Тръмп и Зеленски“ той рационализира страха като ключов двигател на събитията, на които сме свидетели. А палитрите от различни страхове – като пресечни точки или червени линии, които изглеждат напълно валидни маркери за прегрупиране или разделение, поне в политиката и сред елитите.
„Властта на себе си прилича“, твърди Емилия Милчева в актуалния си политически коментар за взаимоотношенията в управлението и в частност за олекването на ДПС–ДПС за сметка на гравитацията около Делян Пеевски. Последният изземва все повече характерната за ДПС роля на брокер на реална власт, като я надгражда с корпулентен размах. Разбира се – не в положителна посока.
Емилия припомня и една важна публикация на „Капитал“ от миналия уикенд. Ако сте пропуснали да прочетете интервюто с българската европрокурорка Теодора Георгиева, непременно поправете това. Защото е ярко свидетелство за безобразието, в което сме затънали до уши. Безобразие, което е пряко свързано с фундамента на устройството на държавата ни и засяга всичко и всички. Заради възпроизвеждащата се гнилоч в съдебната система, грижливо пазена от статуквото.
Не знам дали е заради тази повсеместна и все по-сгъстяваща се тревожност, но почти всички материали тази седмица в „Тоест“ са силно критични. Не че Елена Телбис някога не е била… но в саркастичния си преразказ на събитията от седмицата тя едновременно разхвърля във въздуха Тръмп, Пеевски, Кирил Петков, братята Тейт, че и онези даже малко повече от „братя“ от Възраждане. И пита за още.
Честит 8 март, скъпи читателки на „Тоест“!
Уви, този ден у нас все още се свързва с мама, баба, цветя, бонбони и алкохол. Докато всъщност е символ на борбата за равноправие на жените. Затова е и някак навременно на този ден да започне новата поредица на Надежда Цекулова, посветена на женското здравеопазване и наречена „Анатомия на пола: Жена“. Логично е също първата тема в тази рубрика да е исторически преглед на отношението и нагласите на човечеството към женското здраве.
Свикнали сме в „Тоест“ да четем интересните статии на Анета Василева за архитектура. Тази седмица обаче за всеобща изненада тя пише за кино. Добре де, за кино и архитектура. „Бруталистът“, който Анета смята за недоразумение въпреки няколкото спечелени престижни награди, че и с номинация за най-добър филм на Оскарите, я провокира да напише силно критична рецензия.
Критичен този път е дори материалът на Павлина Върбанова. Тя споделя личното си мнение за подготвяно от Института за български език на БАН прекрояване на граматиката ни, което се прави непрозрачно, без обсъждане с филолози и за съжаление, изглежда твърде самоуверено и самоцелно. Прочетете повече в „Критика на граматичния разум“. Даже да не сте филолог, не подминавайте този текст дори ако на места ви се стори твърде специализиран.
В рубриката ни „На второ четене“ тази седмица Стефан Иванов ни връща към една много важна книга с изключително дългото заглавие „Всички са свободни. Русия една секунда преди Путин, или какво се обърка, как и защо“. Авторът на този монументален документ е Михаил Зигар – журналист, писател, военен кореспондент, бивш главен редактор на независимата телевизия „Дожд“, а сега живеещ в изгнание в Берлин. Книгата „играе на границата между журналистическо разследване, исторически анализ и почти романизирана реконструкция“ на президентските избори в Русия през 1996 г., довели Владимир Путин на власт и поставили началото на мащабното манипулиране на реалността в Русия. На подмяната на свободата и демокрацията с режисиран спектакъл, от който измъкването е трудно до невъзможно. И тази манипулация, оказва се, далеч не е патент на постсоциалистическа Русия.
В този контекст изключително важно е да опазим независимостта на медиите като инструмент за обществена самозащита срещу режисираната реалност. „Тоест“ вече започна осмата си година в служба на българското общество и демокрация.
Приятно четене и гледане!
The Bullet Cannon
Post Syndicated from The History Guy: History Deserves to Be Remembered original https://www.youtube.com/watch?v=wugzXrzI120
Comic for 2025.03.08 – I’m A Spy
Post Syndicated from Explosm.net original https://explosm.net/comics/im-a-spy
New Cyanide and Happiness Comic
Friday Squid Blogging: Squid Loyalty Cards
Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2025/03/friday-squid-blogging-squid-loyalty-cards.html
Squid is a loyalty card platform in Ireland.
Four more stable kernel updates
Post Syndicated from daroc original https://lwn.net/Articles/1013395/
Greg Kroah-Hartman has announced the release of four more stable kernels:
6.13.6,
6.12.18,
6.6.81, and
6.1.130.
Unlike a normal release, Kroah-Hartman did not call for all users to
update their kernels. Specifically, the 6.6.81 kernel is currently broken on
i386 systems, and users should wait for 6.6.82.
Ubuntu 25.04 (Plucky Puffin) progress
Post Syndicated from jzb original https://lwn.net/Articles/1013386/
Matthieu Clemenceau has published
a status update on Ubuntu 25.04 (Plucky Puffin) development to the Ubuntu
Discourse forum. This includes updates on Ubuntu’s adoption
of Dracut as an alternative to initramfs-tools, a move to
a single ISO for arm64 devices rather than device-specific images, and
reverting the planned O3 optimization flags for Plucky Puffin.
Earlier in this cycle, we announced
plans to enable the O3 optimization level for all Ubuntu packages
by default. As part of this effort, we conducted extensive
benchmarking, which revealed that while some workloads saw
improvements, overall system performance slightly declined, and binary
sizes increased. Given these results, we are likely to revert this
change soon.
The beta for Ubuntu 25.04 is planned
for March 27, with the final release scheduled on April 17.
Subminimum Wage
Post Syndicated from LastWeekTonight original https://www.youtube.com/watch?v=NwR0cEQx1i8
Training a call center fraud detection model for IVR calls with Amazon SageMaker Canvas
Post Syndicated from Pablo Forero original https://aws.amazon.com/blogs/architecture/training-a-call-center-fraud-detection-model-for-ivr-calls-with-amazon-sagemaker-canvas/
Fraud detection is a critical challenge for call centers, they need to provide a seamless customer experience while protecting the organization from fraudulent activities. Traditionally, call centers have relied on agents to manually screen calls, which can be time-consuming and expensive. Alternatively, companies might force customers to authenticate themselves every time they call, leading to a poor user experience. Machine learning (ML) offers a powerful solution that can help organization reach a harmonious balance between these approaches, enabling efficient and accurate fraud detection without compromising the customer experience.
This blog post will show you how to use the power of ML to build a fraud-detection model using Amazon SageMaker Canvas, a no-code/low-code ML service that business analysts and domain experts can use to build, train, and deploy ML models without requiring extensive ML expertise.
Background
In this solution, you will use a contact trace record (CTR) dataset from Amazon Connect. The solution works with data from other inbound telephony services provided they contain call specific metadata. Importantly, each call has been previously labeled based on past fraud detection efforts by the call center.
To start, you will enrich the raw CTR data using the phone number validation service from Amazon Pinpoint. Then, you will prepare the data using Amazon SageMaker notebooks and train a fraud detection model using SageMaker Canvas. Finally, to understand how to provide a scalable and cost-effective solution, you will explore how to deploy the model to a Sagemaker endpoint and right-size through autoscaling in a managed, serverless environment.
The following figure shows the architecture with the complete process including data enrichment, merging, cleanup, and model training and deployment. Throughout this blogpost we will reference the key parts as we implement them.

Data enrichment and preparation
Each CTR contains information about an incoming call such as agent, connection attempts, and channel. Before proceeding, you must transform the data into a tabular form (CSV, Parquet, or tables), which are the supported formats in SageMaker Canvas.
The raw CTR dataset doesn’t contain enough information to effectively train an ML model. You will enrich it using the Amazon Pinpoint validate API, which provides additional fields such as carrier, location data, and phone type. After you have the enriched dataset, you can use a SageMaker notebook to clean and prepare the data for training.
Enriching the data with Amazon Pinpoint validate API
Amazon Pinpoint includes a phone number validation service that you can use to determine if a phone number is valid and to obtain additional contact information. For example, the API response for a valid mobile phone number would look like the following:
{
    "NumberValidateResponse": {
        "Carrier": "ExampleCorp Mobile",
        "City": "Seattle",
        "CleansedPhoneNumberE164": "+12065550142",
        "CleansedPhoneNumberNational": "2065550142",
        "Country": "United States",
        "CountryCodeIso2": "US",
        "CountryCodeNumeric": "1",
        "OriginalPhoneNumber": "+12065550142",
        "PhoneType": "MOBILE",
        "PhoneTypeCode": 0,
        "Timezone": "America/Los_Angeles",
        "ZipCode": "98101"
    }
}
While the response for an invalid phone number would contain the following:
{
    "NumberValidateResponse": {
        "CleansedPhoneNumberE164": "+44163296076",
        "CleansedPhoneNumberNational": "163296076",
        "Country": "United Kingdom",
        "CountryCodeIso2": "GB",
        "CountryCodeNumeric": "44",
        "OriginalPhoneNumber": "+440163296076",
        "PhoneType": "INVALID",
        "PhoneTypeCode": 3
    }
}
There are multiple ways to enrich your dataset with this API. The response from the validate API call is a JSON document that contains all the fields. You will need to convert them to the appropriate format and merge them with the original CTR dataset. This will give you an enriched dataset that includes all the fields from the CTR and their corresponding validate results. The goal is to extract the caller phone number from each row in the dataset (CustomerEndpoint in Connect) and run it against the Amazon Pinpoint validate API.
The following figure shows an example architecture used to enrich with Amazon Pinpoint, cache in Amazon DynamoDB, and merge the datasets with Lambda functions. The DynamoDB cache saves the responses from Pinpoint by input key so that you don’t have to re-validate phone numbers.

Data engineering and data preparation
The first step is to clean up the data by discarding fields that aren’t adding any predictive value. This will make the training process faster and the model more accurate. For example, in the CTR data, the AWSAccountId field will be the same for all records, and the ContactId field will be unique, so you can discard them both. The goal is to simplify the dataset as much as possible using SageMaker Canvas to perform multiple experiments to better understand which fields in the data have the biggest impact on the prediction.
After you have reduced the dataset, you can select a random, smaller subset of data (for example, 1,000 records) and build a model in SageMaker Canvas. SageMaker Canvas provides a visual interface that you can use to rapidly build, train, and deploy ML models without the need for extensive coding.
To begin the training process, you will first import the prepared, enriched data file containing the CTR data into SageMaker Canvas. SageMaker Canvas will automatically detect the data format and structure, allowing you to preview the dataset and make any necessary adjustments before proceeding.
After the dataset is ready, you can select the fraud label as your target variable and configure the model training parameters. SageMaker Canvas will handle the underlying ML algorithms and hyperparameter tuning, streamlining the model development process.
After the model is trained, SageMaker Canvas will show an analysis of the fields and their weights. In addition to the build step—where you can drop and transform your imported dataset—SageMaker Canvas also includes Amazon SageMaker Data Wrangler, which you can use to prepare, featurize, and analyze your data. This allows you to do additional transformations as you experiment and iterate. You should continue to run these small experiments while making changes to the training dataset with the goal of getting the best performance from your model, while reducing the training time and the latency in inference.
After experimenting, you will identify the most important features and how you want to transform your data. When you’re confident in your model’s performance, you can decide how to deploy the trained model.
Final model deployment and right-sizing
Once your model is trained, you will need to deploy an endpoint so that you can invoke your model and consume the results via API. For example, the diagram below shows a Lambda Function calling the deployed endpoint. We continue to use the DynamoDB table as a cache. This way we avoid reprocessing numbers.

SageMaker Canvas offers a default deployment option where you can choose the instance type and number of instances to host the trained model that will meet your scaling needs. To help ensure that these instances aren’t over- or under-provisioned, SageMaker provides multiple features to help you optimize your deployment to your specific needs.
- Autoscaling: Autoscaling dynamically adjusts the number of instances provisioned for a model in response to workload changes. The steps to make this change are described in detail in Configure model autoscaling. SageMaker recently introduced Scale Down to Zero for AI inference, which allows endpoints to scale to zero instances during periods of inactivity and can help customers save costs.
- Inference recommender: Amazon SageMaker Inference Recommender reduces the time required to get ML models into production by automating load testing and model tuning across SageMaker ML instances.
- Serverless deployment: Amazon SageMaker Serverless Inference is a purpose-built inference option that you can use to deploy and scale ML models without configuring or managing any of the underlying infrastructure. Compute resources scale automatically depending on traffic, eliminating the need to choose instance types or manage scaling policies. To learn more, see Serverless endpoint operations.
To have use a serverless deployment and obtain inference recommendations, a single-container model is needed. This is currently not possible when using SageMaker Data Wrangler, because it generates two containers following data transformation: one for data preprocessing and one for model prediction.
After preparing the final dataset, you can bring it into SageMaker Canvas to train the detection model. Follow the same steps as you did with the smaller tests, making sure that you don’t use any of the data transformation options within SageMaker Canvas.
Depending on the size and complexity of the final dataset, the training process can take several hours to complete. After the training is complete, SageMaker Canvas will generate a trained model that you can immediately deploy to an endpoint.
Conclusion
By using the power of Amazon SageMaker Canvas, you can build, train, and deploy a robust fraud detection model, empowering your call center to deliver exceptional customer experiences while safeguarding your business and allowing your human agents to focus on legitimate customers.
You can begin testing SageMaker Canvas using the AWS Management Console today or learn more about SageMaker Canvas basics at the SageMaker Canvas Immersion Day workshop.
About the authors
Rayhunter: Device to Detect Cellular Surveillance
Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2025/03/rayhunter-device-to-detect-cellular-surveillance.html
The EFF has created an open-source hardware tool to detect IMSI catchers: fake cell phone towers that are used for mass surveillance of an area.
It runs on a $20 mobile hotspot.