Post Syndicated from The Atlantic original https://www.youtube.com/shorts/IIHMAuaG8NI
What the most popular Netflix shows tell us about the streamer’s algorithm
Post Syndicated from The Atlantic original https://www.youtube.com/shorts/5oNqIhP5utA
Friday Squid Blogging: Increased Squid Population in the Falklands
Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/03/friday-squid-blogging-increased-squid-population-in-the-falklands.html
Some good news: squid stocks seem to be recovering in the waters off the Falkland Islands.
As usual, you can also use this squid post to talk about the security stories in the news that I haven’t covered.
Избори 2026 – често задавани въпроси и грешки при заявленията за гласуване в чужбина
Post Syndicated from Боян Юруков original https://yurukov.net/blog/2026/iz2026-qa/
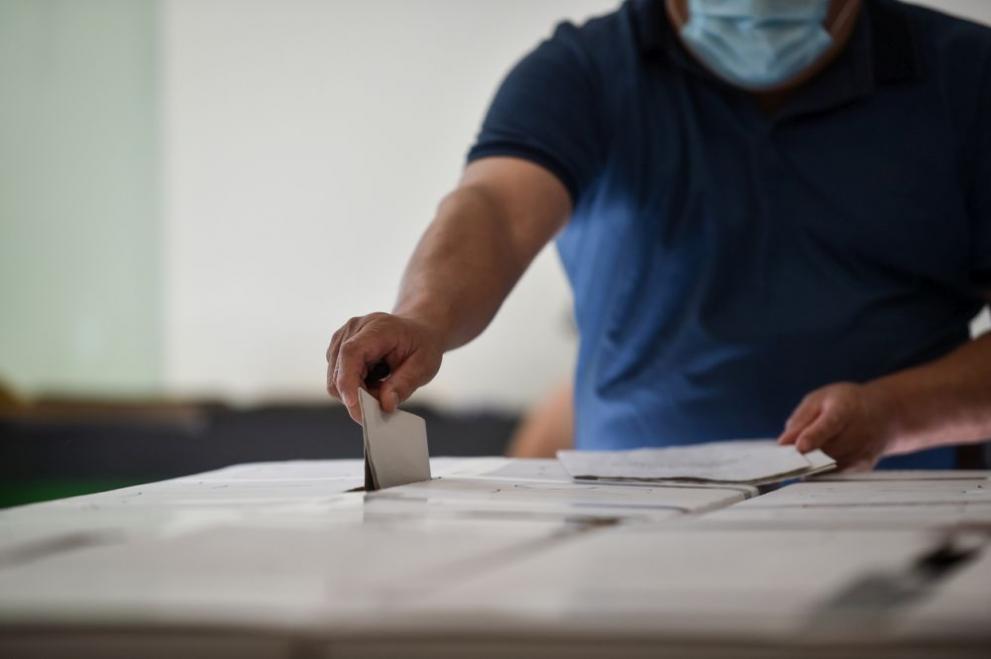
Преди седмица беше публикуван електронния формуляр за заявление за гласуване в чужбина. Разписах съвети как да се попълни. По-рано обясних защо е важно да се подават заявления, особено сега след въведените от мнозинството в парламента ограничения за българите зад граница да гласуват. Вчера показах и данни за активността на кампанията за събиране на заявления.
Доста хора обаче правят грешки при попълване на заявленията, не са сигурни дали могат или се налага да подават такива или не знаят какво следва. Затова ще събера тук списък с чести въпроси и грешки, с които аз и други сме се сблъсквали или се е налагало да обясняваме през различни канали. Тази седмица ЦИК също пусна своя страница с такива отговори. Някои от тях се припокриват със съветите и обясненията, които съм публикувал в последните години.
- Често се въвежда грешен email адрес. Например пропусната буква, грешен доставчик като gmail.com вместо abv или yahoo
- Изписват се имената или адрес на латиница или един или повече символи са на латиница. При проверка дава грешка. Ако нямат кирилица на компютъра или телефона, вдясно на полетата изискващи кирилица има бутон с глобус, който ще изкара виртуална клавиатура на кирилица.
- Въвежда се адрес в чужбина, а не в България. Не забравяйте, че трябва да се въведе постоянен адрес в България. Не споделяйте адреса си в чужбина. Трябва да се изпише както е по лична карта, за да бъде прието заявлението.
- Не въвеждат бащино име. Доколкото доста хора в чужбина не използват отдавна бащиното си име в официални документи там, по лична карта то все още съществува. Затова, ако имате такова, трябва да го въведете в полето. Ако по някаква причина нямате – например е махнато или сте родени в чужбина и никога не е добавяно, оставате полето празно. Валидацията с базата данни за населението ще потвърди дали има такова и дали съвпада.
- Въвеждат се грешно номерата на документа за самоличност. С новия формат въведен от юни 2024 г. вече има две букви в началото номерата на личните карти. Въвежда се именно номерът с двете букви, а не късият от 6 цифри под него. Това води до объркване. Под полетата има разяснения как трябва да се попълва.
- Заявленията за гласуване не могат да се променят или оттеглят. Подаване на заявление за гласуване в чужбина ви добавя в списъка на избраното място, което означава, че бихте могли да гласувате по-бързо спестявайки си формуляр, както и че има по-голяма вероятност да отворят секция близо до вас. Също така ви заличават от списъка по постоянен адрес в България. Някои хора се притесняват, че други ще гласуват от тяхно име в страната. По този начин си гарантирате, че това няма да стане.
- Може да се гласува където и да е в чужбина дори да сте подали заявление за едно място, а се окаже, че сте в дадения ден на друго. Тогава ще трябва да попълните ново заявление и декларация, че не сте гласували на друго място на този вот. Когато живеех в Германия дори подавах заявление за други места в Германия, за да помогна със събирането на заявления там и гласувах в Darmstadt, където имаше по-малко опашки от секциите във Франкфурт, които бяха по-близо до мен.
- Дори със заявление може да гласувате по постоянен адрес в България, ако в деня на вота се наложи да се приберете. За целта на място попълвате Приложение № 18-НС, с което ви възстановяват в избирателния списък. Вижте отговора на ЦИК на този въпрос. Понякога някои комисии не знаят за тази възможност и създават проблем. Тогава говорете с председателя на комисията, накарайте те го да се свърже с РИК да пита, покажете му отговора на ЦИК в линка горе и ако това не помогне, подайте жалба – длъжни са да я приемат и РИК да отговори незабавно.
- Може ли някой да гласува повече пъти. Технически е възможно някой да гласува по постоянен адрес и после да лети извън България и да гласува отново на едно или друго място. На всяко такова трябва да попълва декларации, че не е гласувал другаде. След изборите всички тези декларации се събират и сверяват с гласовете подадени в страната и чужбина. Като резултат биха хванали всички такива опити. Известни са ми дела в миналото срещу такива хора. Единични са, но са се случвали и последствия има.
- Натиснат е бутона за подаване на заявлението, но нищо не се случва. Проверете нагоре по формуляра дали някое поле не е в червено. При натискане на бутона се прави валидация и може да видите пропуснати полета или такива с грешни стойности
- Изпратено е заявлението, но не знам дали е прието. Ако нямате полета в червено за корекция и формата е изпратена, възможно е да получите грешка, която да посочи какъв е проблема. То ще опише какво да правите. Може да се наложи ново попълване в случай, че има грешна стойност, например изписване на име или адрес. Ако съобщението е в зелено, значи е прието. Тогава ще получите мейл за успешното подаване. Ако сте подали грешен email адрес, тогава няма да го получите обаче. Възможно е също да попадне в папката spam. Това няма да отмени подаденото заявление. Може да проверите в списъка с приетите заявления дали името Ви присъства. Ако не го намирате, може да погледнете и списъка с неприетите дали е имало проблем. Докато пиша това, има над 19 хиляди попълнени заявления и около 2800 неприети формуляри, т.е. име, номер на документ или адрес не съвпадат.
- Имам заявление за даден град, но не знам къде е секцията. Къде ще има секции и какви ще бъдат адресите им се определят след кампанията за събиране на заявления от ЦИК и по препоръка на МВнР. Роля за това има разрешение на приемащата страна, физическа възможност за секция, наличие на доброволци за организация и изборна комисия, ограниченията в Изборния кодекс и прочие. Точните адреси ще бъдат определени след 25-ти март и ще бъдат публикувани от посолствата на страницата на Външно. Ще ги публикувам на картата на Glasuvam.org както правя в последните 15 години. Ако сте абонирани за бюлетина ми с града, където живеете, ще получите 3-те най-близки до вас секции заедно с адресите им, както и последващи съобщения в случай, че те бъдат променени.
- Търсят се твърде много данни за идентификация. Наистина, цялата тази информация е налична в държавните институции. Въвеждаме я наново се във формуляра, тъй като не се изисква електронен подпис или друга форма на идентификация за подаване на заявлението за гласуване. Това би било излишно, ако беше въведена преди години електронната идентичност с чипове в личните карти и всеки можеше да се идентифицира електронно бързо и сигурно. Писал съм много затова беше баламирано от редица кабинети и най-вече МВР.
- Защо е нужно да се въвеждат дословно имена и адрес. Тези и други полета като данните от лична карта се сравняват с базата данни за населението. Това е начинът да се идентифицира човек и да се приеме, че заявлението се подава от самия човек при наличие на достатъчно лична информация въведена коректно. За целта дори една буква в името или адреса да е вярно би било в противоречие на този принцип.
- Ако все пак имате проблем, свържете се със [email protected] като посочите максимално много детайли. Важно е да се посочи информация, с която да се идентифицирате, за да се разбере за кое заявление става въпрос. Например кое име и кой email адрес е посочен във формуляра, ако се различава от адреса, от който пишете.
Какви други въпроси, неясни теми и чести грешки се сещате вие? Опишете ги в коментарите и ще допълня в статията. Ако виждате неточности, ще се радвам да ги обсъдим, за да поправя описанието си.
Project NOMAD Vibe Triage
Post Syndicated from Crosstalk Solutions original https://www.youtube.com/watch?v=Opk6EhTUkzg
Metasploit Wrap-Up 03/13/2026
Post Syndicated from Dean Welch original https://www.rapid7.com/blog/post/pt-metasploit-wrap-up-03-13-2026
No bad luck here: Friday the 13th brings new modules and a Metasploit Pro milestone
This week’s Metasploit Framework release delivers three new modules across reconnaissance, evasion, and exploitation: LeakIX-powered discovery for exposed services and leaked data, a Linux x64 RC4 payload packer for more flexible evasive delivery, and an unauthenticated RCE module for SPIP Saisies (CVE-2025-71243). Alongside those additions, we shipped practical quality-of-life improvements including a smaller configurable bind_netcat payload path, automatic WordPress service reporting in the WordPress mixin, and a fix for Base64Decoder defaults in shell payload workflows.
Finally, we’re also excited to share the new Metasploit Pro 5.0.0 release with an updated UI and SSO support amongst other changes, check out the announcement here: Announcing Metasploit Pro 5: Penetration Testing, Evolving.
New module content (3)
LeakIX Search
Authors: LeakIX [email protected] and Valentin Lobstein [email protected]
Type: Auxiliary
Pull request: #21002 contributed by Chocapikk
Path: gather/leakix_search
Description: Adds a new module auxiliary/gather/leakix_search, a new module for LeakIX API – a search engine focused on indexing internet-exposed services and leaked credentials/databases.
Linux RC4 Encrypted Payload Generator
Author: Massimo Bertocchi
Type: Evasion
Pull request: #20966 contributed by litemars
Path: linux/x64/rc4_packer
Description: Adds a new module evasion/linux/x64/rc4_packer packer that encrypts the generated payload with RC4, prepends an optional sleep-based delay (nanosleep), and decrypts/executes the payload at runtime via a compact precompiled stub.
SPIP Saisies Plugin Unauthenticated RCE
Authors: OpenStudio and Valentin Lobstein [email protected]
Type: Exploit
Pull request: #21001 contributed by Chocapikk
Path: multi/http/spip_saisies_rce
AttackerKB reference: CVE-2025-71243
Description: This adds a new module for CVE-2025-71243, an unauthenticated PHP code-injection vulnerability in the SPIP Saisies plugin. The injection takes place through _anciennes_valeurs, which allows an attacker to inject a PHP payload.
Enhancements and features (2)
- #20885 from dledda-r7 – Updates the bind_netcat payload to allow it to be smaller by selecting either default or BSD-style netcat command syntax. Previously, the payload ran both command syntaxes combined by an OR operator so wherever it was executed, the payload worked. The default behavior remains to run both, but in the event a user needs a significantly shorter payload, they can select a single netcat syntax and adjust the filenames.
- #20961 from Nayeraneru – This adds service reporting to WordPress mixin. Now, when you use a WordPress module, it will automatically report the target as WordPress if detected.
Bugs fixed (1)
- #21088 from jbx81-1337 – This adds a default value for the Base64Decoder option to fix an issue with shell payloads using the default base64 encoder.
Documentation
You can find the latest Metasploit documentation on our docsite at docs.metasploit.com.
Get it
As always, you can update to the latest Metasploit Framework with msfupdate and you can get more details on the changes since the last blog post from GitHub:
If you are a git user, you can clone the Metasploit Framework repo (master branch) for the latest. To install fresh without using git, you can use the open-source-only Nightly Installers or the commercial edition Metasploit Pro
Stable kernels for Friday the 13th
Post Syndicated from jzb original https://lwn.net/Articles/1062862/
Greg Kroah-Hartman has announced the release of the 6.19.8, 6.18.18, and 6.12.77 stable kernels. Each of these
kernels includes a number of important fixes; users are advised to
upgrade.
This Fixes Shaky Footage Instantly
Post Syndicated from Matt Granger original https://www.youtube.com/shorts/lSPd5WNiBJs
KYY K3 15.6in Portable Monitor Mini-Review
Post Syndicated from Sam Sabinash original https://www.servethehome.com/kyy-k3-15-6in-portable-monitor-mini-review/
The KYY K3 15.6in Portable Monitor is certainly not the fanciest, but it is a very inexpensive way to get more screen space.
The post KYY K3 15.6in Portable Monitor Mini-Review appeared first on ServeTheHome.
USAID’s Dismantling #lastweektonight
Post Syndicated from LastWeekTonight original https://www.youtube.com/shorts/PxcP98mb1aM
Why Is It So Hard to Make a Good Weather App?
Post Syndicated from The Atlantic original https://www.youtube.com/watch?v=ABMTwykaMZg
An investigation of the forces behind the age-verification bills
Post Syndicated from corbet original https://lwn.net/Articles/1062779/
Reddit user “Ok_Lingonberry3296” has posted the
results of an extensive investigation into the companies that are
pushing US state legislatures to enact age-verification bills.
I’ve been pulling public records on the wave of “age verification”
bills moving through US state legislatures. IRS 990 filings, Senate
lobbying disclosures, state ethics databases, campaign finance
records, corporate registries, WHOIS lookups, Wayback Machine
archives. What started as curiosity about who was pushing these
bills turned into documenting a coordinated influence operation
that, from a privacy standpoint, is building surveillance
infrastructure at the operating system level while the company
behind it faces zero new requirements for its own platforms.
(See also this article for a look at the
California law.)
A set of AppArmor vulnerabilities
Post Syndicated from corbet original https://lwn.net/Articles/1062778/
Qualys has sent out a
somewhat breathless advisory describing a number of vulnerabilities in
the AppArmor security module, which is used in a number of Debian-based
distributions (among others).
This “CrackArmor” advisory exposes a confused-deputy flaw allowing
unprivileged users to manipulate security profiles via
pseudo-files, bypass user-namespace restrictions, and execute
arbitrary code within the kernel. These flaws facilitate local
privilege escalation to root through complex interactions with
tools like Sudo and Postfix, alongside denial-of-service attacks
via stack exhaustion and Kernel Address Space Layout Randomization
(KASLR) bypasses via out-of-bounds reads.
[$] More timing side-channels for the page cache
Post Syndicated from daroc original https://lwn.net/Articles/1061743/
In 2019, researchers published a way to
identify which file-backed pages
were being accessed on a system using timing information from the page cache,
leading to a handful of unpleasant consequences and a change to the design of
the
mincore() system call. Discussion at the time
led to a number of ad-hoc patches to address the
problem. The lack of new page-cache attacks suggested that attempts to fix
things in a piecemeal fashion had succeeded. Now, however, Sudheendra Raghav Neela,
Jonas Juffinger, Lukas Maar, and Daniel Gruss have
found a new set of
holes in the Linux kernel’s page-cache-timing protections that allow
the same general class of attack.
Security updates for Friday
Post Syndicated from jzb original https://lwn.net/Articles/1062775/
Security updates have been issued by Debian (chromium, kernel, and multipart), Fedora (dnf5, dr_libs, easyrpg-player, libmaxminddb, python3.12, strongswan, task, and udisks2), Oracle (.NET 10.0, .NET 8.0, .NET 9.0, gnutls, ImageMagick, kernel, libvpx, mingw-libpng, nginx:1.26, python3.11, and uek-kernel), Red Hat (delve, git-lfs, mingw-libpng, osbuild-composer, and rhc-worker-playbook), SUSE (cjson, curl, dnsdist, libsoup2, postgresql16, postgresql17, postgresql18, python-lxml_html_clean, python-pypdf2, python36, and thunderbird), and Ubuntu (dotnet8, dotnet9, dotnet10, freetype, golang-github-go-git-go-git, golang-golang-x-net, openssh, python-cryptography, sudo, and util-linux).
На прощаване Борисов пие кафе
Post Syndicated from Емилия Милчева original https://www.toest.bg/na-proshtavane-borisov-pie-kafe/

Интервютата на лидера на ГЕРБ Бойко Борисов при видни инфлуенсъри би трябвало да минат за self-promo, но звучат като на прощаване. Борисов се сбогува с величието си. Макар да не спира да лее похвални слова за труда, който е положил за Отечеството.
Тонът е смесица от носталгия, самохвалство и историческа ретроспекция – припомня постиженията си, като магистралите и усилията по европейските интеграции, но вече не е първата политическа сила в България. Сякаш се опитва да маркира „завършване на цикъл“ преди неизбежната трансформация на ГЕРБ.
Sic transit gloria Boyki*
Емилия Милчева разнищва брауновото движение вследствие на създалото се в триъгълника на властта напрежение – и най-вече хаотичните танцови стъпки на Борисов, който непрестанно настъпва опърпания шлейф на партията си и се препъва в него.
 Емилия Милчева
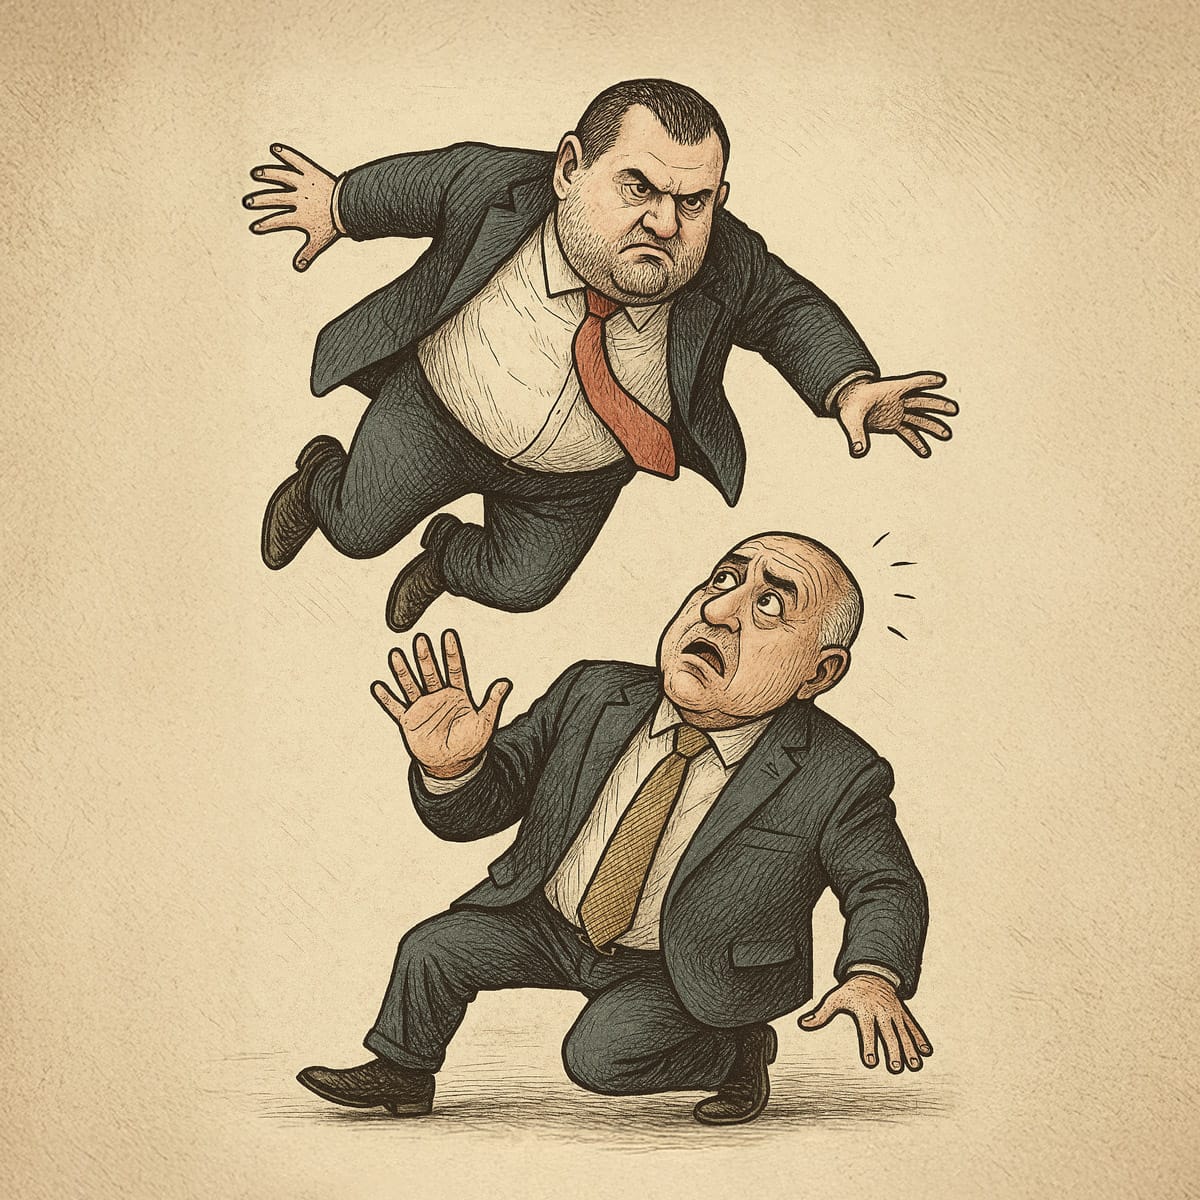
Започна политическата си кариера блестящо, нещо средно между Тодор Живков след Априлския пленум и Рамбо, и четвърт век по-късно е послушник на Пеевски.
След 19 април Бойко Борисов вече няма да е първи в българската политика и партията му няма да е същата. Затова минава през Явор Дачков, през Карбовски, пие кафе с Кристина Патрашкова и ни пуска още един път ония парчета, които толкова радваха навремето, когато бюра в канцеларии и маси във фризьорски салони бяха украсени със снимка календарче на Бате Бойко. Даже някои го рисуваха на капака на колите си.
Сега лафчетата вече се изтъркаха.
Възходът на Пеевски в политиката е вследствие на действията на ПП–ДБ. Те знаеха, че аз ще довърша цикъла на ГЕРБ – трите гилотини, които висяха над главите ни: еврозона, Шенген, мониторингов механизъм. И трите съм ги изчистил! Румен Радев е „нова“ звезда… на 10 години. Той беше министър-председател вече два пъти – вместо Стефан Янев и Гълъб Донев. (Пред Явор Дачков)
България успява да балансира между големите сили, да защитава националните си интереси и да запази енергийната си сигурност и въглищната си индустрия – без нелегална миграция и без уроци по инакомислие в училищата. (Пред Явор Дачков)
За 1300 години съм направил най-много магистрали. (Пред Мартин Карбовски)
Водя най-скромния живот, който някой живее. Там, където съм се родил, там ще си пукна… Знайни и незнайни глупаци да обясняват как съм изнесъл тонове със злато. Той не си представя какво е тон злато. Къде бе, у коя банка бе, нещастници долни?! (Пред Мартин Карбовски)
Когато Румен Радев управляваше еднолично по старата конституция, подписа договор, с който извади 6 милиарда от джоба на българите. Щом българите го харесват, следващите след Радев ще направят договор за 60 милиарда. (Пред Кристина Патрашкова)
Свърши правителството, свършиха и отношенията ни с Пеевски. (Пред Кристина Патрашкова)
Борисов и Пеевски. Разхерметизация?
Ясно е, че никой не иска да е отдолу, когато падне Пеевски. Въпросът е кой наднича зад сгромолясващите се фигури. Добре смазаната машина за влияние не търпи вакуум. От Емилия Милчева.
 Емилия Милчева
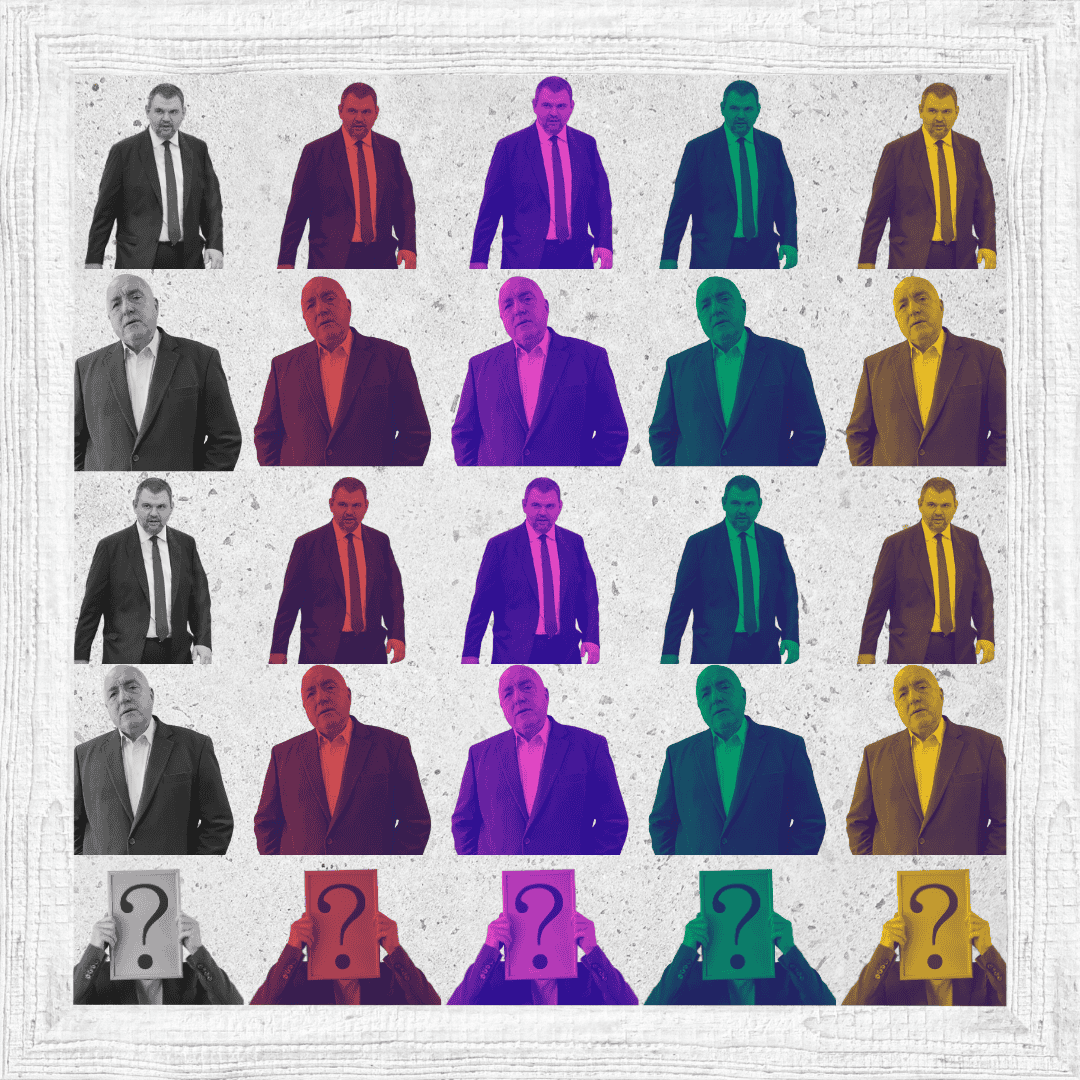
Дали санкционираният за корупция от САЩ и Великобритания Пеевски знае, че отношенията са прекратени? Сигурно Борисов е пропуснал да му каже, защото само преди ден ГЕРБ игнорира собственото си решение да остави на следващия 52-ри парламент решението за ратификация на договора за Борда за мир – организация, учредена от американския президент Доналд Тръмп като алтернатива на ООН. На 22 януари в Давос България и Унгария бяха единствените държави от ЕС сред учредителите.
Бившият вече премиер Росен Желязков подписа присъединяването на България към Борда, макар да беше в оставка. Още тогава лидерът на ДПС – Ново начало поиска парламентът да ратифицира документа. ГЕРБ обаче не го предложи за гласуване в Народното събрание. Най-напред Желязков каза, че ще го внесе, по-късно обаче министърът на външните работи Георг Георгиев обяви, че остава за следващия парламент.
Но Пеевски не се отказва. В последните дни на парламента, преди депутатите да излязат в едномесечен отпуск заради предизборната кампания, той отново направи опит да вкара предложение от името на парламентарната група на ДПС – Ново начало, с което да задължи правителството да внесе за ратификация договора за присъединяване към Борда за мир. Изглежда, повярвал е, че ще му бъде въздадено за заслугите от американска страна и ще паднат санкциите по „Магнитски“.
Обсъждането на договора не успя да мине през Комисията по външна политика, председателствана от Йорданка Фандъкова (ГЕРБ). Попречи му липсата на кворум. Председателстваната от Христо Гаджев (ГЕРБ) Комисия по отбрана обаче му даде зелена светлина с подкрепата на ДПС – Ново начало и правоверните на ГЕРБ „Има такъв народ“.
Макар първоначално да имаше съмнения, че предложението ще мине в пленарната зала заради разцеплението в БСП, то беше прието без гласовете на социалистите. Подкрепиха го от ГЕРБ–СДС, ДПС – Ново начало и „Има такъв народ“.
Това беше едно от редките гласувания, в които ПП–ДБ, „Величие“ и „Възраждане“ бяха в един и същи лагер „против“. Костадин Костадинов още при учредяването на Борда за мир смяташе, че за ратификацията трябва да решат бъдещите депутати:
Това е задача, която трябва да бъде осъществена от следващ кабинет и от следващото Народно събрание.
Д. Анатомия на властта
Буквата „д“, особено главната, става все по-важна в нашата държава. Дали да не предложим референдум азбуката да започва с нея? Д като държава, Д като дизайн на властта, Д като Делян. От Емилия Милчева.
 Емилия Милчева
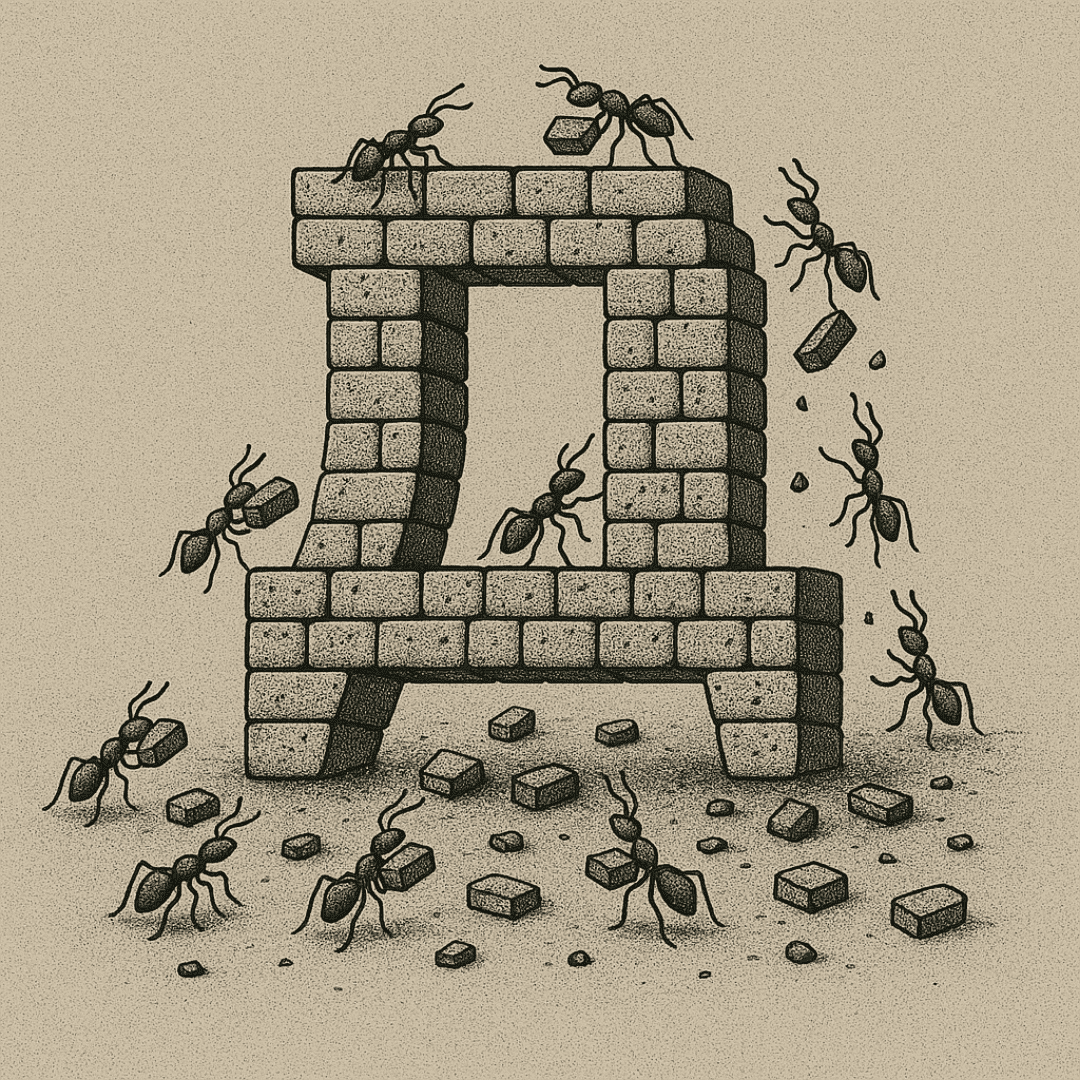
Така Борисов отново засвидетелства вярност към Пеевски, в каквото и да се кълне пред инфлуенсърите. Нищо не е приключило, всичко си е постарому.
Под тежестта на голямото Д, ГЕРБ изгуби своя европейски образ,
коментираха от „Да, България“ по този повод.
Съмнения обаче има и за единението на ГЕРБ по отношение на документа. При задаващата се буря, която ще ги помете от първото място, изявени фигури от партията търсят свое ново политическо гнездо.
След свадата с Делян Добрев, който уж напусна, пък се върна за по-малко от 24 часа, сега се разбунтува Живко Тодоров, който кара своя четвърти мандат като кмет на Стара Загора. Тодоров отказва да е водач на листите на ГЕРБ за региона – да слага успешни кметове начело е практика, използвана от партията. Допреди няколко години Борисов може би щеше да го изхвърли от партията за неподчинение, скалъпвайки нещо с обвинителен уклон.
Но не и сега, когато исполин като ГЕРБ се разклаща, за да отстъпи на „Прогресивна България“ (прогресът да се чете като килийно училище, не като либерализъм).
Отказът на Живко Тодоров да бъде водач на листата на ГЕРБ в Стара Загора е ясен симптом за вътрешна нестабилност на партията и за настъпващата ера на преориентации. Тодоров, който е една от най-успешните фигури на ГЕРБ в района на Стара Загора, отказва да следва традиционната партийна дисциплина – знак, че влиянието на Борисов вече не е безусловно.
Този случай илюстрира как регионалните лидери започват да изследват политическите си алтернативи, подготвяйки се за етапа „след Борисов“ и за евентуалното разцепление или пренастройка на вътрешнопартийната йерархия. Лидерът на ГЕРБ е безсилен пред непокорните кметове – не е на власт, за да прекрати финансиране на проекти например, а и догодина са местните избори и добрите отношения с тези кметове трябва да бъдат запазени. Стига да успее. ГЕРБ и ДПС са монополисти в местната власт, което осигурява не само изборна „инфраструктура“ и контрол върху регионалните мрежи на влияние, но и стабилен политически тил, който трудно се разклаща от парламентарни кризи или от смяна на правителства.
Поход към прогреса. И още банани
Коалиция без партия, лозунги без програма и лидер, който стои „над“ собствената си конструкция. Походът на Румен Радев към властта започва с познат модел и много въпроси какво всъщност стои зад обещанията. От Емилия Милчева.
 Емилия Милчева
Борисов преживява символично „сбогуване“ – припомня собствените си постижения и критикува съвременните лидери, но реалността е, че влиянието му вече се топи.
Отношенията му с Делян Пеевски, съюзник и ключова фигура в парламента, са обтегнати. А опитите да бъде отстранен и.ф. главен прокурор Борислав Сарафов от поста, който заема нелегитимно, изнервят Борисов.
Самият Сарафов стои в кабинета като заложник на сложния баланс между политическите интереси на Борисов и натиска на Пеевски. Изглежда, че ще остане, докато в следващия парламент не се формира мнозинство от 160 депутати за избор на нов ВСС, който от своя страна да избере нов главен прокурор.
Възможно ли е олигархът Пеевски да остане в политическа изолация, след като беше дорийска колона за две правителства (на Николай Денков (ПП) и на Росен Желязков (ГЕРБ)? Най-добре да свиква.
Backblaze Now Serving 314 Trillion Digits of Pi
Post Syndicated from Stephanie Doyle original https://www.backblaze.com/blog/backblaze-now-serving-314-trillion-digits-of-pi/
Lots of us were taught that pi equals 3.14. Maybe 3.14159 if your teacher was ambitious. Akira Haraguchi, who holds the Guiness Book of World Records title for reciting the most digits of pi in a single run, got up to 100,000 digits in 16 hours.
That’s still only a fraction of the record digits of pi that are calculated—3.18471338 × 10⁻⁸% to be exact. So why do we need that much pi?
A pi record isn’t a burst workload. It’s a system that runs at sustained pressure for months, writing checkpoints, flushing buffers, and proving that nothing quietly breaks. Last December, StorageReview set a new record, calculating 314 trillion digits on a Dell PowerEdge R7725.
In honor of Pi Day, Backblaze B2 Cloud Storage has teamed up with StorageReview to host that dataset, which totals over 130TB. The pi dataset is generally available, publicly accessible, and structured for large-scale retrieval and analysis.
Why pi remains a compute benchmark
Pi has long served as a proving ground for computational systems because it offers a deterministic workload with clear correctness criteria and sustained compute and input/output (I/O) demands. Records in pi computation trace back decades and reflect both mathematical and computational advances. In 1949, ENIAC—the first programmable, electronic, general-purpose, digital computer—computed 2,037 digits of pi in about 70 hours, an early demonstration of electronic computing capability that was eventually published in the paper, “The ENIAC’S 1949 Determination of π.”
Algorithms have evolved significantly since then. The Chudnovsky algorithm, developed in 1988, is one of the fastest converging methods for high-precision pi calculation and has been used in many modern record attempts because of its efficiency at large digit counts.
Pi calculations do not mirror typical enterprise workloads such as databases or machine learning training, but their determinism and large scale make them useful for evaluating sustained performance of CPU, memory, and storage subsystems under continuous load. It’s also used in various security functions including random number generation (because computers can’t be truly random), cryptographic algorithms, hash functions, digital signatures, and secure communications protocols like SSL/TLS.
What the 314 trillion digit run represents
In December 2025, StorageReview reported a new record by calculating pi to 314 trillion digits on a single server that ran continuously for approximately 110 days before completion. The achievement emphasizes not only the scale of the computation but also the role of storage architecture, non-uniform memory-access (NUMA) tuning, and system stability in sustaining such a workload.
The raw output of the run, including checkpoints, extended beyond 2PB of data. The finalized dataset hosted in Backblaze B2 exceeds 130TB and is divided into 200GB objects suitable for staged retrieval.
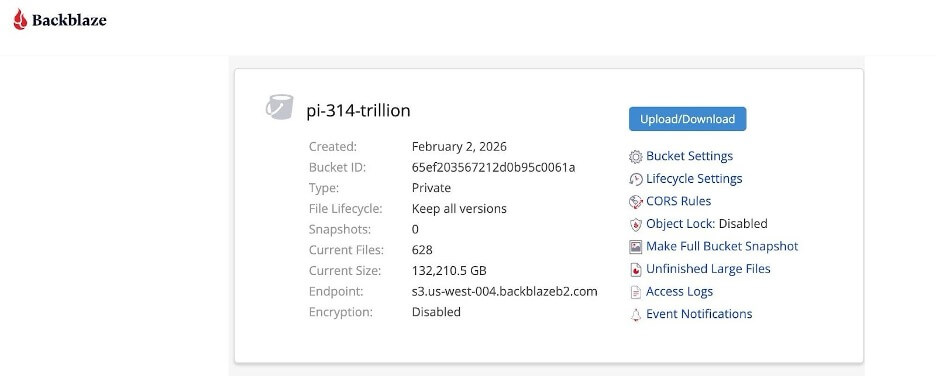
Engineers, researchers, and pi enthusiasts can freely retrieve their own slice of pi (or the whole thing) for analysis, performance characterization, and tool validation. Structuring the dataset into manageable objects enables selective download for analysis, parallelized workflow testing, and evaluation of sustained object retrieval performance.
How to access the dataset
The 314 trillion-digit dataset is available today via Backblaze B2 Cloud Storage.
To request access:
- Visit the pi landing page.
- Submit the required information to receive credentials.
- Use the provided instructions to download via rclone, an open-source cloud storage management tool.
The object layout supports both partial and full dataset retrieval strategies.
Enjoy your pi!
With all the ways you can use the pi dataset, we can’t wait to hear what you all are working on. Feel free to let us know what you’re working on in the comments section below, on socials, or by email.
Happy experimenting!
The post Backblaze Now Serving 314 Trillion Digits of Pi appeared first on Backblaze Blog | Cloud Storage & Cloud Backup
Twenty years of Amazon S3 and building what’s next
Post Syndicated from Sébastien Stormacq original https://aws.amazon.com/blogs/aws/twenty-years-of-amazon-s3-and-building-whats-next/
Twenty years ago today, on March 14, 2006, Amazon Simple Storage Service (Amazon S3) quietly launched with a modest one-paragraph announcement on the What’s New page:
Amazon S3 is storage for the Internet. It is designed to make web-scale computing easier for developers. Amazon S3 provides a simple web services interface that can be used to store and retrieve any amount of data, at any time, from anywhere on the web. It gives any developer access to the same highly scalable, reliable, fast, inexpensive data storage infrastructure that Amazon uses to run its own global network of web sites.
Even Jeff Barr’s blog post was only a few paragraphs, written before catching a plane to a developer event in California. No code examples. No demo. Very low fanfare. Nobody knew at the time that this launch would shape our entire industry.
The early days: Building blocks that just work
At its core, S3 introduced two straightforward primitives: PUT to store an object and GET to retrieve it later. But the real innovation was the philosophy behind it: create building blocks that handle the undifferentiated heavy lifting, which freed developers to focus on higher-level work.
From day one, S3 was guided by five fundamentals that remain unchanged today.
Security means your data is protected by default. Durability is designed for 11 nines (99.999999999%), and we operate S3 to be lossless. Availability is designed into every layer, with the assumption that failure is always present and must be handled. Performance is optimized to store virtually any amount of data without degradation. Elasticity means the system automatically grows and shrinks as you add and remove data, with no manual intervention required.
When we get these things right, the service becomes so straightforward that most of you never have to think about how complex these concepts are.
S3 today: Scale beyond imagination
Throughout 20 years, S3 has remained committed to its core fundamentals even as it’s grown to a scale that’s hard to comprehend.
When S3 first launched, it offered approximately one petabyte of total storage capacity across about 400 storage nodes in 15 racks spanning three data centers, with 15 Gbps of total bandwidth. We designed the system to store tens of billions of objects, with a maximum object size of 5 GB. The initial price was 15 cents per gigabyte.
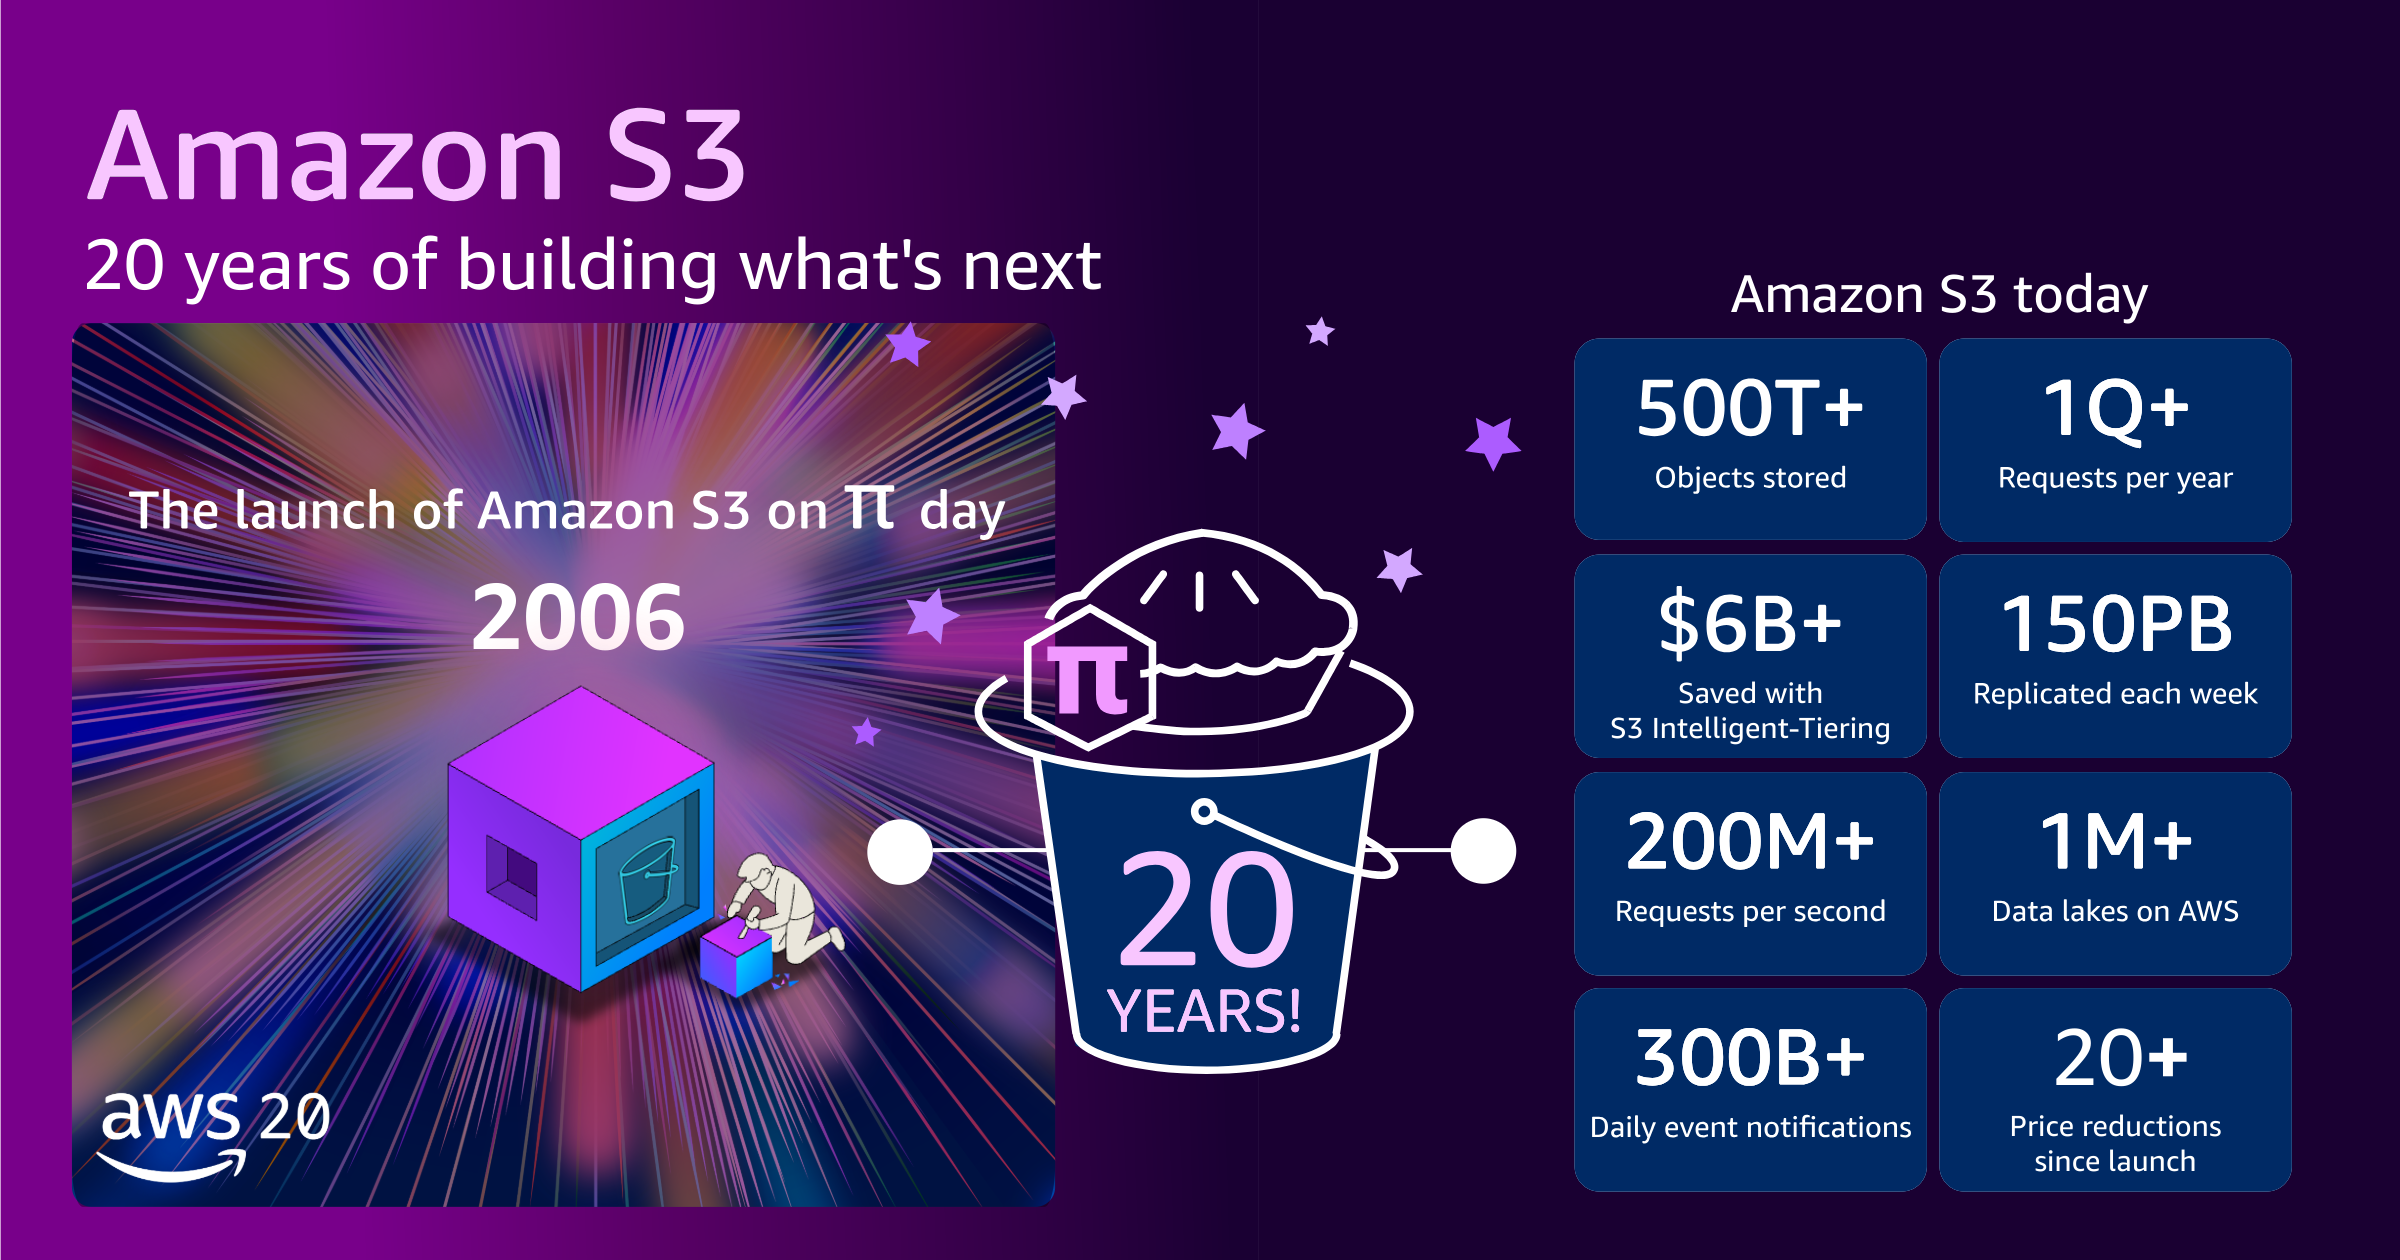
Today, S3 stores more than 500 trillion objects and serves more than 200 million requests per second globally across hundreds of exabytes of data in 123 Availability Zones in 39 AWS Regions, for millions of customers. The maximum object size has grown from 5 GB to 50 TB, a 10,000 fold increase. If you stacked all of the tens of millions S3 hard drives on top of each other, they would reach the International Space Station and almost back.
Even as S3 has grown to support this incredible scale, the price you pay has dropped. Today, AWS charges slightly over 2 cents per gigabyte. That’s a price reduction of approximately 85% since launch in 2006. In parallel, we’ve continued to introduce ways to further optimize storage spend with storage tiers. For example, our customers have collectively saved more than $6 billion in storage costs by using Amazon S3 Intelligent-Tiering as compared to Amazon S3 Standard.
Over the past two decades, the S3 API has been adopted and used as a reference point across the storage industry. Multiple vendors now offer S3 compatible storage tools and systems, implementing the same API patterns and conventions. This means skills and tools developed for S3 often transfer to other storage systems, making the broader storage landscape more accessible.
Despite all of this growth and industry adoption, perhaps the most remarkable achievement is this: the code you wrote for S3 in 2006 still works today, unchanged. Your data went through 20 years of innovation and technical advances. We migrated the infrastructure through multiple generations of disks and storage systems. All the code to handle a request has been rewritten. But the data you stored 20 years ago is still available today, and we’ve maintained complete API backward compatibility. That’s our commitment to delivering a service that continually “just works.”
The engineering behind the scale
What makes S3 possible at this scale? Continuous innovation in engineering.
Much of what follows is drawn from a conversation between Mai-Lan Tomsen Bukovec, VP of Data and Analytics at AWS, and Gergely Orosz of The Pragmatic Engineer. The in-depth interview goes further into the technical details for those who want to go deeper. In the following paragraphs, I share some examples:
At the heart of S3 durability is a system of microservices that continuously inspect every single byte across the entire fleet. These auditor services examine data and automatically trigger repair systems the moment they detect signs of degradation. S3 is designed to be lossless: the 11 nines design goal reflects how the replication factor and re-replication fleet are sized, but the system is built so that objects aren’t lost.
S3 engineers use formal methods and automated reasoning in production to mathematically prove correctness. When engineers check in code to the index subsystem, automated proofs verify that consistency hasn’t regressed. This same approach proves correctness in cross-Region replication or for access policies.
Over the past 8 years, AWS has been progressively rewriting performance-critical code in the S3 request path in Rust. Blob movement and disk storage have been rewritten, and work is actively ongoing across other components. Beyond raw performance, Rust’s type system and memory safety guarantees eliminate entire classes of bugs at compile time. This is an essential property when operating at S3 scale and correctness requirements.
S3 is built on a design philosophy: “Scale is to your advantage.” Engineers design systems so that increased scale improves attributes for all users. The larger S3 gets, the more de-correlated workloads become, which improves reliability for everyone.
Looking forward
The vision for S3 extends beyond being a storage service to becoming the universal foundation for all data and AI workloads. Our vision is simple: you store any type of data one time in S3, and you work with it directly, without moving data between specialized systems. This approach reduces costs, eliminates complexity, and removes the need for multiple copies of the same data.
Here are a few standout launches from recent years:
- S3 Tables – Fully managed Apache Iceberg tables with automated maintenance that optimize query efficiency and reduce storage cost over time.
- S3 Vectors – Native vector storage for semantic search and RAG, supporting up to 2 billion vectors per index with sub-100ms query latency. In only 5 months (July–December 2025), you created more than 250,000 indices, ingested more than 40 billion vectors, and performed more than 1 billion queries.
- S3 Metadata – Centralized metadata for instant data discovery, removing the need to recursively list large buckets for cataloging and significantly reducing time-to-insight for large data lakes.
Each of these capabilities operates at S3 cost structure. You can handle multiple data types that traditionally required expensive databases or specialized systems but are now economically feasible at scale.
From 1 petabyte to hundreds of exabytes. From 15 cents to 2 cents per gigabyte. From simple object storage to the foundation for AI and analytics. Through it all, our five fundamentals–security, durability, availability, performance, and elasticity–remain unchanged, and your code from 2006 still works today.
Here’s to the next 20 years of innovation on Amazon S3.
Тоест разговаряме – епизод 8
Post Syndicated from Владислав Севов original https://www.toest.bg/toest-razghovaryame-epizod-8/

В този епизод на „Тоест разговаряме“ с изследователката и преподавателка арх. Анета Василева обсъдихме архитектурата не просто като професия, а като обществена отговорност. Тръгнахме от войните и разрушаването на градовете и стигнахме до ежедневната среда, в която живеем, както и до въпроса как архитектите и обществото трябва да мислят за бъдещето на градовете.
Основна тема беше и ролята на критиката – защо говоренето и писането за архитектура става все по-трудно в съвременните медии, и то във времена, когато този дебат е по-необходим от всякога. Стана дума и за книгите като по-бавна и устойчива форма на разговор, за дигиталната среда и за нуждата да пазим паметта за архитектурата на близкото минало. Епизодът мина и през конкретни примери – от инициативите на „Ново архитектурно наследство“ до въпроса как се съчетават различните исторически слоеве в градовете ни и защо качеството на пространствата е въпрос не само на архитектура, но и на обществен избор.
Гледайте целия разговор в нашия YouTube канал:
Може да го чуете и като аудиозапис в SoundCloud:
Помолих Анета да отговори тук на още един зрителски въпрос:
Има ли бъдеще архитектурната професия?
Преди около седмица излезе едно проучване на американската ИИ компания „Антропик“ (онази същата, която се противопостави на Тръмп) кои професии биха могли в бъдеще да се заместят от изкуствен интелект. Архитектурата беше сред първите десет. Значи ли това, че архитектите нямат бъдеще? По-скоро го приемам като предупреждение за професията да не забравя смисъла си. Разбира се, че ако само правим 3D визуализации на закони, наредби и градоустройствени ограничения, няма как да имаме бъдеще. Но не мисля, че една архитектура, която се интересува от среда, общности и контекст, стратегически решава комплексни проблеми и комбинира социални и естетически задачи, ще бъде застрашена. Поне засега.
Преди срещата ви помолихме да отговорите на кратката ни анкета. Ето и резултатите от нея:
Градът за хората е … направен по човешка, не по автомобилна мяра. Приветлив, гостоприемен, достъпен за хора с увреждания с пешеходни зони, места за разходка и почивка, велосипедни алеи, добър обществен транспорт, активни фасади и без подлези. Долу подлезите!
Анета Василева е доктор по история и теория на архитектурата и специализира в областта на архитектурата след Втората световна война и опазването на архитектурното наследство. Преподава в УАСГ, член е на БНК на ИКОМОС, на Международния комитет по образование и обучение на DOCOMOMO International и на българската група към същата организация. Съоснователка е на Фондация „Ново архитектурно наследство“, на ГРАДОСКОП и на WhATA. Книгата ѝ „Kicked a Building Lately?*. Архитектурна критика след дигиталната революция“ (изд. „Кралица Маб“, 2024) събира голяма част от критическите ѝ текстове, писани през последните над 15 години за различни издания, в т.ч. и за „Тоест“. Всеки момент предстои да излезе и книгата „Неудобната модерност. Българската архитектура след Втората световна война“ (изд. „Жанет 45“, 2026).
Следващата среща на „Тоест разговаряме“ ще бъде с Надежда Цекулова – авторка в „Тоест“ по теми за образованието и здравеопазването, а в последната една година води рубриката „Анатомия на пола: Жена“. Разговорът ще се излъчва на живо в YouTube Live на 4 април, събота, от 16:00 ч.
В „Тоест разговаряме“ всеки месец ви срещаме с автори, които познавате добре от анализите или от рубриките им в „Тоест“, но този път ще ги видите и чуете в по-личен и непосредствен формат. Във видеоразговорите, предавани на живо, активно участие имате и вие, нашата публика – със своите въпроси, коментари и включване в тематичната анкета. Водещ на поредицата е Владислав Севов, дългогодишен телевизионен журналист и съосновател на „Тоест“.
„Тоест разговаряме“ е поредица, подкрепена от Институт „Отворено общество – София“ и съфинансирана от Европейския съюз в рамките на проекта Media Resilience. Изразените възгледи и мнения са само и изцяло на техните автори и не отразяват непременно възгледите и мненията на Европейския съюз, на Европейската изпълнителна агенция за образование и култура (EACEA) или на Институт „Отворено общество – София“ (ИООС). Нито Европейският съюз, нито EACEA, нито ИООС могат да бъдат държани отговорни за тях.
Explosion at the Confederate Ordnance Laboratory
Post Syndicated from The History Guy: History Deserves to Be Remembered original https://www.youtube.com/watch?v=JS6OdfMCtnA