Откъси от Украйна: Чухте ли сирените?

Post Syndicated from original https://www.toest.bg/otkusi-ot-ukraina/

Откъси от Украйна: Чухте ли сирените?

Виждаме последния блокпост с разположени по пътя противотанкови стоманени „таралежи“ и бетонен бункер, от който стърчи дуло на оръдие. Мъже във военни униформи ни махват да продължим към града. Пълзим бавно и следваме навигацията. Тогава я чуваме. Сирената вие силно над целия град. Мъжки глас от високоговорителя ни предупреждава да потърсим убежище. В този момент колата ни минава покрай военно поделение. На пътя пред нас изскачат двама военни с автомати в ръце и спират движението. Голяма метална врата се плъзва с трясък встрани и през нея излизат няколко камиона. В каросериите им има оръдия. Дулата им са покрити с камуфлажни мрежи. Сирената не спира да вие. Приложението за въздушна тревога на телефона ми бясно вибрира и оцветява картата на Украйна в кървавочервено. Камионите със скорост вземат първия завой, към който се насочваме и ние веднага щом военните на пътя ни пускат да продължим.

Стъписани, не спираме да говорим за сирената, за камионите с оръдия, дали да търсим бомбоубежище, къде ли е най-близкото, какво да правим, ако започне обстрел, как да се защитим. В такъв момент

чужденец като мен дори не осъзнава опасността, защото никога не е преживявал въздушен обстрел с ракета или дрон.

Само тревогата от неизвестното свива сърцето и стомаха, а погледът се забива в небето без ясна посока, сякаш, ако видиш ракетата, ще знаеш как да се защитиш.

Виница е град на около 300 километра южно от Киев, разположен точно под него. Там е първата спирка от пътуването ни в Украйна в края на август 2023 г.

Чухте ли сирените?

Алла ни посреща пред къщата си с питка и сол. Хуквам да я прегърна. Не знам защо плача. С нея и дъщеря ѝ се запознахме в началото на войната, през март 2022 г. Те бяха в България, без дом и много уплашени. През целия им престой се опитвах да им помогна с каквото мога, за да живеят спокойно в София. В навечерието на 2023-та се върнаха в Украйна.

Чухме ги, но бързахме да дойдем при теб.

Казвам ѝ през сълзи и смях, напълно забравила за въздушната тревога.

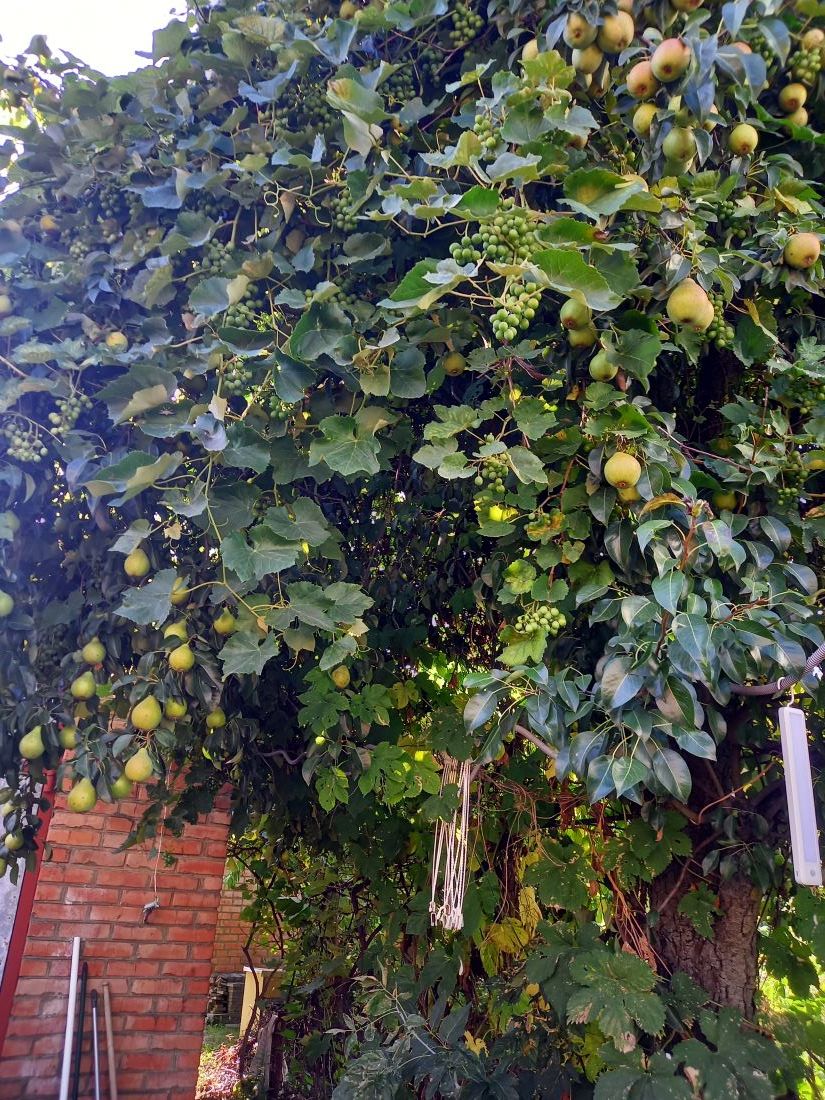
Домът им е типичната украинска малка едноетажна къща. Дворче, градина с цветя, домати, краставици, чушки и няколко тикви. Голяма круша, отрупана с плодове, е надвиснала над масата на двора. Сергей, мъжът на Алла се смее, докато ни показва как в клоните на крушата се е оплела асма, от която висят гроздове. Получило се е голямо сюрреалистично дърво с круши и грозде.
Откъси от Украйна: Чухте ли сирените?
Виница, в двора на Алла © Личен архив

Там за първи път усетих контраста, който ме преследва през всичките петнайсет дни в Украйна –  феномена на тази страна, която воюва и в същото време се опитва да живее нормално. Постоянен сблъсък между напрежението от виещите сирени, концентрираните погледи на хората по улиците, едва забележимо изопнатите, сякаш настръхнали тела, и в същото време непрестанното усилие да се създаде спокойствие навсякъде.

По време на вечеря Алла споменава между многото приказки:

Е, нямаше повече въздушни тревоги днес.

Сънувам не бомби и ракети, а десетките украински жени, с които разговарях в България през тази година и половина, откакто Русия нападна Украйна. Жените бягаха от войната и това, което най-много ме впечатляваше тогава, при първите ми срещи с тях, беше как постоянно гледат в телефоните си. Чудех се какво гледат. Когато се събудих сутринта във Виница, знаех. Защото първото, което направих, беше да погледна дали на телефона ми има информация за въздушна тревога. И те от България са гледали дали далече там, където са близките им, има обстрел.

Пия сутрешното кафе и съставям план с кого ще се срещна през деня.

Внезапно от високоговорителите зазвучава женски глас:

Това е минута мълчание в памет на всички загинали, ранени или засегнати от руското нахлуване в Украйна. В памет на жените, децата, на невинните жертви и на нашите герои на фронта.

В тишината на тази минута прозвучава звук, подобен на махало на голям часовник, което се удря в дървени стени – клоп, клоп, клоп… Огласява целия град.

Така, точно в девет всяка сутрин, в продължение на една минута Украйна мълчи.

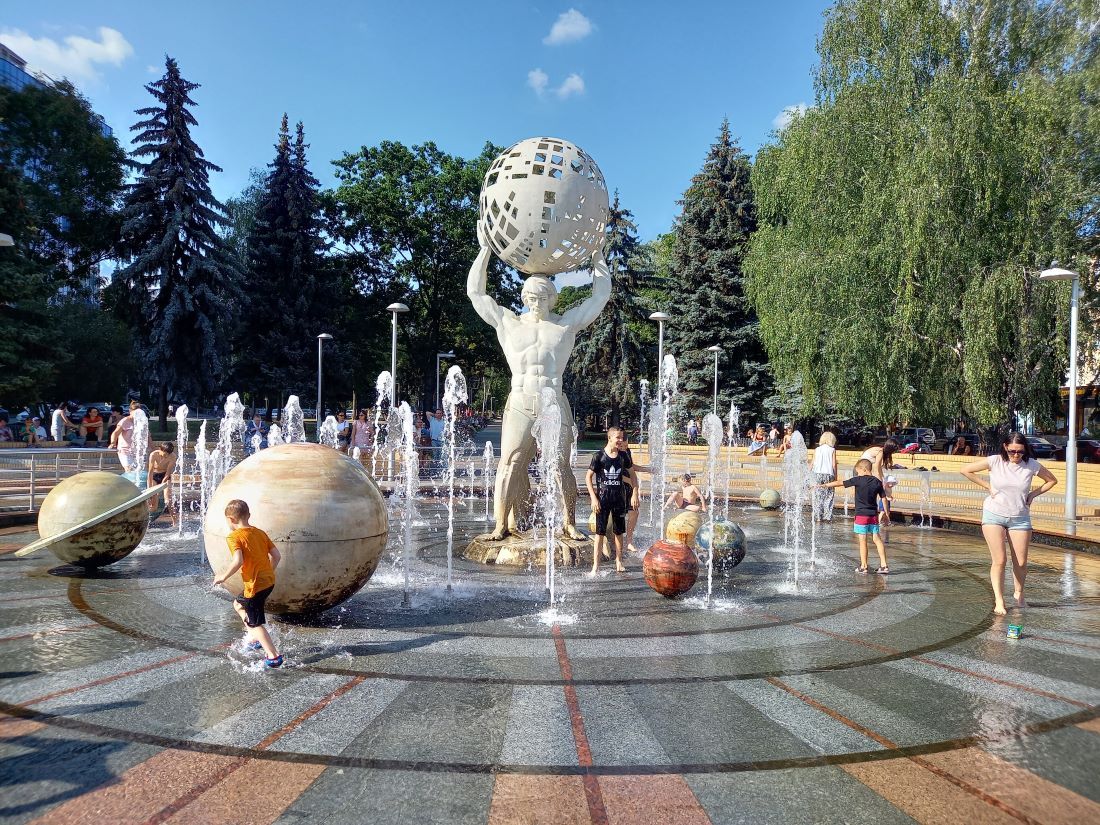
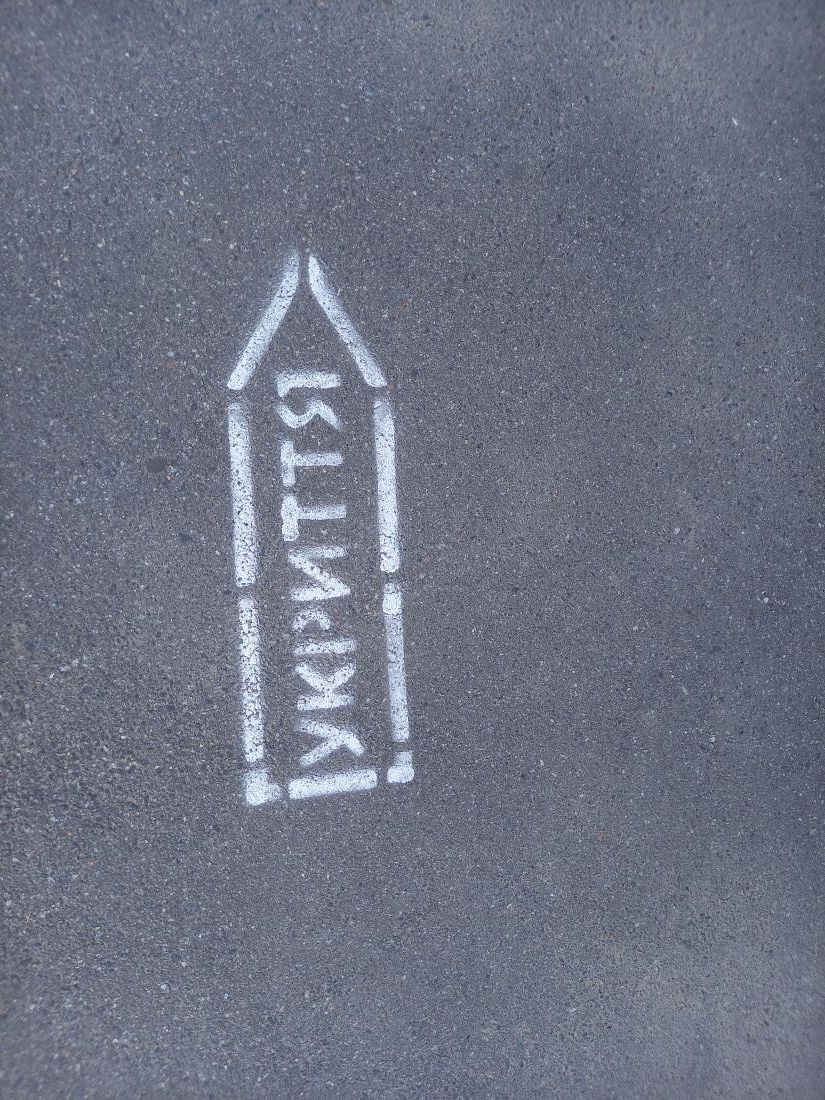
Виница напомня на Пловдив. Разположена е от двете страни на голямата река Южен Буг. Минаваме покрай фонтан във формата на Слънчевата система. Навън по обед вече е над 30 градуса. Деца си играят във фонтана. Майките им са седнали на близките пейки. Сирената започва да вие отново. Винаги е толкова неочаквана, обикновено на фона на някакво рутинно човешко действие, което я прави зловеща натрапница. Аз инстинктивно поглеждам към стрелките по тротоара, които показват къде е най-близкото бомбоубежище. Те поглеждат телефона си. Според приложението засега към града не лети нищо. Животът може да продължи с играещите във фонтана деца.
Никога не съм виждала война на живо. Още по-малко, докато съм гледала филми за война, съм мислила, какво става с цивилното население на воюващата страна. Във филмите почти не показват това. Гледаш батални сцени, кръв, премазани човешки маси на някакво бойно поле. Инстинктивно представата ти за смърт по време на война сякаш се пренася и върху цялото цивилно население. Войниците умират – значи всички умират или поне не е логично да живеят нормално.

Защо да не живеят нормално, защо да не се усмихват или да играят, или да учат. Трябва ли да спре този живот заради войната?

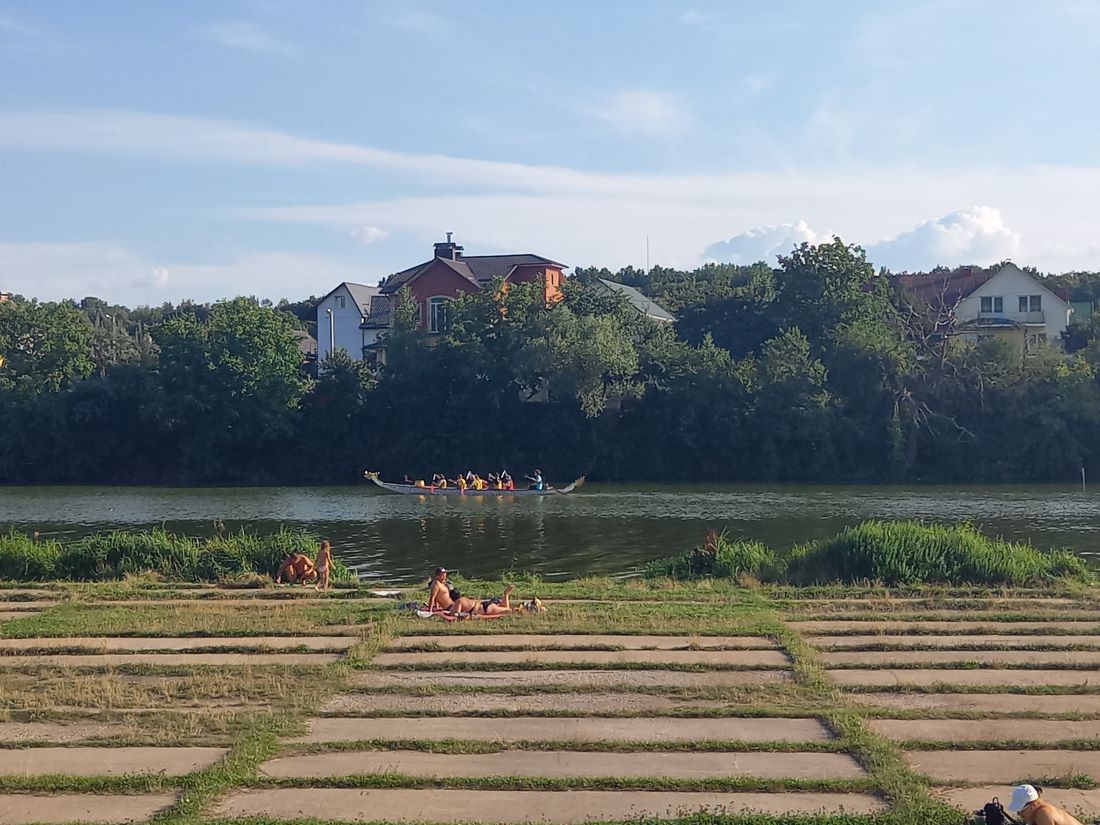
Следобедът идва бързо. Седим до голямо езеро в края на града. По брега му подредени като стражи надничат китни къщи и златните кубета на няколко църкви. В езерото лодки мързеливо се щурат насам-натам. Хората лежат на поляната до самата вода. Май само аз очаквам поредната сирена, която да ме хвърли във въпроси – защо всички се държат сякаш война няма? Алла отгатва мислите ми. Гласът ѝ идва тихо и уверено:

Ако постоянно мислиш за ужаса на войната, за сирените, за заплахата, за близките ти, които сега са на фронта и по тях стрелят, ще се побъркаш. Няма украинско семейство, в което някой от роднините да не е на фронта или да не е загинал, или пък осакатен от войната. Всеки има нужда да си почине от това. Ние, украинците, имаме ведър характер. Винаги ще успеем да намерим нещо красиво около нас, което да повдигне духа ни. Така устояваме на този кошмар.
Откъси от Украйна: Чухте ли сирените?
Виница © Личен архив

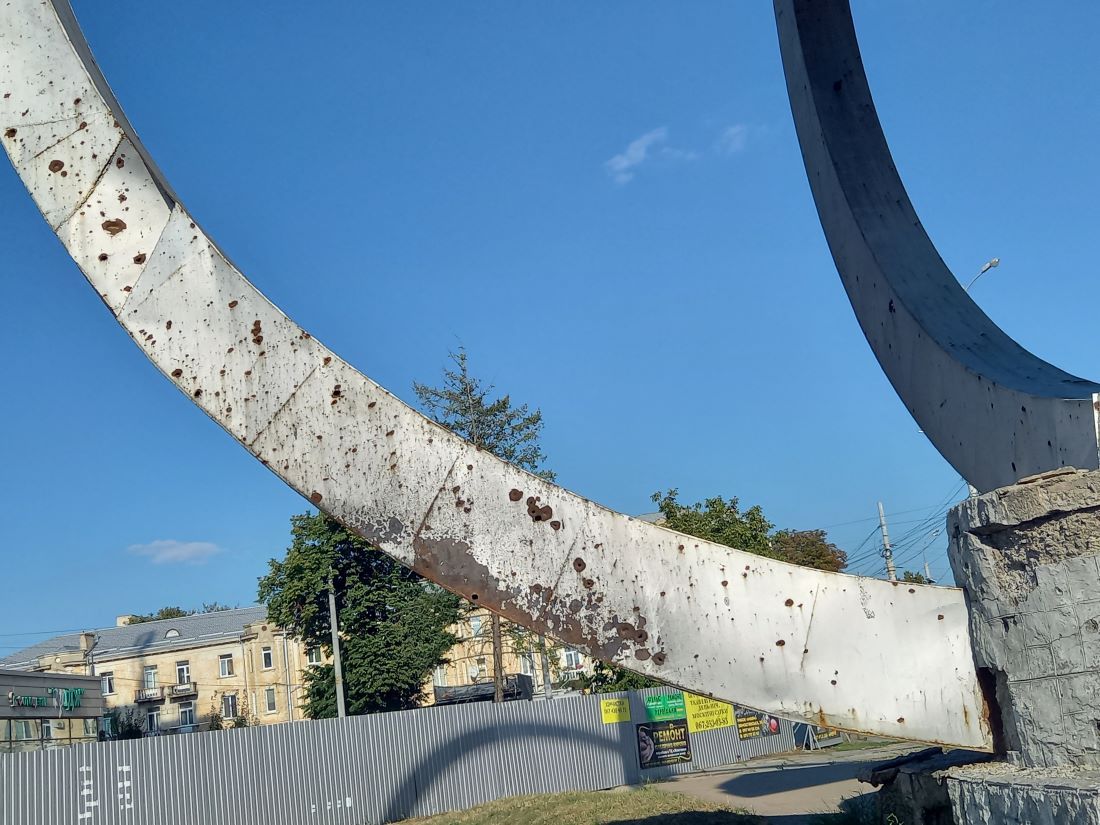
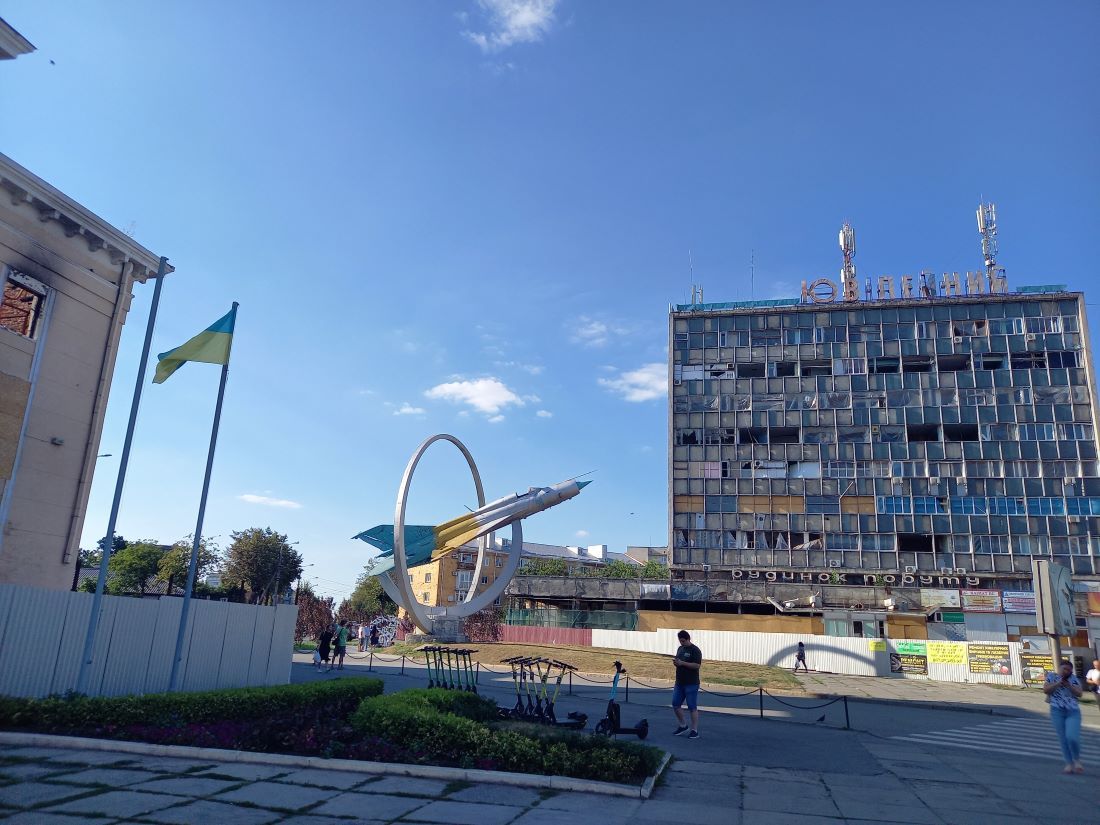
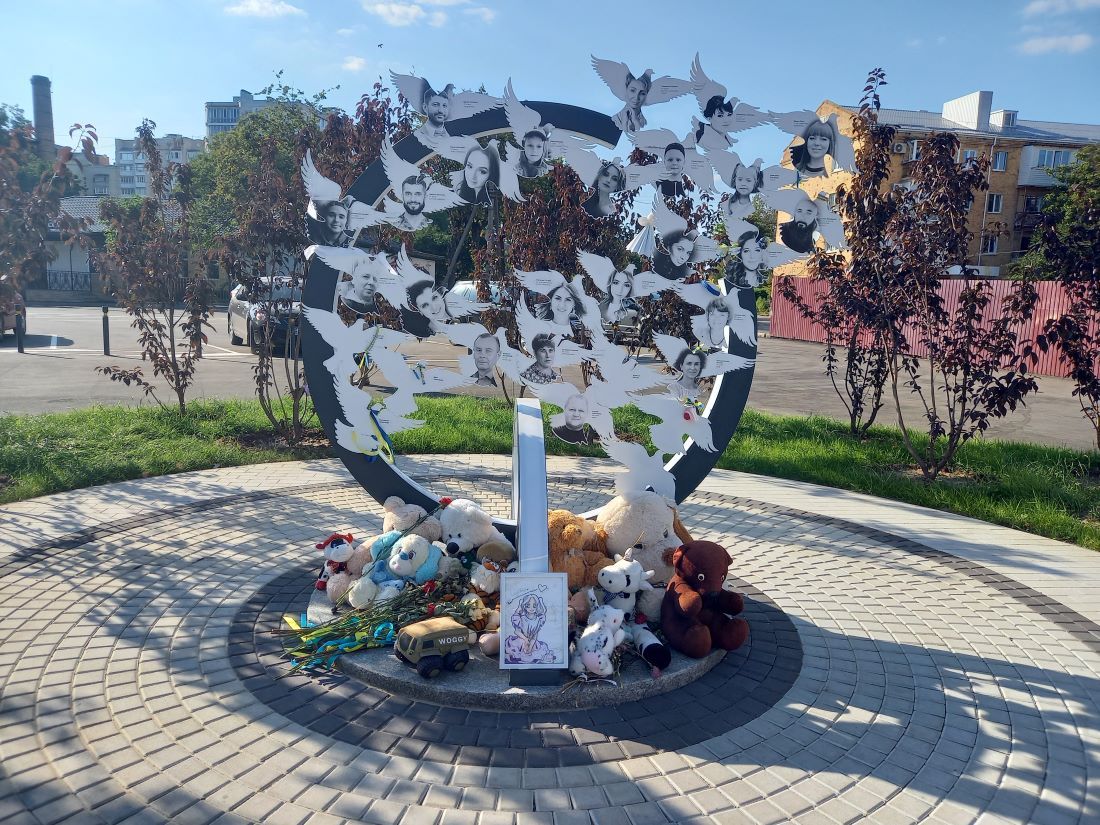
По-късно Алла ме води до Клуба на офицера – мястото, което през миналата година няколко руски ракети разрушиха заедно с административната сграда срещу него. Следите от ударите са зловещи. Зеещи черни дупки, обгорели фасади, по стените на съседните къщи още има хиляди следи като от куршуми. В подножието е изграден малък монумент на загиналите в този ден хора.

Алла ми показва снимка на русо младо момиче в средата. Нейна роднина, която е била на работа в административната сграда по време на обстрела. Разплаква се:

Не можахме да я разпознаем заради обгарянията, а и тялото беше разкъсано. Разбрахме, че е тя, по ДНК теста.

Мълчим. После Алла, която е била в България, тихичко ме пита:

Как може някой да си помисли, че украинците сами биха причинили това на хората си, че украинците сами разрушават цивилни обекти, в които загиват наши хора. Как да им покажа сълзите си?
На другия ден в мола ни застига нова въздушна тревога. Спокоен глас ни нарежда да напуснем сградата. За около две минути без паника хората излизат, качват се на колите си и търпеливо изчакват реда си да напуснат паркинга. Алла отново разгадава изненадата ми и казва:

Това се случва всеки ден. Не е репетиция или тренировка. Не, не сме свикнали! Просто спазваме правилата.

След два дни потегляме към Киев. Магистралата е с по три-четири платна в едната посока. Гладка като стъкло. Нарочно отбиваме и търсим заобиколен маршрут. Искам да разгледам малките населени места. Минаваме през села с китни къщи, чисти площади и равни тротоари. Следват ги огромни посеви с жито или слънчоглед, на които има комбайни. Войната изглежда далечна и нереална. Докато не се загледаш в уличните стълбове на селата. На повечето от тях висят в метални рамки снимки с ликовете на млади момчета и мъже, загинали в тази война. В гробищата ясно се открояват украинските знамена – там, където е погребан човек, загинал пак в тази война.

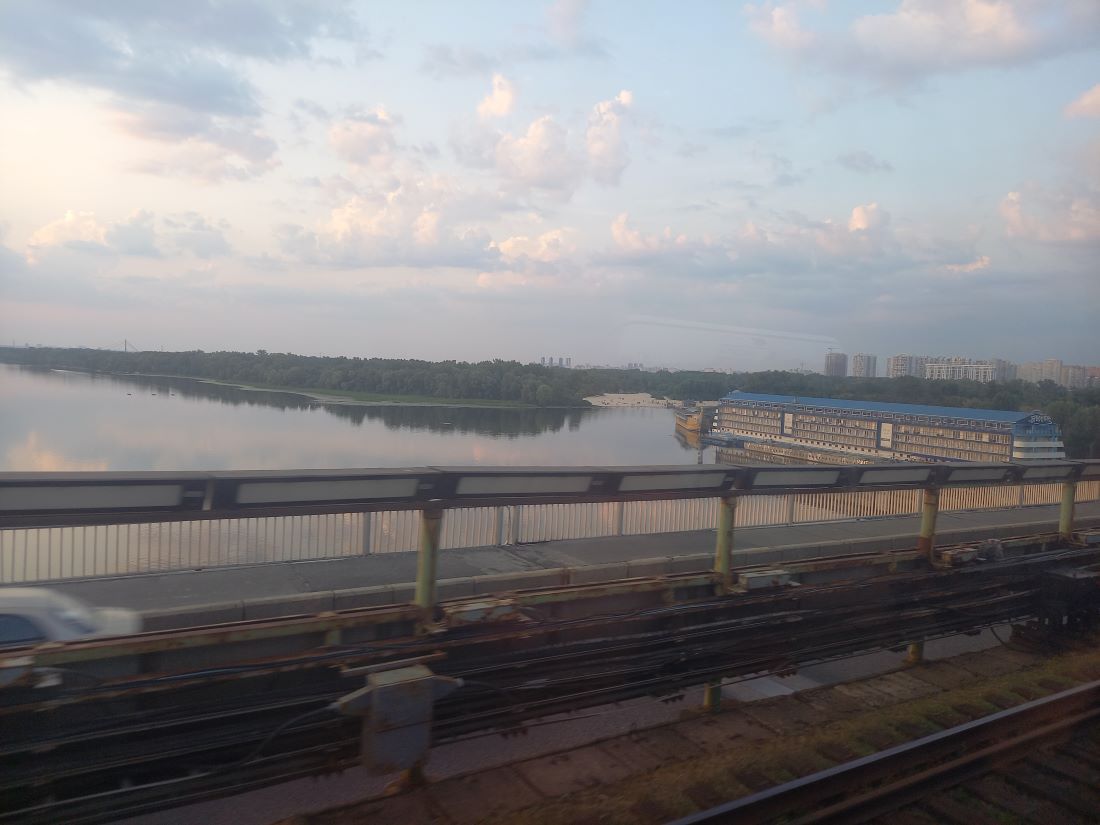
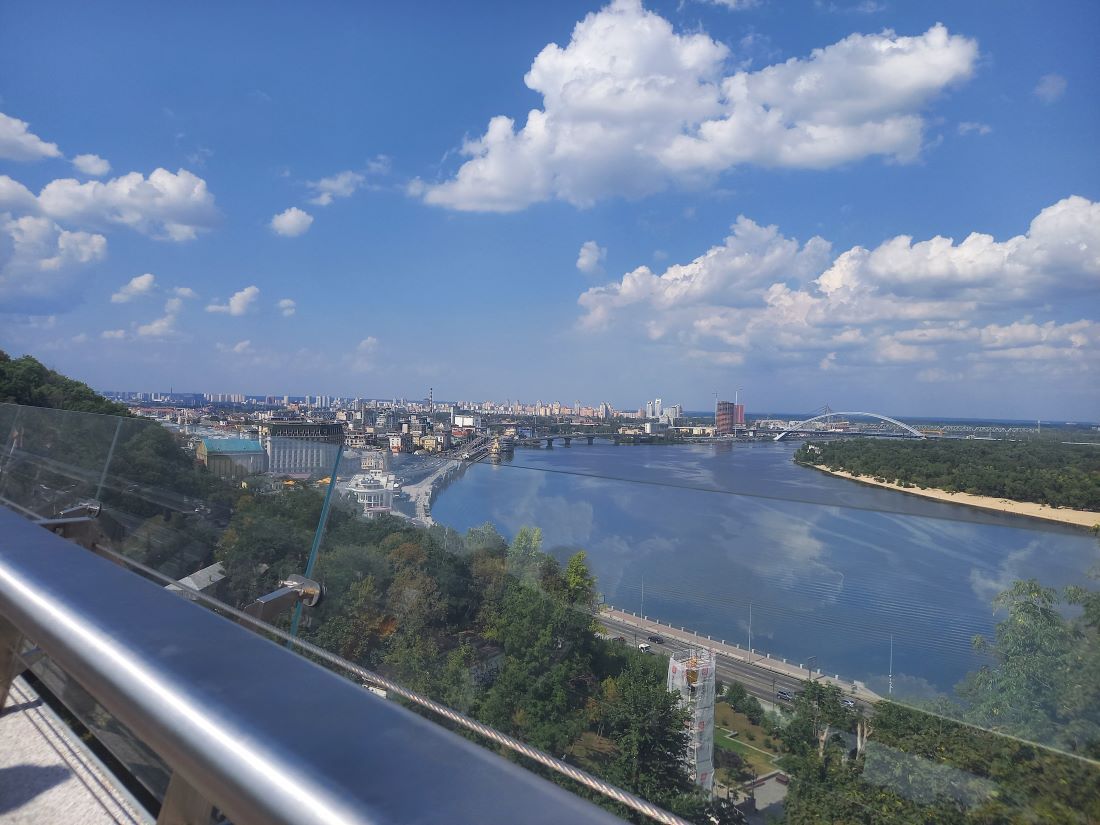
Блокпостовете вече не ни тревожат, защото са на входа и изхода на всеки град. Пред Киев са разположени по-нагъсто и изглеждат по-големи. Дулата на оръдията сочат нагоре от бетонните бункери, завити с камуфлажни мрежи. Киев ни посреща с небостъргачи, трафик и реката, която е зашеметяваща, прилича на море с острови, плажове и няколко огромни моста, които свързват двата бряга.
Киев трябва да се преживее, за да бъде разбран с мащабите му. Ако попиташ киевчанин за място, което търсиш, той ще ти каже, че е много близко. Тръгваш и се оказва на поне трийсет-четирийсет минути пеша.

Входът към метрото е част от сграда. Ескалаторът е стръмен, бавен и няма край. Перонът е на 107 метра под земята. Пътуваш около шест минути към него, ушите ти заглъхват, светлината е приглушено жълта, сводовете на тунела са ниски. Сякаш отиваш в нищото. Представям си как при първите обстрели над Киев хората са се крили в тези дълбоки метростанции с дни. Та в тях е студено, тясно и усойно. Представям си какво е било да седиш там долу през зимата, в началото на войната, докато горе ракетите разрушават и убиват. Вратите – затворени, дълбините на метрото – пълни с деца, възрастни хора, бременни жени, неуспели да вземат връхни дрехи и храна.

Колко може да издържи човек тук, на сто метра под земята, между черните тунели на влаковете и ниските сводове отгоре?

Не е утеха, че над теб има красив хълм, с парк и беседки; стария град на Киев с прекрасната си архитектура, калдъръмените улици, къщата музей на Булгаков, църквите със златни кубета и сергиите с ръчно изработени сувенири. Докато пътувам с ескалатора надолу в бездната на метрото, си мисля как войната е навсякъде, дори и на тези сергии в стария град, на които има издялани от дърво детски играчки танкове.
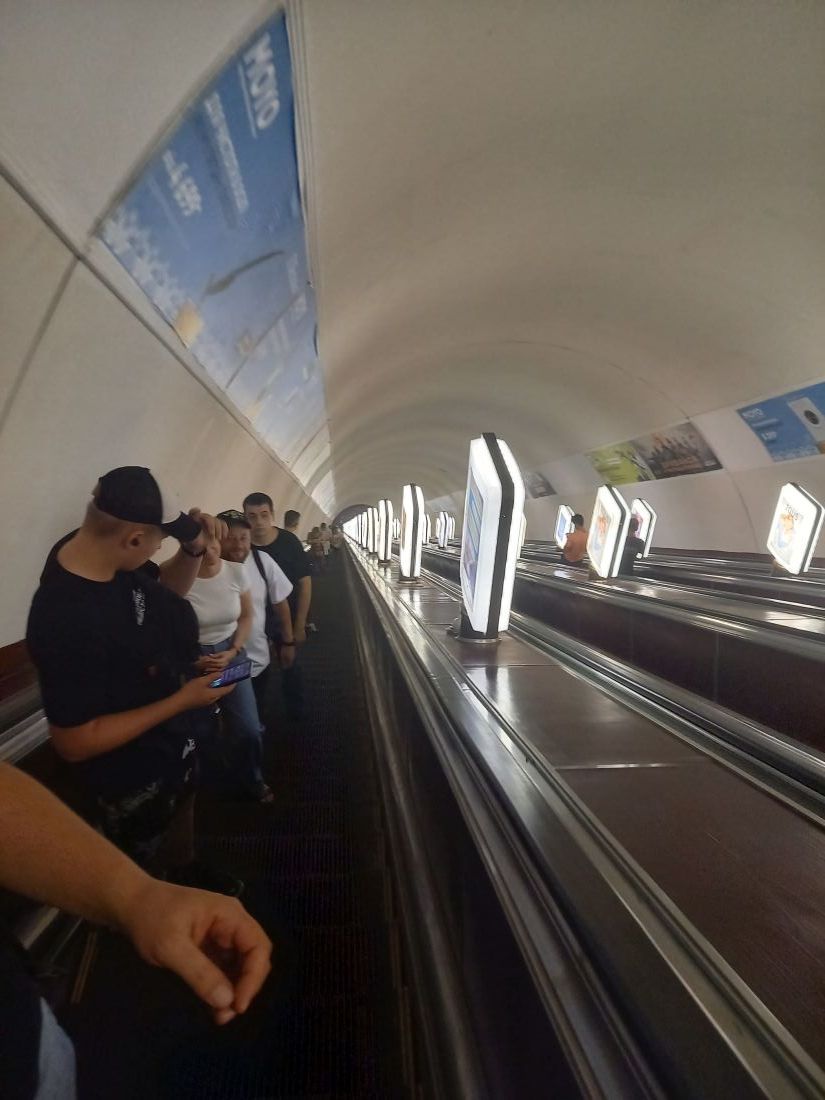
Влакът се спуска с бясна скорост в тунела, вагоните се люлеят като в бурно море и трещят насред тъмнината. Усещаш, въпреки скоростта, как потъваш още по-надълбоко и надолу. Пристигаме. Започва изкачване пет-шест минути нагоре. Преди върха си замаян и преглъщаш, за да освободиш напрежението в ушите.

Измъкваме се насред блестящ площад. Толкова е чисто, че ми иде веднага да седна на земята. Хората се събират около група музиканти, които се подготвят за концерт. Пред тях са поставени не калъфите на инструментите, а големи гилзи от снаряди. Ще свирят, за да съберат пари за фронта. Концертът започва, публиката пее песните им заедно с тях и всеки оставя банкноти в гилзите.

Разговарях с улични музиканти в различни украински градове. Почти всички отделят от изкараните пари за фронта. Мислят го като „дълг и възможност изкуството да победи войната“.

Вечерта по улиците на Киев е пълно с хора. Привидно весели, седят пред заведенията, говорят, смеят се, но твърде много са младите мъже, почти деца с военни униформи, на които липсва крак или ръка. Твърде много са и украинските знаменца на алеята на загиналите герои на Майдана, сред които постоянно се привежда някоя жена, за да постави ново знаменце с нечие име.

Заведенията работят до полунощ, когато започва комендантският час и животът внезапно спира, изведнъж. За четири дни в Киев, няма нито ден или нощ без сирени. Влизаме в клуб за танци. Личи, че сме чужденци. Към нас се приближава млада жена с въпрос:

Дойдохте тук, за да видите как се танцува по време на война ли?

Същото ме пита и мъжът наблизо.
Въпросите им ме смущават с цинизма и горчивината в тях. Опитвам се да обясня, че съм журналистка, която иска да разкаже за Украйна и войната. Мъжът ми казва:

Ние живеем така, докато не ни се наложи също да отидем на фронта. Знаем, че рано или късно това ще стане, независимо какво работим и дали някога сме хващали оръжие в ръце. И ние ще отидем, за да воюваме не само за нас, но и за цяла Европа.

Седим на терасата на хотела, малко след полунощ и телефонът ми започва да вибрира с предупреждение за въздушна тревога. Чуваме сирените да вият. Получавам съобщение от приятел, който живее в Киев:

Дронове над Киев. Не излизайте никъде! След малко нашите ще ги свалят.

Започваме бързо да се обличаме. Хотелът ни има бомбоубежище. Набързо вземам най-необходимото, ако се наложи да останем дълго там. Сърцето ми ще изскочи. Припомням си инструктажа:

Ако не успеете да стигнете до укритие, застанете между две стени, без прозорец наблизо, защото, когато свалят ракетата или дрона, осколките падат на земята и разрушават дори големи сгради. Най-опасни са детонациите, от които се чупят прозорците.

Чакаме. Струва ми се, а може би наистина чувам как гърми ПВО-то. Не мога да изляза и да видя, защото си спомням инструктажа:

Най-често са пострадали хората, които в такива моменти отиват навън, за да снимат.

Чакаме. След около час сирената свири отбой, но ние се чудим да си лягаме ли, да събличаме ли дрехите, колко дълго да не спим…

Рано сутринта на другия ден потегляме към Буча, Ирпин и Гостомел. Звъня, за да уговоря среща. Вместо сигнал „заето“ телефонният оператор ми казва:

Моля, изчакайте, абонатът говори за победата.
New – Amazon EC2 C7a Instances Powered By 4th Gen AMD EPYC Processors for Compute Optimized Workloads

Post Syndicated from Channy Yun original https://aws.amazon.com/blogs/aws/new-amazon-ec2-c7a-instances-powered-by-4th-gen-amd-epyc-processors-for-compute-optimized-workloads/

We launched the compute optimized Amazon EC2 C6a instances in February 2022 powered by 3rd Gen AMD EPYC (Milan) processors, running at frequencies up to 3.6 GHz.

Today, we’re announcing the general availability of new, compute optimized Amazon EC2 C7a instances, powered by the 4th Gen AMD EPYC (Genoa) processors with a maximum frequency of 3.7 GHz, which offer up to 50 percent higher performance compared to C6a instances. You can use this increased performance to process data faster, consolidate workloads, and lower the cost of ownership.

C7a instances offer up to 50 percent higher performance compared to C6a instances. These instances are ideal for running compute-intensive workloads such as high-performance web servers, batch processing, ad serving, machine learning, multiplayer gaming, video encoding, high performance computing (HPC) such as scientific modeling, and machine learning.

C7a instances support AVX-512, Vector Neural Network Instructions (VNNI), and brain floating point (bfloat16). These instances feature Double Data Rate 5 (DDR5) memory, which enables high-speed access to data in-memory, and deliver 2.25 times more memory bandwidth compared to the previous generation instances for lower latency.

C7a instances feature sizes of up to 192 vCPUs with 384 GiB RAM, which you have a new medium instance size, which enables you to right-size your workloads more accurately, offering 1 vCPU, 2 GiB. Here are the detailed specs:

Name vCPUs Memory (GiB) Network Bandwidth (Gbps) EBS Bandwidth (Gbps)
c7a.medium 1 2 Up to 12.5 Up to 10
c7a.large 2 4 Up to 12.5 Up to 10
c7a.xlarge 4 8 Up to 12.5 Up to 10
c7a.2xlarge 8 16 Up to 12.5 Up to 10
c7a.4xlarge 16 32 Up to 12.5 Up to 10
c7a.8xlarge 32 64 12.5 10
c7a.12xlarge 48 96 18.75 15
c7a.16xlarge 64 128 25 20
c7a.24xlarge 96 192 37.5 30
c7a.32xlarge 128 256 50 40
c7a.48xlarge 192 384 50 40
c7a.metal-48xl 192 384 50 40

C7a instances have up to 50 Gbps enhanced networking and 40 Gbps EBS bandwidth, and you can attach up to 128 EBS volumes to an instance, compared to up to 28 EBS volume attachments with the previous generation instances.

C7a instances support always-on memory encryption with AMD secure memory encryption (SME) and new AVX-512 instructions for accelerating encryption and decryption algorithms, convolutional neural network (CNN) based algorithms, financial analytics, and video encoding workloads. C7a instances also support AES-256 compared to AES-128 in C6a instances for enhanced security.

These instances are built on the AWS Nitro System and support Elastic Fabric Adapter (EFA) for workloads that benefit from lower network latency and highly scalable inter-node communication, such as high-performance computing and video processing.

Now Available
Amazon EC2 C7a instances are now available in the following AWS Regions: US East (Ohio), US East (N. Virginia), US West (Oregon), and EU (Ireland). As usual with Amazon EC2, you only pay for what you use. For more information, see the Amazon EC2 pricing page.

To learn more, visit the EC2 C7a instances page and AWS/AMD partner page. You can send feedback to [email protected], AWS re:Post for EC2, or through your usual AWS Support contacts.

— Channy

[$] BPF and security

Post Syndicated from jake original https://lwn.net/Articles/946389/

The eBPF in-kernel virtual machine is
approaching its tenth anniversary as part of Linux; it has grown into a
tool with many types of uses in the ecosystem. Alexei Starovoitov, who
was the creator of eBPF and did much of the development of it, especially
in the early going, gave the opening talk at
Linux
Security Summit Europe
 2023 on the relationship between BPF and
security. In it, he related some interesting history, from a somewhat
different perspective than what is often described, he said. Among other
things, it shows how BPF
has been both a security problem and a security solution along the way.

Enable Security Hub partner integrations across your organization

Post Syndicated from Joaquin Manuel Rinaudo original https://aws.amazon.com/blogs/security/enable-security-hub-partner-integrations-across-your-organization/

AWS Security Hub offers over 75 third-party partner product integrations, such as Palo Alto Networks Prisma, Prowler, Qualys, Wiz, and more, that you can use to send, receive, or update findings in Security Hub.

We recommend that you enable your corresponding Security Hub third-party partner product integrations when you use these partner solutions. By centralizing findings across your AWS and partner solutions in Security Hub, you can get a holistic cross-account and cross-Region view of your security risks. In this way, you can move beyond security reporting and start implementing automations on top of Security Hub that help improve your overall security posture and reduce manual efforts. For example, you can configure your third-party partner offerings to send findings to Security Hub and build standardized enrichment, escalation, and remediation solutions by using Security Hub automation rules, or other AWS services such as AWS Lambda or AWS Step Functions.

To enable partner integrations, you must configure the integration in each AWS Region and AWS account across your organization in AWS Organizations. In this blog post, we’ll show you how to set up a Security Hub partner integration across your entire organization by using AWS CloudFormation StackSets.

Overview

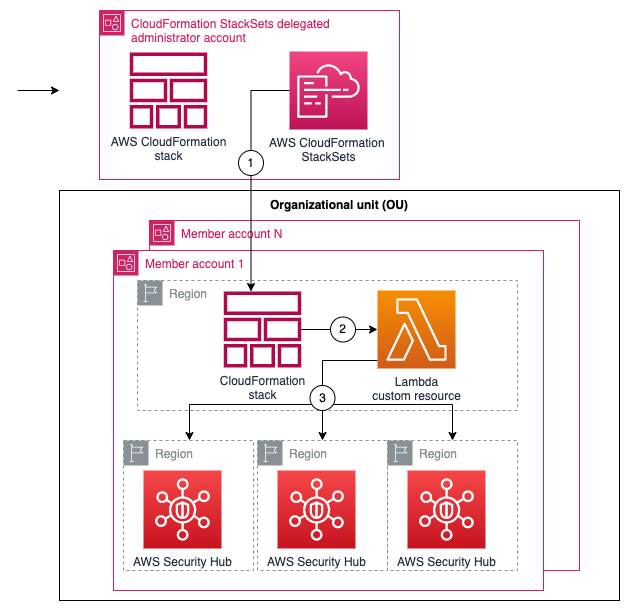
Figure 1 shows the architecture of the solution. The main steps are as follows:

  1. The deployment script creates a CloudFormation template that deploys a stack set across your AWS accounts.
  2. The stack in the member account deploys a CloudFormation custom resource using a Lambda function.
  3. The Lambda function iterates through target Regions and invokes the Security Hub boto3 method enable_import_findings_for_product to enable the corresponding partner integration.

When you add new accounts to the organizational units (OUs), StackSets deploys the CloudFormation stack and the partner integration is enabled.

Figure 1: Diagram of the solution

Figure 1: Diagram of the solution

Prerequisites

To follow along with this walkthrough, make sure that you have the following prerequisites in place:

  • Security Hub enabled across an organization in the Regions where you want to deploy the partner integration.
  • Trusted access with AWS Organizations enabled so that you can deploy CloudFormation StackSets across your organization. For instructions on how to do this, see Activate trusted access with AWS Organizations.
  • Permissions to deploy CloudFormation StackSets in a delegated administrator account for your organization.
  • AWS Command Line Interface (AWS CLI) installed.

Walkthrough

Next, we show you how to get started with enabling your partner integration across your organization using the following solution.

Step 1: Clone the repository

In the AWS CLI, run the following command to clone the aws-securityhub-deploy-partner-integration GitHub repository:

git clone https://github.com/aws-samples/aws-securityhub-partner-integration

Step 2: Set up the integration parameters

  1. Open the parameters.json file and configure the following values:
    • ProductName — Name of the product that you want to enable.
    • ProductArn — The unique Amazon Resource Name (ARN) of the Security Hub partner product. For example, the product ARN for Palo Alto PRISMA Cloud Enterprise, is arn:aws:securityhub:<REGION>:188619942792:product/paloaltonetworks/redlock; and for Prowler, it’s arn:aws:securityhub:<REGION>::product/prowler/prowler. To find a product ARN, see Available third-party partner product integrations.
    • DeploymentTargets — List of the IDs of the OUs of the AWS accounts that you want to configure. For example, use the unique identifier (ID) for the root to deploy across your entire organization.
    • DeploymentRegions — List of the Regions in which you’ve enabled Security Hub, and for which the partner integration should be enabled.
  2. Save the changes and close the file.

Step 3: Deploy the solution

  1. Open a command line terminal of your preference.
  2. Set up your AWS_REGION (for example, export AWS_REGION=eu-west-1) and make sure that your credentials are configured for the delegated administrator account.
  3. Enter the following command to deploy:
    ./setup.sh deploy

Step 4: Verify Security Hub partner integration

To test that the product integration is enabled, run the following command in one of the accounts in the organization. Replace <TARGET-REGION> with one of the Regions where you enabled Security Hub.

aws securityhub list-enabled-products-for-import --region <TARGET-REGION>

Step 5: (Optional) Manage new partners, Regions, and OUs

To add or remove the partner integration in certain Regions or OUs, update the parameters.json file with your desired Regions and OU IDs and repeat Step 3 to redeploy changes to your Security Hub partner integration. You can also directly update the CloudFormation parameters for the securityhub-integration-<PARTNER-NAME> from the CloudFormation console.

To enable new partner integrations, create a new parameters.json file version with the partner’s product name and product ARN to deploy a new stack using the deployment script from Step 3. In the next step, we show you how to disable the partner integrations.

Step 6: Clean up

If needed, you can remove the partner integrations by destroying the stack deployed. To destroy the stack, use the command line terminal configured with the credentials for the AWS StackSets delegated administrator account and run the following command:

 ./setup.sh destroy

You can also directly delete the stack mentioned in Step 5 from the CloudFormation console by accessing the stack page from the CloudFormation console, selecting the stack securityhub-integration-<PARTNER-NAME>, and then choosing Delete.

Conclusion

In this post, you learned how you to enable Security Hub partner integrations across your organization. Now you can configure the partner product of your choice to send, update, or receive Security Hub findings.

You can extend your security automation by using Security Hub automation rules, Amazon EventBridge events, and Lambda functions to start or enrich automated remediation of new ingested findings from partners. For an example of how to do this, see Automated Security Response on AWS.

Developer teams can opt in to configure their own chatbot in AWS Chatbot to receive notifications in Amazon Chime, Slack, or Microsoft Teams channels. Lastly, security teams can use existing bidirectional integrations with Jira Service Management or Jira Core to escalate severe findings to their developer teams.

If you have feedback about this post, submit comments in the Comments section below. If you have questions about this post, start a new thread on the AWS Security, Identity, & Compliance re:Post or contact AWS Support.

Want more AWS Security news? Follow us on Twitter.

Author

Joaquin Manuel Rinaudo

Joaquin is a Principal Security Architect with AWS Professional Services. He is passionate about building solutions that help developers improve their software quality. Prior to AWS, he worked across multiple domains in the security industry, from mobile security to cloud and compliance related topics. In his free time, Joaquin enjoys spending time with family and reading science-fiction novels.

Shachar Hirshberg

Shachar Hirshberg

Shachar is a Senior Product Manager for AWS Security Hub with over a decade of experience in building, designing, launching, and scaling enterprise software. He is passionate about further improving how customers harness AWS services to enable innovation and enhance the security of their cloud environments. Outside of work, Shachar is an avid traveler and a skiing enthusiast.

1.1.1.1 lookup failures on October 4th, 2023

Post Syndicated from Ólafur Guðmundsson original http://blog.cloudflare.com/1-1-1-1-lookup-failures-on-october-4th-2023/

1.1.1.1 lookup failures on  October 4th, 2023

1.1.1.1 lookup failures on  October 4th, 2023

On 4 October 2023, Cloudflare experienced DNS resolution problems starting at 07:00 UTC and ending at 11:00 UTC. Some users of 1.1.1.1 or products like WARP, Zero Trust, or third party DNS resolvers which use 1.1.1.1 may have received SERVFAIL DNS responses to valid queries. We’re very sorry for this outage. This outage was an internal software error and not the result of an attack. In this blog, we’re going to talk about what the failure was, why it occurred, and what we’re doing to make sure this doesn’t happen again.

Background

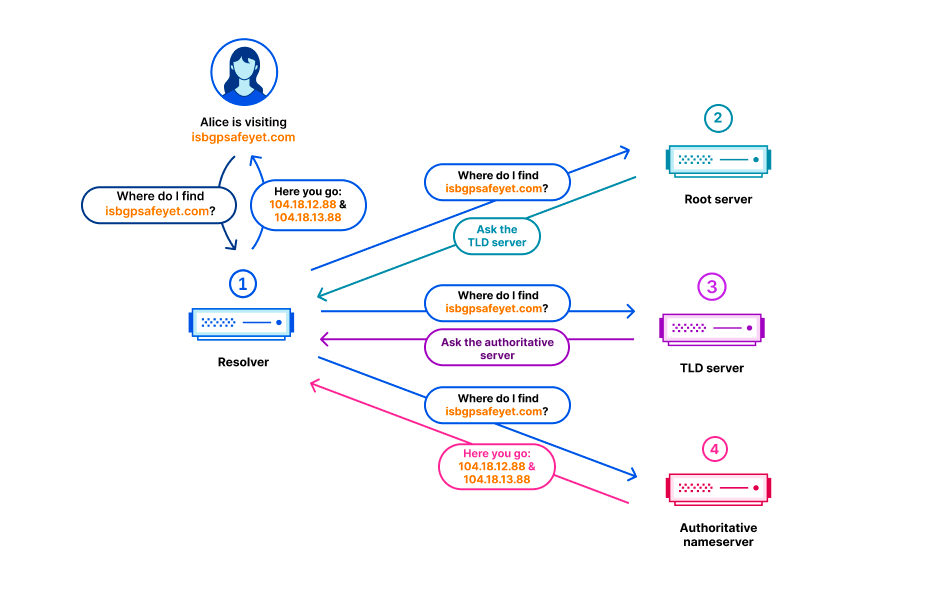
In the Domain Name System (DNS), every domain name exists within a DNS zone. The zone is a collection of domain names and host names that are controlled together. For example, Cloudflare is responsible for the domain name cloudflare.com, which we say is in the “cloudflare.com” zone. The .com top-level domain (TLD) is owned by a third party and is in the “com” zone. It gives directions on how to reach cloudflare.com. Above all of the TLDs is the root zone, which gives directions on how to reach TLDs. This means that the root zone is important in being able to resolve all other domain names. Like other important parts of the DNS, the root zone is signed with DNSSEC, which means the root zone itself contains cryptographic signatures.

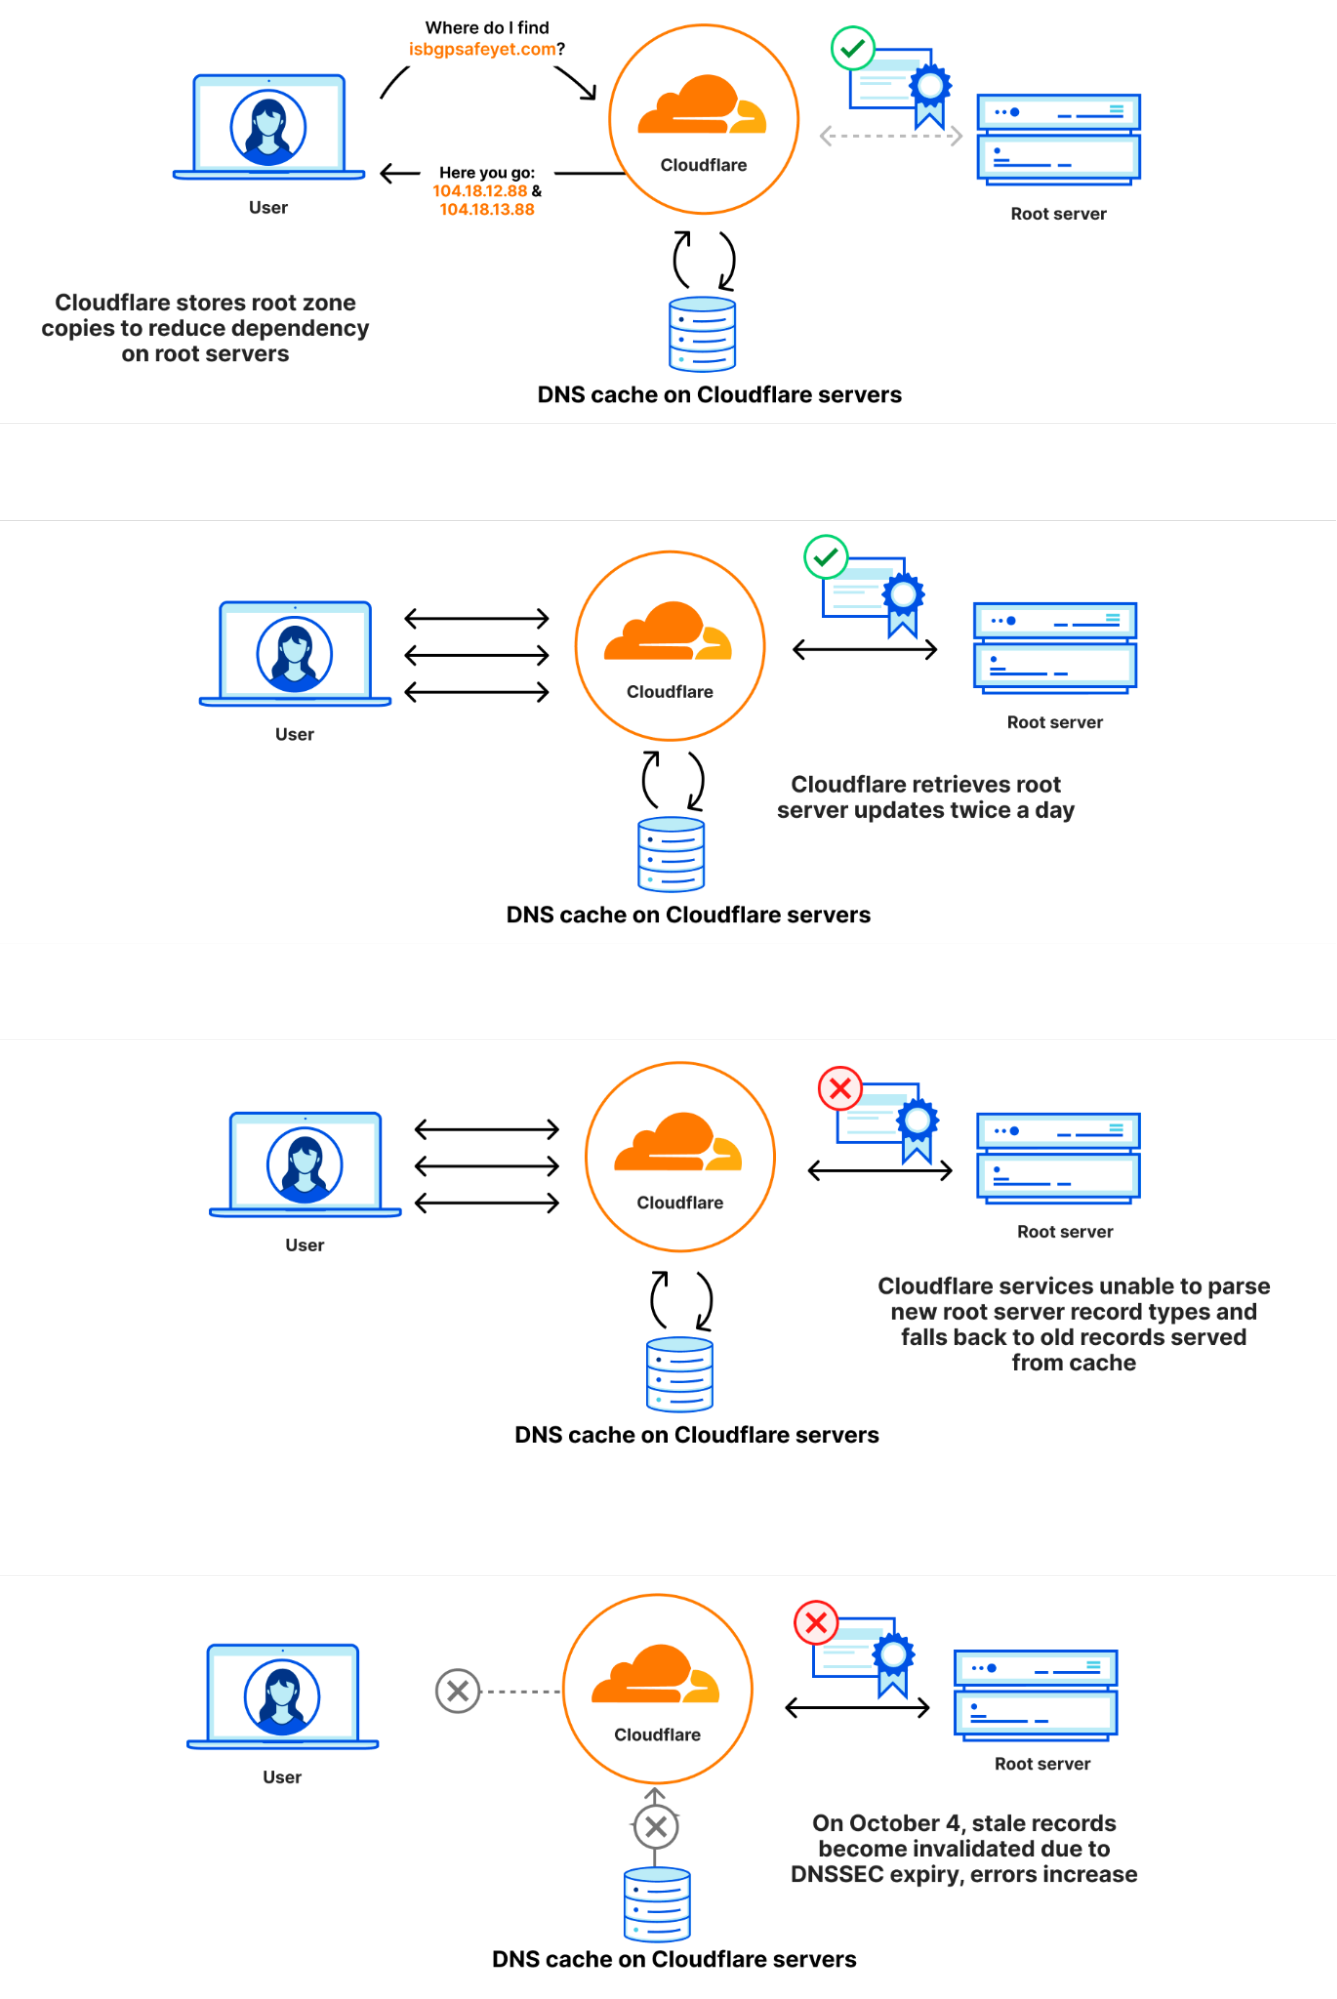
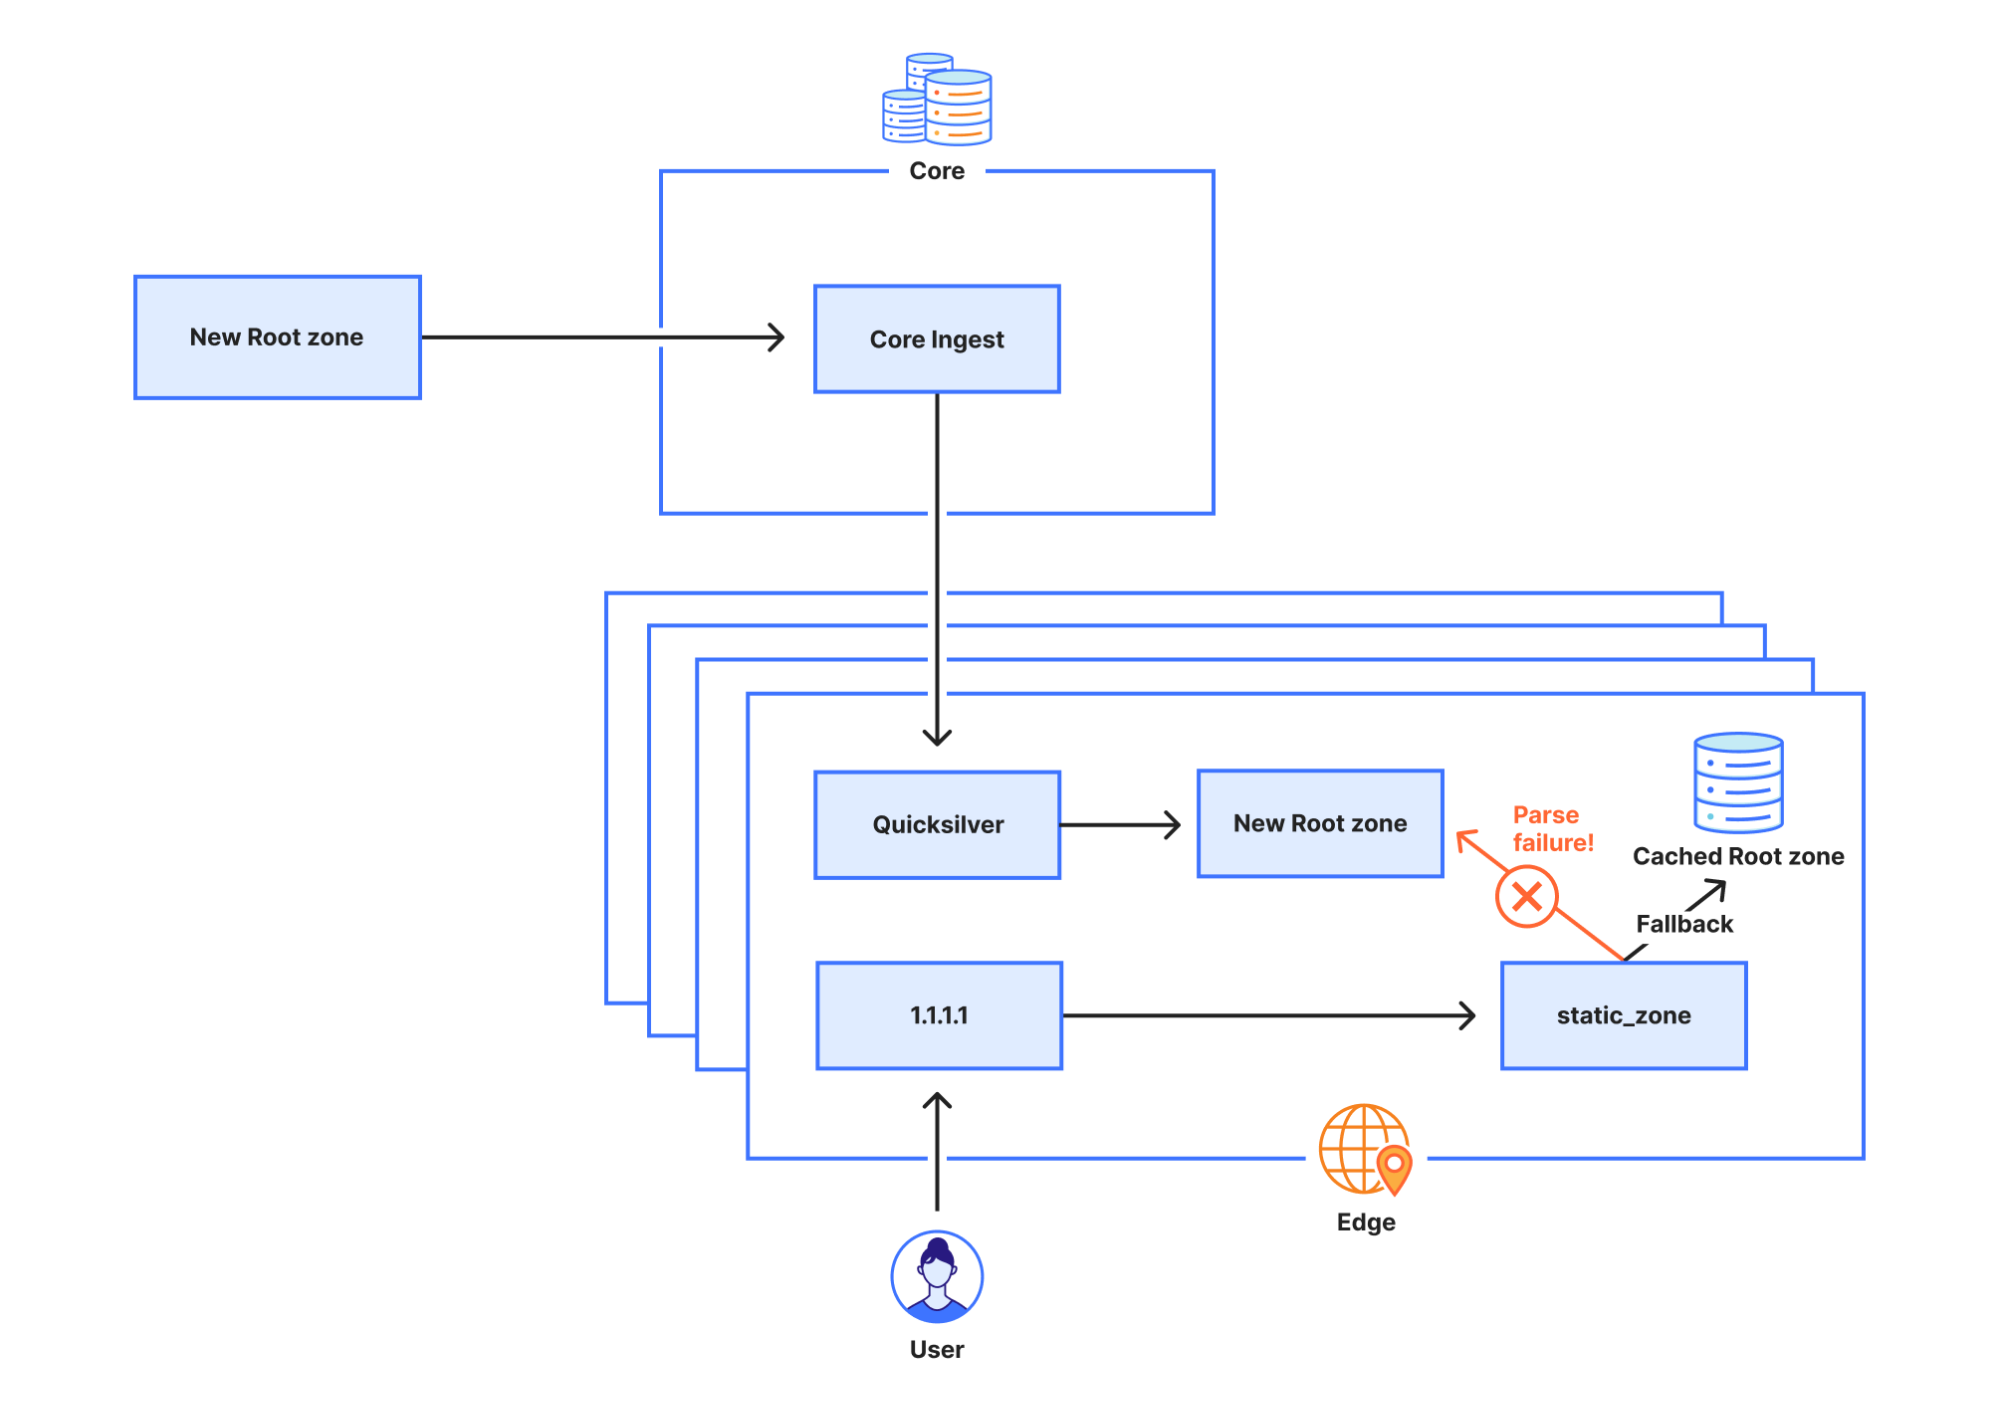
The root zone is published on the root servers, but it is also common for DNS operators to retrieve and retain a copy of the root zone automatically so that in the event that the root servers cannot be reached, the information in the root zone is still available. Cloudflare’s recursive DNS infrastructure takes this approach as it also makes the resolution process faster. New versions of the root zone are normally published twice a day. 1.1.1.1 has a WebAssembly app called static_zone running on top of the main DNS logic that serves those new versions when they are available.

1.1.1.1 lookup failures on  October 4th, 2023

What happened

On 21 September, as part of a known and planned change in root zone management, a new resource record type was included in the root zones for the first time. The new resource record is named ZONEMD, and is in effect a checksum for the contents of the root zone.

The root zone is retrieved by software running in Cloudflare’s core network. It is subsequently redistributed to Cloudflare’s data centers around the world. After the change, the root zone containing the ZONEMD record continued to be retrieved and distributed as normal. However, the 1.1.1.1 resolver systems that make use of that data had problems parsing the ZONEMD record. Because zones must be loaded and served in their entirety, the system’s failure to parse ZONEMD meant the new versions of the root zone were not used in Cloudflare’s resolver systems. Some of the servers hosting Cloudflare's resolver infrastructure failed over to querying the DNS root servers directly on a request-by-request basis when they did not receive the new root zone. However, others continued to rely on the known working version of the root zone still available in their memory cache, which was the version pulled on 21 September before the change.

On 4 October 2023 at 07:00 UTC, the DNSSEC signatures in the version of the root zone from 21 September expired. Because there was no newer version that the Cloudflare resolver systems were able to use, some of Cloudflare’s resolver systems stopped being able to validate DNSSEC signatures and as a result started sending error responses (SERVFAIL). The rate at which Cloudflare resolvers generated SERVFAIL responses grew by 12%. The diagrams below illustrate the progression of the failure and how it became visible to users.

1.1.1.1 lookup failures on  October 4th, 2023

Incident timeline and impact

21 September 6:30 UTC: Last successful pull of the root zone
4 October 7:00 UTC: DNSSEC signatures in the root zone obtained on 21 September expired causing an increase in SERVFAIL responses to client queries.
7:57: First external reports of unexpected SERVFAILs started coming in.
8:03: Internal Cloudflare incident declared.
8:50: Initial attempt made at stopping 1.1.1.1 from serving responses using the stale root zone file with an override rule.
10:30: Stopped 1.1.1.1 from preloading the root zone file entirely.
10:32: Responses returned to normal.
11:02: Incident closed.

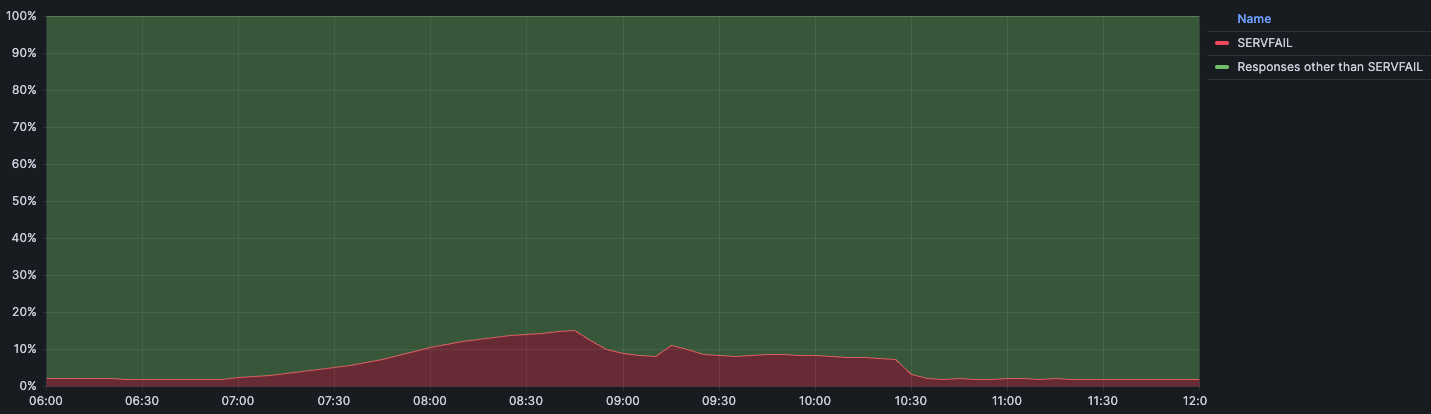
This below chart shows the timeline of impact along with the percentage of DNS queries that returned with a SERVFAIL error:

1.1.1.1 lookup failures on  October 4th, 2023

We expect a baseline volume of SERVFAIL errors for regular traffic during normal operation. Usually that percentage sits at around 3%. These SERVFAILs can be caused by legitimate issues in the DNSSEC chain, failures to connect to authoritative servers, authoritative servers taking too long to respond, and many others. During the incident the amount of SERVFAILs peaked at 15% of total queries, although the impact was not evenly distributed around the world and was mainly concentrated in our larger data centers like Ashburn, Virginia; Frankfurt, Germany; and Singapore.

Why this incident happened

Why parsing the ZONEMD record failed

DNS has a binary format for storing resource records. In this binary format the type of the resource record (TYPE)  is stored as a 16-bit integer. The type of resource record determines how the resource data (RDATA) is parsed. When the record type is 1, this means it is an A record, and the RDATA can be parsed as an IPv4 address. Record type 28 is an AAAA record, whose RDATA can be parsed as an IPv6 address instead. When a parser runs into an unknown resource type it won’t know how to parse its RDATA, but fortunately it doesn’t have to: the RDLENGTH field indicates how long the RDATA field is, allowing the parser to treat it as an opaque data element.

                                   1  1  1  1  1  1
      0  1  2  3  4  5  6  7  8  9  0  1  2  3  4  5
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                                               |
    /                                               /
    /                      NAME                     /
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TYPE                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                     CLASS                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TTL                      |
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                   RDLENGTH                    |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--|
    /                     RDATA                     /
    /                                               /
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
RFC 1035

The reason static_zone didn’t support the new ZONEMD record is because up until now we had chosen to distribute the root zone internally in its presentation format, rather than in the binary format. When looking at the text representation for a few resource records we can see there is a lot more variation in how different records are presented.

.			86400	IN	SOA	a.root-servers.net. nstld.verisign-grs.com. 2023100400 1800 900 604800 86400
.			86400	IN	RRSIG	SOA 8 0 86400 20231017050000 20231004040000 46780 . J5lVTygIkJHDBt6HHm1QLx7S0EItynbBijgNlcKs/W8FIkPBfCQmw5BsUTZAPVxKj7r2iNLRddwRcM/1sL49jV9Jtctn8OLLc9wtouBmg3LH94M0utW86dKSGEKtzGzWbi5hjVBlkroB8XVQxBphAUqGxNDxdE6AIAvh/eSSb3uSQrarxLnKWvHIHm5PORIOftkIRZ2kcA7Qtou9NqPCSE8fOM5EdXxussKChGthmN5AR5S2EruXIGGRd1vvEYBrRPv55BAWKKRERkaXhgAp7VikYzXesiRLdqVlTQd+fwy2tm/MTw+v3Un48wXPg1lRPlQXmQsuBwqg74Ts5r8w8w==
.			518400	IN	NS	a.root-servers.net.
.			86400	IN	ZONEMD	2023100400 1 241 E375B158DAEE6141E1F784FDB66620CC4412EDE47C8892B975C90C6A102E97443678CCA4115E27195B468E33ABD9F78C
Example records taken from https://www.internic.net/domain/root.zone

When we run into an unknown resource record it’s not always easy to know how to handle it. Because of this, the library we use to parse the root zone at the edge does not make an attempt at doing so, and instead returns a parser error.

Why a stale version of the root zone was used

The static_zone app, tasked with loading and parsing the root zone for the purpose of serving the root zone locally (RFC 7706), stores the latest version in memory. When a new version is published it parses it and, when successfully done so, drops the old version. However, as parsing failed the static_zone app never switched to a newer version, and instead continued using the old version indefinitely. When the 1.1.1.1 service is first started the static_zone app does not have an existing version in memory. When it tries to parse the root zone it fails in doing so, but because it does not have an older version of the root zone to fall back on, it falls back on querying the root servers directly for incoming requests.

1.1.1.1 lookup failures on  October 4th, 2023

Why the initial attempt at disabling static_zone didn’t work

Initially we tried to disable the static_zone app through override rules, a mechanism that allows us to programmatically change some behavior of 1.1.1.1. The rule we deployed was:

phase = pre-cache set-tag rec_disable_static

For any incoming request this rule adds the tag rec_disable_static to the request. Inside the static_zone app we check for this tag and, if it’s set, we do not return a response from the cached, static root zone. However, to improve cache performance queries are sometimes forwarded to another node if the current node can’t find the response in its own cache. Unfortunately, the rec_disable_static tag is not included in the queries being forwarded to other nodes, which caused the static_zone app to continue replying with stale information until we eventually disabled the app entirely.

Why the impact was partial

Cloudflare regularly performs rolling reboots of the servers that host our services for tasks like kernel updates that can only take effect after a full system restart. At the time of this outage, resolver server instances that were restarted between the ZONEMD change and the DNSSEC invalidation did not contribute to impact. If they had restarted during this two-week period, they would have failed to load the root zone on startup and fallen back to resolving by sending DNS queries to root servers instead. In addition, the resolver uses a technique called serve stale (RFC 8767) with the purpose of being able to continue to serve popular records from a potentially stale cache to limit the impact. A record is considered to be stale once the TTL amount of seconds has passed since the record was retrieved from upstream.  This prevented a total outage; impact was mainly felt in our largest data centers which had many servers that had not restarted the 1.1.1.1 service in that timeframe.

Remediation and follow-up steps

This incident had widespread impact, and we take the availability of our services very seriously. We have identified several areas of improvement and will continue to work on uncovering any other gaps that could cause a recurrence.

Here is what we are working on immediately:

Visibility: We’re adding alerts to notify when static_zone serves a stale root zone file. It should not have been the case that serving a stale root zone file went unnoticed for as long as it did. If we had been monitoring this better, with the caching that exists, there would have been no impact. It is our goal to protect our customers and their users from upstream changes.

Resilience: We will re-evaluate how we ingest and distribute the root zone internally. Our ingestion and distribution pipelines should handle new RRTYPEs seamlessly, and any brief interruption to the pipeline should be invisible to end users.

Testing: Despite having tests in place around this problem, including tests related to unreleased changes in parsing the new ZONEMD records, we did not adequately test what happens when the root zone fails to parse. We will improve our test coverage and the related processes.

Architecture: We should not use stale copies of the root zone past a certain point. While it’s certainly possible to continue to use stale root zone data for a limited amount of time, past a certain point there are unacceptable operational risks. We will take measures to ensure that the lifetime of cached root zone data is better managed as described in RFC 8806: Running a Root Server Local to a Resolver.

Conclusion

We are deeply sorry that this incident happened. There is one clear message from this incident: do not ever assume that something is not going to change!  Many modern systems are built with a long chain of libraries that are pulled into the final executable, each one of those may have bugs or may not be updated early enough for programs to operate correctly when changes in input happen. We understand how important it is to have good testing in place that allows detection of regressions and systems and components that fail gracefully on changes to input. We understand that we need to always assume that “format” changes in the most critical systems of the internet (DNS and BGP) are going to have an impact.

We have a lot to follow up on internally and are working around the clock to make sure something like this does not happen again.

Les échecs des recherches sur le résolveur 1.1.1.1 le 4 octobre 2023

Post Syndicated from Ólafur Guðmundsson original http://blog.cloudflare.com/fr-fr/1-1-1-1-lookup-failures-on-october-4th-2023-fr-fr/


Le 4 octobre 2023, Cloudflare a rencontré des problèmes de résolution DNS à partir de 7 h UTC, et ce jusqu’à 11 h UTC. Certains utilisateurs de 1.1.1.1 ou de produits tels que WARP, Zero Trust ou d’autres résolveurs DNS tiers utilisant 1.1.1.1 peuvent avoir reçu des réponses SERVFAIL DNS à leurs requêtes, pourtant valides. Nous sommes sincèrement désolés pour cette panne. Celle-ci était due à une erreur logicielle interne et n’était aucunement le résultat d’une attaque. Cet article de blog va nous permettre de discuter de la nature de cette défaillance, des raisons pour lesquelles elle s’est produite et des mesures que nous avons mises en œuvre pour nous assurer qu’une telle situation ne se reproduise jamais.

Contexte

Dans le Domain Name System (DNS, système de noms de domaine), chaque nom de domaine existe au sein d’une zone DNS. Cette zone constitue un ensemble de noms de domaine et de noms d’hôte, contrôlés conjointement. Pour prendre un exemple, Cloudflare est responsable du nom de domaine cloudflare.com, que nous disons se trouver dans la zone « cloudflare.com ». Le domaine de premier niveau (TLD, Top-Level Domain) « .com » est détenu par un tiers et se situe dans la zone « com ». Il donne des indications sur la manière d’atteindre cloudflare.com. Au-dessus de tous les TLD se trouve la zone racine, qui donne des informations sur la marche à suivre pour joindre les TLD. La zone racine joue donc un rôle important, car elle permet la résolution de tous les autres domaines. Comme d’autres composants importants du DNS, la zone racine est signée à l’aide de DNSSEC, ce qui veut dire que la zone racine elle-même contient des signatures cryptographiques.

La zone racine est publiée sur les serveurs racines, mais il est également courant pour les opérateurs de DNS de récupérer automatiquement et de conserver une copie de la zone racine afin que les informations contenues dans cette dernière restent disponibles au cas où les serveurs racines ne seraient pas joignables. L’infrastructure DNS récursive de Cloudflare adopte cette approche, car elle permet également d’accélérer le processus de résolution. De nouvelles versions de la zone racine sont généralement publiées deux fois par jour. Le résolveur 1.1.1.1 dispose d’une application WebAssembly nommée « static_zone » et exécutée en parallèle de la logique DNS principale. C’est cette application qui transmet les nouvelles versions lorsqu’elles sont disponibles.

Que s’est-il passé ?

Le 21 septembre, dans le cadre d’une modification connue et planifiée de la gestion de la zone racine, un nouveau type d’enregistrement de ressource a été inclus dans les zones racines pour la première fois. Baptisé ZONEMD, ce nouvel enregistrement de ressource constitue, dans les faits, une somme de contrôle pour le contenu de la zone racine.

Cette zone est récupérée à l’aide d’un logiciel exécuté au sein du réseau central de Cloudflare. Elle est ensuite redistribuée vers les datacenters Cloudflare partout dans le monde. Après la modification, la zone racine contenant l’enregistrement ZONEMD a continué à être récupéré et distribué comme à la normale. Toutefois, les systèmes du résolveur 1.1.1.1 qui utilisent ces données ont éprouvé des difficultés pour analyser l’enregistrement ZONEMD record. Comme les zones doivent être chargées et transmises dans leur intégralité, l’échec de l’analyse de ZONEMD impliquait que la zone racine n’était pas utilisée dans les systèmes de résolution de Cloudflare. Certains des serveurs hébergeant l’infrastructure du résolveur de Cloudflare ne parvenaient pas à interroger les serveurs DNS racines directement, requête par requête, car ils n’avaient pas reçu la nouvelle zone racine. D’autres, toutefois, continuaient à se reposer sur la version fonctionnelle connue de cette dernière, toujours disponible dans leur mémoire cache, c’est-à-dire la version extraite le 21 septembre, avant la modification.

Le 4 octobre 2023, à 7 h UTC, les signatures DNSSEC de la version de la zone racine datant du 21 septembre ont expiré. Comme il n’existait aucune nouvelle version de cette zone que les systèmes de résolution de Cloudflare pouvaient utiliser, certains de ces derniers ont commencé à ne plus être en mesure de valider les signatures DNSSEC et ont par conséquent commencé à envoyer des messages d’erreur en guise de réponse (SERVFAIL). Le taux de génération de réponses SERVFAIL par les résolveurs de Cloudflare a augmenté de 12 %. Les schémas ci-dessous illustrent la progression de l’erreur et la manière dont elle est devenue visible pour les utilisateurs.

Chronologie et répercussions de l’incident

21 septembre 6 h 30 UTC : dernière extraction réussie de la zone racine.
4 octobre 7 h UTC : expiration des signatures DNSSEC contenues dans la zone racine obtenue le 21 septembre, avec pour résultat une augmentation des réponses SERVFAIL aux requêtes des clients.
7 h 57 : arrivée des premiers signalements externes de réponses SERVFAIL inattendues.
8 h 03 : déclaration de l’incident en interne chez Cloudflare.
8 h 50 : tentative initiale visant à empêcher le résolveur 1.1.1.1 d’émettre des réponses basées sur le fichier de zone racine obsolète à l’aide d’une règle de forçage.
10 h 30 : déploiement d’une mesure empêchant le résolveur 1.1.1.1 de précharger le fichier de zone racine dans son intégralité.
10 h 32 : retour à la normale des réponses.
11 h 02 : fin de l’incident.

Le graphique ci-dessous montre la frise chronologique des répercussions par rapport au pourcentage de requêtes DNS ayant reçu une erreur SERVFAIL en réponse :

Nous nous attendons à un certain volume de base d’erreurs SERVFAIL pour le trafic normal, en période d’activité normale. Ce pourcentage se situe généralement autour des 3 %. Ces erreurs SERVFAIL peuvent résulter de problèmes légitimes au sein de la chaîne DNSSEC, d’échecs de la connexion aux serveurs de référence, d’un délai de réponse trop long de la part des serveurs de référence et de bien d’autres sources. Au cours de l’incident, la quantité d’erreurs SERVFAIL s’est élevée à 15 % du total des requêtes. L’impact n’était toutefois pas distribué de manière homogène à travers le monde et se concentrait principalement dans nos plus grands datacenters, comme ceux d’Ashburn, en Virginia, de Francfort, en Allemagne, et de Singapour.

Les raisons à l’origine de l’incident

Pourquoi l’analyse de l’enregistrement ZONEMD a échoué

Le DNS utilise un format binaire pour stocker les enregistrements de ressources. Sous ce format binaire, le type de l’enregistrement de ressource (TYPE) est stocké sous la forme d’un nombre entier à 16 bits. Le type d’enregistrement de ressource détermine la manière dont les données de la ressource (RDATA) sont analysées. Un type d’enregistrement défini sur 1 signifie qu’il s’agit d’un enregistrement A et que les RDATA peuvent être considérées comme une adresse IPv4. En réciproque, le type 28 désigne un enregistrement AAAA, dont les RDATA peuvent être analysées sous la forme d’une adresse IPv6. Un analyseur qui rencontre un type d’enregistrement inconnu ne saura pas comment analyser ses RDATA, mais n’aura heureusement pas à le faire : le champ RDLENGTH indique la longueur du champ RDATA, soit un paramètre qui permet à l’analyseur de traiter l’enregistrement comme un élément de données opaque.

                                   1  1  1  1  1  1
      0  1  2  3  4  5  6  7  8  9  0  1  2  3  4  5
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                                               |
    /                                               /
    /                      NAME                     /
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TYPE                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                     CLASS                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TTL                      |
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                   RDLENGTH                    |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--|
    /                     RDATA                     /
    /                                               /
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
RFC 1035

L’application static_zone n’a pas pris en charge le nouvel enregistrement ZONEMD, car jusqu’ici, nous avions choisi de distribuer la zone racine en interne sous son format de présentation, plutôt que sous son format binaire. Lorsque nous observons la représentation texte de quelques enregistrements de ressource, nous pouvons constater la présence de bien plus de variations dans la manière dont les différents enregistrements sont présentés.

.			86400	IN	SOA	a.root-servers.net. nstld.verisign-grs.com. 2023100400 1800 900 604800 86400
.			86400	IN	RRSIG	SOA 8 0 86400 20231017050000 20231004040000 46780 . J5lVTygIkJHDBt6HHm1QLx7S0EItynbBijgNlcKs/W8FIkPBfCQmw5BsUTZAPVxKj7r2iNLRddwRcM/1sL49jV9Jtctn8OLLc9wtouBmg3LH94M0utW86dKSGEKtzGzWbi5hjVBlkroB8XVQxBphAUqGxNDxdE6AIAvh/eSSb3uSQrarxLnKWvHIHm5PORIOftkIRZ2kcA7Qtou9NqPCSE8fOM5EdXxussKChGthmN5AR5S2EruXIGGRd1vvEYBrRPv55BAWKKRERkaXhgAp7VikYzXesiRLdqVlTQd+fwy2tm/MTw+v3Un48wXPg1lRPlQXmQsuBwqg74Ts5r8w8w==
.			518400	IN	NS	a.root-servers.net.
.			86400	IN	ZONEMD	2023100400 1 241 E375B158DAEE6141E1F784FDB66620CC4412EDE47C8892B975C90C6A102E97443678CCA4115E27195B468E33ABD9F78C
Exemples d’enregistrements pris sur https://www.internic.net/domain/root.zone

Lorsque nous rencontrons un enregistrement de ressource inconnu, il n’est pas toujours évident de savoir comment le traiter. De ce fait, la bibliothèque que nous utilisons pour analyser la zone racine en périphérie de notre réseau ne s’y risque même pas et renvoie à la place une erreur d’analyse.

Pourquoi une version obsolète de la zone racine a été utilisée

L’application static_zone, chargée de charger et d’analyser la zone racine afin de diffuser cette dernière localement (RFC 7706), stocke la dernière version en mémoire. Lorsqu’une nouvelle version est publiée et qu’elle l’analyse (et qu’elle y parvient !), l’application abandonne l’ancienne version. Toutefois, comme l’analyse a échoué, l’application static_zone n’est jamais passée à la nouvelle version et a continué d’utiliser l’ancienne indéfiniment. Quand le service 1.1.1.1 est lancé pour la première fois, l’application static_zone ne dispose pas d’une version existante en mémoire. Lorsque l’application tente d’analyser la zone racine, mais qu’elle n’y parvient pas, elle se rabat sur l’interrogation directe des serveurs racines concernant les requêtes entrantes, car elle ne dispose pas d’une version plus ancienne de la zone racine sur laquelle se replier.

Pourquoi la tentative initiale de désactiver static_zone n’a pas fonctionné

Au départ, nous avons tenté de désactiver l’application static_zone par le biais d’une règle de forçage, un mécanisme qui nous permet de modifier certains comportements du résolveur 1.1.1.1 de manière programmatique. La règle que nous avons déployée était la suivante :

phase = pre-cache set-tag rec_disable_static

Cette règle ajoute à chaque requête entrante la balise rec_disable_static. Nous vérifions la présence de cette balise au sein de l’application static_zone et, si nous la voyons apparaître, nous ne renvoyons pas de réponse de la zone racine statique, mise en cache. Toutefois, afin d’améliorer les performances du cache, les requêtes sont parfois transférées à un autre nœud, si le nœud actuel ne parvient pas à trouver la réponse dans son propre cache. Malheureusement, la balise rec_disable_static n’est pas incluse dans les requêtes transférées aux autres nœuds. C’est ce qui a amené l’application static_zone à continuer à répondre par des informations obsolètes, jusqu’à ce que nous désactivions totalement l’application.

Pourquoi les impacts ont été partiels

Cloudflare procède régulièrement au redémarrage alterné des serveurs qui hébergent nos services pour des tâches telles que la mise à jour du noyau, qui ne peut prendre effet qu’après un redémarrage complet du système. Au moment de la défaillance, les instances serveur du résolveur qui avaient été redémarrées entre la modification ZONEMD et l’invalidation des DNSSEC n’ont pas contribué à l’impact. Si elles avaient redémarré au cours de cette période de deux semaines, elles n’auraient pas pu charger la zone racine au démarrage et s’en seraient remises à la résolution par envoi de requêtes DNS aux serveurs racines à la place. En outre, le résolveur utilise une technique nommée « Diffuser du contenu obsolète » (RFC 8767) dans le but de pouvoir continuer à diffuser des enregistrements populaires depuis un cache potentiellement obsolète afin de limiter les impacts. Un enregistrement est considéré comme obsolète lorsqu’un nombre de secondes égal au TTL s’est écoulé depuis que l’enregistrement a été récupéré en amont. Cette fonctionnalité a évité une défaillance totale. Les impacts se sont fait principalement sentir dans nos plus grands datacenters, qui disposaient de nombreux serveurs n’ayant pas redémarré le service 1.1.1.1 au cours de cette période.

Mesures de correction et de suivi

Cet incident a eu des répercussions très étendues. En outre, nous prenons la disponibilité de nos services très au sérieux. Nous avons identifié plusieurs domaines d’amélioration et continuerons à nous efforcer de dénicher d’éventuelles autres lacunes susceptibles d’entraîner une récidive.

Dans l’immédiat, nous travaillons sur ce qui suit :

Visibilité : nous allons ajouter des alertes conçues pour nous informer lorsque l’application static_zone diffuse un fichier de zone racine obsolète. En effet, cette diffusion n’aurait pas dû passer inaperçue aussi longtemps. Si nous avions mieux surveillé la zone racine (et grâce aux possibilités de mise en cache existantes), la défaillance n’aurait eu aucun impact. Notre objectif consiste à protéger nos clients et leurs utilisateurs des modifications en amont.

Résilience : nous allons réévaluer la manière dont nous ingérons et distribuons la zone racine en interne. Nos pipelines d’ingestion et de distribution doivent pouvoir traiter les RRTYPE sans accroc et les éventuelles interruptions brèves du pipeline doivent être invisibles pour les utilisateurs finaux.

Tests : malgré la présence de tests en place autour de ce problème, y compris de tests liés à des modifications non publiées pour l’analyse des nouveaux enregistrements ZONEMD, nous n’avons pas suffisamment testé ce qui se produit lorsque l’analyse de la zone racine échoue. Nous allons améliorer notre couverture de tests, de même que les processus connexes.

Architecture : nous ne devrions pas utiliser de copies obsolètes de la zone racine passé un certain point. S’il est certes possible de continuer à utiliser des données de zone racine pendant une période limitée, ces dernières entraînent des risques opérationnels inacceptables après un moment. Nous allons prendre des mesures pour nous assurer que la durée de vie des données de zone racine mises en cache soit mieux gérée, comme décrit dans la RFC 8806 : Running a Root Server Local to a Resolver (Exécuter un serveur racine en local pour un résolveur).

Conclusion

Nous sommes profondément désolés que cet incident se soit produit. Nous en retirons un message clair : il ne fait jamais supposer que rien ne va changer ! De nombreux systèmes modernes sont bâtis autour d’une longue chaîne de bibliothèques extraites au sein de l’exécutable final et chacune d’elles peut comporter des bugs ou ne pas être mise à jour suffisamment tôt pour que les programmes puissent fonctionner correctement lorsque des changements se produisent au niveau des intrants. Nous comprenons l’importance du fait de disposer d’une bonne structure de tests en place, capable de détecter les régressions, de même que les systèmes et les composants qui rencontrent des défaillances invisibles au premier abord après une modification des intrants. Nous savons que nous devons toujours partir du principe que les changements de « format » au niveau des systèmes les plus essentiels d’Internet (le DNS et le BGP) auront forcément des répercussions.

Nous avons beaucoup de suivi à effectuer en interne et travaillons sans relâche pour nous assurer que ce genre d’incident ne se reproduise plus jamais.

1.1.1.1 Lookup-Fehler am 4. Oktober 2023

Post Syndicated from Ólafur Guðmundsson original http://blog.cloudflare.com/de-de/1-1-1-1-lookup-failures-on-october-4th-2023-de-de/


Am 4. Oktober 2023 traten bei Cloudflare Probleme bei der DNS-Auflösung auf, die um 07:00 UTC begannen und um 11:00 UTC endeten. Einige Nutzer von 1.1.1.1 oder Produkten wie WARP, Zero Trust oder DNS-Resolvern von Drittanbietern, die 1.1.1.1 verwenden, haben möglicherweise SERVFAIL DNS-Antworten auf gültige Anfragen erhalten. Wir möchten uns vielmals für diesen Ausfall entschuldigen. Dieser Ausfall war ein interner Softwarefehler und nicht das Ergebnis eines Angriffs. In diesem Blogartikel werden wir erläutern, was der Fehler war, warum er auftrat und was wir unternehmen, um sicherzustellen, dass sich so etwas nicht wiederholt.

Hintergrund

Im Domain Name System (DNS) existiert jeder Domain-Name innerhalb einer DNS-Zone. Die Zone ist eine Sammlung von Domain-Namen und Host-Namen, die gemeinsam kontrolliert werden. So ist Cloudflare beispielsweise für die Domain cloudflare.com verantwortlich, die sich in der Zone „cloudflare.com“ befindet. Die Top-Level-Domain (TLD) .com gehört einer dritten Partei und befindet sich in der Zone „com“. Sie gibt Auskunft darüber, wie cloudflare.com zu erreichen ist. Über allen TLDs befindet sich die Root-Zone, die Hinweise darauf gibt, wie die TLDs erreicht werden. Das bedeutet, dass die Root-Zone wichtig ist, um alle anderen Domain-Namen auflösen zu können. Wie andere wichtige Teile des DNS ist auch die Root-Zone mit DNSSEC signiert, was bedeutet, dass die Root-Zone selbst kryptografische Signaturen enthält.

Die Root-Zone wird aufden Root-Servern, veröffentlicht, es ist jedoch auch üblich, dass DNS-Betreiber automatisch eine Kopie der Root-Zone abrufen und aufbewahren. Damit sind die Informationen in der Root-Zone auch dann noch verfügbar, wenn die Root-Server nicht erreichbar sind. Die rekursive DNS-Infrastruktur von Cloudflare verfolgt diesen Ansatz, da er auch den Auflösungsprozess beschleunigt. Neue Versionen der Root-Zone werden normalerweise zweimal täglich veröffentlicht. 1.1.1.1 verfügt über eine WebAssembly-Anwendung namens static_zone, die über der Haupt-DNS-Logik läuft und diese neuen Versionen bereitstellt, sobald sie verfügbar sind.

Was ist passiert?

Am 21. September wurde im Rahmen einer bekannten und geplanten Änderung der Verwaltung der Root-Zonen erstmals ein neuer Typ von Ressourceneintrag in die Root-Zonen aufgenommen. Der neue Ressourceneintrag trägt die Bezeichnung ZONEMD und ist im Grunde eine Prüfsumme für den Inhalt der Root-Zone.

Die Root-Zone wird von einer Software abgerufen, die im Kernnetzwerk von Cloudflare läuft. Anschließend wird sie an die Rechenzentren von Cloudflare auf der ganzen Welt weiterverteilt. Nach der Änderung wurde die Root-Zone, die den ZONEMD-Eintrag enthält, weiterhin wie gewohnt abgerufen und verteilt. Die 1.1.1.1-Resolver-Systeme, die diese Daten verwenden, hatten jedoch Probleme beim Parsen des ZONEMD-Eintrags. Da Zonen in ihrer Gesamtheit geladen und bereitgestellt werden müssen, bedeutete das Versagen des Systems beim Parsen von ZONEMD, dass die neuen Versionen der Root-Zone nicht in den Resolver-Systemen von Cloudflare verwendet wurden. Einige der Server, die die Resolver-Infrastruktur von Cloudflare hosten, gingen dazu über, die DNS-Root-Server direkt abzufragen, wenn sie die neue Root-Zone nicht erhalten haben. Andere verließen sich jedoch weiterhin auf die bekannte funktionierende Version der Root-Zone, die noch in ihrem Speichercache vorhanden war, d. h. die Version, die am 21. September vor der Änderung abgerufen wurde.

Am 4. Oktober 2023 um 07:00 UTC sind die DNSSEC-Signaturen in der Version der Root-Zone vom 21. September abgelaufen. Da es keine neuere Version gab, die die Cloudflare-Resolversysteme verwenden konnten, waren einige der Cloudflare-Resolversysteme nicht mehr in der Lage, DNSSEC-Signaturen zu validieren und begannen daher, Fehlerantworten (SERVFAIL) zu übermitteln. Die Rate, mit der Cloudflare-Resolver SERVFAIL-Antworten generierten, stieg um 12 %. Die folgenden Abbildungen veranschaulichen den Verlauf des Ausfalls und wie er für die Nutzer sichtbar wurde.

Zeitlicher Ablauf und Auswirkungen des Vorfalls

21. September 6:30 UTC: Letzter erfolgreicher Abruf (Pull) der Root-Zone
4. Oktober 7:00 UTC: DNSSEC-Signaturen in der Root-Zone, die am 21. September erhalten wurden, sind abgelaufen, was zu einem Anstieg der SERVFAIL-Antworten auf Client-Abfragen führt.
7:57: Erste externe Berichte über unerwartete SERVFAILs treffen ein.
8:03: Interner Cloudflare-Vorfall gemeldet.
8:50: Ein erster Versuch wird unternommen, den 1.1.1.1-Dienst mittels einer Override-Regel davon abzuhalten, Antworten mit der veralteten Root-Datei zu übermitteln.
10:30: 1.1.1.1 hat das Vorladen der Root-Zonendatei vollständig gestoppt.
10:32: Die Antworten sind wieder normal.
11:02: Vorfall abgeschlossen.

Das folgende Diagramm zeigt den zeitlichen Verlauf der Auswirkungen zusammen mit dem Prozentsatz der DNS-Abfragen, auf die ein SERVFAIL-Fehler ausgegeben wurde:

Bei normalem Traffic erwarten wir ein bestimmtes Volumen an SERVFAIL-Fehlern im Normalbetrieb. Normalerweise liegt dieser Prozentsatz bei etwa 3 %. Diese SERVFAILs können durch legitime Probleme in der DNSSEC-Kette, Fehler bei der Verbindung zu autoritativen Servern, zu lange Antwortzeiten der autoritativen Server und viele andere Faktoren verursacht werden. Während des Vorfalls erreichte die Anzahl der SERVFAILs einen Spitzenwert von 15 % der gesamten Abfragen, obwohl die Auswirkungen nicht gleichmäßig über die Welt verteilt waren und sich hauptsächlich auf unsere größeren Rechenzentren wie Ashburn, Virginia, Frankfurt und Singapur konzentrierten.

Warum es zu diesem Vorfall kam

Warum das Parsen des ZONEMD-Eintrags fehlgeschlagen ist

DNS hat ein binäres Format für die Speicherung von Ressourceneinträgen. In diesem Binärformat wird der Typ des Ressourceneintrags (TYPE) als 16-Bit-Integer gespeichert. Der Typ des Ressourceneintrags bestimmt, wie die Ressourcendaten (RDATA) geparst werden. Wenn der Eintragstyp 1 ist, bedeutet dies, dass es sich um einen A-Eintrag handelt und die RDATA als IPv4-Adresse geparst werden kann. Eintragstyp 28 ist ein AAAA-Eintrag, dessen RDATA stattdessen als IPv6-Adresse geparst werden kann. Wenn ein Parser auf einen unbekannten Ressourcentyp stößt, weiß er nicht, wie er dessen RDATA parsen soll, aber glücklicherweise muss er das auch nicht: Das Feld RDLENGTH gibt an, wie lang das RDATA-Feld ist, so dass der Parser es als undurchsichtiges Datenelement behandeln kann.

                                   1  1  1  1  1  1
      0  1  2  3  4  5  6  7  8  9  0  1  2  3  4  5
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                                               |
    /                                               /
    /                      NAME                     /
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TYPE                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                     CLASS                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TTL                      |
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                   RDLENGTH                    |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--|
    /                     RDATA                     /
    /                                               /
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
RFC 1035

Warum static_zone den neuen ZONEMD-Eintrag noch nicht unterstützte? Weil wir uns bisher dafür entschieden hatten, die Root-Zone intern in ihrem Darstellungsformat und nicht im Binärformat zu verteilen. Ein Blick auf die Textdarstellung einiger Ressourceneinträge zeigt, dass es bei der Darstellung der verschiedenen Datensätze sehr viel mehr Unterschiede gibt.

.			86400	IN	SOA	a.root-servers.net. nstld.verisign-grs.com. 2023100400 1800 900 604800 86400
.			86400	IN	RRSIG	SOA 8 0 86400 20231017050000 20231004040000 46780 . J5lVTygIkJHDBt6HHm1QLx7S0EItynbBijgNlcKs/W8FIkPBfCQmw5BsUTZAPVxKj7r2iNLRddwRcM/1sL49jV9Jtctn8OLLc9wtouBmg3LH94M0utW86dKSGEKtzGzWbi5hjVBlkroB8XVQxBphAUqGxNDxdE6AIAvh/eSSb3uSQrarxLnKWvHIHm5PORIOftkIRZ2kcA7Qtou9NqPCSE8fOM5EdXxussKChGthmN5AR5S2EruXIGGRd1vvEYBrRPv55BAWKKRERkaXhgAp7VikYzXesiRLdqVlTQd+fwy2tm/MTw+v3Un48wXPg1lRPlQXmQsuBwqg74Ts5r8w8w==
.			518400	IN	NS	a.root-servers.net.
.			86400	IN	ZONEMD	2023100400 1 241 E375B158DAEE6141E1F784FDB66620CC4412EDE47C8892B975C90C6A102E97443678CCA4115E27195B468E33ABD9F78C
Beispieldatensätze entnommen von https://www.internic.net/domain/root.zone

Wenn wir auf einen unbekannten Ressourceneintrag stoßen, ist es nicht immer einfach zu wissen, wie wir damit umgehen sollen. Aus diesem Grund unternimmt die Bibliothek, die wir zum Parsen der Root-Zone an der Edge verwenden, keinen entsprechenden Versuch und gibt stattdessen einen Parser-Fehler aus.

Warum eine veraltete Version der Root-Zone verwendet wurde

Die static_zone-App, die mit dem Laden und Parsen der Root-Zone beauftragt ist, um die Root-Zone lokal bereitzustellen (RFC 7706), speichert die neueste Version im Speicher. Wenn eine neue Version veröffentlicht wird, parst sie diese und verwirft bei erfolgreichem Parsen die alte Version. Da das Parsen jedoch fehlschlug, wechselte die static_zone-App nie zu einer neueren Version, sondern verwendete stattdessen weiterhin die alte Version auf unbestimmte Zeit. Wenn der 1.1.1.1-Dienst zum ersten Mal gestartet wird, hat die static_zone-App keine bestehende Version im Speicher. Wenn sie versucht, die Root-Zone zu analysieren, schlägt dies fehl, aber da sie nicht auf eine ältere Version der Root-Zone zurückgreifen kann, fragt sie die Root-Server direkt nach eingehenden Anfragen ab.

Warum der erste Versuch, static_zone zu deaktivieren, nicht funktioniert hat

Zunächst versuchten wir, die static_zone-App durch Überschreibungsregeln zu deaktivieren, ein Mechanismus, mit dem wir einige Verhaltensweisen von 1.1.1.1 programmatisch ändern können. Die von uns angewandte Regel lautete:

phase = pre-cache set-tag rec_disable_static

Bei jeder eingehenden Anfrage fügt diese Regel das Tag rec_disable_static zur Anfrage hinzu. In der static_zone-App wird auf dieses Tag geprüft, und wenn es gesetzt ist, wird keine Antwort aus der gecachten, statischen Root-Zone ausgegeben. Zur Verbesserung der Cache-Performance werden Abfragen jedoch manchmal an einen anderen Knoten weitergeleitet, wenn der aktuelle Knoten die Antwort nicht in seinem eigenen Cache finden kann. Leider ist das rec_disable_static-Tag nicht in den Abfragen enthalten, die an andere Knoten weitergeleitet werden, was dazu führte, dass die static_zone-App weiterhin mit veralteten Informationen antwortete, bis wir die App schließlich ganz deaktivierten.

Warum die Auswirkungen nur teilweise eintraten

Cloudflare führt regelmäßig fortlaufende Neustarts der Server durch, auf denen unsere Dienste gehostet werden, um Aufgaben wie Kernel-Updates durchzuführen, die nur nach einem vollständigen Neustart des Systems wirksam werden können. Zum Zeitpunkt dieses Ausfalls trugen Resolver-Server-Instanzen, die zwischen der ZONEMD-Änderung und der DNSSEC-Ungültigmachung neu gestartet wurden, nicht zu den Auswirkungen bei. Hätten sie während dieses zweiwöchigen Zeitraums neu gestartet, hätten sie die Root-Zone beim Start nicht geladen und stattdessen DNS-Abfragen an Root-Server gesendet. Darüber hinaus verwendet der Resolver eine Technik namens „serve stale“ (RFC 8767) mit dem Ziel, beliebte Einträge aus einem möglicherweise veralteten Cache weiter zu übermitteln, um die Auswirkungen zu begrenzen. Ein Eintrag gilt als veraltet, wenn die TTL-Sekundenzahl seit dem Abruf des Eintrags aus dem vorgelagerten Bereich verstrichen ist.  Dadurch konnte ein Totalausfall verhindert werden; die Auswirkungen waren vor allem in unseren größten Rechenzentren zu spüren, in denen viele Server standen, die den 1.1.1.1-Dienst in diesem Zeitraum nicht neu gestartet hatten.

Abhilfe- und Folgemaßnahmen

Dieser Vorfall hatte weitreichende Auswirkungen, und wir nehmen die Verfügbarkeit unserer Dienste sehr ernst. Wir haben mehrere Bereiche identifiziert, in denen Verbesserungen möglich sind, und werden weiter daran arbeiten, weitere Lücken aufzudecken, die einen erneutes Auftreten verursachen könnten.

An diesen Aspekten arbeiten wir sofort:

Sichtbarkeit: Wir fügen Warnungen hinzu, um zu benachrichtigen, wenn static_zone eine veraltete Root-Zonendatei bereitstellt. Es hätte nicht sein dürfen, dass das Bereitstellen einer veralteten Root-Zonendatei so lange unbemerkt bleibt, wie es der Fall war. Hätten wir dies besser überwacht, hätte es dank der vorhandenen Zwischenspeicherung keine Auswirkungen gegeben. Unser Ziel ist es, unsere Kunden und deren Nutzer vor vorgelagerten Änderungen zu schützen.

Ausfallsicherheit: Wir werden neu bewerten, wie wir die Root-Zone intern einlesen und verteilen. Unsere Aufnahme- und Verteilungspipelines sollten neue RRTYPEs nahtlos verarbeiten, und jede kurze Unterbrechung der Pipeline sollte für Endnutzer nicht sichtbar sein.

Tests: Obwohl wir Tests zu diesem Problem durchgeführt haben, einschließlich Tests zu noch nicht veröffentlichten Änderungen beim Parsen der neuen ZONEMD-Einträge, haben wir nicht ausreichend getestet, was passiert, wenn die Root-Zone nicht geparst werden kann. Wir werden den Testumfang und die damit verbundenen Prozesse verbessern.

Architektur: Wir sollten ab einem bestimmten Punkt keine veralteten Kopien der Root-Zone mehr verwenden. Es ist zwar möglich, veraltete Root-Zonendaten für eine begrenzte Zeit weiter zu verwenden, aber ab einem bestimmten Punkt gibt es inakzeptable Betriebsrisiken. Wir werden Maßnahmen ergreifen, um sicherzustellen, dass die Lebensdauer von gecachten Root-Zonendaten besser verwaltet wird, wie in „RFC 8806: Running a Root Server Local to a Resolver“ beschrieben.

Fazit

Wir bedauern zutiefst, dass es zu diesem Vorfall gekommen ist. Aus diesem Vorfall ergibt sich eine klare Botschaft: Gehen Sie niemals davon aus, dass sich etwas nicht ändern wird!  Viele moderne Systeme bestehen aus einer langen Kette von Bibliotheken, die in die endgültige ausführbare Datei einfließen. Jede dieser Bibliotheken kann Fehler enthalten oder nicht früh genug aktualisiert werden, damit die Programme bei Änderungen der Eingaben korrekt funktionieren. Wir wissen, wie wichtig gute Tests sind, die es ermöglichen, Regressionen zu erkennen und Systeme und Komponenten zu entwickeln, die bei Änderungen der Eingaben zuverlässig versagen. Wir verstehen, dass wir immer davon ausgehen müssen, dass „Format“-Änderungen in den kritischsten Systemen des Internets (DNS und BGP) Auswirkungen haben werden.

Wir haben intern viel zu klären und arbeiten rund um die Uhr, um sicherzustellen, dass sich so etwas nicht wiederholt.

Fallos de la búsqueda de 1.1.1.1 del 4 de octubre de 2023

Post Syndicated from Ólafur Guðmundsson original http://blog.cloudflare.com/es-es/1-1-1-1-lookup-failures-on-october-4th-2023-es-es/


El 4 de octubre de 2023, Cloudflare sufrió problemas en la resolución de DNS entre las 07:00 y las 11:00 UTC. Algunos usuarios de 1.1.1.1 o de productos como WARP, Zero Trust o de solucionadores DNS externos que utilicen 1.1.1.1 pueden haber recibido respuestas SERVFAIL DNS a consultas válidas. Lamentamos mucho esta interrupción. Fue debido a un error interno del software y no fue consecuencia de ningún ataque. En esta publicación del blog, hablaremos acerca de en qué consistió el fallo, por qué se produjo y qué estamos haciendo para garantizar que no se repita.

Antecedentes

En el sistema de nombres de dominio (DNS), cada nombre de dominio existe en una zona DNS, que está formada por un conjunto de nombres de dominio y nombres de servidor que se controlan juntos. Por ejemplo, Cloudflare es responsable del nombre de dominio cloudflare.com, que decimos que está en la zona “cloudflare.com”. El dominio de nivel superior (TLD) .com es propiedad de un tercero y está en la zona “com”. Proporciona indicaciones acerca de cómo llegar a cloudflare.com. Por encima de todos los TLD se encuentra la zona raíz, que ofrece indicaciones acerca de cómo llegar a los TLD. Esto significa que la zona raíz es importante para poder resolver todos los demás nombres de dominio. Al igual que otros componentes importantes del DNS, la zona raíz está firmada con DNSSEC, lo que significa que la propia zona raíz contiene firmas criptográficas.

La zona raíz se publica en los servidores raíz, pero también es habitual que los operadores de DNS recuperen y conserven automáticamente una copia de la zona raíz. De esta forma, en el caso de que no se pueda contactar con los servidores raíz, la información de la zona raíz seguirá estando disponible. La infraestructura DNS recursiva de Cloudflare adopta este enfoque, ya que también acelera el proceso de resolución. Las nuevas versiones de la zona raíz suelen publicarse dos veces al día. 1.1.1.1 tiene una aplicación WebAssembly denominada static_zone que se ejecuta sobre la lógica de DNS principal que entrega estas nuevas versiones cuando están disponibles.

Qué pasó

El 21 de septiembre, como parte de un cambio conocido y planificado en la gestión de las zonas raíz, se incluyó por primera vez en ellas un nuevo registro de recurso, denominado ZONEMD, que en realidad es una suma de comprobación del contenido de la zona raíz.

La zona raíz se recupera mediante software que se ejecuta en la red principal de Cloudflare. A continuación se redistribuye a los centros de datos de Cloudflare en todo el mundo. Tras el cambio, la recuperación y distribución de la zona raíz que contenía el registro ZONEMD continuaron con normalidad. Sin embargo, los sistemas de resolución de 1.1.1.1 que utilizan estos datos tuvieron problemas al analizar el registro ZONEMD. Debido a que las zonas se deben cargar y entregar en su totalidad, el hecho de que el sistema no pudiera analizar el registro ZONEMD significó que las nuevas versiones de la zona raíz no se utilizaban en los sistemas de resolución de Cloudflare. Algunos de los servidores que alojan la infraestructura de resolución de Cloudflare, al no recibir la nueva zona raíz, pasaron a consultar los servidores raíz DNS directamente a nivel individual para cada solicitud. No obstante, otros continuaron confiando en la versión funcional conocida de la zona raíz aún disponible en su caché de memoria, que era la versión obtenida el 21 de septiembre antes del cambio.

El 4 de octubre de 2023 a las 07:00 UTC, las firmas DNSSEC en la versión de la zona raíz del 21 de septiembre caducaron. Puesto que no había ninguna versión más nueva que los sistemas de resolución de Cloudflare pudieran utilizar, algunos de ellos dejaron de poder validar las firmas DNSSEC y, como resultado, empezaron a enviar respuestas de error (SERVFAIL). La velocidad a la que los solucionadores de Cloudflare generaron respuestas SERVFAIL aumentó un 12 %. Los diagramas siguientes muestran la evolución del fallo y cómo se visualizó para los usuarios.

Cronología e impacto del incidente

21 de septiembre 6:30 UTC: última extracción correcta de la zona raíz.
4 de octubre 7:00 UTC: las firmas DNSSEC en la zona raíz obtenidas el 21 de septiembre caducan, lo que causa un incremento de las respuestas SERVFAIL a las consultas de los clientes.
7:57: se empiezan a recibir las primeras notificaciones externas acerca de respuestas SERVFAIL inesperadas.
8:03: se declara un incidente interno de Cloudflare.
8:50: se realiza un intento inicial con una regla de anulación para evitar que 1.1.1.1 entregue respuestas utilizando el archivo de zona raíz obsoleto.
10:30: se evita que 1.1.1.1 precargue el archivo de zona raíz en su totalidad.
10:32: las respuestas vuelven a la normalidad.
11:02: se cierra el incidente.

El gráfico siguiente muestra la cronología del impacto del incidente junto con el porcentaje de consultas DNS que se devolvieron con un error SERVFAIL:

Esperamos un volumen de línea base de errores SERVFAIL para el tráfico habitual durante el funcionamiento normal. Ese porcentaje suele girar en torno al 3 %. Estos errores SERVFAIL pueden ser debidos a problemas reales en la cadena DNSSEC, a la imposibilidad de conectarse a los servidores autoritativos, a que los servidores autoritativos tardan demasiado en responder y a muchos otros motivos. Durante el incidente, el número máximo de errores SERVFAIL fue del 15 % del total de consultas, aunque la repercusión no fue uniforme en todo el mundo y se concentró principalmente en nuestros centros de datos más grandes, como los de Ashburn (Virginia), Fráncfort (Alemania) y Singapur.

Por qué se produjo este incidente

Por qué falló el análisis del registro ZONEMD

DNS tiene un formato binario para el almacenamiento de registros de recursos. En este formato binario, el tipo del registro de recurso (TYPE) se almacena como un entero de 16 bits. El tipo de registro de recurso determina cómo se analizan los datos del recurso (RDATA). Cuando el tipo de registro es 1, esto significa que es un registro A, y que RDATA se puede analizar como una dirección IPv4. En cambio, el tipo de registro 28 es un registro AAAA, cuyo RDATA se puede analizar como una dirección IPv6. Cuando un analizador se encuentra con un tipo de recurso desconocido, no sabrá cómo analizar su RDATA, pero afortunadamente no tiene que hacerlo: el campo RDLENGTH indica la longitud del campo RDATA, lo que permite al analizador tratarlo como un elemento de datos opaco.

                                   1  1  1  1  1  1
      0  1  2  3  4  5  6  7  8  9  0  1  2  3  4  5
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                                               |
    /                                               /
    /                      NAME                     /
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TYPE                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                     CLASS                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TTL                      |
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                   RDLENGTH                    |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--|
    /                     RDATA                     /
    /                                               /
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
RFC 1035

El motivo por el que static_zone no admitió el nuevo registro ZONEMD es porque hasta ahora habíamos optado por distribuir la zona raíz internamente en su formato de presentación, en lugar de en formato binario. Si miramos la representación de texto de algunos registros de recursos, podemos ver que hay mucha variación en cómo se presentan los distintos recursos.

.			86400	IN	SOA	a.root-servers.net. nstld.verisign-grs.com. 2023100400 1800 900 604800 86400
.			86400	IN	RRSIG	SOA 8 0 86400 20231017050000 20231004040000 46780 . J5lVTygIkJHDBt6HHm1QLx7S0EItynbBijgNlcKs/W8FIkPBfCQmw5BsUTZAPVxKj7r2iNLRddwRcM/1sL49jV9Jtctn8OLLc9wtouBmg3LH94M0utW86dKSGEKtzGzWbi5hjVBlkroB8XVQxBphAUqGxNDxdE6AIAvh/eSSb3uSQrarxLnKWvHIHm5PORIOftkIRZ2kcA7Qtou9NqPCSE8fOM5EdXxussKChGthmN5AR5S2EruXIGGRd1vvEYBrRPv55BAWKKRERkaXhgAp7VikYzXesiRLdqVlTQd+fwy2tm/MTw+v3Un48wXPg1lRPlQXmQsuBwqg74Ts5r8w8w==
.			518400	IN	NS	a.root-servers.net.
.			86400	IN	ZONEMD	2023100400 1 241 E375B158DAEE6141E1F784FDB66620CC4412EDE47C8892B975C90C6A102E97443678CCA4115E27195B468E33ABD9F78C
Registros de ejemplo obtenidos en https://www.internic.net/domain/root.zone

Cuando nos encontramos con un registro de recurso desconocido, no siempre es fácil saber cómo gestionarlo. Por este motivo, la biblioteca que utilizamos para analizar la zona raíz en el perímetro no intenta hacer esto, y en su lugar devuelve un error del analizador.

Por qué se utilizó una versión obsoleta de la zona raíz

La aplicación static_zone, cuya tarea es cargar y analizar la zona raíz con la finalidad de entregar la zona raíz a nivel local (RFC 7706), almacena la última versión en memoria. Cuando se publica una nueva versión la analiza y, cuando ha completado correctamente el análisis, descarta la versión anterior. Sin embargo, puesto que el análisis falló, la aplicación static_zone nunca cambió a la nueva versión, y continuó utilizando la versión anterior indefinidamente. Cuando el servicio 1.1.1.1 se inicia por primera vez, la aplicación static_zone no tiene ninguna versión existente en memoria. Cuando intenta analizar la zona raíz, el análisis falla, pero puesto que no tiene ninguna versión anterior de la zona raíz de reserva, recurre a consultar los servidores raíz directamente para las solicitudes entrantes.

Por qué el intento inicial de desactivar static_zone no funcionó

En un principio, intentamos desactivar la aplicación static_zone mediante reglas de anulación, un mecanismo que nos permite modificar mediante programación determinados comportamientos de 1.1.1.1. La regla que implementamos fue la siguiente:

phase = pre-cache set-tag rec_disable_static

Para toda solicitud entrante, esta regla añade la etiqueta rec_disable_static a la solicitud. En la aplicación static_zone, buscamos esta etiqueta y, si está establecida, no devolvemos una respuesta desde la zona raíz estática en caché. No obstante, a fin de mejorar el rendimiento de la caché las consultas a veces se reenvían a otro nodo en el caso de que el nodo actual no pueda encontrar la respuesta en su propia caché. Lamentablemente, la etiqueta rec_disable_static no está incluida en las consultas que se reenvían a otros nodos, por lo que la aplicación static_zone continuó respondiendo con información obsoleta hasta que finalmente desactivamos la aplicación por completo.

Por qué el impacto fue parcial

Cloudflare realiza periódicamente reinicios secuenciales de los servidores que alojan nuestros servicios a fin de realizar tareas como las actualizaciones de kernel, que requieren un reinicio completo del sistema para entrar en vigor. Cuando se produjo esta interrupción, las instancias de servidor de solucionador que se habían reiniciado entre el cambio de ZONEMD y la invalidación de DNSSEC no contribuyeron al impacto. Si se hubieran reiniciado durante este plazo de dos semanas, no habrían podido cargar la zona raíz al iniciarse y habrían recurrido para la resolución a enviar las consultas DNS a los servidores raíz. Además, el solucionador utiliza una técnica denominada serve-stale (RFC 8767) con la finalidad de poder continuar entregando registros populares desde una caché potencialmente obsoleta a fin de limitar el impacto. Se considera que un registro está obsoleto cuando ha transcurrido el número de segundos de TTL desde la recuperación del registro de los niveles superiores. Esto evitó una interrupción total; los afectados fueron principalmente nuestros centros de datos más grandes, donde había muchos servidores que no habían reiniciado el servicio 1.1.1.1 en ese periodo.

Medidas de corrección y seguimiento

Este incidente tuvo una amplia repercusión, y nos tomamos la disponibilidad del servicio muy en serio. Hemos identificado varias áreas de mejora y seguiremos trabajando para descubrir cualquier otra vulnerabilidad que pudiera causar una repetición del incidente.

Estamos trabajando de forma inmediata en lo siguiente:

Visibilidad: hemos añadido alertas que notifican cuando static_zone entrega un archivo de zona raíz obsoleto. Esta entrega de un archivo de zona raíz obsoleto que se ha producido no debería haber pasado inadvertida durante tanto tiempo. Con una mejor supervisión y con el almacenamiento en caché existente, esto no habría tenido ninguna repercusión. Nuestro objetivo global es proteger a nuestros clientes y sus usuarios de los cambios en los niveles superiores.

Resiliencia: reevaluaremos cómo absorbemos y distribuimos la zona raíz internamente. Nuestros procesos de ingesta y distribución deberían gestionar nuevos RRTYPE sin problemas, y cualquier breve interrupción del proceso debería ser invisible para los usuarios finales.

Pruebas: a pesar de realizar pruebas en torno a este problema, incluidas pruebas relacionadas con cambios aún no publicados en el análisis de los nuevos registros ZONEMD, no probamos adecuadamente lo que sucede cuando falla el análisis de la zona raíz. Mejoraremos la cobertura de nuestras pruebas y los procesos relacionados.

Arquitectura: no deberíamos utilizar copias obsoletas de la zona raíz pasado cierto punto. Aunque sin duda es posible continuar utilizando datos de la zona raíz obsoleta durante cierto tiempo, pasado cierto punto esto implica riesgos operativos inaceptables. Tomaremos medidas para garantizar una mejor gestión de la duración de los datos de zona raíz en caché, tal como se describe en RFC 8806: Running a Root Server Local to a Resolver.

Conclusión

Lamentamos mucho este incidente. Y la lección está clara: no debemos asumir nunca que algo no va a cambiar. Muchos sistemas modernos se han desarrollado con una larga cadena de bibliotecas que se añaden al ejecutable final, cada una de las cuales puede contener errores o no haberse actualizado con antelación suficiente para que los programas funcionen correctamente cuando se produzcan cambios en los datos de entrada. Comprendemos la importancia de realizar pruebas adecuadas a fin de poder detectar regresiones y los sistemas y componentes que fallan cuando hay cambios en los datos de entrada. Comprendemos que necesitamos suponer siempre que los cambios de “formato” en los sistemas más críticos de Internet (DNS y BGP) van a tener repercusiones.

Debemos realizar un exhaustivo seguimiento interno y vamos a trabajar sin descanso para garantizar que este tipo de incidente no se repita.

2023年10月4日の1.1.1.1ルックアップ障害

Post Syndicated from Ólafur Guðmundsson original http://blog.cloudflare.com/ja-jp/1-1-1-1-lookup-failures-on-october-4th-2023-ja-jp/


2023年10月4日、Cloudflareで07:00~11:00 (協定世界時) にかけてDNS解決に関する障害が発生しました。一部の1.1.1.1の利用者、または1.1.1.1を使用するWarp 、Zero Trust、サードパーティDNSリゾルバなどの製品の一部の利用者が、有効なクエリに対して「SERVFAIL DNS」応答を受信した可能性があります。この度は、ご迷惑をおかけして大変申し訳ございませんでした。この障害は内部的なソフトウェアのエラーであり、攻撃によるものではありません。このブログでは、障害の経緯、発生理由、そして再発防止に対する当社の取り組みについて説明します。

背景

ドメインネームシステム(DNS)の仕組みでは、すべてのドメイン名はDNSゾーン内に存在します。ゾーンには、ドメイン名とホスト名のセットの集合体が管理されています。たとえば、Cloudflareはcloudflare.comというドメイン名を管理しており、これは「cloudflare.com」ゾーンにあると言えます。トップレベルドメイン(TLD)「.com」はサードパーティが所有し、「com」ゾーンにあります。comによってcloudflare.comへのアクセス方法が示されます。すべてのTLDの上位には各TLDへのアクセス方法を示す、ルートゾーンがあります。そのため、ルートゾーンは他のすべてのドメイン名を解決できるようにするために重要な存在です。DNSの他の重要な部分と同様に、ルートゾーンもDNSSECで署名されており、ルートゾーン自体には暗号署名が含まれています。

ルートゾーンはルートサーバーによって公開されていますが、多くのDNS運用者は一般的にルートサーバーに到達できない場合でもルートゾーンの情報を利用できるようにルートゾーンのコピーを自動的に取得して保持するようにしています。 Cloudflareの再帰DNSインフラストラクチャも解決プロセスを高速化するため、このアプローチを採用しています。ルートゾーンの新バージョンは通常1日2回公開されます。1.1.1.1では、 static_zoneと呼ばれるWebAssemblyアプリがメインのDNSロジックの上で動作しており、新バージョンが公開された段階で新バージョンを提供できるようにしています。

障害発生の原因

9月21日、ルートゾーン管理における既知の計画済みの変更の内容に、ルートゾーンに初めて、チェックサムとして機能する新たなリソースレコードタイプ「ZONEMD」が追加されるというものがありました。

ルートゾーンの情報は、Cloudflareのコアネットワークで動作するソフトウェアによって取得されます。その後、世界中のCloudflareのデータセンターに再配布されます。変更後も、ZONEMDレコードを含むルートゾーンは通常通り取得および配布は継続して実行されていました。しかし、そのデータを利用する1.1.1.1のリゾルバシステムに問題があり、ZONEMDレコードを解析することができませんでした。ゾーンは全体をロードして提供する必要があるため、システムがZONEMDを解析できなかったことにより、ルートゾーンの新バージョンをCloudflareのリゾルバシステムで使用することができなくなりました。Cloudflareのリゾルバインフラストラクチャをホストしているサーバーの中には、新しいルートゾーンの情報を受信できなかった場合、リクエストの都度、DNSルートサーバーに直接問い合わせるようにフェイルオーバーするものもあります。しかし、他のサーバーは、メモリキャッシュに保存されたルートゾーンの既知の動作バージョン(変更前の9月21日に引き出されたバージョン)の利用を続けました。

2023年10月4日7時(協定世界時)、9月21日バージョンのルートゾーンのDNSSECの有効期限が切れました。Cloudflareのリゾルバシステムで利用可能な新しいバージョンが無くなり、Cloudflareの一部のリゾルバシステムがDNSSECシグネチャを検証できなくなり、その結果、エラーレスポンス(SERVFAIL)を送信するようになりました。CloudflareリゾルバのSERVFAILレスポンス生成割合が12%増加する事態となりました。以下の図は、障害の進行と、ユーザーへの影響が表面化した経緯を示しています。

インシデントのタイムラインと影響

9月21 日6:30(協定世界時):ルートゾーンからの最後の情報引き出しの成功
10月4日7:00(協定世界時):9月21日に取得したルートゾーンのDNSSEC署名が期限切れとなり、クライアントからの問い合わせに対するSERVFAIL応答が増加。
7:57:予期せぬSERVFAILに対する最初の外部報告が入り始める。
06:32:Cloudflare社内でインシデントが宣言される。
8:50:オーバーライドルールを使用して、1.1.1.1が古いルートゾーンファイルを使用した応答を提供するのを防ぐ最初の試みを実施。
10:30:1.1.1.1のルートゾーンファイルの事前読み込みを完全に停止。10:32:応答が正常に回復。
11:02:インシデントをクローズ。

この下のグラフは、影響とSERVFAILエラーで返されたDNS問い合わせのパーセンテージを時系列で表したものです:

私たちは、平常時のトラフィックにおけるSERVFAILエラーの基準量(通常値)を3%程度と想定しています。この場合のSERVFAILは、DNSSECチェーンにおける正当な問題、権威サーバーへの接続の失敗、権威サーバーの応答のタイムアウト、その他多くの要因によって引き起こされる可能性があります。インシデントの間、SERVFAILの量は総クエリの15%でピークに達しましたが、その影響は世界中に均等に分散されたわけではなく、アッシュバーン(バージニア州)、フランクフルト(ドイツ)、シンガポールのような大規模なデータセンターに主に集中しました。

インシデント発生の理由

ZONEMDレコードの解析に失敗した理由

DNSは、リソースレコードの格納にバイナリ形式を採用しています。このバイナリ形式では、リソースレコードのタイプ(TYPE)は16ビットの整数として格納されます。リソースレコードのタイプが、リソースデータ(RDATA)の解析方法を決定します。レコードタイプ「1」はAレコードであることを意味し、RDATAはIPv4アドレスとして解析されます。レコードタイプ「28」はAAAAレコードを意味し、RDATAはIPv6アドレスとして解析されます。解析が未知のリソースタイプに遭遇した場合、RDATAの解析方法を判断することができないが、RDLENGTHフィールドがRDATAフィールドの長さを示すため、解析はそれを不明なデータ要素として扱うことができます。

                                   1  1  1  1  1  1
      0  1  2  3  4  5  6  7  8  9  0  1  2  3  4  5
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                                               |
    /                                               /
    /                      NAME                     /
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TYPE                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                     CLASS                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TTL                      |
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                   RDLENGTH                    |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--|
    /                     RDATA                     /
    /                                               /
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
RFC 1035

static_zoneが新しいZONEMDレコードをサポートしなかった理由は、これまで私たちがルートゾーンをバイナリ形式ではなく、プレゼンテーション形式で内部配布することを選んできたためです。リソースレコードのテキスト表現をいくつか見てみると、異なるレコードの表示形式には、さらに多くのバリエーションがあることがわかります。

.			86400	IN	SOA	a.root-servers.net. nstld.verisign-grs.com. 2023100400 1800 900 604800 86400
.			86400	IN	RRSIG	SOA 8 0 86400 20231017050000 20231004040000 46780 . J5lVTygIkJHDBt6HHm1QLx7S0EItynbBijgNlcKs/W8FIkPBfCQmw5BsUTZAPVxKj7r2iNLRddwRcM/1sL49jV9Jtctn8OLLc9wtouBmg3LH94M0utW86dKSGEKtzGzWbi5hjVBlkroB8XVQxBphAUqGxNDxdE6AIAvh/eSSb3uSQrarxLnKWvHIHm5PORIOftkIRZ2kcA7Qtou9NqPCSE8fOM5EdXxussKChGthmN5AR5S2EruXIGGRd1vvEYBrRPv55BAWKKRERkaXhgAp7VikYzXesiRLdqVlTQd+fwy2tm/MTw+v3Un48wXPg1lRPlQXmQsuBwqg74Ts5r8w8w==
.			518400	IN	NS	a.root-servers.net.
.			86400	IN	ZONEMD	2023100400 1 241 E375B158DAEE6141E1F784FDB66620CC4412EDE47C8892B975C90C6A102E97443678CCA4115E27195B468E33ABD9F78C
レコードの例(右記URLより抜粋):https://www.internic.net/domain/root.zone

未知のリソースレコードに遭遇した際の処理方法の判断は必ずしも単純なものではありません。このため、私たちがエッジで使用するルートゾーン解析用のライブラリは、解析を行わずに代わりに解析エラーを返します。

ルートゾーンの古いバージョンが使用された理由

static_zoneアプリは、ルートゾーンをローカルに提供(FC 7706)する目的で、ルートゾーンの読み込みと解析を行い、最新バージョンをメモリに保存します。新バージョンが公開されると、static_zoneアプリがそれを解析し、解析に成功すると旧バージョンを削除します。しかし、static_zoneアプリは解析に失敗し、新しいバージョンに切り替えることができないため、古いバージョンを延々と使用し続けることになりました。1.1.1.1サービスが最初に起動されたとき、static_zoneアプリは既存のバージョンをメモリ内に持ち合わせていません。ルートゾーンを解析しようとすると失敗するものの、ルートゾーンの古いバージョンも持ち合わせていないため、ルートサーバーに直接リクエストを問い合わせることになります。

static_zoneを無効にする最初の試みがうまくいかなかった理由

当初、1.1.1.1の動作をプログラム的に変更可能な仕組みであるオーバーライドルールによってstatic_zoneアプリの無効化が試行されました。私たちが展開したルールは以下のとおりです:

phase = pre-cache set-tag rec_disable_static

このルールは、受信したリクエストに「rec_disable_static」タグを付加します。static_zoneアプリの内部でこのタグをチェックし、設定されている場合、キャッシュされた静的ルートゾーンから応答を返しません。ただし、現在のノードが自身のキャッシュから応答を見つけられない場合、キャッシュパフォーマンス向上のために、問い合わせが別のノードに転送されることがあります。残念ながら、他のノードに転送される問い合わせにはrec_disable_staticタグが含まれないため、最終的にアプリを完全に無効にするまで、static_zoneアプリは古い情報を返し続けることとなりました。

影響が部分的だった理由

Cloudflareでは、カーネルアップデートなどのシステムを完全に再起動することで有効になるタスクのため、当社のサービスをホストするサーバーを定期的に順次の再起動を実施しています。今回の障害発生時、ZONEMDの変更とDNSSECの無効化の間に再起動されたリゾルバサーバインスタンスは、影響に寄与していません。もしこの2週間の間に再起動されていた場合、起動時にルートゾーンのロードに失敗し、代わりにルートサーバーにDNSクエリを送信して解決を試みることになったでしょう。加えて、リゾルバはserve-stale(RFC 8767)と呼ばれる技法を用い、影響を抑制する目的で、アクセス数の多いレコードを、最新ではない可能性のあるキャッシュから提供し続けることになります。レコードが上流から取得されてからTTL秒数が経過すると、そのレコードは最新ではないとみなされます。これにより、完全な停止を防ぎました。影響は主に、その時間枠内に1.1.1.1サービスを再起動しなかった多数サーバーを抱える最大規模のデータセンターで発生しました。

改善とフォローアップ手順

今回のインシデントは広範囲に影響を及ぼしており、当社では当社のサービスの可用性について非常に重く受け止めております。当社はいくつかの領域における改善点の特定に至りましたが、今後も再発の原因となるその他のギャップの発見に努めてまいります。

当社が直後から取り組んでいる内容は以下のとおりです。

可視性:static_zoneが古いルートゾーンファイルを提供した場合に通知するアラートを追加しました。古いルートゾーンファイルが提供された場合に長期間気づかれないという事態は防がれるべき事象でした。もし私たちがこの件をもっときちんと監視し、キャッシングが存在していれば、影響はなかったでしょう。上流で行われた変更からお客様とそのユーザーをお守りすることが私たちの目標です。

耐障害性:内部的なルートゾーンの取得と配布方法を見直します。取得および配布のパイプラインは、新しいRRTYPEをシームレスに処理し、パイプラインの短時間の中断はエンドユーザーが気付かない程度に抑える必要があります。

テスト:新しいZONEMDレコードの解析における未公表の変更に関連するテストを含め、この問題に関するテストを実施しているにもかかわらず、ルートゾーンの解析に失敗した場合のテスト内容が不十分でした。そのため、カバレッジと関連するプロセスを改善していきます。

設計:特定の期限を過ぎたルートゾーンの古いコピーを使用すべきではありません。古いルートゾーンデータも限られた時間であれば使用し続けることは確かに可能ですが、ある時点を過ぎると、許容できない運用上のリスクが生じます。RFC 8806「Running a Root Server Local to a Resolver(ルートサーバーをリゾルバに対してローカルで実行する)」に記述されているように、キャッシュされたルートゾーンデータの有効期間をより適切に管理するための対策を講じます。

まとめ

このようなインシデントを起こしてしまったことを深くお詫び申し上げます。このインシデントから学ぶべき教訓は「変更はないだろう」と思い込まないことです。現代のシステムの多くは、最終的な実行ファイルに組み込まれる長いライブラリ群の連鎖で構築されており、そのひとつひとつにバグがあったり、変更があっても更新に遅延が発生してプログラムが正しく動作しないなどと言った事象が発生することがあります。私たちは、変更によるリグレッションを適切に検出する優れたテストや、変更に対して正常に失敗するシステムやコンポーネントを用意することがいかに重要であるかを理解しています。私たちは、インターネットの最も重要なシステム(DNSやBGP)における「形式」の変更が影響を及ぼすことを常に想定する必要があることを理解しています。

社内でフォローアップすべきことはたくさんあり、私たちは現在、このようなことを二度と起こさないよう24時間体制で取り組んでいます。

2023 年 10 月 4 日 1.1.1.1 查詢失敗

Post Syndicated from Ólafur Guðmundsson original http://blog.cloudflare.com/zh-tw/1-1-1-1-lookup-failures-on-october-4th-2023-zh-tw/


2023 年 10 月 4 日,Cloudflare 於世界標準時 7:00 開始至 11:00 結束期間遇到 DNS 解析問題。1.1.1.1 或 Warp 、 Zero Trust 等產品的一些使用者,或使用 1.1.1.1 的第三方 DNS 解析程式可能已經收到對有效查詢的 SERVFAIL DNS 回應。對於此次服務中斷,我們深感抱歉。此次服務中斷為內部軟體錯誤,而非攻擊造成的結果。在這篇部落格中,我們將討論失敗的內容、發生的原因,以及我們可以採取哪些措施來確保這種情況不再發生。

背景

在 Domain Name System (DNS) 中,每一個網域名稱存在於 DNS 區域內。區域是在一起接受控制的網域名稱和主機名稱的集合。例如,Cloudflare 負責網域 cloudflare.com,我們稱之為「cloudflare.com」區域。頂級網域 (TLD) .com 由第三方擁有,位於「com」區域。它提供如何連線 cloudflare.com 的指示。所有 TLD 之上為根區域,提供如何連線 TLD 的指示。這意味著根區域對於解析所有其他網域名稱很重要。與 DNS 的其他重要部分一樣,根區域使用 DNSSEC 進行簽署,這也意味著根區域本身包含加密簽章。

根區域發布於根伺服器上,但 DNS 營運商自動擷取並保留根區域副本的情況也很常見, 以便在無法連線根伺服器的情況下,根區域中的資訊仍然可供使用。Cloudflare 的遞迴 DNS 基礎架構會採用此方法,因為它還可加速解析程序。新版根區域通常一天發布兩次。1.1.1.1 具有稱為 static_zone 的 WebAssembly 應用程式,該應用程式執行於主 DNS 邏輯之上,當新版本可供使用時,即可提供這些新的版本。

狀況說明

9 月 21 日,作為根區域管理中的已知計畫內變更的一部分,新的資源記錄類型首次納入根區域。新資源記錄稱為 ZONEMD,實際上是根區域內容的總和檢查碼。

藉由執行於 Cloudflare 核心網路的軟體來擷取根區域。隨後,根區域被重新分散到 Cloudflare 在世界各地的資料中心。變更之後,可繼續正常擷取和分散包含 ZONEMD 記錄的根區域。然而,使用該資料的 1.1.1.1 解析程式系統在剖析 ZONEMD 記錄時遇到問題。由於區域必須完整載入和提供,因此系統無法剖析 ZONEMD,這意味著新版根區域未在 Cloudflare 的解析程式系統中使用。若託管 Cloudflare 解析程式基礎架構的某些伺服器未收到新的根區域,則會發生容錯移轉,直接逐個請求地查詢 DNS 根伺服器。不過,其他伺服器會繼續依賴其記憶體快取仍然可用的已知工作版根區域,這是在變更之前於 9 月 21 日提取的版本。

2023 年 10 月 4 日世界標準時 7:00,根區域版本中自 9 月 21 日開始的 DNSSEC 簽章到期。由於 Cloudflare 解析程式系統沒有能夠使用的更新版本,某些 Cloudflare 解析程式系統無法驗證 DNSSEC 簽章,並因此開始傳送錯誤回應 (SERVFAIL)。Cloudflare 解析程式產生 SERVFAIL 回應的速度提升了 12%。下圖說明了失敗的進度,以及如何顯示給使用者。

事件時間表和影響

9 月 21 日世界標準時 6:30:根區最後一次成功提取
10 月 4 日世界標準時 7:00:根區域中於 9 月 21 日取得的 DNSSEC 簽章到期,導致對用戶端查詢的 SERVFAIL 回應增加。
7:57︰第一個外部非預期 SERVFAIL 報告開始出現。
8:03︰正式宣佈發生內部 Cloudflare 事件。
8:50:初次嘗試阻止 1.1.1.1 使用具有覆寫規則的過時根區域檔案來提供回應。
10:30:完全阻止 1.1.1.1 預先載入根區域檔案。
10:32:回應恢復正常。
11:02︰事件結束。

下圖顯示了影響時間表,以及傳回 SERVFAIL 錯誤的 DNS 查詢百分比:

我們預計,在正常操作期間,常規流量的 SERVFAIL 錯誤數量會達到基準。該比例通常在 3% 左右。這些 SERVFAIL 可能是由於 DNSSEC 鏈中的合法問題、無法連線至權威伺服器、權威伺服器回應時間太長,以及其他因素引起。在事件發生期間,SERVFAIL 數量達到峰值,佔查詢總計的 15%,但影響在全球範圍內的分佈並不均勻,且主要集中在較大型的資料中心,例如維吉尼亞州阿什本、德國法蘭克福和新加坡。

為什麼會發生這一事件

剖析 ZONEMD 記錄失敗的原因

DNS 採用二進位格式來儲存資源記錄。在此二進位格式中,資源記錄 (TYPE) 的類型儲存為 16 位元整數。資源記錄的類型確定剖析資源資料 (RDATA) 的方式。當記錄類型為 1 時,這意味著它是 A 記錄,RDATA 可以解析為 IPv4 位址。記錄類型 28 為 AAAA 記錄,而其 RDATA 則剖析為 IPv6 位址。當剖析器遇到未知的資源類型時,它不知道如何剖析其 RDATA,但幸運的是它不必這樣做:RDLENGTH 欄位表示 RDATA 欄位的長度,允許剖析器將其視為 OPAQUE 資料元素。

                                   1  1  1  1  1  1
      0  1  2  3  4  5  6  7  8  9  0  1  2  3  4  5
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                                               |
    /                                               /
    /                      NAME                     /
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TYPE                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                     CLASS                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TTL                      |
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                   RDLENGTH                    |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--|
    /                     RDATA                     /
    /                                               /
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
RFC 1035

之所以 static_zone 不支援新的 ZONEMD 記錄,是因為到目前為止,我們選擇以其呈現格式(而非二進位格式)在內部分散根區域。查看一些資源記錄的文字呈現時,我們可以看到不同記錄的呈現方式有很多變化版本。

.			86400	IN	SOA	a.root-servers.net. nstld.verisign-grs.com. 2023100400 1800 900 604800 86400
.			86400	IN	RRSIG	SOA 8 0 86400 20231017050000 20231004040000 46780 . J5lVTygIkJHDBt6HHm1QLx7S0EItynbBijgNlcKs/W8FIkPBfCQmw5BsUTZAPVxKj7r2iNLRddwRcM/1sL49jV9Jtctn8OLLc9wtouBmg3LH94M0utW86dKSGEKtzGzWbi5hjVBlkroB8XVQxBphAUqGxNDxdE6AIAvh/eSSb3uSQrarxLnKWvHIHm5PORIOftkIRZ2kcA7Qtou9NqPCSE8fOM5EdXxussKChGthmN5AR5S2EruXIGGRd1vvEYBrRPv55BAWKKRERkaXhgAp7VikYzXesiRLdqVlTQd+fwy2tm/MTw+v3Un48wXPg1lRPlQXmQsuBwqg74Ts5r8w8w==
.			518400	IN	NS	a.root-servers.net.
.			86400	IN	ZONEMD	2023100400 1 241 E375B158DAEE6141E1F784FDB66620CC4412EDE47C8892B975C90C6A102E97443678CCA4115E27195B468E33ABD9F78C
範例記錄源自 https://www.internic.net/domain/root.zone

當我們遇到未知的資源記錄時,並不總是能輕鬆知道如何處理。因此,我們用於剖析邊緣根區域的程式庫不會嘗試這樣做,而是傳回剖析器錯誤。

為什麼使用過時版根區域

static_zone 應用程式的任務是載入和剖析根區域,以便在本機提供根區域 (RFC 7706),並將最新版本儲存在記憶體中。當新版本發布時,它會對其進行剖析,並在成功完成後捨棄舊版本。然而,由於剖析失敗,static_zone 應用程式絕不會轉換至更新版本,而是無限期地繼續使用舊版本。當 1.1.1.1 服務首次啟動時,static_zone 應用程式的記憶體中沒有現有版本。當它嘗試剖析根區域時,剖析會失敗,但由於沒有可回復的舊版根區域,它會直接回復到查詢根伺服器的傳入請求。

為什麼停用 static_zone 的初始嘗試不起作用

最初,我們嘗試透過覆寫規則來停用 static_zone 應用程式,這是一種允許我們以程式設計方式變更 1.1.1.1 某些行為的機制。我們的部署規則是:

phase = pre-cache set-tag rec_disable_static

針對任何傳入的請求,此規則都會將標籤 rec_disable_static 新增至請求。在 static_zone 應用程式內,我們會檢查此標籤,如果已設定,我們不會透過快取的靜態根區域傳回回應。但是,為了改善快取效能,如果目前節點在自己的快取中找不到回應,有時會將查詢轉傳至另一個節點。遺憾的是,轉傳至其他節點的查詢中不包括 rec_disable_static 標籤,這會導致 static_zone 應用程式繼續使用過時的資訊進行回覆,直至我們最終完全停用該應用程式。

為什麼影響是局部的

Cloudflare 會定期對託管我們服務的伺服器執行滾動重啟,以執行核心更新等任務,這些任務只能在系統完全重新啟動後才會生效。在此服務中斷期間,在發生 ZONEMD 變更與 DNSSEC 無效期間重新啟動的解析程式伺服器執行個體不會造成影響。如果它們在這兩週期間重新啟動,則無法在啟動時載入根區域,而是藉由向根伺服器傳送 DNS 查詢來回復到解析。此外,解析程式使用一種稱為「提供過時」(RFC 8767) 的技術,目的是能夠繼續從可能過時的快取中提供常用的記錄,以限制影響。自透過上游擷取記錄以來,一旦達到 TTL 秒數,該記錄就會被視為過時。這避免了完全的服務中斷;影響主要發生在我們最大型的資料中心,其中有許多伺服器在該時間範圍內沒有重新啟動 1.1.1.1 服務。

補救措施和後續步驟

該事件產生了廣泛的影響,我們極其重視服務的可用性。我們已經確定了幾個需要改進的領域,並將繼續努力發現可能導致事件再次發生的任何其他漏洞。

下面是我們立即採取的措施:

可見度:我們新增了警示,以便在 static_zone 提供過時的根區域檔案時發出通知。只要提供過時的根區域檔案,都不應被忽視。如果我們利用現有的快取更好地監控此問題,就不會有影響。我們的目標是保護我們的客戶及其使用者免受上游變更的影響。

復原能力:我們將重新評估在內部擷取和分散根區域的方式。我們的擷取和分散管道應無縫處理新的 RRTYPE,並且管道的任何短暫服務中斷都應不為最終使用者所見。

測試:儘管圍繞此問題設置了測試,包括與剖析新 ZONEMD 記錄時未發布變更相關的測試,但我們沒有對根區域剖析失敗時發生的情況進行充分測試。我們將改善測試覆蓋範圍和相關程序。

架構:我們不應使用超過某種程度的根區域過時副本。雖然在有限的時間內,繼續使用過時的根區域資料當然是可能的,但超過某種程度,就會出現不可接受的操作風險。我們將採取各種措施,確保快取的根區域資料生命週期得到更好的管理,如 RFC 8806:對解析程式本機執行根伺服器中所述。

結論

對於這次發生的事件,我們深感抱歉。這一事件傳遞了一個明確的訊息:永遠不要認為事情不會改變!許多現代系統都是使用一長串程式庫構建,這些程式庫被提取至最終的可執行檔中,其中的每個程式庫都可能存在錯誤,或者可能沒有足夠早地更新,使得程式在輸入發生變更時無法正確運作。我們瞭解,設置良好的測試非常重要,以便在輸入變更時進行迴歸偵測,以及偵測正常失敗的系統和元件。我們還瞭解,我們需要始終認為網際網路中最關鍵的系統(DNS 和 BGP)發生「格式」變更將會產生影響。

在內部,我們還有很多事情要跟進,我們正在夜以繼日的處理,以確保此類事件不會再次發生。

2023 年 10 月 4 日 1.1.1.1 查询失败

Post Syndicated from Ólafur Guðmundsson original http://blog.cloudflare.com/zh-cn/1-1-1-1-lookup-failures-on-october-4th-2023-zh-cn/


在 2023 年 10 月 4 日,从 7:00 UTC 到 11:00 UTC 的这段时间里,Cloudflare 出现了 DNS 解析问题。1.1.1.1 或 Warp、Zero Trust 等产品或使用 1.1.1.1 的第三方 DNS 解析器的一些用户可能会收到对有效查询的 SERVFAIL DNS 响应。对于本次故障,我们深表歉意。本次故障是内部软件错误造成的,不是遭到攻击所致。在这篇博文中,我们将讨论出现了什么故障、发生原因以及我们采取了哪些措施来确保这种情况不再发生。

背景

在域名系统 (DNS) 中,每个域名都位于一个 DNS 区域中。区域是一起控制的域名和主机名的集合。例如,Cloudflare 负责域名 cloudflare.com,我们称其为在 “cloudflare.com” 区域中。.com 顶级域名 (TLD) 归第三方所有,位于 “com” 区域中。它提供如何访问 cloudflare.com 的指示。对于 TLD,最重要的是根区,它提供如何访问 TLD 的指示。这意味着根区对于解析所有其他域名非常重要。与 DNS 的其他重要部分一样,根区也使用 DNSSEC 进行签名,这意味着根区本身包含加密签名。

根区在根服务器上发布,但 DNS 运营商通常也会自动检索并保留根区的副本,使得万一根服务器无法访问时,根区中的信息仍然可用。Cloudflare 的递归 DNS 基础设施也采用了这种方法,因为它还可以加快解析过程。根区的新版本通常每天发布两次。1.1.1.1 有一个名为 static_zone 的 WebAssembly 应用程序,它在主 DNS 逻辑的基础上运行,在新版本可用时为它们提供服务。

究竟发生了什么

在 9 月 21 日,作为根区管理已知和计划变更的一部分,根区中首次加入了一种新的资源记录类型。新资源记录名为 ZONEMD,实际上是根区内容的校验和。

根区通过在 Cloudflare 核心网络中运行的软件检索。随后,它被重新分配到 Cloudflare 遍布全球的数据中心。更改后,包含 ZONEMD 记录的根区仍可正常检索和分配。但是,使用该数据的 1.1.1.1 解析器系统在解析 ZONEMD 记录时遇到了问题。由于区域必须完整加载并提供,如果系统无法解析 ZONEMD,则意味着 Cloudflare 解析器系统未使用新版本的根区。一些托管 Cloudflare 解析器基础架构的服务器在未收到新的根区时,无法逐个请求直接查询 DNS 根服务器。然而,继续依赖于根区的已知正常工作版本的其他用户在内存缓存中仍可使用该版本,即在变更前于 9 月 21 日提取的版本。

在 2023 年 10 月 4 日 07:00 UTC,9 月 21 日发布的根区版本中的 DNSSEC 签名已过期。由于 Cloudflare 解析器系统无法使用本来应该可以使用的较新版本,Cloudflare 的一些解析器系统无法验证 DNSSEC 签名,因此开始发送错误响应 (SERVFAIL)。Cloudflare 解析器生成 SERVFAIL 响应的比率增长了 12%。下图说明了故障的发展过程以及用户如何看到故障。

事件时间线和影响

9 月 21 日 6:30 UTC:最后一次成功提取根区
10 月 4 日 7:00 UTC:在 9 月 21 日获得的根区中的 DNSSEC 签名过期,导致对客户端查询的 SERVFAIL 响应增加。
7:57:开始收到第一份关于意外 SERVFAIL 的外部报告。
8:03:宣布内部 Cloudflare 事件。
8:50:首次尝试通过覆盖规则阻止 1.1.1.1 使用过期的根区文件提供响应。10:30:完全阻止 1.1.1.1 预装根区文件。
10:32:响应恢复正常。
11:02:事件关闭。

下图显示了受影响的时间以及返回 SERVFAIL 错误的 DNS 查询的百分比:

在正常运行期间,我们预计常规流量会出现 SERVFAIL 错误。通常这一比例在 3% 左右。造成这些 SERVFAIL 可能原因有 DNSSEC 链中的正当合理的问题、无法连接到权威性服务器、权威性服务器响应时间过长等等。在本次事件中,SERVFAIL 数量峰值达到总查询量的 15%,但其影响并不是全球均匀分布,主要集中在我们较大的数据中心,如弗吉尼亚州阿什本、德国法兰克福和新加坡。

发生本次事件的原因

解析 ZONEMD 记录失败的原因

DNS 采用二进制格式存储资源记录。在这种二进制格式中,资源记录的类型 (TYPE) 存储为16 位整数。资源记录的类型决定了资源数据 (RDATA) 的解析方式。当记录类型为 1 时,表示这是一条 A 记录,其 RDATA 可被解析为 IPv4 地址。记录类型 28 是 AAAA 记录,其 RDATA 可被解析为 IPv6 地址。当解析器遇到未知资源类型时,它不知道如何解析其 RDATA,但幸运的是,解析不是必需的:RDLENGTH 字段指出了 RDATA 字段的长度,从而允许解析器将其视为不透明数据元素。

                                   1  1  1  1  1  1
      0  1  2  3  4  5  6  7  8  9  0  1  2  3  4  5
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                                               |
    /                                               /
    /                      NAME                     /
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TYPE                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                     CLASS                     |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                      TTL                      |
    |                                               |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
    |                   RDLENGTH                    |
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--|
    /                     RDATA                     /
    /                                               /
    +--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+--+
RFC 1035

static_zone 之所以不支持新的 ZONEMD 记录,是因为到目前为止,我们一直选择在内部以根区的展示格式分发根区,而不是二进制格式。在查看一些资源记录的文本表述时,我们可以发现不同记录的表述方式存在更多差异。

.			86400	IN	SOA	a.root-servers.net. nstld.verisign-grs.com. 2023100400 1800 900 604800 86400
.			86400	IN	RRSIG	SOA 8 0 86400 20231017050000 20231004040000 46780 . J5lVTygIkJHDBt6HHm1QLx7S0EItynbBijgNlcKs/W8FIkPBfCQmw5BsUTZAPVxKj7r2iNLRddwRcM/1sL49jV9Jtctn8OLLc9wtouBmg3LH94M0utW86dKSGEKtzGzWbi5hjVBlkroB8XVQxBphAUqGxNDxdE6AIAvh/eSSb3uSQrarxLnKWvHIHm5PORIOftkIRZ2kcA7Qtou9NqPCSE8fOM5EdXxussKChGthmN5AR5S2EruXIGGRd1vvEYBrRPv55BAWKKRERkaXhgAp7VikYzXesiRLdqVlTQd+fwy2tm/MTw+v3Un48wXPg1lRPlQXmQsuBwqg74Ts5r8w8w==
.			518400	IN	NS	a.root-servers.net.
.			86400	IN	ZONEMD	2023100400 1 241 E375B158DAEE6141E1F784FDB66620CC4412EDE47C8892B975C90C6A102E97443678CCA4115E27195B468E33ABD9F78C
取自 https://www.internic.net/domain/root.zone 的记录示例

当我们遇到未知的资源记录时,往往不知道如何处理它。因此,我们用来解析边缘根区的库不会尝试解析,而是返回解析器错误。

为什么会使用过期版本的根区

static_zone 应用程序负责加载和解析根区,以便在本地提供根区服务 (RFC 7706),它将最新版本存储在内存中。当有新版本发布时,它会解析新版本,并在解析成功后丢弃旧版本。然而,由于解析失败,static_zone 应用程序未能切换到较新的版本,而是无限期地继续使用旧版本。当 1.1.1.1 服务首次启动时,static_zone 应用程序的内存中没有现有版本。当它尝试解析根区时会失败,但是由于没有旧版本的根区作为后备,它只能针对传入请求直接查询根服务器。

为什么最初尝试禁用 static_zone 时没有成功

起初,我们尝试通过覆盖规则禁用 static_zone 应用程序(覆盖规则是一种允许我们以编程方式更改 1.1.1.1 的某些行为的机制)。我们制定的规则如下:

phase = pre-cache set-tag rec_disable_static

对于任何接收到的请求,此规则都会在请求中添加 rec_disable_static 标记。在 static_zone 应用程序中,我们会检查该标记,如果设置了该标记,我们就不会从缓存的静态根区返回响应。但是,为了提高缓存性能,如果当前节点无法在自己的缓存中找到响应,查询有时会被转发到另一个节点。不幸的是,rec_disable_static 标记并没有包含在转发到其他节点的查询中,这导致 static_zone 应用程序继续以陈旧的信息回复,直到我们最终完全禁用该应用程序。

为什么影响是局部的

Cloudflare 会定期对托管我们服务的服务器进行滚动重新启动,以执行内核更新等任务,这些更新只有在系统完全重新启动后才能生效。在本次故障发生时,在 ZONEMD 更改和 DNSSEC 失效之间重新启动的解析器服务器实例不会造成影响。如果它们在这两周内重新启动,它们将无法在启动时加载根区,而只能通过向根服务器发送 DNS 查询来进行解析。此外,解析器还使用了一种称为“过期服务”(serve stale) (RFC 8767) 的技术,目的是能够继续从可能过期的缓存中提供当前的记录,以限制影响。一旦从上游检索记录的 TTL 秒数已过,该记录就会被视为过期记录。这避免了全面中断;受影响的主要是我们最大的数据中心,这些数据中心有许多服务器在该时间段内没有重新启动 1.1.1.1 服务。

补救及后续步骤

这一事件产生了广泛的影响,而我们非常重视我们服务的可用性。我们已经确定了几个改进的领域,并将继续努力发现任何其他可能导致复发的缺陷。

如下是我们目前进行中的工作:

可见性:我们会添加警报功能,以便在 static_zone 提供过期的根区文件时发出通知。这种长时间提供过期的根区文件而毫无所觉的情况不应该发生。如果我们能更好地进行监控,再加上现有的缓存,就不会产生任何影响。我们的目标是保护客户及其用户免受上游变更的影响。

恢复能力:我们将重新评估如何在内部摄取和分发根区。我们的摄取和分发管道应无缝处理新的 RRTYPE,最终用户应看不到管道的任何短暂中断。

测试:尽管围绕这个问题进行了测试,包括与解析新 ZONEMD 记录的未发布变更相关的测试,但我们并未充分测试当根区解析失败时会发生什么情况。我们将改进测试范围和相关流程。

架构:某个时间点过后,我们不应使用过期的根区副本。在有限的时间内继续使用过期的根区数据当然是可能的,但超过一定时间就会产生不可接受的运行风险。我们将采取措施,确保按照 RFC 8806:在解析器本地运行根服务器中所述,更好地管理缓存的根区数据的生命周期 。

总结

我们对本次事件的发生深表遗憾。本次事件给了我们一个明确的启示:永远不要认为有些东西会一成不变!许多现代系统都有一长串的库,这些库被提取到最终的可执行文件中,每一个库都可能存在错误,或者未能及早更新以在输入发生变化时可以正确运行。我们明白,进行良好的测试是多么重要,它可以检测出在输入发生变化时从容失败回归、系统和组件。我们知道,我们需要始终认为互联网最关键系统(DNS 和 BGP)中的“格式”变化会产生影响。

我们内部有很多事情需要跟进,正在夜以继日地工作,以确保类似事件不再发生。

The collective thoughts of the interwebz