Post Syndicated from Crosstalk Solutions original https://www.youtube.com/shorts/vwVuySdmQRg
Rain or Shine, Your Dashboard Just Got Smarter! ☀️🌧️
Post Syndicated from BeardedTinker original https://www.youtube.com/watch?v=yS7BOrzXABQ
Trump Invades Blue America, with Rosa Brooks | The David Frum Show
Post Syndicated from The Atlantic original https://www.youtube.com/watch?v=ohMdK3VOWQ4
OpenSUSE disables bcachefs
Post Syndicated from corbet original https://lwn.net/Articles/1037496/
The openSUSE project has announced
that the bcachefs filesystem will be disabled in its kernel builds starting
with 6.17; bcachefs users will have to make other arrangements. “The
“
current 6.16.* is NOT affected. Neither is Slowroll (for now).
[$] KDE launches its own distribution (again)
Post Syndicated from jzb original https://lwn.net/Articles/1037166/
At Akademy 2025, the
KDE Project released an
alpha version of KDE Linux, a
distribution built by the project to “include the best
“. It is aimed at providing an operating system
implementation of everything KDE has to offer, using the most advanced
technologies
suitable for home use, business use, OEM installations, and more
“eventually
“. For now there are many rough edges and missing
features that users should be aware of before taking the plunge; but
it is an interesting look at the kind of complete Linux system that
KDE developers would like to see.
Three decades in kernelland
Post Syndicated from jzb original https://lwn.net/Articles/1037477/
At Open
Source Summit Europe, LWN’s Jonathan Corbet presented “Three Decades in
Kernelland“; the talk provides a look at how the kernel got to
where it is, what makes it successful, and what may be coming
next. The video of the
talk is now online for LWN readers who would like to check it
out.
За математиката, хората и радостта
Post Syndicated from original https://www.toest.bg/za-matematikata-horata-i-radostta/

Поредна събота през учебната година. Най-голямата аудитория на Физическия факултет на Софийския университет е препълнена. Поне още толкова хора гледат онлайн. Темата е математика, или по-точно т.нар. висша математика – кралицата на науките, сложната и страшната. Лекциите продължават над пет астрономически часа, провеждат се в рамките на „Школа по физика София“, а слушателите са от ученици до пенсионери. Събрал ги е гл. ас. Лъчезар Симеонов.
Лъчо, както го наричат дори портиерите във факултета, е завършил бакалавърската и магистърската си степен във Физическия факултет на Софийския университет „Св. Климент Охридски“, където е направил и докторантурата си по квантова оптика. Две години от докторантурата си прекарва в Германия на разменни начала в експерименталната група на професор Томас Халфман, в която Лъчо е бил теоретикът.
Интересите му са в областта на теоретичната физика, най-вече в сферата на фундаменталната физика. Казва, че се вълнува повече как работи светът, а не толкова какво са магнитни свойства или различни материали: какво е време, какво е пространство, какво казва квантовата физика за всичко заобикалящо ни, какво е съзнанието – фундаменталните въпроси, които са на границата на философията и религията.
Лъчезар се определя като „колекционер на добри обяснения“. От повечето книги, които е изчел, е взел по нещо, за да събере колекциите си. „Някои хора колекционират картички, аз колекционирам добри обяснения на неща, които са ми били сложни и са ме затормозявали.“
Може да се каже, че школата му е сбор от неговите колекции, събирани внимателно през годините. „Повече от 90% от моята работа е била да подбера най-доброто от стотици книги и да мога да го дам на хората смилаемо.“
С гл. ас. Лъчезар Симеонов разговарят Донка Дойчева-Попова и Пейо Попов.
Вие сте човек, който събира обяснения, както казвате. Но даването е много интересно – преподавателят дава. Защо давате?
Няколко са причините, поради които искам да давам. Първата е изумителната красота. Не мога да се стърпя и да не я покажа на всички. Това е като да гледаш някакъв невероятен филм и просто искаш да го споделиш с всичките си приятели. При мен е горе-долу същото – виждам потресаваща, изумителна красота във физиката и математиката и искам да покажа на всички за какво става въпрос.
Естествено, не всеки се изумява от това, което виждам аз. Но понякога забелязвам пламъчето в очите на някои хора – бум! – и избухва. Моята реакция е: „А, и ти си като мен, и ти го видя, нали?“ Това е единият ми мотив.
Другия бих могъл да изразя с думите „любов към хората“. Аз обичам хората и това, което се получава, когато им давам, е, че на тях им харесва, те са доволни и щастливи, ще го ползват после в живота си. Може би ще си изкарват прехраната с това знание. Доволен съм, че така знанието расте и това разширява светогледа им. Защото голяма част от тях живеят като скотове – какво ще ядем, какво ще пием, кога да полегнем.
Често ме питат: „Къде ще ползвам тази математика или физика?“ И аз винаги искам да задам въпроса: „Човече, защо ти е да я ползваш?“
Естествено, че най-вероятно ще я ползваш. Можеш много пари да изкараш с нея, но на първо място трябва да ти е интересно, да излезеш от нивото „да ядем и да пием“. Изпълзи от дъното на кладенеца, за да видиш светлината. Това според мен е толкова полезно за човека, колкото и да му дадеш храна и вода, тоест ти трябва да го нахраниш не само физически.
Според мен човек трябва да възприема професията си като форма на любов. Това е форма на раздаване, а аз обичам да се раздавам. Обичам хората – те са странни, ядосват те, но въпреки това ги обичам.
Имам големи идеи, искам да ги публикувам един ден и работя по тях, но дори да открия най-великите неща на тоя свят в науката, по-важни са хората. Хората са по-важни от нещата, от откритията, от успехите. Така че може да се окаже, че школата ще бъде може би едно от най-големите ми постижения – по-голямо от великите открития, които някой човек би могъл да направи и които после ще бъдат забравени. Хората са ценни.
Как започна школата?
Винаги съм искал да се занимавам с математика и физика и знаех, че един ден ще го направя. Като ученик бях самоук, сам се учех на математика. Ученето сам е трудно. По стечение на обстоятелствата и под влиянието на родителите ми, които не смятаха, че има хляб в моята идея, бях попаднал в икономическа гимназия. Там учителите бяха чудесни, но математиката не беше централното, занимаваха се с други неща.
Един ден попаднах на изумителен преподавател – Пламен Румпалов. Той направи нещо, което не бях виждал до този момент. Можеше в рамките на няколко месеца да систематизира цялата математика, която съм учил във всички години на училищното образование, при това с повече подробности и детайли. Бях потресен от това и си казах: „Добре, значи е възможно по някакъв начин така да селектираш материала, че да го обясниш разбираемо, смилаемо и за кратко време.“ Тоест материалът е толкова малко, че може да се разбере за пет-шест месеца, по шест часа всяка събота. Тогава се запитах: „Възможно ли е това да стане с физиката и с математиката?“ И може да се каже, че идеята за школата е била винаги в мен от момента, в който видях този човек.
Всичко, което съм учил, е било с идеята един ден да го преподавам на другите.
Дори съм подготвил в ума си цели томове книги, които ще излязат в бъдеще – те ще са разбираеми, прости и хубави и хората ще ги четат с наслада. Имам проект за всичко това още от детските си години.
Какво конкретно дава школата?
Обучението в школата трае две години – първата се учи математика и човек може да спре дотам, ако това е всичко, от което има нужда. Математиката е разделена на седем модула и е подходяща за хора с всестранни интереси, не е необходимо да са физици. В тези модули учим изкуствен интелект, вероятности, диференциално смятане, интегрално смятане.
Повечето участници в школата искат да се занимават с физика, но тя е перфектна и за програмисти, за икономисти, за хора, които се занимават със статистика и обработка на данни. Тоест тя е за всеки, който може да приложи тази математика в живота си. Но ако трябва да съм честен, практическата функция на школата е само една от страните ѝ.
Взел съм например едни от най-силните лекции на „Станфорд“ и на MIT по темата за изкуствения интелект и съм ги подобрил според мен. Окастрил съм ненужните неща и съм сложил тези, които са важни. Така човек може да се докосне дори до изкуствения интелект в школата, при това на разбираем, прост и лесен език.
Има голям глад за специалисти, които не просто са програмисти, а трябва да могат да използват езика на математиката в своите програми. Давам ви пример с мой приятел, чиято работа в една инженерна фирма беше да смята как би паднала дадена сграда при удар със самолет. Естествено, смята това със специализиран софтуер, но започна да се пита как действа този код. След една година учене успя да разбере не само как работи кодът, но записа и докторантура. Сега вече може да работи над развоя на тази програма, да я разширява още повече. Това е практическата част, тоест човек, ако знае как, може да изкара много пари, ако иска.
Друг мой приятел ми сподели, че слушал една от моите лекции и си измислил своя сигмоидна функция, като даже написа научна статия по този въпрос. Времето, в което живеем, изисква всеки човек да е технически по-грамотен, а зад всичко това стои математика.
Но както казах, в този курс се опитвам да направя друго – да запаля огъня в хората, да им обясня по друг начин математиката. Има един мит за Аристотел. Когато преподавал философия, започвал от може би най-трудния раздел – естетиката. Попитали го защо точно от естетиката. А той отговорил, че ако успее да накара учениците си да се възхищават сами, значи ги е научил на най-важното. И аз съм съгласен с това.
Истината е, че в математиката, в анализа, в диференциалното смятане се крият изумителни неща. Оказва се например, че откритието на Исак Нютон и Лайбниц за диференциалното смятане е езикът на природата. Тя е написана на него. И никой не знае защо. Там са отговорите на въпроси като „Какво е безкрайност?“ или „Какво е безкрайно малко?“ и т.н. Човек може да ги схване дори без да знае математика. А това е още първата ми лекция в школата. Имам и шестчасова лекция по философия, в която отделям време на теми като съзнание, знание, съществуване, безкрайност. Не е необходимо човек да е математик, за да ги разбере. Иска ми се да запаля интереса на хората по тези универсални въпроси. За мен това е по-същественото и пътьом, разбира се – техника и задачи.

Колко курсисти сте имал през последните години?
В последните две години имаме пробив – дойдоха по сто души. Интересното е, че те не просто идват, но и остават. Бях изненадан, очаквах около 15–20 души. Отпаднаха изключително малко хора, запазихме почти всички. Може би помага това, че предлагаме и онлайн участие в лекциите. Почти не сме използвали реклама, а дойдоха толкова много хора. Тази година сме решили да разширим рекламата си, за да достигнем до още повече.
Причината да идват толкова много хора според мен се корени в големите пропуски в образованието им, които те самите искат да запълнят. Самата образователна система е направена по такъв начин, че да бъде абсолютно неразбираема за повечето хора, обезсърчаваща, немотивираща. Не съм този, който може да обясни защо това е така, но каквато и да е причината, резултатът е, че хората имат страшно много дупки в знанията си и са страшно обезсърчени. И това не е мързел, както си мислят мнозина – просто е обезсърчение.
Хората не искат да се занимават с това, защото си казват: „Каква е тази суха материя, тебеширена наука?“, „Къде ще ми трябва?“, „Колко е скучно“. Истината е, че нашата образователна система както в средното, така и във висшето образование, за съжаление, е обезсърчаваща.
Тя е скучна, непрактична, цели наизустяване, а не разбиране. Не иска да си задаваш въпроси, а ти тъпче отговорите в устата наготово. Не е цветна, не е красива и реално образованието, което получаваме, е една изкривена версия на истината.
А тя е много по-красива, много по-изумителна и горките хора нямат достъп до нея. Може би школата възникна и като едно свято негодувание против това. Нас ни има, за да кажем: „Ето, има и друг подход.“
На каква възраст са участниците в школата и необходими ли са специални знания, за да се запишеш?
Мнозинството са ученици след IХ клас и студенти, но имаме и хора на 40, на 50, дори имаме един човек на 60, който учи във факултета при нас астрофизика. Но средностатистическият посетител е на около 19 години.
Единственото нужно е човек да има ентусиазъм, жажда за знание и някаква базисна училищна математика. Трябва да може да преобразува изрази, но също ще е чудесно, ако не се шокира при вида на синус и логаритъм, въпреки че се опитваме и тях да обясним.
Имате ли истории, с които се гордеете?
Ще разкажа за моя помощник Явор. В него видях как един млад човек, който започна от нищото, вече знае толкова много, че е на ниво професионален физик. Прекрасно е да го гледам как расте – от малко стръкче до голямо красиво цвете. Предполагам, че това е чувството, което един родител изпитва към своите деца. Моите деца са все още малки и не съм преживял целия процес, дано и това ми се случи. Родителят влага в тях и изведнъж те му връщат – започват да говорят като него, да мислят като него.
Учителската работа е малко или много да копираш себе си в някой друг. Това действително прилича на родителството. И като видя как младите хора попиват тия познания и се ориентират, и критично гледат на света, и вече четат научни статии, при това с разбиращ поглед, знаят къде има грешка, и ме изпълва една радост и гордост от порастването им, от това, че ще станат прекрасни хора!
Вие правите математиката достъпна и разбираема с много видеа в Instagram, в TikTok. В тях математиката не е непревземаема интелектуална крепост. Какво Ви коства това усилие и защо го правите?
Има различни нива на разбиране или различни нива на схващане. Представете си, че не сте вкусвали никога мед. Разказват ви за текстурата му, за всичките му вкусови качества и предимства, знаете вече всичко, но не сте го опитвали никога. Цялата информация, с която разполагате, ви стига дори да станете най-добрият експерт по мед. Но нищо не може да се сравни с опитването.
Тоест има разлика между това да знаеш нещо и да го срещнеш, видиш, усетиш. В математиката и физиката и почти във всяка област на познанието е така. Тази разлика е много трудна за обяснение, но е форма на интуиция, а ние в школата се стремим да достигнем това по-дълбоко ниво.
Математиката се гради – слагаме новото върху добре укрепналото старо. Какво казвате на хората, които там някъде, например в гимназията, са изпуснали нещо и градежът им се клати? Или на хората, които се срамуват от пропуските си или чувстват вина?
Вината никога не помага, тя по-скоро взема от силите на човека. Ако някой има наистина автентичен интерес, ще намери начин да разбере истината. Вместо вина прилагам друг мотивация – „виж колко красиво може да бъде“. Това е като физическата ни форма – „трябва да отида на фитнес, да сваля тези паласки, да направя нещо, иначе лошо ми се пише“. Обаче ако го обърнем – „знам, че мога да изглеждам по-добре, да се чувствам по-добре“, това е много по-мотивиращо. Твърдя, че вторият мотив е по-чист, по-силен.
Ще прозвучи малко странно, но във вината има голяма доза егоизъм. Вината и страхът са форма на егоизъм: „аз не ставам“ – фокусът е върху себе си, навътре. За да може човек да постигне каквото и да било, трябва да се фокусира навън, към нещо по-голямо от него самия.
Това важи за всяка област на живота – в секса, в свиренето на пиано, в преподаването: докато мислиш как ще се представиш, се проваляш. Затова трябва да забравиш за страха и да се пуснеш по течението, или както джедаите казват: „Не мисли, а действай!“ Тактиката е да забравиш за себе си. Не е лесно, знам, но едва тогава можем да живеем щастливо. Много сме фокусирани върху себе си и това ни пречи.

Постоянно говорите за щастието, красотата, радостта. Докъде искате да стигнете? Какво още искате да се случи?
Много неща. Първото от тях е, че искам почти всеки да е чувал за тази алтернатива – школата: ако има нещо, което не можеш да схванеш, има къде да го научиш. Дори човек да не запише цялата школа, може да има нещо малко, което да го интересува, и това е мястото, където да го чуе разбираемо. Ако просто дам надежда на хората, които искат да се занимават с тези области, за мен това е достатъчно. Значи има надежда.
Планираме и допълнителен материал под формата на учебници, където задачите да са подредени по сложност. Искаме да отворим и крило „Квантова физика“.
Лекциите в школата не са всичко. Разчитам да се създаде общност от хората, които ги посещават. Вече ставам свидетел на приятелства, зародили се в школата, и на хора, които привличат собствените си приятели в нея. Според мен най-добре се учи в рамките на приятелството, с общуване по и извън темата, която ни е събрала. Мисля, че това би могло да промени цялото образование в страната.
Не вярвам, че институциите променят обществото. Те са важни, разбира се, не съм против тях. Но истинският прогрес и истинската промяна идват не от институция, а от движение. Движението се състои от единомислещи хора с еднакви интереси и приятелства, които имат визия да направят нещо заедно. За разлика от институциите, които имат строга йерархия и ред, в движенията има голяма доза спонтанност и отвореност към всеки, който има същите интереси.
И древните гърци, и древните египтяни са се занимавали с математика. Но знаете ли как е възникнала най-великата математика? Няколко гърци в Древна Елада, които били приятели, седнали да мислят заедно. И са създали цялата математика много по-добре от египтяните!
Вярвам, че приятелството променя абсолютно всичко; да не кажа, че е дори по-важно от цялата математика и физика.
Голямата цел на школата ще бъде да създам условията и да чакам да се случи чудото – да дойдат хора, които да създадат велики, изумителни приятелства от общ интерес.
Тогава вярвам, че няма да сме просто алтернатива на институционалното образование, а ще се влеем обратно в него, за да го обогатим. И хората ще са образовани, ще излязат от дребните си кутийки и ще видят други неща. Ето това е голямата цел на школата.
Светът се променя с бясна скорост. Професиите, в които ще се развиват поколенията, започващи днес образователния си път, все още не са измислени. Подготвена ли е нашата образователна система, за да отговори на тези предизвикателства? Какво може и трябва да се промени? А как?
Веднъж месечно в рубриката „Възможното образование“ говорим за промяната – такава, каквато искаме да я видим, за добрите примери и за посоките, в които може би е добре да обърне поглед българската образователна система.
Security updates for Wednesday
Post Syndicated from jzb original https://lwn.net/Articles/1037471/
Security updates have been issued by Fedora (buildah, containers-common, glycin, loupe, podman, rust-matchers, and rust-tracing-subscriber), Red Hat (fence-agents, jackson-annotations, jackson-core, jackson-databind, jackson-jaxrs-providers, and jackson-modules-base, pki-deps:10.6, python-requests, python3.12-cryptography, redis:6, redis:7, and resource-agents), Slackware (libssh), SUSE (aide, cloud-init, iperf, java-1_8_0-openjdk, jq, kernel-devel, python-deepdiff, regionServiceClientConfigAzure, regionServiceClientConfigEC2, and regionServiceClientConfigGCE), and Ubuntu (gnutls28).
HMS Oxley: The First Allied Submarine Lost in WWII
Post Syndicated from The History Guy: History Deserves to Be Remembered original https://www.youtube.com/watch?v=VFDp4auQDVs
Реформата на домовете за деца – между обещанията и реалността
Post Syndicated from Евгения Тонева original https://www.toest.bg/reformata-na-domovete-za-detsa-mezhdu-obeshtaniyata-i-realnostta/

През 2025 г. България официално приключва процеса по деинституционализация на грижата за деца. Терминът се отнася за замяната на познатите от социалистическото минало големи детски домове с по-малки социални услуги и приемна грижа, където децата да растат в сигурна семейна среда. Но не се изчерпва с това, а включва нова философия как да реагира държавата, ако едно дете остане без родители, които да го гледат. Дали извършената реформа обаче е цялостна и истинска?
Сцена от един уж отдавна закрит дом
Августовски следобед е. Вървя през малкия град, където ме упътиха за „дома за болни деца“. В края на улицата се намира стандартна триетажна сграда с асфалтиран двор. Гледката напомня на занемарено училище и някак инстинктивно човек очаква там да няма деца в средата на лятната ваканция.
Деца обаче има. Те също ме забелязват и след малко поне десет от тях вече се катерят по оградата, други подават ръце през нея. Питат ме едно през друго при тях ли идвам, как се казвам, откъде съм, казват ми имената си, правят ми комплименти. Някои произнасят думите трудно, други изобщо не говорят, обръщат се към мен, но отместват глава, когато ги погледна, повечето искат да ме пипнат, да се здрависаме, едно момиче ме прегръща. Създалата се суматоха приключва толкова бързо, колкото е и започнала, когато глас някъде отдалече обявява, че вече е време всички да влизат вътре. След малко дворът напълно утихва. Нищо особено не се е променило отпреди осем години, когато бях тук за последно. Още тогава този дом беше вече „закрит“.
Вероятно всеки, който е имал повод да посети дом за деца в миналото, е бил участник или свидетел на сцена, подобна на тази. Или дори на съвсем същата.
Поведението на децата в домове често е натрапчиво. Те са, както се казва, прилепчиви – гушкат непознати, казват им, че ги обичат, готови са да тръгнат с тях, понякога без нито веднъж да са ги погледнали директно в лицата. В това професионалистите лесно разпознават симптом на хроничната липса на внимание.
При децата, които израстват без родители или без други значими възрастни, с които да се свържат емоционално истински, живеейки в големи сгради, приютяващи десетки като тях, често се проявяват също и забавяне в развитието, психологически проблеми, усещане за ниска собствена стойност, неувереност в перспективата за бъдещето. Това е свързано с развитата от тях зависимост от структурата на институцията: еднотипно, стриктно разграфено ежедневие в йерархична, затворена среда, в което децата правят почти всичко заедно на големи групи, независимо от нуждите или желанията си.
Тази зависимост на свой ред пречи на социалната адаптация и ограничава възможностите за успешен самостоятелен живот след края на престоя в дома. Бившите възпитаници на институции са изложени на по-висок риск от бедност и бездомничество, въвличане в криминални дейности, самоубийство.
Пред такива трудности са изправени хиляди деца от държавните домове, създадени по времето на социализма в България.
Докато българската държава произвежда домове и социални проблеми, на запад се трупат научни доказателства за вредното въздействие на институционалната грижа върху децата.
Още през 90-те години става ясно, че обхватът на институционалната грижа за децата у нас е тревожно висок, а качеството на грижата в институциите – тревожно ниско. Първото официално картографиране на домовете от 2001 г. по проект на Световната банка показва близо 35 000 деца в различни видове специализирани институции: домове за бебета от 0- до 3-годишна възраст; домове за деца, лишени от родителски грижи в предучилищна и в училищна възраст; домове за деца с физически увреждания и умствена изостаналост; интернатни групи в помощни и възпитателни училища. Големият обхват предполага недобро финансиране и недостатъчен контрол (доколкото изобщо е имало някакъв), които пък генерират оскъдица и злоупотреби, характерни за българските детски домове почти през цялото им съществуване.

Усилията да се намали институционализацията на деца започват още по това време и включват както целенасочени действия на държавата в лицето на новосъздадената система за закрила на детето, така и на български и международни организации, работещи на терен. Тези усилия променят живота на някои деца и родители, но постепенно за много от професионалистите, ангажирани с тях, става ясно, че без цялостна концепция за голяма, структурна промяна, проблемите ще продължат да съществуват, а домовете спорадично да генерират шумни скандали.
Емблематичен в това отношение е скандалът, предизвикан от филма на британската журналистка Кейт Блюит за дома за деца с увреждания в с. Могилино, Русенско, излъчен по BBC през 2007 г. Фрапиращо лошите условия за живот и отношение към изоставените в този дом деца, прожектирани през филтъра на изумения поглед на един чужд на нашенския контекст наблюдател, предизвикват дълбоко неприятно усещане за срам сред голяма част от българското общество.
Голямото обещание за деинституционализацията
През 2010 г. с Националната стратегия „Визия за деинституционализацията на децата в Република България“ българската държава прави голямо обещание да скъса окончателно със стария начин за отглеждане на деца в домове завинаги, като закрие всички такива институции в срок от 15 години. По това време в 137 дома живеят малко над 7500 деца. За всяко от тях, както и за другите деца, на които в бъдеще ще се налага да живеят без родители, държавата се ангажира да заменени институционалната грижа с грижа в „семейна или близка до семейната среда“.
Обявеният курс към деинституционализация е решителна стъпка към промяна, с която държавата с безпрецедентна откритост признава съществуването на сериозен проблем в социалната сфера и се ангажира с неговото разрешаване. Реформата е подкрепена от Европейската комисия и водещи експерти от европейски неправителствени организации, чиито представители консултират планирането на процеса и съдействат той да получи интегрирано финансиране чрез няколко европейски структурни фонда. Тогава Европейската комисия за първи път експериментира с „кръстосано“ финансиране за осъществяване на една национална публична политика в държава членка.
Сред експертите в областта у нас и в чужбина съществува съгласие, че българският план за деинституционализация е смел и амбициозен (вж. например тук, тук и тук).
Предхождащият я опит на други държави показва, че подобни мащабни реформи се осъществяват трудно и бавно.
Макар целите им да са хуманни и подкрепени с безспорни научни доказателства за вредата, която нанася институционалната грижа, пътят на осъществяването им е обрасъл с тревоги и страхове. Например какво ще се случи с децата, персонала и материалния фонд на закритите домове и възможна ли е изобщо алтернатива?
Преди да бъде приета Националната стратегия за деинституционализация, за мнозина в България този път дори изглежда немислим, както показва и знаковото изказване от 2008 г. на тогавашната социална министърка г-жа Емилия Масларова във връзка със скандала около филма за дома в с. Могилино, че „домове винаги ще има, такива с решетки на прозорците“.
И все пак държавата тръгва по този път. Зад процеса у нас стоят конкретен план, политическата воля на реформистки настроеното управляващо мнозинство и европейските средства. Затова той е посрещнат с любопитство, ентусиазъм и искрена надежда, че ще стане по-добре (а не както винаги).
Обратно в наши дни – закриването на последните домове
През 2025 г. старите институции за грижа за деца са затворени с изключение на два дома за медико-социални грижи за деца във Варна и Плевен. Децата, настанени в тях от цялата страна, са със сериозни увреждания, които изискват специално внимание и – по експертни оценки – постоянна медицинска грижа. Липсата на подходящи алтернативи за настаняване на деца с подобни нужди и страхът какво ще се случи с тях извън домовете, са препъникамъкът пред закриването им.
Доза горчива ирония има във факта, че именно децата с най-сериозни увреждания все още са в институции. Една от причините българският модел за деинституционализация да се смята за толкова смел и новаторски е декларацията, че реформата у нас ще започне тъкмо с децата с увреждания. Тъй като те са най-уязвимите сред всички деца без родители, за тях решения се намират най-трудно и често се получава така, че „пропадат в дупките“ на реформистките политики. Изглежда, че вместо да опровергае заключенията от натрупания другаде опит, деинституционализацията у нас ги потвърждава.
При все това
детската деинституционализация неизменно присъства като особен повод за гордост в изказванията на членове на всички правителства от 2010 г. насам –
независимо от политическата сила, която представляват, и от нейните заслуги към процеса. „Реформата у нас се осъществява изключително като държавна политика и в резултат на това вече няма институционална грижа за деца“, заявява социалният министър Борислав Гуцанов през юли 2025 г. и допълва, че държавата ни може да служи за пример на други страни в това отношение. Макар до предвидения край на реформата да остават броени месеци, а закриването на последните два дома за деца сериозно да буксува по време на управлението му. Въпреки настояванията на неправителствени организации нито Социалното, нито Здравното министерство (под чиято юрисдикция се намират последните останали домове) възстанови работата на създадения от предходното правителство експертен съвет за подпомагане на закриването на тези домове.
„Алтернативата“ на закритите домове
Освен закриването на всички домове за деца (без два), постиженията на България в деинституционализирането на детската грижа би трябвало да включват и сигурна семейна среда за децата, които не разчитат на родителска грижа. Инвестициите в развитието на приемната и резидентната грижа са значителни. Обхватът на първата се увеличава над десетократно за последните 15 години. Изградена е нова инфраструктура от социални услуги за резидентна грижа, в които децата да живеят в по-малки групи и да получават повече индивидуализирана подкрепа и внимание. Законът за социалните услуги, приет през 2018 г., въвежда нови регулации за качество на грижите в тези места за настаняване.
От публичните данни (годишни доклади на Агенцията за социално подпомагане и Регистъра на видовете социални услуги, финансирани от държавния бюджет) може да се извлече информацията, че към днешна дата приблизително 8500 деца в България живеят в уредена от държавата грижа. Около 1500 от тях са в приемни семейства, а други 4000 – в семейства на свои близки и роднини. Малко над 3000 са настанени в близо 300 социални услуги за резидентна грижа. Това са най-вече т.нар. центрове за настаняване от семеен тип. Както показва и самото име, чрез тези центрове държавата осигурява среда, близка до семейната.

Тези числа са сравнително устойчиви през последните пет години. Те сочат, че в края на процеса на деинституционализация малко повече от 1/3 от всички деца, за които държавата осигурява грижа, живеят в малки групови домове. Макар и „от семеен тип“, те не са фактически семейна среда, каквато осигурява приемната грижа.
Един преглед на разположението на малките домове показва, че в момента поне 66 от тях се намират в сгради на формално вече затворени институции.
Или с други думи, почти всяка четвърта от тези социални услуги в момента се намира в сграда, в която в миналото е имало дом. Още поне 15 услуги за резидентна грижа са в малки населени места в непосредствена близост до затворени домове, понякога на същата улица или дори в самия двор на бившата вече институция.
Така близо 900 деца без родители и в момента живеят във или до закритите домове. Важен детайл е, че социалните услуги в бившите домове обикновено са по две или повече, за между 8 и 15 деца всяка. Това означава, че заедно живеят по 20, 30, а в някои случаи и повече деца.
Конкретен пример: Роман
Децата от историята, с която започва статията, живеят на едно от тези места.
Роман е град гара в Северозападна България, на железопътната линия София – Варна. Там повече от 50 години са функционирали два дома: единият – за деца с увреждания, другият – без увреждания. Днес във всяка от сградите на тези вече закрити домове има по три нови социални услуги за резидентна грижа.


Гара Роман и училищен автобус в гр. Роман. Снимки: Евгения Тонева
В този трайно обезлюдяващ се град живеят постоянно по-малко от 2000 души, което означава, че при средно 10 деца и 8 възрастни, които се грижат за тях в услуга, един на всеки 20 души в града е или дете, или служител в някоя от тях. За сравнение, в областния град Враца един на всеки 500 души е дете или служител в услуга за резидентна грижа за деца, а в столицата, където са съсредоточени най-много на брой такива услуги – един на 2000 души.
Тази пропорция е стряскаща, защото е индикация за наличието на едно детско социално гето, в което органите за закрила на детето продължават да настаняват нови деца. Всяко от тях попада в тази без никакво съмнение институционална среда и заживява в сянката на стигмата за „домското дете“. Ако попитам някое от тях къде живее, вероятно ще чуя от собствената му уста за „дома за здрави деца“ и „дома за болни деца“, нищо че „на хартия“ институции в този град вече няма.
Защо това е проблем?
Сградите, които някога са били домове за стотици деца, продължават да носят тежестта на миналото. Тежест, която не се изтрива с промени „на хартия“ или във вътрешното устройство, нито дори с нови стандарти за грижа. Тези места все така се асоциират с изоставени деца и социално изключване. Установените практики и нагласи, старите модели на поведение и отношенията, характерни за институционалната грижа, също невинаги могат да се трансформират в принципно различни в ежедневната работа на персонала.
В новите услуги „от семеен тип“ често работят същите хора от „закритите“ домове, а новите служители лесно усвояват техните модели. Макар формално групите да са по-малки, децата, настанени в такива струпани на едно място услуги, все пак са твърде много, за да получат необходимото индивидуално внимание. Времето, прекарано с възпитателите в лични разговори, не е равностойно на това в семейна среда, което пречи на изграждането на сигурни, постоянни връзки.
По-голямата част от времето децата прекарват всички заедно. Още повече че предвид малкото населено място, възможностите им за образование и други занимания остават ограничени до това, което се организира за тях и в което всички участват като група. Също така всички ходят в едно и също училище и завършват с един и същи профил, независимо от интересите си.
Това положение естествено влияе върху развитието и социална адаптация по същия начин, по който животът в домовете е влияел в миналото, останало уж зад нас след деинституционализацията.
Между постигнатото и необходимото
Българската деинституционализация има своите успехи, които следва да се признаят, най-малкото като знак за волята за промяна и признателност към усилията на хората, втъкали професионалния или доброволческия си път в този процес. Тези, които наистина ги е грижа, са немалко. Старите домове са закрити и вече са прокарани мостовете към новите модели за държавна детска грижа. Историята обаче още няма щастлив край, защото деинституционализацията не бива да се свежда до статистика, доказваща успешно изпълнен политически проект, при която е важно какви показатели „преобладават“. Тя е и морален ангажимент за осигуряване на по-добро детство за всяко дете в България, което се озовава в особено тежката житейска ситуация да остане без родители до себе си.
Преди да посочваме сами себе си като позитивен пример за успешни реформи, от който други държави да черпят опит, е нужно да се вгледаме внимателно в скритите форми на институционализация, които все още съществуват. Като начало може да видим произволно дете, живеещо днес в някой дом от уж безвъзвратно отишлото си минало.
Мария от „Махала“ и нейното усещане за общност
Post Syndicated from Ина Иванова original https://www.toest.bg/mariya-ot-mahala-i-neynoto-useshtane-za-obshtnost/

Това е история за пътя, който изминава една идея, споделена между приятели, за да се превърне в независимо арт пространство. Точно така преди две години и половина в София се появява книжарница „Махала“ , вкоренява се в града и променя хората, попаднали в обсега ѝ. Градска, светла и висока (в буквалния и метафоричния смисъл), тя заявява вкус – литературен, музикален, естетически. „Махала“ е концептуална независима книжарница, която предлага художествена литература и ценни издания на няколко езика. За изкушения читател обаче е ясно, че подбраните автори са имена, които формират микрообщества от почитатели по цял свят.
Предлагаме книги, които харесваме. Неща, към които не бих посегнала, не бих предложила и на никой друг,
споделя Мария Енчева и това вероятно е най-честният подход. Методология, която легитимира и овластява доверието. На екипа – към клиентите, но и на почитателите на независимата книжарница – към вкуса на собствениците, които селектират книгите, списанията, албумите и събитията си.
Съдружници в начинанието са Йордан Жечев (журналист, общественик и предприемач в различни бизнеси, свързани с изкуството и вкуса към живота) и Мария Енчева (една от иконичните ни съвременни преводачки, основно от нидерландски език).
С Йордан се запознахме чрез общ приятел и малко така, на шега, веднъж той ми подхвърли: абе, дай да си отворим книжарница. А като си наумиш нещо, започваш да ровиш в сайтовете. Тръгнахме да търсим помещение под наем, но все още като на игра, докато не попаднахме на това място. А иначе хората често мислят, че винаги съм мечтала да имам книжарница, макар до този разговор с Йордан да не си бях представяла изобщо, че ще правя нещо различно от преводите.
Като дете Мария Енчева всъщност е искала да кара камион – тир, голям и трансграничен. Може би защото, както самата тя твърди, много обича да шофира, но вероятно и заради свободата… Впрочем днес тя отново пресича граници и създава мостове – между езици, култури и човеци. Страстта си към пътя подхранва с кемпера, с който със съпруга ѝ пътешестват при всеки удобен случай. Нарича пътуването вид медитация. А после се засмива, че ѝ харесва заради
монотонността на шофирането и защото все пак е някаква власт – ти си големият, с когото всички се съобразяват.
Връщаме се към необятната тема за превода.
Не съм си представяла, че ще се занимавам с превод, просто исках да уча езици.
Мария Енчева става преводач на художествена литература, след като завършва германистика в Софийския университет. Мечтае за норвежки, но още по време на следването си започва да изучава нидерландски и този език впоследствие става основният, от който превежда. И то благодарение на чудновата история.
Тя винаги е обичала да чете книги, но веднъж попада на една, която много иска да сподели с приятели – става въпрос за „Отива една жена при лекаря“ на Рей Клуун. „Така че запретнах ръкави и я преведох“, започва Мария. А после дълго се опитва да открие издател. Впоследствие научава, че правата на български вече са купени от издателство „Жанет 45“, а Манол Пейков търси преводач от нидерландски. Когато най-после издател и преводач се срещат и книгата е публикувана, започват буккросинг кампания с обществена значимост. През 2012 г. книгата може да бъде заявена на фейсбук страницата на кампанията срещу рака на гърдата, пристига с уникален код, читателят се регистрира и може да отиде на профилактичен преглед в специално обозначени кабинети – а после да предаде екземпляра от „Отива една жена при лекаря“ на свои приятели. Книгата, написана заради личната история на Рей Клуун, който губи съпругата си от рак на гърдата, вероятно спасява хора.
Животът е непредвидим, невинаги става каквото очакваш, и понякога малките решения, които вземаш, могат да сменят посоката ти. Подарих книгата на всичките си приятели, но аз не съм отваряла повече този превод и мисля, че по принцип това е част от моето притеснение – не чета готовите книги.
Мария споделя, че е човек, който се съмнява, но вероятно знае, че липсата на категоричност често е плод на широтата, с която мислим света.
Мария Енчева е фина и крехка като присъствие, а теменужените ѝ очи излъчват сила. Силата на свободолюбивия дух, на търсещия човек, който не се бои да споделя с другите – и така да преумножава натрупаното. Защото културата е натрупвания, но и жажда, любопитство към света в различните му проявления. Още повече за един преводач.
Истината е, че българският език ми е много важен и затова се опитвам да чета много на него. На нидерландски чета по-скоро за да откривам нови автори.
Това, което остава неизвестно за читателите, е процесът на изследване и предаване на авторовите намерения, многократното завръщане към отделни части на романа, върху който работи преводачът. А Мария признава, че се случва книгите да я лекуват.
Понякога в ролята си на книжар прави списъци от книги за приятели, които имат „нужда от малко свежа кръв“. Разбира се, съобразява се с техния читателски вкус. Две от последните книги, които е препоръчала, са „Вратата“ на Магда Сабо и „Соленоид“ на Картареску. Когато избира книга за себе си, гледа издателството.
Има български издателства, които не правят компромиси.
Другият ѝ ориентир е преводачът – има такива, които не биха се захванали с литература, лишена от стойност.
Да селектираш книги и събития за книжарница обаче е съвсем друг вид работа и Мария и Йордан се ръководят също и от вкуса на хората, които харесват. В книжарницата питат клиентите и приятелите си за издания, които са им направили впечатление.
Независими пространства като „Махала“ всъщност имат щастливата съдба и мисия да изграждат вкус.
Процесът с предпоставянето на очаквания е двупосочен и в комерсиалния ни свят често се приема, че пазарът, търсенето, леснината за купувача предопределят предлагането. Опасността при този подход обаче е в мекото усещане за наклон, отговарящ на все по-занижени очаквания и вероятно формиращ такива. Арт пространство, което отстоява концепцията си, завихря около себе си аудитория, очакваща да бъде предизвикана – визуално, естетически и ментално. „Махала“ подбира книги, които не могат да минат за бърза литература, поддържа усещането за общество, което в защитената „стая“ зад витрините, край голямата маса, да се чувства в безопасност. И това също е част от трудността да управляваш книжарница, „да я поддържаш жива“, както казва Мария.

Важна част от ритъма на книжарницата „На Бенковски срещу улица Екзарх Йосиф“ е селектирането на специални събития – литературни и киноразговори, малки музикални вечери, обществени дебати, представяне на автори. И разбира се, култовата „Четвъртъчна поезия“, която под формата на абонамент представя стихотворения с гласа на Йордан Жечев (за отбрано и нарастващо общество от ценители).
Начинът, по който функционират обществените пространства в повечето големи европейски градове, често е свързан точно с търсената близост до книгите. Обичайно това са библиотеки или култови арт книжарници – места, в които концептуалният подход среща и надгражда архитектурата, а историята им често обхваща едно-две столетия и е част от иконичния им статут. Достатъчно е да напомним парижката книжарница Shakespeare & Company, която предлага на писатели, артисти и интелектуалци възможност да преспят сред книгите на малки легла, които денем се използват като канапета. Подобни места често са в ролята на културни хъбове, където се организират литературни и музикални вечери, изложби, различни срещи. По подобен начин програмата на „Махала“ съвместява традиционното вече четене на поезия с вечери с тематични разговори или с прожекции на авторско кино.
Буквално дни преди разговора ни Мария Енчева за пореден път беше в Амстердам, където обича да работи в Обществената библиотека, намираща се точно на пристанището:
огромна и светла, цялата в стъкло и срещу корабите в морето – това наистина е място, направено с размах, място, на което се чувстваш приет, у дома си и можеш да останеш колкото време ти е нужно. Това усещане се надявам, че сме пресъздали и ние.
Казва още, че с годините Амстердам се е превърнал в някакъв смисъл в неин дом. Дом, в който се озовава без двете си пораснали вече деца, без съпруга и работата си. Там може да бъде нещо различно и по дълбоко личен начин – себе си.
Такава, каквато искам да бъда, да не се налага да гледам часовник, да робувам на график, абсолютната свобода, която дори не си представям, че мога да изживея в ежедневието.
Едновременно с това Мария Енчева осъзнава, че отделянето за кратко дава на нейните момчета самостоятелност, но и възможността да поемат отговорност – за битовото, а и за живота на двете котки: „подобно отсъствие е доста възпитателно за всички ни“. Споделя, че през различните възрасти на децата си по различен начин се е учила да бъде родител, че това е непрекъснат процес. Най-важно за нея е да запазят емоционалната връзка помежду си – затова се опитва да слуша тяхната музика или да гледа и чете хорърите, които харесват.
А сега, когато разполага с малко повече време, се е записала на курс по италиански. Пребивавайки в различните езици, Мария с разбиране приема шегата, че говори български, немски, английски, нидерландски и учи езика на тийнейджърите. Именно защото
езиците на различните поколения са културен код. И за един преводач това е част от работата му.
Колкото до превода, винаги се опитвам да се поставя на мястото на читателя. За мен това е водещото. В момента превеждам детски книги – наредила съм ги три подред. И когато успея да ги подкупя с нещо, момчетата ми се връзват и четем заедно. Аз им чета на глас, а те ми подсказват кое не звучи по детски, кое едно дете не би изрекло, не би разбрало…
Мария Енчева смята, че е особено важно
да четем извън себе си. Защото книгите учат на емпатия – да влезем в друг живот, в нечия друга глава, да си представим проблемите на други хора.
Това е, което очаква книгите да дадат и на синовете ѝ.

За финал се връщаме в „Махала“ – мястото, което концентрира усилията ѝ да създава смисъл по своя тих, ненатрапчив, светъл маниер. В сърцето на книжарницата има дълга маса, на която са изложени различни издания, но точно там посетителите могат да седнат с чаша чай или хубаво вино и да разглеждат книгите спокойно, преди да решат какво да изберат. Именно там са и най-съкровените моменти на свързаност, които Мария казва, че споделя в работата си.
Да се подпрем на масата десет, дванайсет човека и да гледаме заедно филм. Когато много души правим едно и също нещо, това е усещането за общност.
Независимата книжарница „Махала“ всъщност променя Мария Енчева:
Преобърна живота ми на 180 градуса. Не бях си представяла дори, че ще бъда човекът, който съм днес. Знаеш ли защо? Защото допреди масата ужасно се страхувах от хората, ненавиждах всяко общуване лице в лице. А тази маса, която се намести в живота ми преди две години и половина, ме накара да се изправя пред всякакви хора. И да открия, че човеците всъщност не са толкова страшни. Че хората дори са добри, страхотни събеседници, пълни с истории, добронамерени. И всъщност около масата срещнах приятели. Може би това е най-голямата промяна в живота ми. Не спечелих пари, но спечелих приятели.
Хората, които тихо и кротко променят средата, в която живеят, формират общности и задават посоки, в които има смисъл да тръгнем заедно. Тук ви срещаме с тях. Това са „Тези хора“.
1st Nikon Z Cinema Camera – Nikon ZR
Post Syndicated from Matt Granger original https://www.youtube.com/watch?v=uS8JJFScBfk
Comic for 2025.09.10 – Positive People
Post Syndicated from Explosm.net original https://explosm.net/comics/positive-people
New Cyanide and Happiness Comic
Only time and air raid was conducted on the continental US by enemy forces in WWII.
Post Syndicated from The History Guy: History Deserves to Be Remembered original https://www.youtube.com/shorts/07hGA0rfcoE
Biology Department
Post Syndicated from xkcd.com original https://xkcd.com/3140/

A path toward removal of kernel high-memory support
Post Syndicated from corbet original https://lwn.net/Articles/1037391/
As a followup to his OSS Europe talk on the
future of 32-bit support in the kernel, Arnd Bergmann has put together
a
detailed plan for the eventual removal of high-memory support, which he
calls “one of the least popular features of the Linux kernel
“. The
intent is “to gradually phase out highmem over the next 2 years for
“. This plan is posted as a prompt for a discussion to
mainline kernels
be held at the Kernel Summit in December, so chances are it will evolve
considerably in the next few months.
NVIDIA Rubin CPX is an AI GPU for Next-Gen NVIDIA AI GPUs
Post Syndicated from Patrick Kennedy original https://www.servethehome.com/nvidia-rubin-cpx-is-an-ai-gpu-for-next-gen-nvidia-ai-gpus/
The NVIDIA Rubin CPX is an AI GPU for next-gen NVIDIA GPUs. Planned for 2026, NVIDIA will have heterogeneous GPU and memory types clustered
The post NVIDIA Rubin CPX is an AI GPU for Next-Gen NVIDIA AI GPUs appeared first on ServeTheHome.
Decrease your storage costs with Amazon OpenSearch Service index rollups
Post Syndicated from Luis Tiani original https://aws.amazon.com/blogs/big-data/decrease-your-storage-costs-with-amazon-opensearch-service-index-rollups/
Amazon OpenSearch Service is a fully managed service to support search, log analytics, and generative AI Retrieval Augment Generation (RAG) workloads in the AWS Cloud. It simplifies the deployment, security, and scaling of OpenSearch clusters. As organizations scale their log analytics workloads by continuously collecting and analyzing vast amounts of data, they often struggle to maintain quick access to historical information while managing costs effectively. OpenSearch Service addresses these challenges through its tiered storage options: hot, UltraWarm, and cold storage. These storage tiers are great options to help optimize costs and offer a balance between performance and affordability, so organizations can manage their data more efficiently. Organizations can choose between these different storage tiers by keeping data in expensive hot storage for quick access or moving it to cheaper cold storage with limited accessibility. This trade-off becomes particularly challenging when organizations need to analyze both recent and historical data for compliance, trend analysis, or business intelligence.
In this post, we explore how to use index rollups in Amazon OpenSearch Service to address this challenge. This feature helps organizations efficiently manage their historical data by automatically summarizing and compressing older data while maintaining its analytical value, significantly reducing storage costs in any storage tier without sacrificing the ability to query historical information effectively.
Index rollups overview
Index rollups provide a mechanism to aggregate historical data into summarized indexes at specified time intervals. This feature is particularly useful for time series data where the granularity of older data can be reduced while maintaining meaningful analytics capabilities.
Key benefits include:
- Reduced storage costs (varies by granularity level), for example:
- Larger savings when aggregating from seconds to hours
- Moderate savings when aggregating from seconds to minutes
- Improved query performance of historical data
- Maintained data accessibility for long-term analytics
- Automated data summarization process
Index rollups are part of a comprehensive data management strategy. The real cost savings come from properly managing your data lifecycle in conjunction with rollups. To achieve meaningful cost reductions, you must remove or move the original data to a lower-cost storage tier after creating the rollup.
For customers already using Index State Management (ISM) to move older data to UltraWarm or cold tiers, rollups can provide significant additional benefits. By aggregating data at higher time intervals before moving it to lower-cost tiers, you can dramatically reduce the volume of data in these tiers, leading to further cost savings. This strategy is particularly effective for workloads with large amounts of time series data, typically measuring in terabytes or petabytes. The larger your data volume, the more impactful your savings will be when implementing rollups correctly.
Index rollups can be implemented using ISM policies through the OpenSearch Dashboards UI or the OpenSearch API. Index rollups require OpenSearch or Elasticsearch 7.9 or later.
The decision to use different storage tiers requires careful consideration of an organization’s specific needs, balancing the desire for cost savings with the requirement for data accessibility and performance. As data volumes continue to grow and analytics become increasingly important, finding the right storage strategy becomes crucial for businesses to remain competitive and compliant while managing their budgets effectively.
In this post, we consider a scenario with a large volume of time series data that can be aggregated using the Rollup API. With rollups, you have the flexibility to either store aggregated data in the hot tier for rapid access or aggregate and promote it to more cost-effective tiers such as UltraWarm or cold storage. This approach allows for efficient data and index lifecycle management while optimizing both performance and cost.
Index rollups are often confused with index rollovers, which are automated OpenSearch Service operations that create new indexes when specified thresholds are met, for example by age, size, or document count. This feature maintains raw data while optimizing cluster performance through controlled index growth. For example, rolling over when an index reaches 50 GB or is 30 days old.
Use cases for index rollups
Index rollups are ideal for scenarios where you need to balance storage costs with data granularity, such as:
- Time series data that requires different granularity levels over time – For example, Internet of Things (IoT) sensor data where real-time precision matters only for the most recent data.
- Traditional approach – It is common for users to keep all data in expensive hot storage for instant accessibility. However, this isn’t optimal for cost.
- Recommended – Retain recent (per second) data in hot storage for immediate access. For older periods, store aggregated (hourly or daily) data using index rollups. Move or delete the higher-granularity old data from the hot tier. This balances accessibility and cost-effectiveness.
- Historical data with cost-optimization needs – For example, system performance metrics where overall trends are more valuable than precise values over time.
- Traditional approach – It is common for users to store all performance metrics at full granularity indefinitely, consuming excessive storage space. We don’t recommend storing data indefinitely. Implement a data retention policy based on your specific business needs and compliance requirements.
- Recommended – Maintain detailed metrics for recent monitoring (last 30 days) and aggregate older data into hourly or daily summaries. This preserves the trend analysis capability while significantly reducing storage costs.
- Log data with infrequent historical access and low value – For example, application error logs where detailed investigation is primarily needed for recent incidents.
- Traditional approach – It is common for users to keep all log entries at full detail, regardless of age or access frequency.
- Recommended – Preserve detailed logs for an active troubleshooting period (for example, 1 week) and maintain summarized error patterns and statistics for older periods. This enables historical pattern analysis while reducing storage overhead.
Schema design
A well-planned schema is crucial for successful rollup implementation. Proper schema design makes sure your rolled-up data remains valuable for analysis while maximizing storage savings. Consider the following key aspects:
- Identify fields required for long-term analysis – Carefully select fields that provide meaningful insights over time, avoiding unnecessary data retention.
- Define aggregation types for each field, such as min, max, sum, and average – Choose appropriate aggregation methods that preserve the analytical value of your data.
- Determine which fields can be excluded from rollups – Reduce storage costs by omitting fields that don’t contribute to long-term analysis.
- Consider mapping compatibility between source and target indexes – Provide successful data transition without mapping conflicts. This involves:
- Matching data types (for example, date fields remain as date in rollups)
- Handling nested fields appropriately
- Ensuring all required fields are included in the rollup
- Considering the impact of analyzed vs. non-analyzed fields
- Incompatible mappings can lead to failed rollup jobs or incorrect data aggregation.
Functional and non-functional requirements
Before implementing index rollups, consider the following:
- Data access patterns – When implementing data rollup strategies, it’s crucial to first analyze data access patterns, including query frequency and usage periods, to determine optimal rollup intervals. This analysis should lead to specific granularity metrics, such as deciding between hourly or daily aggregations, while establishing clear thresholds based on both data volume and query requirements. These decisions should be documented alongside specific aggregation rules for each data type.
- Data growth rate – Storage optimization begins with calculating your current dataset size and its growth rate. This information helps quantify potential space reductions across different rollup strategies. Performance metrics, particularly expected query response times, should be defined upfront. Additionally, establish monitoring KPIs focusing on latency, throughput, and resource usage to make sure the system meets performance expectations.
- Compliance or data retention requirements – Retention planning requires careful consideration of regulatory requirements and business needs. Develop a clear retention policy that specifies how long to keep different types of data at various granularity levels. Implement systematic processes for archiving or deleting older data and maintain detailed documentation of storage costs across different retention periods.
- Resource utilization and planning – For successful implementation, proper cluster capacity planning is essential. This involves accurately sizing computing resources, including CPU, RAM, and storage requirements. Define specific time windows for executing rollup jobs to minimize impact on regular operations. Set clear resource utilization thresholds and implement proactive capacity monitoring. Finally, develop a scalability plan that accounts for both horizontal and vertical growth to accommodate future needs.
Operational requirements
Proper operational planning facilitates smooth ongoing management of your rollup implementation. This is essential for maintaining data reliability and system health:
- Monitoring – You must monitor rollup jobs for their accuracy and desired results. This means implementing automated checks that validate data completeness, aggregation accuracy, and job execution status. Set up alerts for failed jobs, data inconsistencies, or when aggregation results fall outside expected ranges.
- Scheduling hours – Schedule rollup operations during periods of low system usage, typically during off-peak hours. Document these maintenance windows clearly and communicate them to all stakeholders. Include buffer time for potential issues and establish clear procedures for what happens if a maintenance window needs to be extended.
- Backup and recovery – OpenSearch Service takes automated snapshots of your data at 1-hour intervals. But you can define and implement comprehensive backup procedures using snapshot management functionality to support your Recovery Time Objective (RTO) and Recovery Point Objective (RPO).
Your RPO can be customized through different rollup schedules based on index patterns. This flexibility helps you define varied data loss tolerance levels according to your data’s criticality. For mission-critical indexes, you can configure more frequent rollups, while maintaining less frequent schedules for analytical data.
You can tailor RTO management in OpenSearch per index pattern through backup and replication options. For critical rollup indexes, implementing cross-cluster replication maintains up-to-date copies, significantly reducing recovery time. Other indexes might use standard backup procedures, balancing recovery speed with operational costs. This flexible approach helps you optimize both storage costs and recovery objectives based on your specific business requirements for different types of data within your OpenSearch deployment.
Before implementing rollups, audit all applications and dashboards that use the data being aggregated. Update queries and visualizations to accommodate the new data structure. Test these changes thoroughly in a staging environment to confirm they continue to provide accurate results with the rolled-up data. Create a rollback plan in case of unexpected issues with dependent applications.
In the following sections, we walk through the steps to create, run, and monitor a rollup job.
Create a rollup job
As discussed in previous sections, there are some considerations when choosing good candidates for index rollup usage. Building on this concept, identify your indexes to roll up their data and create the jobs.The following code is an example of creating a basic rollup job:
This rollup job processes IoT sensor data, aggregating readings from the sensor-* index pattern into hourly summaries stored in sensor_rolled_hour. It maintains device-level granularity while calculating average, minimum, and maximum values for temperature, humidity, pressure, and battery levels. The job executes hourly, processing 1,000 documents per batch.
The preceding code assumes that the device_id field is of type keyword; note that aggregation can’t be performed on the text field.
Start the rollup job
After you create the job, it will automatically be scheduled based on the job’s configuration (refer to the schedule: part of the job example code in the previous section). However, you can also trigger the job manually using the following API call:
POST _plugins/_rollup/jobs/sensor_hourly_rollup/_start
The following is an example of the results:
Monitor progress
Using Dev Tools, run the following command to monitor the progress:
GET _plugins/_rollup/jobs/sensor_hourly_rollup/_explain
The following is an example of the results:
The GET _plugins/_rollup/jobs/sensor_hourly_rollup/_explain command shows the current status and statistics of the sensor_hourly_rollup job. The response shows important statistics such as the number of processed documents, indexed rollups, time spent on indexing and searching, and records of any failures. The status indicates whether the job is active (started) or stopped (stopped) and shows the last processed timestamp. This information is crucial for monitoring the efficiency and health of the rollup process, helping administrators track progress, identify potential issues or bottlenecks, and confirm the job is operating as expected. Regular checks of these statistics can help in optimizing the rollup job’s performance and maintaining data integrity.
Real-world example
Let’s consider a scenario where a company collects IoT sensor data, ingesting 240 GB of data per day to an OpenSearch cluster, which totals 7.2 TB per month.
The following is an example record:
Assume you have a time series index with the following configuration:
- Ingest rate: 10 million documents per hour
- Retention period: 30 days
- Each document size: Approximately 1 KB
The total storage without rollups is as follows:
- Per-day storage size: 10,000,000 docs per hour × ~1 KB × 24 hours per day = ~240 GB
- Per-month storage size: 240 GB × 30 days = ~7.2 TB
The decision to implement rollups should be based on a cost-benefit analysis. Consider the following:
- Current storage costs vs. potential savings
- Compute costs for running rollup jobs
- Value of granular data over time
- Frequency of historical data access
For smaller datasets (for example, less than 50 GB/day), the benefits might be less significant. As data volumes grow, the cost savings become more compelling.
Rollup configuration
Let’s roll up the data with the following configuration:
- From 1-minute granularity to 1-hour granularity
- Aggregating average, min, and max, grouped by device_id
- Reducing 60 documents per minute to 1 rollup document per minute
The new document count per hour is as follows:
- Per-hour documents: 10,000,000/60 = 166,667 docs per hour
- Assuming each rollup document is 2 KB (extra metadata), total rollup storage: 166,667 docs per hour × 24 hours per day × 30 days × 2KB ˜= 240 GB/month
Verify all required data exists in the new rolled index, then delete the original index to remove raw data manually or by using ISM policies (as discussed in the next section).
Execute the rollup job following the preceding instructions to aggregate data into the new rolled up index. To view your aggregated results, run the following code:
The following code shows the example results:
This document represents the rolled-up data for sensor_001 and sensor_002 during a 1-hour period. It aggregates 1 hour of sensor readings into a single record, storing minimum, average, and maximum values for temperature levels. The record includes metadata about the rollup process and timestamps for data tracking. This aggregated format significantly reduces storage requirements while maintaining essential statistical information about the sensor’s performance during that hour.
We can calculate the storage savings as follows:
- Original storage: 7.2 TB (or 7200 GB)
- Post-rollup storage: 240 GB
- Storage savings: ((7.2 TB – 240 GB)/7.2 GB) × 100 = 96.67% savings
Using OpenSearch rollups as demonstrated in this example, you can achieve approximately 96% storage savings while preserving important aggregate insights.
The aggregation levels and document sizes can be customized according to your specific use case requirements.
Automate rollups with ISM
To fully realize the benefits of index rollups, automate the process using ISM policies. The following code is an example that implements a rollup strategy based on the given scenario:
This ISM policy automates the rollup process and data lifecycle:
-
- Applies to all indexes matching the sensor-* pattern.
- Keeps original data in the hot state for 1 day.
- After 1 day, rolls up the data into minutely aggregations. Aggregates by device_id and calculates average, minimum, and maximum for temperature and humidity.
- Stores rolled-up data in the sensor_rolled_minutely index.
- Deletes the original index 2 days after rollup.
This strategy offers the following benefits:
- Recent data is available at full granularity
- Historical data is efficiently summarized
- Storage is optimized by removing original data after rollup
You can monitor the policy’s execution using the following command:
Remember to adjust the timeframes, metrics, and aggregation intervals based on your specific requirements and data patterns.
Conclusion
Index rollups in OpenSearch Service provide a powerful way to manage storage costs while maintaining valuable historical data access. By implementing a well-planned rollup strategy, organizations can achieve significant cost savings while making sure their data remains available for analysis.
To get started, take the following next steps:
- Review your current index patterns and data retention requirements
- Analyze your historical data volumes and access patterns
- Start with a proof-of-concept rollup implementation in a test environment
- Monitor performance and storage metrics to optimize your rollup strategy
- Move the infrequently accessed data between storage tiers:
- Delete data you’ll no longer use
- Automate the process using ISM policies
To learn more, refer to the following resources:
- Amazon OpenSearch Service Documentation
- Amazon OpenSearch Service on YouTube: Index Rollups
- Summarizing indexes in Amazon OpenSearch Service with index rollups
- Index rollups API
About the authors
Accelerating local serverless development with console to IDE and remote debugging for AWS Lambda
Post Syndicated from Brian Krygsman original https://aws.amazon.com/blogs/compute/accelerating-local-serverless-development-with-console-to-ide-and-remote-debugging-for-aws-lambda/
Delightful developer experience is an important part of building serverless applications efficiently, whether you’re creating an automation script or developing a complex enterprise application. While AWS Lambda has transformed modern application development in the cloud with its serverless computing model, developers spend significant time working in their local environments. They rely on familiar IDEs, debugging tools, testing frameworks, and build within established organizational workflows to deliver production-ready applications.
This post covers some recent enhancements to local developer experience. Two new Lambda features, namely console to IDE and remote debugging, further bridge the gap between cloud and local development, enabling you to leverage the full power of your local tools while working with Lambda functions in the cloud.
Overview
Serverless development with Lambda spans both cloud and local environments, each with its unique strengths. While the Lambda console offers rapid deployment and prototyping, local development provides the depth and flexibility needed for a complex application development workflow that includes integration testing, deployment to shared environments, continuous integration/continuous deployment (CI/CD) pipelines, and collaboration with other team members. The local developer experience encompasses the tools, workflows, and practices that developers use on their local devices to build and maintain their applications. An intuitive local development experience helps application development teams achieve high productivity, ensure code quality, and confidently ship changes to production.
Recent local serverless development experience enhancements
Local development workflows can be seen as two distinct but interconnected loops: the inner loop of writing, testing, and debugging code locally, and the outer loop that extends to cloud deployment, integration testing, release pipeline, and monitoring, as shown in the following figure. For serverless applications, developers want immediate feedback within the inner loop, as they iterate on function code and test integrations with AWS services. AWS has been steadily enhancing the local development experience for developers building on Lambda, with a focus on accelerating the inner loop, where developers spend most of their time.
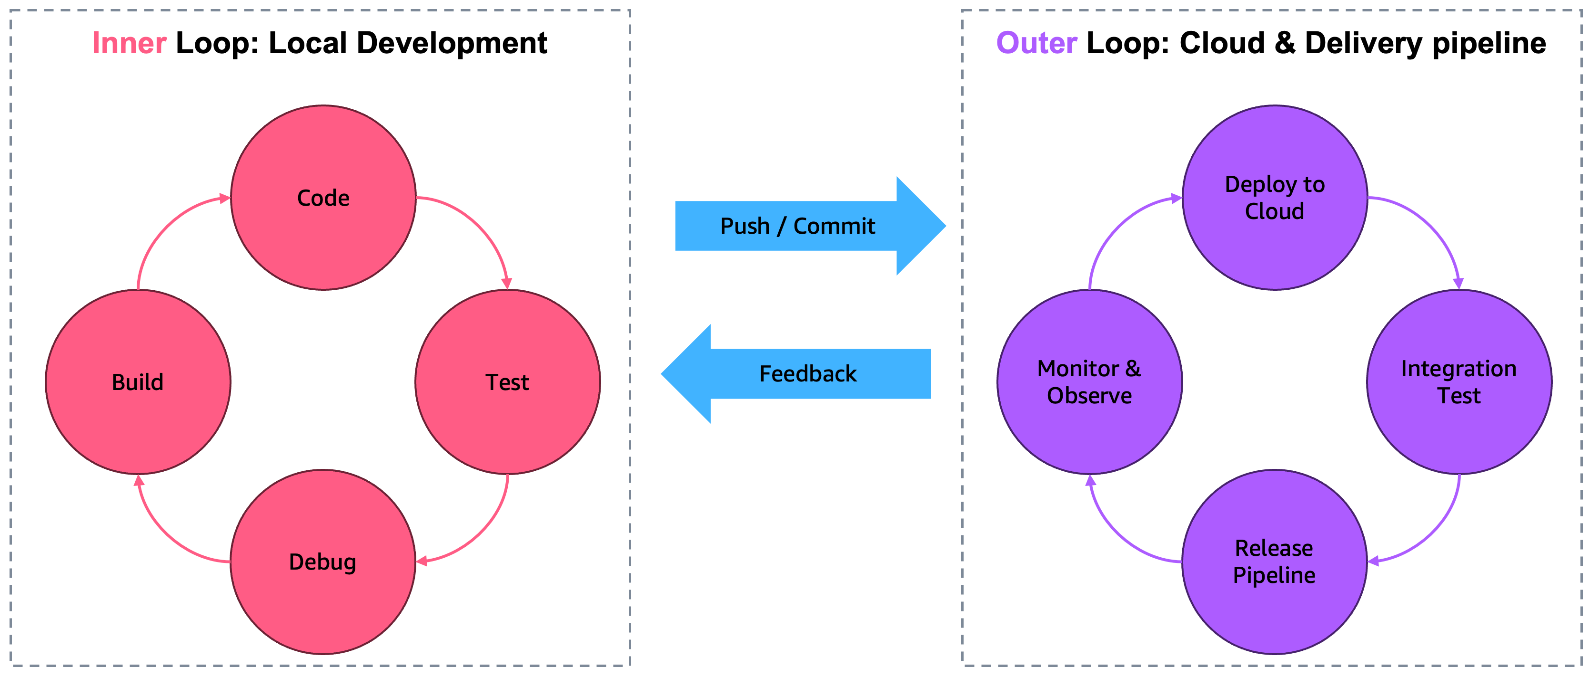
Figure 1: Inner and outer loop
Visual Studio Code (VS Code) is the most popular IDE among developers according to the 2024 Stack Overflow Developer Survey. Enhanced local IDE experience enables developers to code, test, debug, and deploy Lambda-based serverless applications more efficiently in their local IDE when using VS Code. It introduced the Application Builder interface, which streamlines the entire development workflow from setup to deployment with features such as guided walkthrough for environment setup, pre-configured sample applications, build setting management, and improved local debugging capabilities. This eliminates the need to switch between multiple interfaces. This experience also integrates with AWS Infrastructure Composer, which enables visual application building directly from VS Code, and provides quick-action buttons for common tasks like building, deploying, and invoking functions both locally and in the cloud.
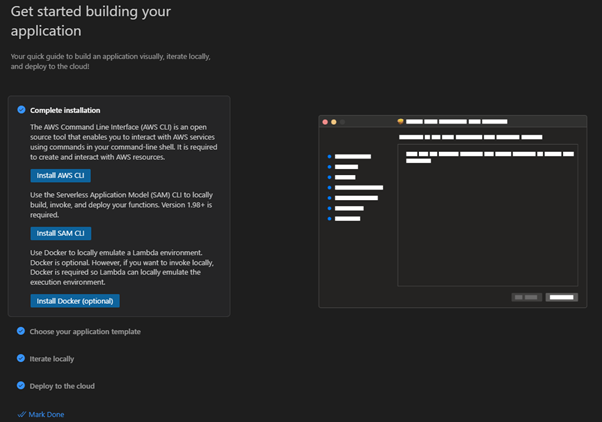
Figure 2 Guided walkthrough in VS Code IDE
With Serverless Land’s extensive ready-to-use pattern library available directly in VS Code, you can now browse, search, and implement a collection of curated, pre-built serverless patterns without leaving the IDE. This integration makes it easier to use proven architectures and AWS best practices while building serverless applications. Amazon CloudWatch Logs Live Tail support for Lambda functions in VS Code brings real-time log streaming and analytics capabilities directly into the IDE, enabling you to monitor and troubleshoot your Lambda functions without context switching. Whether testing a new feature or debugging an issue, you can now see the immediate impact of your code changes without leaving the IDE.
Console to IDE
Over the past decade, the Lambda console has enabled developers to quickly get started with writing Lambda functions, allowing them to rapidly iterate through changing code, testing, and deploying their functions. The console IDE experience saw a major usability refresh in 2024, including the introduction of Amazon Q Developer in the Lambda console.
As applications grow in complexity, developers often need to refactor code, add complex logic, include utility libraries as dependencies, or handle edge cases in their Lambda functions. Examples include using external libraries for complex time calculations or adding modules that perform caller-specific validations. This can make functions too bulky to manage in the console.
Developers may also want to move their functions into a software development lifecycle (SDLC) process that includes test frameworks, security scanning tools, infrastructure as code (IaC) templates, or CI/CD pipelines. This may necessitate that they use version control to collaborate across the team or develop with an AI agent steered by custom rules.
Previously, setting this up required manually configuring a local development environment, including IDE, language runtime, and build/package toolchains. Then, you had to download your function code, configuration, and integration settings and copy them into the IDE. You also had to create the required IaC template with AWS Serverless Application Model (AWS SAM). Only then could you deploy to the cloud to validate the accuracy of your code and configuration and continue with your development workflow.
The new Lambda console to IDE feature enables seamless transition from a cloud-hosted code/test cycle to a local environment, allowing you to download your function code and configuration to local VS Code IDE with just one click. From there, you can easily add dependencies and commit code into source control. Furthermore, you can sync back to the cloud for deployment or export a full AWS SAM template with the “Convert to SAM” capability and continue managing your function as if you had started locally. Console to IDE guides you through setting up the IDE on your local device, if you don’t already have one, along with any necessary configuration. The following figures show a function open in the Lambda console and thereafter in the local VS Code IDE.
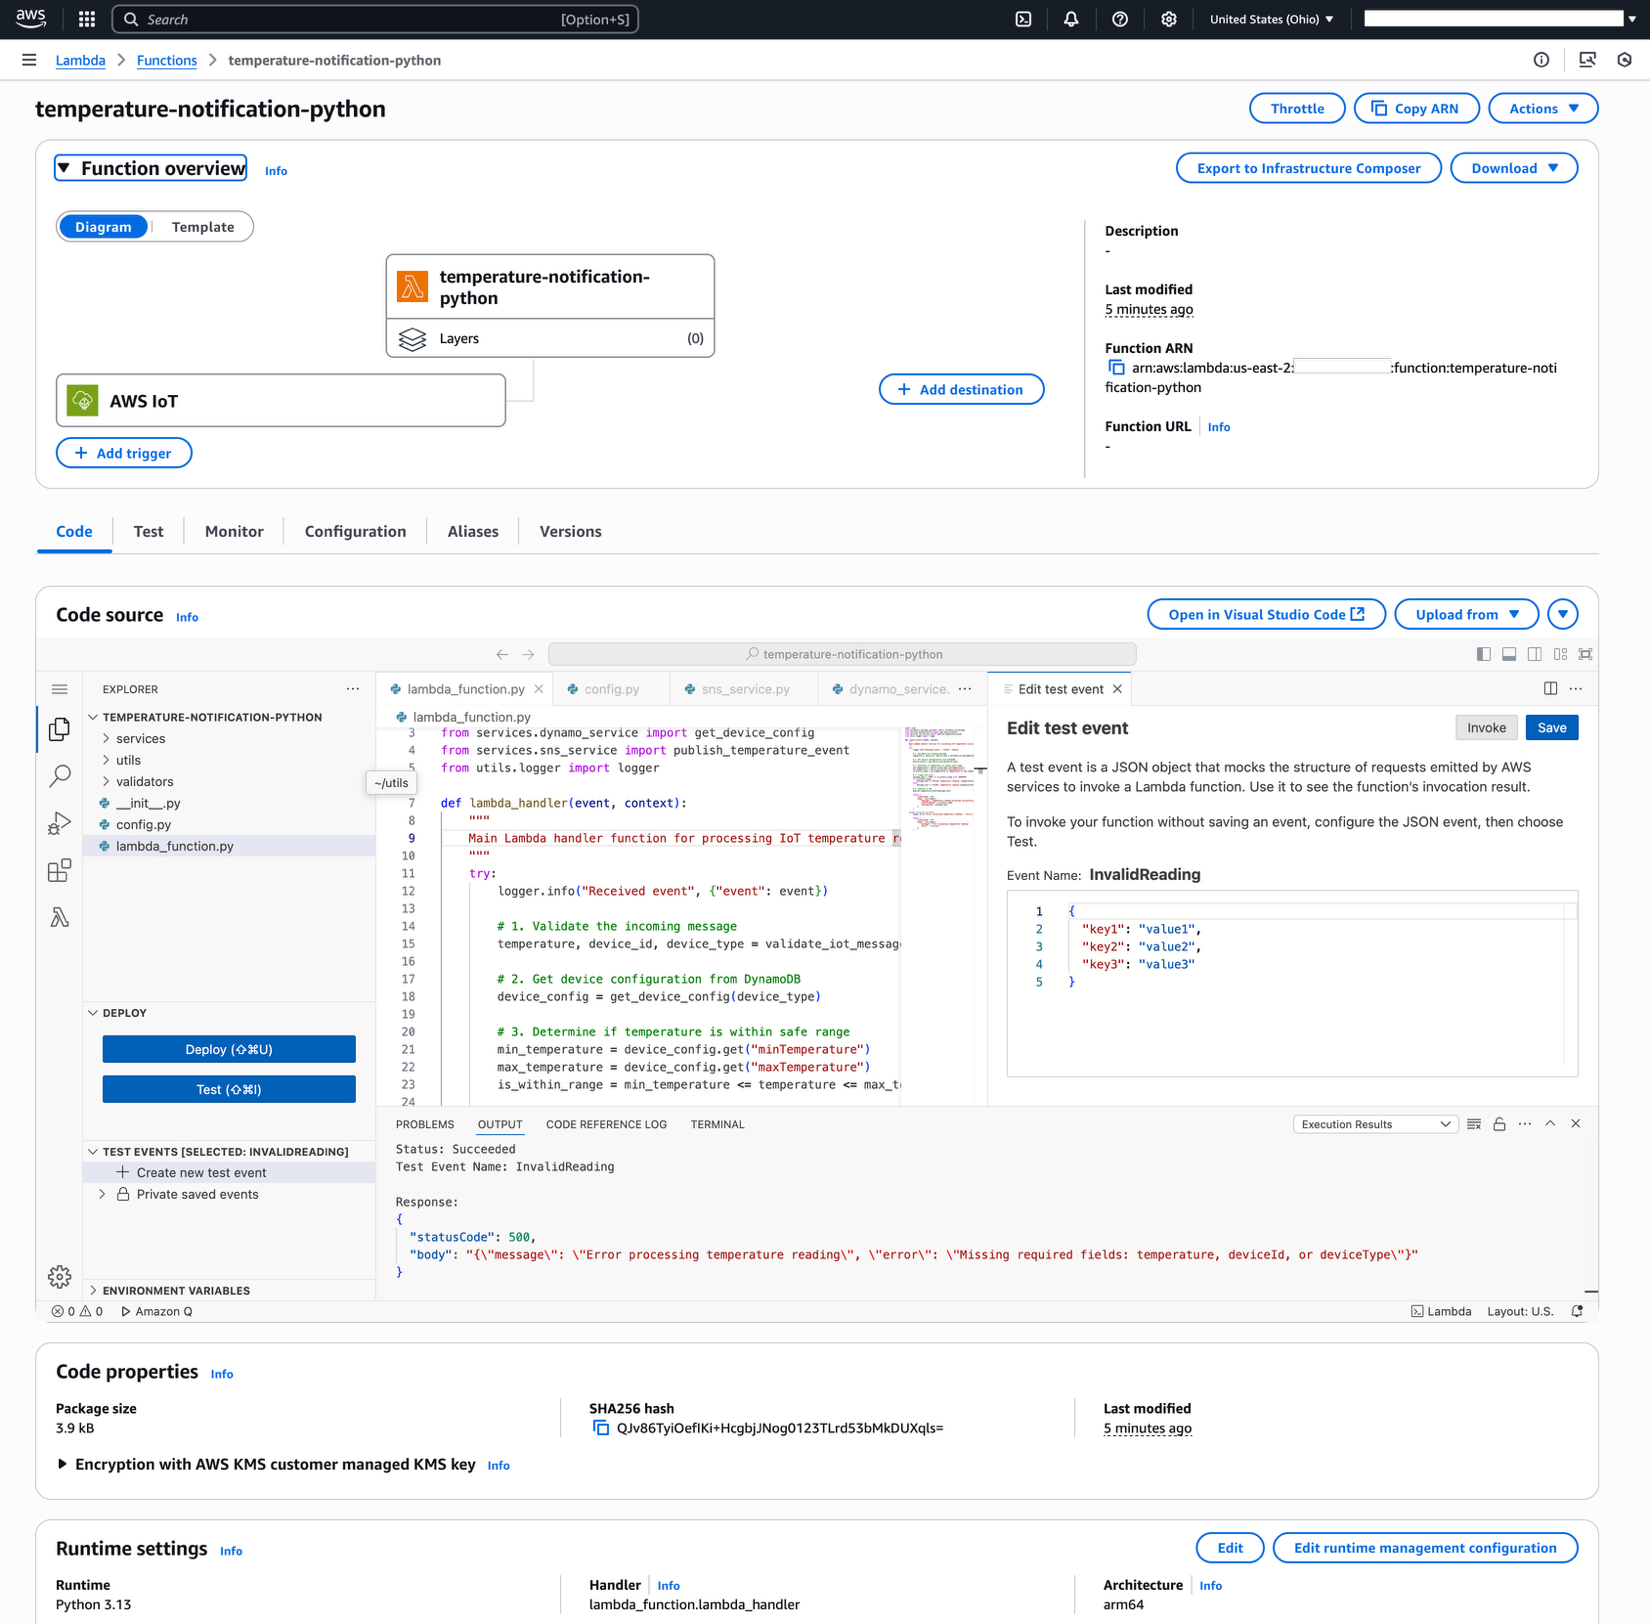
Figure 3: A Lambda function as seen in the console IDE
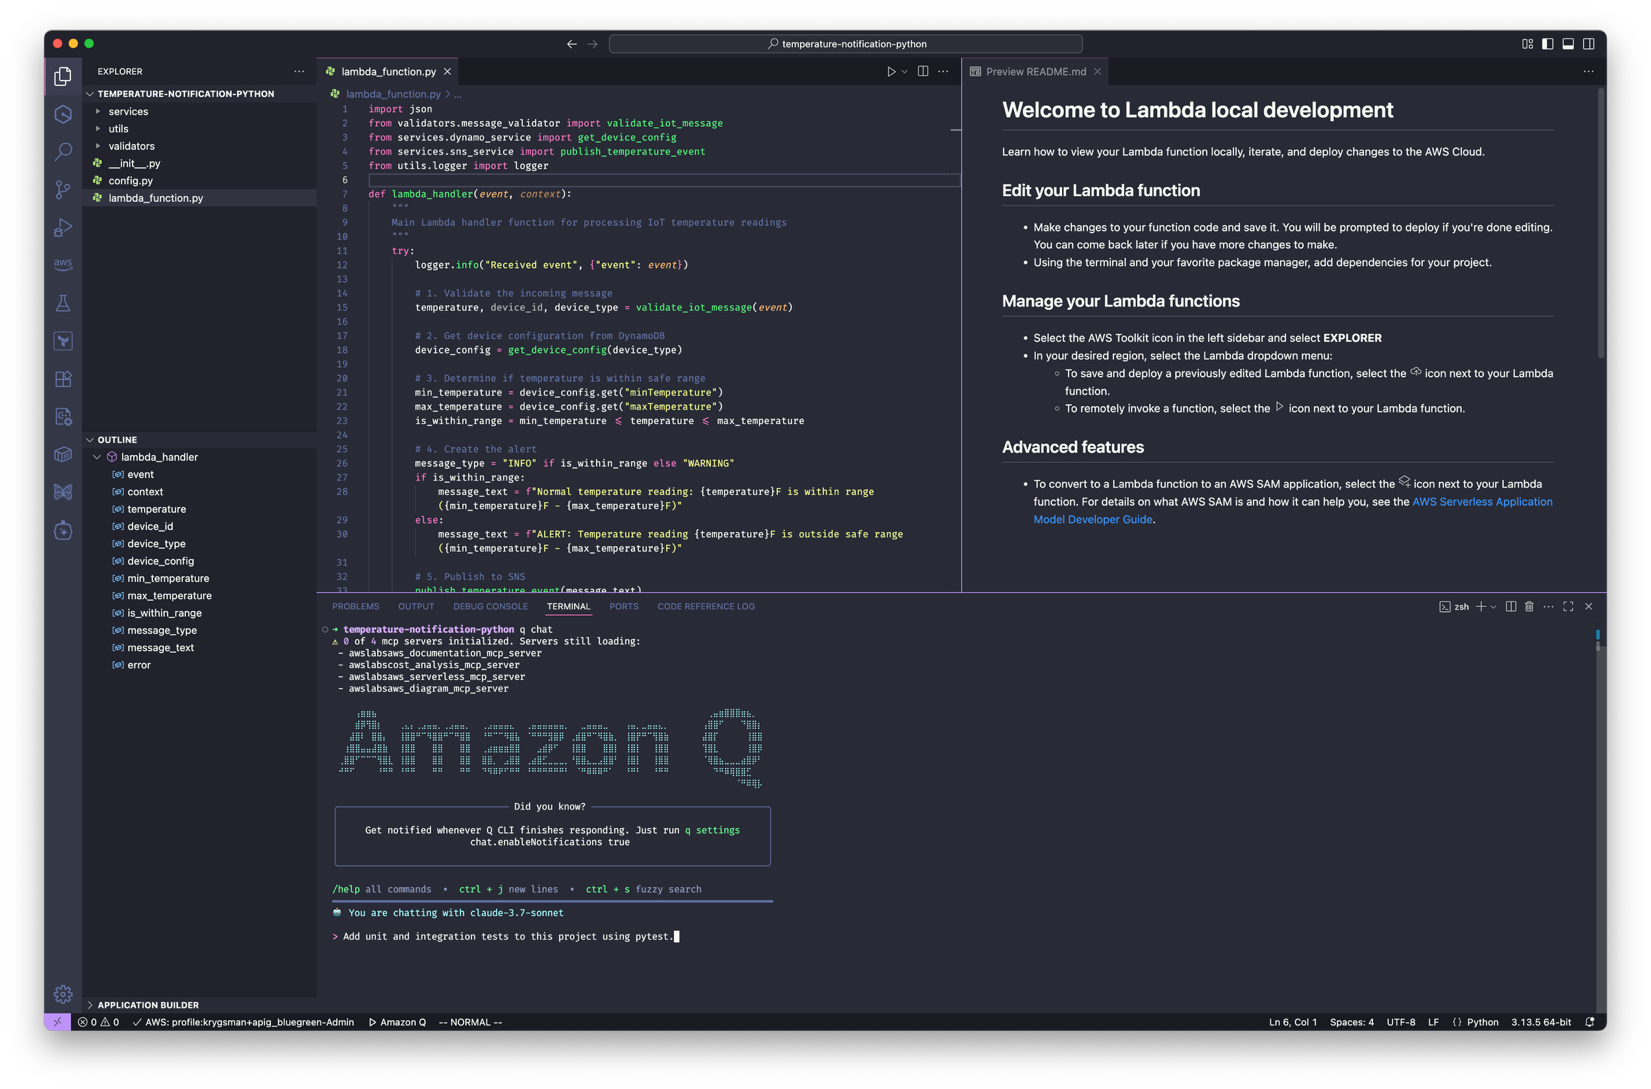
Figure 4: The same Lambda function as seen in a local IDE after Console to IDE export
By making it easy to transition inner loop development between cloud and local development environments, the console to IDE feature makes it easy to quickly scale an idea from proof-of-concept to a full-fledge serverless application. Visit the Lambda documentation to learn more.
Remote debugging
Developers building serverless applications with Lambda often need to test and debug cross-service integrations. While local debugging tools offer valuable capabilities, they do not fully replicate the Lambda runtime environment and its interactions with other AWS services, especially when dealing with Amazon Virtual Private Cloud (VPC) resources and AWS Identity and Access Management (IAM) permissions. Therefore, developers had to rely on print statements and verbose logging, and for complex scenarios they had to deploy their functions multiple times to diagnose and resolve issues. This process extended development cycles, particularly when troubleshooting issues specific to the production environment. Developers wished they could use advanced local development tools like debuggers to investigate issues with code running in Lambda functions deployed in the cloud.
Lambda’s new remote debugging feature now enables you to debug your functions running in the cloud directly from your local VS Code IDE using the AWS Toolkit extension. You can now debug the execution environment of the function running in the cloud in its IAM execution role’s security context with access to configured VPC resources, and trace execution through entire service flows in the cloud.
To start debugging, enable Remote debugging when invoking your function through the AWS Toolkit. Configure your local code path and payload and choose Remote Invoke. AWS Toolkit automatically adds an AWS-managed debugging Lambda layer to your function, extends the timeout, publishes a temporary version, and reverts the config change. AWS Toolkit then invokes the published debug version. You can then start debugging. This feature establishes a secure connection between your local debugger and the function running in the cloud using AWS IoT Secure Tunneling. When your debug session is finished, Lambda automatically removes the temporary function version. You can end your debug session explicitly. Otherwise, it will end automatically after 60 seconds of inactivity or when the Lambda function timeout is reached.
The following figure shows how setting a breakpoint in VS Code IDE during a remote debugging session pauses execution so that you can inspect the data with which the function running in the cloud is called, along with your function’s variables. You can continue to step forward from this point line-by-line to follow the function’s execution.
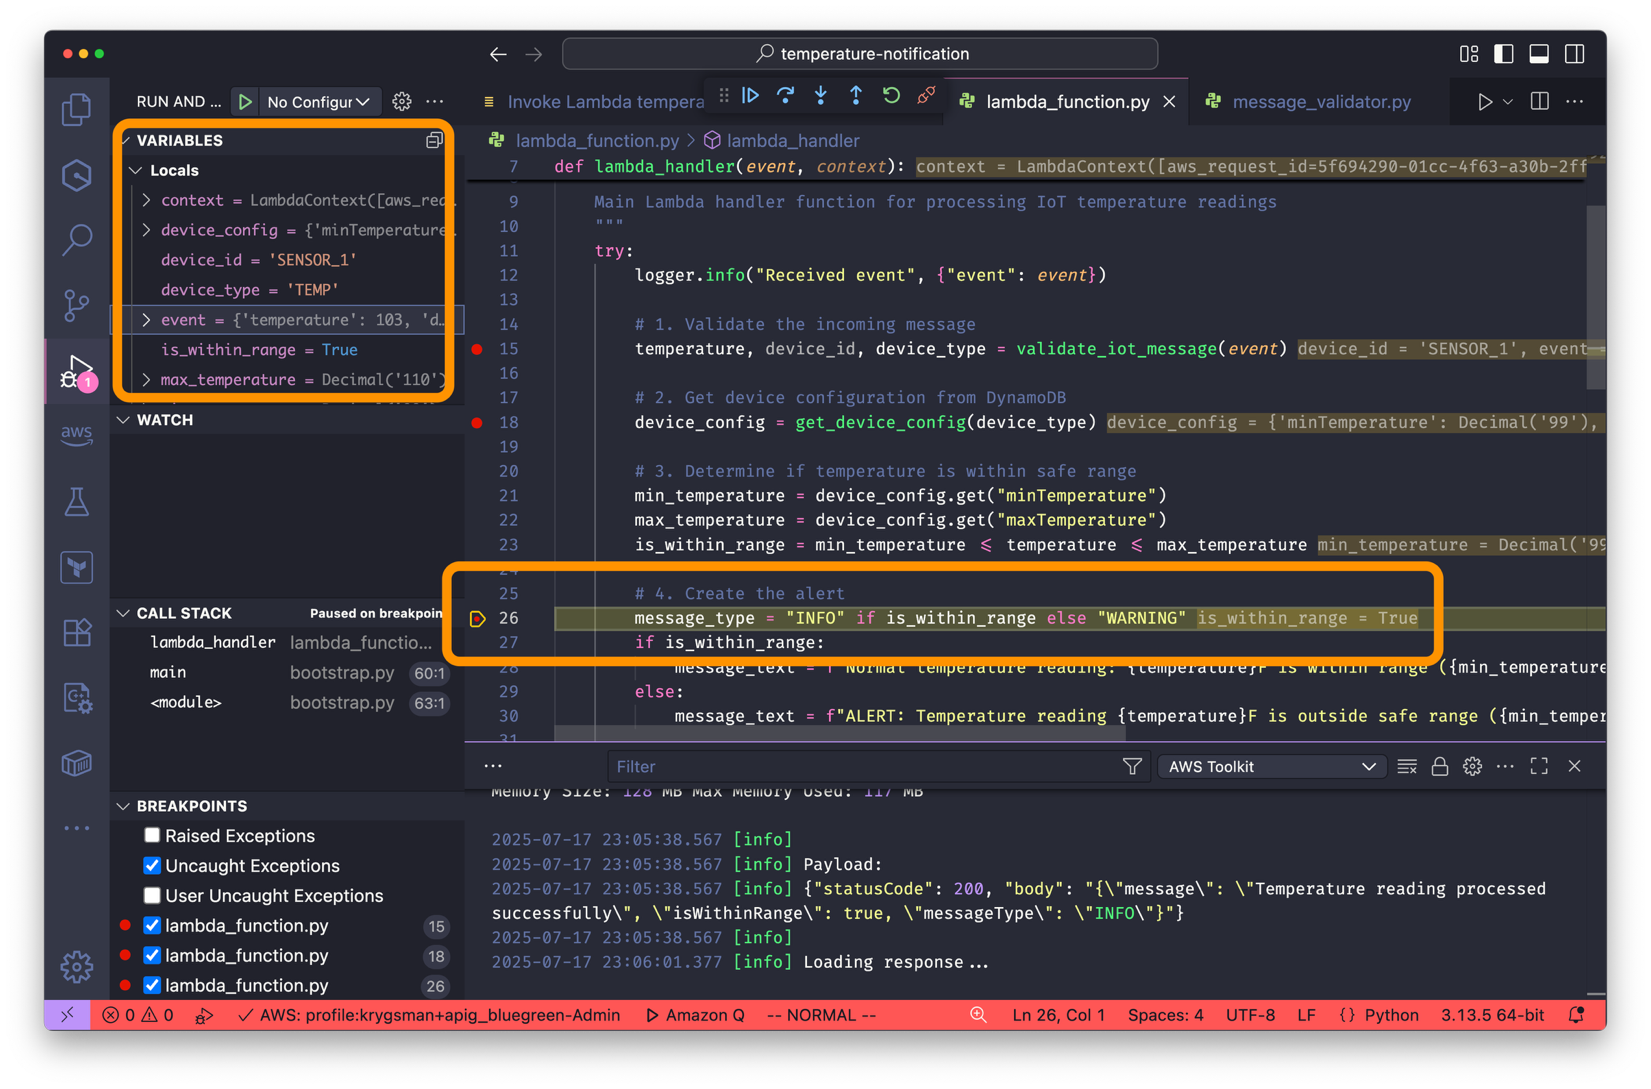
Figure 5: VS Code IDE debugger attached to execution environment of a Lambda function running in the cloud
All of this means that you don’t have to set up local emulators to approximate cloud behavior, manage complex test frameworks, or continuously capture expensive logs with TRACE-level detail to understand how your code executes. Your debugger can show you exactly what invocation parameters look like, such as event and context, when they reach your function handler. You can step through how your function behaves for different inputs and inspect variable values along the way. Since your code is running in the cloud, you can even see how your function’s IAM execution role affects its behavior. As you step through, you can immediately see when an AWS SDK service call fails due to lack of permissions.
Moreover, you can combine this with the console to IDE feature described previously in this post. When you’ve downloaded your function and scaffolded your local environment with console to IDE, you can debug the function as it runs in the cloud with remote debugging. This gives you much more visibility into the Lambda developer experience, which helps you find issues more easily, fix bugs quickly, and deliver new features rapidly. Follow the steps in the documentation to get started.
Best practices
Although the improved developer experience enables you to move faster when building serverless applications using Lambda, you should incorporate AWS-recommended best practices into your application development workflow.
For large or complex functions, refactor the code following the programming language norms so that developers and AI agents can better understand it. For example, move complex business logic, such as inventory calculations, out of the function handler into a separate module. Console to IDE allows you to use your local refactoring tools to refactor function code.
For isolated cost allocation and security boundaries between development and production, use separate AWS environments for different stages of your development process. You can use console to IDE to generate an AWS SAM template for your application with properties of your function and related AWS resources, which streamlines consistent cross-environment deployments. Then, you can then automate deployments of your template and function code with a CI/CD pipeline.
During development, you should test your functions in the cloud when you can. Remote debugging makes it easier to test functions running in the cloud from your local environment, allowing you to step through your code to validate logic and least-privilege function execution permissions. To optimize cost, focus on logging just enough to recreate problem scenarios, including necessary context about function execution, rather than logging everything you need to diagnose behavior. This also means that you have smaller log volumes to sift through.
You should recreate problem scenarios in an environment where you control the flow of input and can use remote debugging. When possible, you should use a development environment where there are no other sources of invokes. There’s a small window while remote debugging applies the temporary config change where other traffic to $LATEST might cause unexpected results, such as a slower cold start. By default, the debugger does not initialize when running on $LATEST. You should also use Aliases and Versions to explicitly pin environments to the appropriate version of a function, which avoids this problem and gives you more deterministic behavior along with the ability to do canary deployments.
Conclusion
The local development experience enhancements, including debugging workflows and IDE integrations, minimize the configuration and setup needed for developers to locally build serverless applications using Lambda. This enables developers to focus on building business logic. These enhancements also provide the rapid feedback loop developers need while making sure that their local environment accurately reflects cloud behavior.
AWS continues to streamline the local developer experience for serverless applications in areas such as local testing of service integrations, IaC workflows, troubleshooting capabilities, and using AI assistance more deeply in local development workflows. All of this helps developers build more efficient and secure serverless applications.
To get started with these new capabilities, visit the Lambda developer guide for detailed walkthroughs and best practices. Share your experiences and suggestions through the Lambda GitHub issues page to help shape the future of serverless developer experience.
For more serverless learning resources, visit Serverless Land. Likewise, check out this video from an AWS Community Builder showcasing the latest capabilities.
Accessing private Amazon API Gateway endpoints through custom Amazon CloudFront distribution using VPC Origins
Post Syndicated from Napoleone Capasso original https://aws.amazon.com/blogs/compute/accessing-private-amazon-api-gateway-endpoints-through-custom-amazon-cloudfront-distribution-using-vpc-origins/
Organizations can use Amazon CloudFront Virtual Private Cloud (VPC) Origins to deliver content from applications hosted in private subnets within Amazon VPC. Network traffic flows between Amazon CloudFront and Application Load Balancers (ALBs), Network Load Balancers (NLBs), or Amazon Elastic Compute Cloud (Amazon EC2) instances deployed within private subnets. This means that Amazon CloudFront can access both public and private Amazon Web Services (AWS) resources seamlessly.
This post demonstrates how you can connect CloudFront with a Private REST API in Amazon REST API Gateway using a VPC origin.
Overview
Organizations looking to enhance their application security and performance can find several key benefits in this architecture. You can use it to keep your APIs private and access them through CloudFront, implementing more security layers such as AWS Shield Advanced, geoblocking and TLSv1.3 support along with custom cipher suites. You can use this approach to engage the global CloudFront content delivery network while maintaining more control over the distribution.
Furthermore, you can enhance security controls through the built-in features of CloudFront, such as AWS WAF integration, custom SSL certificates, and field-level encryption. The VPC Origins feature eliminates any need to expose your internal resources to the public internet, which reduces your application’s potential attack surface.
Enterprises that need to maintain strict compliance requirements while delivering content globally can find this solution particularly valuable. Contain all traffic within the AWS private network to better meet your security and compliance objectives while still providing fast, reliable access to your applications.
Solution overview
You can set up CloudFront as the front door to your application and use VPC Origins integrated with an internal ALB to route traffic to Private Rest API through an execute-api VPC endpoint. All traffic between CloudFront and Private REST API remains within the AWS Private network.
The following figure provides an overview of the solution.
This diagram depicts three services running in an AWS account. The CloudFront distribution serves as the main entry point for the application. This distribution connects to an internal ALB using VPC Origins. The interface VPC endpoint execute-api is set as the target for the internal ALB to route requests to the Private Amazon API Gateway.
Solution deployment
To deploy this solution, follow the instructions in the GitHub repository and clone the repository.
The solution can be deployed in any AWS Region. Make sure to have a valid SSL certificate in AWS Certificate Manager (ACM) in the us-east-1 Region for the CloudFront distribution. All other resources must be in the same Region.
Prerequisites
For this walkthrough, the following resources are needed:
- An Amazon VPC with at least 2 Private Subnets.
- A Public Hosted Zone in Amazon Route 53.
- A valid public SSL certificate in ACM in the us-east-1 Region for CloudFront and another certificate in the same Region as an ALB.
- A custom domain name, covered by the ACM certificate for CloudFront distribution.
These are the input parameters for the solution deployment.
Walkthrough
The AWS Serverless Application Model (AWS SAM) template from the sample GitHub repository creates a secure, private networking architecture that provides controlled access to an API Gateway through CloudFront. It provisions a private API Gateway with a VPC endpoint, an internal ALB, and a CloudFront distribution. The template establishes secure communication channels by implementing private networking components, configuring SSL certificates, and setting up Route53 DNS routing. It uses custom AWS Lambda resources to dynamically manage network interfaces and security group configurations, providing a robust and flexible infrastructure for private API access, as shown in the following figure.
Step 1: Create the CloudFront distribution and the VPC Origins
The solution creates a CloudFront distribution that enables wide range of HTTP clients by supporting HTTP2 and HTTP3, enhances your solution security by enforcing HTTPS-only traffic, and uses a custom domain with the user-provided SSL certificate.The internal ALB is configured as the origin for the CloudFront distribution, and it is created using the VPC Origins feature.
The VPC Origins references the internal ALB, and only supports HTTPS protocol.
When the VPC Origins is created, the custom resource Lambda function adds an inbound rule to the CloudFront VPC Origin security group to allow traffic only from the CloudFront prefix list in the chosen Region.
Step 2: Create the ALB
The internal ALB is configured with an HTTPS listener using the user-provided SSL certificate. This maintains the encryption of the traffic between CloudFront and the ALB.
The target group of the ALB points to the execute API VPC endpoint IP addresses. These IP addresses are fetched using a custom resource Lambda function.
The custom resource Lambda function fetches private IPs for given network interface IDs using the EC2 client and returns a dictionary with keys IP0 and IP1 values as the private IPs.
Furthermore, the Lambda function adds an inbound rule to the internal ALB security group to allow traffic from the VPC Origin security group.
Step 3: Create the VPC endpoint for Private API Gateway
The execute-api VPC Endpoint is configured to route traffic from the internal ALB to the Private API Gateway. Only VPC endpoints can resolve private endpoints and route traffic securely.
Step 4: Create the Private API Gateway Resource Policy
The Resource Policy set up on the Private API Gateway only allows traffic from the VPC endpoint placed within the user-defined VPC.
Testing
Fetch the CloudFront URL from the Outputs section of the deployed stack and test it by using the curl command or your web browser.
Conclusion
This post demonstrates how you can establish a secure architecture to access a Private REST API Gateway through a Private ALB, using Amazon CloudFront as the entry point for your application. The solution uses the CloudFront VPC Origins feature, a powerful capability that you can use to directly integrate CloudFront with resources that you host within your Amazon VPC. You can implement this architecture to significantly enhance your application’s security posture as you restrict access to your backend services and minimize the potential attack surface. This approach provides you with a robust and reliable method to protect your applications from unauthorized access while maintaining high availability and performance through the CloudFront global content delivery network.