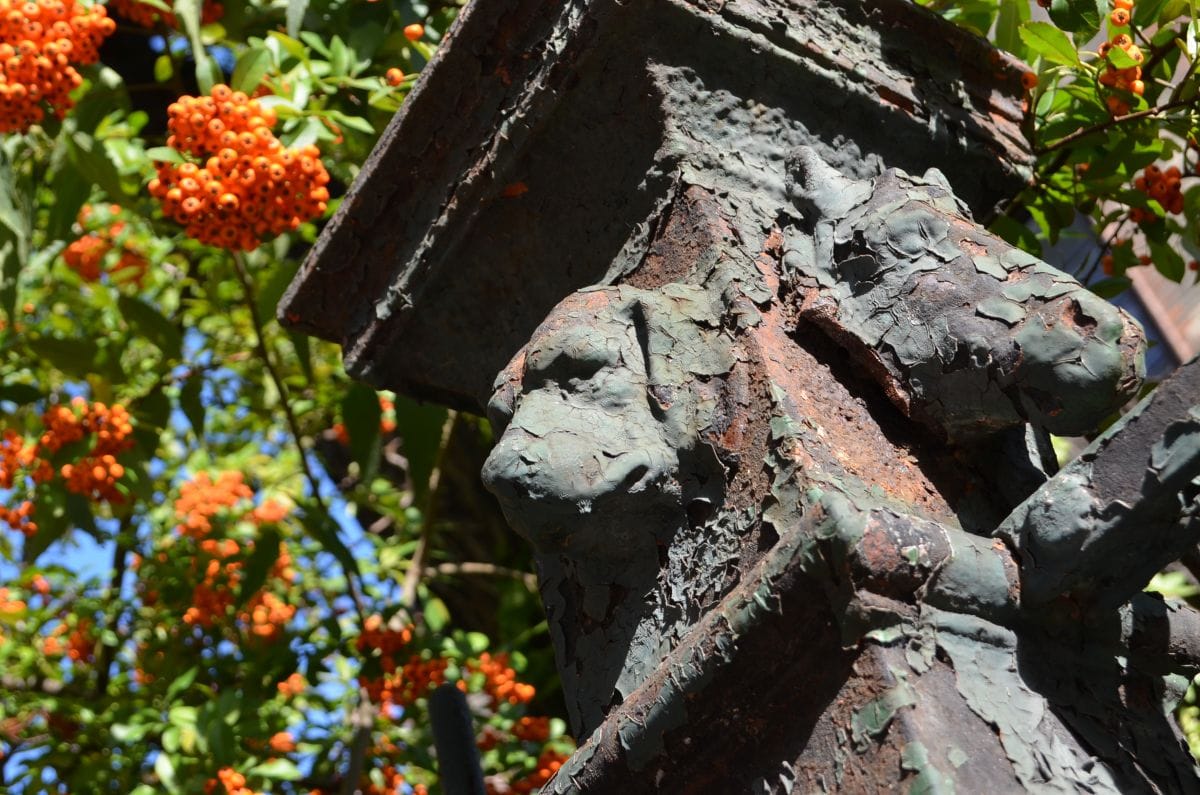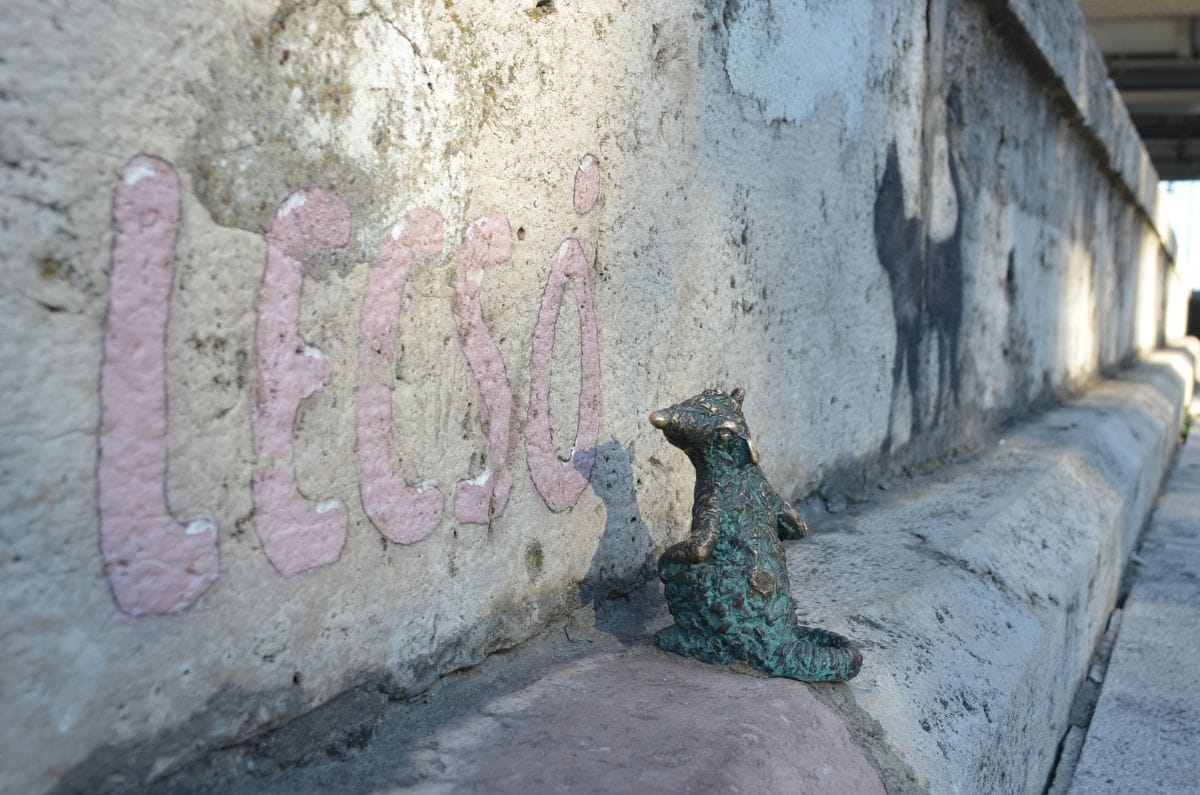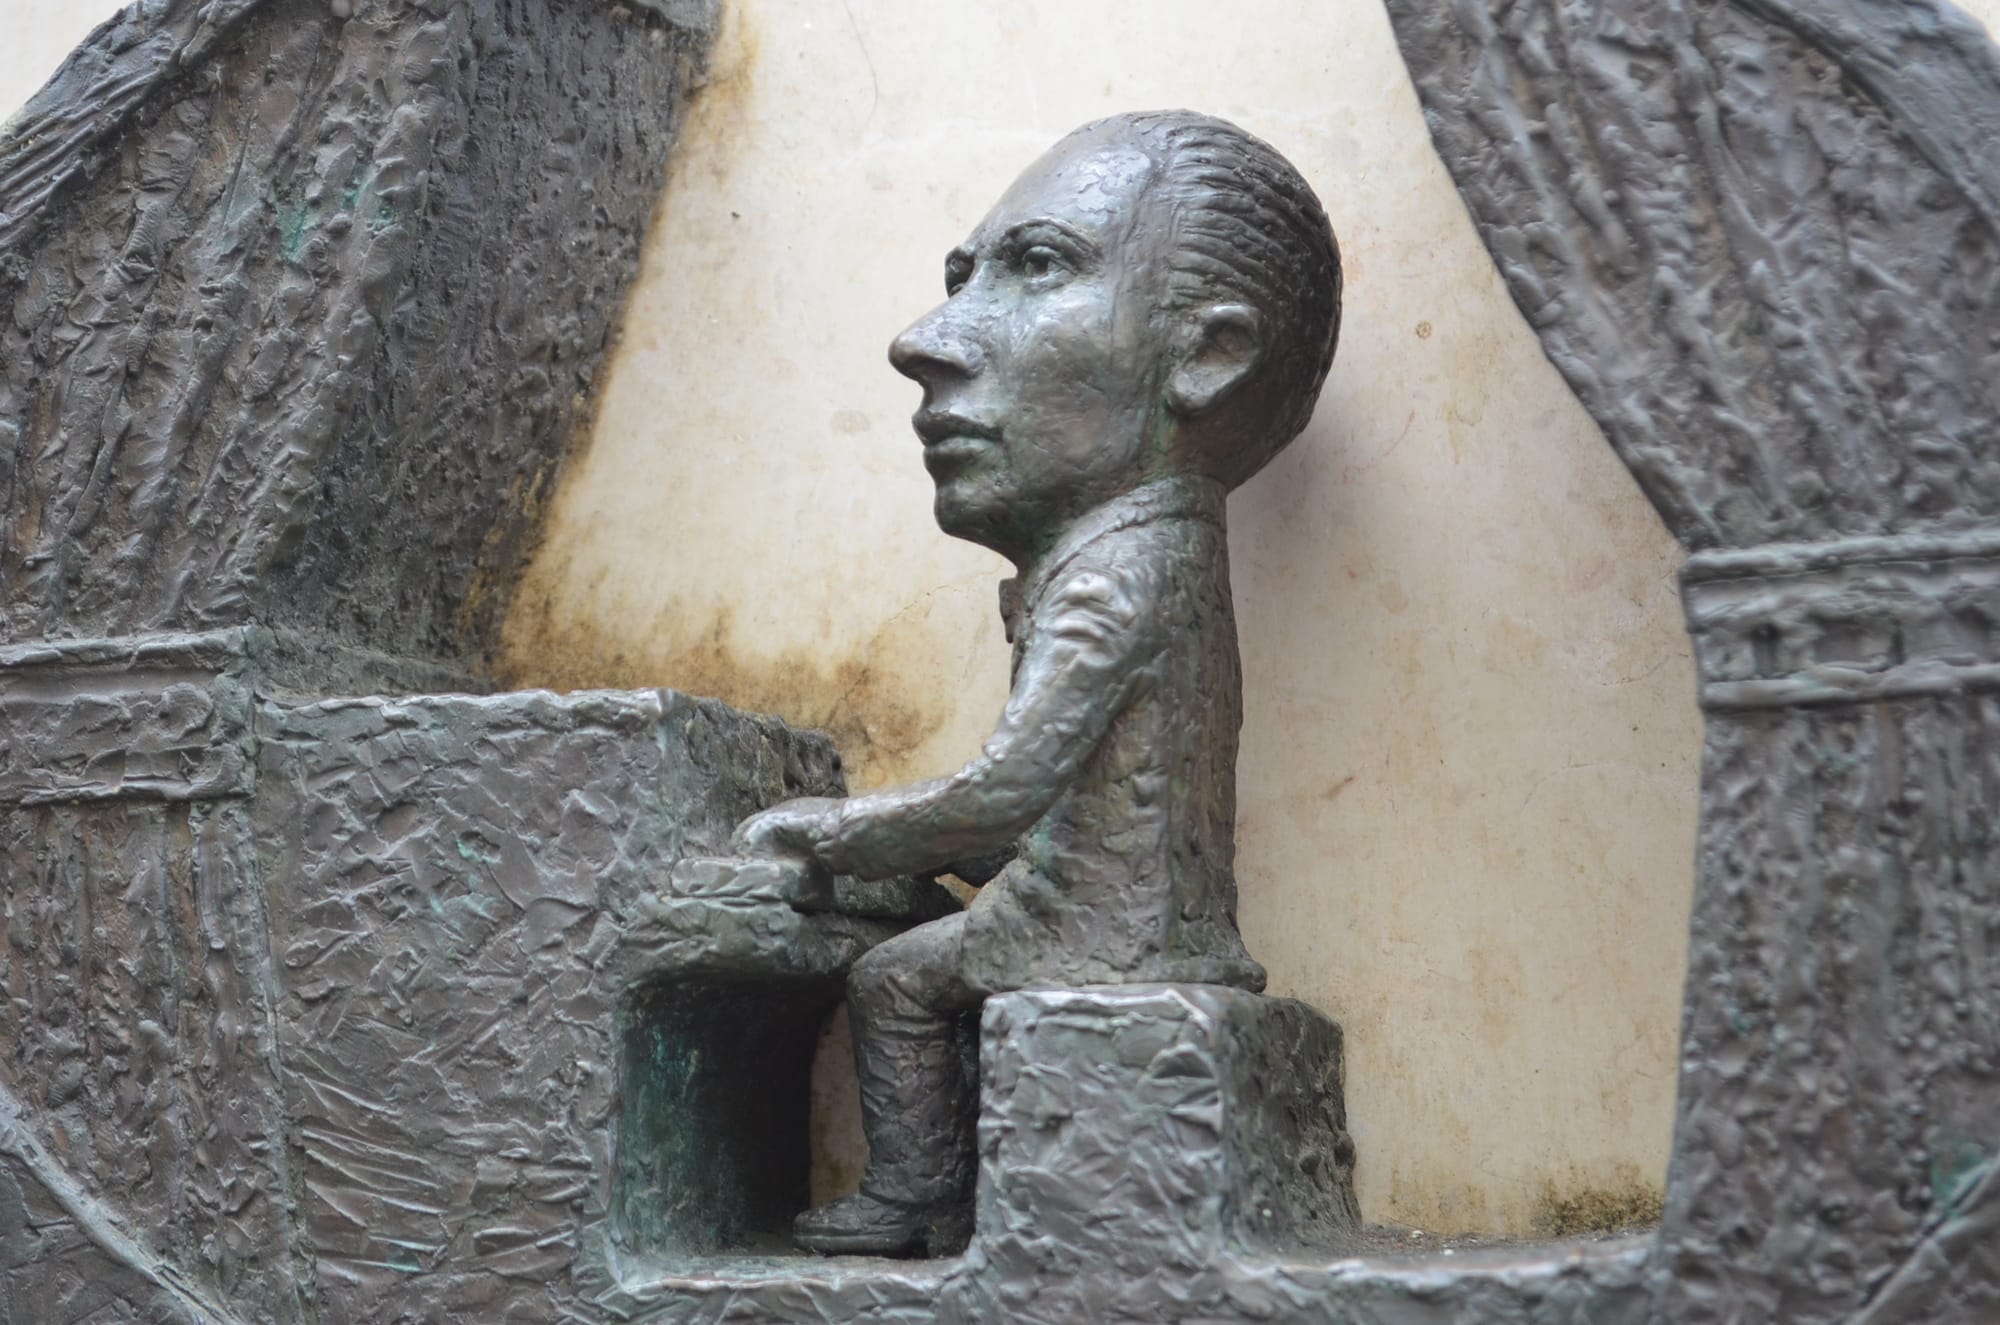На второ четене: „Родословно дърво“

Post Syndicated from Стефан Иванов original https://www.toest.bg/na-vtoro-chetene-rodoslovno-durvo/

„Родословно дърво“ от Мария Роса Лохо

На второ четене: „Родословно дърво“

превод от испански Елица Колева, София: изд. „ЖАР-Жанет Аргирова“, 2020

Това на пръв поглед е роман, който изглежда като семейна хроника, но постепенно се оказва нещо далеч по-сложно. Това е литературен опит да се мисли за паметта, идентичността и историята чрез фигурата на рода. В основата му стои простият, почти антропологичен въпрос доколко човек принадлежи на себе си и доколко е резултат от една верига от предходни животи, истории и митове. Още в началото разказвачката поставя този въпрос като своеобразна програма на текста. Родът не е единственото дърво, а цяла вселена от съдби, които се преплитат, отразяват и повтарят.

В този смисъл романът се движи по една граница, позната от големите семейни епоси на световната литература. Неговият генетичен код може да бъде проследен едновременно в европейската традиция на родовата хроника и в латиноамериканския магически реализъм. От европейската страна стои моделът на романи като „Буденброкови“ на Томас Ман, мащабна история на семейство, в която времето постепенно разрушава социалните и моралните структури на рода. При Ман родът е икономическа и културна институция, която се разпада под натиска на модерността. При Лохо обаче родът не се разпада толкова, колкото се разклонява и митологизира. Той не е буржоазна институция, а почти природен феномен, нещо като биологична джунгла от характери, странности и съдби.

Тук се появява и другият важен литературен паралел, традицията на латиноамериканската фамилна сага, чийто най-емблематичен пример е „Сто години самота“ на Габриел Гарсия Маркес. В романа на Маркес родът Буендия живее в пространство, където историята, митът и магията са почти неразличими. Подобна атмосфера се усеща и при Лохо, макар и в по-тиха и по-иронична форма. Историите за предците, за урочасани жени, мистични свещеници и своенравни матриарси звучат едновременно като семейни анекдоти и като фолклорни легенди. В тях реалността постоянно се плъзга към фантастичното. Например разказът за Маруха може да бъде прочетен и като история за психическо страдание, и като легенда за магическо проклятие.

Тази двусмисленост е една от най-интересните стратегии на романа. Той не се опитва да обясни света рационално, но и не настоява на магическото. Вместо това оставя читателя в едно пространство на колебание, където суеверието, религията и психологията съществуват едновременно. В този смисъл романът се родее и с творчеството на Уилям Фокнър, където историята на рода също се разказва чрез фрагменти, слухове и полузабравени истории. И при Фокнър, и при Лохо

родовата памет се оказва ненадежден архив, нещо средно между документ и мит.

Особено силна линия в романа е образът на жените, които се оказват истинските носители на родовата енергия. Докато официалната история обикновено поставя мъжете в центъра и те са войници, свещеници, политически фигури, то семейната история на Лохо постепенно разкрива, че именно жените са архитектите на рода. Прапрабабата Мария Антония е почти легендарна фигура, дребна, но властна жена, която управлява имота си с твърда ръка, стреля по бирници и раздава жито на бедните.

Този образ може да бъде поставен в интересен диалог с други литературни матриарси. Той напомня например на Урсула от „Сто години самота“, но и на героините на Федерико Гарсия Лорка, особено в „Къщата на Бернарда Алба“. При Лорка женската власт е едновременно трагична и жестока, тя съществува в рамките на патриархалния ред, но често се превръща в негово най-строго продължение. Подобно напрежение се усеща и в романа на Лохо. Жените са подчинени на социалните правила, но същевременно са тези, които ги налагат и поддържат.
На второ четене: „Родословно дърво“

Повествователната структура на книгата също е показателна за нейния постмодерен характер. Разказвачката постоянно напомня, че много от историите са непълни, откъслечни или предадени чрез слухове. Родът е архив на устната традиция, която се променя с всяко ново поколение. Тук романът влиза в диалог с писатели като Хорхе Луис Борхес и В. Г. Зебалд, които също превръщат паметта в литературен лабиринт. При Борхес миналото често се оказва мрежа от въображаеми текстове, а при Зебалд е архив от отломки, снимки и полуизчезнали истории. „Родословно дърво“ използва сходна техника и семейната памет се превръща в своеобразна библиотека от призрачни разкази.

В исторически план романът проследява и миграцията, един от големите процеси на модерността. Галисийците, които напускат Испания и се отправят към Южна Америка, са част от огромна вълна от европейски емигранти в края на XIX и началото на XX век. За тях Аржентина е обещание за нов живот, но и пространство, в което старата идентичност постепенно се размива. В този аспект книгата може да бъде сравнена с литературата на изгнанието, например с творчеството на Владимир Набоков или Милан Кундера, макар контекстът да е различен. И при тях миграцията създава чувство за раздвоена принадлежност, човек никога не е напълно у дома си нито в старата, нито в новата страна.

Тази тема има особено силен отзвук, ако се опитаме да прочетем романа през перспективата на съвременността. В началото на XXI век идеята за родословие преживява своеобразен ренесанс благодарение на генетичните тестове, дигиталните архиви и социалните мрежи. Хиляди хора по света се опитват да реконструират семейната си история чрез ДНК анализи и генеалогични бази данни. Романът на Лохо обаче подсказва нещо, което тези технологии често забравят.

Произходът е разказ. Гените могат да покажат откъде идват телата ни, но не могат да възстановят историите, които са изградили нашата идентичност.

Тук се появява и един любопитен паралел с българската действителност. Галисийският свят, описан в романа – суров, селски, белязан от бедност и силни семейни структури – изненадващо напомня на българското село от началото на XX век. И в двата случая виждаме общество, в което религиозните вярвания, суеверията и семейната солидарност играят решаваща роля. Болестите се обясняват чрез магия или проклятие, а социалният ред се поддържа чрез авторитета на рода.

Разликата е, че за галисийците голямото бягство е към Америка, докато за българите през последните десетилетия посоката е към Западна Европа. Но логиката е сходна. Икономическата периферия изтласква хората навън, а семейните истории се разкъсват между различни континенти. В този смисъл романът на Лохо може да бъде прочетен и като своеобразно огледало на съвременната демографска съдба на България – страна, в която милиони семейни истории също са разделени между различни държави.

Най-ироничният и може би най-философски момент в книгата е начинът, по който тя се отнася към самата идея за родословие. От една страна, родът е представен като мощна сила, нещо, което определя характера, съдбата и дори странностите на героите. От друга страна, самият разказ показва колко хаотична и случайна е тази система. Родословното дърво се оказва борхесов лабиринт от истории, в който всяко поколение се опитва да открие някакъв смисъл.

Така книгата постепенно се превръща в роман не толкова за миналото, колкото за нашия начин да го разказваме. Родът е литературна конструкция, история, която постоянно се пренаписва. И ако книгата оставя някакъв философски извод, той също е леко ироничен. Човек може да търси корените си безкрайно, но накрая неизбежно открива, че

всяко родословно дърво е съставено от паднали клони, пропуснати истории и няколко упорити легенди, които семейството отказва да забрави.


Никой от нас не чете единствено най-новите книги. Тогава защо само за тях се пише? „На второ четене“ е рубрика, в която отваряме списъците с книги, публикувани преди поне година, четем ги и препоръчваме любимите си от тях. За нея медията „Тоест“ е отличена с Националната награда „Христо Г. Данов“ (2025) за принос в представянето на българската книга.

Рубриката е част от партньорската програма Читателски клуб „Тоест“, благодарение на която активните дарители на „Тоест“ получават 20% отстъпка от коричната цена на всички книги на включените издателства. Изборът на заглавия обаче е единствено на авторите Стефан Иванов, Севда Семер и Антония Апостолова, които биха ви препоръчали тези книги и ако имаше как да се разходите с тях в книжарницата. 
Powering the agents: Workers AI now runs large models, starting with Kimi K2.5

Post Syndicated from Michelle Chen original https://blog.cloudflare.com/workers-ai-large-models/

We’re making Cloudflare the best place for building and deploying agents. But reliable agents aren’t built on prompts alone; they require a robust, coordinated infrastructure of underlying primitives.

At Cloudflare, we have been building these primitives for years: Durable Objects for state persistence, Workflows for long running tasks, and Dynamic Workers or Sandbox containers for secure execution. Powerful abstractions like the Agents SDK are designed to help you build agents on top of Cloudflare’s Developer Platform.

But these primitives only provided the execution environment. The agent still needed a model capable of powering it. 

Starting today, Workers AI is officially in the big models game. We now offer frontier open-source models on our AI inference platform. We’re starting by releasing Moonshot AI’s Kimi K2.5 model on Workers AI. With a full 256k context window and support for multi-turn tool calling, vision inputs, and structured outputs, the Kimi K2.5 model is excellent for all kinds of agentic tasks. By bringing a frontier-scale model directly into the Cloudflare Developer Platform, we’re making it possible to run the entire agent lifecycle on a single, unified platform.

The heart of an agent is the AI model that powers it, and that model needs to be smart, with high reasoning capabilities and a large context window. Workers AI now runs those models.

The price-performance sweet spot

We spent the last few weeks testing Kimi K2.5 as the engine for our internal development tools. Within our OpenCode environment, Cloudflare engineers use Kimi as a daily driver for agentic coding tasks. We have also integrated the model into our automated code review pipeline; you can see this in action via our public code review agent, Bonk, on Cloudflare GitHub repos. In production, the model has proven to be a fast, efficient alternative to larger proprietary models without sacrificing quality.

Serving Kimi K2.5 began as an experiment, but it quickly became critical after reviewing how the model performs and how cost-efficient it is. As an illustrative example: we have an agent that does security reviews of Cloudflare’s codebases. This agent processes over 7B tokens per day, and using Kimi, it has caught more than 15 confirmed issues in a single codebase. Doing some rough math, if we had run this agent on a mid-tier proprietary model, we would have spent $2.4M a year for this single use case, on a single codebase. Running this agent with Kimi K2.5 cost just a fraction of that: we cut costs by 77% simply by making the switch to Workers AI.

As AI adoption increases, we are seeing a fundamental shift not only in how engineering teams are operating, but how individuals are operating. It is becoming increasingly common for people to have a personal agent like OpenClaw running 24/7. The volume of inference is skyrocketing.

This new rise in personal and coding agents means that cost is no longer a secondary concern; it is the primary blocker to scaling. When every employee has multiple agents processing hundreds of thousands of tokens per hour, the math for proprietary models stops working. Enterprises will look to transition to open-source models that offer frontier-level reasoning without the proprietary price tag. Workers AI is here to facilitate this shift, providing everything from serverless endpoints for a personal agent to dedicated instances powering autonomous agents across an entire organization.

The large model inference stack

Workers AI has served models, including LLMs, since its launch two years ago, but we’ve historically prioritized smaller models. Part of the reason was that for some time, open-source LLMs fell far behind the models from frontier model labs. This changed with models like Kimi K2.5, but to serve this type of very large LLM, we had to make changes to our inference stack. We wanted to share with you some of what goes on behind the scenes to support a model like Kimi.

We’ve been working on custom kernels for Kimi K2.5 to optimize how we serve the model, which is built on top of our proprietary Infire inference engine. Custom kernels improve the model’s performance and GPU utilization, unlocking gains that would otherwise go unclaimed if you were just running the model out of the box. There are also multiple techniques and hardware configurations that can be leveraged to serve a large model. Developers typically use a combination of data, tensor, and expert parallelization techniques to optimize model performance. Strategies like disaggregated prefill are also important, in which you separate the prefill and generation stages onto different machines in order to get better throughput or higher GPU utilization. Implementing these techniques and incorporating them into the inference stack takes a lot of dedicated experience to get right. 

Workers AI has already done the experimentation with serving techniques to yield excellent throughput on Kimi K2.5. A lot of this does not come out of the box when you self-host an open-source model. The benefit of using a platform like Workers AI is that you don’t need to be a Machine Learning Engineer, a DevOps expert, or a Site Reliability Engineer to do the optimizations required to host it: we’ve already done the hard part, you just need to call an API.

Beyond the model — platform improvements for agentic workloads

In concert with this launch, we’ve also improved our platform and are releasing several new features to help you build better agents.

Prefix caching and surfacing cached tokens

When you work with agents, you are likely sending a large number of input tokens as part of the context: this could be detailed system prompts, tool definitions, MCP server tools, or entire codebases. Inputs can be as large as the model context window, so in theory, you could be sending requests with almost 256k input tokens. That’s a lot of tokens.

When an LLM processes a request, the request is broken down into two stages: the prefill stage processes input tokens and the output stage generates output tokens. These stages are usually sequential, where input tokens have to be fully processed before you can generate output tokens. This means that sometimes the GPU is not fully utilized while the model is doing prefill.

With multi-turn conversations, when you send a new prompt, the client sends all the previous prompts, tools, and context from the session to the model as well. The delta between consecutive requests is usually just a few new lines of input; all the other context has already gone through the prefill stage during a previous request. This is where prefix caching helps. Instead of doing prefill on the entire request, we can cache the input tensors from a previous request, and only do prefill on the new input tokens. This saves a lot of time and compute from the prefill stage, which means a faster Time to First Token (TTFT) and a higher Tokens Per Second (TPS) throughput as you’re not blocked on prefill.

Workers AI has always done prefix caching, but we are now surfacing cached tokens as a usage metric and offering a discount on cached tokens compared to input tokens. (Pricing can be found on the model page.) We also have new techniques for you to leverage in order to get a higher prefix cache hit rate, reducing your costs.

New session affinity header for higher cache hit rates

In order to route to the same model instance and take advantage of prefix caching, we use a new x-session-affinity header. When you send this header, you’ll improve your cache hit ratio, leading to more cached tokens and subsequently, faster TTFT, TPS, and lower inference costs.

You can pass the new header like below, with a unique string per session or per agent. Some clients like OpenCode implement this automatically out of the box. Our Agents SDK starter has already set up the wiring to do this for you, too.

curl -X POST \
"https://api.cloudflare.com/client/v4/accounts/{ACCOUNT_ID}/ai/run/@cf/moonshotai/kimi-k2.5" \
  -H "Authorization: Bearer {API_TOKEN}" \
  -H "Content-Type: application/json" \
  -H "x-session-affinity: ses_12345678" \
  -d '{
    "messages": [
      {
        "role": "system",
        "content": "You are a helpful assistant."
      },
      {
        "role": "user",
        "content": "What is prefix caching and why does it matter?"
      }
    ],
    "max_tokens": 2400,
    "stream": true
  }'

Redesigned async APIs

Serverless inference is really hard. With a pay-per-token business model, it’s cheaper on a single request basis because you don’t need to pay for entire GPUs to service your requests. But there’s a trade-off: you have to contend with other people’s traffic and capacity constraints, and there’s no strict guarantee that your request will be processed. This is not unique to Workers AI — it’s evidently the case across serverless model providers, given the frequent news reports of overloaded providers and service disruptions. While we always strive to serve your request and have built-in autoscaling and rebalancing, there are hard limitations (like hardware) that make this a challenge.

For volumes of requests that would exceed synchronous rate limits, you can submit batches of inferences to be completed asynchronously. We’re introducing a revamped Asynchronous API, which means that for asynchronous use cases, you won’t run into Out of Capacity errors and inference will execute durably at some point. Our async API looks more like flex processing than a batch API, where we process requests in the async queue as long as we have headroom in our model instances. With internal testing, our async requests usually execute within 5 minutes, but this will depend on what live traffic looks like. As we bring Kimi to the public, we will tune our scaling accordingly, but the async API is the best way to make sure you don’t run into capacity errors in durable workflows. This is perfect for use cases that are not real-time, such as code scanning agents or research agents.

Workers AI previously had an asynchronous API, but we’ve recently revamped the systems under the hood. We now rely on a pull-based system versus the historical push-based system, allowing us to pull in queued requests as soon as we have capacity. We’ve also added better controls to tune the throughput of async requests, monitoring GPU utilization in real-time and pulling in async requests when utilization is low, so that critical synchronous requests get priority while still processing asynchronous requests efficiently.

To use the asynchronous API, you would send your requests as seen below. We also have a way to set up event notifications so that you can know when the inference is complete instead of polling for the request. 

// (1.) Push a request in queue
// pass queueRequest: true
let res = await env.AI.run("@cf/moonshotai/kimi-k2.5", {
  "requests": [{
    "messages": [{
      "role": "user",
      "content": "Tell me a joke"
    }]
  }, {
    "messages": [{
      "role": "user",
      "content": "Explain the Pythagoras theorem"
    }]
  }, ...{<add more requests in a batch>} ];
}, {
  queueRequest: true,
});


// (2.) grab the request id
let request_id;
if(res && res.request_id){
  request_id = res.request_id;
}
// (3.) poll the status
let res = await env.AI.run("@cf/moonshotai/kimi-k2.5", {
  request_id: request_id
});

if(res && res.status === "queued" || res.status === "running") {
 // retry by polling again
 ...
}
else 
 return Response.json(res); // This will contain the final completed response 

Try it out today

Get started with Kimi K2.5 on Workers AI today. You can read our developer docs to find out model information and pricing, and how to take advantage of prompt caching via session affinity headers and asynchronous API. The Agents SDK starter also now uses Kimi K2.5 as its default model. You can also connect to Kimi K2.5 on Workers AI via Opencode. For a live demo, try it in our playground.

And if this set of problems around serverless inference, ML optimizations, and GPU infrastructure sound  interesting to you — we’re hiring!


Google details new 24-hour process to sideload unverified Android apps (Ars Technica)

Post Syndicated from corbet original https://lwn.net/Articles/1063735/

Ars Technica describes
the ritual
that will be required before a future Android device will
deign to install apps from somewhere other than the Play Store. It is not
for the impatient.

Here are the steps:

  • Enable developer options by tapping the software build number in About
    Phone seven times
  • In Settings > System, open Developer Options and scroll down to
    “Allow Unverified Packages.”
  • Flip the toggle and tap to confirm you are not being coerced
  • Enter device unlock code
  • Restart your device
  • Wait 24 hours
  • Return to the unverified packages menu at the end of the security delay
  • Scroll past additional warnings and select either “Allow temporarily”
    (seven days) or “Allow indefinitely.”
  • Check the box confirming you understand the risks.
  • You can now install unverified packages on the device by tapping the
    “Install anyway” option in the package manager.

Neoclouds Are Winning on Compute. Storage Shouldn’t Slow Them Down.

Post Syndicated from David Johnson original https://www.backblaze.com/blog/neoclouds-are-winning-on-compute-storage-shouldnt-slow-them-down/

A decorative image showing servers, the cloud, and drives.

Neoclouds are having a moment.

As demand for AI infrastructure keeps climbing, a new wave of providers is proving there’s real appetite for something other than the traditional hyperscaler model. They’re moving fast, specializing deeply, and building strong businesses around the layers that matter most to their customers: GPU access, high-performance compute, AI services, and developer experience.

That momentum is real, as is the next bottleneck. For many neoclouds, the challenge is no longer just how to deliver more compute. It’s how to deliver a more complete platform without taking on all the complexity of becoming a full-stack cloud provider. And that usually brings teams to the same question: Sshould we build our own storage layer?

Key points: Why should neoclouds care about specialized storage?

  • Neoclouds are capturing a major market opportunity by specializing in compute, AI, and high-performance infrastructure instead of trying to replicate the hyperscaler model. But without an independent, S3 compatible storage layer, many providers run into a split-stack problem: compute lives on the neocloud while data stays in a major cloud, bringing egress fees, friction, and architectural sprawl.
  • Teams that decide to build storage themselves often underestimate what that really means. Whether the path is open-source software like Ceph or purpose-built hardware, the result is often the same: Slower execution, more operational burden, and less focus on the product that actually differentiates the business.
  • The stronger strategy is to treat storage as a specialized tech stack layer and intentionally partner to solve the need, so internal teams can stay focused on compute, AI services, and customer experience.
  • Backblaze gives neoclouds an S3 compatible object storage backbone that can be integrated quickly, scaled immediately, and delivered without the overhead of building and operating storage from scratch.

The real neocloud opportunity is specialization

The shift toward neoclouds is really a shift toward specialization.

For years, the default assumption in cloud infrastructure was that the winning model looked like a hyperscaler: Build the entire stack, own every layer, and expand horizontally into as many services as possible. That model produced scale, but it also produced operational sprawl, complexity, and costs that many customers are increasingly motivated to avoid.

Neoclouds are succeeding because they’re taking the opposite path. Instead of trying to be everything to everyone, they’re building best-of-breed platforms around targeted workloads and high-value services. That’s especially true in AI, where performance, cost control, and speed matter more than a long menu of loosely related products.

But the closer a neocloud gets to becoming a full platform, the more pressure it faces to solve for storage.

The split-stack problem gets expensive

Without integrated object storage, customers often end up in a split-stack architecture. They run compute on a neocloud, but keep their data parked in a major cloud provider, which creates problems quickly.

For example: Large training datasets, model checkpoints, and output artifacts have to move across environments, costs become harder to predict, egress charges start to shape architecture decisions, and performance can suffer when storage and compute are no longer designed to work together.

At that point, storage becomes a core requirement for offering a platform that feels complete, efficient, and economically viable.

So teams ask the obvious question: should we build it ourselves?

Building storage usually means building a second company inside your company

This is where the conversation often gets framed too narrowly.

On paper, the decision can look straightforward: deploy open-source software such as Ceph, or design purpose-built hardware for tighter control over performance and economics.

In reality, both paths create the same strategic problem. They pull engineering focus away from your core platform and into a long-term storage business you never actually meant to start.

That matters because storage is not just infrastructure. It is an operating discipline. It comes with its own tuning, scaling, durability trade-offs, support burden, procurement risk, migration complexity, and day-two operational entropy.

Once you build it, you own all of it.

The software trap: Ceph is open source, not low overhead

Ceph is often the default option for teams exploring S3 compatible storage because it appears flexible, proven, and relatively accessible on commodity hardware.

And to be clear, Ceph can be powerful. But there’s a big difference between deploying Ceph and running it well at scale.

In production, Ceph demands specialized expertise. Teams have to manage CRUSH maps, OSD tuning, replication behavior, rebalancing events, and the network impact that comes with those changes. Those are not occasional tasks. They are part of the ongoing operational load.

That burden grows as environments get larger and more performance-sensitive.

For AI and high-performance compute use cases, generic Ceph deployments can also become throughput bottlenecks. When storage ceilings start constraining training jobs or data-intensive workflows, the problem is no longer confined to the storage team. It starts affecting the value of your core compute offering.

And migration is rarely simple. Because data is distributed across the cluster in ways that are optimized for internal resilience, moving out of a Ceph environment can become a resource-heavy extraction exercise that introduces risk to live workloads.

So while Ceph may reduce license costs up front, it can create a much more expensive operational reality over time.

The hardware trap: more control, more rigidity

For some neocloud teams, custom storage hardware feels like the more strategic answer.

The logic is easy to understand: if storage is critical, why not optimize the hardware and software stack together and get more predictable performance?

The issue is that custom storage hardware rarely stays clean and predictable for long.

Supply chains change. Drive capacities shift. Components become harder to source consistently. Architectures designed around one hardware profile suddenly have to absorb another. This dynamic can leave teams paying for density they can’t fully use or reworking systems to accommodate equipment that wasn’t part of the original plan.

Durability management adds another layer of complexity. As systems age, parity strategies and erasure coding decisions may need to change to maintain reliability. That can reduce usable capacity, increase cost per terabyte, and trigger compute-intensive re-encoding processes at exactly the wrong time.

Then there’s the networking layer. At scale, object storage is not just disks and nodes. It also depends on a traffic management architecture capable of handling massive ingress and egress flows without introducing opaque failure points. Whether you build around open source components or buy expensive hardware appliances, you’re signing up for another category of highly specialized infrastructure work.

And all of that comes with a capital model that is harder to unwind. Hardware investments lock teams into depreciation cycles and planning assumptions that may not match where the market is headed next.

The strategic shift: own differentiation, not every layer

The most important shift here is not technical. It’s organizational.

At a certain point, the storage question becomes a question of where your best people should spend their time.

Should your engineers be tuning replication policies, planning hardware refreshes, and troubleshooting storage network behavior?

Or should they be improving the platform features your customers actually choose you for?

For most neoclouds, the answer is clear.

Their advantage comes from how well they deliver compute, how quickly they adapt to AI demand, how smooth their developer experience feels, and how effectively they help customers run modern workloads. That is where focus compounds. That is where differentiation lives.

Storage matters enormously, but that does not mean it has to be built in-house.

Storage works better as a specialized utility

The neocloud ecosystem works best when providers can connect to open, specialized layers instead of rebuilding the entire stack themselves.

When storage is treated as a utility rather than an internal R&D project, teams can move faster and stay aligned with what the business actually needs. They avoid procurement cycles, reduce operational overhead, and eliminate a category of complexity that would otherwise keep expanding over time.

Equally importantly, they can offer customers a more complete and coherent platform without forcing data to remain trapped in legacy cloud environments.

How Backblaze helps neoclouds move faster

Backblaze gives neoclouds an independent, S3-compatible object storage backbone that can plug into existing compute, AI, and container workflows without requiring a storage buildout from scratch.

That means teams can:

  • Integrate with existing tooling: Use a drop-in, API-compatible storage layer that works with existing workflows, SDKs, CLIs, and infrastructure tools.
  • Reduce operational burden: Offload the complexity of durability engineering, bit-rot protection, fleet management, and storage operations.
  • Avoid punitive egress economics: In Backblaze-powered and colocated partner environments, move data between compute and storage without the cost friction that often comes with major cloud architectures.
  • Scale immediately: Go from terabytes to exabytes without waiting on hardware procurement, deployment schedules, or expansion projects.
  • Keep teams focused: Direct engineering effort toward the product roadmap instead of a second internal storage program.

Backblaze also brings the underlying scale and performance neoclouds need to support modern AI and data-intensive workloads, including up to 1Tbps aggregate throughput, 11 nines of annual durability, a 99.9% uptime SLA, and enterprise security and compliance capabilities.

Build what matters

Neoclouds are winning because they know where to specialize.

That focus is their strength. It is also their opportunity.

The fastest path to a stronger platform is not to recreate every layer of the cloud stack. It is to build the parts that make your business distinct, then connect them to the right partners for the rest.

Storage is too important to ignore, but it is also too easy to underestimate.

If you want to move faster, serve customers better, and keep your roadmap centered on what makes your platform valuable, don’t turn storage into a distraction.

Build what matters. Let Backblaze handle the storage.Interested in learning how Backblaze supports neocloud platforms? Explore B2 Neo or talk with our team about building a more open, AI-ready storage architecture.

The post Neoclouds Are Winning on Compute. Storage Shouldn’t Slow Them Down. appeared first on Backblaze Blog | Cloud Storage & Cloud Backup

NVIDIA’s Vera CPU in Detail: High Perf Chip Takes Aim at Broader AI Server Market

Post Syndicated from Ryan Smith original https://www.servethehome.com/nvidias-vera-cpu-in-detail-high-perf-chip-takes-aim-at-broader-ai-server-market/

While NVIDIA is best known as a GPU company for obvious reasons, the company has now spent almost half of its existence trying to branch into the CPU market as well. From early forays into processor designs with Denver – and ambitions of x86 processors unrealized – through multiple generations of Tegra SoCs, and now […]

The post NVIDIA’s Vera CPU in Detail: High Perf Chip Takes Aim at Broader AI Server Market appeared first on ServeTheHome.

Preemptive and Proactive: An enhanced CNAPP available with Exposure Command

Post Syndicated from Joel Alcon original https://www.rapid7.com/blog/post/em-preemptive-proactive-enhanced-cnapp-available-exposure-command

Earlier this year, we made a significant announcement: Rapid7 partnered with ARMO to add AI-powered cloud application detection and response (CADR) – or cloud runtime security – to our cloud security portfolio. At the time, I published a blog highlighting this two-part approach for modern cloud security that combines preemptive exposure management (understanding the threats that could exist) with proactive runtime security (detecting the threats that are happening).

Today, we are thrilled to announce that this vision is fully realized and integrated with Rapid7 Exposure Command. For our customers, this milestone represents our ability to deliver on the promise of a complete Cloud-Native Application Protection Platform (CNAPP) that helps security teams preemptively identify and proactively thwart attacks.

Exploring the possibilities of this unified CNAPP

At Rapid7, we believe that a CNAPP is unified if it operates from a single, objective source of truth. By integrating cloud runtime security directly into Exposure Command, we are seamlessly merging the preemptive (posture, configurations, identities, and vulnerabilities) with the proactive (runtime behavior and active threats). The table below summarizes this enhancement:

⠀

Today’s Rapid7 Cloud Security solution

What cloud runtime adds

Primary Focus

Prevention, risk reduction, and preemptive response

Real-time exposure detection and proactive response

Core Question

“What is vulnerable and could be attacked?”

“Is an attacker exploiting our environment now?”

Lifecycle Stage 

Pre-deployment, continuous scanning, or periodic intervals

Continuous monitoring of live (in-production) workloads

What It Finds

Misconfigurations, exposed secrets, software CVEs, missing patches

Active exploits, lateral movement, unauthorized process execution, SQL injection

⠀

The true power of this unified architecture is best understood through the lens of a security practitioner’s daily battle against cloud threats. The previous blog post discussed this in theory; let’s use this blog to talk about the reality.

The baseline

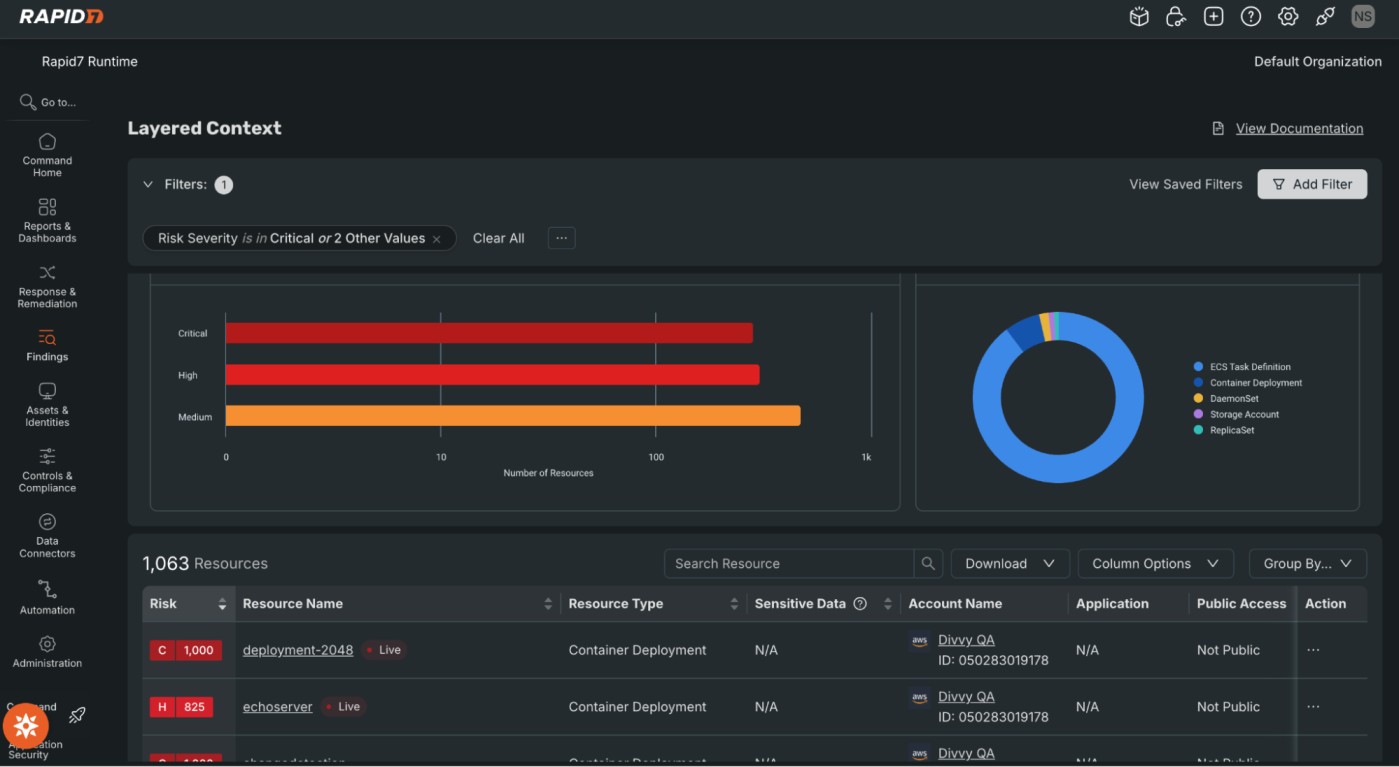
Exposure Command continuously scans and assesses your cloud posture to identify whether a container exposure exists in a production cluster. Traditional scanners would stop here, leaving you to prioritize this vulnerability against others. In Exposure Command, this detection is not just part of a static score, but instead it is part of an attack path. Our preemptive security platform tells you, for instance, whether this specific container has internet access and an over-privileged IAM role, making it highly reachable and exploitable. This means that you are not just looking at a CVE; you are looking at the potential blueprint behind a major breach.

Layered-Context-Dashboard-Rapid7-Exposure-Command-CNAPP.jpg

The proactive validation

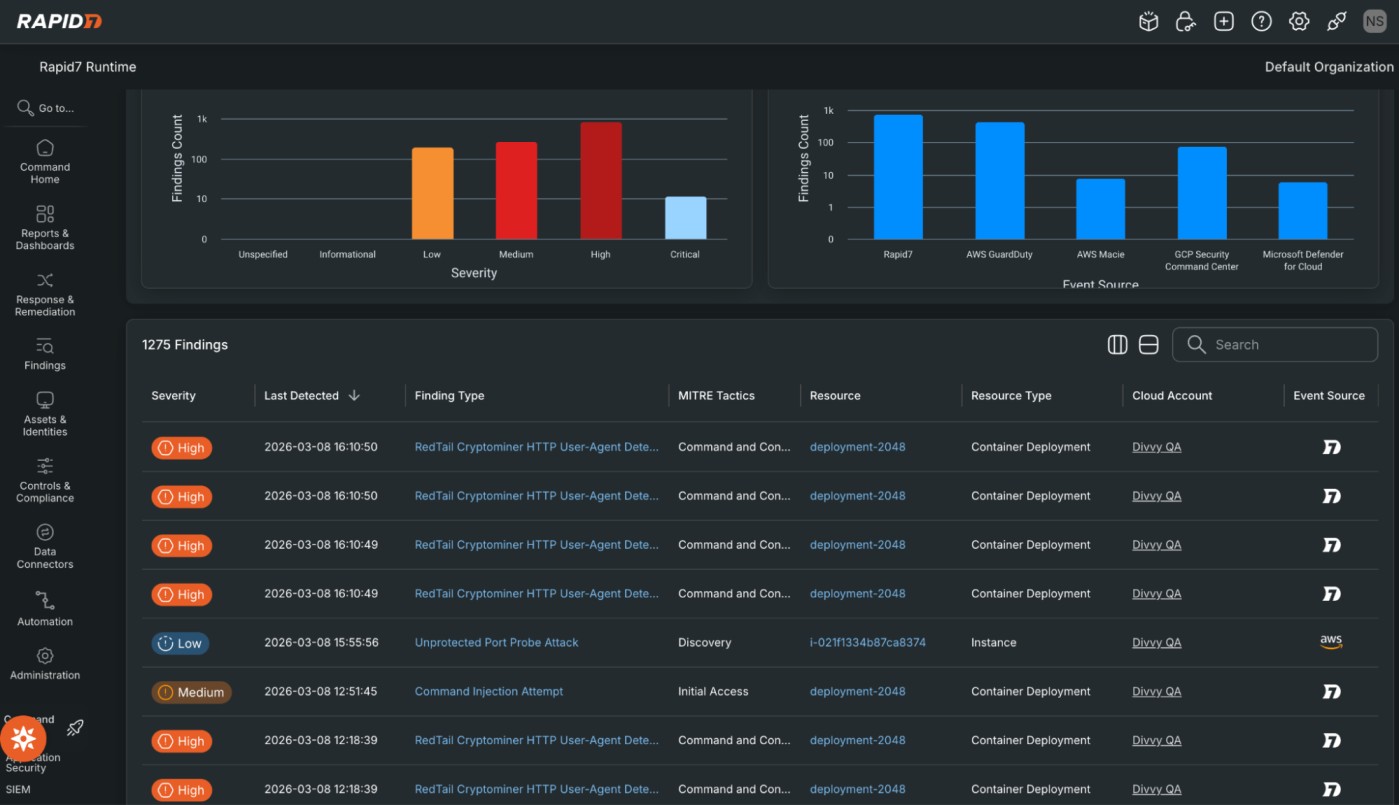
This is where cloud runtime security turns theory into reality. Instead of treating the vulnerability as just a potential risk, the platform utilizes eBPF sensors to provide continuous, direct kernel-level observability and application L7 visibility. Exposure Command analyzes this sensor data, uses AI to establish baseline workload behavior, and uncovers anomalies in real time. For example, security analysts gain instant visibility when that vulnerable container suddenly spawns a reverse shell and initiates an external connection to a known malicious IP, rather than executing its standard database queries.

Runtime-Security-Rapid7-Exposure-Command-CNAPP.jpg

The response

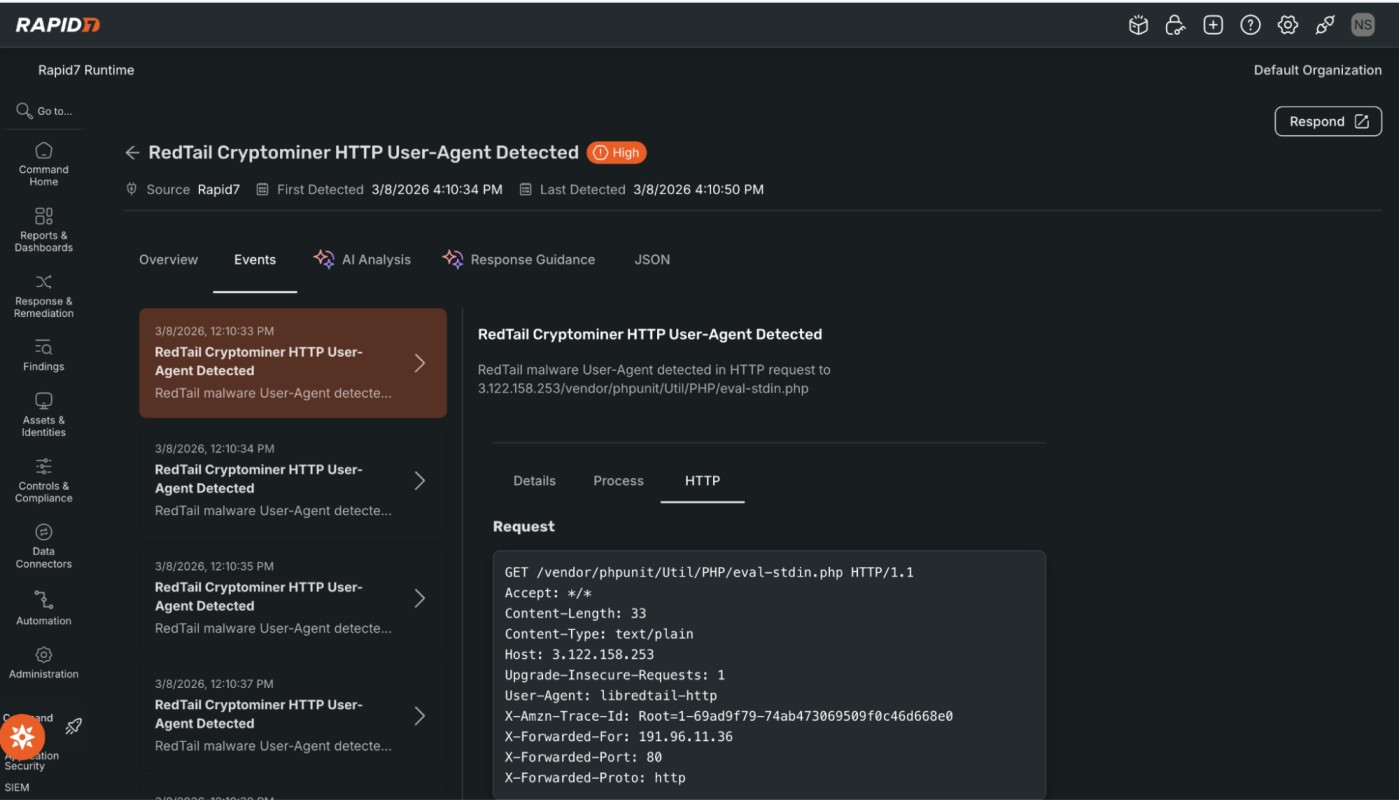
When a runtime anomaly is detected on a high-priority asset, the platform instantly aggregates these events into streamlined alerts. It links the initial application-layer exploit to the infrastructure-level change, such as the attacker attempting a container escape using that over-privileged IAM role. More importantly, the platform can trigger an automated response. By automatically terminating the malicious process, pausing the compromised container, or isolating the namespace, Exposure Command effectively stops an attacker’s lateral movement in seconds.

Malicious-process-alert-Rapid7-Exposure-Command-CNAPP.jpg

The investigation

Stopping the threat, understanding how it happened, and proving you resolved it, is what creates a truly resilient security program. Rapid7 Exposure Command does not just initially block the attack and leave you sifting through raw kernel logs to truly remediate the threat. Instead, it uses AI-generated remediation summaries to translate complex runtime telemetry into a clear, actionable remediation narrative. It explains exactly how the attacker bypassed initial defenses, what lateral movement they attempted, and the precise root-cause misconfigurations that allowed it. This empowers security teams to confidently report to leadership on the active threats they’ve neutralized, while providing developers with the exact context and code-level recommendations they need to patch the underlying exposure.

Amplifying signal vs. noise

When you combine predictive exposure analytics with deep application-layer and kernel-level visibility, you fundamentally change your operational efficiency. You stop chasing every theoretical risk and start focusing on what matters most. Exposure Command is a unified solution that eliminates the noisy alerts that tend to overwhelm security operations teams. Teams are able to prioritize remediation not just by CVSS score, but by real-time validation of what is actively loaded into memory and what is currently being exploited (i.e., risk and exposure). This means your developers spend less time patching vulnerabilities that fail to pose an immediate risk, and SecOps spends less time investigating benign container behavior.

With the general availability of cloud runtime security as part of Exposure Command, Rapid7 delivers a strategic, engineering-driven platform that achieves the mission of true CNAPP. We provide the precise answer to, “Could I be compromised?” through preemptive exposure management, and the definitive answer to, “Am I currently compromised?” through proactive runtime security. By closing the loop between these two questions, we allow enterprises to secure their cloud environments with accuracy, speed, and confidence. This is a great example of the wider approach to preemptive security that Rapid7 is delivering across different use cases through the Command Platform’s comprehensive exposure management and threat detection & response capabilities.

Visit Rapid7’s CNAPP hub page to learn more about how the fully integrated Rapid7 Exposure Command with cloud runtime security can transform your cloud defense.

Radicle 1.7.0 released

Post Syndicated from jzb original https://lwn.net/Articles/1063712/

Version
1.7.0
(“Daffodil”) of the Radicle peer-to-peer, local-first code
collaboration stack has been released. Some of the changes in this
release include improved I/O usage, the ability to block nodes at the
connection level, and clearer errors for rad id
updates. See the release notes for a full list of changes and bug
fixes.

[$] Development tools: Sashiko, b4 review, and API specification

Post Syndicated from corbet original https://lwn.net/Articles/1063303/

The kernel project has a unique approach to tooling that avoids many
commonly used development systems that do not fit the community’s scale and
ways of working. Another way of looking at the situation is that the kernel
project has often under-invested in tooling, and sometimes seems bent on
doing things the hard way. In recent times, though, the amount of effort
that has gone into development tools for the kernel has increased, with
some interesting results. Recent developments in this area include the
Sashiko code-review system, a patch-review manager built into b4, and a new
attempt at a framework for the specification and verification of kernel
APIs.

20 years in the AWS Cloud – how time flies!

Post Syndicated from Channy Yun (윤석찬) original https://aws.amazon.com/blogs/aws/20-years-in-the-aws-cloud-how-time-flies/

AWS has reached its 20th anniversary! With a steady pace of innovation, AWS has grown to offer over 240 comprehensive cloud services and continues to launch thousands of new features annually for millions of customers. During this time, over 4,700 posts have been published on this blog—more than double the number since Jeff Barr wrote the 10th anniversary post.
AWS changed my life
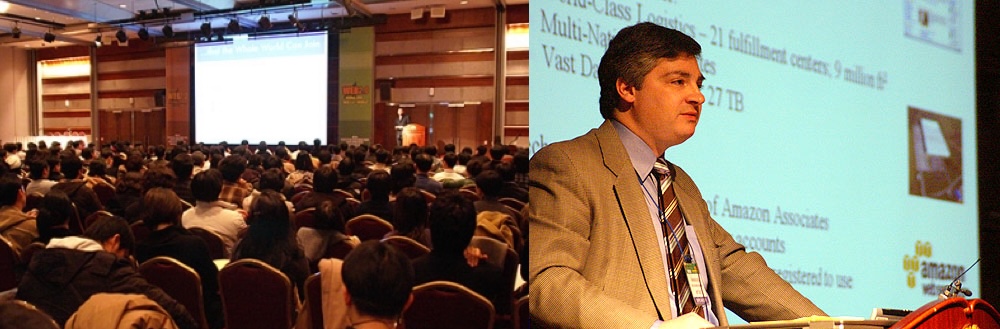
Reflecting on what I was doing 20 years ago, I met Jeff in Seoul on March 13, 2006, when he came as the keynote speaker for the Korea NGWeb conference. At that time, Amazon was one of the first pioneers to initiate an API economy, introducing ecommerce API services. After the keynote speech, he returned home that evening, and I believe he wrote the Amazon S3 launch blog post on the flight back to the United States.

That short meeting with him brought significant changes to my life. He became my role model as a blogger, and I began building API-based services in my company and opening them to third-party developers. When I was a PhD student while taking a break from work, I realized that for individual researchers like me, AWS Cloud services are powerful tools for conducting large-scale research projects. After returning to work, my company became one of the first AWS customers in Korea in 2014. Countless developers—myself included—have embraced cloud computing and actively used its capabilities to accomplish what was previously impossible.

Over the past decade, the technology landscape has transformed dramatically. Deep learning emerged as a breakthrough in AI, evolving through generative AI based on large language models (LLMs) to today’s agentic AI technology. Jeff wrote, “When looking into the future, you need to be able to distinguish between flashy distractions and genuine trends, while remaining flexible enough to pivot if yesterday’s niche becomes today’s mainstream technology.” This principle guides how AWS approaches innovation—we start by listening to what customers truly need. The real trend isn’t pursuing every emerging technology, but rather reimagining solutions that address customers’ most critical challenges.

20 years of AWS
For the first 10 years, Jeff selected his favorite AWS launches and blog posts. Amazon S3, Amazon EC2 (2006), Amazon Relational Database Service, Amazon Virtual Private Cloud (2009), Amazon DynamoDB, Amazon Redshift (2012), Amazon WorkSpaces, Amazon Kinesis (2013), AWS Lambda (2014), and AWS IoT (2015).

While I also hate to play favorites, I want to choose some of my favorite AWS blog posts of the past decade.

  • Deploying containers easily (2014) – Amazon Elastic Container Service makes it straightforward for you to run any number of containers across a managed cluster of Amazon EC2 instances using powerful APIs and other tools. In 2017, we launched Amazon Elastic Kubernetes Service as a fully managed Kubernetes service and AWS Fargate as a serverless deployment option.
  • High availability database at global scale (2017) – Amazon Aurora is a modern relational database service offering performance and high availability at scale. In 2018, we launched Amazon Aurora Serverless v1, and this serverless database evolved to Amazon Aurora Serverless v2 to scale down to zero. In 2025, we also launched Amazon Aurora DSQL is the fastest serverless distributed SQL database for always available applications.
  • Machine learning (ML) at your fingertips (2017) – Amazon SageMaker is a fully managed end-to-end ML service that data scientists, developers, and ML experts can use to quickly build, train, and host machine learning models at scale. In 2024, we launched the next generation of Amazon SageMaker, a unified platform for data, analytics, and AI and introduced Amazon SageMaker AI to focus specifically on building, training, and deploying AI and ML models at scale.
  • Best price performance for cloud workloads (2018) – We launched Amazon EC2 A1 instances powered by the first generation of Arm-based AWS Graviton Processors designed to deliver the best price performance for your cloud workloads. Last year, we previewed EC2 M9g instances powered by AWS Graviton5 processors. Over 90,000 AWS customers have reaped the benefits of Graviton supporting popular AWS services such as Amazon ECS and Amazon EKS, AWS Lambda, Amazon RDS, Amazon ElastiCache, Amazon EMR, and Amazon OpenSearch Service.
  • Run AWS Cloud in your data center (2019) – AWS Outposts is a family of fully managed services delivering AWS infrastructure and services to virtually any on-premises or edge location for a truly consistent hybrid experience. Now, AWS Outposts is available in a variety of form factors, from 1U and 2U Outposts servers to 42U Outposts racks, and multiple rack deployments. Customers such as DISH, Fanduel, Morningstar, Philips, and others use Outposts in workloads requiring low latency access to on-premises systems, local data processing, data residency, and application migration with local system interdependencies.
  • Best price performance for ML workloads (2019) – We launched Amazon EC2 Inf1 instances powered by the first generation of AWS Inferentia chips designed to provide fast, low-latency inferencing. In 2022, we launched Amazon EC2 Trn1 instances powered by the first generation of AWS Trainium chips optimized for high performance AI training. Last year, we launched Amazon EC2 Trn3 UltraServers powered by Trainium3 to deliver the best token economics for next-generation generative AI applications. Customers such as Anthropic, Decart, poolside, Databricks, Ricoh, Karakuri, SplashMusic, and others are realizing performance and cost benefits of Trainium-based instances and UltraServers.
  • Build your generative AI apps on AWS (2023) – Amazon Bedrock is a fully managed service that offers a choice of industry leading AI models along with a broad set of capabilities that you need to build generative AI applications, simplifying development with security, privacy, and responsible AI. Last year, we introduced Amazon Bedrock AgentCore, an agentic platform for building, deploying, and operating effective agents securely at scale. Now, more than 100,000 customers worldwide choose Amazon Bedrock to deliver personalized experiences, automate complex workflows, and uncover actionable insights.
  • Your AI coding companion (2023) – We launched Amazon CodeWhisperer as the industry’s first cloud-based AI coding assistant service. The service delivered code generation from comments, open-source code reference tracking, and vulnerability scanning capabilities. In 2024, we rebranded the service to Amazon Q Developer and expanded its features to include a chat-based assistant in the console, project-based code generation, and code transformation tools. In 2025, this service evolved into Kiro, a new agentic AI development tool that brings structure to AI coding through spec-driven development, taking projects from prototype to production. Recently, Kiro previewed an autonomous agent, a frontier agent that works independently on development tasks, maintaining context and learning from every interaction.
  • Broaden your AI model choices (2024) – We launched Amazon Titan models further increasing cost-effective AI model choice for text and multimodal needs in Amazon Bedrock. At AWS re:Invent 2024, we announced Amazon Nova models that delivers frontier intelligence and industry leading price performance. Now Amazon Nova has a portfolio of AI offerings—including Amazon Nova models, Amazon Nova Forge, a new service to build your own frontier models; and Amazon Nova Act, a new service to build agents that automate browser-based UI workflows powered by a custom Amazon Nova 2 Lite model.

Build with AI: Your path forward
A decade ago, AWS responded to the emergence of deep learning by launching the broadest and deepest ML services, such as Amazon SageMaker, democratizing AI for a wide range of customers—from individual developers and startups to large enterprises—regardless of their technical expertise.

AI technology has advanced significantly, but building and deploying AI models and applications still remains complex for many developers and organizations. AWS offers the broadest selection of AI models through Amazon Bedrock, including leading providers such as Anthropic and OpenAI. By using our model training and inference infrastructure and responsible AI both practical and scalable, you can accelerate trusted AI innovation while maintaining control of your data and costs—all built on our global infrastructure’s operational excellence.

Reinvent your idea, keep on learning, build confidently with AI you can trust, and share your successes with us! New AWS customers receive up to $200 in credits to try AWS AI for free. If you’re a student, start building with Kiro for free using 1,000 credits per month for one year.

— Channy

Security updates for Thursday

Post Syndicated from jzb original https://lwn.net/Articles/1063659/

Security updates have been issued by Debian (freetype), Fedora (aqualung, kiss-fft, libtasn1, mac, and vim), Red Hat (libarchive, osbuild-composer, and rhc), Slackware (expat), SUSE (ca-certificates-mozilla, chromium, cockpit, cockpit-machines, cockpit-podman, curl, docker, docker-compose, docker-stable, gnutls, gstreamer-rtsp-server, gstreamer-plugins-ugly, gstreamer- plugins-rs, gstreamer-plugins-libav, gstreamer-plugins-good, gstreamer-plugins- base, gstreamer-plugins-bad, gstreamer-docs, gstreamer-devtools, gstreamer, gvfs, helm, kernel, krb5-appl, libsoup, libxslt, libxml2, openssh, python-cryptography, python-django, python-pypdf2, python-simpleeval, python311, qemu, ruby4.0-rubygem-sprockets, ruby4.0-rubygem-thor, ruby4.0-rubygem-web-console, ruby4.0-rubygem-websocket-extensions, skaffold, smb4k, tomcat, ucode-intel, util-linux, virtiofsd, and zlib), and Ubuntu (bouncycastle, exiv2, freerdp3, linux-aws, linux-aws-5.4, linux-gcp-5.4, linux-oracle, linux-oracle-5.4, linux-xilinx-zynqmp, linux-aws-fips, python2.7, roundcube, and valkey).

„Класацията“ на игромислещите. Първа цедка

Post Syndicated from original https://www.toest.bg/klasatsiyata-na-igromisleshtite-purva-tsedka/

„Класацията“ на игромислещите. Първа цедка

Необходимо пояснение: поредиците са въведени като едно заглавие, при все че някои от събеседниците предпочитат определена конкретна част, а други настояват на единството на тези поредици. Редът е азбучен, а не според броя получени гласове.

Алиса на Американ Макгий
American McGee's Alice

2000
Вещерът
The Witcher

2007–2015 · поредица
Диско Елизиум
Disco Elysium

2019
Драконова епоха
Dragon Age

2009–2024 · поредица
Древните свитъци
The Elder Scrolls

1994–2011 · поредица
Ефектът на масата
Mass Effect

2007–2017 · поредица
Жертва
Sacrifice

2000
Киберпънк 2077
Cyberpunk 2077

2020
Нефритената империя
Jade Empire

2005
Плейнскейп: Мъчение
Planescape: Torment

1999
Болдърсгейт
Baldur's Gate

1998–2023 · поредица
Рицари на Старата република
Star Wars: Knights of the Old Republic

2003–2004 · диптих
Ъндъртейл
Undertale

2015
Ядрена зима
Fallout

1997–2018 · поредица


Миглена Николчина: Въпреки че задругата ни от години общува около игрите, оказа се, че

в първите 25 игри, които всеки от нас избра, четиринайсет се повтарят – нито много, нито малко.

Неповтарящите се (а и някои липси) ми се виждат не по-малко знакови от споделените. Само Еньо е посочил „Гибел“ (Doom), която не просто беше много популярна, но и беше налагана от първите изявени „игрознайци“ като модел за – както е при Аарсет – ергодичното изкуство, тоест изкуство, базирано на кибернетична система, която генерира различна последователност от знаци всеки път, когато произведението се преживява1. Ергодичните подходи се базират на преекспониране на интерактивността за сметка на „стабилните“ игрови компоненти – от една страна, самото кодиране, от друга – степента, в която игрите могат да инкорпорират „старите“ изкуства в себе си: не просто разказ (визирам спора с наратолозите), но и персонажи, драматургия, живопис, архитектура, опера… както и конкретното и фактологично присъствие на история, философия, политология.

От друга страна, трогната съм, че „Нефритената империя“ (Jade Empire), за която си мислех, че ще помня само аз, е споделена. Какво според вас – като имаме предвид, че ориентацията в това още неканонизирано поле неизбежно предполага случайни фактори – обединява съвпаденията на някои игри и нулевото присъствие на някога много популярни и знакови игри („Лара Крофт“, „Марио“)?

Северина Станкева: За мен не е изненадващо, че се обединяваме около класиките на ролевия жанр, тоест този с най-много четене. За да продължим със статистиката, на практика

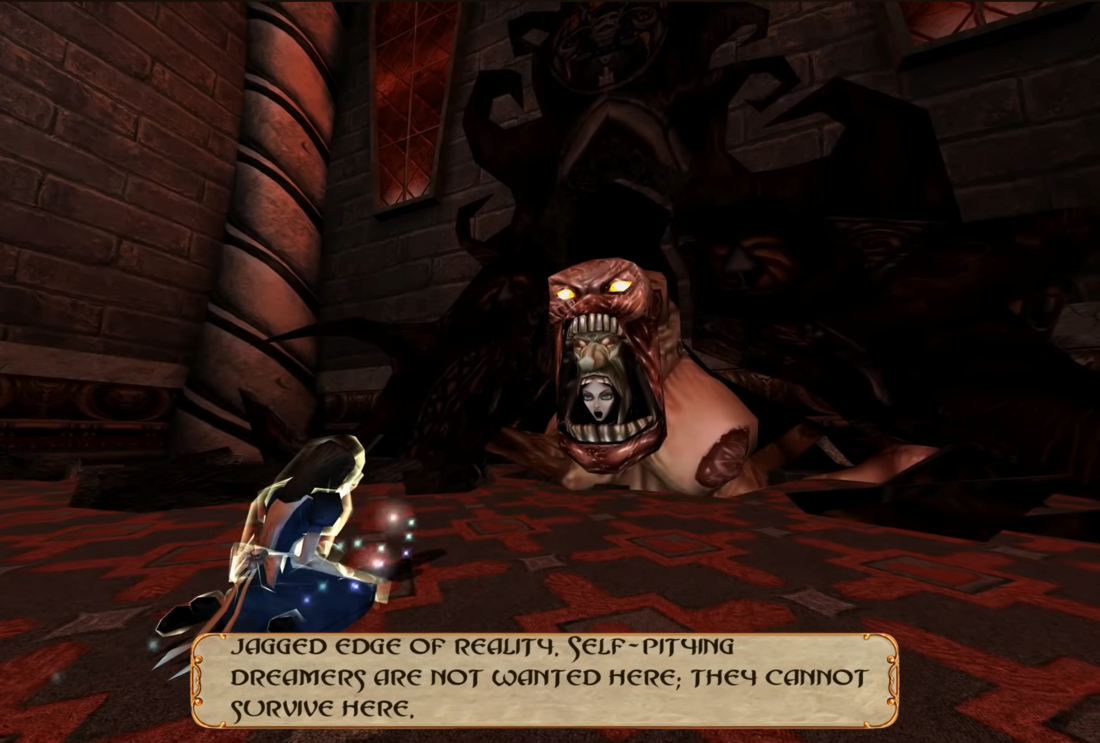
само една игра от четиринайсетте не е ролева или с ролеви елементи и това е „Алиса на Американ Макгий“ (American McGee’s Alice).

Тъкмо нея не очаквах да видя при някого от вас, но съм изключително приятно изненадана, че Николай я е посочил. Любопитно е, че тя е създадена в съзнателна опозиция на масови заглавия като „Гибел“2, но бори жанра отвътре – продължава да е в рамките на екшън приключенската шапка, но по авангарден начин. И тя обаче е пряко свързана с литературата.

Ако в ролевите игри сме, общо взето, на едно мнение и различията са по линия на предпочитанията на едно или друго заглавие или част от поредица, то по отношение на ергодичното се разминаваме. Измежду моите фаворити има няколко игри от може би най-ергодичния жанр въобще, който по твое предложение преведохме като „пикареска“ (roguelike), но засега ще се въздържа да ги коментирам, защото не попадат в първата четвърт. По отношение на липсващите заглавия – ако това беше класация за най-влиятелните игри на всички времена, в личен или не план, тя щеше да изглежда доста различно. За да си послужа с един прословут цитат от Марио, принцесата ни, изглежда, е в друг замък. 

Николай Генов: Причината да включа „Алиса на Американ Макгий“ в своя подбор не е свързана толкова с някаква жанрова авангардност по отношение на други игри, нито идва по линия на нейната „механика“, тъй като не смятам, че тя се отличава с нещо кой знае какво в този план. Истинското ѝ достойнство сякаш се крие в образцовия начин, по който създателите третират литературното произведение – преработват го, интерпретират го и го разгръщат в един шизоиден регистър, като по този начин остранностяват и читателското преживяване.

Нещо съвсем друго прави „Вещерът“ (The Witcher) – от една страна, поредицата подема и продължава мотива, заложен в книгите на Сапковски, за трудността (и отговорността) да се вземат решения, но тук вече играчът бива поставен в активна позиция – той е този, който трябва да действа и да решава, следователно цената, която се заплаща за тази свобода, добива допълнително измерение и от констатация се превръща в перформатив.

Миглена вече е имала лекции за това как подобни механизми се задействат в „Рицарите на Старата република“ (Knights of the Old Republic) – запомнил съм един много въздействащ неин пример от втората игра. Умишлено – и в някакъв смисъл като негова реплика – аз „предпочетох“ първата част, тъй като след „точката на пречупване“ (кулминацията на историята) пред играча се поставя интегралният въпрос дали нещата могат да продължат по същия начин, или всичко оттук насетне трябва да се промени.

Знам, че известно разминаване с Миглена имаме по линия на „Древните свитъци“ (The Elder Scrolls), тъй като аз продължавам да твърдя, че „Мороуинд“ (Morrowind), а не „Скайрим“ (Skyrim) е голямото заглавие тук. Бих направил една допълнителна маневра, с която да заявя, че по лична преценка четвъртата игра от поредицата – „Забрава“ (Oblivion) – предлага по-интересни сюжети от „Мороуинд“ и „Скайрим“, взети заедно, без обаче да се доближи до онзи невероятен размах на въображението, който виждаме в цялата му възхитителна мощ при светостроенето на „Мороуинд“.

За прераждането (или възкресението) на страхотната „Киберпънк“ (Cyberpunk 2077) вече сме говорили, а за началото на „Драконовата епоха“ (Dragon age) дори не смея да отворя дума. Ще си позволя да кажа само, че това, което първата игра от поредицата успява да направи, тази повествователна плътност, която постига, сякаш се губи в продълженията ѝ, които съвсем не заемат същото място в моите очи.

Еньо Стоянов: Може би нашата „класация“ казва повече за процеса на собственото си оформление, отколкото за неговите „класически“ заглавия в полето на видеоигрите. Трябва да подчертая, че това, което пробвахме да направим, е своеобразен експеримент – вместо да се договаряме за предварителни критерии за подбор и оценка, които догматично да спазваме при изготвянето на нашия списък, ние по-скоро

опитахме да посочим заглавия на почти асоциативен принцип: кои игри ни хрумват едва ли не първосигнално като важни, значими, интересни.

Нашият експеримент се оказва по-скоро един опит да се открои картата на полето на видеоигрите в неговото настояще и история, за която невинаги си даваме сметка, но която безсъзнателно несъмнено ни помага да навигираме из него. Това не значи, че просто сме отразили собствените си предпочитания, вкусове, предразсъдъци и пр. Самата идея да се предложи списък на „най-доброто“ някак те възпира да включиш в него игри, които са изпълнени с несполуки, но към които въпреки това имаш силен сантимент и привързаност, по-голяма от онази, която изпитваш към далеч по-съвършени и образцови заглавия. От друга страна, самите „образци“ изглеждат сякаш твърде „чисти“ въплъщения на стойностност, твърде клиширани емблеми на майсторство, символи, нивелирани до неутралност поради постоянните и често почти празни и опразващи ги жестове на преклонение.

Изглежда, сме предпочели заглавия, които не въплъщават съвършенство, не са „представителни“, а по-скоро се оказват интензивно качествени в някакво отношение, заглавия, които с нещо в себе си засенчват своите слабости и така подсказват напрегната борба с условията на собственото си изкуство. Тоест това са игри, които едновременно разкриват тези условия, противят им се, за да ги разширят, да ги преосмислят, да ги подложат на преоценка.

„Класацията“ на игромислещите. Първа цедка
Кадър от Cyberpunk 2077

Миглена Николчина: Нека си признаем, че в тази първа цедка на съвпадащи заглавия попаднаха игри, които са действително качествени в едно, друго или множество отношения, но които са също така масово харесвани, награждавани, дискутирани във форуми. Те са ролеви игри, но освен това са фантастични или по посока на дракони и магьосници („Болдърсгейт“, „Древните свитъци“, „Драконова епоха“, „Вещерът“), или по посока на произтичащи от технологиите катастрофи („Ядрена зима“, „Ефектът на масата“, „Киберпънк“). Голямото изключение е може би „Диско Елизиум“, където фантастичното под разни форми присъства, но катастрофата се простира от социално-историческото и психологическото до онтологическото, без да се приписва пряко на магични или технологични причинители.

Тук обаче възникват и множество разделителни линии по отношение на параметри като конструиране на игровите (но понякога и на неигровите персонажи), както и по отношение на типовете взаимодействие с диалозите, отношенията между героите, развитието на сюжетните линии, наличието или липсата на битки.

В някои от игрите персонажите са дадени в дълбочина – пример е сложният образ на Крея във втората част на „Рицари на старата република“, която, въпреки че е неигрови персонаж, добива различен релеф според развитието на аватара. В обичайния случай развитието на персонажите се отнася само до бойните им умения, в някои от игрите включва етически компонент (светло–тъмно и пр.) – има и други възможности, но не ги виждам представени тук. Голямото изключение е „Диско Елизиум“, където изграждането на аватара добива бароково-фантастични измерения. Разлики от този вид има и в другите параметри. В „Диско Елизиум“ се изстрелва един-единствен изстрел и той е тежко предопределен от предходните решения на играча. Ефектът на масата включва аспекти на стрелба. Много от игрите включват цял арсенал от повече или по-малко фантастични оръжия. Тук отново съвпадащите ни избори са в масовката, в повечето от тях сраженията заемат доста сериозно място.

Най-сетне, големи дебати има – или понякога везните тежко се накланят в някоя посока, – що се отнася до предпочитания към една или друга част от поредица. Аз обаче като многократно превъртала някои поредици (включително „Кредото на убиеца“, която не попадна в първата цедка) настоявам върху сериозното сюжетно и смислово единство на някои от тях – например „Ефектът на масата“ (Mass Effect) или „Вещерът“.

Северина Станкева: Любопитно е, че освен класически примери за бойни игри, каквито са повечето игри въобще, през първата цедка успя да премине и най-известната игра, която позволява играчът да я изиграе изцяло пацифистки – „Ъндъртейл“ (Undertale). Тя е важна не просто защото позволява мирен подход, но и защото проблематизира връзката между играч и игра по един некласически метаначин. Ако в „Диско Елизиум“ изстрелът е натоварен с всички избори, направени до него в конкретното проиграване, то в „Ъндъртейл“ тези избори не престават да преследват играча и в следващите му преигравания.

„Класацията“ на игромислещите. Първа цедка
Кадър от Undertale

Ако като играч избереш да избиваш всичко срещнато в света на чудовищата, в който случайно си попаднал, а после започнеш отначало, но миролюбиво, за да видиш как ще изглежда историята от другата страна, играта все още те „помни“ като тиранин. В резултат моралът на играча има много по-сериозни и необратими последствия, съответно се увеличава и отговорността по начин, който аз поне не съм срещала другаде, и той е поредното доказателство за наивността на простото разграничение механика–сюжет, което многократно сме обсъждали.

Пример за различна морална система, от която се вдъхновяват създателите на „Диско Елизиум“, е тази на „Плейнскейп: Мъчение“ (Planescape: Torment), на която се носи славата като на най-философската игра, защото включва множество ясно отделени философски системи в своите дървета на решенията. Философскостта ѝ обаче остава изцяло в рамките на класическото диалогово повествование, а различните избори не променят нищо в механиката.

С оглед на всичко това и продължавайки нишката, подхваната от Еньо, ми се струва, че и нашата класация успява да се саморегулира в движение, така че да включва както заглавия, които задават канона, така и такива, които поставят под съмнение зададените от него рамки и така разширяват потенциала на това какво видеоигрите могат да бъдат. Предстои да видим дали това ще се запази и в следващите части на класацията.

1 Espen Aarseth. Aporia and Epiphany in Doom and The Speaking Clock: Temporality in Ergodic Art. In: Cyberspace Textuality. Computer Technology and Literary Theory. Marie-Laure Ryan (ed.). Indiana UP: 1999.

2 Вж. например това интервю на Американ Макгий по темата.

В рубриката „Игромислие“ публикуваме разговори, в които се срещат, съпоставят и противопоставят различни гледни точки към многоизмерния, многожанров феномен на видеоигрите – не толкова като електронен спорт, колкото като нов синтез на изкуствата и като ново поле на общуване и социалност.

Будапеща на Колодко – толкова много истории

Post Syndicated from Нева Мичева original https://www.toest.bg/budapeshta-na-kolodko-tolkova-mnogo-istorii/

Будапеща на Колодко – толкова много истории

Топ 50 на най-високите статуи в света съдържа преобладаващо божества, издигнати на публични места след 2000 г., макар начело на списъка да е индийски политик, а най-цѐнен според ЮНЕСКО да е един китайски Буда от IX век. Всички се намират в Азия, с три изключения: сенегалски ансамбъл, построен от севернокорейци край Дакар, плюс две Родини – руска и украинска. Най-високият обелиск стърчи във Вашингтон; египетските пирамиди се борят за надмощие с мексиканските; за първенство в кубиците бетон на Балканите се надпреварват шуменският мемориал „Създатели на българската държава“ и „летящата чиния“ на Бузлуджа (и двата монумента са от 1981 г.). Все произведения, мислени да всяват страхопочитание и да заявяват значимост. Неслучайно „монументален“ ще рече „внушителен“, „огромен“…

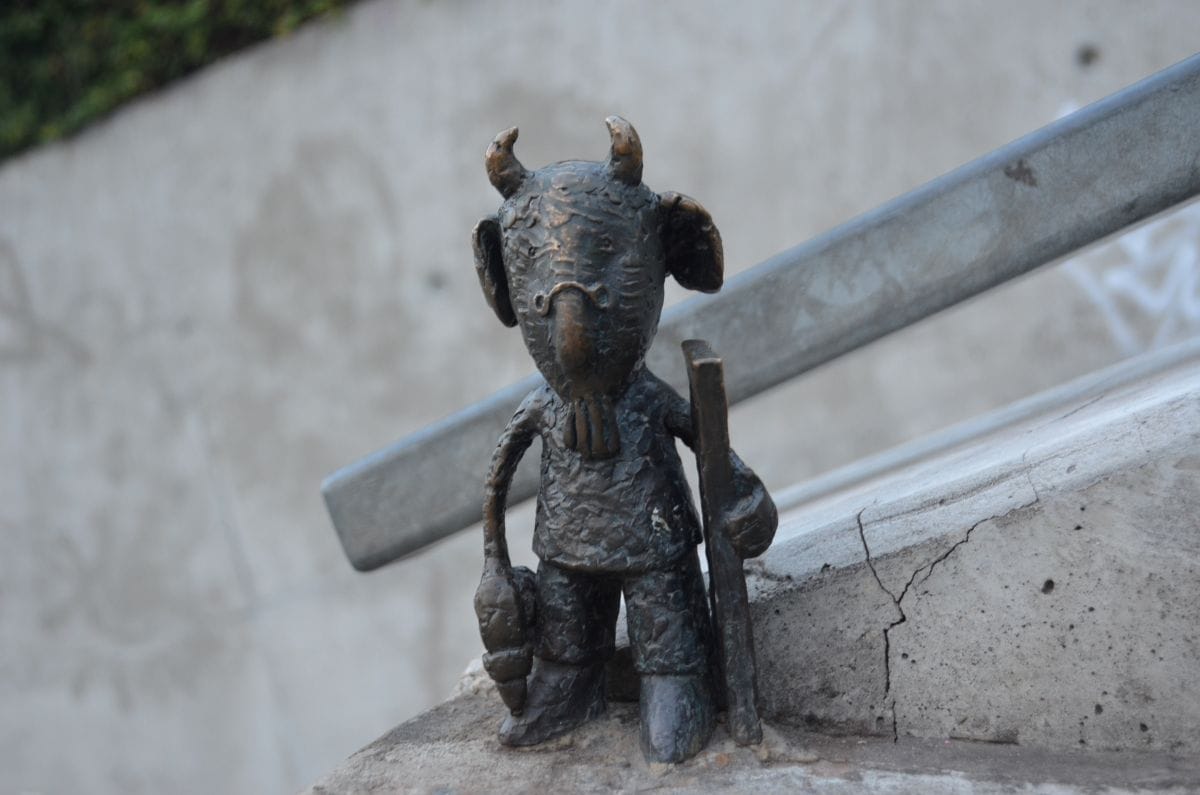
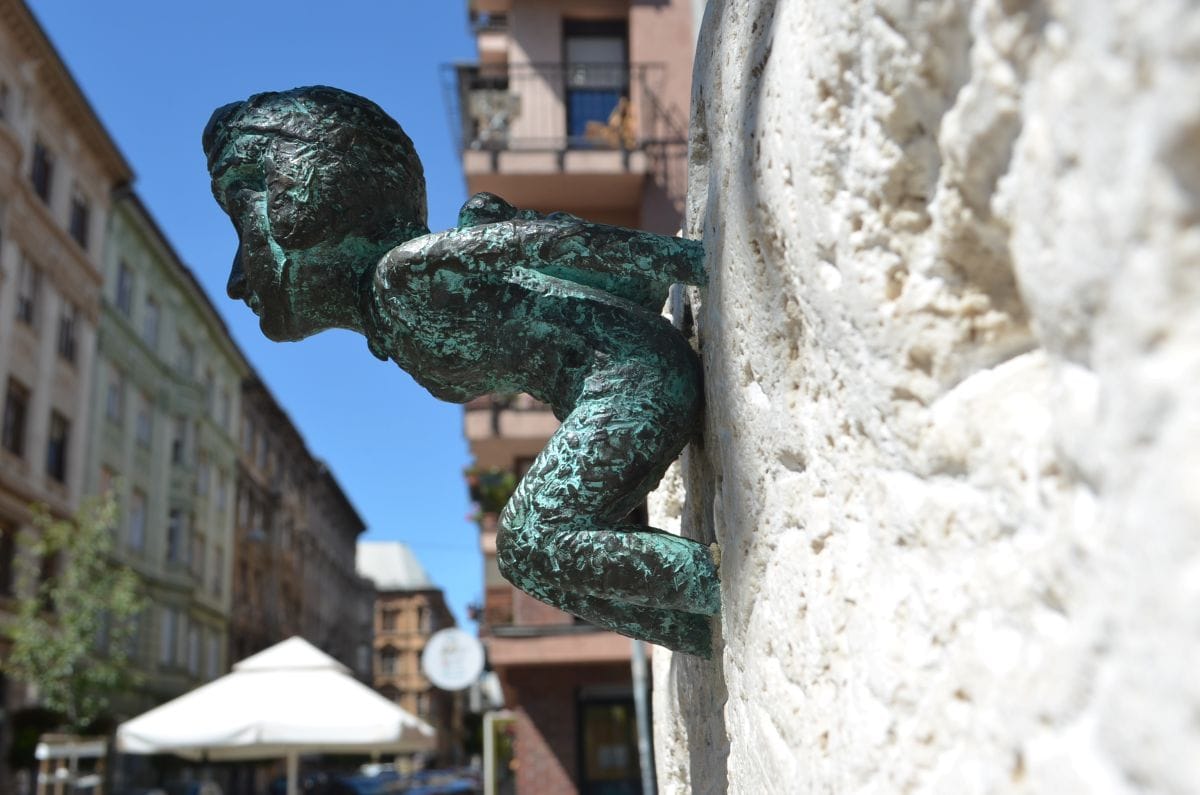
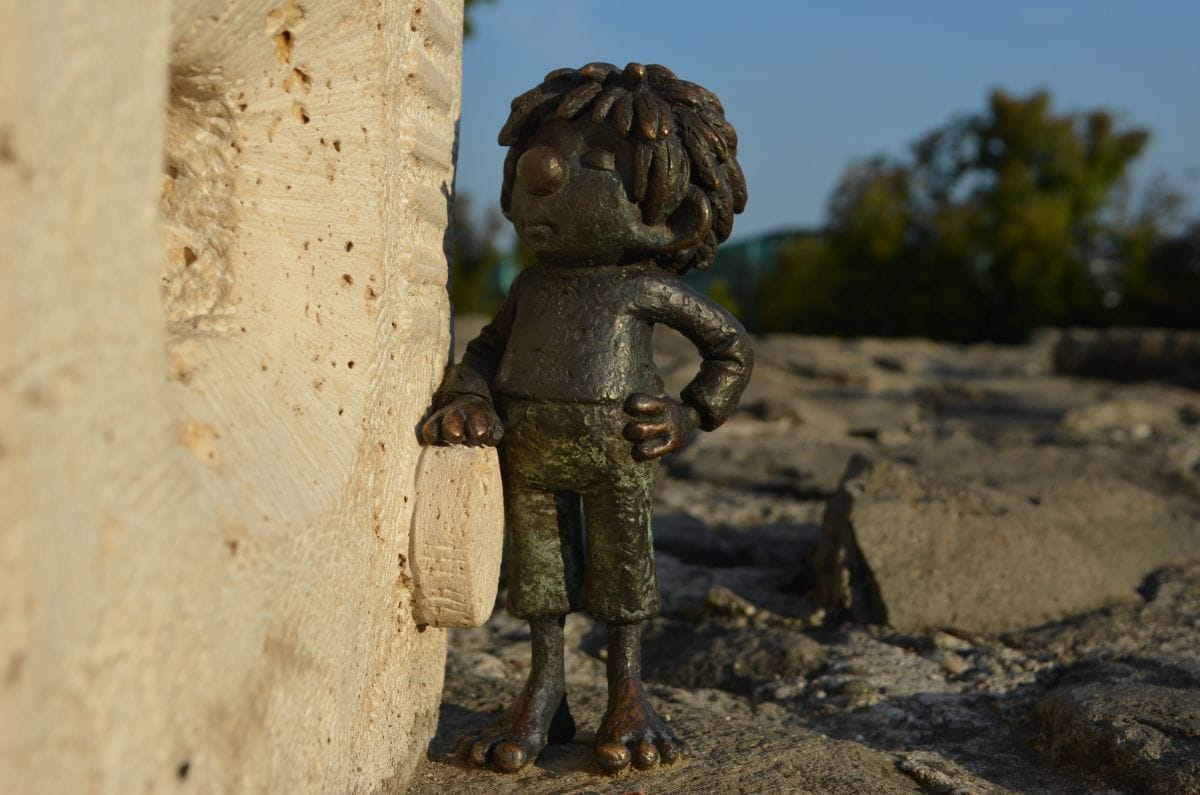
И все пак има паметници, способни да извикват нежност и да поразяват с нежеланието да се набиват на очи. Желязното момченце в Стокхолм например – педя човече, което от 1967 г. седи на леглото си, гледа луната и е ту украсено с цветя от своите посетители, ту увито с плетени от тях шалчета, ту почетено с монети и бонбони. Или близо осемстотинте 20–30-сантиметрови гномчета с различни професии и характери, завзели Вроцлав през последните две десетилетия… В групата на монументите, отричащи смазващите обеми в полза на гальовните жестове, попадат и фигурките, с които Михай(ло) Колодко осява Будапеща от неотдавна.

Колодко е роден в Ужгород през 1978 г., завършва монументална скулптура в Лвов през 2002-ра, а през 2010-та се преформулира като автор на „градски миниатюри“ – започва от родната си Украйна и продължава в Унгария, където се преселва през 2017-та.

Изкуството му е улично, „партизанско“ (guerrilla art), тоест непредвидимо, неканено и неканонично.

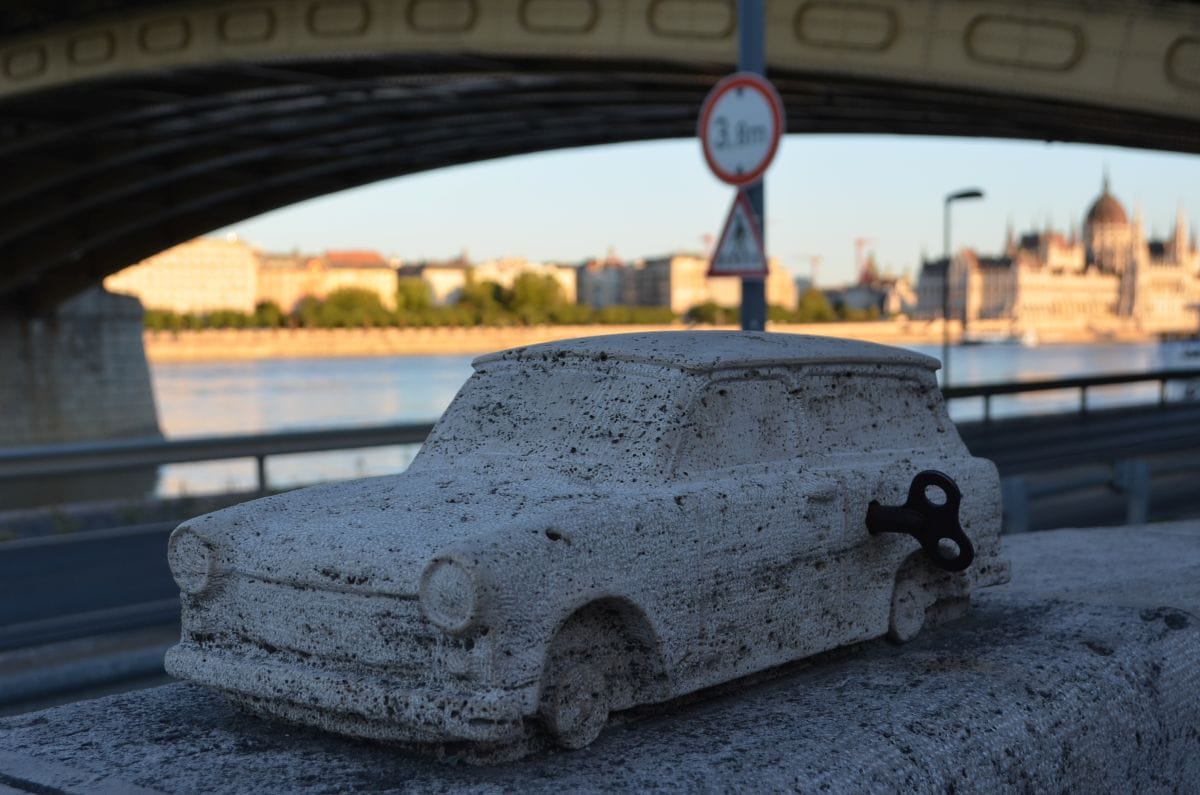
Паметниците, които прави по собствен почин и монтира където му хрумне, са маломерни, появяват се без ленти за прерязване и тържествени слова, вместо владетели изобразяват анимационни герои или вещи и хич не настояват да бъдат гледани. А и авторът, за капак, не обяснява много-много коя какво значи.

Будапеща е всякак голяма: има и история, и гледки, и простор, и разнообразие. Ето защо е особено любопитно как дребните творби на украинеца с унгарски корен осезаемо я разширяват. Една столица може да си позволи да прескача от тема на тема, без да изтърве нишката (но не и да бъде монотонна); една традиция – да се свърже с безброй други, без да загуби физиономията си (но не и да се капсулира в себе си). Когато кривнеш към тихо място, за да потърсиш поредния „колодко“ (в интернет изобилстват картите, на които са отбелязани местонахожденията на джобните му статуи, и групите, които обсъждат техните изниквания и изчезвания), и приклекнеш да се взреш, нещата добиват личен привкус. И пъстро се разбягват във всички посоки.

От Пух до Вук

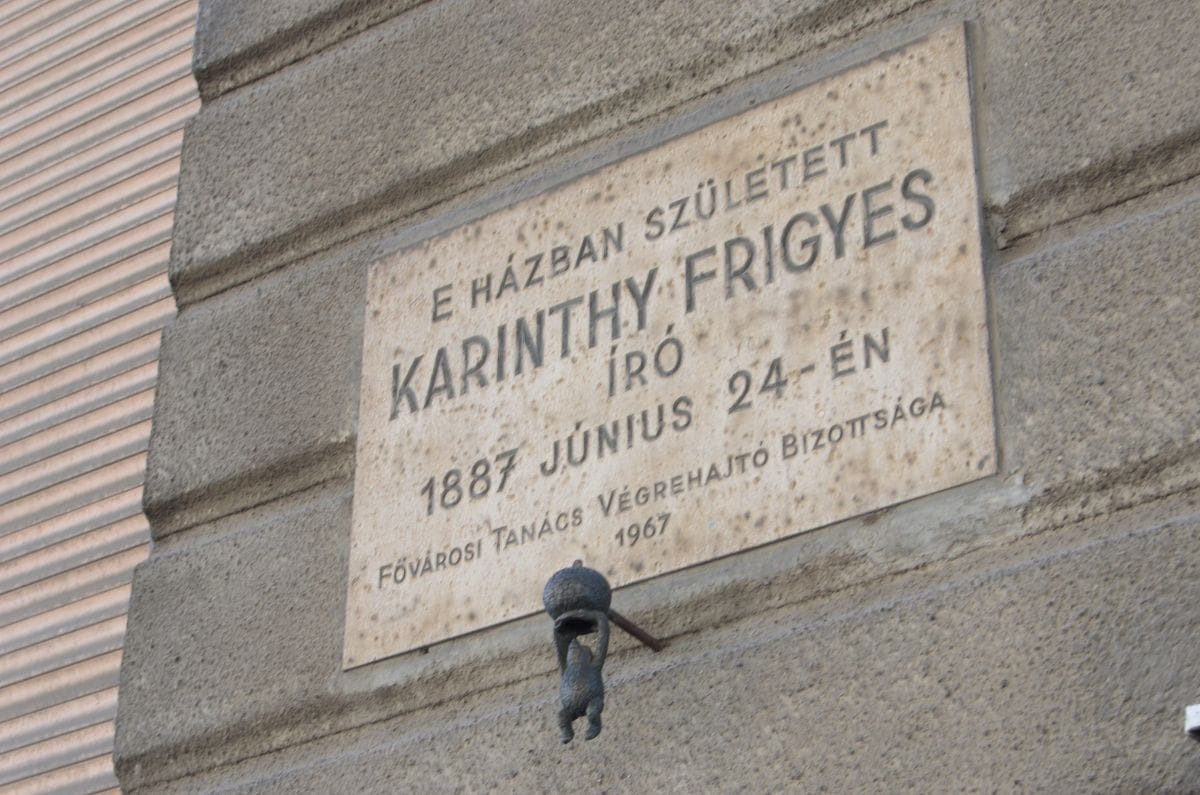
Фотосафарито от колодко на колодко е превъзходна идея за прекарването на ден-два, че и три в Будапеща – фигурките са вече над 40, в зони от двете страни на Дунава, които човек бездруго би се радвал да посети. Тръгвам с амбицията да видя колкото може повече и започвам от онази, която ми е най-присърце: Мечо Пух, увиснал под паметната плоча на своя преводач Фридеш Каринти. На Пух на унгарски му казват Мицимацко – втората част значи „плюшено мече“, а Мици е галеното име на Емилия Каринти, авторка на подстрочниците за всички преводи на брат си Фридеш от английски.

Същият този брат впрочем, изтъкнат писател, остава в световната история с нещо съвсем неочаквано – идеята за шестте степени на разделение. Тя се появява за първи път в разказа му „Вериги“: група приятели обсъждат, че между произволни двама души на света има максимум петима други, през чиито сфери на познанства, брънка по брънка, двамата произволни могат да осъществят контакт. Най-красивото изречение в текста:

В близост до Северния полюс, казват, стрелката на компаса пощурява и започва да се върти в кръг. Същото, изглежда, се случва на убежденията ни, когато се окажем твърде близо до Бог.

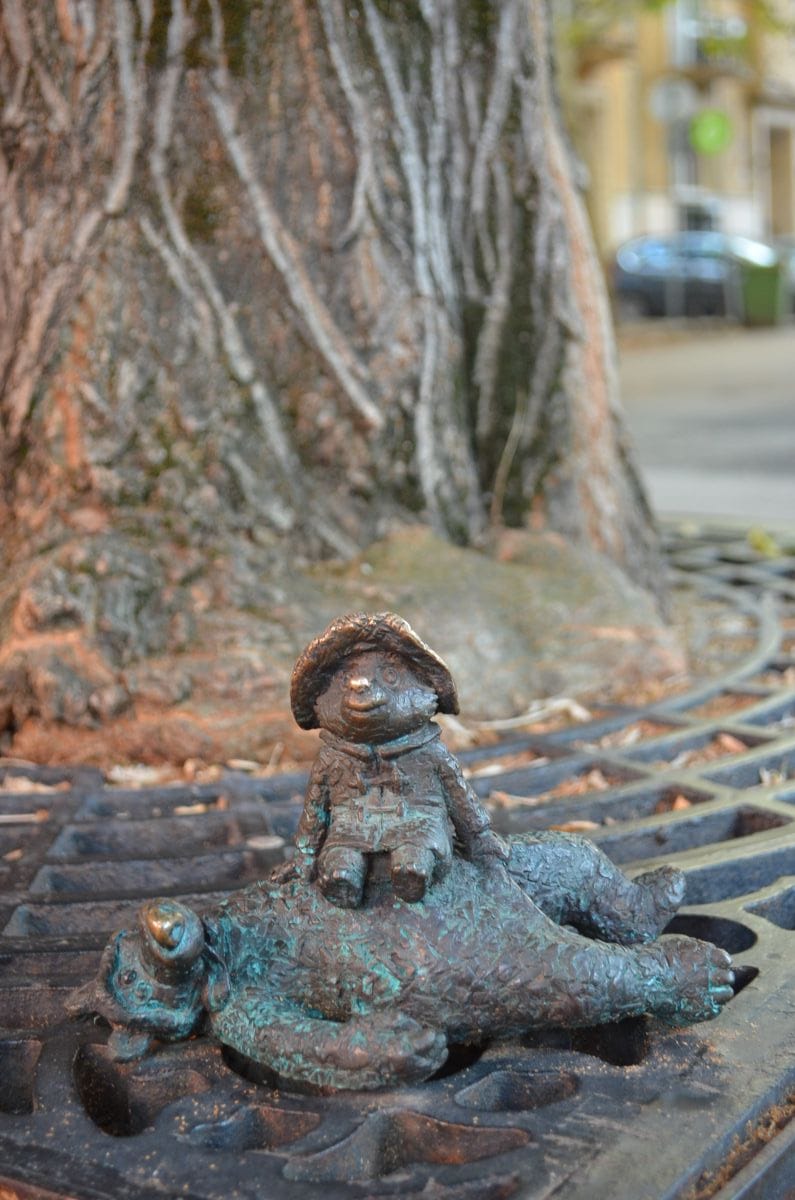
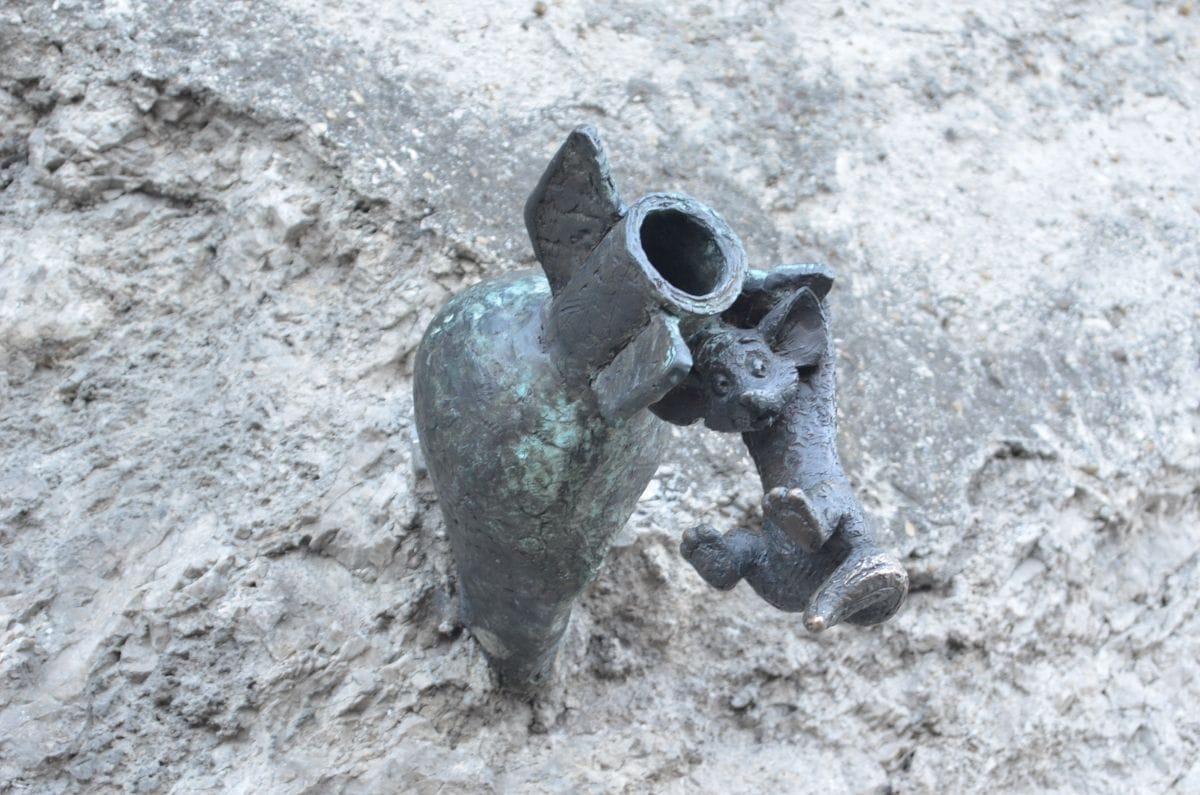
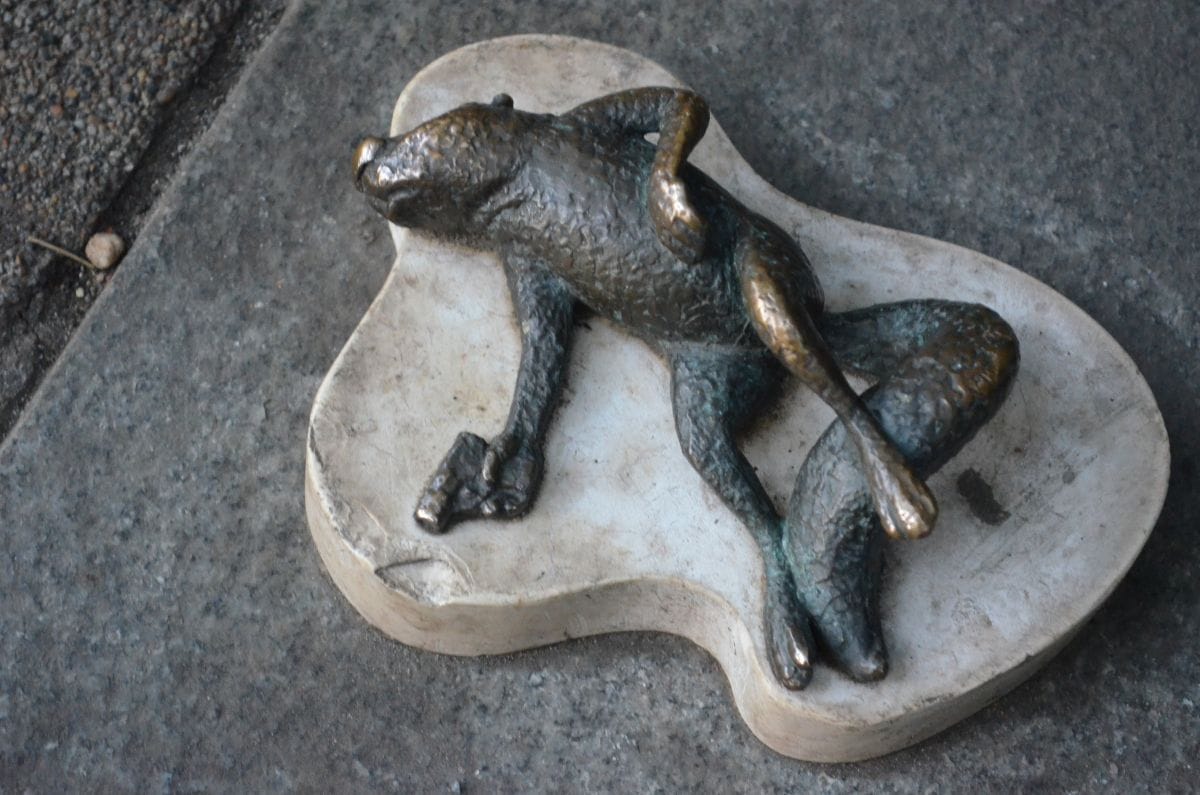
С Пух мечките не се изчерпват – високо на стената на бившето Британско посолство в Пеща е закачено мечето на Мистър Бийн, а под едно старо дърво на „Медве уца“ (улица „Мечка“) в Буда Падингтън седи върху търбуха на мечока от приказката за Маша. Из града са разхвърляни и други създания от книги и филми – жабок (конферансието на мъпетите Кермит), козел (Елек Мек – добронамерен, но нескопосен майстор от стопмоушън сериал за деца от 70-те), червей (също от анимационен сериал, този път за въодушевен рибар), заек (онзи с карираните уши, добре познат и в България – в подстъпите към замъка, недостъпно високо за наболяващото ми коляно), Йода. И лисичето на име Вук – в подножието на хълма Гелерт то виси от опашката на бомба, забила нос в скалата. Любимецът ми обаче е котаракът Гарфийлд.

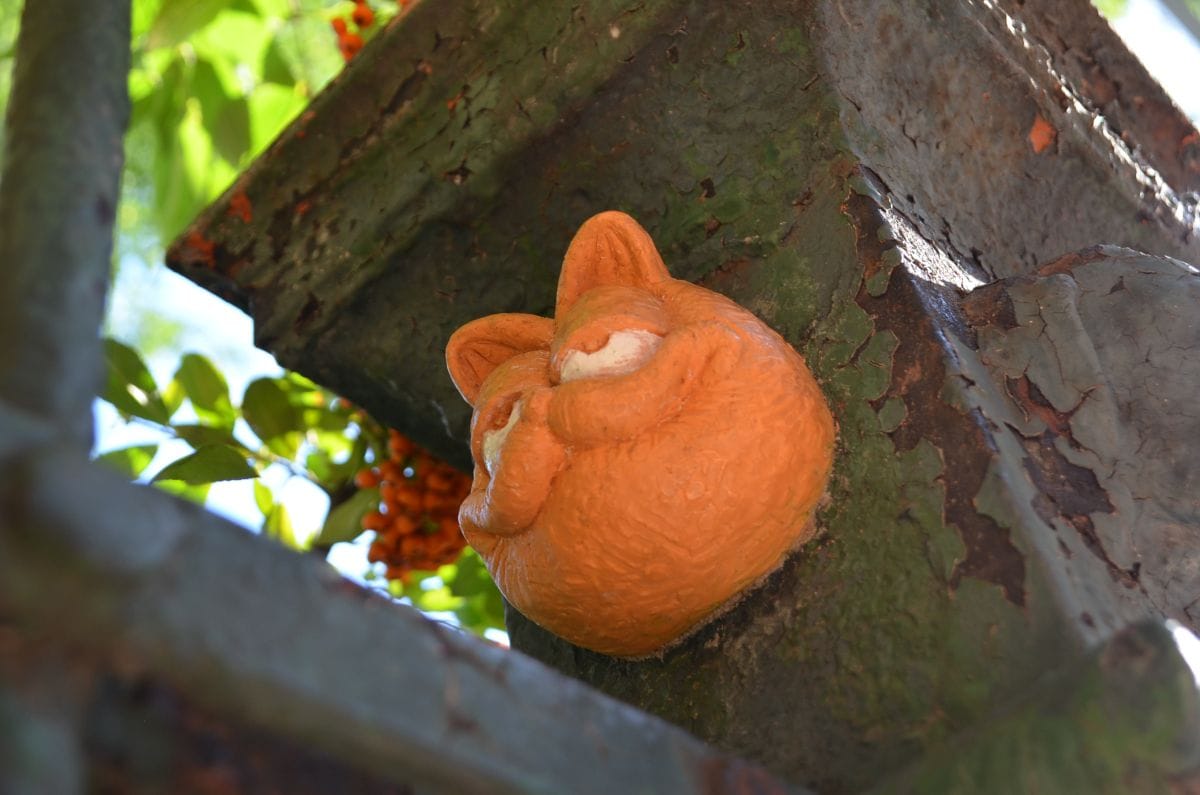
Картата ме праща откъм неправилната страна на улица „Дембински“, където напразно се оглеждам за „дебелия, мързелив и егоистичен“ риж персиец от американския комикс, докато една непозната не схваща какво ме мъчи, и не ме упътва с дрезгави подвиквания на унгарски и къси бипкания откъм отворената си кола. Вървя бавно покрай металната ограда на Университета по ветеринарна медицина и оглеждам колоните, на върха на всяка от които в четири посоки надничат животински муцуни. Комбинациите са различни, някои колони са с по три образа, други с по два, а тук-таме са опадали всичките. Под един изригнал в плодчета огнен трън виждам главите на кон и куче и аха да пропусна третата страна, когато госпожата ме спира с клаксон и подвикване. Отгоре ме зяпа облата апатична физиономия на Гарфийлд и от нея ме напушва смях, който ме държи с километри.

Кубчета и луноходи

Щом научава, че един от любимите му художници – самоукият Тивадар Костка, наричан Чонтвари – е бил гимназист в Ужгород и е обичал да се пързаля на лед, Колодко си наумява да му извае фигурка на кънки. Отива да се допита до свой преподавател, който, ужасѐн от идеята, му обяснява, че за голяма личност не върви малко паметниче. И Колодко почти се отказва. После обаче размисля и първият от няколко мини-Чонтвари изниква край река Уж.

Не разбирах защо любовта не бива да се изразява в малък мащаб…

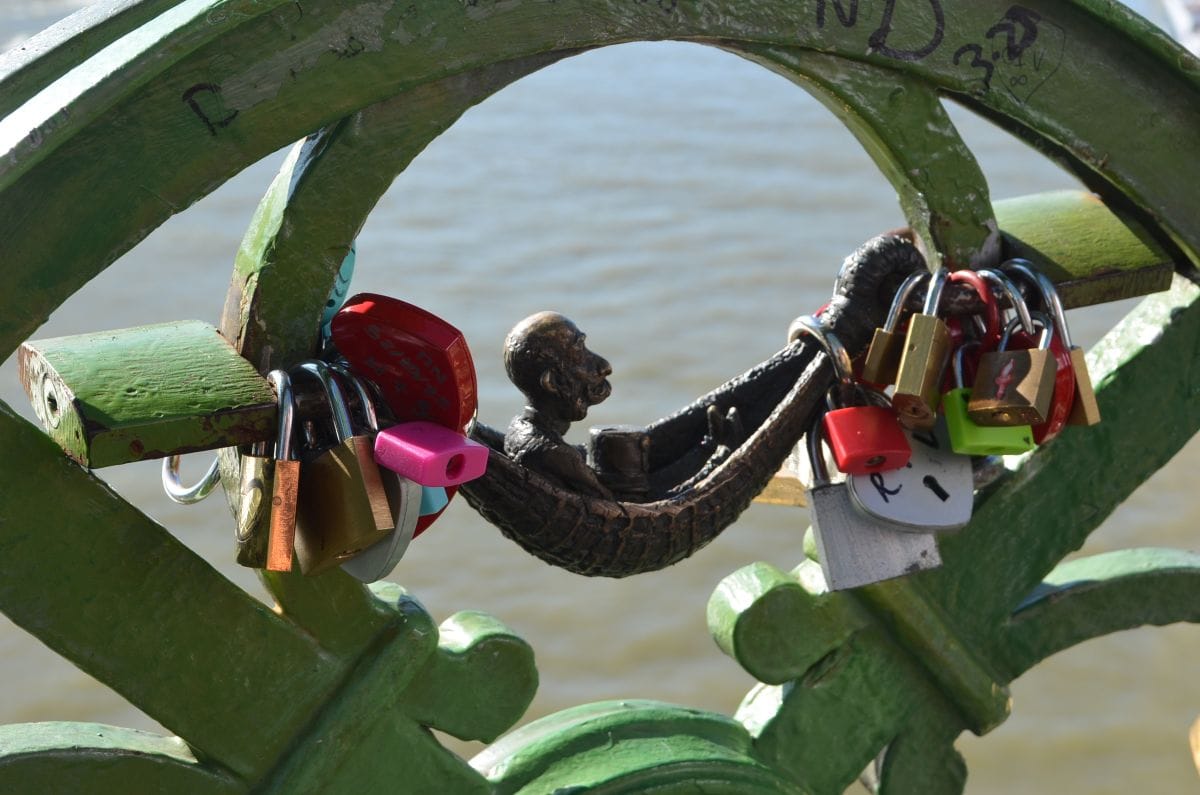
И все пак човешките изображения сякаш са редки в по-новата практика на скулптора – император Франц Йосиф, отпуснат в хамак на Моста на свободата; английската кралица, която маха от покрива на подводница в парка Миленариш; подпийнал римски легионер, опнал късокрако телце край останките от амфитеатър в Обуда; легендарният Чък Норис, овързан с въжета, най-сетне победен… от местната бюрокрация. (През 2006 г. започва строежът на нов мост над Дунава и за името му се обявява конкурс онлайн: насмешливите унгарци масово гласуват то да бъде „Чък Норис“, но – уви! – властите решават в полза на „Медиери“.)

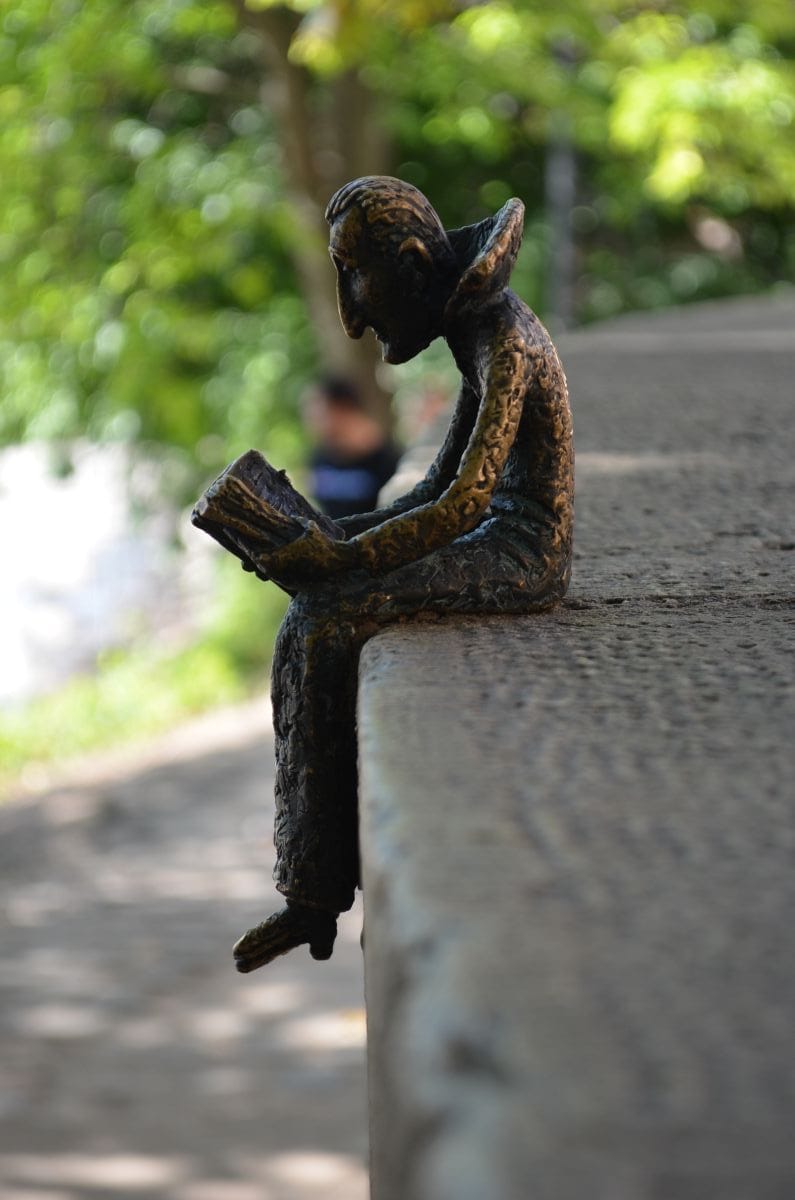
Мил Дракула е седнал на дувар в Градския парк и чете книга (апропо, Бела Лугоши, най-харизматичният актьор в ролята на вампира, е унгарец). Легендарният илюзионист Хари Худини, майстор на драматичните измъквания от усмирителни ризи и безизходни ситуации, е роден под името Ерих Вайс в Будапеща – негова статуйка се намира на „Кирай“, централната улица в еврейския квартал. Сред колодковците, изобразяващи хора, е и поетесата Хана Сенеш – след обучение от британските ВВС през 1944 г. тя скача с парашут в Югославия и се насочва към Унгария, за да саботира нацистите. Заловена е и умира на 23 години след чудовищни изпитания. Фигурката ѝ е разположена над нивото на очите в пресечната точка на улиците „Рожа“ и „Йошика“.

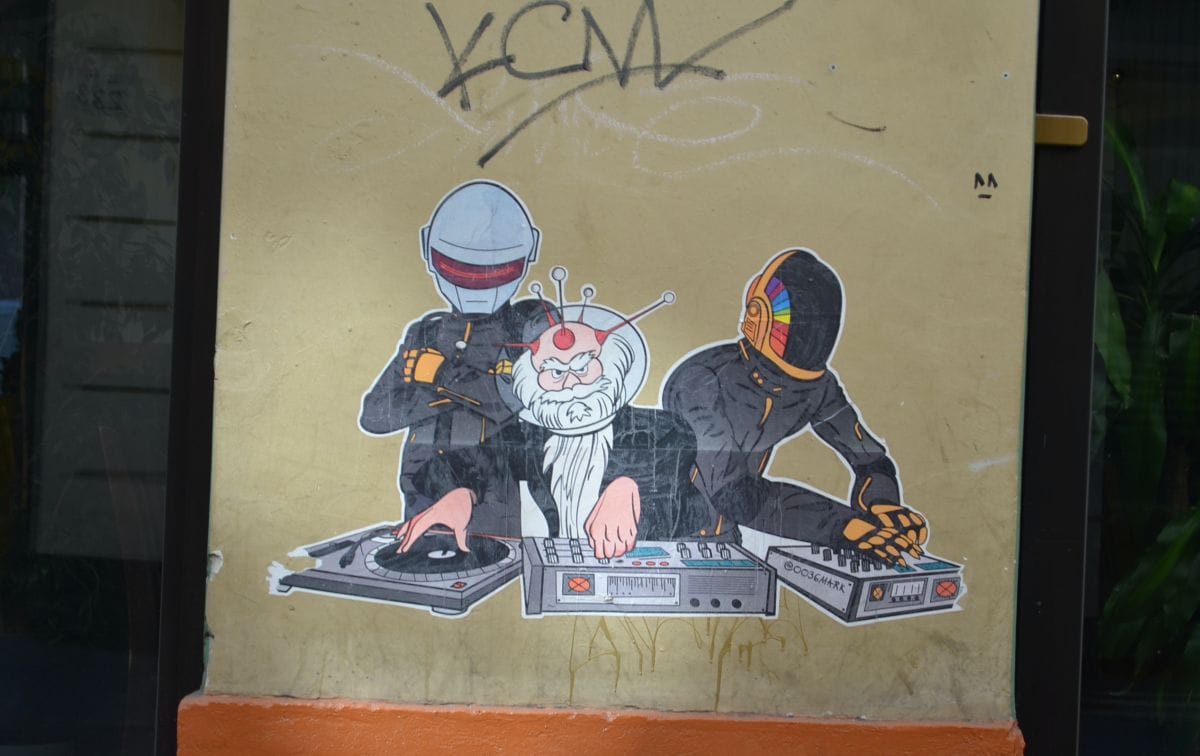
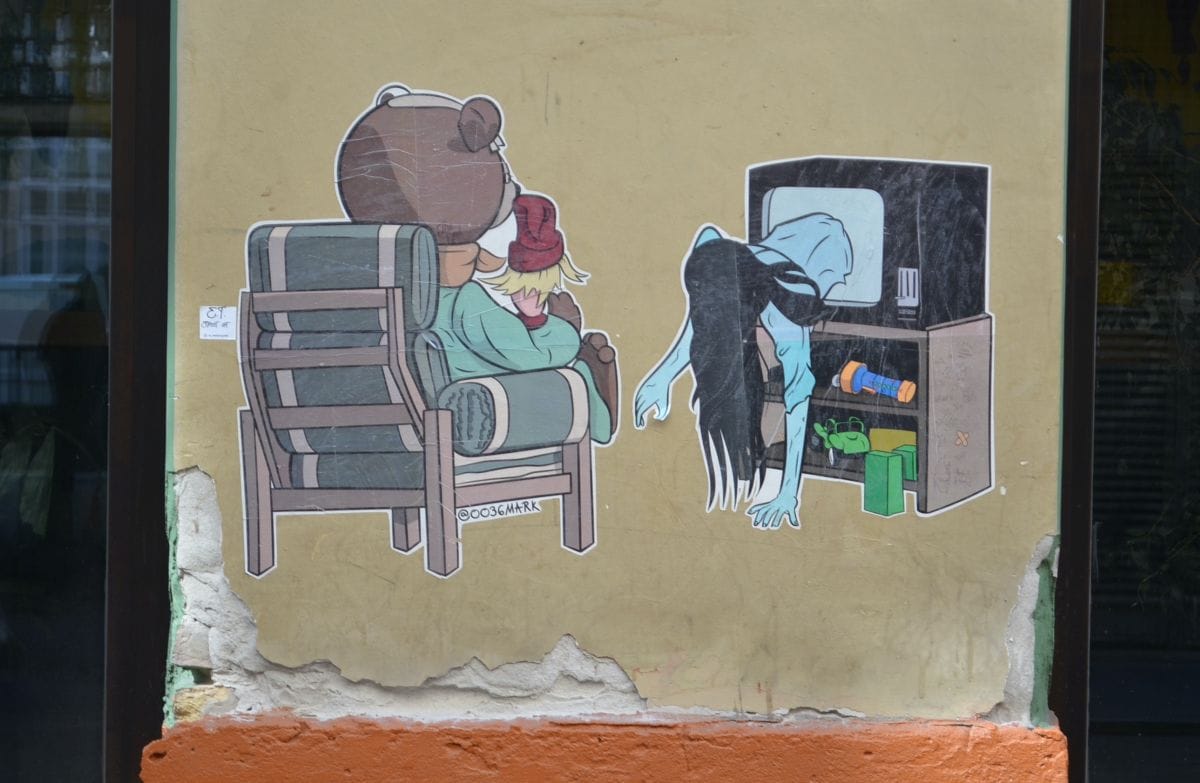
В някогашното еврейско гето – в момента възхаотично туристическо средище – попадам на друг уличен артист, който събира по неочакван начин местни и чужди попкултурни образи. И докато снимам как унгарският Тиви Мечо (нещо като нашия Сънчо от заставката на вечерното „детско“) гледа от телевизора да изпълзява момичето от японския филм на ужасите „Кръгът“, а малко по-нататък Емзеперикс, правнукът на семейство Мейзга, миксира рамо до рамо с „Дафт Пънк“, пред погледа ми изскача барелеф с любопитна форма. Носестият мъж в центъра, разбирам по-късно, е Режьо Шереш, музикант и цирков артист, години наред свирил на пиано в ресторант „Малката лула“, на чиято фасада сега е паметната плоча…

В средата на 30-те една мелодия на Шереш се прославя първо в Будапеща, после в Щатите и оттам по целия свят – Gloomy Sunday. Лошото е, че бъдещият евъргрийн скоро се сдобива с мрачна легенда и тя плъзва след него като сянка през граници и океани – който слуша печалните ноти на неделната песен, разправят, сам отнема живота си. Пресата в няколко държави измисля прякори („усмъртителният хит“, „химнът на самоубийците“), роят се митове и дори забрани… И това – преди дори да дойдат нацистите, Шереш да бъде обречен на години принудителен труд, да оцелее, да бедства в социалистическа Унгария и да загине от собствената си ръка през 1968-ма…

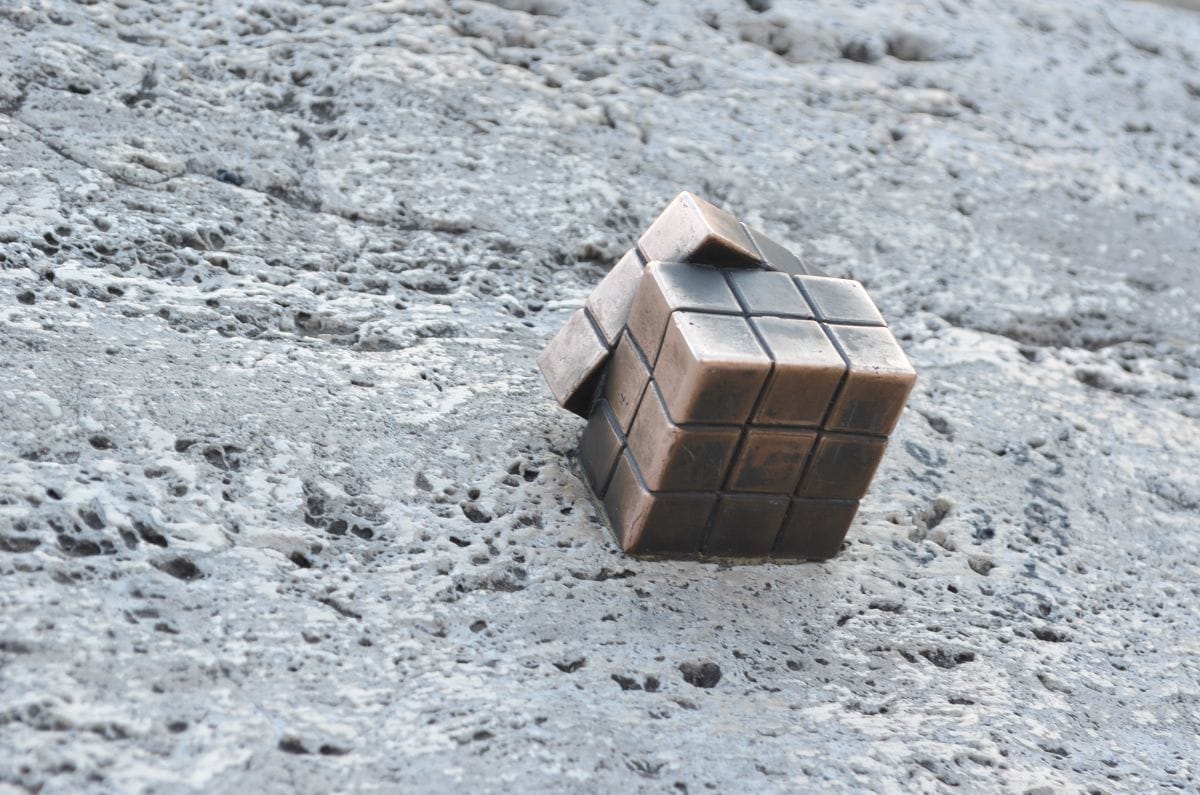
Много по-трудно е да намериш нови въпроси, отколкото отговори,

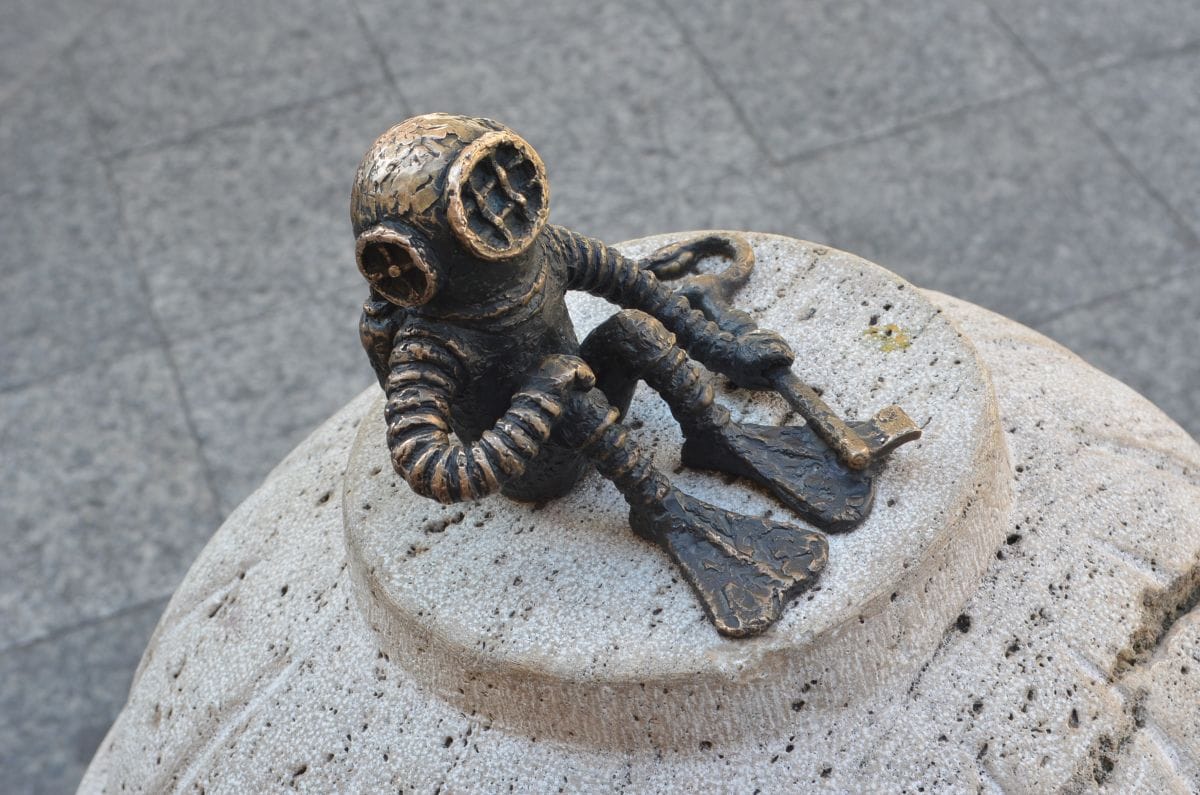
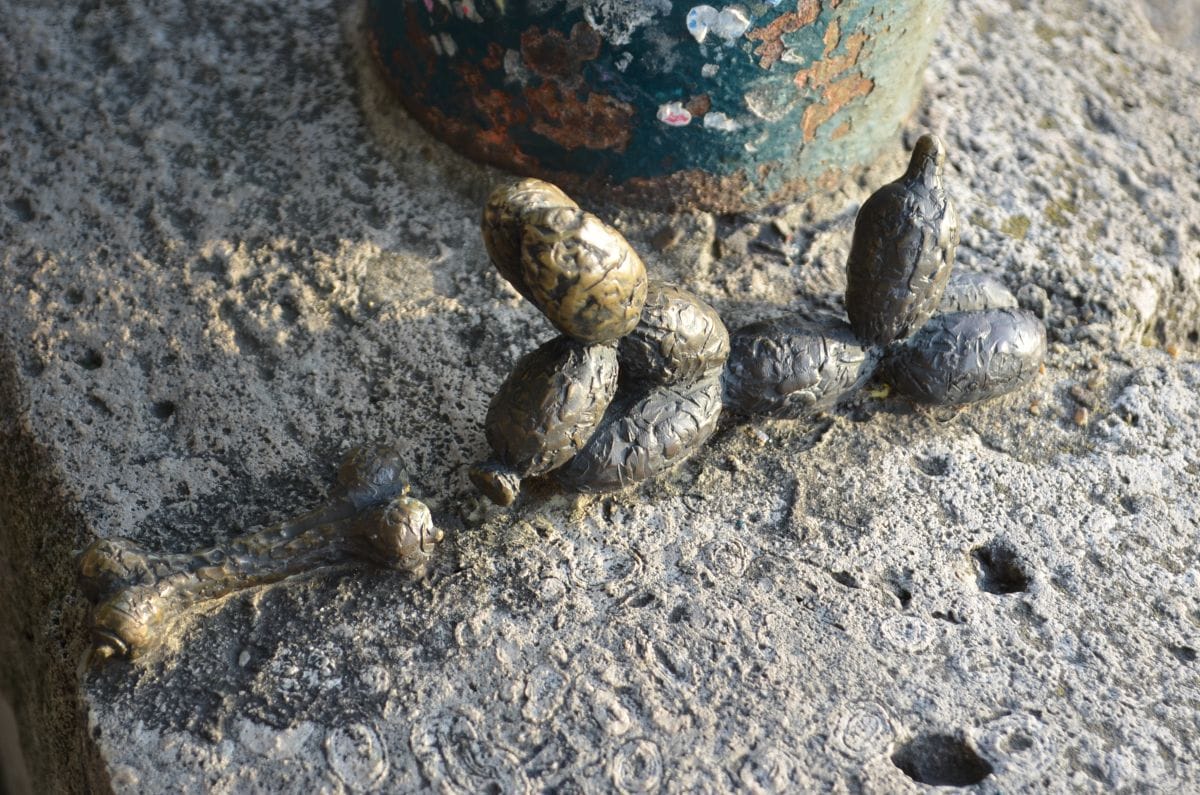
казва архитектът и скулптор Ерньо Рубик, чието прочуто кубче краси в бронзов вид крайречната алея в Буда. Други специфично унгарски теми на Колодко са водолазът с ключа до пищното кафене „Ню Йорк“ (един от гостите на откриването преди 130 години уж бил Ференц Молнар – бъдещ автор на великолепния роман „Момчетата от улица „Пал“, – който толкова се възторгнал, че запокитил ключа му в Дунава, та да стои кафенето завинаги отворено); американският луноход на улица „Холд“ („Луна“), поставен в чест на проектиралия го инженер Ференц Павлич, избягал през печалната 1956-та. И разбира се, лечо. Най-бързото описание на тази вкусна яхния е „унгарският рататуй“ – ето защо Колодко е създал мишок по подобие на страстния гастроном от филма „Рататуй“ и с розов спрей е изписал Lecsó на стената пред него.

Страна огромная, иди на…

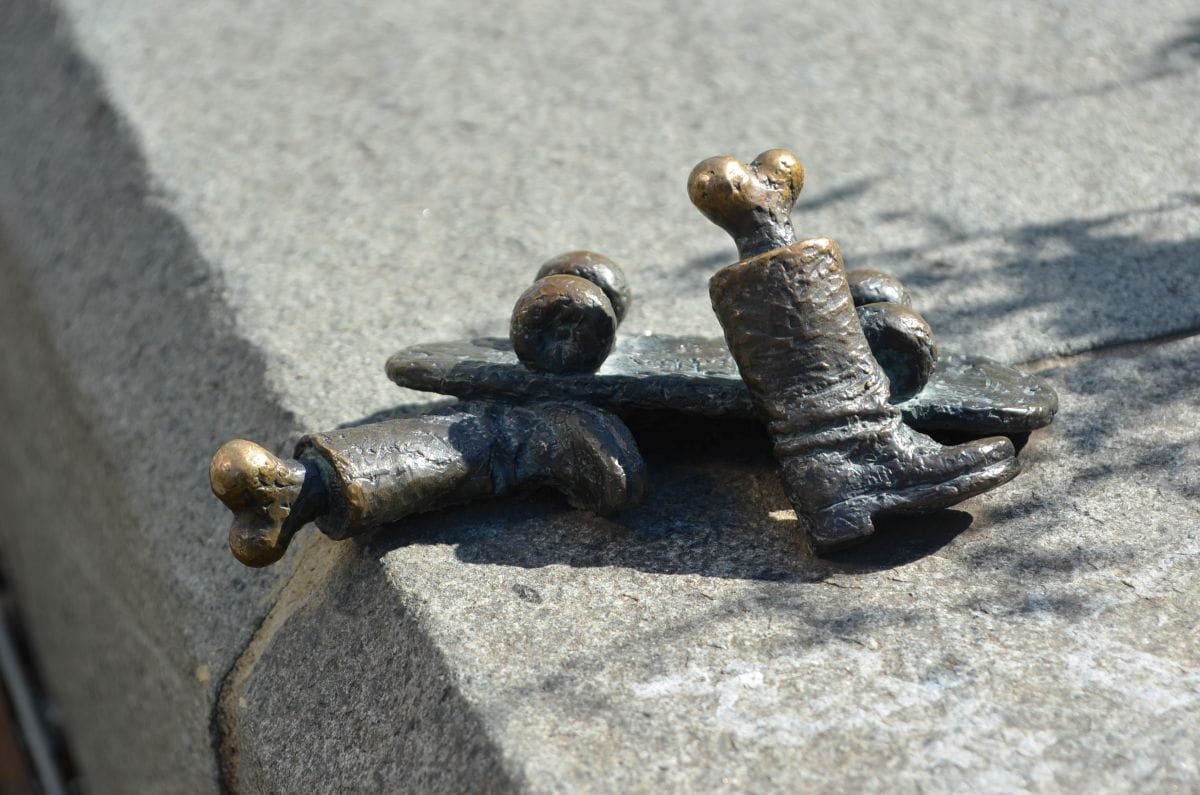
На 23 октомври 1956 г. Унгария се опълчва срещу „народната“ си власт. В отговор на искането за демокрация СССР праща танкове и въстанието е смазано. Убити са почти 3000 унгарци, над 200 000 напускат страната – травмата е жива до ден днешен. „На „Ракоци“, срещу Националния театър, лежеше Сталин. Гигантската статуя е домъкната чак от Площада на героите…“, чете за БНР от записките си поетесата Невена Стефанова. Тя е в Будапеща в първите часове на бунта, когато протестиращи връхлитат паметника на съветския касапин край Градския парк и го събарят така, че на постамента остават да стърчат само ботушите… На три минути от някогашното му място, досами авангардната сграда на новичкия Етнографски музей, Колодко е инсталирал дребен преобърнат скейтборд и чифт ботуши, от които се подават кокали.

Будапеща на Колодко – толкова много истории
„Сталин“ ©Нева Мичева

На площад „Свобода“ все още се издига обелиск, посветен на Съветската армия. Върху градинската ограда срещу него през 2019 г. скулпторът монтира бронзова възглавничка, на която – като корона – почива ушанка с петолъчка. В пристъп на възмущение крайнодесен депутат (от партия, която си дружи с „Възраждане“) записва за социалните мрежи как с брадвичка откъртва шапката и я мята в Дунава. Не след дълго в същата точка от оградата пак се появява възглавничка, сега обаче с брадва отгоре – паметник на агресивните любители на бившия окупант. И не само. На 9 май 2023 г. Колодко комбинира видеото на депутата със свое, в което хвърлената в Дунава ушанка е изпълзяла на жабешки крака от водата като във филм на ужасите и се е намърдала на най-близкото стълбище.


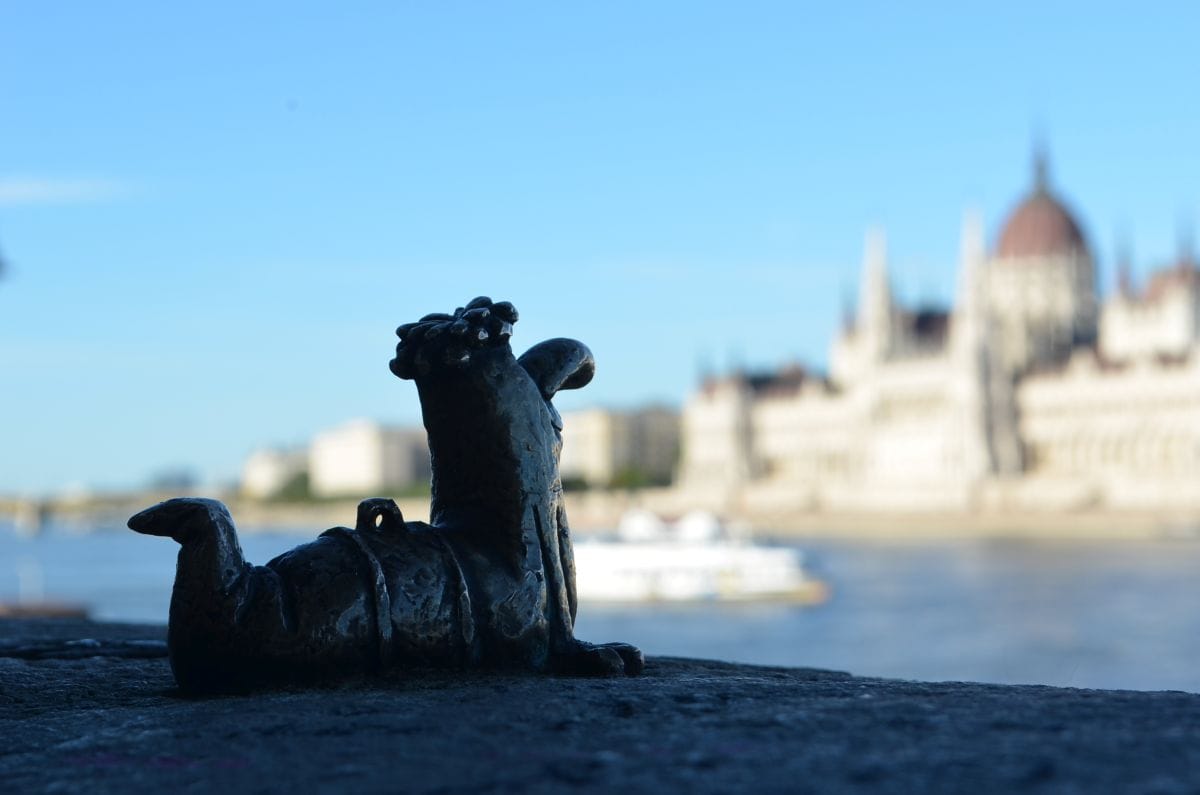
На Русия са посветени още две произведения по крайбрежната откъм Буда. „Тъжният танк“ е увесил дуло срещу изумителната сграда на парламента (златните ръчици на заглавната снимка са на Светла Кьосева, преводачката на най-новия литературен нобелист Ласло Краснахоркаи), а на хълбока му пише: „Руснаци, вървете си вкъщи!“… „Няма компот“ пък препраща към момента, в който в популярната комедия за Втората световна „Младшият сержант и другите“ главният герой търси зимнина в унгарска къща, а заварва скрит червеноармеец с картечница (и ушанка): „Руснаците са вече в килера!“. Колодко коментира:

Дойдат ли в страната ти руснаците, нямат срам – настаняват се като у дома си и ти изяждат всичкия компот!

Доста по̀ на север, след остров Маргит, откъм Пеща, на променадата „Москва“ е щръкнало и „Послание“, увековечило случката със защитниците на Змийския остров от началото на руското нашествие в Украйна: върху бял постамент с формата на огромен среден пръст от малък боен кораб се пули Путин.

Кунс и Кателан

Ars longa vita brevis е в началото на ул. „Фалк Микса“, на две крачки от статуята на инспектор Коломбо (местна чудатост отпреди заселването на Колодко в Будапеща), и представлява изпружена катерица с пистолет в лапата – намигване към препарираната катерица с пистолет от „Бибидибобидибу“ на Маурицио Кателан („Хуморът действа като доброто произведение на изкуството – целта и на двете е да те накарат да се вгледаш и да се замислиш…“, обяснява безцеремонният италианец). „Либидо“ пък – на парапет край реката – е реприз на характерните балонени кучета на Джеф Кунс (някога женен за унгарската порноактриса и италианска депутатка Чичолина). Едно миниписоарче край двореца „Вайдахуняд“ в Градския парк – вече откраднато – отдава почит на революционния „Фонтан“ на Марсел Дюшан, когото също няма как да не цитирам:

Дори по каквито и да било причини да се объркаш да харесаш нещо, което не е за харесване, в обичането има далеч повече хляб, отколкото в мразенето. В смисъл: каква е ползата от мразенето? Хабиш си енергията и умираш по-рано.

Построиш ли мост

Лиса Симпсън (в ролята на Жана д’Арк) е пострадала от атмосферните условия и на снимката стои тъжно; трабантчето с ключе за навиване не ме въодушевява; за най-новия паметник (ловец от сибирското племе ханти, колонизирано някога от руснаците) научавам доста по-късно. Ето как на последния си колодко – току-що изскочил от телевизора Пумукъл, дружелюбно духче от осемдесетарски анимационен сериал – попадам неволно край една хубава стара гимназия в Естергом. Министатуите са не само в Будапеща: има ги в сериозна концентрация в Ужгород, както и – отделни екземпляри – другаде: Риека, Оломуц, Нюрнберг, Стокхолм.

Естергом е дунавски град на час с влак от столицата, а аз минавам през него, защото съм 65-тата „пазителка на моста“, свързващ го с отсрещното словашко градче Щурово, където живея от няколко месеца. Мостът е „Мария Валерия“ – половин километър в зелено над могъщите води – и е наречен на най-малката дъщеря на споменатия по-горе Франц Йосиф. Издигнат е в края на ХIХ век и е разрушаван два пъти – през 20-те и през 40-те, – а най-новият му живот започва през 2001-ва. Иначе казано, досега е съществувал повече в отсъствието, отколкото в присъствието си, и тази мисъл не спира да ме удивлява: построиш ли мост, той си остава факт дори когато е съборен. Моята първа задача по тези чаровни краища е, както казва Карол Фрюхауф, прекрасният съосновател на приютилата ме арт резиденция, да се уверявам всяка сутрин, че мостът си е на мястото. И докато я изпълнявам, не мога да съм по-благодарна – за всичко от този и от онзи бряг.

The collective thoughts of the interwebz