Въпроси и отговори от институциите относно Мартин Нотариуса

Post Syndicated from Bozho original https://blog.bozho.net/blog/4265

В последните два месеца зададохме с колеги от Да, България (Йорданова, Цонева, Мирчев) над 40 въпроса до институциите относно казусите „Нотариуса“ и „Осемте джуджета“, които са фрапантни примери за зависимоститв в съдебната власт. Публикувам пакет с всички тях, като институциите, които питахме, са: прокуратурата, антикорупционната комисия, МВР, бюрото за контрол на СРС, НАП, Агенция по вписванията, МРРБ, МП, ИВСС, СГС.

Дали тези мрежи са имали връзка с политическо влияние – според мен да, но то няма как да се разкрие от документи. Отказите на някои институции да отговорят (или да отговорят по същество), както и състоянието на нормативмата уредба, създаването и отбранявянето на спец съда според мен са индикации за такова.

От отговорите мога да направя следните обобщения:

  • Институциите крият информация от парламента – от пълния отказ на антикорупционната комисия изобщо да отговаря (след един кратък не-отговор в началото), през старателното криене, в нарушение на закона, от страна на МВР на ролята на Нотариуса като секретен сътрудник, през куриозната интерпретация на прокуратурата на правилника на парламента, самоопределяйки исканията по него като искания по друт нормативем акт, през разширително тълкуване на следственатя тайна, до уклончивите и половинчати отговори на някои въпроси.
  • Има голям проблем със СРС-тата (подслушвания, напр.) – оказа се, че веществени доказателствени средства на база на СРС не се унищожават. Никой няма данни за това колко СРС-та са използвани срещу лица извън досъдебни производства, срещу които след това няма повдигнати обвинения. Сигналите за злоупотреби текат от бюрото за контрол през МП до инспектората на ВСС, който отказва да ги проверява. Нотариуса е бил свидетел по дела и най-вероятно е давал съгласие да бъде записван, което е генеритало големи количества СРС-комромати срещу магистрати (и може би не само)
  • Мрежата на нотариуса може да се проследи надълбоко от институциите, ако имат желание – една малка капка от това е справката, която получихме от Търговския регистър за лица, подавали заявления за вписване по фирми на Нотариуса (там излизат познатите имена от разследването на АКФ, но и други). През НАП може да бъде извадена свързаността и парични потоци от фирмите на Нотариуса (не сме питали за това, защото е данъчна и осигутителна информация). Прави впечатление една ревизия на фирма на Нотариуса по искане по прокуратурата. Дали разследващите органи ще потърсят, ще намерят, и ще използват тази информация за да няма повече такива мрежи, зависи от обществения натиск върху тях.
  • Липсва какъвто и да е външен контрол върху секретните сътрудници на МВР (а и на службите). Видно от отказите да се отговори на всякакви въпроси, писмено и устно, оставя единствения контрол на секретните сътрудници да бъде вътрешен в МВР (от инспектората и дирекция „Вътрешна сигурност“). Правило е на дейностите на репресивните органи да има институционален контрол – има бюро за контрол на СРС, има съдебен контрол за актове на прокуратурата, има парламентарна комисия за контрол на службите. Но няма механизъм, по който да се контролира институционално (а не наказателноправно) злоупотребите със секретните сътрудници – те какви задачи изпълняват, тези задачи имат ли политически или компроматни цели и т.н.
  • Има странни действия от страна на ГДБОП около Осемте джуджета. Първо, материалите по разследването са внесени директно във Върховната касационна прокуратура, а не в първоинстанционните – СГП или специализираната първоинстанционна (към онзи момент). МВР не предостави адекватни мотиви за това действие (опитаха да го обяснят с бъдещо закриване на специзлизираната прокуратура, което към момента на предаването дори не е било качено на обществено обсъждане). След това именно ВКП образува производството (според МВР, макар върховната прокуратура да отказа да ни отговори), което е екзотичен подход (общо 61 такива за 10 години). Второ, арестът на Кристиян Христов е преди той да даде пресконференция, като нямаме отговор дали МВР е получило разпореждането от прокуратурата писмено или е било координирано устно.

От всички тези проблеми следва необходимост от законови промени в следните закони, като ще ги вмесем в началото на следващия парламент:

  • Наказателно-процесуалния кодекс – за подобряване на режима на използване на СРС, както и за уточняване на обхвата на следствената тайна и случаите, в които тя може да бъде разкривана при надделяващ обществен интерес
  • Закона за специалните разузнавателни средства – относо относно реда за използване на СРС както в наказателни производства, така и в други случаи, особено с оглед на унищожаването на резултатите от тях, вместо да „залежават“ с компроматни цели
  • Закона за съдебната власт – нужно е да вненим на органите на съдебната власт да водят много по-подробна съдебна статистика по всякакви критерии, на база на които могат да се правят анализи за евентуални злоупотреби (напр. прилагани СРС-та на свидетели, спирания и прекратявания с цел държане „на трупчета“ и т.н.)
  • Закона за МВР – за въвеждане на форма на външен контрол на режима на секретните сътрудници – дали от Министерство на правосъдието, дали като допълнителния функции на бюрото за контрол на СРС, дали парламентарен контрол, или комбинация от горните

Смятам, че свършихме доста работа, за да се заровим в детайлите на механизмите на работа на паралелната власт, която чрез компромати, СРС-та, злоупотреба с наказателно-процесуални действия и секретни сътрудници и да идентифицираме къде трябва да направим промени, за да не се случват повече.

Материалът Въпроси и отговори от институциите относно Мартин Нотариуса е публикуван за пръв път на БЛОГодаря.

Пука ли им на политиците за нас?

Post Syndicated from Емилия Милчева original https://www.toest.bg/puka-li-im-na-polititsite-za-nas/

Пука ли им на политиците за нас?

Хората от Брестовица пак протестират срещу негодната за пиене и ползване вода заради високото съдържание на манган. Близки на убития на столична улица 14-годишен Филип и хора от сдружението „Ангели на пътя“ са на пореден протест за справедлива присъда и срещу пуснатия под домашен арест, който го помете с колата си. От Фондация „Даная“ не спират да протестират срещу управата на „Пирогов“ заради съмнения, че момичето е починало поради неглижиране на случая. Екоорганизации протестират срещу промените на ГЕРБ и ДПС в Закона за насърчаване на инвестициите, които осигуряват бърза писта на проекти с огромно екологично въздействие, 15 години валидност на решенията за ОВОС – вместо сегашните пет – и обжалване само на една инстанция.

Докога с лъжите?

Проблемът в Брестовица е поне от пет години, отпреди държавата да влезе в поредица от шест предсрочни вота за три години. От чешмите тече вода, която съдържа до 20 пъти завишено количество манган при норма от 50 микрограма. Хората излизат на протест, боледуват, пак излизат на протест, а регионални министри, областни управители, политици не спират да обещават. Но дори не са се произнесли откъде е манганът – виновен ли е близкият ВЕЦ, друга ли е причината? А 20-те милиона за проекта за нов довеждащ колектор и ВиК мрежа така и не се намират. 

България е първа от 27-те страни в ЕС по брой смъртни случаи при катастрофи за 2023 г. с 82 жертви на един милион случая при средно за Общността 46 на един милион. Българските политици, все едно кои, са неспособни да решат проблема, който се разраства от десетилетия и отнема живота на толкова хора, сред които и деца. 

Детската болница, обещана през 1978-ма и после през 2004 г., все така не помръдва от идеята да я има. А българите от години доплащат най-много за здраве в ЕС, освен че са с най-ниска средна продължителност на живота. 

България е пълна със стотици проблеми, нерешени от години – негодни пътища, отсечки, на които загиват хора, разрушени мостове, безводие, незаконни сметища, зелени площи, които се застрояват, гори, които се изсичат, и опустошителни наводнения. 

Последните реформи

Политиците лъжат, че ще решат проблемите, а хората проумяват, че на политиците не им пука. Какво виждат гражданите? Самодоволни, самодостатъчни, нечувствителни към социалните проблеми, бюрократизирани и партизирани до крайност персони, бълващи лозунги и декларации вместо истинска политика, боричкащи се политически съперници, устремили се към институционално окопаване… Съешават се в името на компромис(и) и се разделят по избори. Договарят се, скрити от публичното внимание, и се нападат пред камерите и микрофоните. Боят се от реформите, защото ще загубят популярност, гласове и лостове за влияние – затова административната, здравната и образователната реформа са на трупчета, както и съдебната. Обещават децентрализация, но не искат да се лишат от контрола, който им осигурява софиоцентризмът.

Към този ценностен образ на българския политик се прибавя и политическата криза – честите предсрочни избори в последните години, които обезсмислят всяка стратегическа визия и реализацията ѝ. Затова управляващите залитат към популизма – вдигат пенсии, увеличават заплати. Мизерните пенсии в България безспорно се нуждаеха от повишение, но паралелно с реформа на системата и увеличение на пенсионната вноска, въпреки че подобно решение ще бъде посрещнато със съпротива (едва 11% биха го одобрили). Без административна реформа – намаляване на чиновниците, внедряване на електронни платформи и информационни технологии, системи за управление на качеството и др. – заплатите на чиновниците се вдигат „на калпак“. Безплатното висше образование обаче, както и забраната на рекламите за хазарта няма да бъдат приети от това Народно събрание.

Затова пък предсрочно – през февруари – 49-тият парламент взе решение да повиши с 25 до 30% и възнагражденията в МВР от 1 януари 2025 г., въвеждайки нов механизъм за изчисляването им. Но МВР си е същото – огромният бюджет се изразходва предимно за заплати, „една прослойка от около 6400 човека на ръководни постове взема и заплата, и пенсия“ (Веселин Вучков по БНР) и корупционните скандали не спират. Предстои и заплатите на военните да нараснат с 30% от догодина. 

Това са лесни решения. Управляващите знаят, че са еднодневки, и са безотговорни по отношение на разходите, защото никой няма да им търси сметка. 

Последните смели и болезнени за България реформи бяха извършени по време на управлението на Иван Костов – приватизация, пенсионна реформа, ликвидация на управлявани неефективно и натрупали огромни дългове държавни дружества, начало на здравната реформа. Някои от тези процеси, като работническо-мениджърската приватизация, бяха подложени на критика, а кабинетът на ОДС плати цената за непопулярните мерки. 

Политиците след него така и не намериха смелост, решителност и лидерска устойчивост да продължат с модернизацията на държавата, с усилията за по-голяма демократичност и реална, а не формална отчетност на всички институции, не само на прокуратурата. Сега липсва стабилно мнозинство, което да осигури подкрепа за реформите и гаранции, че ще се проведат без прекъсване.

Преди поредните избори

Предстоят избори и политиците се замерят със скандали за пачки, доклади на временни комисии и чий газ е по-руски. Като се изключат количествата, които идват от Азербайджан, останалият е руски и го внасят посредници, тъй като „Газпром“ прекрати отношенията си с България. Президентът Румен Радев не бърка, като казва, че миналата година чрез посредници са внесени 1,7 млрд. куб. м. Подготвил се е, за да защити 13-годишната сделка с турската държавна компания „Боташ“, сключена от служебния му кабинет и подготвена при негова визита в Турция.

След последния работен ден на депутатите, които излизат в отпуск заради изборите, служебното правителство на Димитър Главчев поема щафетата с „разкритията“, а депутатите подновяват обещанията. Чиста вода за Брестовица, чисти ръце в съдебната система, строги наказания за убийците на пътя, детска болница, нов главен прокурор.

Какво още?

Още.

What’s Up, Home? – Welcome, Zabbix 7.0beta3

Post Syndicated from Janne Pikkarainen original https://blog.zabbix.com/whats-up-home-welcome-zabbix-7-0beta3/27988/

When Zabbix 7.0beta3 got released, I immediately updated my What’s up, home? environment to run it. As usual, the update process was seamless and fast, going through everything in about a minute with my Raspberry Pi 4.

As I updated Zabbix maybe ten minutes ago, these are very real-time impressions of the new version.

The new honeycomb widget

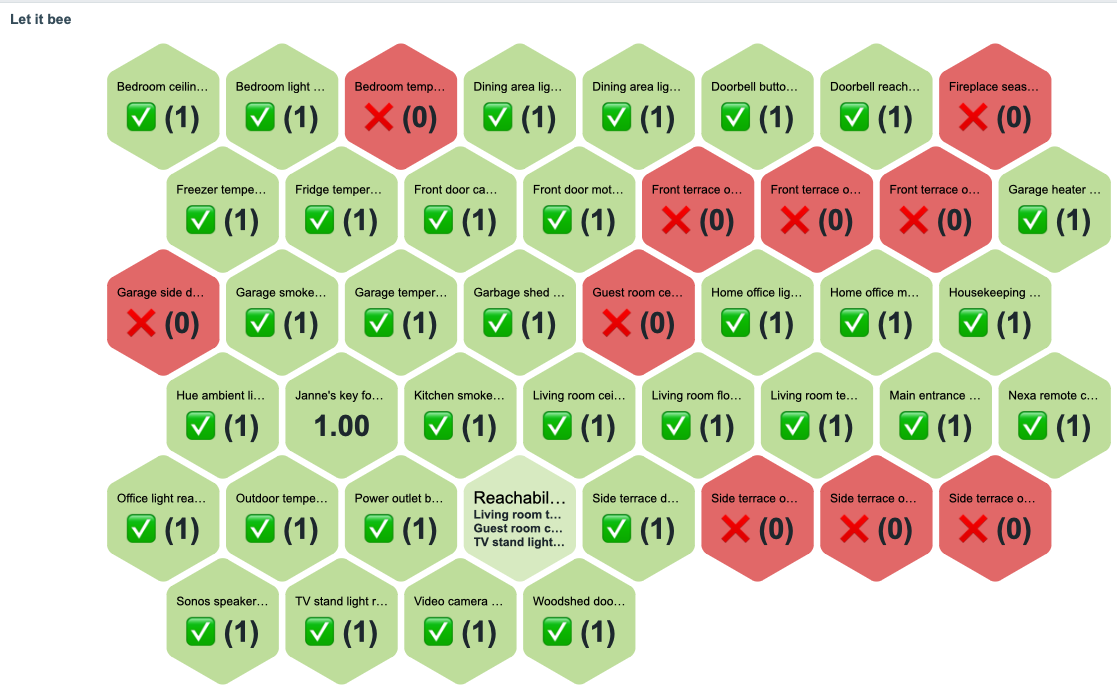
This new honeycomb widget might be useful! Here’s my first try with it, illustrating the reachability status of my IoT devices.

The text shown on widget combs can be modified freely as in the widget advanced config you can put there any Zabbix macro you want.

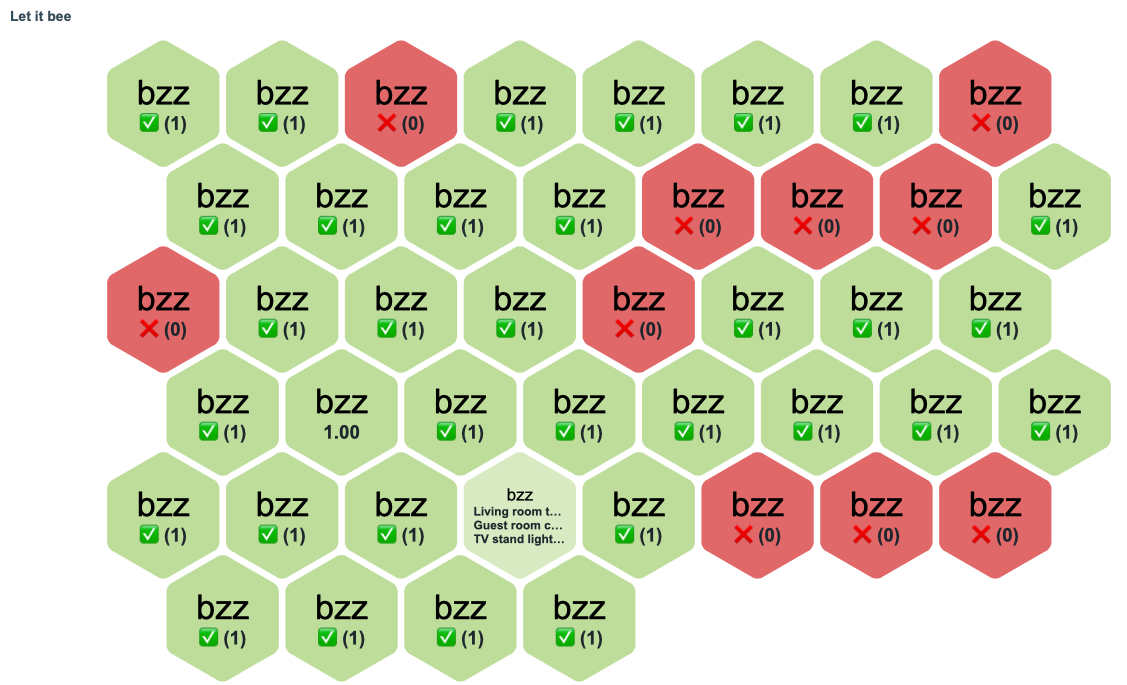
… or if you are such an eternal child that I am, just put there some static text:

The widget supports the new widget communication framework, so whatever item you click there can then be notified by other widgets on the dashboards, to make the experience more interactive.

Versatile host navigator widget

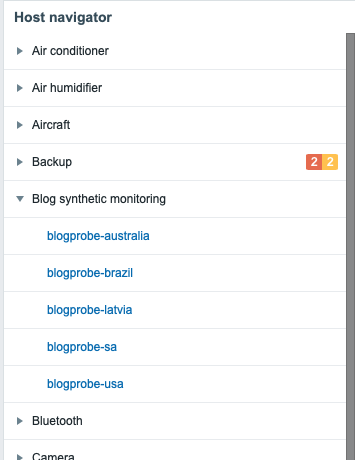
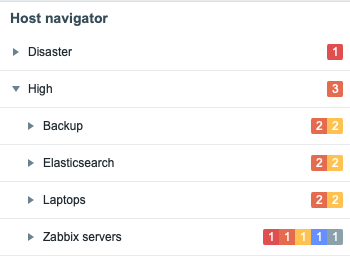
There’s another new widget in town, and its name is Host Navigator. With it, you can create a widget that groups your hosts with any criteria by their host groups, or tag values, and it looks like this.

If you then add new widgets or modify the existing ones on your dashboard to receive events from the Host Navigator widget, the changes on other widgets will be reflected in real time. You can also group the items by using multiple rules, for example, first by severity and then by host group, as shown below.

Nice for quick browsing!

Many more improvements

Underneath there’s more going on, but these two were the most visible additions. Other than that, new icons, Zabbix can now execute trigger actions much faster than before (apparently previously there was ~4 seconds lag, now it’s capable of acting in about 100 milliseconds if I read the ticket right), PDF reporting and streaming to external systems are not experimental anymore.

Another solid release marching towards the final version of Zabbix 7.0. In my home environment, these beta versions have been perfectly stable for me.

This post was originally published on the author’s page.

The post What’s Up, Home? – Welcome, Zabbix 7.0beta3 appeared first on Zabbix Blog.

В началото на юни „Алеф” награждава победителите в единадесетия литературен конкурс

Post Syndicated from Екип на Биволъ original https://bivol.bg/alef-konkurs-burgas.html

петък 26 април 2024


Стойността на човешкия живот и цената, която нашите предци са били готови да платят за неговото спасяване по време на Холокоста отвори врати към знанията и въображението на над 300…

Ухажорът Йонги-Бонги-Бо

Post Syndicated from Тоест original https://www.toest.bg/uhazhorut-yongi-bongi-bo/

Ухажорът Йонги-Бонги-Бо

I

На брега на Коромандел,
дето тиквите гърмят,
вдън гората, по средата
Йонги-Бонги-Бо живя.
Стол разбрицан, къс от свещ,
кана щърба – тоз младеж
имаше едва това.
Сред гората той живя,
имаше едва това.
Туй беше Йонги-Бонги-Бо,
туй беше Йонги-Бонги-Бо. 

II

Веднъж, когато се помъкна
там, дето тиквите гърмят,
не щеш ли, взе че се натъкна
на куп от камък този път.
И ненадейно чу тогаз
жена с чаровен, топъл глас
с кокошките си да говори.
И под носа си промърмори:
„Ах, лейди Джингли Джоунс това е!
Седи връз камъните, зная!
Ах, лейди Джингли Джоунс това е!“ –
си рече Йонги-Бонги-Бо,
си рече Йонги-Бонги-Бо.

III

„О, Джингли, ти, прекрасна дама!
Там, дето тиквите гърмят,
дали съпруга ще ми станеш?
Тъй уморен ми е духът!
Така самотен аз живея
на този бряг чакълест, див,
самичък веч едва съм жив!
Вземи ме ти, аз в теб съм влюбен,
животът ми ще стане хубав!“
Тъй рече Йонги-Бонги-Бо,
тъй рече Йонги-Бонги-Бо.

IV

„На този бряг във Коромандел
скариди и пореч растат,
и евтини, и изобилни!
Гъмжи от риба този кът!
Вземи угарката от свещ,
и стола също! – със копнеж
той рече. – Щърбавата кана!
Като морето любовта ми
дълбока е! Не ще те мамя!“
Тъй рече Йонги-Бонги-Бо,
тъй рече Йонги-Бонги-Бо. 

V

Тогаз кахърно му отвърна,
обляна цяла в сълзи, тя:
„Ах, жалко, но е невъзможно!
Ах, ти ужасно закъсня!
Аз с радост бих се съгласила…“
(и тук закърши пръсти, милата)
„… но в Англия си имам друг
и той ще стане мой съпруг!
За жалост, Йонги-Бонги-Бо,
за жалост, Йонги-Бонги-Бо!

VI

Той, мистър Джоунс, се казва Хендъл.
Кокошки праща ми оттам,
от Доркинг, право от пазара.
Без него ще е зор голям!
Задръж си стола и свещта,
и щърба кана аз не ща,
но нека дружки сме си още!
Щом Хендъл прати ми кокошки,
на тебе цели три ще дам!
Да знаеш, Йонги-Бонги-Бо,
да знаеш, Йонги-Бонги-Бо! 

VII

Макар и да си толкоз хилав,
но с грамаданска пък глава,
и шапката ти все да хвърка –
да знаеш, че е затова!
Макар и да си тъпоумен,
аз исках да намеря думи,
за да се изразя по-меко…
Та, ще си тръгваш ли полека?
Какво да кажа друго нямам,
остава да се махнеш само!
Това е, Йонги-Бонги-Бо,
това е, Йонги-Бонги Бо!“ 

VIII

По хлъзгавия склон на Мъртъл,
там, дето тиквите гърмят,
наш Йонги-Бонги-Бо си хвана
към тихите морета път.
Зад залив кротко си лежеше
огромна костенурка. Беше
известна с туй, че бързо плава.
Какво на него му остава?
„Ха, ето кой ще ме спаси!
Я ти на гръб ме понеси!“
Тъй рече Йонги-Бонги-Бо,
тъй рече Йонги-Бонги-Бо.

IX

Из океана, що бушува
и кротва се, и се снишава,
със Йонги-Бонги-Бо на гръб
чевръсто костенурка плава.
Към остров Бошен тя го кара
и със движения прастари,
печални, плава, накъдето
потъва слънцето в морето.
„Прощавай, лейди Джингли, сбогом!
Без тебе да живея мога!“ –
тъй пя си Йонги-Бонги-Бо,
тъй пя си Йонги-Бонги-Бо. 

Х 

А на брега на Коромандел
онази дама си остана
и тя за Йонги вечно жали
там, върху купчината камък.
Затуй в нащърбената кана
тя сълзи рони. Отзарана
и камънака там измива,
като със сълзи го облива.
И прегъната на две,
на кокошките реве
тя за Йонги-Бонги-Бо,
тя за Йонги-Бонги-Бо.

Едуард Лиър
Превод от английски Светлана Комогорова – Комата


Едуард Лиър (1812–1888) е английски поет, писател, художник, илюстратор и музикант, автор на няколко популярни сборника с нонсенс стихотворения, разкази и песни. Роден е в Холоуей, Северен Лондон, и е предпоследното от 21 деца на Ан Кларк Скерет и Джеремая Лиър. Известен е най-вече със своите нонсенс поетични и прозаични творби и особено с лимериците – форма, която той популяризира. За произведенията му е характерна изключителната езикова изобретателност. Като музикант е единственият автор на песни по текстове на Алфред Тенисън, чиято музика самият Тенисън е одобрил. Много свои нонсенс текстове също претворява в песни, включително и „Ухажорът Йонги-Бонги-Бо“. Известен е и с това, че се представя с дългите псевдоними Mr Abebika kratoponoko Prizzikalo Kattefello Ablegorabalus Ableborinto phashyph или Chakonoton the Cozovex Dossi Fossi Sini Tomentilla Coronilla Polentilla Battledore & Shuttlecock Derry down Derry Dumps.

Светлана Комогорова – Комата (р. 1968) е преводачка, поетеса, певица и автор на песни. Носителка на Специалната награда „Кръстан Дянков“ (2010) за превода на „Шантарам“ от Грегъри Дейвид Робъртс; номинирана два пъти за наградата „Евроком“ за превод на фантастика, както и за наградата „Христо Г. Данов“ (2005) за превода на „Лед“ от Владимир Сорокин. Много обича Луис Карол, а най-любимите ѝ произведения са „Алиса в страната на чудесата“ и „Алиса в огледалния свят“. Авторка е на два напълно различни превода на двете книги – единият, съвместен със Силвия Вълкова, е публикуван за първи път през 1996 г. от издателство „Дамян Яков“ и оттогава е преиздаван няколко пъти, а другият – през 2022 г. от издателство „Хеликон“. Изпитва подчертано и невъобразимо влечение към нонсенса в литературата и в изкуството изобщо.


Според Екатерина Йосифова „четящият стихотворение сутрин… добре понася другите часове“ от деня. Убедени, че поезията държи умовете ни будни, а сърцата – отворени, в края на всеки месец ви предлагаме по едно стихотворение. Защото и в най-смутни времена доброто стихотворение е добра новина.

Българската „чужбина“ – едно мечтано и непознато място

Post Syndicated from original https://www.toest.bg/bulgarskata-chuzhbina-edno-mechtano-i-nepoznato-myasto/

Българската „чужбина“ – едно мечтано и непознато място

Една от най-интересните теми в практиката и теорията на превода, поне за мен, е

въпросът, свързан с така наречените „непреводими“ думи.

За такива се смятат понятия, често обозначаващи абстрактни усещания, състояния или изживявания, които съществуват в конкретни езици, но нямат директен еквивалент, чрез който лесно могат да бъдат предадени на други езици.

Някои от тези „непреводими“ думи с течение на времето навлизат и започват да се използват, без да се превеждат, в други, несходни езици, включително и в българския. Такива например са португалската „саудаде“, немската „цайтгайст“, датската „хюга“, испанската „дуенде“, японската „умами“ и френското словосъчетание „жоа де вивр“.

Ситуацията се усложнява, когато въпросната „непреводима“ дума все още не е придобила универсална разпознаваемост. В тези случаи преводачът има няколко възможни хода: да остави думата, както си е в оригинала, разчитайки, че значението ѝ ще се разбере от контекста (каквато е англоезичната традиция), или да сложи дефиницията ѝ в бележка под линия (каквато е българската); да я обясни с повече думи в самия текст; да я преведе със сходна, макар и не съвсем точна дума, която съществува в приемния език.

Най-интересни – и коварни – обаче са случаите, в които се налага да бъде преведена определена дума, която принципно има директен „еквивалент“ в приемния език, но той не обхваща всичките възможни културни значения, социални конотации и исторически натрупвания, които се съдържат в оригиналното понятие.

Това, разбира се, е съвсем нормална част от процеса на превода. И всъщност се случва много по-често, отколкото бихме могли да предположим – дори и с най-обикновени и всекидневни, направо насъщни думи, които на пръв поглед може да изглеждат напълно взаимно преводими.

Българският „хляб“ например незадължително се равнява на френския pain, който пък незадължително е еквивалент на индийския „наан“, който пък не е идентичен с ивритския „маца“.

И така нататък. 

Ето защо, когато преди известно време американското онлайн издание Hopscotch Translation ме покани да споделя случай от моята преводаческа практика, като напиша текст за дума, която смятам за непреводима, аз реших – вместо за очевидно „непреводима“ българска дума – да разкажа за понятие, което на пръв поглед има ясен превод и директни еквиваленти на повечето езици. А именно думата „чужбина“.

В щедрата си рецензия на английския ми превод на сборника „Куфарът на брат ми“ (изд. ICU) преводачката Изидора Анжел споделя, че би ѝ се искало да съм оставила думата chujbina на български, без да я превеждам – като

жужащата комбинация от срички, която завинаги остава екзотичен източник на страстно увлечение, вечно копняна и недостижима.

Коментарът на Изидора е съвсем резонен. Макар на теория българската дума „чужбина“ да си има директен английски превод, който речникът с готовност ни предоставя, английската abroad всъщност не улавя пълната гама от конотации на българското понятие, нито пък успява да предаде

огромната власт, която думата „чужбина“ упражнява върху сърцата, умовете и колективното съзнание на много българи.

За тях думата „чужбина“ често означава много повече и по-сложни неща от това, което на английски се разбира под abroad и което чисто и просто обозначава намиращото се отвъд физическите граници на България. За много от живелите през комунизма български граждани думата обхваща възвишени идеи за свобода, справедливост и демокрация, но също така служи и като определение за конкретен стандарт на живот и събирателен термин за базисни, но като цяло недостъпни (и съответно силно желани) потребителски стоки, храни, услуги и удобства. 

Именно по време на комунизма понятието „чужбина“, въпреки че съществува в българския език от много по-рано (няма как тук да не споменем Ботевата „тежка чужбина“), заживява нов живот. Както казва Изидора, правейки препратка към Фернандо Песоа, точно в този период чужбина се превръща в

страната фантом […] която вечно е митът, нищото, което е всичко.

В ежедневния език през ерата на комунизма думата „чужбина“ се използва почти изключително като определение на капиталистическия Запад и много по-рядко във връзка с други комунистически страни или други части на „развиващия се“ свят. Самият български комунистически режим също използва думата най-вече по отношение на същия този Запад, въпреки че институционалната употреба включва и известен нюанс на опасност и враждебност.

Ако се вгледаме в етимологията на думата, ще открием, че още в самия си строеж тя съдържа намеци за опасност и враждебност. Коренът ѝ идва от праславянската дума *ťuďь (‘чужди хора’) и служи като основа на цяла поредица от сродни думи, които също притежават „недружелюбна“ конотация, например „чужд“, „чужденец“, а даже и „отчуждение“, както и моя личен фаворит „чуждица“¹.

Интересно е, че докато коренът на „чужбина“, изглежда, почива на някаква субективна емоция и индивидуално възприятие, английските еквиваленти на думата са основани по-скоро върху факти. Етимологията на термина abroad е пространствена, от староанглийското словосъчетание on brede, буквално означаващо „нашир“. Другият възможен превод на „чужбина“ като overseas, който буквално значи „отвъд морето“, очевидно се основава на географски понятия и възприятия².

Като елемент от българското колективно съзнание думата „чужбина“ има и едно допълнително преимущество: тя идеално се римува и има същия брой срички като антонима си „родина“. За разлика от българските понятия, съответните английски еквиваленти на двете думи – abroad и homeland – не споделят никакво сричково, ритмично или звуково родство.

Идеята за „чужбина“ преминава през „Куфарът на брат ми“ като лайтмотив – това не е изненадващо, като се има предвид, че сборникът, чието подзаглавие гласи „Истории за пътя“, е посветен на темите за миграцията, имиграцията и емиграцията. В общо 239-те страници на оригиналната българска версия на книгата думата се появява общо 33 пъти, които включват и няколко необичайни форми: три пъти в множествено число („чужбини“) и веднъж членувана („чужбината“).

В повечето от тези случаи думата се използва повече или по-малко неутрално, което моят английски превод отразява, предавайки я като abroad. На няколко места обаче преводът на „чужбина“ като abroad не улавя цялата палитра от нюансирани значения на оригиналното понятие и не успява да пренесе – така да се каже – тежкия багаж, с който българската дума е натоварена.

Първият такъв случай, който и самата Изидора визира в своята рецензия, е в текста на Георги Господинов. Там той споделя преживяване от детството си:

Спомням си как като деца тичахме подир самолетите с брат ми и махахме с ръка. […] Надявахме се един ден да се качим на самолет и да стигнем до държавата Чужбина, макар брат ми да твърдеше, че на картата такава няма.

Коментарът на Изидора, че тук би било удачно думата да остане непреведена като Chujbina е съвсем намясто, тъй като това поне би намекнало, че терминът съдържа много по-сложна мрежа от значения и конотации от тези, които понятието Abroad успява да обхване.

Друг пример, при който преводът на „чужбина“ като abroad не успява да предаде сложността на оригинала съвсем успешно, е в обширното есе на Димитър Камбуров, в която думата се споменава цели 21 пъти. Имайки предвид тази забележителна честота, както и факта, че и четирите граматически изключения, споменати малко по-горе, се появяват точно в този текст, може да предположим, че за Камбуров думата „чужбина“ е интелектуално понятие, а даже и екзистенциално състояние, много по-обширно, дълбоко и концептуално от това, което abroad сигнализира просто като място, разположено отвъд границите на родната му страна. И докато за Господинов „Чужбина“ е чужда страна, то „чужбините“ на Камбуров често се отъждествяват с жени.

В един забележителен пасаж от неговия текст думата се появява три пъти в непосредствена близост, паралелно с една „чужденка“, която се оказва и „чужда жена“:

… стипендията ми в Будапеща се случи съвършено друг вид чужбина. Чужбина като чужденка. Чужбина като чужда жена.

В този откъс, преводът на „чужбина“ като abroad би разрушил ясно видимите в оригинала звукови и етимологични връзки между думите – по тази причина, в превода си аз реших да стъпя върху общия им „чужд“ корен. Стремейки се да възпроизведа ритмичните и речитативни качества на оригинала, съм се опитала да запазя някои от повторенията (и дори съм добавила едно, което не съществува в оригинала), така че преводът ми гласи:

… my fellowship in Budapest became a completely different type of foreign country. A foreign country like a foreign woman. A foreign country like another man’s woman.

Третият случай, където думите „чужбина“ и abroad не са напълно взаимнозаменяеми, се намира – случайно или не – в текста, с който самата аз участвам като автор в сборника. Забележителното в случая е, че докато „чужбина“ присъства веднъж в българската версия и abroad – веднъж в английската, двете думи всъщност се появяват на съвсем различни места в двата текста.

В българския оригинал „чужбина“ се споменава като част от списъка със „смразяващи кръвта задължения“, отпечатани върху задната корица на първия ми, издаден през 1985 г. международен паспорт. Според едно от тях притежателят на документа „е длъжен… да се регистрира в съответното дипломатическо или консулско представителство на НРБ в чужбина“. Преценявайки, че този подробен списък с инструкции би отегчил англоезичния читател, в английския превод съм решила (подобни радикални решения си позволявам само като превеждам мои собствени текстове) да пропусна откъса изцяло, така че той напълно отсъства от английската версия.

Тя обаче включва думата abroad на съвсем различно място – като превод на друга българска фраза – „зад граница“, която през комунизма също се радва на голяма популярност и подобно на „чужбина“ съдържа както елемент на копнеж, така и лек нюанс на провинциалност. И докато в оригинала съм поставила фразата в кавички, в опит да я маркирам и иронизирам, в превода съм я предала без кавички, просто като abroad, избирайки да не разсейвам и обърквам англоезичния читател с непонятни за него конотации.

Последното място в антологията, където вероятно щеше да бъде по-подходящо думата „чужбина“ да остане в оригинал, е в началото на есето на Едгар Вилянуева, което той първоначално е написал на испански, а впоследствие Нева Мичева е превела на български. За моя английски превод използвах както българския превод на текста, така и оригинала – поне доколкото ми позволиха моите (признавам, ограничени) познания по испански.

В английската си версия съм предала mi primera noción del extranjero на Вилянуева и „първата ми идея за „чужбина“ на Мичева като my first notion of “abroad”. Даже несъзнателно съм репродуцирала решението на Нева Мичева допълнително да акцентира върху „чужбина“ като концептуално понятие, поставяйки думата в кавички, които всъщност липсват в оригинала.

Ако съдим по това дали успешно предава смисъла на оригинала, преводът ми е съвсем приемлив. Обръщайки се с нов поглед към него сега обаче, съжалявам, че дори не съм обмислила като потенциално решение да използвам испанската думата extranjero в английската версия. Това би било начин да се запази следа от езика, на който текстът е бил написан първоначално, но също така би осветило концептуалната връзка между испанското extranjero и българската „чужбина“, тъй като – за разлика от abroad – и двете думи споделят идеята за чуждост/странност в корените си.

Сега също така забелязвам, че Вилянуева описва първата си noción del extranjero като un lugar soñado y desconocido, което Нева Мичева превежда по-поетично като „мечтано и невиждано място“, а аз – по-буквално като a dreamed-of and unknown place, тоест „мечтано и непознато място“. Тези описания са особено ценни – не само защото успяват да предадат значението на самата дума, но и защото идеално изразяват невъзможността тя да се преведе от един език на друг еднозначно.

1 Идеята за враждебност се е промъкнала и в лингвистиката. Според българските тълковни речници чуждицата е „ненужно заета дума от чужд език, която има съответствие в родния“. Когато обаче става дума за използване на чужда дума без съществуващ еквивалент в българския, се използва терминът „заемка“, който е сходен и с английското понятие loan word, буквално „заета дума“. Друг подход към въвеждането на чужди думи е така наречената „калка“ – по ирония на съдбата заета от френски (calque ‘копирна хартия’), – която означава дума или израз, заети от друг език чрез буквално превеждане („копиране“) дума по дума или корен по корен. Хубав пример за двете понятия е случаят с немската дума Schadenfreude, която се използва на английски, без да се превежда, докато на български съществува като „злорадство“.

2 Любопитно е, че английско-българските речници предлагат „чужбина“ като превод на думата overseas, а българско-английските не предлагат overseas като превод на „чужбина“. В този контекст си струва да помислим върху начина, по който историята и географията на местата, откъдето двете думи произлизат, се е отпечатал върху тяхната етимология. Произходът на думата overseas вероятно е свързан с факта, че Великобритания е остров – появата на термина в края на XVI век напълно съвпада, със сигурност неслучайно, с началото на британския колониализъм, а по време на Първата световна война думата overseas придобива популярност като евфемизъм за „колониален“. В контраст с това, както свидетелства споменатото по-горе стихотворение на Христо Ботев „На прощаване в 1868 г.“, за българите „чужбина“ се намира точно от другата страна на Дунава.


В рубриката „От дума на дума“ Екатерина Петрова търси актуални, интересни или новопоявили се думи от нашето ежедневие и проследява често изненадващия им произход, развитието на значенията им във времето и взаимовръзките им с близки и далечни езици.

[$] Python JIT stabilization

Post Syndicated from daroc original https://lwn.net/Articles/970397/

On April 11, Brandt Bucher posted
PEP 744 (“JIT Compilation”),
which summarizes the current state of Python’s new
copy-and-patch just-in-time (JIT) compiler
. The JIT is currently
experimental, but the PEP proposes some criteria for the circumstances under which it
should become a non-experimental part of Python.

The discussion
of the PEP hasn’t
reached a conclusion, but
several members of the community have already raised questions
about how the JIT would fit into future iterations of the Python language.

Orchestrate an end-to-end ETL pipeline using Amazon S3, AWS Glue, and Amazon Redshift Serverless with Amazon MWAA

Post Syndicated from Radhika Jakkula original https://aws.amazon.com/blogs/big-data/orchestrate-an-end-to-end-etl-pipeline-using-amazon-s3-aws-glue-and-amazon-redshift-serverless-with-amazon-mwaa/

Amazon Managed Workflows for Apache Airflow (Amazon MWAA) is a managed orchestration service for Apache Airflow that you can use to set up and operate data pipelines in the cloud at scale. Apache Airflow is an open source tool used to programmatically author, schedule, and monitor sequences of processes and tasks, referred to as workflows. With Amazon MWAA, you can use Apache Airflow and Python to create workflows without having to manage the underlying infrastructure for scalability, availability, and security.

By using multiple AWS accounts, organizations can effectively scale their workloads and manage their complexity as they grow. This approach provides a robust mechanism to mitigate the potential impact of disruptions or failures, making sure that critical workloads remain operational. Additionally, it enables cost optimization by aligning resources with specific use cases, making sure that expenses are well controlled. By isolating workloads with specific security requirements or compliance needs, organizations can maintain the highest levels of data privacy and security. Furthermore, the ability to organize multiple AWS accounts in a structured manner allows you to align your business processes and resources according to your unique operational, regulatory, and budgetary requirements. This approach promotes efficiency, flexibility, and scalability, enabling large enterprises to meet their evolving needs and achieve their goals.

This post demonstrates how to orchestrate an end-to-end extract, transform, and load (ETL) pipeline using Amazon Simple Storage Service (Amazon S3), AWS Glue, and Amazon Redshift Serverless with Amazon MWAA.

Solution overview

For this post, we consider a use case where a data engineering team wants to build an ETL process and give the best experience to their end-users when they want to query the latest data after new raw files are added to Amazon S3 in the central account (Account A in the following architecture diagram). The data engineering team wants to separate the raw data into its own AWS account (Account B in the diagram) for increased security and control. They also want to perform the data processing and transformation work in their own account (Account B) to compartmentalize duties and prevent any unintended changes to the source raw data present in the central account (Account A). This approach allows the team to process the raw data extracted from Account A to Account B, which is dedicated for data handling tasks. This makes sure the raw and processed data can be maintained securely separated across multiple accounts, if required, for enhanced data governance and security.

Our solution uses an end-to-end ETL pipeline orchestrated by Amazon MWAA that looks for new incremental files in an Amazon S3 location in Account A, where the raw data is present. This is done by invoking AWS Glue ETL jobs and writing to data objects in a Redshift Serverless cluster in Account B. The pipeline then starts running stored procedures and SQL commands on Redshift Serverless. As the queries finish running, an UNLOAD operation is invoked from the Redshift data warehouse to the S3 bucket in Account A.

Because security is important, this post also covers how to configure an Airflow connection using AWS Secrets Manager to avoid storing database credentials within Airflow connections and variables.

The following diagram illustrates the architectural overview of the components involved in the orchestration of the workflow.

The workflow consists of the following components:

  • The source and target S3 buckets are in a central account (Account A), whereas Amazon MWAA, AWS Glue, and Amazon Redshift are in a different account (Account B). Cross-account access has been set up between S3 buckets in Account A with resources in Account B to be able to load and unload data.
  • In the second account, Amazon MWAA is hosted in one VPC and Redshift Serverless in a different VPC, which are connected through VPC peering. A Redshift Serverless workgroup is secured inside private subnets across three Availability Zones.
  • Secrets like user name, password, DB port, and AWS Region for Redshift Serverless are stored in Secrets Manager.
  • VPC endpoints are created for Amazon S3 and Secrets Manager to interact with other resources.
  • Usually, data engineers create an Airflow Directed Acyclic Graph (DAG) and commit their changes to GitHub. With GitHub actions, they are deployed to an S3 bucket in Account B (for this post, we upload the files into S3 bucket directly). The S3 bucket stores Airflow-related files like DAG files, requirements.txt files, and plugins. AWS Glue ETL scripts and assets are stored in another S3 bucket. This separation helps maintain organization and avoid confusion.
  • The Airflow DAG uses various operators, sensors, connections, tasks, and rules to run the data pipeline as needed.
  • The Airflow logs are logged in Amazon CloudWatch, and alerts can be configured for monitoring tasks. For more information, see Monitoring dashboards and alarms on Amazon MWAA.

Prerequisites

Because this solution centers around using Amazon MWAA to orchestrate the ETL pipeline, you need to set up certain foundational resources across accounts beforehand. Specifically, you need to create the S3 buckets and folders, AWS Glue resources, and Redshift Serverless resources in their respective accounts prior to implementing the full workflow integration using Amazon MWAA.

Deploy resources in Account A using AWS CloudFormation

In Account A, launch the provided AWS CloudFormation stack to create the following resources:

  • The source and target S3 buckets and folders. As a best practice, the input and output bucket structures are formatted with hive style partitioning as s3://<bucket>/products/YYYY/MM/DD/.
  • A sample dataset called products.csv, which we use in this post.

Upload the AWS Glue job to Amazon S3 in Account B

In Account B, create an Amazon S3 location called aws-glue-assets-<account-id>-<region>/scripts (if not present). Replace the parameters for the account ID and Region in the sample_glue_job.py script and upload the AWS Glue job file to the Amazon S3 location.

Deploy resources in Account B using AWS CloudFormation

In Account B, launch the provided CloudFormation stack template to create the following resources:

  • The S3 bucket airflow-<username>-bucket to store Airflow-related files with the following structure:
    • dags – The folder for DAG files.
    • plugins – The file for any custom or community Airflow plugins.
    • requirements – The requirements.txt file for any Python packages.
    • scripts – Any SQL scripts used in the DAG.
    • data – Any datasets used in the DAG.
  • A Redshift Serverless environment. The name of the workgroup and namespace are prefixed with sample.
  • An AWS Glue environment, which contains the following:
    • An AWS Glue crawler, which crawls the data from the S3 source bucket sample-inp-bucket-etl-<username> in Account A.
    • A database called products_db in the AWS Glue Data Catalog.
    • An ELT job called sample_glue_job. This job can read files from the products table in the Data Catalog and load data into the Redshift table products.
  • A VPC gateway endpointto Amazon S3.
  • An Amazon MWAA environment. For detailed steps to create an Amazon MWAA environment using the Amazon MWAA console, refer to Introducing Amazon Managed Workflows for Apache Airflow (MWAA).

launch stack 1

Create Amazon Redshift resources

Create two tables and a stored procedure on an Redshift Serverless workgroup using the products.sql file.

In this example, we create two tables called products and products_f. The name of the stored procedure is sp_products.

Configure Airflow permissions

After the Amazon MWAA environment is created successfully, the status will show as Available. Choose Open Airflow UI to view the Airflow UI. DAGs are automatically synced from the S3 bucket and visible in the UI. However, at this stage, there are no DAGs in the S3 folder.

Add the customer managed policy AmazonMWAAFullConsoleAccess, which grants Airflow users permissions to access AWS Identity and Access Management (IAM) resources, and attach this policy to the Amazon MWAA role. For more information, see Accessing an Amazon MWAA environment.

The policies attached to the Amazon MWAA role have full access and must only be used for testing purposes in a secure test environment. For production deployments, follow the least privilege principle.

Set up the environment

This section outlines the steps to configure the environment. The process involves the following high-level steps:

  1. Update any necessary providers.
  2. Set up cross-account access.
  3. Establish a VPC peering connection between the Amazon MWAA VPC and Amazon Redshift VPC.
  4. Configure Secrets Manager to integrate with Amazon MWAA.
  5. Define Airflow connections.

Update the providers

Follow the steps in this section if your version of Amazon MWAA is less than 2.8.1 (the latest version as of writing this post).

Providers are packages that are maintained by the community and include all the core operators, hooks, and sensors for a given service. The Amazon provider is used to interact with AWS services like Amazon S3, Amazon Redshift Serverless, AWS Glue, and more. There are over 200 modules within the Amazon provider.

Although the version of Airflow supported in Amazon MWAA is 2.6.3, which comes bundled with the Amazon provided package version 8.2.0, support for Amazon Redshift Serverless was not added until the Amazon provided package version 8.4.0. Because the default bundled provider version is older than when Redshift Serverless support was introduced, the provider version must be upgraded in order to use that functionality.

The first step is to update the constraints file and requirements.txt file with the correct versions. Refer to Specifying newer provider packages for steps to update the Amazon provider package.

  1. Specify the requirements as follows:
    --constraint "/usr/local/airflow/dags/constraints-3.10-mod.txt"
    apache-airflow-providers-amazon==8.4.0

  2. Update the version in the constraints file to 8.4.0 or higher.
  3. Add the constraints-3.11-updated.txt file to the /dags folder.

Refer to Apache Airflow versions on Amazon Managed Workflows for Apache Airflow for correct versions of the constraints file depending on the Airflow version.

  1. Navigate to the Amazon MWAA environment and choose Edit.
  2. Under DAG code in Amazon S3, for Requirements file, choose the latest version.
  3. Choose Save.

This will update the environment and new providers will be in effect.

  1. To verify the providers version, go to Providers under the Admin table.

The version for the Amazon provider package should be 8.4.0, as shown in the following screenshot. If not, there was an error while loading requirements.txt. To debug any errors, go to the CloudWatch console and open the requirements_install_ip log in Log streams, where errors are listed. Refer to Enabling logs on the Amazon MWAA console for more details.

Set up cross-account access

You need to set up cross-account policies and roles between Account A and Account B to access the S3 buckets to load and unload data. Complete the following steps:

  1. In Account A, configure the bucket policy for bucket sample-inp-bucket-etl-<username> to grant permissions to the AWS Glue and Amazon MWAA roles in Account B for objects in bucket sample-inp-bucket-etl-<username>:
    {
        "Version": "2012-10-17",
        "Statement": [
            {
                "Effect": "Allow",
                "Principal": {
                    "AWS": [
                        "arn:aws:iam::<account-id-of- AcctB>:role/service-role/<Glue-role>",
                        "arn:aws:iam::<account-id-of-AcctB>:role/service-role/<MWAA-role>"
                    ]
                },
                "Action": [
                    "s3:GetObject",
    "s3:PutObject",
    		   "s3:PutObjectAcl",
    		   "s3:ListBucket"
                ],
                "Resource": [
                    "arn:aws:s3:::sample-inp-bucket-etl-<username>/*",
                    "arn:aws:s3:::sample-inp-bucket-etl-<username>"
                ]
            }
        ]
    }
    

  2. Similarly, configure the bucket policy for bucket sample-opt-bucket-etl-<username> to grant permissions to Amazon MWAA roles in Account B to put objects in this bucket:
    {
        "Version": "2012-10-17",
        "Statement": [
            {
                "Effect": "Allow",
                "Principal": {
                    "AWS": "arn:aws:iam::<account-id-of-AcctB>:role/service-role/<MWAA-role>"
                },
                "Action": [
                    "s3:GetObject",
                    "s3:PutObject",
                    "s3:PutObjectAcl",
                    "s3:ListBucket"
                ],
                "Resource": [
                    "arn:aws:s3:::sample-opt-bucket-etl-<username>/*",
                    "arn:aws:s3:::sample-opt-bucket-etl-<username>"
                ]
            }
        ]
    }
    

  3. In Account A, create an IAM policy called policy_for_roleA, which allows necessary Amazon S3 actions on the output bucket:
    {
        "Version": "2012-10-17",
        "Statement": [
            {
                "Sid": "VisualEditor0",
                "Effect": "Allow",
                "Action": [
                    "kms:Decrypt",
                    "kms:Encrypt",
                    "kms:GenerateDataKey"
                ],
                "Resource": [
                    "<KMS_KEY_ARN_Used_for_S3_encryption>"
                ]
            },
            {
                "Sid": "VisualEditor1",
                "Effect": "Allow",
                "Action": [
                    "s3:PutObject",
                    "s3:GetObject",
                    "s3:GetBucketAcl",
                    "s3:GetBucketCors",
                    "s3:GetEncryptionConfiguration",
                    "s3:GetBucketLocation",
                    "s3:ListAllMyBuckets",
                    "s3:ListBucket",
                    "s3:ListBucketMultipartUploads",
                    "s3:ListBucketVersions",
                    "s3:ListMultipartUploadParts"
                ],
                "Resource": [
                    "arn:aws:s3:::sample-opt-bucket-etl-<username>",
                    "arn:aws:s3:::sample-opt-bucket-etl-<username>/*"
                ]
            }
        ]
    }

  4. Create a new IAM role called RoleA with Account B as the trusted entity role and add this policy to the role. This allows Account B to assume RoleA to perform necessary Amazon S3 actions on the output bucket.
  5. In Account B, create an IAM policy called s3-cross-account-access with permission to access objects in the bucket sample-inp-bucket-etl-<username>, which is in Account A.
  6. Add this policy to the AWS Glue role and Amazon MWAA role:
    {
        "Version": "2012-10-17",
        "Statement": [
            {
                "Effect": "Allow",
                "Action": [
                    "s3:GetObject",
                    "s3:PutObject",
                    "s3:PutObjectAcl"
                ],
                "Resource": "arn:aws:s3:::sample-inp-bucket-etl-<username>/*"
            }
        ]
    }

  7. In Account B, create the IAM policy policy_for_roleB specifying Account A as a trusted entity. The following is the trust policy to assume RoleA in Account A:
    {
        "Version": "2012-10-17",
        "Statement": [
            {
                "Sid": "CrossAccountPolicy",
                "Effect": "Allow",
                "Action": "sts:AssumeRole",
                "Resource": "arn:aws:iam::<account-id-of-AcctA>:role/RoleA"
            }
        ]
    }

  8. Create a new IAM role called RoleB with Amazon Redshift as the trusted entity type and add this policy to the role. This allows RoleB to assume RoleA in Account A and also to be assumable by Amazon Redshift.
  9. Attach RoleB to the Redshift Serverless namespace, so Amazon Redshift can write objects to the S3 output bucket in Account A.
  10. Attach the policy policy_for_roleB to the Amazon MWAA role, which allows Amazon MWAA to access the output bucket in Account A.

Refer to How do I provide cross-account access to objects that are in Amazon S3 buckets? for more details on setting up cross-account access to objects in Amazon S3 from AWS Glue and Amazon MWAA. Refer to How do I COPY or UNLOAD data from Amazon Redshift to an Amazon S3 bucket in another account? for more details on setting up roles to unload data from Amazon Redshift to Amazon S3 from Amazon MWAA.

Set up VPC peering between the Amazon MWAA and Amazon Redshift VPCs

Because Amazon MWAA and Amazon Redshift are in two separate VPCs, you need to set up VPC peering between them. You must add a route to the route tables associated with the subnets for both services. Refer to Work with VPC peering connections for details on VPC peering.

Make sure that CIDR range of the Amazon MWAA VPC is allowed in the Redshift security group and the CIDR range of the Amazon Redshift VPC is allowed in the Amazon MWAA security group, as shown in the following screenshot.

If any of the preceding steps are configured incorrectly, you are likely to encounter a “Connection Timeout” error in the DAG run.

Configure the Amazon MWAA connection with Secrets Manager

When the Amazon MWAA pipeline is configured to use Secrets Manager, it will first look for connections and variables in an alternate backend (like Secrets Manager). If the alternate backend contains the needed value, it is returned. Otherwise, it will check the metadata database for the value and return that instead. For more details, refer to Configuring an Apache Airflow connection using an AWS Secrets Manager secret.

Complete the following steps:

  1. Configure a VPC endpoint to link Amazon MWAA and Secrets Manager (com.amazonaws.us-east-1.secretsmanager).

This allows Amazon MWAA to access credentials stored in Secrets Manager.

  1. To provide Amazon MWAA with permission to access Secrets Manager secret keys, add the policy called SecretsManagerReadWrite to the IAM role of the environment.
  2. To create the Secrets Manager backend as an Apache Airflow configuration option, go to the Airflow configuration options, add the following key-value pairs, and save your settings.

This configures Airflow to look for connection strings and variables at the airflow/connections/* and airflow/variables/* paths:

secrets.backend: airflow.providers.amazon.aws.secrets.secrets_manager.SecretsManagerBackend secrets.backend_kwargs: {"connections_prefix" : "airflow/connections", "variables_prefix" : "airflow/variables"}

  1. To generate an Airflow connection URI string, go to AWS CloudShell and enter into a Python shell.
  2. Run the following code to generate the connection URI string:
    import urllib.parse
    conn_type = 'redshift'
    host = 'sample-workgroup.<account-id-of-AcctB>.us-east-1.redshift-serverless.amazonaws.com' #Specify the Amazon Redshift workgroup endpoint
    port = '5439'
    login = 'admin' #Specify the username to use for authentication with Amazon Redshift
    password = '<password>' #Specify the password to use for authentication with Amazon Redshift
    role_arn = urllib.parse.quote_plus('arn:aws:iam::<account_id>:role/service-role/<MWAA-role>')
    database = 'dev'
    region = 'us-east-1' #YOUR_REGION
    conn_string = '{0}://{1}:{2}@{3}:{4}?role_arn={5}&database={6}&region={7}'.format(conn_type, login, password, host, port, role_arn, database, region)
    print(conn_string)
    

The connection string should be generated as follows:

redshift://admin:<password>@sample-workgroup.<account_id>.us-east-1.redshift-serverless.amazonaws.com:5439?role_arn=<MWAA role ARN>&database=dev&region=<region>
  1. Add the connection in Secrets Manager using the following command in the AWS Command Line Interface (AWS CLI).

This can also be done from the Secrets Manager console. This will be added in Secrets Manager as plaintext.

aws secretsmanager create-secret --name airflow/connections/secrets_redshift_connection --description "Apache Airflow to Redshift Cluster" --secret-string "redshift://admin:<password>@sample-workgroup.<account_id>.us-east-1.redshift-serverless.amazonaws.com:5439?role_arn=<MWAA role ARN>&database=dev&region=us-east-1" --region=us-east-1

Use the connection airflow/connections/secrets_redshift_connection in the DAG. When the DAG is run, it will look for this connection and retrieve the secrets from Secrets Manager. In case of RedshiftDataOperator, pass the secret_arn as a parameter instead of connection name.

You can also add secrets using the Secrets Manager console as key-value pairs.

  1. Add another secret in Secrets Manager in and save it as airflow/connections/redshift_conn_test.

Create an Airflow connection through the metadata database

You can also create connections in the UI. In this case, the connection details will be stored in an Airflow metadata database. If the Amazon MWAA environment is not configured to use the Secrets Manager backend, it will check the metadata database for the value and return that. You can create an Airflow connection using the UI, AWS CLI, or API. In this section, we show how to create a connection using the Airflow UI.

  1. For Connection Id, enter a name for the connection.
  2. For Connection Type, choose Amazon Redshift.
  3. For Host, enter the Redshift endpoint (without port and database) for Redshift Serverless.
  4. For Database, enter dev.
  5. For User, enter your admin user name.
  6. For Password, enter your password.
  7. For Port, use port 5439.
  8. For Extra, set the region and timeout parameters.
  9. Test the connection, then save your settings.

Create and run a DAG

In this section, we describe how to create a DAG using various components. After you create and run the DAG, you can verify the results by querying Redshift tables and checking the target S3 buckets.

Create a DAG

In Airflow, data pipelines are defined in Python code as DAGs. We create a DAG that consists of various operators, sensors, connections, tasks, and rules:

  • The DAG starts with looking for source files in the S3 bucket sample-inp-bucket-etl-<username> under Account A for the current day using S3KeySensor. S3KeySensor is used to wait for one or multiple keys to be present in an S3 bucket.
    • For example, our S3 bucket is partitioned as s3://bucket/products/YYYY/MM/DD/, so our sensor should check for folders with the current date. We derived the current date in the DAG and passed this to S3KeySensor, which looks for any new files in the current day folder.
    • We also set wildcard_match as True, which enables searches on bucket_key to be interpreted as a Unix wildcard pattern. Set the mode to reschedule so that the sensor task frees the worker slot when the criteria is not met and it’s rescheduled at a later time. As a best practice, use this mode when poke_interval is more than 1 minute to prevent too much load on a scheduler.
  • After the file is available in the S3 bucket, the AWS Glue crawler runs using GlueCrawlerOperator to crawl the S3 source bucket sample-inp-bucket-etl-<username> under Account A and updates the table metadata under the products_db database in the Data Catalog. The crawler uses the AWS Glue role and Data Catalog database that were created in the previous steps.
  • The DAG uses GlueCrawlerSensor to wait for the crawler to complete.
  • When the crawler job is complete, GlueJobOperator is used to run the AWS Glue job. The AWS Glue script name (along with location) and is passed to the operator along with the AWS Glue IAM role. Other parameters like GlueVersion, NumberofWorkers, and WorkerType are passed using the create_job_kwargs parameter.
  • The DAG uses GlueJobSensor to wait for the AWS Glue job to complete. When it’s complete, the Redshift staging table products will be loaded with data from the S3 file.
  • You can connect to Amazon Redshift from Airflow using three different operators:
    • PythonOperator.
    • SQLExecuteQueryOperator, which uses a PostgreSQL connection and redshift_default as the default connection.
    • RedshiftDataOperator, which uses the Redshift Data API and aws_default as the default connection.

In our DAG, we use SQLExecuteQueryOperator and RedshiftDataOperator to show how to use these operators. The Redshift stored procedures are run RedshiftDataOperator. The DAG also runs SQL commands in Amazon Redshift to delete the data from the staging table using SQLExecuteQueryOperator.

Because we configured our Amazon MWAA environment to look for connections in Secrets Manager, when the DAG runs, it retrieves the Redshift connection details like user name, password, host, port, and Region from Secrets Manager. If the connection is not found in Secrets Manager, the values are retrieved from the default connections.

In SQLExecuteQueryOperator, we pass the connection name that we created in Secrets Manager. It looks for airflow/connections/secrets_redshift_connection and retrieves the secrets from Secrets Manager. If Secrets Manager is not set up, the connection created manually (for example, redshift-conn-id) can be passed.

In RedshiftDataOperator, we pass the secret_arn of the airflow/connections/redshift_conn_test connection created in Secrets Manager as a parameter.

  • As final task, RedshiftToS3Operator is used to unload data from the Redshift table to an S3 bucket sample-opt-bucket-etl in Account B. airflow/connections/redshift_conn_test from Secrets Manager is used for unloading the data.
  • TriggerRule is set to ALL_DONE, which enables the next step to run after all upstream tasks are complete.
  • The dependency of tasks is defined using the chain() function, which allows for parallel runs of tasks if needed. In our case, we want all tasks to run in sequence.

The following is the complete DAG code. The dag_id should match the DAG script name, otherwise it won’t be synced into the Airflow UI.

from datetime import datetime
from airflow import DAG 
from airflow.decorators import task
from airflow.models.baseoperator import chain
from airflow.providers.amazon.aws.sensors.s3 import S3KeySensor
from airflow.providers.amazon.aws.operators.glue import GlueJobOperator
from airflow.providers.amazon.aws.operators.glue_crawler import GlueCrawlerOperator
from airflow.providers.amazon.aws.sensors.glue import GlueJobSensor
from airflow.providers.amazon.aws.sensors.glue_crawler import GlueCrawlerSensor
from airflow.providers.amazon.aws.operators.redshift_data import RedshiftDataOperator
from airflow.providers.common.sql.operators.sql import SQLExecuteQueryOperator
from airflow.providers.amazon.aws.transfers.redshift_to_s3 import RedshiftToS3Operator
from airflow.utils.trigger_rule import TriggerRule


dag_id = "data_pipeline"
vYear = datetime.today().strftime("%Y")
vMonth = datetime.today().strftime("%m")
vDay = datetime.today().strftime("%d")
src_bucket_name = "sample-inp-bucket-etl-<username>"
tgt_bucket_name = "sample-opt-bucket-etl-<username>"
s3_folder="products"
#Please replace the variable with the glue_role_arn
glue_role_arn_key = "arn:aws:iam::<account_id>:role/<Glue-role>"
glue_crawler_name = "products"
glue_db_name = "products_db"
glue_job_name = "sample_glue_job"
glue_script_location="s3://aws-glue-assets-<account_id>-<region>/scripts/sample_glue_job.py"
workgroup_name = "sample-workgroup"
redshift_table = "products_f"
redshift_conn_id_name="secrets_redshift_connection"
db_name = "dev"
secret_arn="arn:aws:secretsmanager:us-east-1:<account_id>:secret:airflow/connections/redshift_conn_test-xxxx"
poll_interval = 10

@task
def get_role_name(arn: str) -> str:
    return arn.split("/")[-1]

@task
def get_s3_loc(s3_folder: str) -> str:
    s3_loc  = s3_folder + "/year=" + vYear + "/month=" + vMonth + "/day=" + vDay + "/*.csv"
    return s3_loc

with DAG(
    dag_id=dag_id,
    schedule="@once",
    start_date=datetime(2021, 1, 1),
    tags=["example"],
    catchup=False,
) as dag:
    role_arn = glue_role_arn_key
    glue_role_name = get_role_name(role_arn)
    s3_loc = get_s3_loc(s3_folder)


    # Check for new incremental files in S3 source/input bucket
    sensor_key = S3KeySensor(
        task_id="sensor_key",
        bucket_key=s3_loc,
        bucket_name=src_bucket_name,
        wildcard_match=True,
        #timeout=18*60*60,
        #poke_interval=120,
        timeout=60,
        poke_interval=30,
        mode="reschedule"
    )

    # Run Glue crawler
    glue_crawler_config = {
        "Name": glue_crawler_name,
        "Role": role_arn,
        "DatabaseName": glue_db_name,
    }

    crawl_s3 = GlueCrawlerOperator(
        task_id="crawl_s3",
        config=glue_crawler_config,
    )

    # GlueCrawlerOperator waits by default, setting as False to test the Sensor below.
    crawl_s3.wait_for_completion = False

    # Wait for Glue crawler to complete
    wait_for_crawl = GlueCrawlerSensor(
        task_id="wait_for_crawl",
        crawler_name=glue_crawler_name,
    )

    # Run Glue Job
    submit_glue_job = GlueJobOperator(
        task_id="submit_glue_job",
        job_name=glue_job_name,
        script_location=glue_script_location,
        iam_role_name=glue_role_name,
        create_job_kwargs={"GlueVersion": "4.0", "NumberOfWorkers": 10, "WorkerType": "G.1X"},
    )

    # GlueJobOperator waits by default, setting as False to test the Sensor below.
    submit_glue_job.wait_for_completion = False

    # Wait for Glue Job to complete
    wait_for_job = GlueJobSensor(
        task_id="wait_for_job",
        job_name=glue_job_name,
        # Job ID extracted from previous Glue Job Operator task
        run_id=submit_glue_job.output,
        verbose=True,  # prints glue job logs in airflow logs
    )

    wait_for_job.poke_interval = 5

    # Execute the Stored Procedure in Redshift Serverless using Data Operator
    execute_redshift_stored_proc = RedshiftDataOperator(
        task_id="execute_redshift_stored_proc",
        database=db_name,
        workgroup_name=workgroup_name,
        secret_arn=secret_arn,
        sql="""CALL sp_products();""",
        poll_interval=poll_interval,
        wait_for_completion=True,
    )

    # Execute the Stored Procedure in Redshift Serverless using SQL Operator
    delete_from_table = SQLExecuteQueryOperator(
        task_id="delete_from_table",
        conn_id=redshift_conn_id_name,
        sql="DELETE FROM products;",
        trigger_rule=TriggerRule.ALL_DONE,
    )

    # Unload the data from Redshift table to S3
    transfer_redshift_to_s3 = RedshiftToS3Operator(
        task_id="transfer_redshift_to_s3",
        s3_bucket=tgt_bucket_name,
        s3_key=s3_loc,
        schema="PUBLIC",
        table=redshift_table,
        redshift_conn_id=redshift_conn_id_name,
    )

    transfer_redshift_to_s3.trigger_rule = TriggerRule.ALL_DONE

    #Chain the tasks to be executed
    chain(
        sensor_key,
        crawl_s3,
        wait_for_crawl,
        submit_glue_job,
        wait_for_job,
        execute_redshift_stored_proc,
        delete_from_table,
        transfer_redshift_to_s3
        )
    

Verify the DAG run

After you create the DAG file (replace the variables in the DAG script) and upload it to the s3://sample-airflow-instance/dags folder, it will be automatically synced with the Airflow UI. All DAGs appear on the DAGs tab. Toggle the ON option to make the DAG runnable. Because our DAG is set to schedule="@once", you need to manually run the job by choosing the run icon under Actions. When the DAG is complete, the status is updated in green, as shown in the following screenshot.

In the Links section, there are options to view the code, graph, grid, log, and more. Choose Graph to visualize the DAG in a graph format. As shown in the following screenshot, each color of the node denotes a specific operator, and the color of the node outline denotes a specific status.

Verify the results

On the Amazon Redshift console, navigate to the Query Editor v2 and select the data in the products_f table. The table should be loaded and have the same number of records as S3 files.

On the Amazon S3 console, navigate to the S3 bucket s3://sample-opt-bucket-etl in Account B. The product_f files should be created under the folder structure s3://sample-opt-bucket-etl/products/YYYY/MM/DD/.

Clean up

Clean up the resources created as part of this post to avoid incurring ongoing charges:

  1. Delete the CloudFormation stacks and S3 bucket that you created as prerequisites.
  2. Delete the VPCs and VPC peering connections, cross-account policies and roles, and secrets in Secrets Manager.

Conclusion

With Amazon MWAA, you can build complex workflows using Airflow and Python without managing clusters, nodes, or any other operational overhead typically associated with deploying and scaling Airflow in production. In this post, we showed how Amazon MWAA provides an automated way to ingest, transform, analyze, and distribute data between different accounts and services within AWS. For more examples of other AWS operators, refer to the following GitHub repository; we encourage you to learn more by trying out some of these examples.


About the Authors


Radhika Jakkula is a Big Data Prototyping Solutions Architect at AWS. She helps customers build prototypes using AWS analytics services and purpose-built databases. She is a specialist in assessing wide range of requirements and applying relevant AWS services, big data tools, and frameworks to create a robust architecture.

Sidhanth Muralidhar is a Principal Technical Account Manager at AWS. He works with large enterprise customers who run their workloads on AWS. He is passionate about working with customers and helping them architect workloads for costs, reliability, performance, and operational excellence at scale in their cloud journey. He has a keen interest in data analytics as well.

Optimize data layout by bucketing with Amazon Athena and AWS Glue to accelerate downstream queries

Post Syndicated from Takeshi Nakatani original https://aws.amazon.com/blogs/big-data/optimize-data-layout-by-bucketing-with-amazon-athena-and-aws-glue-to-accelerate-downstream-queries/

In the era of data, organizations are increasingly using data lakes to store and analyze vast amounts of structured and unstructured data. Data lakes provide a centralized repository for data from various sources, enabling organizations to unlock valuable insights and drive data-driven decision-making. However, as data volumes continue to grow, optimizing data layout and organization becomes crucial for efficient querying and analysis.

One of the key challenges in data lakes is the potential for slow query performance, especially when dealing with large datasets. This can be attributed to factors such as inefficient data layout, resulting in excessive data scanning and inefficient use of compute resources. To address this challenge, common practices like partitioning and bucketing can significantly improve query performance and reduce computation costs.

Partitioning is a technique that divides a large dataset into smaller, more manageable parts based on specific criteria, such as date, region, or product category. By partitioning data, downstream analytical queries can skip irrelevant partitions, reducing the amount of data that needs to be scanned and processed. You can use partition columns in the WHERE clause in queries to scan only the specific partitions that your query needs. This can lead to faster query runtimes and more efficient resource utilization. It especially works well when columns with low cardinality are chosen as the key.

What if you have a high cardinality column that you sometimes need to filter by VIP customers? Each customer is usually identified with an ID, which can be millions. Partitioning isn’t suitable for such high cardinality columns because you end up with small files, slow partition filtering, and high Amazon Simple Storage Service (Amazon S3) API cost (one S3 prefix is created per value of partition column). Although you can use partitioning with a natural key such as city or state to narrow down your dataset to some degree, it is still necessary to query across date-based partitions if your data is time series.

This is where bucketing comes into play. Bucketing makes sure that all rows with the same values of one or more columns end up in the same file. Instead of one file per value, like partitioning, a hash function is used to distribute values evenly across a fixed number of files. By organizing data this way, you can perform efficient filtering, because only the relevant buckets need to be processed, further reducing computational overhead.

There are multiple options for implementing bucketing on AWS. One approach is to use the Amazon Athena CREATE TABLE AS SELECT (CTAS) statement, which allows you to create a bucketed table directly from a query. Alternatively, you can use AWS Glue for Apache Spark, which provides built-in support for bucketing configurations during the data transformation process. AWS Glue allows you to define bucketing parameters, such as the number of buckets and the columns to bucket on, providing an optimized data layout for efficient querying with Athena.

In this post, we discuss how to implement bucketing on AWS data lakes, including using Athena CTAS statement and AWS Glue for Apache Spark. We also cover bucketing for Apache Iceberg tables.

Example use case

In this post, you use a public dataset, the NOAA Integrated Surface Database. Data analysts run one-time queries for data during the past 5 years through Athena. Most of the queries are for specific stations with specific report types. The queries need to complete in 10 seconds, and the cost needs to be optimized carefully. In this scenario, you’re a data engineer responsible for optimizing query performance and cost.

For example, if an analyst wants to retrieve data for a specific station (for example, station ID 123456) with a particular report type (for example, CRN01), the query might look like the following query:

SELECT station, report_type, columnA, columnB, ...
FROM table_name
WHERE
report_type = 'CRN01'
AND station = '123456'

In the case of the NOAA Integrated Surface Database, the station_id column is likely to have a high cardinality, with numerous unique station identifiers. On the other hand, the report_type column may have a relatively low cardinality, with a limited set of report types. Given this scenario, it would be a good idea to partition the data by report_type and bucket it by station_id.

With this partitioning and bucketing strategy, Athena can first eliminate partitions for irrelevant report types, and then scan only the buckets within the relevant partition that match the specified station ID, significantly reducing the amount of data processed and accelerating query runtimes. This approach not only meets the query performance requirement, but also helps optimize costs by minimizing the amount of data scanned and billed for each query.

In this post, we examine how query performance is affected by data layout, in particular, bucketing. We also compare three different ways to achieve bucketing. The following table represents conditions for the tables to be created.

. noaa_remote_original athena_non_bucketed athena_bucketed glue_bucketed athena_bucketed_iceberg
Format CSV Parquet Parquet Parquet Parquet
Compression n/a Snappy Snappy Snappy Snappy
Created via n/a Athena CTAS Athena CTAS Glue ETL Athena CTAS with Iceberg
Engine n/a Trino Trino Apache Spark Apache Iceberg
Is partitioned? Yes but with different way Yes Yes Yes Yes
Is bucketed? No No Yes Yes Yes

noaa_remote_original is partitioned by the year column, but not by the report_type column. This row represents if the table is partitioned by the actual columns that are used in the queries.

Baseline table

For this post, you create several tables with different conditions: some without bucketing and some with bucketing, to showcase the performance characteristics of bucketing. First, let’s create an original table using the NOAA data. In subsequent steps, you ingest data from this table to create test tables.

There are multiple ways to define a table definition: running DDL, an AWS Glue crawler, the AWS Glue Data Catalog API, and so on. In this step, you run DDL via the Athena console.

Complete the following steps to create the "bucketing_blog"."noaa_remote_original" table in the Data Catalog:

  1. Open the Athena console.
  2. In the query editor, run the following DDL to create a new AWS Glue database:
    -- Create Glue database
    CREATE DATABASE bucketing_blog;

  3. For Database under Data, choose bucketing_blog to set the current database.
  4. Run the following DDL to create the original table:
    -- Create original table
    CREATE EXTERNAL TABLE `bucketing_blog`.`noaa_remote_original`(
      `station` STRING, 
      `date` STRING, 
      `source` STRING, 
      `latitude` STRING, 
      `longitude` STRING, 
      `elevation` STRING, 
      `name` STRING, 
      `report_type` STRING, 
      `call_sign` STRING, 
      `quality_control` STRING, 
      `wnd` STRING, 
      `cig` STRING, 
      `vis` STRING, 
      `tmp` STRING, 
      `dew` STRING, 
      `slp` STRING, 
      `aj1` STRING, 
      `gf1` STRING, 
      `mw1` STRING)
    PARTITIONED BY (
        year STRING)
    ROW FORMAT SERDE 
      'org.apache.hadoop.hive.serde2.OpenCSVSerde' 
    WITH SERDEPROPERTIES ( 
      'escapeChar'='\\',
      'quoteChar'='\"',
      'separatorChar'=',') 
    STORED AS INPUTFORMAT 
      'org.apache.hadoop.mapred.TextInputFormat' 
    OUTPUTFORMAT 
      'org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat'
    LOCATION
      's3://noaa-global-hourly-pds/'
    TBLPROPERTIES (
      'skip.header.line.count'='1'
    )

Because the source data has quoted fields, we use OpenCSVSerde instead of the default LazySimpleSerde.

These CSV files have a header row, which we tell Athena to skip by adding skip.header.line.count and setting the value to 1.

For more details, refer to OpenCSVSerDe for processing CSV.

  1. Run the following DDL to add partitions. We add partitions only for 5 years out of 124 years based on the use case requirement:
    -- Load partitions
    ALTER TABLE `bucketing_blog`.`noaa_remote_original` ADD
      PARTITION (year = '2024') LOCATION 's3://noaa-global-hourly-pds/2024/'
      PARTITION (year = '2023') LOCATION 's3://noaa-global-hourly-pds/2023/'
      PARTITION (year = '2022') LOCATION 's3://noaa-global-hourly-pds/2022/'
      PARTITION (year = '2021') LOCATION 's3://noaa-global-hourly-pds/2021/'
      PARTITION (year = '2020') LOCATION 's3://noaa-global-hourly-pds/2020/';

  2. Run the following DML to verify if you can successfully query the data:
    -- Check data 
    SELECT * FROM "bucketing_blog"."noaa_remote_original" LIMIT 10;

Now you’re ready to start querying the original table to examine the baseline performance.

  1. Run a query against the original table to evaluate the query performance as a baseline. The following query selects records for five specific stations with report type CRN05:
    -- Baseline
    SELECT station, report_type, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, tmp
    FROM "bucketing_blog"."noaa_remote_original"
    WHERE
        report_type = 'CRN05'
        AND ( station = '99999904237'
            OR station = '99999953132'
            OR station = '99999903061'
            OR station = '99999963856'
            OR station = '99999994644'
        );

We ran this query 10 times. The average query runtime for 10 queries is 27.6 seconds, which is far longer than our target of 10 seconds, and 155.75 GB data is scanned to return 1.65 million records. This is the baseline performance of the original raw table. It’s time to start optimizing data layout from this baseline.

Next, you create tables with different conditions from the original: one without bucketing and one with bucketing, and compare them.

Optimize data layout using Athena CTAS

In this section, we use an Athena CTAS query to optimize data layout and its format.

First, let’s create a table with partitioning but without bucketing. The new table is partitioned by the column report_type because most of expected queries use this column in the WHERE clause, and objects are stored as Parquet with Snappy compression.

  1. Open the Athena query editor.
  2. Run the following query, providing your own S3 bucket and prefix:
    --CTAS, non-bucketed
    CREATE TABLE "bucketing_blog"."athena_non_bucketed"
    WITH (
        external_location = 's3://<your-s3-location>/athena-non-bucketed/',
        partitioned_by = ARRAY['report_type'],
        format = 'PARQUET',
        write_compression = 'SNAPPY'
    )
    AS
    SELECT
        station, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, vis, tmp, dew, slp, aj1, gf1, mw1, report_type
    FROM "bucketing_blog"."noaa_remote_original"
    ;

Your data should look like the following screenshots.


There are 30 files under the partition.

Next, you create a table with Hive style bucketing. The number of buckets needs to be carefully tuned through experiments for your own use case. Generally speaking, the more buckets you have, the smaller the granularity, which might result in better performance. On the other hand, too many small files may introduce inefficiency in query planning and processing. Also, bucketing only works if you are querying a few values of the bucketing key. The more values you add to your query, the more likely that you will end up reading all buckets.

The following is the baseline query to optimize:

-- Baseline
SELECT station, report_type, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, tmp
FROM "bucketing_blog"."noaa_remote_original"
WHERE
    report_type = 'CRN05'
    AND ( station = '99999904237'
        OR station = '99999953132'
        OR station = '99999903061'
        OR station = '99999963856'
        OR station = '99999994644'
    );

In this example, the table is going to be bucketed into 16 buckets by a high-cardinality column (station), which is supposed to be used for the WHERE clause in the query. All other conditions remain the same. The baseline query has five values in the station ID, and you expect queries to have around that number at most, which is less enough than the number of buckets, so 16 should work well. It is possible to specify a larger number of buckets, but CTAS can’t be used if the total number of partitions exceeds 100.

  1. Run the following query:
    -- CTAS, Hive-bucketed
    CREATE TABLE "bucketing_blog"."athena_bucketed"
    WITH (
        external_location = 's3://<your-s3-location>/athena-bucketed/',
        partitioned_by = ARRAY['report_type'],
        bucketed_by = ARRAY['station'],
        bucket_count = 16,
        format = 'PARQUET',
        write_compression = 'SNAPPY'
    )
    AS
    SELECT
        station, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, vis, tmp, dew, slp, aj1, gf1, mw1, report_type
    FROM "bucketing_blog"."noaa_remote_original"
    ;

The query creates S3 objects organized as shown in the following screenshots.


The table-level layout looks exactly the same between athena_non_bucketed and athena_bucketed: there are 13 partitions in each table. The difference is the number of objects under the partitions. There are 16 objects (buckets) per partition, of roughly 10–25 MB each in this case. The number of buckets is constant at the specified value regardless of the amount of data, but the bucket size depends on the amount of data.

Now you’re ready to query against each table to evaluate query performance. The query will select records with five specific stations and report type CRN05 for the past 5 years. Although you can’t see which data of a specific station is located in which bucket, it has been calculated and located correctly by Athena.

  1. Query the non-bucketed table with the following statement:
    -- No bucketing 
    SELECT station, report_type, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, tmp
    FROM "bucketing_blog"."athena_non_bucketed"
    WHERE
        report_type = 'CRN05'
        AND ( station = '99999904237'
            OR station = '99999953132'
            OR station = '99999903061'
            OR station = '99999963856'
            OR station = '99999994644'
        );


We ran this query 10 times. The average runtime of the 10 queries is 10.95 seconds, and 358 MB of data is scanned to return 2.21 million records. Both the runtime and scan size have been significantly decreased because you’ve partitioned the data, and can now read only one partition where 12 partitions of 13 are skipped. In addition, the amount of data scanned has gone down from 206 GB to 360 MB, which is a reduction of 99.8%. This is not just due to the partitioning, but also due to the change of its format to Parquet and compression with Snappy.

  1. Query the bucketed table with the following statement:
    -- Hive bucketing
    SELECT station, report_type, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, tmp
    FROM "bucketing_blog"."athena_bucketed"
    WHERE
        report_type = 'CRN05'
        AND ( station = '99999904237'
            OR station = '99999953132'
            OR station = '99999903061'
            OR station = '99999963856'
            OR station = '99999994644'
        );


We ran this query 10 times. The average runtime of the 10 queries is 7.82 seconds, and 69 MB of data is scanned to return 2.21 million records. This means a reduction of average runtime from 10.95 to 7.82 seconds (-29%), and a dramatic reduction of data scanned from 358 MB to 69 MB (-81%) to return the same number of records compared with the non-bucketed table. In this case, both runtime and data scanned were improved by bucketing. This means bucketing contributed not only to performance but also to cost reduction.

Considerations

As stated earlier, size your bucket carefully to maximize performance of your query. Bucketing only works if you are querying a few values of the bucketing key. Consider creating more buckets than the number of values expected in the actual query.

Additionally, an Athena CTAS query is limited to create up to 100 partitions at one time. If you need a large number of partitions, you may want to use AWS Glue extract, transform, and load (ETL), although there is a workaround to split into multiple SQL statements.

Optimize data layout using AWS Glue ETL

Apache Spark is an open source distributed processing framework that enables flexible ETL with PySpark, Scala, and Spark SQL. It allows you to partition and bucket your data based on your requirements. Spark has several tuning options to accelerate jobs. You can effortlessly automate and monitor Spark jobs. In this section, we use AWS Glue ETL jobs to run Spark code to optimize data layout.

Unlike Athena bucketing, AWS Glue ETL uses Spark-based bucketing as a bucketing algorithm. All you need to do is add the following table property onto the table: bucketing_format = 'spark'. For details about this table property, see Partitioning and bucketing in Athena.

Complete the following steps to create a table with bucketing through AWS Glue ETL:

  1. On the AWS Glue console, choose ETL jobs in the navigation pane.
  2. Choose Create job and choose Visual ETL.
  3. Under Add nodes, choose AWS Glue Data Catalog for Sources.
  4. For Database, choose bucketing_blog.
  5. For Table, choose noaa_remote_original.
  6. Under Add nodes, choose Change Schema for Transforms.
  7. Under Add nodes, choose Custom Transform for Transforms.
  8. For Name, enter ToS3WithBucketing.
  9. For Node parents, choose Change Schema.
  10. For Code block, enter the following code snippet:
    def ToS3WithBucketing (glueContext, dfc) -> DynamicFrameCollection:
        # Convert DynamicFrame to DataFrame
        df = dfc.select(list(dfc.keys())[0]).toDF()
        
        # Write to S3 with bucketing and partitioning
        df.repartition(1, "report_type") \
            .write.option("path", "s3://<your-s3-location>/glue-bucketed/") \
            .mode("overwrite") \
            .partitionBy("report_type") \
            .bucketBy(16, "station") \
            .format("parquet") \
            .option("compression", "snappy") \
            .saveAsTable("bucketing_blog.glue_bucketed")

The following screenshot shows the job created using AWS Glue Studio to generate a table and data.

Each node represents the following:

  • The AWS Glue Data Catalog node loads the noaa_remote_original table from the Data Catalog
  • The Change Schema node makes sure that it loads columns registered in the Data Catalog
  • The ToS3WithBucketing node writes data to Amazon S3 with both partitioning and Spark-based bucketing

The job has been successfully authored in the visual editor.

  1. Under Job details, for IAM Role, choose your AWS Identity and Access Management (IAM) role for this job.
  2. For Worker type, choose G.8X.
  3. For Requested number of workers, enter 5.
  4. Choose Save, then choose Run.

After these steps, the table glue_bucketed. has been created.

  1. Choose Tables in the navigation pane, and choose the table glue_bucketed.
  2. On the Actions menu, choose Edit table under Manage.
  3. In the Table properties section, choose Add.
  4. Add a key pair with key bucketing_format and value spark.
  5. Choose Save.

Now it’s time to query the tables.

  1. Query the bucketed table with the following statement:
    -- Spark bucketing
    SELECT station, report_type, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, tmp
    FROM "bucketing_blog"."glue_bucketed"
    WHERE
        report_type = 'CRN05'
        AND ( station = '99999904237'
            OR station = '99999953132'
            OR station = '99999903061'
            OR station = '99999963856'
            OR station = '99999994644'
        );


We ran the query 10 times. The average runtime of the 10 queries is 7.09 seconds, and 88 MB of data is scanned to return 2.21 million records. In this case, both the runtime and data scanned were improved by bucketing. This means bucketing contributed not only to performance but also to cost reduction.

The reason for the larger bytes scanned compared to the Athena CTAS example is that the values were distributed differently in this table. In the AWS Glue bucketed table, the values were distributed over five files. In the Athena CTAS bucketed table, the values were distributed over four files. Remember that rows are distributed into buckets using a hash function. The Spark bucketing algorithm uses a different hash function than Hive, and in this case, it resulted in a different distribution across the files.

Considerations

Glue DynamicFrame does not support bucketing natively. You need to use Spark DataFrame instead of DynamicFrame to bucket tables.

For information about fine-tuning AWS Glue ETL performance, refer to Best practices for performance tuning AWS Glue for Apache Spark jobs.

Optimize Iceberg data layout with hidden partitioning

Apache Iceberg is a high-performance open table format for huge analytic tables, bringing the reliability and simplicity of SQL tables to big data. Recently, there has been a huge demand to use Apache Iceberg tables to achieve advanced capabilities like ACID transaction, time travel query, and more.

In Iceberg, bucketing works differently than the Hive table method we’ve seen so far. In Iceberg, bucketing is a subset of partitioning, and can be applied using the bucket partition transform. The way you use it and the end result is similar to bucketing in Hive tables. For more details about Iceberg bucket transforms, refer to Bucket Transform Details.

Complete the following steps:

  1. Open the Athena query editor.
  2. Run the following query to create an Iceberg table with hidden partitioning along with bucketing:
    -- CTAS, Iceberg-bucketed
    CREATE TABLE "bucketing_blog"."athena_bucketed_iceberg"
    WITH (table_type = 'ICEBERG',
          location = 's3://<your-s3-location>/athena-bucketed-iceberg/', 
          is_external = false,
          partitioning = ARRAY['report_type', 'bucket(station, 16)'],
          format = 'PARQUET',
          write_compression = 'SNAPPY'
    ) 
    AS
    SELECT
        station, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, vis, tmp, dew, slp, aj1, gf1, mw1, report_type
    FROM "bucketing_blog"."noaa_remote_original"
    ;

Your data should look like the following screenshot.

There are two folders: data and metadata. Drill down to data.

You see random prefixes under the data folder. Choose the first one to view its details.

You see the top-level partition based on the report_type column. Drill down to the next level.

You see the second-level partition, bucketed with the station column.

The Parquet data files exist under these folders.

  1. Query the bucketed table with the following statement:
    -- Iceberg bucketing
    SELECT station, report_type, date, source, latitude, longitude, elevation, name, call_sign, quality_control, wnd, cig, tmp
    FROM "bucketing_blog"."athena_bucketed_iceberg"
    WHERE
        report_type = 'CRN05'
        AND
        ( station = '99999904237'
            OR station = '99999953132'
            OR station = '99999903061'
            OR station = '99999963856'
            OR station = '99999994644'
        );


With the Iceberg-bucketed table, the average runtime of the 10 queries is 8.03 seconds, and 148 MB of data is scanned to return 2.21 million records. This is less efficient than bucketing with AWS Glue or Athena, but considering the benefits of Iceberg’s various features, it is within an acceptable range.

Results

The following table summarizes all the results.

. noaa_remote_original athena_non_bucketed athena_bucketed glue_bucketed athena_bucketed_iceberg
Format CSV Parquet Parquet Parquet Iceberg (Parquet)
Compression n/a Snappy Snappy Snappy Snappy
Created via n/a Athena CTAS Athena CTAS Glue ETL Athena CTAS with Iceberg
Engine n/a Trino Trino Apache Spark Apache Iceberg
Table size (GB) 155.8 5.0 5.0 5.8 5.0
The number of S3 Objects 53360 376 192 192 195
Is partitioned? Yes but with different way Yes Yes Yes Yes
Is bucketed? No No Yes Yes Yes
Bucketing format n/a n/a Hive Spark Iceberg
Number of buckets n/a n/a 16 16 16
Average runtime (sec) 29.178 10.950 7.815 7.089 8.030
Scanned size (MB) 206640.0 358.6 69.1 87.8 147.7

With athena_bucketed, glue_bucketed, and athena_bucketed_iceberg, you were able to meet the latency goal of 10 seconds. With bucketing, you saw a 25–40% reduction in runtime and a 60–85% reduction in scan size, which can contribute to both latency and cost optimization.

As you can see from the result, although partitioning contributes significantly to reduce both runtime and scan size, bucketing can also contribute to reduce them further.

Athena CTAS is straightforward and fast enough to complete the bucketing process. AWS Glue ETL is more flexible and scalable to achieve advanced use cases. You can choose either method based on your requirement and use case, because you can take advantage of bucketing through either option.

Conclusion

In this post, we demonstrated how to optimize your table data layout with partitioning and bucketing through Athena CTAS and AWS Glue ETL. We showed that bucketing contributes to accelerating query latency and reducing scan size to further optimize costs. We also discussed bucketing for Iceberg tables through hidden partitioning.

Bucketing just one technique to optimize data layout by reducing data scan. For optimizing your entire data layout, we recommend considering other options like partitioning, using columnar file format, and compression in conjunction with bucketing. This can enable your data to further enhance query performance.

Happy bucketing!


About the Authors

Takeshi Nakatani is a Principal Big Data Consultant on the Professional Services team in Tokyo. He has 26 years of experience in the IT industry, with expertise in architecting data infrastructure. On his days off, he can be a rock drummer or a motorcyclist.

Noritaka Sekiyama is a Principal Big Data Architect on the AWS Glue team. He is responsible for building software artifacts to help customers. In his spare time, he enjoys cycling with his road bike.

Ubuntu 24.04 LTS (Noble Numbat) released

Post Syndicated from corbet original https://lwn.net/Articles/971175/

Version 24.04 LTS of the Ubuntu distribution is out.

This release continues Ubuntu’s proud tradition of integrating the
latest and greatest open source technologies into a high-quality,
easy-to-use Linux distribution. The team has been hard at work
through this cycle, together with the community and our partners,
to introduce new features and fix bugs.

The list of changes and enhancements is long; click below for some details.
More information can be found in the
release notes
; see also this
page
for a summary of security-related changes.

Автентичният интерес прави един учител успешен

Post Syndicated from Надежда Цекулова original https://www.toest.bg/avtentichniyat-interes-pravi-edin-uchitel-uspeshen/

Автентичният интерес прави един учител успешен

Даниел Симеонов вече е популярен с киношколата, която развива от няколко години в училището в с. Дерманци. Дори докато говорим, той се готви за монтажа на последния ѝ филм и събира средства за обновяване на техниката в кинолабораторията на училището. Но противно на първото впечатление, в работата на Даниел не образованието е отворило врата за киното, а киното отваря множество образователни врати.

Надежда Цекулова разговаря с Даниел Симеонов за ролята на киното като педагогически инструмент. 


Учил сте различни специалности в няколко университета в няколко държави. Как се озовахте в училището в село Дерманци?

Откровено казано – не знам. Никога не съм очаквал, че така ще се стекат нещата в моя живот. Аз съм завършил гимназия в Луковит преди много години. Бях добър по философия, ходех по олимпиади. Приеха ме в Софийския университет да уча философия. Оказа се много по-различно от това, което си представях, беше изчезнала цялата магия, която моят учител по философия ми „изпращаше“ с всеки урок. След това заминах в чужбина, върнах се и винаги съм искал да се занимавам с изкуство. Но понеже съм от малък град, а в малкия град мечтите ти са потиснати от какви ли не обстоятелства, не смеех да преследвам големи мечти. И дълго време само тайно исках да се занимавам с кино. 

Не знам как реших, че ще преследвам мечтата си този път. Започнах да уча кинорежисура, след това работих в корпоративния сектор… Така след известно търсене на себе си в чужбина и у нас попаднах на една обява на „Заедно в час“ и реших, че ще ставам учител. Никога преди това не съм си го представял, не съм мислил това за някаква възможна за мен професия. Но започнах и ето ни тук…

Образованието Ви е намерило неочаквано, но е успяло да Ви задържи по-дълго от всичко останало. Защо?

Абсолютно е така. Може би защото още на първата година интегрирах киното, успях да направя тази сглобка (смее се). Избягвах думата, но трябваше да я кажа. И тая сглобка, която се получи, ме кара да се чувствам добре. Най-важното е срещата с децата. Много бързо разбрах, че нищо в децата не може да ме накара да съм тревожен, притеснен, напрегнат. По-скоро с колегите, с училищната среда, с институционалността срещам затруднения. Но се чувствам чудесно с работата си. 

Мислил ли сте как се получава това?

Според мен първо по важност е не дали учителят може прецизно да си предаде урока, дали е добър в прилагането на интерактивни методи и други модерни думи, не че те са лоши. Най-важното е дали има автентично и искрено желание да общува с деца, да му е интересен техният свят. Не искам това да звучи наивно или патетично, но това е истината. 

А как стигнахте до училището в съседство с родното Ви село? 

Работя тук от самото начало. Когато отидох на интервюто в „Заедно в час“, им казах, че имам едно-единствено условие и то е да работя в Дерманци. Истината е, че аз дори знаех, че учителката по английски скоро напуска, и нещата станаха естествено. 

С какви ученици се срещнахте в училището в Дерманци?

С всякакви ученици. Тогава беше основно училище, сега вече сме до 10. клас. Ние сме двама учители по английски и си разпределяме класовете. Например тази година преподавам на деца от втори до седми клас. Това отваря интересни въпроси за образователната система. 

Какви?

Ако си учител в голям град и в училището ти има четири паралелки в пети клас, ти си учител по английски език в пети клас и да кажем, в шести или осми клас. В същото време аз трябва да преподавам във втори, трети, четвърти, пети, шести и седми клас, което са шест различни нива. Ако утре имам пет часа, подготвям пет различни урока – от картинки с думички за втори клас до сегашно перфектно време и граматическа конструкция. И аз пак съм с привилегия, защото това е език. Докато, ако преподаваш биология или история, или математика, това е изключително предизвикателство. Дори да си невероятен учител, колко ефективен можеш да си и колко дълго, когато работиш по този начин? 

Тези неща матурата, НВО и PISA само ги регистрират под формата на разлики между постиженията на децата в градовете и селата, но не ги обясняват. Министърът говори много хубаво, но на следващия ден ние получаваме от МОН някакви инструкции, които са еднакви за мен и за учителя във водеща гимназия в София. Това не ми помага.

Другият въпрос е паралелната вселена на частните уроци. Наричам я вселена, защото тя се отваря и всичко потъва в нея… Тя е назована, идентифицирана и след това си скръстваме ръцете и казваме: „Да, добре.“ МОН имам предвид. МОН е загубило всякаква състоятелност по отношение на работата си с уязвими групи и с решаването на големите образователни неравенства. 

Автентичният интерес прави един учител успешен
Даниел Симеонов © Личен архив

И на този фон Вие правите школа по кино в село Дерманци? Доста бутиково начинание.

Да. Да Ви кажа, начинанието ни би било също толкова бутиково и в София, и в Пловдив, и в Бургас… В рамките на образователната система децата нямат истинска среща с изкуството, всичко минава през занаятчийството. Докато концепцията, която ние имаме за киноучилище, е киното да е педагогически инструмент. Киното да е отправна точка за създаване на устойчиви нагласи у децата, компетентност и т.нар. меки умения – да работят в екип, да изразяват отношение към света, да имат критическо мислене, да развиват своите комуникационни, презентационни умения, като същевременно срещата с изкуството е на първо място. 

Може ли да дадете пример какво означава това?

Процесът при нас протича така – гледаме филм, след това го мислим, обсъждаме, пишем за него. А не: „Извадете си тетрадките и запишете: Видове обективи.“ Образно казано, разбира се. Това обаче е много голямо предизвикателство, понякога институциите изобщо не разбират какво правим. Трябва много време, ние дори сме адаптирали някакви неща, за да се срещнем чисто понятийно. Защото понякога не ни разбират, като казваме, че децата в шести клас разсъждават върху откъс на Тарковски или Бунюел. В България има изключително подценяване на киното и на изкуството изобщо. 

Малко трудно се говори за това, защото хората се обиждат, но ако трябва да си кажем истината, нека обърнем поглед към музиката и изобразителното изкуство, които са представени в учебната програма. Самата програма и какво е заложено в нея, е по-малкият проблем според мен. Но нека погледнем учителите. 

За съжаление, пак трябва да направим разграничение между градовете и селата. В града аз бих направил анкета колко учители по изобразително изкуство и музика ходят на концерти и изложби, каква музика слушат, защото това е най-искреният опит, който ще предадат на децата. Работят ли с текстове, коментират ли произведения на изкуството, или часовете са пълнеж. 

В селата пък в повечето случаи няма учители по музика и изобразително изкуство. Няма как да има учител по изобразително изкуство в нашето училище, защото часовете му трудно ще направят и половин норматив. Така учителката по английски, моята колега, понеже има по-малко часове по английски, взема и музиката. Тя е много отговорен човек, но според Вас колко е мотивирана да преподава музика, каква е нейната компетентност и отдаденост? И макар у нас да липсва съзнание за това, тези проблеми също допринасят за тъжните ни резултати на всякакви видове изпити.

Може ли да обясните по-подробно това?

Ако едно училище може да развива добре предметите по изкуства, без да е специализирано в тях, това води до по-голяма добавена стойност за учениците, за общата им култура. Помага им в разбирането на текстове от по-разнообразни сфери на живота. Защото моите деца, дори да са умни, ако им се падне на PISA един текст за Шопен, те никога не са чували за него и това автоматично вдига трудността на задачата. 

Изпитвал съм това на себе си, когато се явявах на TOEFL (изпит по английски език – б.а.). Падна ми се текст за гама-лъчението, радиоактивните вълни и така нататък. За мен тези понятия са непознати и аз се боря не с английския, а с много други неща. Със своята притесненост, тревожност, с абсолютното усилие да запомня, защото темата ми е безкрайно далечна. Аз съм възрастен човек, явявал съм се на десетки изпити, учил съм в няколко държави. А представете си как се чувства в такава ситуация едно дете на 13–14 години и как това се отразява на представянето му. 

При тези изходни условия как въвличате учениците си в идеята да се занимават с кино? 

Ще се върна в началото на нашия разговор, когато ме попитахте с какви деца съм се срещнал. Аз пътувам много и смело мога да кажа, че са деца като всички. Моите деца са абсолютно същите, със същите страхове, вълнения, радости, тревоги, но с едно голямо изключение – те нямат достъп до възможности. И това, бих казал, е национален проблем. 

Вие споменахте, че децата Ви отиват сега на кино. Просто си взимат връхните дрешки, хващат някакъв обществен транспорт и отиват да гледат филм. Моите деца нямат тази възможност. По пътя към киното или към парка, или където и да отиват, Вашите деца ще видят плакати на други филми, на концерти, може би на някоя по-популярна театрална постановка. Ще видят плаката на „Дюн 2“, ще извадят телефоните и ще си кажат: „Я да го чекна.“ Те неволно вече ще са се срещнали с други изкуства, с един по-широк свят. Моите няма къде да видят този плакат, за да направят това усилие и тоя елементарен рисърч, който връстниците им ще направят, докато се возят в автобуса. Нещо толкова просто и толкова гигантско като проблем. 

Но Вие ме попитахте как ги въвличам – много просто, аз искам автентично да общувам с тях и това се отплаща. От значение е, че съм от тяхната общност, живея на 7 километра, някои деца живеят в моето село. И в същото време имам високи очаквания от тях. Ето, днес е събота, след 15 минути трябва да тръгна към Дерманци, защото ще монтираме филма, който ще представяме в Португалия. И съм малко разочарован, че няма да дойдат всички седем деца, а ще дойдат четири. В същото време си казвам: „Луд ли си, днес е събота и цели четири деца ще дойдат доброволно, без заплаха от двойки или отсъствия, да правят нещо за училище.“ Те са мотивирани от дейността и от връзката ни; от една страна, им е интересно, от друга страна, за тях е важно да не ме разочароват. 

Споменахте, че се подготвяте за фестивал в Португалия, в предходни години сте водили учениците си на фестивали за младежко кино в Германия, във Франция… Как успявате? Някои от децата, които живеят в малки и отдалечени населени места, не са стигали дори до областния град.

Успявам с лични усилия и с подкрепата на организацията „Арте Урбана Колектив“, с която правим всичко това. Това е много дълъг и трудоемък логистичен процес, но си струва, за децата е страхотна възможност. За съжаление, българското образование чрез националните си програми не дава такива възможности. Националните програми много често ти казват: „Ние ти даваме пари за едно пътуване в рамките на областта.“ Благодаря, но аз в моята област нищо не мога да направя. Например, ако живея на 20 км от Плевен и на 40 км от Ловеч, но съм в Ловешка област, трябва да отида в Ловеч. Освен че е по-далеч, там изборът на изложби или концерти е много по-ограничен. 

И за съжаление, тези недомислици дори не са резултат от злонамереност, а от комбинация на инерция, липса на инициативност и желание за прогрес. Написах едно писмо, с което предложих тези ограничения да се променят, и получих положителен отговор. Същото стана с програмата „Заедно в изкуството и спорта“. Там бяха заложени ограничен брой изкуства, най-популярните. По време на общественото обсъждане ние предложихме да се включи и филмовото изкуство. Отговориха ни, че от догодина ще се включи. И това се случи. Тази година добавят и фотография. Добре, но има още толкова необхванати възможности. Защо не се даде възможност училищата да определят изкуството, което ще развиват. Някой може да има възможност да развива цирково изкуство, знам ли. Или да се направи микс от изкуства, защо не?

Смесвате ли кино и английски? 

Не. Напротив, искам да бъдат ясно разграничени. Искам да знаят, че клипчетата, които гледаме в часовете по английски, не са кино. И в същото време не искам нивото на английския да им пречи да се срещат с киноизкуството. В нашето училище е абсолютно забранено да пускаме филми без педагогическа идея, просто за да пълним време. Едно е по история в девети клас да пуснеш филм за Втората световна война, друго е на втори клас да им пуснеш „Мики Маус“, за да мълчат. 

Навеждате ме на мисълта как се вписва в този контекст пускането в час по „Човекът и обществото“ в начален курс клип на Слави Клашъра…

Зле. Слави Клашъра не можем да го забраним, но един уважаващ себе си учител не може да го пуска като образователен материал. Ако ще го пускаме на децата, след това трябва да направим критично обсъждане – как смесва доказани факти и разни мистики и измислици, защо това е проблем, защо не е добре да го ползваме за източник. Тук топката пак е в учителите. Както срещаме децата с автентичното киноизкуство, така очакваме и другите учители да ги срещат с автентична наука.

Тук според мен има едно оправдание на възрастните, не само на учителите – че сегашните деца не се интересуват от това, което ние като възрастни искаме да им кажем. Вашите наблюдения такива ли са?

Откога преподаваме само неща, които предварително се харесват на децата? На тях може да им харесва по цял ден да са на телефоните, на моите – по цял ден да играят кючеци. Училището е там, за да каже нещо ново – ето, сега ще си говорим някакви безинтересни неща, а аз ще се постарая да ги предам по интересен начин. Не е вярно, че децата не се интересуват, но когато човек има ниски очаквания и от тях, и от себе си, няма как да са успешни. Твоя работа е да го направиш интересно – съжалявам, но това е истината. Твоя работа е да помислиш как да стане. Как да направиш връзка с техния свят. 

Примерно, как да говорим за стереотипи и предразсъдъци? Да извадя един учебник и да им диктувам? Не, аз говоря през техния опит, защото те са се срещали с това. Гледахме един филм на Фасбиндер – „Страх изяжда душата“. Моите деца ги познавам, те имат близки роднини, приятели, които са гастарбайтери. И така през техния опит отворихме много дълбок разговор. След това снимаха интервюта с хора, които работят в чужбина, за препятствията в техния живот, как се чувстват там и какви са предразсъдъците, които срещат. И повярвайте ми, че всички работиха с голяма мотивация и разбиране.

Искам да завършим този разговор с някой много умен въпрос, но за съжаление, не разполагам с такъв. Може би Вие като учител ще ми подскажете какъв е умният отговор, който търся за финал?

Ъглите, от които можем да гледаме към образованието, са прекалено много, травмата е прекалено голяма. 

Но ако търсим умен финал, бих казал, че „дела трябват, а не думи“. Съжалявам, че ползвам този цитат на Левски, който се е превърнал в клише. За реформа в образованието се говори отдавна, но се работи на парче – един текст в тази наредба, втори в онази наредба. Това не води доникъде. Ужасно закъснели сме с това усилие и то трябва да мине през всички пластове на системата – от преформулиране на ролята на синдикалните структури, през програмите, учителите, всичко останало. И да се направи.

The collective thoughts of the interwebz