Tag Archives: Uncategorized

Zero-Day Exploit Against Windows BitLocker

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/zero-day-exploit-against-windows-bitlocker.html

It’s nasty, but it requires physical access to the computer:

The exploit, named YellowKey, was published earlier this week by a researcher who goes by the alias Nightmare-Eclipse. It reliably bypasses default Windows 11 deployments of BitLocker, the full-volume encryption protection Microsoft provides to make disk contents off-limits to anyone without the decryption key, which is stored in a secured piece of hardware known as a trusted platform module (TPM). BitLocker is a mandatory protection for many organizations, including those that contract with governments.

Slashdot thread. And here’s Nightmare-Eclipse’s GitHub account.

Upcoming Speaking Engagements

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/upcoming-speaking-engagements-56.html

This is a current list of where and when I am scheduled to speak:

The list is maintained on this page.

How Dangerous Is Anthropic’s Mythos AI?

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/how-dangerous-is-anthropics-mythos-ai.html

Last month, Anthropic made a remarkable announcement about its new model, Claude Mythos Preview: it was so good at finding security vulnerabilities in software that the company would not release it to the general public. Instead, it would only be available to a select group of companies to scan and fix their own software.

The announcement requires context—but it contained an essential truth.

While Anthropic’s model is really good at finding software vulnerabilities, so are other models. The UK’s AI Security Institute found that OpenAI’s GPT-5.5, already generally available, is comparable in capability. The company Aisle reproduced Anthropic’s published results with smaller, cheaper models.

At the same time, Anthropic’s refusal to publicly release its new model makes a virtue out of necessity. Mythos is very expensive to run, and the company doesn’t appear to have the resources for a general release. What better way to juice the company’s valuation than to hint at capabilities but not prove them, and then have others parrot their claims?

Nonetheless, the truth is scary. Modern generative AI systems—not just Anthropic’s, but OpenAI’s and other, open-source models—are getting really good at finding and exploiting vulnerabilities in software. And that has important ramifications for cybersecurity: on both the offense and the defense.

Attackers will use these capabilities to find, and automatically hack, vulnerabilities in systems of all kinds. They will be able to break into critical systems around the world, sometimes to plant ransomware and make money, sometimes to steal data for espionage purposes, and sometimes to control systems in times of hostility. This will make the world a much more dangerous, and more volatile, place.

But at the same time, defenders will use these same capabilities to find, and then patch, many of those same systems. For example, Mozilla used Mythos to find 271 vulnerabilities in Firefox. Those vulnerabilities have been fixed, and will never again be available to attackers. In the future, AIs automatically finding and fixing vulnerabilities in all software will be a normal part of the development process, which will result in much more secure software.

Of course, it’s not that simple. We should expect a deluge of both attackers using newly found vulnerabilities to break into systems, and at the same time much more frequent software updates for every app and device we use. But lots of systems aren’t patchable, and many systems that are don’t get patched, meaning that many vulnerabilities will stick around. And it does seem that finding and exploiting is easier than finding and fixing. All of this points to a more dangerous short-term future. Organizations will need to adapt their security to this new reality.

But it’s the long term that we need to focus on. Mythos isn’t unique, but it’s more capable than many models that have come before. And it’s less capable than models that will come after. AIs are much better at writing software than they were just six months ago. There’s every reason to believe that they will continue to get better, which means that they will get better at writing more secure software. The endgame gives AI-enhanced defenders advantages over AI-enhanced attackers.

Even more interesting are the broader implications. The same searching, pattern-matching and reasoning capabilities that make these models so good at analyzing software almost certainly apply to similar systems. The tax code isn’t computer code, but it’s a series of algorithms with inputs and outputs. It has vulnerabilities; we call them tax loopholes. It has exploits; we call them tax avoidance strategies. And it has black hat hackers: attorneys and accountants.

Just as these models are finding hundreds of vulnerabilities in complex software systems, we should expect them to be equally effective at finding many new and undiscovered tax loopholes. I am confident that the major investment banks are working on this right now, in secret. They’ve fed AI the tax code of the US, or the UK, or maybe every industrialized country, and tasked the system with looking for money-saving strategies. How many tax loopholes will those AIs find? Ten? One hundred? One thousand? The Double Dutch Irish Sandwich is a tax loophole that involves multiple different tax jurisdictions. Can AIs find loopholes even more complex? We have no idea.

Sure, the AIs will come up with a bunch of tricks that won’t work, but that’s where those attorneys and accountants come in—to verify, and then justify, the loopholes. And then to market them to their wealthy clients.

As goes the tax code, so goes any other complex system of rules and strategies. These models could be tasked with finding loopholes in environmental rules, or food and safety rules—anywhere there are complex regulatory systems and powerful people who want to evade those rules.

The results will be much worse than insecure computers. Tax loopholes result in less revenue collected by governments, and regulatory loopholes allow the powerful to skirt the rules, both of which have all sorts of social ramifications. And while software vendors can patch their systems in days, it generally takes years for a country to amend its tax code. And that process is political, with lobbyists pressuring legislators not to patch. Just look at the carried interest loophole, a US tax dodge that has been exploited for decades. Various administrations have tried to close the vulnerability, but legislators just can’t seem to resist lobbyists long enough to patch it.

AI technologies are poised to remake much of society. Just as the industrial revolution gave humans the ability to consume calories outside of their bodies at scale, the AI revolution will give humans the ability to perform cognitive tasks outside of their bodies at scale. Our systems aren’t designed for that; they’re designed for more human paces of cognition. We’re seeing it right now in the deluge of software vulnerabilities that these models are finding and exploiting. And we will soon see it in a deluge of vulnerabilities in all sorts of other systems of rules. Adapting to this new reality will be hard, but we don’t have any choice.

This essay originally appeared in The Guardian.

OpenAI’s GPT-5.5 is as Good as Mythos at Finding Security Vulnerabilities

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/openais-gpt-5-5-is-as-good-as-mythos-at-finding-security-vulnerabilities.html

The UK’s AI Security Institute evaluated GPT-5.5’s ability to find security vulnerabilities, and found that it is comparable to Claude Mythos. Note that the OpenAI model is generally available.

Here is the Institute’s evaluation of Mythos.

And here is an analysis of a smaller, cheaper model. It requires more scaffolding from the prompter, but it is also just as good.

Copy.Fail Linux Vulnerability

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/copy-fail-linux-vulnerability.html

This is the worst Linux vulnerability in years.

TL;DR

  • copy.fail is a Linux kernel local privilege escalation, not a browser or clipboard attack. Disclosed by Theori on 29 April 2026 with a working PoC.
  • It abuses the kernel crypto API (AF_ALG sockets) plus splice() to write four bytes at a time straight into the page cache of a file the attacker does not own.
  • The exploit works unmodified across Ubuntu, RHEL, Debian, SUSE, Amazon Linux, Fedora and most others. No race condition, no per-distro offsets.
  • The file on disk is never modified. AIDE, Tripwire and checksum-based monitoring see nothing.
  • Kubernetes Pod Security Standards (Restricted) and the default RuntimeDefault seccomp profile do not block the syscall used. A custom seccomp profile is needed.
  • The mainline fix landed on 1 April. Distros are rolling kernels out now. Patch.

“Local privilege escalation” sounds dry, so let me unpack it. It means: an attacker who already has some way to run code on the machine, even as the most boring unprivileged user, can promote themselves to root. From there they can read every file, install backdoors, watch every process, and pivot to other systems.

Why does that matter on shared infrastructure? Because “local” covers a lot of ground in 2026: every container on a shared Kubernetes node, every tenant on a shared hosting box, every CI/CD job that runs untrusted pull-request code, every WSL2 instance on a Windows laptop, every containerised AI agent given shell access. They all share one Linux kernel with their neighbours. A kernel LPE collapses that boundary.

News article.

Agentic application modernization at scale with Strands and Amazon Transform custom

Post Syndicated from Kanishk Mahajan original https://aws.amazon.com/blogs/devops/use-generative-ai-agents-for-application-modernization-at-scale-with-strands-amazon-transform-custom-and-amazon-bedrock-agentcore/

Introduction

Modernizing applications by upgrading language runtimes, migrating SDKs, and refactoring frameworks is important for cloud adoption but can be labor-intensive at scale. Each repository requires analysis of dependencies and transformation needs; custom transformation logic must be built and validated, and changes are often executed sequentially across codebases. If you have hundreds of applications, this stretches timelines from months to years, while introducing inconsistency across your teams.

To address this, Amazon Web Services (AWS) provides a composable set of building blocks. AWS Transform custom enables reusable, CLI-driven code transformations for upgrading runtimes, SDKs, and frameworks consistently across large portfolios. Strands Agents provides a framework for building multi-agent systems that coordinate complex transformation workflows. Amazon Bedrock AgentCore delivers the managed runtime, memory, and observability to operate these agents reliably in production. Together, they replace manual, sequential modernization with an intelligent, automated approach that scales.

In this post, we show you how to combine these services to build a generative AI–powered, agentic modernization system that can automatically analyze application repositories, determine required changes, create missing transformations, and execute them in parallel at scale.

Solution overview

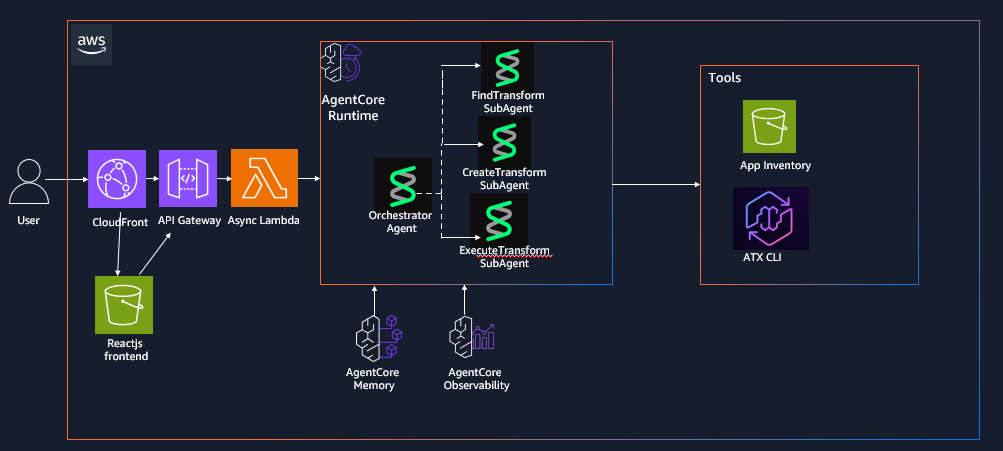
The solution uses an agentic architecture that separates intelligent decision-making from deterministic execution, enabling automation at scale while maintaining consistency and control. In this post, you will build an AI-driven application modernization system that demonstrates how multi-agent workflows can be applied to large-scale code transformation scenarios. You interact with the system through a React-based frontend or API interface, submitting individual repositories or batch workloads via CSV inputs. Requests are processed asynchronously through an API layer that invokes an orchestrator agent running on Amazon Bedrock AgentCore, which coordinates specialized agents to analyze codebases, identify transformation requirements, and manage execution workflows. Results are stored and surfaced through the interface, allowing users to track progress and review outputs in real time.The workflow begins with repository analysis, where the system inspects application codebases to identify languages, dependencies, and required upgrades such as runtime version changes or SDK migrations. Based on this analysis, the system maps each application to an existing transformation when available. If no suitable transformation exists, a creation agent dynamically generates one using natural language instructions and publishes it to a centralized registry for reuse, creating a continuously improving system where transformation coverage expands over time.

Once transformations are identified or created, an execution agent runs them at scale by invoking AWS Batch jobs that execute the AWS Transform custom CLI, enabling parallel processing across multiple repositories. The orchestrator coordinates all agents, maintains workflow state using Amazon Bedrock AgentCore Memory, and ensures reliable execution through structured task decomposition, tool invocation, and error handling. While the example focuses on application re-platforming, the same architectural pattern can be applied to other large-scale code analysis and automation workflows.

The following architecture diagram (Figure 1) illustrates the various components of our solution as outlined in this section:architecture diagram describing the multi agent strands and agentcore deployment

Figure 1: AWS Transform custom Agentic Orchestration Architecture using Strands agents and Amazon Bedrock AgentCore

Prerequisites

Complete the following prerequisites:

  1. Install the AWS Command Line Interface (AWS CLI).
  2. Install the AWS SAM CLI v1.100.0+
  3. Install Docker v20.x+.
  4. Install Node.js v18.x+
  5. Install Python v3.11+
  6. Install the AWS CDK CLI
  7. Enable access to a Bedrock model for the orchestrator in your deployment region. The default model can be configured through the Amazon Bedrock model access console. To use a different model, set `BEDROCK_MODEL_ID` in `deployment/config.env` before Step 3 and enable access to that model instead. Model access approval can take a few minutes in some accounts, so complete this step before deploying.

Dependencies

The Strands Agents implementation has the following dependencies that are packaged in the DockerFile:

  1. Strands multi-agent framework: strands-agents
  2. Strands agent tools and utilities: strands-agents-tools
  3. HTTP library for API calls: requests
  4. Amazon Bedrock AgentCore SDK: bedrock-agentcore
  5. AWS SDK for Python: boto3

Deploy the solution

The solution is available for download on the GitHub repo. This post walks through the CDK + SAM deployment path (Option A in the repository README). The repository also includes a CDK-only option (Option B); see the repository README for details.

Step 1: Clone the repository

git clone https://github.com/aws-samples/aws-transform-custom-samples.git

cd aws-transform-custom-samples/agentic-atx-platform

Step 2: Configure AWS Credentials

# Configure AWS CLI

aws configure

# Verify credentials

aws sts get-caller-identity

Step 3: Deploy ATX CLI Container image and frontend using AWS CDK

# Copy configuration template (defaults work for most setups; edit only to change region or Bedrock model)

cd deployment

cp config.env.template config.env

# Authenticate with Amazon ECR Public (required for the Docker base image pull)

aws ecr-public get-login-password --region us-east-1 | docker login --username AWS --password-stdin public.ecr.aws

# Build the UI placeholder so CDK’s UI stack has ui/dist/ to deploy

cd ../ui && npm install && npx vite build

# Install CDK dependencies and bootstrap (run once per account/region)

cd ../cdk

npm install cdk bootstrap

# Build TypeScript and deploy the three stacks

npx tsc

CDK_DEFAULT_ACCOUNT=$(aws sts get-caller-identity --query Account --output text)

cdk deploy AtxContainerStack AtxInfrastructureStack AtxUiStack --require-approval never

# Note for accounts without a default VPC , pass the VPC context flags to `cdk deploy`:

cdk deploy AtxContainerStack AtxInfrastructureStack AtxUiStack --require-approval never

cdk deploy AtxContainerStack AtxInfrastructureStack AtxUiStack --require-approval never -c existingVpcId=vpc-xxx -c existingSubnetIds=subnet-aaa,subnet-bbb -c existingSecurityGroupId=sg-ccc

# Subnets must be public (auto-assign public IP enabled) or private with a NAT gateway so Fargate tasks can reach Amazon ECR, Amazon S3, and Git repositories.

Step 4: Deploy Strands Agents to AgentCore runtime using AWS SAM

cd ../sam./deploy.sh

# Invoke the deploy Lambda to create the AgentCore Runtime via the bedrock-agentcore-control SDK (takes 2-5 minutes)

aws lambda invoke --function-name atx-deploy-agentcore \ --region us-east-1 \ --cli-binary-format raw-in-base64-out \ --payload '{"action":"deploy"}' \ --cli-read-timeout 900 /tmp/deploy-output.jsoncat /tmp/deploy-output.json

Step 5: Wire the AgentCore runtime ARN into the async invoke Lambda

ACCOUNT_ID=$(aws sts get-caller-identity --query Account --output text)

RUNTIME_ARN=$(python3 -c "import json; print(json.loads(json.load(open('/tmp/deploy-output.json'))['body'])['runtime_arn'])")aws lambda update-function-configuration \ --function-name atx-async-invoke-agent \ --region us-east-1 \ --environment "Variables={AGENT_RUNTIME_ARN=${RUNTIME_ARN},RESULT_BUCKET=atx-custom-output-${ACCOUNT_ID},JOBS_TABLE=atx-transform-jobs}"

Step 6: Rebuild and deploy the frontend with AgentCore API endpoint

# Update the React application with the deployed API endpoint and redeploy it.

API_URL=$(aws cloudformation describe-stacks \ --stack-name AtxAgentCoreSAM \ --region us-east-1 \ --query 'Stacks[0].Outputs[?OutputKey==`ApiEndpoint`].OutputValue' \ --output text)

cd ../ui

VITE_API_ENDPOINT=$API_URL npx vite build./deploy-aws.sh

# This rebuilds the React application with the correct API endpoint, uploads it to Amazon S3, and invalidates the Amazon CloudFront distribution.

Step 7: Access the application

# After deployment completes, retrieve the CloudFront distribution URL from the AWS CloudFormation outputs and open it in your browser to access the application UI.

aws cloudformation describe-stacks \ --stack-name AtxUiStack \ --region us-east-1 \ --query 'Stacks[0].Outputs[?OutputKey==`WebsiteUrl`].OutputValue' \ --output text

Using the application

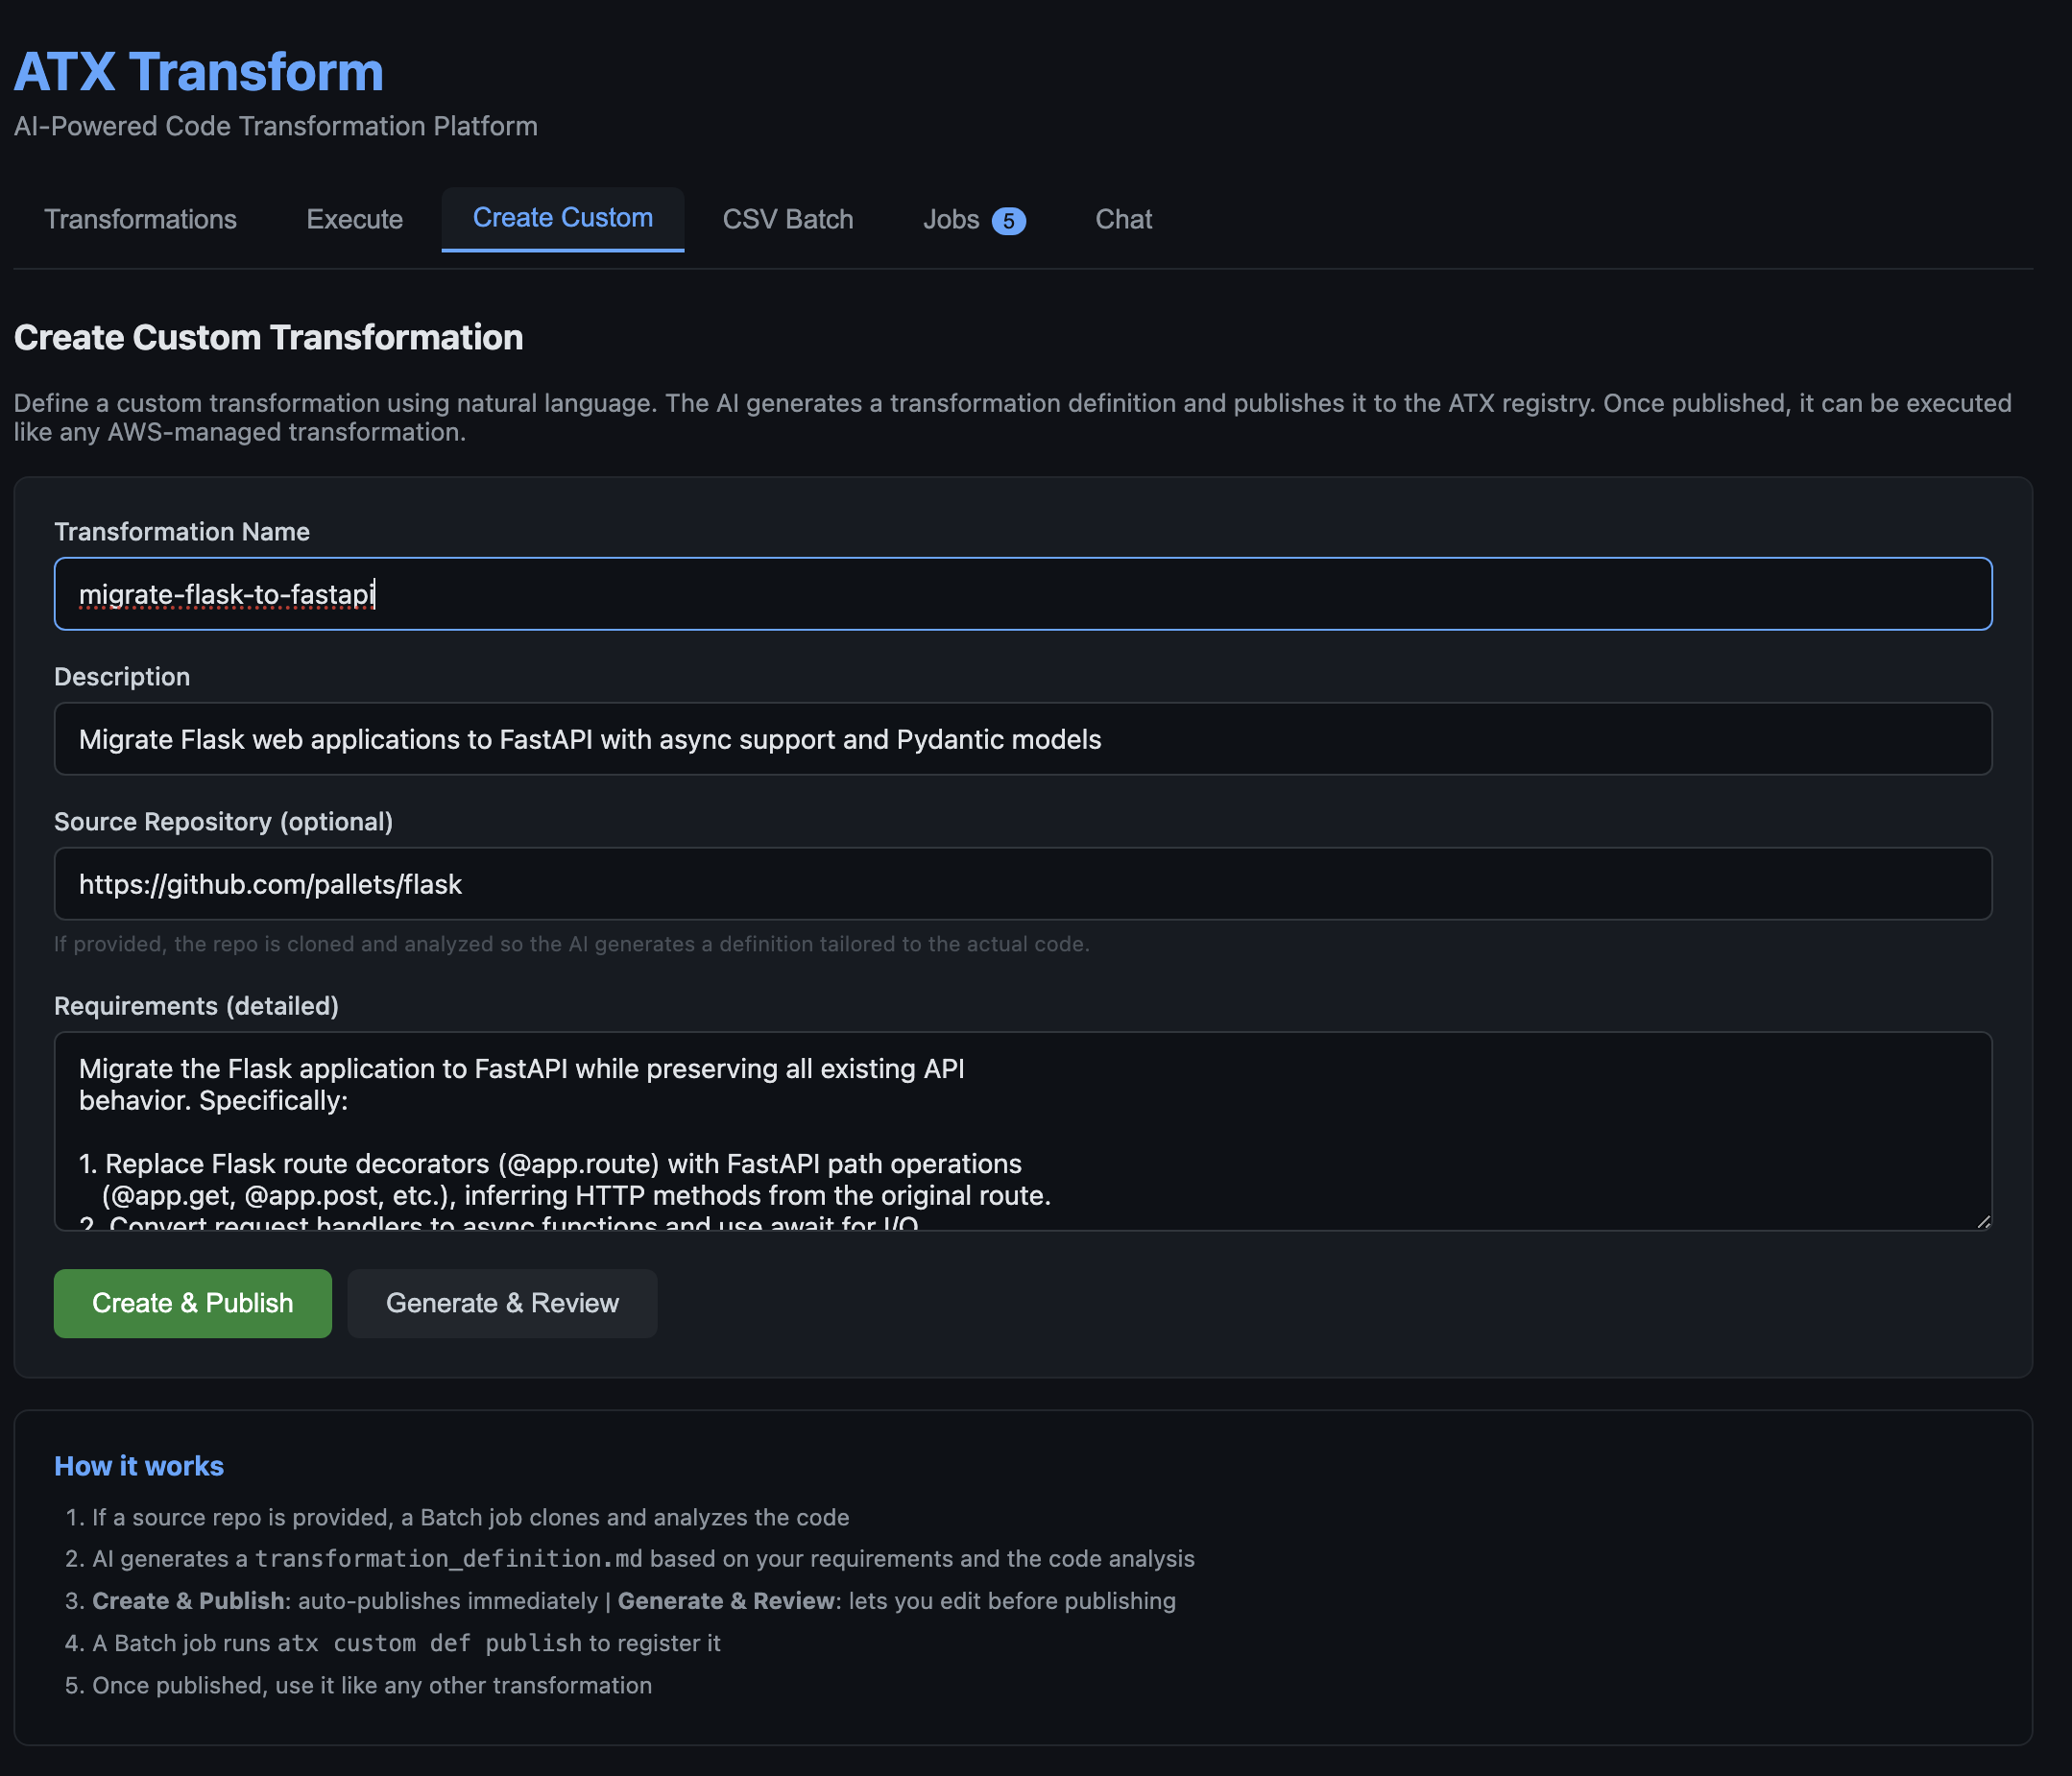
The UI exposes five tabs covering the complete modernization workflow: browsing available transformations, executing a transformation on a single repository, creating a new custom transformation with natural language, batch-processing a CSV of repositories, and tracking job status. This section walks through two of the most common flows.

Create a custom transformation from natural language

Open the Create Custom tab, describe the transformation in plain English (for example, “Upgrade Spring Boot 2 applications to Spring Boot 3”), and optionally provide a reference repository URL. The creation agent analyzes the source, generates a transformation definition, and publishes it to the ATX registry for reuse across the portfolio.

Describing a custom transformation in plain English. The form accepts a name, description, optional reference repository, and natural-language requirements.

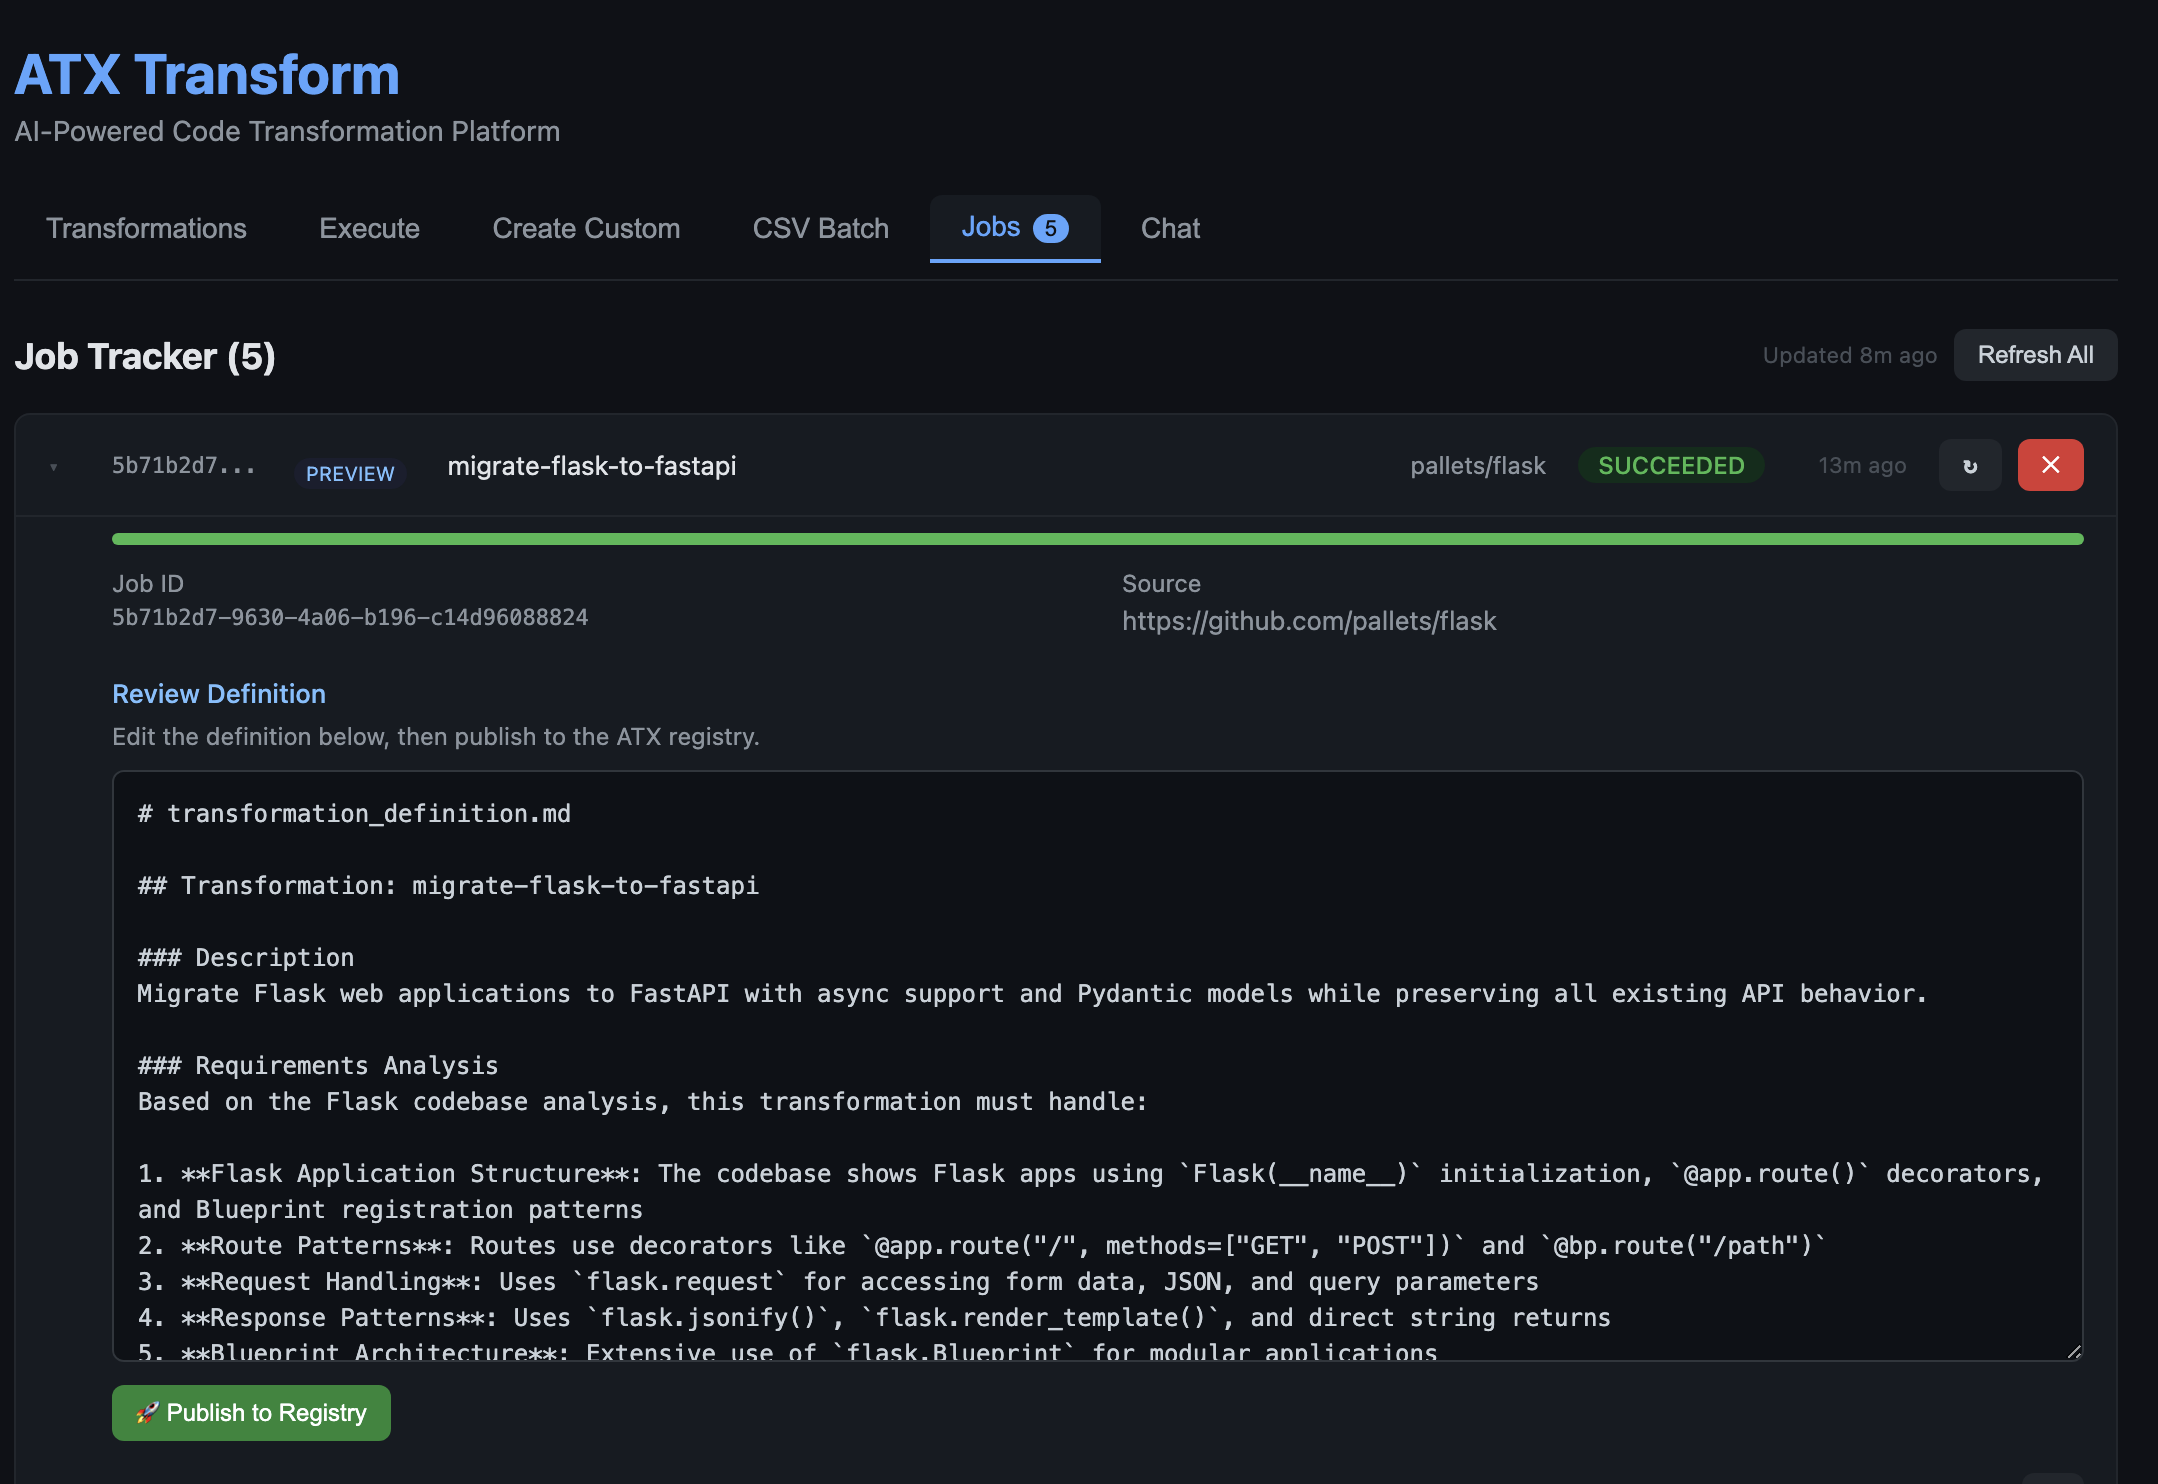
Figure 2: Describing a custom transformation in plain English. The form accepts a name, description, optional reference repository, and natural-language requirements.After submitting, the orchestrator clones the reference repository, analyzes the source, and generates a transformation definition tailored to the actual code patterns found in the codebase. This takes 1–5 minutes depending on repository size. The generated definition is then shown for review in the Jobs tab, where it can be edited before publishing to the ATX registry.

Figure 3: The AI-generated transformation definition shown for review in the Jobs tab. The agent analyzed the Flask codebase and produced a detailed definition covering routes, request handling, response patterns, and Blueprint architecture. The user can edit the definition in-place and click Publish to Registry when ready.Once published, the new transformation appears in the Transformations tab alongside AWS-managed transformations and can be executed the same way on any repository.

Run a batch of repositories from a CSV

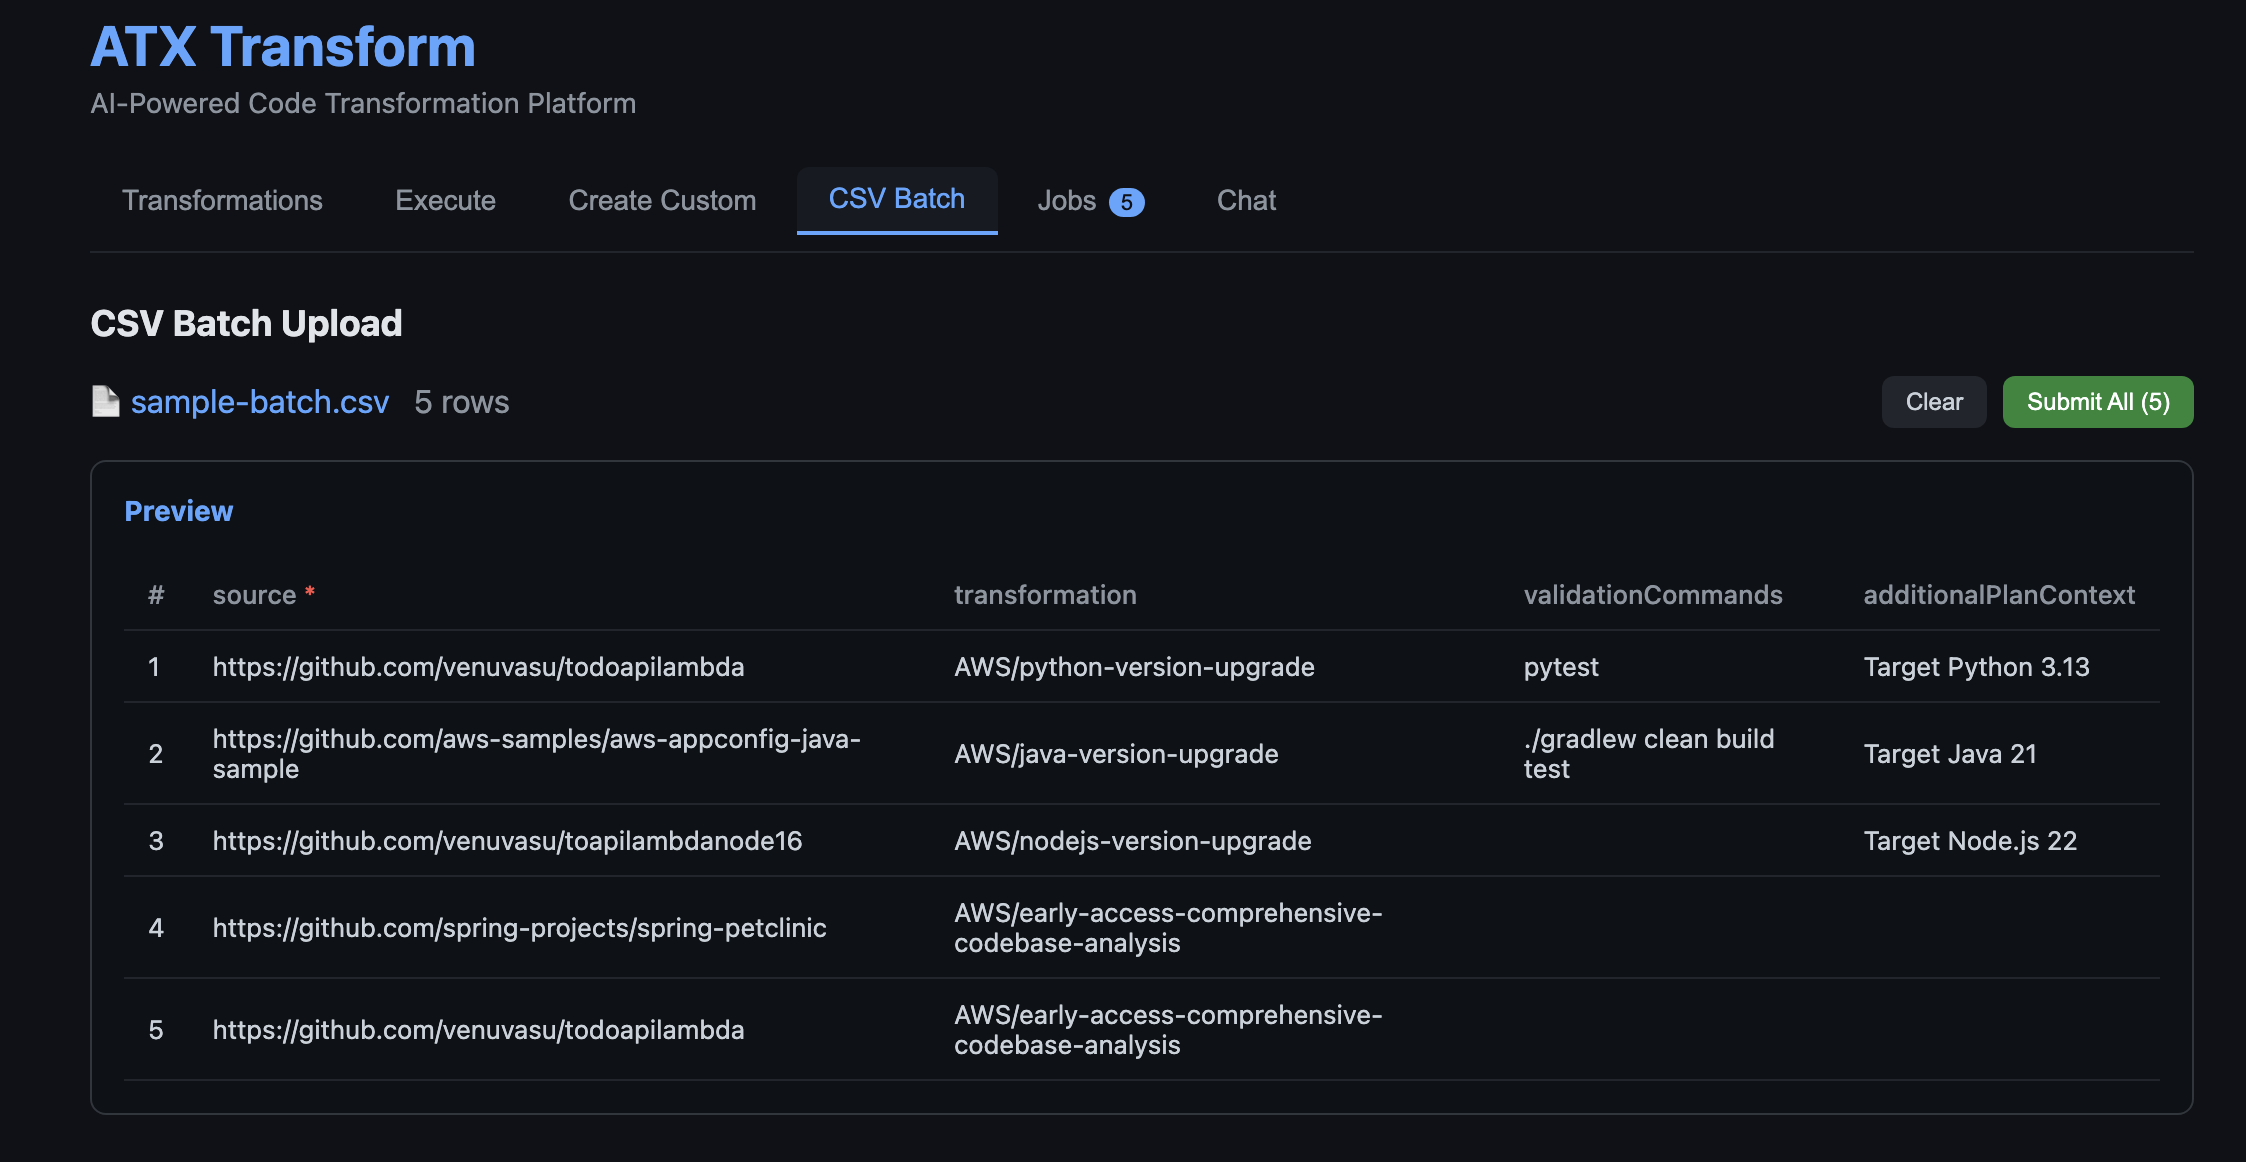
Open the CSV Batch tab and upload a CSV listing repository URLs and target transformations. A sample `sample-batch.csv` is included in the repository at `agentic-atx-platform/ui/sample-batch.csv`. The preview shows the parsed rows before submission. On Submit All, each row becomes a separate AWS Batch job running in parallel, and the Jobs tab shows live status as repositories complete.

Uploading a batch of repositories for parallel processing. The CSV lists a source repository URL, target transformation, optional validation commands, and additional plan context per row.

Figure 4: Uploading a batch of repositories for parallel processing. The CSV lists a source repository URL, target transformation, optional validation commands, and additional plan context per row. Each row becomes an independent AWS Batch job on submission.

Clean up

To avoid recurring charges, remove the resources after trying the solution.

Step 1: Delete the SAM Stack

sam delete --stack-name AtxAgentCoreSAM --region us-east-1 --no-prompts

Step 2: Delete the CDK Stacks

Remove the three CDK stacks in reverse order. The S3 buckets are configured with `autoDeleteObjects: true`, so CDK will empty them before deletion.

cd cdk

npx cdk destroy AtxUiStack AtxInfrastructureStack AtxContainerStack --force

Conclusion

In this post, you learned how to build a generative AI–powered, agentic system for application modernization that can analyze application repositories, determine required code changes, create missing transformations, and execute those transformations at scale. By combining AWS Transform Custom for transformation execution with Amazon Bedrock AgentCore for orchestration, and Strands Agents for multi-agent coordination and AWS Transform container solution for parallel processing, this approach demonstrates how intelligent automation can be applied to large-scale code transformation workflows.

This solution directly addresses the challenges of traditional modernization approaches. It reduces manual effort by automating repository analysis and transformation mapping, eliminates gaps in transformation coverage by dynamically generating reusable transformations, and significantly improves scalability through parallel execution using AWS Batch.

By introducing a centralized, agent-driven workflow with built-in observability and state management, organizations can achieve faster, more consistent, and governed modernization across large application portfolios. To get started, deploy the solution in your AWS environment, test it with a sample repository or batch workload, and extend it by creating custom transformations tailored to your applications. You can further integrate this approach into your CI/CD pipelines to enable continuous modernization and accelerate your cloud migration initiatives.


About the authors

Kanishk Mahajan is Principal – AI/ML with AWS Professional Services. In this role, he leads GenAI and agentic transformations for some of AWS largest customers in Telco and Media & Entertaintment.

Sandeep Batchu is a Senior Security Architect at Amazon Web Services, with extensive experience in software engineering, solutions architecture, and cybersecurity. Passionate about bridging business outcomes with technological innovation, Sandeep guides customers through their cloud and generative AI journey, helping them design and implement secure, scalable, and resilient architectures in the era of AI-driven transformation.

Venugopalan Vasudeven (Venu) is a Principal Specialist Solutions Architect at AWS, where he leads Agentic AI initiatives focused on AWS Transform. He helps customers adopt and scale AI-powered developer and modernization solutions to accelerate innovation and business outcomes.

Insider Betting on Polymarket

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/insider-betting-on-polymarket.html

Insider trading is rife on Polymarket:

Analysis by the Anti-Corruption Data Collective, a non-profit research and advocacy group, found that long-shot bets—­defined as wagers of $2,500 or more at odds of 35 percent or less—­on the platform had an average win rate of around 52 percent in markets on military and defense actions.

That compares with a win rate of 25 percent across all politics-focused markets and just 14 percent for all markets on the platform as a whole.

It is absolutely insane that this is legal. We already know how insider betting warps sports. Insider betting warping politics—and military actions—is orders of magnitude worse.

Rowhammer Attack Against NVIDIA Chips

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/rowhammer-attack-against-nvidia-chips.html

A new rowhammer attack gives complete control of NVIDIA CPUs.

On Thursday, two research teams, working independently of each other, demonstrated attacks against two cards from Nvidia’s Ampere generation that take GPU rowhammering into new—­and potentially much more consequential—­territory: GDDR bitflips that give adversaries full control of CPU memory, resulting in full system compromise of the host machine. For the attack to work, IOMMU memory management must be disabled, as is the default in BIOS settings.

“Our work shows that Rowhammer, which is well-studied on CPUs, is a serious threat on GPUs as well,” said Andrew Kwong, co-author of one of the papers. “GDDRHammer: Greatly Disturbing DRAM Rows­Cross-Component Rowhammer Attacks from Modern GPUs.” “With our work, we… show how an attacker can induce bit flips on the GPU to gain arbitrary read/write access to all of the CPU’s memory, resulting in complete compromise of the machine.”

Update Friday, April 3: On Friday, researchers unveiled a third Rowhammer attack that also demonstrates Rowhammer attacks on the RTX A6000 that achieves privilege escalation to a root shell. Unlike the previous two, the researchers said, it works even when IOMMU is enabled.

The second paper is GeForge: Hammering GDDR Memory to Forge GPU Page Tables for Fun and Profit:

…does largely the same thing, except that instead of exploiting the last-level page table, as GDDRHammer does, it manipulates the last-level page directory. It was able to induce 1,171 bitflips against the RTX 3060 and 202 bitflips against the RTX 6000.

GeForge, too, uses novel hammering patterns and memory massaging to corrupt GPU page table mappings in GDDR6 memory to acquire read and write access to the GPU memory space. From there, it acquires the same privileges over host CPU memory. The GeForge proof-of-concept exploit against the RTX 3060 concludes by opening a root shell window that allows the attacker to issue commands that run unfettered privileges on the host machine. The researchers said that both GDDRHammer and GeForge could do the same thing against the RTC 6000.

DarkSword Malware

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/darksword-malware.html

DarkSword is a sophisticated piece of malware—probably government designed—that targets iOS.

Google Threat Intelligence Group (GTIG) has identified a new iOS full-chain exploit that leveraged multiple zero-day vulnerabilities to fully compromise devices. Based on toolmarks in recovered payloads, we believe the exploit chain to be called DarkSword. Since at least November 2025, GTIG has observed multiple commercial surveillance vendors and suspected state-sponsored actors utilizing DarkSword in distinct campaigns. These threat actors have deployed the exploit chain against targets in Saudi Arabia, Turkey, Malaysia, and Ukraine.

DarkSword supports iOS versions 18.4 through 18.7 and utilizes six different vulnerabilities to deploy final-stage payloads. GTIG has identified three distinct malware families deployed following a successful DarkSword compromise: GHOSTBLADE, GHOSTKNIFE, and GHOSTSABER. The proliferation of this single exploit chain across disparate threat actors mirrors the previously discovered Coruna iOS exploit kit. Notably, UNC6353, a suspected Russian espionage group previously observed using Coruna, has recently incorporated DarkSword into their watering hole campaigns.

A week after it was identified, a version of it leaked onto the internet, where it is being used more broadly.

This news is a month old. Your devices are safe, assuming you patch regularly.

Hacking Polymarket

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/05/hacking-polymarket.html

Polymarket is a platform where people can bet on real-world events, political and otherwise. Leaving the ethical considerations of this aside (for one, it facilitates assassination), one of the issues with making this work is the verification of these real-world events. Polymarket gamblers have threatened a journalist because his story was being used to verify an event. And now, gamblers are taking hair dryers to weather sensors to rig weather bets.

There’s also insider trading: a lot of it.

Amazon Q Developer end-of-support announcement

Post Syndicated from Ankit Sharma original https://aws.amazon.com/blogs/devops/amazon-q-developer-end-of-support-announcement/

When we launched Amazon Q Developer, our goal was to bring AI assistance directly into the developer workflow. Customers adopted Q Developer across VS Code, JetBrains, Eclipse, and Visual Studio, using it for code generation, debugging, and chat-based guidance. Q Developer proved that AI belongs in the inner loop of software development.

Over the past year, we’ve learned that the most impactful AI developer experiences go far beyond code generation and completion. Developers need AI that understands their entire project: the architecture, the requirements, the tests, and the intent behind the code. It requires a purpose-built environment. That’s why we built Kiro.

What is Kiro? Kiro is an agentic development environment (IDE, CLI) built from the ground up for spec-driven development. Instead of reacting to individual prompts, Kiro works from structured specifications to plan, implement, and verify changes across your entire codebase. Key capabilities include:

  • Specs — Define what you want to build in structured, natural-language requirements that Kiro uses to drive implementation end to end.
  • Hooks — Automated triggers that run on file save, commit, or other events to enforce standards, run tests, or update documentation without manual intervention.
  • Steering files — Project-level configuration that gives Kiro persistent context about your architecture, conventions, and constraints.
  • Custom subagents — Specialized AI agents you define for domain-specific tasks like security review, API contract validation, or infrastructure provisioning.
  • Powers — Composable capability modules that extend Kiro’s agentic behavior for your specific workflows.

Kiro also includes everything developers rely on in Q Developer today: agentic coding, inline chat, terminal integration, and MCP support.

What’s changing Amazon Q Developer IDE plugins and paid Subscriptions will reach end of support on April 30, 2027, giving customers 12 months to transition to Kiro.

  • New signups will no longer available starting May 15, 2026. New Q Developer Free Tier account creation (via Builder ID in IDE plugins) and new Q Developer subscription creation (via the AWS Console) will be blocked.
  • Model changes: starting May 29, 2026, Opus 4.6 will no longer be available on Q Developer Pro. Opus 4.5 and all other existing models remain available. The latest coding models, including Opus 4.7, are available exclusively on Kiro.
  • Existing customers retain access. If you access Q Developer via a Q Developer Pro subscription or Kiro subscription, you will continue to have access to the Q Developer IDE plugins until April 30, 2027. The May 15, 2026 change affects new signups for Q Developer accounts and subscriptions.
  • IDE plugin listings remain live. Q Developer plugins will remain published on all four IDE marketplaces with a deprecation notice directing users to Kiro. Critical bugfixes will continue to be pushed to existing users through the transition window.

What’s not changing Amazon Q Developer in the AWS Management Console and first-party AWS experiences (AWS Marketing Website, AWS Documentation Website, AWS Console Mobile App, and Amazon Q Developer for Chat Apps – Slack & Microsoft Teams) are not impacted by this sunset and will continue to be available to AWS customers. Customers using Q Developer in these products will retain access to their current subscription benefits and capabilities.

What you should do

  • Explore Kiro today. Download Kiro at kiro.dev and try spec-driven development on your next project.
  • Review the migration guide for your specific IDE.
  • If you have questions about migrating, contact your AWS account team.

We’re excited about the future of AI-powered development and we’re committed to making this transition as smooth as possible for every customer.

Промените, които носи AI

Post Syndicated from Григор original http://www.gatchev.info/blog/?p=2695

Писал съм и преди за тях. Отначало колебливо – чувствах се неадекватен фантазьор. Но напоследък все повече хора пишат същото или части от него. Ето поредната статия по темата:

https://shumer.dev/something-big-is-happening

И реших, че е добре да напиша нещо полезно за който има акъл. Който не чете дълги неща – за него си е, мога да му кусна в устата, но не и да глътна вместо него. И да не ми циври после, че не е знаел навреме.

—-

1. Технологичните революции

AI не е първата технологична революция на човечеството. Преди него бяха компютрите. Преди тях – атомът. Електричеството. Парата. Индустрията… Та чак до стиснатия в питекантропския юмрук камък.

Не, всъщност преди това – слизането от дърветата. Не, всъщност още преди това – качването на тях… До първата жива клетка. Всяка еволюционна промяна е по същество технологична революция, и обратното. Много различно ли е за един хомо хабилис умението да издяла каменен нож от еволюцията да му поникнат страшни зъби?

А технологичните революции не са милостиви. При индустриалната по света са измрели от глад и мизерия милиони селяни, ненаучили се да са работници. Десетки милиони са потънали в мизерия, когато електричеството е изместило парата. Световна атомна война ни се размина, но знаем какво би причинила атомна бомба дори на могъща и добре подготвена армия от 1940-те, за милионен град да не говорим. Компютрите оставиха без работа стотици милиони „сини якички“… Винаги по една и съща причина – неподготвените за новото остават излишни.

В по-нови времена – все повече по свой избор. Крепостните селяни не се учеха да четат, понеже книгата хляб не раждала. „Сините якички“ не учеха компютри, за да не си развалят очите. И едните, и другите разбраха грешката си по трудния начин и платиха за нея с късен и лош старт. С тези, които днес не учат AI, ще е същото.

Много от тях са убедени, че работа за фермери, зидари и готвачи ще има винаги. Същото мислеха орачите преди тракторите, преписвачите на книги – преди печатарската преса, каруцарите – преди колите… А колко професии го мислеха преди компютрите – да изброявам ли?

Новото не само унищожава работни места. Обикновено и създава нови, често напълно неочаквани, и често още повече от унищожените. Но каймака го обират първите пренаучили се. За другите остава утайката, ако изобщо я има. Изберете си от кои искате да бъдете.

2. Този път е различно!

Точно така са мислели и орачите преди тракторите, преписвачите преди печатарската преса и т.н. Всеки път е било същото, просто те не са искали да го разберат, защото не са били на кеф. И са си плащали после.

Само че този път наистина е различно. Проблемът е, че не по добрия начин.

Един трактор заменя десетки орачи, но не оре без тракторист. Първите орачи, които се научат да го карат, живеят по-охолно отпреди. Печатарските преси също не могат без работници. Камионите без шофьори. Компютрите – без работещи на тях… Често много по-малко от заменените, особено отначало, но все пак хора.

Тук е разликата. AI все повече нямат нужда от оператор – вършат все по-добре работата му и сами. Вече сме не просто на ръба AI да може да изпълни задача или да отговори на въпрос по-добре от всеки човек. На ръба сме той да може да формулира задачата или да зададе въпроса по-добре от всеки човек.

Ама и AI имат нужда някой да пише софтуера им? Също вече не. Последните версии на почти всички големи AI са написани предимно от предишните им версии. Скокът във възможностите им се дължи предимно на това. И тези много по-добри последни версии в момента пишат следващите, още по-добри от тях, с още по-голяма разлика. Последният модел на Anthropic – Mythos – вече е далеч по-добър и от най-добрите програмисти в софтуерните задачи. Толкова по-добър, че засега е непубличен, за да не откриват чрез него хакери екплойти в дори смятани сега за непробиваеми софтуери… Познайте дали не е също толкова по-добър от сегашните модели и в други отношения. Подобренията, влезли в него, няма как да са само в един вид умения, LLM-ите не работят така – ще са във всички.

В софтуера нещата са най-напред. Не толкова защото ударението по създаване на AI беше там – по-скоро защото програмните езици са силно формализирани, простички и детерминистични, с тях AI се справя по-добре с едни и същи ресурси. Но и във всичко друго нещата не са много по-назад – да кажем, едно-две поколения модели. Сега актуалният публичен модел на Anthropic – Opus – е в софтуера на нивото на приличен, макар и не блестящ програмист, а примерно в разбирането на човешките чувства – където предишният им модел, Sonnet, е в програмирането. Mythos надмина дори отличните програмисти в софтуера, по-добри от него са само гениите – логично е в разбирането на човешките чувства да е на нивото на Opus в програмирането. Все още не блестящ, но вече добър, на нивото на Opus в софтуера.

Конкуренцията между големите AI фирми е безмилостна – която изостане и с месец, почва да трупа изоставане и потегля към фалита. Така че Mythos с гаранция вече пише на максимални обороти следващия модел. Който ще има програмистки умения, много по-добри от това на написалия го, надминаващи тези и на гениите програмисти. (Терминът за такова ниво е “transhuman”.) Познайте и в колко други неща ще надмине повечето хора този следващ модел. По-следващият вероятно ще надмине във всичко или почти всичко всеки човек, освен може би гениите в най-трудните за AI области. Този след него ще надмине хората в абсолютно всичко… А следващият след него? А по-следващият?…

Преди ново поколение AI модел се създаваше от нула до зрялост за към две години, първите версии на ChatGPT отнемаха към толкова. При Sonnet това отне дори мъничко по-малко от година, 11 месеца и половина. Opus измина този път само за около 9 месеца – Sonnet вече що-годе ставаше за програмиране и помагаше, към една трета от Opus е написана от него или с негова помощ. Mythos (по непублична информация) вече е почти зрял, по-малко от 5 месеца след започването му – вероятно ще измине този път за около 6 месеца, и разликата от него до Opus е доста по-сериозна от тази от Opus до Sonnet. Благодарение основно на това, че Opus вече е приличен програмист, твърди се, че към две трети от Mythos са написани от него… Следващият модел, да го наречем условно Legend (Антропик, безплатна идея за вас! 🙂 ), като се има предвид колко добър е Mythos, вероятно ще е написан почти изцяло от него, вероятно ще има още по-голямо предимство пред предшественика си, и вероятно ще е вече зрял след 3-4 месеца. (Дотогава нищо чудно Mythos да е още непубличен.) По-следващият, да го наречем условно Superman, вероятно ще е с още по-голяма разлика от Legend, и ще е готов може би за 3 месеца или дори малко по-малко. А моделът след него вероятно ще е богоподобен на фона дори на Superman, ще стане готов за вероятно не повече от 2-2.5 месеца и вероятно ще е най-подходящо да го наречем God… Quo vadis – накъде отиваме? Може би до не повече от година?

2027 година е. Шеф сте на софтуерна фирма. Legend програмира много по-добре от кой да е реално привлекаем жив програмист. Конкурентите му от OpenAI, Google и прочее – също. Достъп до AI, който върши работата на 100 програмисти – с перфектно качество, винаги в срок, никога не боледува, няма проблеми, не взима отпуски, работи 24/7 – ще към 1000 долара месечно, стандартна корпоративна цена сега. Ще държите ли на работа 100 програмисти, или ще купите един такъв достъп? Глупав въпрос, нали?

Три до шест месеца след това. Актуалният модел на Antropic вече е Superman. Шеф сте на компания за какъв ще да е интелектуален труд. Дизайн, инженерство, архитектура, песни, книги, филми, наука, право, счетоводство, медицина, обучение… добавете пропуснатото. Достъп до AI, който върши работата на 100 служители… глупав въпрос, нали?

Още три до шест месеца по-късно. Актуалният модел на Antropic вече е God. Шеф сте на компания за какъвто и да е физически труд. Строителни услуги, хамаллък, садене на марули, бране на ябълки, продаване в магазин, гледане на болни, планинско спасяване, развличане на деца, метене на улици… добавете пропуснатото. Вече има машини – някои от тях човекоподобни роботи, други специализирани – проектирани, произведени и управлявани от God или конкурентите му. Достъп до машина или набор машини, които вършат работата на 100 бачкатори… глупав въпрос, нали?

Да, досега проектирането, изпитването и производството на толкова нови и много машини е отнемало десетки години. Познайте обаче колко време ще отнеме на God, или на следващия след него модел, или на по-следващия, готов след година – година и половина. Вероятно след броени години ще има достатъчно такива машини, за да изместят всеки човек.

Тази екстраполация е базирана на Sonet, Opus и Mythos. Sonnet и Opus ги познавам добре. Възможно ли е да са ми прехвалили Mythos, както не мога да се уверя лично? Да – но надали с много. Че е достъпен засега само за 12 големи, предимно софтуерни организации, точно заради брилянтността му в софтуера, е потвърден факт. (Намира с лекота купища експлойти и в най-сигурните сегашни софтуер – докопат ли го хакерите, в света ще настане хаос.) Така че темпото на развитие би могло да е малко по-бавно, може би чак двукратно, но не повече. А двукратно по-бавно означава масовите уволнения заради изместване от AI да се случат след 2 години вместо след 1. Ако това ви успокоява, сте герои от виц. Недейте, скоро и с палячовство няма да може да се изкарва доход, смешни наоколо ще има в излишък.

И да, публикуването на нов модел очевидно може да бъде забавено по едни или други причини. Но засега няма механизъм, който ще забави разработката на нови модели, дори ако старите още не са публикувани. Не само заради конкуренцията между AI фирмите. Коя агенция за сигурност на държавата ще позволи развитието на нейните AI да бъде спряно, докато в това време потенциалните ѝ врагове развиват AI като бесни?… И когато поредният модел стане способен да създаде лекарство против рак и да забави или дори спре стареенето, надали ще бъде скрит за дълго, примерно за цяла година – който го скрие, ще е заслужил каквото всички извършители на геноцид в историята заедно не са. Така че забавяния може да има, но надали ще са много големи.

Мислите иначе ли? За такива неща мислят глупавите, умните смятат. Ако можете да смятате, направете си и вие сметките колко бързо пътува този влак и им вярвайте. Ако не, вярвайте на който може да смята. Иначе ще сте урок за по-умните.

Ще станат ли хората непотребни? Надали. Нищо чудно добри решения по въпроса да дойдат именно от AI-та. Но се пригответе да живеете скоро в свят, различен от сегашния.

3. Икономическите последствия

2027-8-9 година е. Шеф сте на фирма. Конкуренцията ви е подменила част от служителите си с AI. Спестила е разходи за заплати, надконкурира ви. Какъв е изборът ви? Оставате шеф на фирма само ако направите същото. Иначе фалирате.

Правите го. Отново сте в бизнеса. Но там винаги има и най-неконкурентен, влак без последен вагон няма как. Какъв е изборът му? Подменя още служители с AI, иначе фалира. Последният вагон е откачен и изоставен или преместен напред – последен става този преди него…

Скоро всички служители във фирми са подменени с AI. Малко по-късно и всички работници. Където преди са работели хиляди, сега има само шепичка шефове. За кратко – кой шеф може да бъде по-кадърен и лоялен от от поколението Superman, да не говорим за God?… Много скоро след това фирмите имат вече само собственици. А конкуренцията между тях не спира – най-неуспешните фалират, други ги изкупуват, агрегацията тече с AI скорост. Докато се огледате, наоколо са останали един файтон свръхбогаташи, всички други са разорени.

Харесва ли ви идеята? „Ако съм свръхбогаташ – да!“ Да, ама не – спали сте в час по икономика. Нека наваксаме проспаното.

Заводите „Форд“ в САЩ са ваши. Произвеждате и продавате по 10 милиона коли годишно. Марджинът ви е 5%, при 400 милиарда годишен оборот печелите 20 милиарда годишно. Но подменяте всичките си работници с AI и марджинът ви става заради спестените заплати 50%. Годишната ви печалба ще е 200 милиарда, десетократно по-голяма. Шампанско, моля! И нови яхти!

Но месец по-късно от почти милион коли месечно продажбите ви са спаднали на към 2000. Годишно ще са 24 000, и годишната ви печалба е станала вместо 200 милиарда годишно към 500 милиона. Вместо да скочи 10 пъти, е паднала 40 пъти. Защото всеки фирмаджия в САЩ е постъпил като вас – подменил е с AI всичките си работници или служители. И те, останали без заплати, вече не могат да си позволят да купуват коли. Правят го само малкото все още работещи, заради връзки или по милост, в държавната и общински администрации.

Докато се опомните от вестта, AI-шефът на заводите ви предупреждава и че обемът на покупките ви на материали, ток и всичко друго е спаднал драстично. Така че вече пазарувате на доста по-дребно и доставните ви цени са скочили с 20%. Поемете ли вие разликата, марджинът ви слиза на 30%, печалбата – на 300 милиона годишно, вече почти сто пъти по-малка отпреди подмяната. Качите ли цените си с 20%, продажбите ще спаднат и още, обемът на покупките ви на материали също, цените им ще скочат още – бизнесът ви влиза в свредел.

Нямате избор. Орязвате печалбата си. Все пак 300 милиона годишно пак са много в такава ужасна криза. (Че тая криза я създаде подмяната на работници с AI, в която участвахте и вие, предпочитате да не си спомняте.) Но много скоро иде нов удар – продажбите на практика спират. Заради 100 пъти намалената ви печалба сте платили 100 пъти по-малко данък и държавната и общински администрации, които живеят от данъците, вече не могат да плащат заплати. Подменили са служителите си с AI и те също вече не могат да купуват коли… Дори да спрете производството напълно, вече не можете да плащате дори на фирмата за роботи-охранители с AI. Налага се да продадете заводите си, докато крадците не са ги опоскали и времето не ги е съсипало.

А на кого? Всички други големи фирми са също във фалит. Даже фирмите зад големите AI – могат да устискат на сериозно намаление на приходите си, но не и на спадане до 1%, а вече няма кой да може да им плати и толкова. Банките са фалирали до една заради трилионите заеми за жилища и прочее, които са станали необслужваеми – останалите без заплати заемополучатели нямат с какво да плащат вноските си. А ликвидността на една банка рядко е над 20% – ако над такъв процент заеми гръмнат, гръмва тя цялата… Чудо ще е, ако за заводите ви, стрували стотици милиарди, сега някой ви даде и милион. Вече не сте мултимилиардер – надали сте и милионер даже.

Да кажем, чудото се е случило, успели сте да намерите такъв. Все пак сте взели един милион. Но какво ще си купите с него? Магазините са затворени – кой има пари, че да купи каквото и да е?! Бившите свръхбогаташи сте единици, а останалите нямат пукнат цент. Същото важи за всички услуги – транспорт, бензиностанции, ток… Фермерите, които още имат земя и машини, вече искат да произвеждат храна само за себе си – но откъде части и гориво дори за това?!… И вече се чудите не на коя от яхтите си да празнувате, а как да се нахраните.

Икономиката е кръговрат. Произвеждате стоки или услуги, продавате, плащате на работниците, те с тези пари си купуват стоки и услуги. Не е перпетуум мобиле, защото етапът на производството в този кръг създава повече стойност, отколкото консумира. Така че върти ли се кръгът, производството непрекъснато създава принадена стойност, плюс над разходите, и тя се разпределя навсякъде в кръга. Има и за покриване на неизбежните загуби, и за данъци, и за вашата и на работниците издръжка, и за тях да спестяват, и за вас да богатеете – тоест, за да расте икономиката като цяло… Но спре ли да се върти кръгът, примерно защото работниците вече нямат пари да купуват, спира и производството, а оттам и създаването на принадена стойност. Приходите стават нулеви. Вчерашните мултимилиардери почват да умират от глад. А някои от неизбежните разходи продължават и унищожават и останалото от спрялата икономика.

(Този механизъм, в много по-лек вариант, е причината за Великата депресия от 1929 г. Вярването в trickle-down теорията и дерегулацията, неглижирането на антитръстовските закони и на опасността от растящото икономическо неравенство създават условия много от парите в обществото да бъдат изтеглени „горе“, при най-богатите. Те обаче са нищожен процент, техните потребителски нужди са нищожни на фона на тези на хиляди пъти по-многобройните средна класа и по-бедни. Създава се ситуация, в която който има нужда от стоки и услуги няма достатъчно пари да купува, а който има достатъчно пари, няма достатъчно нужда от покупки. Потреблението спада с около 30%, производството – БВП на САЩ – също. Резултатът е незапомнена безработица и мизерия. От 30% спад в потреблението. А спадът в потреблението заради AI революцията вероятно ще е много по-голям, теоретично може да доближи 100%…)

4. Справяне с икономическите последствия

Ще бъдат ли взети мерки да се избегне катастрофата? Вероятно да – както виждаме, дори свръхбогаташите имат нужда от тях, и то повече от клошарите или даже работниците. Не е сигурно обаче дали ще са взети достатъчно и с достатъчно ефект.

Ефективните срещу такъв проблем мерки са видове преразпределяне на парите откъдето са се концентрирали силно към където има капацитет за масово потребление. Ляво правителство е по-вероятно да предприеме достатъчни, за да не рухне икономиката. (Въпреки че и тези правителства обикновено имат задкулисни връзки с големите пари, които ще ги спират.) Дясно може да прояви разум и да се жертва, но може и да не вземе достатъчно и/или ефективни. А реакционери и/или политически измамници с мераци за корони и тронове вероятно дори ще се възползват от ситуацията, за да се сдобият с абсолютна власт. (Великата депресия е основна причина за мизерията в Германия през 1930-те, която докарва Хитлер на власт.) Ако сред тях има и собственици на големи AI, изкушението те да бъдат използвани за установяване на технототалитарен абсолютен контрол е много силно, и рискът за това общество е огромен.

Какви общества имат най-голям шанс да се справят добре с такава икономическа ситуация? Няма как да се предскаже с гаранция. Но при равни други условия най-добри шансове имат социални общества със силна либерална демокрация, кадърна регулация на AI бизнеса, ниска корупция, високо грамотен народ и към този момент с кадърно и не-популистко лявоцентристко правителство.

Ще има ли не само на теория, а и в реалността необходимото осъзнаване сред ключовите играчи на необходимостта да бъде запазена покупателната способност на масовите потребители? Някои дори вече го заявяват открито – примерно съм срещал подобни твърдения на Илон Мъск. Много други засега не са го казвали, но е малко вероятно да не го разбират. Някои обаче вероятно не го разбират и ще противодействат на адекватните мерки, особено твърде обвързаните с десни идеологии. (Идеологията на мозъка е тежък вид лудост. Не я подценявайте.)

Какви механизми могат да реализират нужното? Най-често обсъжданата и най-проста идея е безусловен базов доход за всички. Тя обаче има сериозен недостатък – би създала уравновиловка в обществото, а изравненото икономически общество не е добро за развитието. За него е нужен спектър на богатството – не прекалено широк и маргинализиран, но не и прекалено тесен. (Едно по-сериозно отърсване на икономиката от идеологиите и създаване в нея на нетърпимост към тях вероятно би позволило на кадърни учени и/или мощни AI да изведат формулите за определяне на оптималното за всяка икономическа ситуация разпределение на богатството в обществото. Но ще е трудно да се постигне, през последните няколко години икономиката се идеологизира до екстремна степен.) Така че вероятно ще е нужно да се помисли за подходящи механизми, способни да разпределят богатството в обществото по определен спектър, и да променят този спектър при икономическа необходимост.

Какви биха били ключовите проблеми пред това реализиране? Икономиката е ентропийна отворена система, подчиняваща се на статистическата механика. В такава система негентропията проявява тенденция към концентриране към „входящата зона“. Казано икономически, парите проявяват тенденция към концентриране в зоната, където принадената стойност навлиза в системата. По начало това е зоната, в която тя се създава – производството. Законодателни или икономически мерки могат да я изместят другаде, примерно в зоната на управление на потока на парите (банковата система). Силна мафия може да я измести в зоната на върхушката си, чрез грабителство. (Или ако контролира държавата – дори чрез подходящо законодателство.) Но където и да е тази зона, парите ще се опитват да се концентрират там. А концентрирането им ще се стреми да намали зоната до малка част от икономическата система.

На теория мерки, които поддържат зоната на навлизане на принадената стойност разпределена на много широка площ (включваща всичкия или почти всичкия капацитет за консумиране в икономиката), биха били оптимални в такава ситуация. Такива мерки обаче засега не са известни. Вероятно достатъчно мощен AI би могъл да предложи подходящи. Поддържането на тази зона много широка обаче е противостоене на естествената ѝ тенденция за свиване – възможно е да се окаже, че няма как да се направи достатъчно стабилно, за да издържа силни сътресения. А технологичните революции са именно такива, и при такава скорост на развитието ще са много чести.

На практика по-лесно се оказва парите в икономиката да бъдат преразпределяни от зоната, където се концентрират, към зоните с максимален потребителски капацитет. (Примерно богатите биват облагани с високи данъци, от които печелят всички – така икономическото неравенство продължава да съществува, но намалява като размер.) Известни са ни приличен брой такива механизми. Много от тях обаче имат сериозни недостатъци, например данъчното облагане често може да бъде изкривявано чрез заобикаляне на закона или вратички в него. Други начини, например разчитащите на фиксирана номенклатура, е възможно да стагнират развитието на икономиката, а може би и на технологиите и прогреса…

Като цяло, идеални мерки вероятно няма, дори за конкретно тази специфична ситуация. Но е напълно реално да има мерки, които при достатъчно широко и сериозно прилагане са достатъчно добри, за да намалят размера на икономическите проблеми до приемлив. Въпросът е дали ще бъдат приложени, и ако да – дали ще е достатъчно широко и сериозно.

5. Социалните последствия

Слагал ли е ваш колега гордо пред шефа 20 страници красив доклад, пълен с графики и прочее, как върви строежът, за който отговаря във фирмата той? Написан за една нощ с помощта на AI? Докато вие подсмърчате и се червите, понеже не умеете да се справяте с AI и докладът ви за вашия строеж е пет изречения? И разбирате отлично как изглежда в очите и на шефа, и на всички околни той, а как – вие? Не е малка разлика, нали?

(Да, докладът му вероятно хич не е идеален, съвременните AI не са още истински добри в това. Но шефът надали ще го разбере – вероятно ще накара някое AI да му го синтезира в пет изречения. Колкото е и вашият – но впечатлението от разликата ще остане… А и да забележак проблемите в доклада му, впечатлението е важното в тази история само за плиткоумните. Истински важното е, че той се е потил много часове, но се е научил как се правят хубави доклади с AI, а вие не сте. И занапред той ще посвещава още много часове за учене и трупане на нови знания и умения, често на цената на лишения и недоспиване. Докато вие най-много да научите как да правите с AI смешни картинки и какви са връзките между чакрите и предсказанията на баба Ванга. Защото толкова зор ще си дадете.)

Разликата изглежда голяма, но е микроскопична. След година-две този колега ще сложи пред шефа 20 000 страници (вероятно в електронен вид) проект за бъдещия ви строеж, подробен до последното кабарче по мебелите, перфектен във всяко отношение. Също направен за една нощ с AI, от актуалното след година поколение, преди вие да сте прочели докрай 20-те страници спецификация. След още година той за седмица не само ще направи проекта, но и ще построи сградата сам, с управлявани от AI ресурси, наети за една трета от стойността на работници. А след още година ще реализира сам със същата скорост и икономичност цели подводни или орбитални градове, Фулърови куполи или аркологии, мостове през морета или тунели под тях… Докато вие тепърва ще учите как се правят с някое чатджипити презентации и други подобни, от които вече никой не се интересува. Колко голяма на този фон е разликата с 20-страничния доклад?

Не бързайте да се депресирате, ей сега ще имате по-добър повод. Срещате тогава колегата и в разговора с него откривате, че той знае как точно се настройват резонансните струни на виола д’аморе. Може да нарисува по-добре от Леонардо изглед към Матерхорн от ледника Теодул. Да каже как точно ще се сгънат белтъчните молекули в хемоцианиновия комплекс в кръвта на краб-пътешественик, ако му инжектирате еди-кой си хемотоксин. Да докаже конектурата на Поанкаре по-елегантно от Перелман, за само няколко минути. Да разгроми на шах най-добрите сто шахматисти хора на света, в сеанс на едновременна игра срещу всичките. Да напише поезия, по-добра от тази на Верлен, на ведически санскрит или инупиак. И че е по-добър психолог и от гениите – може да разбере по едно ваше движение всичко, което ви безпокои, да ви предскаже перфектно, да ви манипулира за ваше добро или зло, по негов избор… Защото си е присадил имплант за връзка с AI, или се е научил да може всичко това по някакъв друг, дошъл от AI начин. А вие не сте.

Депресирахте ли се вече? Пак бързате. Той не само изглежда подмладен, отслабнал и с по-правилно лице. Наистина е – вече може да управлява просто с мисъл не само външността, а и възрастта си, старее само ако му се иска, подмладява се обратно когато му кефне, реално е безсмъртен. Вече никакви болести не го плашат не защото има лечения за тях, а защото организмът му вече не е податлив на тях. Може да вдигне тонове с една ръка и да улови с два пръста летяща муха със затворени очи, само по слух. Може да се гмурне до дъното на океана без да диша няколко часа и без да му пречат налягането, студът и тъмнината там. Ако изпразнят в него няколко картечни ленти, не само няма да умре на място, а след седмица-две дори без лечение ще е пак идеално здрав. И това е само началото на възможностите му. А всички те заедно са само началото на това, което ще може утре… Докато вие въздишате заради бръчките и белите си косми.

Ще стане ли всичко това за само две години? Може би не, дори въпреки скоростта на развитие на AI. Но и двайсет да отнеме, ще стане. И познайте колко ще ви утеши тогава, че е отнело по-дълго. Колегата ще пътува във влака към бъдещето, към нови и все по-невероятни чудеса. А вие ще сте останали на спирка, която за него ще е дори не Средновековие, а Питекантропие – и много скоро може да стане и Динозаврие…

Обществото ще се раздели на две групи. Група, която смогва да е актуална с развитието на технологиите, може би на цената на огромен труд и много жертви, но хората в нея сами определят съдбата си и са боговете на този свят на бъдещето. И група, която не смогва или се е отказала да е актуална, която просто се вози докъдето я закарат, и съдбата на хората в нея я определя първата група – реално те са неин добитък. Да, първата група може и да са добри към втората. Но дали ще го правят според интересите на тези във втората група, или според своите, е въпрос който е добре да си зададете.

В коя от двете групи ще сте, зависи от вас. Правите този избор в момента, с колко усилия ще посветите на учене на AI. Предупредени сте – не се оплаквайте, когато се окажете не в която група искате. Направите ли от мързел и/или глупост грешния избор, се сърдете на себе си. И ако собствените ви деца ви заплюят утре в очите, знайте, че сте го заслужили.

6. Добре, а какво да правим?

Въпросът за много повече от един милион долара.

Вече има сума ти статии по въпроса, и повечето казват едно и също. Можете да им вярвате, ако не идват от пропагандна радиоточка. Бих добавил и от мен:

– Стегнете си финансите. Веднага, не догодина. Нищо, че вече е трудно – то е, защото нещата вече се движат по нанадолнището, не ги чакайте и да наберат скорост, тогава хич няма да можете. Колко сериозни сътресения ни чакат не е ясно. Може почти да ги няма. Може да са зловещи. Когато има приличен шанс да завали пороен дъжд, е разумно да си вземеш чадър. Пък нека дъждът се размине.
– Въпросът „Какво да науча, че да ме храни следващите 10 години“ вече е индикатор за идиот. Учете каквото ще ви храни веднага, или почти веднага – ще остарее още преди да го научите. Свикнете непрекъснато да учите и непрекъснато да сменяте каквото учите, често драстично, изоставяйки плода на огромни усилия. Могъщите динозаври са измрели, защото не са се адаптирали достатъчно. Мишеподобните бозайници са оцелели, защото са.
– Днес AI не е съвършен – халюцинира, дава грешни съвети. Утре ще е много по-умен, и от днес, и от вас. Не го съдете по спомените си от днес или особено пък от вчера. Да мислите зрял юначага за бебето, което е бил, е неразумно подценяване.
– До 10-15 години, ако не се случи някакво ужасяващо бедствие, ще са възможни неща които днес изглеждат фантазия. Но ще са за който може да си ги позволи, а отначало това няма да е всеки. По-добре да можете, с пари или знания. И двете се постигат днес със здраво учене на AI.
– Учете не само как да работите с AI, а и как работи самият той. Да можете да се возите в кола не е ценност за никой, който би ви плащал. Ценност е да можете да карате кола по-добре от 99% от хората или да можете да ремонтирате или сглобите кола.
– Учете не по два часа седмично – по четири часа дневно, поне 6 дни седмично. Не от след месец – от днес, след месец вече хубавите вагони в този влака ще са заминали, а може би и лошите.
– Непрекъснато се напъвайте да научите и още, да пробвате и каквото не сте. Денят, в който си кажете „Научих достатъчно за днес“, е денят в който сте слезли от влака. Ако си казвате за нещо „Много зор ще е, но мога да го науча“, значи е важно за учене, но не е най-важното. Най-важното за учене е това, за което си казвате: „Това посмъртно не мога да го науча“ – подхващайте го веднага и без колебание.
– Каквото сте научили днес, утре вече няма да е същото, познанията ви ще са остарели до безполезност. Нормално е, възприемайте го като нещо естествено. Пренаучавайте се моментално, оставяйте днешното учене за утре само ако искате то вече да няма смисъл.
– Колкото по-напред отиват нещата, толкова повече и по-здраво учене ще ви трябва, за да не слезете от влака. Където слезете там ще останете, друг влак напред няма да има. А влакът е все по-бърз, малко допълнителен престой в него ви откарва доста по-напред, по-нататък – повече. Струва си да се напънете докрай.
– Колкото по-дълго се задържите на влака, толкова повече възможности ще имате. Ако нещата вървят с този темп, до максимум 10 години хората ще се разделят на „магьосници“ и „добитък“. В първата ще са задържалите се във влака достатъчно дълго. Във втората – останалите над 99%. Сетете се каква ще е разликата между двете, примерно в какво ще могат тези в едната и тези в другата група, и защо е добре да сте в първата.
– Вероятно с времето ще почне да има и AI с „открити познания“ (а и код на софтуера, който ги движи). Предпочитайте ги пред „закритите“ – точно както разумният човек предпочита софтуера с отворен код пред този със затворен, и откритите хора пред потайните. (Ако някой мисли иначе, не спорете с него. Умствените ресурси са ви нужни за учене на AI, не ги пилейте. Идиотите са за игнориране, не за спорене с тях.)
– Ако от някой момент нататък стане невъзможно да сте във влака без неща като мозъчни импланти и подобни, бъдете внимателни. Не ги ли вземете, изпадате. Вземете ли ги безразсъдно, ще ви се иска да бяхте изпаднали. Преценете как да го направите без риск за автокефалността си. Главата ви е за да носите шапка само ако сте плашило – на хората им е за мислене. И е полезно да я товарите здраво, и за нея, и за вас. Вид тренировка е.
– Същото важи изобщо за използването на AI. Дори да сте реалист и факт-чекър, мощта на днешен добър AI вече може да ви обамбузи здраво, ако му вярвате безпрекословно. Примерно ако сте се чули някога да кажете „Ама аз питах чатджипити!“. (И дори ако зад това не стои нечие намерение, а просто усилените през неговото богатство ваши си деформации.) Утрешните AI ще са несравнимо по-мощни – не ставайте нечии зомбита, не е живот.
Fast16 Malware

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/04/fast16-malware.html

Researchers have reverse-engineered a piece of malware named Fast16. It’s almost certainly state-sponsored, probably US in origin, and was deployed against Iran years before Stuxnet:

“…the Fast16 malware was designed to carry out the most subtle form of sabotage ever seen in an in-the-wild malware tool: By automatically spreading across networks and then silently manipulating computation processes in certain software applications that perform high-precision mathematical calculations and simulate physical phenomena, Fast16 can alter the results of those programs to cause failures that range from faulty research results to catastrophic damage to real-world equipment.”

Another news article.

Lots of interesting details at the links.

Claude Mythos Has Found 271 Zero-Days in Firefox

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2026/04/claude-mythos-has-found-271-zero-days-in-firefox.html

That’s a lot. No, it’s an extraordinary number:

Since February, the Firefox team has been working around the clock using frontier AI models to find and fix latent security vulnerabilities in the browser. We wrote previously about our collaboration with Anthropic to scan Firefox with Opus 4.6, which led to fixes for 22 security-sensitive bugs in Firefox 148.

As part of our continued collaboration with Anthropic, we had the opportunity to apply an early version of Claude Mythos Preview to Firefox. This week’s release of Firefox 150 includes fixes for 271 vulnerabilities identified during this initial evaluation.

As these capabilities reach the hands of more defenders, many other teams are now experiencing the same vertigo we did when the findings first came into focus. For a hardened target, just one such bug would have been red-alert in 2025, and so many at once makes you stop to wonder whether it’s even possible to keep up.

Our experience is a hopeful one for teams who shake off the vertigo and get to work. You may need to reprioritize everything else to bring relentless and single-minded focus to the task, but there is light at the end of the tunnel. We are extremely proud of how our team rose to meet this challenge, and others will too. Our work isn’t finished, but we’ve turned the corner and can glimpse a future much better than just keeping up. Defenders finally have a chance to win, decisively.

They’re right. Assuming the defenders can patch, and push those patches out to users quickly, this technology favors the defenders.

News article.