Querying a Decade of Drive Stats Data

Post Syndicated from Pat Patterson original https://www.backblaze.com/blog/querying-a-decade-of-drive-stats-data/
Last week, we published Backblaze Drive Stats for Q3 2022, sharing the metrics we’ve gathered on our fleet of over 230,000 hard drives. In this blog post, I’ll explain how we’re now using the Trino open source SQL query engine in ensuring the integrity of Drive Stats data, and how we plan to use Trino in future to generate the Drive Stats result set for publication.

Converting Zipped CSV Files into Parquet

In his blog post Storing and Querying Analytical Data in Backblaze B2, my colleague Greg Hamer explained how we started using Trino to analyze Drive Stats data earlier this year. We quickly discovered that formatting the data set as Apache Parquet minimized the amount of data that Trino needed to download from Backblaze B2 Cloud Storage to process queries, resulting in a dramatic improvement in query performance over the original CSV-formatted data.

As Greg mentioned in the earlier post, Drive Stats data is published quarterly to Backblaze B2 as a single .zip file containing a CSV file for each day of the quarter. Each CSV file contains a record for each drive that was operational on that day (see this list of the fields in each record).

When Greg and I started working with the Parquet-formatted Drive Stats data, we took a simple, but somewhat inefficient, approach to converting the data from zipped CSV to Parquet:

  • Download the existing zip files to local storage.
  • Unzip them.
  • Run a Python script to read the CSV files and write Parquet-formatted data back to local storage.
  • Upload the Parquet files to Backblaze B2.

We were keen to automate this process, so we reworked the script to use the Python ZipFile module to read the zipped CSV data directly from its Backblaze B2 Bucket and write Parquet back to another bucket. We’ve shared the script in this GitHub gist.

After running the script, the drivestats table now contains data up until the end of Q3 2022:

trino:ds> SELECT DISTINCT year, month, day 
FROM drivestats ORDER BY year DESC, month DESC, day DESC LIMIT 1;
year | month | day 
------+-------+-----
 2022 |     9 |  30 
(1 row)

In the last article, we were working with data running until the end of Q1 2022. On March 31, 2022, the Drive Stats dataset comprised 296 million records, and there were 211,732 drives in operation. Let’s see what the current situation is:

trino:ds> SELECT COUNT(*) FROM drivestats;
   _col0 
-----------
 346006813 
(1 row) 

trino:ds> SELECT COUNT(*) FROM drivestats 
    WHERE year = 2022 AND month = 9 AND day = 30;
   _col0 
--------
 230897 
(1 row)

So, since the end of March, we’ve added 50 million rows to the dataset, and Backblaze is now spinning nearly 231,000 drives—over 19,000 more than at the end of March 2022. Put another way, we’ve added more than 100 drives per day to the Backblaze Cloud Storage Platform in the past six months. Finally, how many exabytes of raw data storage does Backblaze now manage?

trino:ds> SELECT ROUND(SUM(CAST(capacity_bytes AS bigint))/1e+18, 2)
FROM drivestats WHERE year = 2022 AND month = 9 AND day = 30;
 _col0 
-------
  2.62 
(1 row)

Will we cross the three exabyte mark this year? Stay tuned to find out.

Ensuring the Integrity of Drive Stats Data

As Andy Klein, the Drive Stats supremo, collates each quarter’s data, he looks for instances of healthy drives being removed and then returned to service. This can happen for a variety of operational reasons, but it shows up in the data as the drive having failed, then later revived. This subset of data shows the phenomenon:

trino:ds> SELECT year, month, day, failure FROM drivestats WHERE 
serial_number = 'ZHZ4VLNV' AND year >= 2021 ORDER BY year, month, 
day;
 year | month | day | failure 
------+-------+-----+---------
...
 2021 |    12 |  26 |       0 
 2021 |    12 |  27 |       0 
 2021 |    12 |  28 |       0 
 2021 |    12 |  29 |       1 
 2022 |     1 |   3 |       0 
 2022 |     1 |   4 |       0 
 2022 |     1 |   5 |       0 
...

This drive appears to have failed on Dec 29, 2021, but was returned to service on Jan 3, 2022.

Since these spurious “failures” would skew the reliability statistics, Andy searches for and removes them from each quarter’s data. However, even Andy can’t see into the future, so, when a drive is taken offline at the end of one quarter and then returned to service in the next quarter, as in the above case, there is a bit of a manual process to find anomalies and clean up past data.

With the entire dataset in a single location, we can now write a SQL query to find drives that were removed, then returned to service, no matter when it occurred. Let’s build that query up in stages.

We start by finding the serial numbers and failure dates for each drive failure:

trino:ds> SELECT serial_number, DATE(FORMAT('%04d-%02d-%02d', year, 
month, day)) AS date 
FROM drivestats 
WHERE failure = 1;
  serial_number  |    date    
-----------------+------------
 ZHZ3KMX4        | 2021-04-01 
 ZA12RBBM        | 2021-04-01 
 S300Z52X        | 2017-03-01 
 Z3051FWK        | 2017-03-01 
 Z304JQAE        | 2017-03-02 
...
(17092 rows)

Now we find the most recent record for each drive:

trino:ds> SELECT serial_number, MAX(DATE(FORMAT('%04d-%02d-%02d', 
year, month, day))) AS date
    FROM drivestats 
    GROUP BY serial_number;
  serial_number   |    date    
------------------+------------
 ZHZ65F2W         | 2022-09-30 
 ZLW0GQ82         | 2022-09-30 
 ZLW0GQ86         | 2022-09-30 
 Z8A0A057F97G     | 2022-09-30 
 ZHZ62XAR         | 2022-09-30 
...
(329908 rows)

We then join the two result sets to find spurious failures; that is, failures where the drive was later returned to service. Note the join condition—we select records whose serial numbers match and where the most recent record is later than the failure:

trino:ds> SELECT f.serial_number, f.failure_date
FROM (
    SELECT serial_number, DATE(FORMAT('%04d-%02d-%02d', year, month, 
day)) AS failure_date
    FROM drivestats 
    WHERE failure = 1
) AS f
INNER JOIN (
    SELECT serial_number, MAX(DATE(FORMAT('%04d-%02d-%02d', year, 
month, day))) AS last_date
    FROM drivestats 
    GROUP BY serial_number
) AS l
ON f.serial_number = l.serial_number AND l.last_date > f.failure_date;
  serial_number  | failure_date 
-----------------+--------------
 2003261ED34D    | 2022-06-09 
 W300STQ5        | 2022-06-11 
 ZHZ61JMQ        | 2022-06-17 
 ZHZ4VL2P        | 2022-06-21 
 WD-WX31A2464044 | 2015-06-23 
(864 rows)

As you can see, the current schema makes date comparisons a little awkward, pointing the way to optimizing the schema by adding a DATE-typed column to the existing year, month, and day. This kind of denormalization is common in analytical data.

Calculating the Quarterly Failure Rates

In calculating failure rates per drive model for each quarter, Andy loads the quarter’s data into MySQL and defines a set of views. We additionally define the current_quarter view to restrict the failure rate calculation to data in July, August, and September 2022:

CREATE VIEW current_quarter AS 
    SELECT * FROM drivestats
    WHERE year = 2022 AND month in (7, 8, 9);

CREATE VIEW drive_days AS 
    SELECT model, COUNT(*) AS drive_days 
    FROM current_quarter
    GROUP BY model;

CREATE VIEW failures AS
    SELECT model, COUNT(*) AS failures
    FROM current_quarter
    WHERE failure = 1
    GROUP BY model
UNION
    SELECT DISTINCT(model), 0 AS failures
    FROM current_quarter
    WHERE model NOT IN
    (
        SELECT model
        FROM current_quarter
        WHERE failure = 1
        GROUP BY model
    );

CREATE VIEW failure_rates AS
    SELECT drive_days.model AS model,
           drive_days.drive_days AS drive_days,
           failures.failures AS failures, 
           100.0 * (1.0 * failures) / (drive_days / 365.0) AS 
annual_failure_rate
    FROM drive_days, failures
    WHERE drive_days.model = failures.model;

Running the above statements in Trino, then querying the failure_rates view, yields a superset of the data that we published in the Q3 2022 Drive Stats report. The difference is that this result set includes drives that Andy excludes from the Drive Stats report: SSD boot drives, drives that were used for testing purposes, and drive models which did not have at least 60 drives in service:

trino:ds> SELECT * FROM failure_rates ORDER BY model;
        model         | drive_days | failures | annual_failure_rate 
----------------------+------------+----------+---------------------
 CT250MX500SSD1       |      32171 |        2 |                2.27 
 DELLBOSS VD          |      33706 |        0 |                0.00 
 HGST HDS5C4040ALE630 |       2389 |        0 |                0.00 
 HGST HDS724040ALE640 |         92 |        0 |                0.00 
 HGST HMS5C4040ALE640 |     341509 |        3 |                0.32 
 ...
 WDC WD60EFRX         |        276 |        0 |                0.00 
 WDC WDS250G2B0A      |       3867 |        0 |                0.00 
 WDC WUH721414ALE6L4  |     765990 |        5 |                0.24 
 WDC WUH721816ALE6L0  |     242954 |        0 |                0.00 
 WDC WUH721816ALE6L4  |     308630 |        6 |                0.71 
(74 rows)

Query 20221102_010612_00022_qscbi, FINISHED, 1 node
Splits: 139 total, 139 done (100.00%)
8.63 [82.4M rows, 5.29MB] [9.54M rows/s, 628KB/s]

Optimizing the Drive Stats Production Process

Now that we have shown that we can derive the required statistics by querying the Parquet-formatted data with Trino, we can streamline the Drive Stats process. Starting with the Q4 2022 report, rather than wrangling each quarter’s data with a mixture of tools on his laptop, Andy will use Trino to both clean up the raw data and produce the Drive Stats result set for publication.

Accessing the Drive Stats Parquet Dataset

When Greg and I started experimenting with Trino, our starting point was Brian Olsen’s Trino Getting Started GitHub repository, in particular, the Hive connector over MinIO file storage tutorial. Since MinIO and Backblaze B2 both have S3-compatible APIs, it was easy to adapt the tutorial’s configuration to target the Drive Stats data in Backblaze B2, and Brian was kind enough to accept my contribution of a new tutorial showing how to use the Hive connector over Backblaze B2 Cloud Storage. This tutorial will get you started using Trino with data stored in Backblaze B2 Buckets, and includes a section on accessing the Drive Stats dataset.

You might be interested to know that Backblaze is sponsoring this year’s Trino Summit, taking place virtually and in person in San Francisco, on November 10. Registration is free; if you do attend, come say hi to Greg and me at the Backblaze booth and see Trino in action, querying data stored in Backblaze B2.

The post Querying a Decade of Drive Stats Data appeared first on Backblaze Blog | Cloud Storage & Cloud Backup.

[$] Better CPU selection for timer expiration

Post Syndicated from original https://lwn.net/Articles/913568/

On the surface, the kernel’s internal timer mechanism would not appear to
have changed much in a long time; the core API looks quite similar to the
one present in the 1.0 release. Underneath the API, naturally, quite a bit
of complexity has been added over the years. The implementation of this
API looks to become even more complex — but faster — if and when this
patch set
from Anna-Maria Behnsen finds its way into the mainline.

Deploying IBM Cloud Pak for integration on Red Hat OpenShift Service on AWS

Post Syndicated from Eduardo Monich Fronza original https://aws.amazon.com/blogs/architecture/deploying-ibm-cloud-pak-for-integration-on-red-hat-openshift-service-on-aws/

Customers across many industries use IBM integration software, such as IBM MQ, DataPower, API Connect, and App Connect, as the backbone that integrates and orchestrates their business-critical workloads.

These customers often tell Amazon Web Services (AWS), they want to migrate their applications to AWS Cloud, as part of their business strategy: to lower costs, gain agility, and innovate faster.

In this blog, we will explore how customers, who are looking at ways to run IBM software on AWS, can use Red Hat OpenShift Service on AWS (ROSA) to deploy IBM Cloud Pak for Integration (CP4I) with modernized versions of IBM integration products.

As ROSA is a fully managed OpenShift service that is jointly supported by AWS and Red Hat, plus managed by Red Hat site reliability engineers, customers benefit from not having to manage the lifecycle of Red Hat OpenShift Container Platform (OCP) clusters.

This post explains the steps to:

  • Create a ROSA cluster
  • Configure persistent storage
  • Install CP4I and the IBM MQ 9.3 operator

Cloud Pak for integration architecture

In this blog, we are implementing a highly available ROSA cluster with three Availability Zones (AZ), three master nodes, three infrastructure nodes, and three worker nodes.

Review the AWS documentation for Regions and AZs and the regions where ROSA is available to choose the best region for your deployment.

Figure 1 demonstrates the solution’s architecture.

IBM Cloud Pak for Integration on ROSA architecture

Figure 1. IBM Cloud Pak for Integration on ROSA architecture

In our scenario, we are building a public ROSA cluster, with an internet-facing Classic Load Balancer providing access to Ports 80 and 443. Consider using a ROSA private cluster when you are deploying CP4I in your AWS account.

We are using Amazon Elastic File System (Amazon EFS) and Amazon Elastic Block Store (Amazon EBS) for our cluster’s persistent storage. Review the IBM CP4I documentation for information about supported AWS storage options.

Review AWS prerequisites for ROSA and AWS Security best practices in IAM documentation, before deploying CP4I for production workloads, to protect your AWS account and resources.

Cost

You are responsible for the cost of the AWS services used when deploying CP4I in your AWS account. For cost estimates, see the pricing pages for each AWS service you use.

Prerequisites

Before getting started, review the following prerequisites:

Installation steps

To deploy CP4I on ROSA, complete the following steps:

  1. From the AWS ROSA console, click Enable ROSA to active the service on your AWS account (Figure 2).

    Enable ROSA on your AWS account

    Figure 2. Enable ROSA on your AWS account

  2. Create an AWS Cloud9 environment to run your CP4I installation. We used a t3.small instance type.
  3. When it comes up, close the Welcome tab and open a new Terminal tab to install the required packages:
    curl "https://awscli.amazonaws.com/awscli-exe-linux-x86_64.zip" -o "awscliv2.zip"
    unzip awscliv2.zip
    sudo ./aws/install
    wget https://mirror.openshift.com/pub/openshift-v4/clients/rosa/latest/rosa-linux.tar.gz
    sudo tar -xvzf rosa-linux.tar.gz -C /usr/local/bin/
    
    rosa download oc
    sudo tar -xvzf openshift-client-linux.tar.gz -C /usr/local/bin/
    
    sudo yum -y install jq gettext
  4. Ensure the ELB service-linked role exists in your AWS account:
    aws iam get-role --role-name 
    "AWSServiceRoleForElasticLoadBalancing" || aws iam create-service-linked-role --aws-service-name 
    "elasticloadbalancing.amazonaws.com"
  5. Create an IAM policy named cp4i-installer-permissions with the following permissions:
    {
        "Version": "2012-10-17",
        "Statement": [
            {
                "Effect": "Allow",
                "Action": [
                    "autoscaling:*",
                    "cloudformation:*",
                    "cloudwatch:*",
                    "ec2:*",
                    "elasticfilesystem:*",
                    "elasticloadbalancing:*",
                    "events:*",
                    "iam:*",
                    "kms:*",
                    "logs:*",
                    "route53:*",
                    "s3:*",
                    "servicequotas:GetRequestedServiceQuotaChange",
                    "servicequotas:GetServiceQuota",
                    "servicequotas:ListServices",
                    "servicequotas:ListServiceQuotas",
                    "servicequotas:RequestServiceQuotaIncrease",
                    "sts:*",
                    "support:*",
                    "tag:*"
                ],
                "Resource": "*"
            }
        ]
    }
  6. Create an IAM role:
    1. Select AWS service and EC2, then click Next: Permissions.
    2. Select the cp4i-installer-permissions policy, and click Next.
    3. Name it cp4i-installer, and click Create role.
  7. From your AWS Cloud9 IDE, click the grey circle button on the top right, and select Manage EC2 Instance (Figure 3).

    Manage the AWS Cloud9 EC2 instance

    Figure 3. Manage the AWS Cloud9 EC2 instance

  8. On the Amazon EC2 console, select the AWS Cloud9 instance, then choose Actions / Security / Modify IAM Role.
  9. Choose cp4i-installer from the IAM Role drop down, and click Update IAM role (Figure 4).

    Attach the IAM role to your workspace

    Figure 4. Attach the IAM role to your workspace

  10. Update the IAM settings for your AWS Cloud9 workspace:
    aws cloud9 update-environment --environment-id $C9_PID --managed-credentials-action DISABLE
    rm -vf ${HOME}/.aws/credentials
  11. Configure the following environment variables:
    export ACCOUNT_ID=$(aws sts get-caller-identity --output text --query Account)
    export AWS_REGION=$(curl -s 169.254.169.254/latest/dynamic/instance-identity/document | jq -r '.region')
    export ROSA_CLUSTER_NAME=cp4iblog01
  12. Configure the aws cli default region:
    aws configure set default.region ${AWS_REGION}
  13. Navigate to the Red Hat Hybrid Cloud Console, and copy your OpenShift Cluster Manager API Token.
  14. Use the token and log in to your Red Hat account:
    rosa login --token=<your_openshift_api_token>
  15. Verify that your AWS account satisfies the quotas to deploy your cluster:
    rosa verify quota
  16. When deploying ROSA for the first time, create the account-wide roles:
    rosa create account-roles --mode auto --yes
  17. Create your ROSA cluster:
    rosa create cluster --cluster-name $ROSA_CLUSTER_NAME --sts \
      --multi-az \
      --region $AWS_REGION \
      --version 4.10.35 \
      --compute-machine-type m5.4xlarge \
      --compute-nodes 3 \
      --operator-roles-prefix cp4irosa \
      --mode auto --yes \
      --watch
  18. Once your cluster is ready, create a cluster-admin user (it takes approximately 5 minutes):
    rosa create admin --cluster=$ROSA_CLUSTER_NAME
  19. Log in to your cluster using the cluster-admin credentials. You can copy the command from the output of the previous step. For example:
    oc login https://<your_cluster_api_address>:6443 \
      --username cluster-admin \
      --password <your_cluster-admin_password>
  20. Create an IAM policy allowing ROSA to use Amazon EFS:
    cat <<EOF > $PWD/efs-policy.json
    {
      "Version": "2012-10-17",
      "Statement": [
     {
       "Effect": "Allow",
       "Action": [
         "elasticfilesystem:DescribeAccessPoints",
         "elasticfilesystem:DescribeFileSystems"
       ],
       "Resource": "*"
     },
     {
       "Effect": "Allow",
       "Action": [
         "elasticfilesystem:CreateAccessPoint"
       ],
       "Resource": "*",
       "Condition": {
         "StringLike": {
           "aws:RequestTag/efs.csi.aws.com/cluster": "true"
         }
       }
     },
     {
       "Effect": "Allow",
       "Action": "elasticfilesystem:DeleteAccessPoint",
       "Resource": "*",
       "Condition": {
         "StringEquals": {
           "aws:ResourceTag/efs.csi.aws.com/cluster": "true"
         }
       }
     }
      ]
    }
    EOF
    POLICY=$(aws iam create-policy --policy-name "${ROSA_CLUSTER_NAME}-cp4i-efs-csi" --policy-document file://$PWD/efs-policy.json --query 'Policy.Arn' --output text) || POLICY=$(aws iam list-policies --query 'Policies[?PolicyName==`cp4i-efs-csi`].Arn' --output text)
  21. Create an IAM trust policy:
    export OIDC_PROVIDER=$(oc get authentication.config.openshift.io cluster -o json | jq -r .spec.serviceAccountIssuer| sed -e "s/^https:\/\///")
    cat <<EOF > $PWD/TrustPolicy.json
    {
      "Version": "2012-10-17",
      "Statement": [
     {
       "Effect": "Allow",
       "Principal": {
         "Federated": "arn:aws:iam::${ACCOUNT_ID}:oidc-provider/${OIDC_PROVIDER}"
       },
       "Action": "sts:AssumeRoleWithWebIdentity",
       "Condition": {
         "StringEquals": {
           "${OIDC_PROVIDER}:sub": [
             "system:serviceaccount:openshift-cluster-csi-drivers:aws-efs-csi-driver-operator",
             "system:serviceaccount:openshift-cluster-csi-drivers:aws-efs-csi-driver-controller-sa"
           ]
         }
       }
     }
      ]
    }
    EOF
  22. Create an IAM role with the previously created policies:
    ROLE=$(aws iam create-role \
      --role-name "${ROSA_CLUSTER_NAME}-aws-efs-csi-operator" \
      --assume-role-policy-document file://$PWD/TrustPolicy.json \
      --query "Role.Arn" --output text)
    aws iam attach-role-policy \
      --role-name "${ROSA_CLUSTER_NAME}-aws-efs-csi-operator" \
      --policy-arn $POLICY
  23. Create an OpenShift secret to store the AWS access keys:
    cat <<EOF | oc apply -f -
    apiVersion: v1
    kind: Secret
    metadata:
      name: aws-efs-cloud-credentials
      namespace: openshift-cluster-csi-drivers
    stringData:
      credentials: |-
        [default]
        role_arn = $ROLE
        web_identity_token_file = /var/run/secrets/openshift/serviceaccount/token
    EOF
  24. Install the Amazon EFS CSI driver operator:
    cat <<EOF | oc create -f -
    apiVersion: operators.coreos.com/v1
    kind: OperatorGroup
    metadata:
      generateName: openshift-cluster-csi-drivers-
      namespace: openshift-cluster-csi-drivers
    ---
    apiVersion: operators.coreos.com/v1alpha1
    kind: Subscription
    metadata:
      labels:
        operators.coreos.com/aws-efs-csi-driver-operator.openshift-cluster-csi-drivers: ""
      name: aws-efs-csi-driver-operator
      namespace: openshift-cluster-csi-drivers
    spec:
      channel: stable
      installPlanApproval: Automatic
      name: aws-efs-csi-driver-operator
      source: redhat-operators
      sourceNamespace: openshift-marketplace
    EOF
  25. Track the operator installation:
    watch oc get deployment aws-efs-csi-driver-operator \
     -n openshift-cluster-csi-drivers
  26. Install the AWS EFS CSI driver:
    cat <<EOF | oc apply -f -
    apiVersion: operator.openshift.io/v1
    kind: ClusterCSIDriver
    metadata:
      name: efs.csi.aws.com
    spec:
      managementState: Managed
    EOF
  27. Wait until the CSI driver is running:
    watch oc get daemonset aws-efs-csi-driver-node \
     -n openshift-cluster-csi-drivers
  28. Create a rule allowing inbound NFS traffic from your cluster’s VPC Classless Inter-Domain Routing (CIDR):
    NODE=$(oc get nodes --selector=node-role.kubernetes.io/worker -o jsonpath='{.items[0].metadata.name}')
    VPC_ID=$(aws ec2 describe-instances --filters "Name=private-dns-name,Values=$NODE" --query 'Reservations[*].Instances[*].{VpcId:VpcId}' | jq -r '.[0][0].VpcId')
    CIDR=$(aws ec2 describe-vpcs --filters "Name=vpc-id,Values=$VPC_ID" --query 'Vpcs[*].CidrBlock' | jq -r '.[0]')
    SG=$(aws ec2 describe-instances --filters "Name=private-dns-name,Values=$NODE" --query 'Reservations[*].Instances[*].{SecurityGroups:SecurityGroups}' | jq -r '.[0][0].SecurityGroups[0].GroupId')
    aws ec2 authorize-security-group-ingress \
      --group-id $SG \
      --protocol tcp \
      --port 2049 \
      --cidr $CIDR | jq .
  29. Create an Amazon EFS file system:
    EFS_FS_ID=$(aws efs create-file-system --performance-mode generalPurpose --encrypted --region ${AWS_REGION} --tags Key=Name,Value=ibm_cp4i_fs | jq -r '.FileSystemId')
    SUBNETS=($(aws ec2 describe-subnets --filters "Name=vpc-id,Values=${VPC_ID}" "Name=tag:Name,Values=*${ROSA_CLUSTER_NAME}*private*" | jq --raw-output '.Subnets[].SubnetId'))
    for subnet in ${SUBNETS[@]}; do
      aws efs create-mount-target \
        --file-system-id $EFS_FS_ID \
        --subnet-id $subnet \
        --security-groups $SG
    done
  30. Create an Amazon EFS storage class:
    cat <<EOF | oc apply -f -
    kind: StorageClass
    apiVersion: storage.k8s.io/v1
    metadata:
      name: efs-sc
    provisioner: efs.csi.aws.com
    parameters:
      provisioningMode: efs-ap
      fileSystemId: $EFS_FS_ID
      directoryPerms: "750"
      gidRangeStart: "1000"
      gidRangeEnd: "2000"
      basePath: "/ibm_cp4i_rosa_fs"
    EOF
  31. Add the IBM catalog sources to OpenShift:
    cat <<EOF | oc apply -f -
    apiVersion: operators.coreos.com/v1alpha1
    kind: CatalogSource
    metadata:
      name: ibm-operator-catalog
      namespace: openshift-marketplace
    spec:
      displayName: IBM Operator Catalog
      image: 'icr.io/cpopen/ibm-operator-catalog:latest'
      publisher: IBM
      sourceType: grpc
      updateStrategy:
        registryPoll:
          interval: 45m
    EOF
  32. Get the console URL of your ROSA cluster:
    rosa describe cluster --cluster=$ROSA_CLUSTER_NAME | grep Console
  33. Copy your entitlement key from the IBM container software library.
  34. Log in to your ROSA web console, navigate to Workloads > Secrets.
  35. Set the project to openshift-config; locate and click pull-secret (Figure 5).

    Edit the pull-secret entry

    Figure 5. Edit the pull-secret entry

  36. Expand Actions and click Edit Secret.
  37. Scroll to the end of the page, and click Add credentials (Figure 6):
    1. Registry server address: cp.icr.io
    2. Username field: cp
    3. Password: your_ibm_entitlement_key

      Configure your IBM entitlement key secret

      Figure 6. Configure your IBM entitlement key secret


  38. Next, navigate to Operators > OperatorHub. On the OperatorHub page, use the search filter to locate the tile for the operators you plan to install: IBM Cloud Pak for Integration and IBM MQ. Keep all values as default for both installations (Figure 7). For example, IBM Cloud Pak for Integration:

    Figure 7. Install CP4I operators

    Figure 7. Install CP4I operators

  39. Create a namespace for each CP4I workload that will be deployed. In this blog, we’ve created for the platform UI and IBM MQ:
    oc new-project integration
    oc new-project ibm-mq
  40. Review the IBM documentation to select the appropriate license for your deployment.
  41. Deploy the platform UI:
    cat <<EOF | oc apply -f -
    apiVersion: integration.ibm.com/v1beta1
    kind: PlatformNavigator
    metadata:
      name: integration-quickstart
      namespace: integration
    spec:
      license:
        accept: true
        license: L-RJON-CD3JKX
      mqDashboard: true
      replicas: 3  # Number of replica pods, 1 by default, 3 for HA
      storage:
        class: efs-sc
      version: 2022.2.1
    EOF
  42. Track the deployment status, which takes approximately 40 minutes:
    watch oc get platformnavigator -n integration
  43. Create an IBM MQ queue manager instance:
    cat <<EOF | oc apply -f -
    apiVersion: mq.ibm.com/v1beta1
    kind: QueueManager
    metadata:
      name: qmgr-inst01
      namespace: ibm-mq
    spec:
      license:
        accept: true
        license: L-RJON-CD3JKX
        use: NonProduction
      web:
        enabled: true
      template:
        pod:
          containers:
            - env:
                - name: MQSNOAUT
                  value: 'yes'
              name: qmgr
      queueManager:
        resources:
          limits:
            cpu: 500m
          requests:
            cpu: 500m
        availability:
          type: SingleInstance
        storage:
          queueManager:
            type: persistent-claim
            class: gp3
            deleteClaim: true
            size: 2Gi
          defaultClass: gp3
        name: CP4IQMGR
      version: 9.3.0.1-r1
    EOF
  44. Check the status of the queue manager:
    oc describe queuemanager qmgr-inst01 -n ibm-mq

Validation steps

Let’s verify our installation!

  1. Run the commands to retrieve the CP4I URL and administrator password:
    oc describe platformnavigator integration-quickstart \
      -n integration | grep "^.*UI Endpoint" | xargs | cut -d ' ' -f3
    oc get secret platform-auth-idp-credentials \
      -n ibm-common-services -o jsonpath='{.data.admin_password}' \
      | base64 -d && echo
  2. Using the information from the previous step, access your CP4I web console.
  3. Select the option to authenticate with the IBM provided credentials (admin only) to login with your admin password.
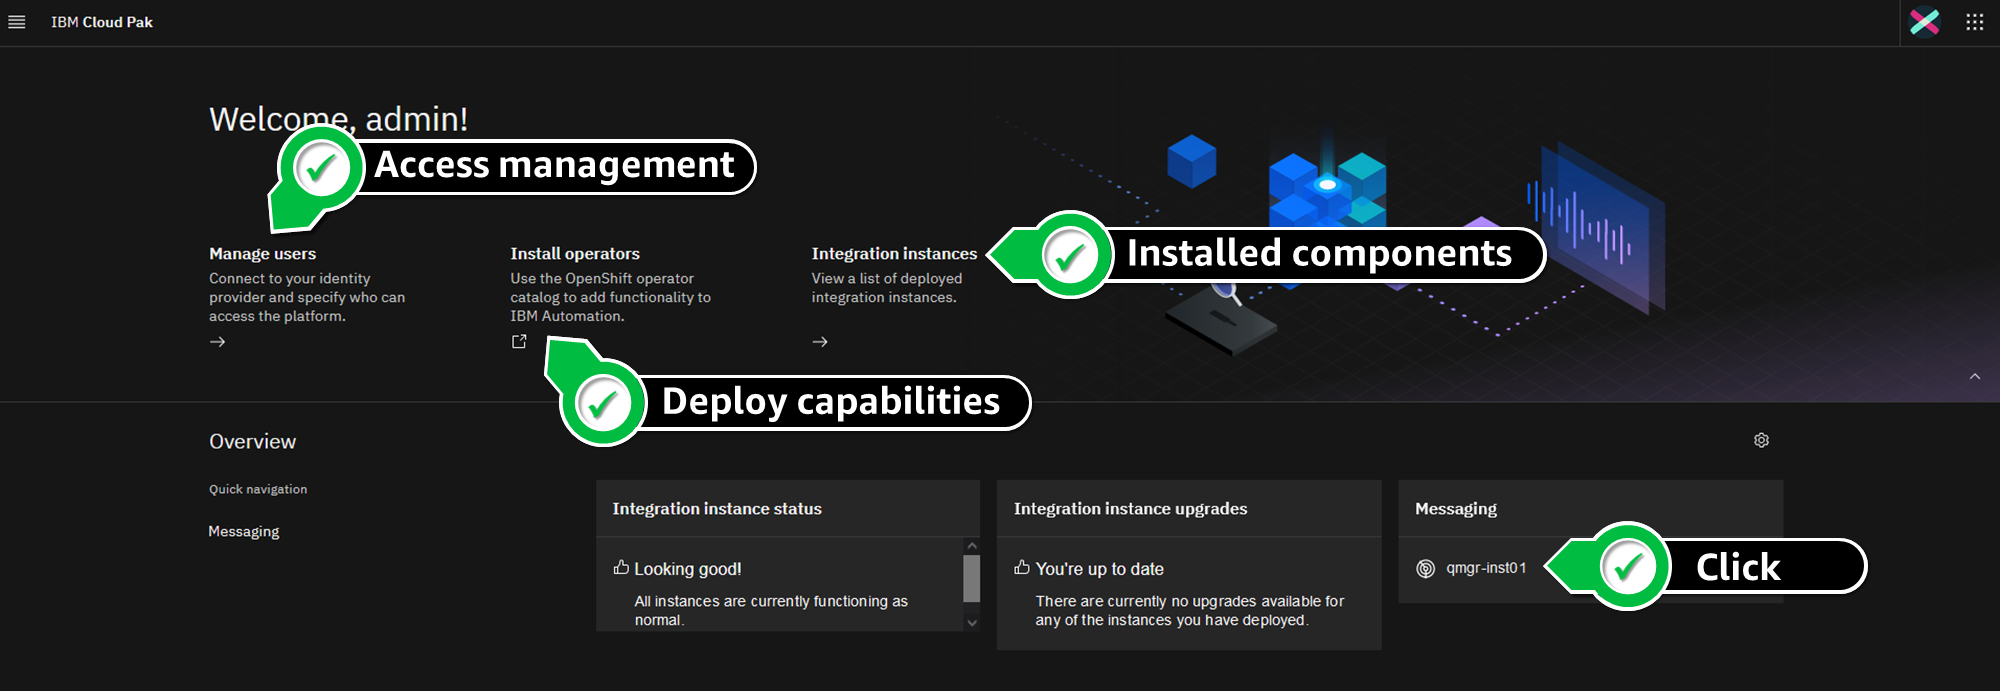
  4. From the CP4I console, you can manage users and groups allowed to access the platform, install new operators, and view the components that are installed.
  5. Click qmgr-inst01 in the Messaging widget to bring up your IBM MQ setup (Figure 8).

    CP4I console features

    Figure 8. CP4I console features

  6. In the Welcome to IBM MQ panel, click the CP4IQMGR queue manager. This shows the state, resources, and allows you to configure your instances (Figure 9).

    Queue manager details

    Figure 9. Queue manager details

Congratulations! You have successfully deployed IBM CP4I on Red Hat OpenShift on AWS.

Post installation

Review the following topics, when you are installing CP4I on production environments:

Cleanup

Connect to your Cloud9 workspace, and run the following steps to delete the CP4I installation, including ROSA. This avoids incurring future charges on your AWS account:

EFS_EF_ID=$(aws efs describe-file-systems \
  --query 'FileSystems[?Name==`ibm_cp4i_fs`].FileSystemId' \
  --output text)
MOUNT_TARGETS=$(aws efs describe-mount-targets --file-system-id $EFS_EF_ID --query 'MountTargets[*].MountTargetId' --output text)
for mt in ${MOUNT_TARGETS[@]}; do
  aws efs delete-mount-target --mount-target-id $mt
done
aws efs delete-file-system --file-system-id $EFS_EF_ID

rosa delete cluster -c $ROSA_CLUSTER_NAME --yes --region $AWS_REGION

Monitor your cluster uninstallation logs, run:

rosa logs uninstall -c $ROSA_CLUSTER_NAME --watch

Once the cluster is uninstalled, remove the operator-roles and oidc-provider, as informed in the output of the rosa delete command. For example:

rosa delete operator-roles -c 1vepskr2ms88ki76k870uflun2tjpvfs --mode auto –yes
rosa delete oidc-provider -c 1vepskr2ms88ki76k870uflun2tjpvfs --mode auto --yes

Conclusion

This post explored how to deploy CP4I on AWS ROSA. We also demonstrated how customers can take full advantage of managed OpenShift service, focusing on further modernizing application stacks by using AWS managed services (like ROSA) for their application deployments.

If you are interested in learning more about ROSA, take part in the AWS ROSA Immersion Workshop.

Check out the blog on Running IBM MQ on AWS using High-performance Amazon FSx for NetApp ONTAP to learn how to use Amazon FSx for NetApp ONTAP for distributed storage and high availability with IBM MQ.

For more information and getting started with IBM Cloud Pak deployments, visit the AWS Marketplace for new offerings.

Further reading

Security updates for Monday

Post Syndicated from original https://lwn.net/Articles/914012/

Security updates have been issued by Debian (ffmpeg, libxml2, python-django, python-scciclient, and xen), Fedora (ghc-cmark-gfm, java-latest-openjdk, and vim), Mageia (expat, ntfs-3g, and wkhtmltopdf), Oracle (kernel), Slackware (sudo), and SUSE (expat, libxml2, rubygem-loofah, and xmlbeans).

Server-side rendering micro-frontends – the architecture

Post Syndicated from James Beswick original https://aws.amazon.com/blogs/compute/server-side-rendering-micro-frontends-the-architecture/

This post is written by Luca Mezzalira, Principal Specialist Solutions Architect, Serverless.

Microservices are a common pattern for building distributed systems. As frontend developers have modified their approaches to build architectures at scale, many are building micro-frontends.

This blog series explores how to implement micro-frontends using a server-side rendering (SSR) approach with AWS services. This first article covers the architecture characteristics and building blocks for designing a successful micro-frontends architecture in the AWS Cloud.

What are micro-frontends?

Micro-frontends are the technical representation of a business subdomain. They allow independent teams to work in parallel, reducing external dependencies and increasing delivery throughput. They embody several microservices characteristics such as governance decentralization, design for failure, and evolutionary design.

The main difference between micro-frontends and components is related to the domain ownership present inside a micro-frontend. With components, the domain knowledge is usually delegated to its container, which knows how to use the component’s property based on the context. Owning the domain inside a micro-frontend enables the independence that you expect in a distributed system. This doesn’t mean that micro-frontends cannot communicate or share resources, but the mindset is different compared with components.

If you are using microservices today, you may benefit from micro-frontends for scaling your frontend applications. Before micro-frontends, scaling was based primarily on developers’ expertise. Micro-frontends allow you to modernize frontend applications iteratively like you would with microservices. Every user downloads only the code needed for accomplishing a specific task, increasing the performance and users experience of a web application.

Architecture characteristics

This blog series builds a product details page of an example ecommerce website using micro-frontends with serverless infrastructure.

Page layout

The page is composed of:

  • A template that includes a header. This could include more common parts but uses one in this example.
  • A notifications micro-frontend that is client-side rendered. The notifications system must react to user interactions, so cannot be server-side rendered with the rest of the page.
  • A product details micro-frontend.
  • A reviews micro-frontend.

Every micro-frontend is independent and can be developed by different teams working on the same project. This can reduce external dependencies and potential bugs across the entire application.

The key system characteristics of this project are:

  1. Server-side rendering: The system must be designed with a server-side rendering approach. This provides fast rendering of the page inside modern browsers and reduces the need of client-side JavaScript for rendering the page.
  2. Framework agnostic: The solution must work with a broad variety of JavaScript libraries available and not be bound or optimized to a specific framework.
  3. Use optimizations best practices: Optimization is a key feature for server-side rendering applications. Many industries rely on these characteristics for increasing sales. This example encapsulates core web vitals metrics, progressive hydration, and different levels of caches to speed up the response times of the webpages.
  4. Team independence: Every micro-frontend must be developed with minimum external dependencies. Constant coordination across teams can be a sign of design-time coupling that invalidates the purpose behind a distributed system.
  5. Serverless infrastructure for frontend developers: The serverless paradigm helps developers focus on the business logic instead of infrastructure, using a “pay for value” model, which helps to reduce costs. You can cache micro-frontend responses and reduce the traffic on the origin and the need to scale every part of the system in the same way.

High-level architecture design

This is the high-level design to incorporate these architectural characteristics:

Architectural overview

  1. The application entry point is a content delivery network (CDN) that is used for caching, performance, and security reasons.
  2. The server-side rendering approach requires a place to store all the static files to hydrate the JavaScript code in the browser and for styling components.
  3. Pages requests require a UI composer that retrieves the micro-frontends and stitches them together to provide the page consumed by a browser. It streams the final HTML page to the browser to enhance the largest contentful paint (LCP) metric from the core web vitals.
  4. Decouple micro-frontends from the UI composer relies on two mechanisms: A micro-frontends discovery that acts like a service discovery in a microservice architecture, and an HTML template per page that describes where to inject the micro-frontends inside a page. The templates can live in the same repository where the other static files are present.
  5. The notification micro-frontend reacts to user interactions, providing a notification when a user adds a product in the cart.
  6. The product details micro-frontend has highly cacheable data that doesn’t require many changes over time.
  7. The reviews micro-frontend must retrieve user reviews of a specific product.

The key element for avoiding design-time coupling in this architecture is the micro-frontends discovery. The main advantages of this approach are to provide discoverability to simplify multi-environments strategies, and also to reduce the blast radius thanks to using blue/green deployments or canary releases. This topic will be covered in depth in an upcoming post.

From high-level design into implementation

The framework-agnostic approach helps to enable control over system evolution. It achieves this by using HTML-over-the-wire, where every micro-frontend renders an HTML fragment and returns it to the UI composer.

When the UI composer gathers the HTML fragments, it composes the final page to render using transclusion. Every page is represented by a specific template hosted in static files. The UI composer retrieves the template and then retrieves placeholder references in the template that can be replaced with the micro-frontend fragments.

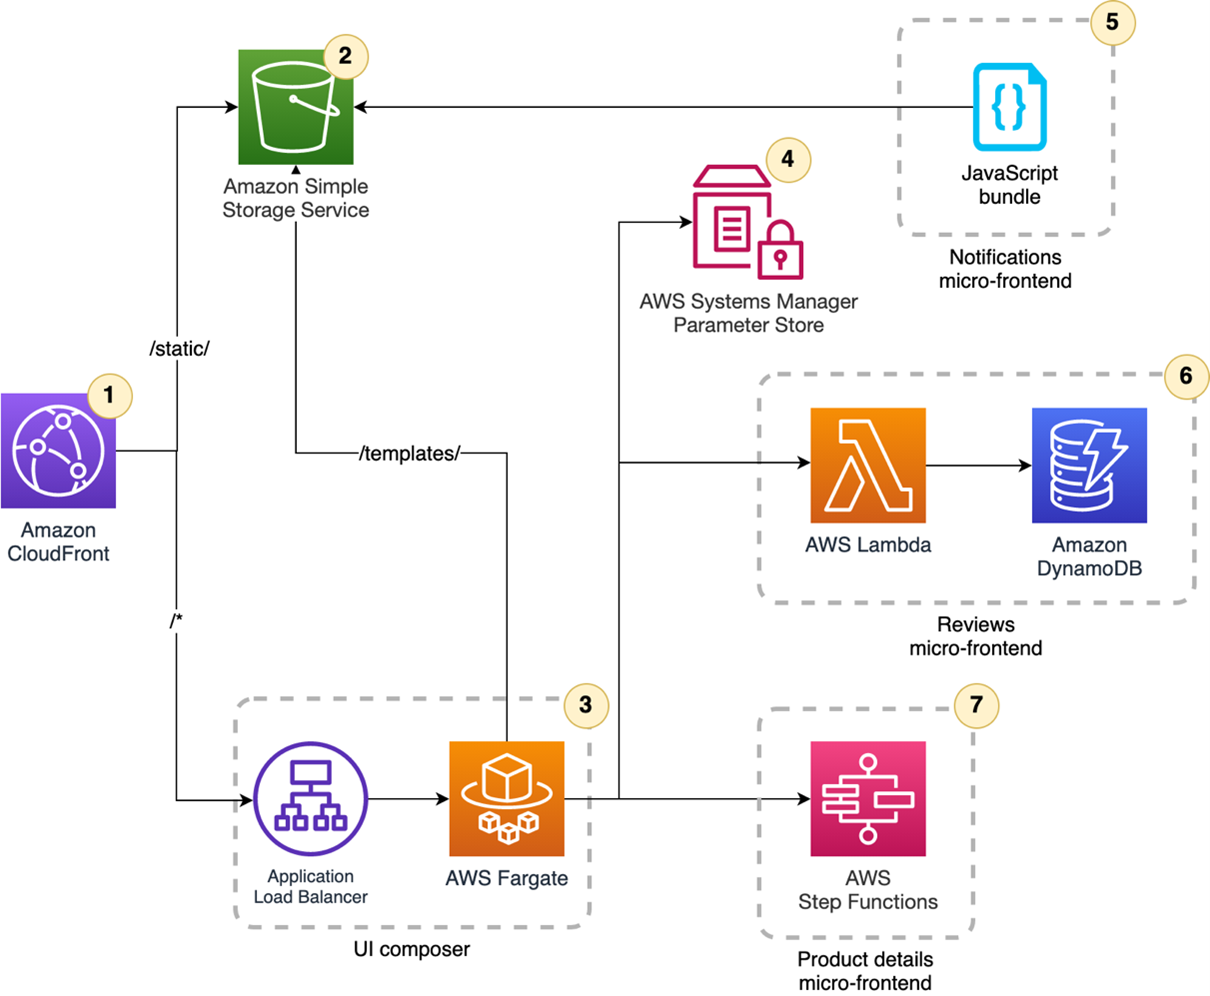
This is the architecture used:

Architecture diagram

  1. Amazon CloudFront provides a unique entry point to the application. The distribution has two origins: the first for static files and the second for the UI composer.
  2. Static files are hosted in an Amazon S3 bucket. They are consumed by the browser and the UI composer for HTML templates.
  3. The UI composer runs on a containers cluster in AWS Fargate. Using a containerized solution allows you to use streaming capabilities and multithreading rendering if needed.
  4. AWS Systems Manager Parameter Store is used as a basic micro-frontends discovery system. This service is a key-value store used by the UI composer for retrieving the micro-frontends endpoints to consume.
  5. The notifications micro-frontend stores the optimized JavaScript bundle in the S3 bucket. This renders on the client since it must react to user interactions.
  6. The reviews micro-frontend is composed by an AWS Lambda function with the user reviews stored in Amazon DynamoDB. It’s rendered fully server-side and it outputs an HTML fragment.
  7. The product details micro-frontend is a low-code micro-frontend using AWS Step Functions. The Express Workflow can be invoked synchronously and contains the logic for rendering the HTML fragment and a caching layer. This increases performance due to the native integration with over 200 AWS services.

Using this approach, every team developing a micro-frontend is independent to build and evolve their business domain. The main touchpoints with other teams are related to the initial integrations and the communication mechanism between micro-frontends present in the same page. When these points are achieved, every team reduces external dependencies and can embrace the evolutionary nature of micro-frontends.

Conclusion

This first post starts the journey into micro-frontends, a distributed architecture for frontend applications. The next post will explore the UI composer and micro-frontends discovery implementations.

If you are interested in learning more about micro-frontends, see the micro-frontends decisions framework, a mental model created for the initial complexity of approaching micro-frontends design. When used as a north star, the decisions framework simplifies the development of micro-frontends applications.

In the AWS reference architectures section, you can find a complete diagram similar to the application described in this blog series with additional details.

For more serverless learning resources, visit Serverless Land.

The Conviction of Uber’s Chief Security Officer

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2022/11/the-conviction-of-ubers-chief-security-officer.html

I have been meaning to write about Joe Sullivan, Uber’s former Chief Security Officer. He was convicted of crimes related to covering up a cyberattack against Uber. It’s a complicated case, and I’m not convinced that he deserved a guilty ruling or that it’s a good thing for the industry.

I may still write something, but until then, this essay on the topic is worth reading.

SystemTap 4.8 released

Post Syndicated from original https://lwn.net/Articles/913908/

Version 4.8 of the SystemTap tracing tool is out. “Enhancements to this release include: kernel runtime improvements
on multi-CPU systems, python3 tapset support through python3.11,
tapset and template script for cve livepatching, bpf backend
embedded-code assembler improvements
“.

Седмицата (28 октомври – 5 ноември)

Post Syndicated from Светла Енчева original https://toest.bg/editorial-28-oct-5-nov-2022/

Гласуването с хартиени бюлетини се завърна. Поне на първо четене. Но изминалата седмица най-сетне ни зарадва и с една добра политическа новина – парламентът гласува с голямо мнозинство предоставяне на военна помощ за Украйна. В последния момент от „Български възход“ промениха позицията си и гласуваха „за“, така че против останаха само от „Възраждане“ и БСП. Този ход на партията на Стефан Янев е повече от интересен, като се има предвид, че председателят ѝ беше отстранен от поста министър на отбраната в редовното правителство на Кирил Петков, защото възпроизвеждаше опорките на кремълската пропаганда, отказвайки да нарече руската агресия в Украйна война. Но кой знае, може би желанието му да участва във властта, каквато и да е тя, е по-силно от привързаността му към Русия на Путин.

Служебният военен министър Димитър Стоянов от своя страна даде ясен знак, че ще се опита да попречи на предоставянето на реална военна помощ, заявявайки, че предложението на правителството по този въпрос ще бъде „крайно консервативно“. Като имаме предвид, че редовно правителство не се очертава скоро, нищо чудно парламентът и президентът Румен Радев (посредством назначените от него служебни кабинети) да си прехвърлят топката до края на войната.

На този фон служебният премиер Гълъб Донев демонстрира две положителни качества – чувство за хумор и способност за самоирония. Той повтори вица за себе си, разказан през лятото от Бойко Борисов: „Как Гълъб Донев прави бюджет? Перо по перо.“

Емилия Милчева

„На терена на постполитиката президентът е цар“, твърди Емилия Милчева в тазседмичния си политически коментар. Признаци на постполитиката са деидеологизация, тоест отказване от идеите за ляво и дясно, популистки мерки, стихийно появяващи се и закърняващи политически формации. Във времената на постполитиката печели онзи, който е не-политик по закон – президентът, а безконтролната власт, опакована като „служба на Отечеството“, се услажда. Единственото, което в тази ситуация вгорчава битието на Радев, е, че парламентът изненадващо заработи.

Мирослав Зафиров

Политиката в Израел може да ни изглежда далечна тема, но всъщност ни е изненадващо близка. На 1 ноември в страната се проведоха поредните „последни избори“ – петите от 2019 г. насам, а това доста напомня ситуацията у нас. Дни преди изборите в Израел в обзорната си статия Мирослав Зафиров открои и други паралели с България. Обща между двете страни е и надеждата, че най-сетне ще се сформира стабилно правителство, въпреки че изгледите това да стане в Израел са повече, отколкото в България.

Юлия Георгиева

Юлия Георгиева от Центъра за хуманни политики, който управлява дневния център за хора със зависимости „Розовата къща“, е била герой на няколко публикации в „Тоест“. Радваме се, че тя вече е и наш автор с кратка справка от първа ръка за зависимостите в България. В нея Юлия споделя личен професионален опит и представя в исторически контекст употребата на психоактивни вещества в страната ни, борбата срещу нея, както и формите за подкрепа на хора със зависимости. Изводите за ролята на държавата в това отношение никак не са оптимистични.

Константина Василева

Медиите като част от дезинформационния поток – това е темата на статията на Константина Василева в съвместната ни рубрика с АЕЖ-България „Хроники на инфодемията“. В нея се описват едни от основните механизми за дезинформация. Такъв механизъм например е представянето на факти без контекст – нещо, което не е чуждо дори на БТА. Друг фактор е „медийната легитимност назаем“ – подправени скрийншотове на статии, които се представят като публикации на реномирани издания. Според авторката социалните мрежи са най-прекият път до дезинформацията, а подкопаването на доверието в медиите е основна тактика за неутрализиране на проверката на факти.

Зорница Христова

Минаваме на по-приятна вълна – културната. В рубриката „По буквите“ Зорница Христова ни препоръчва две стихосбирки и един роман. Стихотворенията в „Пристанището на часовника“ на Мария Липискова се обитават от жена, чиито белези на принадлежност към определена част на обществото са повехнали или изтръгнати. Във „Време за суинг“ от Зейди Смит (в превод на Невена Дишлиева-Кръстева) темите за принадлежността – раса, класа, пол – отекват ритмично, като тракане на обувки за степ. А в поетичната книга „Светът на думите“ от Роман Кисьов несъвпадението със себе си не е мъчителен парадокс, а състояние, което носи радост, усещане за богатство и свобода.

Мирослава Кацарова

Тазгодишното осмо издание на „Пловдив Джаз Фест“ започна вчера, а закриването му е на 7 ноември. На тази дата в пловдивския Културен дом „Борис Христов“ концерт ще изнесе една от най-прочутите съвременни джаз певици – Гретчен Парлато. По молба на „Тоест“ българската ѝ колежка Мирослава Кацарова, която е и организатор на фестивала, направи блицинтервю с Парлато за силата на деликатния музикален изказ. Докато го четете, може да се насладите и на няколко музикални изпълнения на певицата.

Щом сме на музикална вълна, и този път няма да ви оставя без лична препоръка. Нина Хаген, известна като германската „кръстница на пънка“, има нов албум – 11 години след последния си. Той ще бъде пуснат в продажба на 9 декември, а междувременно се завъртя една песен от него – 16 Tons. Песента всъщност е кавър – оригиналът от 1946 г., посветен на тежкия живот на миньорите, е на Мърл Травис, но парчето става популярно едва след кавър версията на Тенеси Ърни Форд от 1955 г. и европейския вариант на Франки Лейн от следващата година.

В клипа към версията на Нина Хаген вместо нея участват други, гримирани в неин стил. Но гласът си е нейният, колкото и да не прилича на женски. Просто „кръстницата на пънка“ може не само да стига височини на оперно сопрано, а да пее и така:

Приятно четене и слушане!

Източник

Медиите като част от дезинформационния поток

Post Syndicated from original https://toest.bg/mediite-kato-chast-ot-dezinformatsionniya-potok/

През 2021 г. Европейският парламент публикува доклад за дезинформацията и пропагандата, в който се отбелязва, че борбата с тях става все по-сложна, защото са все по-преплетени с реално съдържание и съответно все по-трудни за идентифициране. Особено опасно е, когато дезинформацията се споделя от личности с висок авторитет.

В статия за механизмите на дезинформацията от януари т.г. в Nature Reviews Улрих Екер и колегите му изтъкват и значителната роля на дигиталната инфраструктура, по-конкретно възможността чрез социалните мрежи с прецизност да се таргетират хора с определени интереси и предпочитания. Авторите отбелязват, че досегашният модел на третиране на дезинформацията като информационен дефицит вече не работи. Решението не е в предоставянето на повече факти. Има редица мисловни, емоционални и ценностни механизми, които изкривяват начина, по който хората пресяват информация – особено ако тя противоречи на техните убеждения.

В такава среда е от особено значение не само информирането на аудиторията, но и начинът, по който това се прави. Има редица неща, с които медиите допринасят за дезинформационния поток.

Факти без контекст

Понякога непълната информация, поднесена без достатъчно контекст, може да бъде подвеждаща. Пример са новините в български медии за рекордните случаи на COVID-19 в Нова Зеландия тази година. През февруари дори БТА отрази новината с фокус върху сензационния елемент („1160 нови случая на зараза, което е най-голямата цифра от началото на пандемията“), допълвайки, че рекордният брой на новозаразени е регистриран „в момент, в който продължават протестите срещу антиковидните рестрикции и ваксинационната политика на правителството“. Самата информация не е некоректна, но без контекст може да се интерпретира погрешно.

Първо, поднесена по такъв начин, новината оставя впечатление за масово недоволство и противопоставяне. В действителност близо 90% от цялото население е ваксинирано. Едва 25% от респондентите на представителното проучване на Ipsos от февруари смятат, че мерките в страната са твърде строги, а допитване на Kantar през март показва, че само 12% от гражданите подкрепят протестите срещу мерките.

Протестът тръгва от стотина души и дори в пика си не надхвърля 2000–3000 демонстранти (или около 0,05% от населението). Голяма част от тях изобщо не са спонтанно появили се граждани. Организирани групи идват от цялата страна след агитацията на Браян Тамаки – пастор във фундаменталистка църква, за която един от ветераните на новозеландската журналистика алармира, че се вписва в дефиницията за култ. Въпреки че партията му Vision NZ активно организира всички протести срещу мерките на правителството, Тамаки всъщност печели пари от… даване на църковна земя под наем за подвижни центрове за ваксиниране и тестване.

Второ, има рекорд, защото през първите две години на пандемията дневните случаи на COVID-19 в Нова Зеландия само по изключение са надхвърляли 200, а в повечето дни са били под 10. Това се променя през февруари 2022 г., защото отварянето на границите за повече пътуващи от други страни премахва огромна бариера срещу разпространението на вируса, която дотогава е предпазвала страната. Над 1000 новозаразени на ден е рекорд само за местния контекст и спрямо изключително ниските нива преди това. Числата са значително по-малки в сравнение с останалия свят. На 16 февруари, когато Нова Зеландия отчита този рекорд от 1160 души, новите случаи в България са 6589 (като само три седмици по-рано бяха надхвърлили 12 000).

Някои български медии дори преминават от зоната на недостатъчен контекст в зоната на сериозна дезинформация, интерпретирайки броя на случаите в Нова Зеландия като „доказателство“, че ваксинирането не работи. Без никаква проверка на новозеландски научни изследвания или местна статистика. Както изглежда, за източници не са ползвани и новозеландски медии, които задължително се консултират професионално с учени и статистици преди публикация.

Също така по-важната статистика е не броят на заразените на ден (той зависи много и от нивото на тестване, което в Нова Зеландия по това време е изключително високо), а броят на починалите от COVID-19. Това е значително по-надежден критерий дали населението е успешно предпазено от тежките последствия от вируса, което е и целта на ваксинационната кампания. По данни на СЗО, преди публикуването на новината за „рекорда“ общо починалите от COVID-19 в страната са 53 души. Към днешна дата броят им е малко над 2100 – за целия период от 2020 г. досега. За още контекст, населението на Нова Зеландия е около 5,1 млн. души и 89,14% от тях имат поне една ваксинационна доза. По данни на официалния портал за коронавируса в България, към момента смъртните случаи от COVID-19 у нас са близо 38 000. Ваксинирани са около 30% от гражданите.

Медийна легитимност назаем

Доверието в легитимни медии вече се използва за прокарване на фалшиви новини, които те никога не са тиражирали. В социалните мрежи все по-често се разпространяват скрийншотове на „новини“, които уж са публикувани от уважавани издания. В действителност се използват екранни снимки на истински статии, на които се подменя заглавие, снимка или придружаващ текст.

Наскоро например републиканецът Тед Круз възмутено сподели материал уж на Atlantic, в който се твърди, че мюсюлмански родители са били обвинени в крайнодесни пристрастия, защото са възроптали срещу програма за сексуално образование. „Левицата е отвъд пародията“, гласи туитът на американския сенатор, придружен със снимка на статията. Проблемът е, че такъв материал никога не е бил публикуван, а предполагаемата му авторка Аби Олдхайзър от десетилетие не работи за изданието. Скрийншотът е манипулиран – с подменени текстове и заглавна снимка – и очевидно създаден с цел да предизвика реакции.

Това е пример как фалшива новина може да придобие легитимност, като 1) излезе с логото на истинска медия и 2) я сподели политик с много последователи, които едва ли са проверили фактите, преди да се включат в общия възмутен хор.

В Европа се случва същото. По-рано тази година във Facebook набра популярност статия уж на германската обществена телевизия ARD, според която президентът на страната Франк-Валтер Щайнмайер е сравнил пандемията с диктатура. Това е изфабрикувана история, както и новината, че дядото на канцлера Олаф Шолц е бил част от SS. Измислените истории засягат всякакви теми – от „упадъчното образование“ в САЩ до войната в Украйна. Обикновено за имитация се подбират по-големи медии, като BBC, CNN и Deutsche Welle. Лесен тест за проверка на подобни новини е просто да се види дали има достоверен линк към самата статия. Имитацията на заглавие е лесна, по-трудно се имитира цял сайт.

Социалните медии: най-прекият път до дезинформацията

Социалните медии играят значителна роля в разпространението на подобни фалшифицирани новини. Потребителите често препускат през огромното количество информация в социалните мрежи и споделят статии, без дори да ги четат, какво остава да проверят достоверността на написаното. Eкосистемата на тези мрежи предразполага към бързо прескачане на вниманието от една тема на друга. Алгоритмите влошават нещата, защото с всеки коментар или харесване на фалшиви новини от потребителя все повече подобни публикации излизат на преден план.

Снимките и личните профили създават илюзия за достоверност, но през последните 5 години потокът от дезинформация е толкова сериозен, че става все по-трудно да се разбере дали зад профилите стоят истински хора, или организирани групи от онлайн тролове. Покрай нашумелите преговори на Twitter с Илон Мъск се загатна, че фалшивите профили в социалната мрежа са далеч над официално изчислените 5–11%. Според данни на Statista само през първото тримесечие на 2022 г. Facebook е премахнал 1,6 милиарда (да, милиарда) фалшиви акаунта. И това най-вероятно е само върхът на айсберга. Дори LinkedIn обяви борба с фалшивите профили. Там поне целта е най-вече маркетингова, за разлика от политическия и обществен фокус в други социални мрежи.

Неслучайно индексът на доверие в медиите, публикуван от Европейския съюз за радио и телевизия, отбелязва постоянен срив на доверието в социалните мрежи в Европа от 2014 г. насам.

Подкопаването на доверието като тактика за неутрализиране на проверката на факти

Любим дезинформационен рефрен в социалните мрежи е, че те предоставят „истинска“ и „неподправена“ информация, за разлика от „платените“ медии и официалните източници. Той се появява не само в потребителските разговори, но и в наратива на малки медии и независими автори на съдържание, особено в YouTube. Тази опорна точка е изключително удобна. Ако не се вярва на медиите, няма да се вярва и на проверката на факти, направена от тях. По този начин разобличаването на дезинформацията може да бъде „обезвредено“ още преди да се е състояло.

Недоверието в „официалната информация“ има двоен механизъм на действие: 1) помага да се разпространят опасни митове и дезинформация и 2) парадоксално, подсилва доверието в тях. В крайна сметка, ако някой предвиди, че дадено твърдение ще бъде отхвърлено, и то наистина се отрече от проверителите на факти, това може да се интерпретира като „доказателство“, че се покрива информация. Този механизъм работи много силно психологически, защото разчита на т.нар. confirmation bias – склонността ни да виждаме само това, което подкрепя съществуващото ни мнение, и да пренебрегваме останалото, което му противоречи.

В Източна Европа навигирането в тези води е по-сложно, защото има основателни причини за съмнение в безпристрастността на медийното отразяване. Непрозрачната собственост, политическата обвързаност, конфликтите на интереси и координираните дезинформационни кампании донякъде оправдават недоверието в големите медии. Спирането на RT и „Спутник“ на територията на ЕС e решение, основано на това, че при липса на независима редакционна политика големите медии действително могат да бъдат значителни проводници на дезинформация.

В англоезичния свят масмедиите преди дигиталните времена (преса, телевизия, радио) се наричат legacy media. Днес все по-често този израз (както и „мейнстрийм медии“) се употребява в нов, политизиран контекст. Онлайн сайтове и кабелни телевизии го използват за критика срещу големите издания, които избягват да коментират определени гледни точки. Подтекстът е, че те или не са способни да „уловят новите тенденции“, или умишлено крият факти и съобщават само определена информация. Така проверката на факти се интерпретира като налагане на мнение и дори като опит за цензура.

Проблемът с аргумента за „всички гледни точки“ е, че има „гледни точки“, които са базирани на частично или изцяло неверни данни. Те се отсяват в името на качеството на информацията, не на заглушаването на мнения. Има хора, които и днес са убедени, че Земята е плоска, макар Аристотел да говори за сферичната ѝ форма още през IV век пр.н.е., а околосветското пътешествие на Магелан и Елкано през ХVI век доказва това на практика. Би било абсурдно алтернативната гледна точка за плоска Земя да заема екранно време. По същия начин качествените медии отказват да тиражират информация, която не е надеждно подкрепена от факти. Онлайн сайтове и видеоканали, които се стремят към по-голяма аудитория и трафик, нямат такива скрупули. Това ги прави значително по-отворени към публикуване на непроверена, понякога и открито манипулативна и грешна информация.

Давид срещу Голиат?

От около 2016 г. насам нова гвардия от „независими“ уебсайтове, подкасти и видеоканали все по-активно налага своите тези за упадъка на големите медии. Стив Банън и онлайн изданието Breitbart бяха сред първите. Наративът варира от „авторите на големите издания са некомпетентни и качеството е далеч от славните им дни“ до „официалните политкоректни новини няма да ви кажат това, което ние можем“. Идеята е една: вече не може да имате доверие на големите медии, само шепа „независими смелчаци“ казват нещата „такива, каквито са“. С една малка подробност – има доста въпросителни около независимостта на Банън и компания.

Зад Breitbart стоят парите на Робърт Мърсър – хеджфонд мениджър, който според Джейн Майър от New Yorker е вложил 10 млн. долара в проектите на Банън, докато са били още във фаза развиващи се блогове. Макар да пази добре личното си пространство, Мърсър е известен и с друга инвестиция, която предизвика медийна буря през 2018 г. „Кеймбридж Аналитикa“ се прочу с опита си да повлияе на американските избори през 2016 г., използвайки неетично придобити психометрични данни на милиони потребители на Facebook, за да ги профилира и потенциално манипулира като избиратели.

Връзката на Breitbart с милионери с политически интереси не е изключение. Въпреки че се брандират като свободни от манипулация независими медии, много от „алтернативните“ информационни канали се финансират от хора, които имат интерес да се насочва вниманието към определени теми. Ще чуете безброй разкази за „смели и инакомислещи“ създатели на съдържание, които се опълчват срещу „диктата на официалните медии“. Британският уебсайт UnHerd също се брандира като алтернатива, но позицията му срещу пандемичните мерки има много малко общо с независимия научен консенсус и повече с вижданията на инвеститора, който го финансира – Пол Маршал. Позициите на „независимия сайт“ до голяма степен се припокриват с друг проект, който е получил над 10 млн. паунда от Маршал – консервативния GB News. Съвсем очаквано, сред любимите теми в UnHerd e и „митът за дезинформацията“.

Около американския уебсайт Daily Wire също има цяло съзвездие от независими видео и подкаст канали, чиито водещи редовно гостуват един на друг. Всеки си има отделен бранд, но основните им послания (случайно или не) са добре синхронизирани по отношение на пандемията и други актуални обществени теми. Проследяването на финансирането им води до петролните магнати Дан и Ферис Уилкс. Не е изненада, че покрай критиките на тези канали към упадъка на съвременното образование в САЩ рано или късно се стига до промоция на PragerU. Въпреки че съкращението U в името идва от university, това не е акредитиран университет, а организация, която създава видеоклипове и онлайн курсове по най-различни обществени теми. Сред тях са и климатичните промени, които очаквано се отричат, предвид бизнес интересите на спонсорите в областта на фосилните горива.

Водещите и гостите на тези алтернативни канали винаги са версия на Давид, който се изправя срещу Голиат. Самотният професор срещу академичното общество. Независимият журналист, който сам снима документални филми, за да не му диктуват продуцентите какво да каже. Пропуска се малката подробност, че зад тези давидовци стоят огромни бизнес голиати и мисленето им „извън кутията“ е изненадващо синхронизирано с други медийни проекти на същите спонсори.

У нас посланията далеч не са така добре продуцирани, но кабелни телевизии, YouTube канали и онлайн издания, склонни да публикуват дезинформация (или да я смесват с реални факти) разчитат на по-нерафинираните варианти на именно този модел. И любими гости винаги са „смелчаците“, които „казват истината“ и които „няма да видите по големите медии“.

Какво е решението?

Дезинформацията е световен проблем. България е изправена пред някои допълнителни бариери в борбата си с него. През 2022 г. страната ни е на последно място сред членовете на Европейския съюз в Индекса за медийна грамотност, заема 91-во място в класацията за медийна свобода на „Репортери без граници“ (като дълги години беше 20 позиции назад) и e в топ 5 на държавите от ЕС с най-високо доверие в социалните мрежи според Европейския съюз за радио и телевизия.

Но има начини това да се промени. Изследователите, които се занимават с изучаване на дезинформацията, и европейските институции, които работят по темата, обновяват непрекъснато препоръките си. Основните инструменти, които те предлагат, са: ресурси и платформи за проверка на факти; обучение как да се верифицира съдържание (както за журналисти, така и за граждани); повече усилия в развиването на научна комуникация; разследваща журналистика, която изобличава дезинформацията; и съвсем не на последно място – обучения по медийна грамотност за всякакви възрасти.

Решението не е в по-голямо количество информация, а в изграждането на умения тя да се анализира и отсява качествено.

Заглавна илюстрация: © Пеню Кирацов
„Тоест“ е официален партньор за публикуването на материалите от поредицата „Хроники на инфодемията“, реализирана от АЕЖ-България съвместно с Фондация „Фридрих Науман“.

Източник

На терена на постполитиката президентът е цар

Post Syndicated from Емилия Милчева original https://toest.bg/na-terena-na-postpolitikata-prezidentut-e-tsar/

Стига да поискат, политиците в България могат да продават лиценз за това как се линчува политиката, за да се замени с постполитика. На модерния Запад за тази цел бяха нужни десетилетия, но българите се справиха бързо и направиха една хубава работа, ама българска.

Деидеологизация – няма ляво, няма дясно, и левите, и десните приемат народняшки мерки, а обещанията до едно врат в соса на популизма. И макар че всички говорят за политика и обществото е силно политизирано, избирателната активност спада, масова партия в България няма. А ако не броим „тристранката“, поставила ги на една маса с властта и работодателите, синдикатите отдавна са загубили влияние – освен като нечий инструмент.

Европейската тенденция, констатирана от изследователи, е налице – партиите все повече приличат на движения, стихийно появили се и внезапно пресъхнали. Понятието „членска маса“ е далеч от съдържимото, влагано в него през 90-те например, когато степента на политическа ангажираност беше висока. Около лидерите има по-скоро пламенни фенове, отколкото добре структурирана партия. Или зависими и лоялни привърженици заради облагите, получени от времето, когато „нашите“ са управлявали – почти като акционерно дружество.

Във времената на постполитиката печели онзи, който е не-политик по закон – президентът. Той и назначените от него правителства са деидеологизирани по презумпция, а поради естеството на избора не може да им бъде търсена каквато и да била политическа отговорност. Такава безконтролна власт, опакована като „служба на Отечеството“, особено се услажда.

Изненадаааа!

Но докато президентът Румен Радев се окопава с назначения в министерства, агенции и държавни дружества, 48-мият парламент взе че заработи. Мъчителният тридневен избор на председател, а впоследствие – и на председатели на комисии, не даваше особени надежди, но ето че съгласието е възможно. При това съвсем не крехко и на ръба, а с достатъчно стабилни мнозинства и даже нееднократно. Срещу някои парламентарни решения служебният кабинет ще се съпротивлява до последния си ден.

Сто седемдесет и пет народни представители от ГЕРБ–СДС, „Продължаваме промяната“ (ПП), ДПС, „Демократична България“ (ДБ) и „Български възход“ (БВ) гласуваха България да предостави военна помощ на Украйна. Против бяха БСП и „Възраждане“, а мандатоносителят на ПП и лидер на „Средна европейска класа“ Константин Бачийски се въздържа.

Партията на Стефан Янев се принади към останалите в пленарната зала, макар че при обсъждането в парламентарните комисии по външна политика и по отбрана не подкрепи предложението. Тактически ход на БВ, който едва ли може да я причисли към мнозинството на евро-атлантиците, но със сигурност преследва друга цел. Защо не например да се включи със свои представители в едно бъдещо правителство, в бъдещи договорки за разпределение на квоти в един или друг регулатор, във Висшия съдебен съвет и т.н.? Така подкрепяният от проруската АБВ „Български възход“ на миролюбеца Янев, съратник на президента, а изглежда – и на енергийния бос Христо Ковачки, се втурна към евро-атлантизма на „войнолюбците“ (по Румен Радев).

Дори остана там и при гласуването на още 8 нови бойни самолета от типа F-16 Block 70 – сделка за 1,3 млрд. долара, подкрепена в парламента от същата евро-атлантическа коалиция от ГЕРБ–СДС, ПП, ДПС, ДБ и (както стана ясно) БВ. Този път обаче евро-атлантизмът на „Промяната“ се пропука – от 53-ма народни представители 10 се въздържаха (сред тях Калина Константинова, Росен Костурков и Бойко Рашков), 9 отсъстваха от залата, а един (съпредседателят на партията Асен Василев) беше против. Но това не е особена изненада, тъй като Василев неколкократно е заявявал, че никакви самолети не трябва да се купуват, докато не дойдат първите F-16. „Да плащаме занапред за нещо, преди да сме получили първата поръчка, е безотговорно поведение както към българските избиратели, така и към ВВС“, заяви преди месец Василев.

А чудесата със съгласията не свършват. По предложение на ГЕРБ–СДС парламентарната Енергийна комисия с председател Делян Добрев (ГЕРБ), громител на газовите сделки на кабинета „Петков“, одобри проекторешение за диверсификация на ядреното гориво, а заедно с Добрев ръка вдигнаха и Радослав Рибарски (ПП), както и депутатите от ДПС, ДБ, БВ. Несъгласен беше само Драгомир Стойнев (БСП). Целта на решението е да бъде ускорен процесът по осигуряване на неруско ядрено гориво за АЕЦ „Козлодуй“, започнал при третото правителство на ГЕРБ и продължен в 7-месечния кабинет на ПП. На правителството се възлага да обезпечи дейността на Агенцията за ядрено регулиране за алтернативен тип гориво през 2024 г.

На почти пълно мнозинство се радва и законопроектът за енергия от морски вятър (офшорни вятърни централи в акваторията на Черно море), получил в комисия гласовете на ГЕРБ, ПП, ДПС, БСП и ДБ. Намерения за приемането му бяха изразени още в предишния парламент.

Сдружаването на ГЕРБ, БСП и ДПС около предложението за връщане на хартиената бюлетина (наедно с машинния вот) е лъжицата катран в този низ от съгласия по теми, които оттласкват България от орбитата на Кремъл. Гласуването с хартиени бюлетини улеснява купения и манипулирания вот и обединението на партиите на статуквото около връщането им не предвещава нищо добро. Със 125 гласа „за“ срещу 100 „против“ на първо четене народните представители от ГЕРБ–СДС, ДПС и БСП върнаха хартиената бюлетина в играта с мотиви, че така се връщат доверието и честността в изборния процес.

Отпор

В решението за оръжието за Украйна се дава месец на служебното правителство да докладва на парламента какво оборудване може да предостави „съобразно българските възможности и гарантирайки сигурността и защитата на населението“ – тоест без да бъде отслабен отбранителният ни капацитет. Кабинетът се задължава да проведе разговори със страни членки на НАТО, за да осигури модерно оборудване.

Коментарът на служебния военен министър Димитър Стоянов беше, че предложението на Министерството на отбраната ще бъде „крайно консервативно“ и зенитноракетни ПВО комплекси, както и самолети Су-25 и МиГ-29 няма да бъдат предоставяни. Което до известна степен обезценява парламентарното решение, тъй като Украйна има най-голяма нужда тъкмо от такава техника. Въпреки това международните агенции отчетоха външнополитическия ефект на решението като добър сигнал от България. Техническото му изпълнение обаче може да го изпразни от съдържание. Първата изпратена от София към Киев „военнологистична“ помощ беше смехотворна – наред с облекла, в нея имаше походни легла, палатки и… чаршафи.

По отношение на ядреното гориво, от което България е 100% зависима от Русия, служебното правителство също се разбърза. Президентското управление се кани да обяви процедура за избор на доставчик на ядрено гориво за АЕЦ „Козлодуй“. Така се отваря вратата за френската компания „Фраматом“, която в съвместно предприятие с руската ТВЕЛ произвежда свежо ядрено гориво – аналог на използваното в АЕЦ „Козлодуй“. Другият участник е американската „Уестингхаус“, с която по време на третото правителство на Бойко Борисов бе подписано споразумение за внедряване на алтернативно гориво в V блок на атомната централа.

Намеренията на ръководство на АЕЦ бяха да обяви търг в средата на 2024 г., но служебното правителство смени мениджмънта и дори наложи нови правила – за първи път търгът ще се прави от БЕХ, а не от АЕЦ „Козлодуй“. Преди това обаче четвъртото служебно правителство на Радев отмени решение от 13 юли т.г. на кабинета „Петков“, което гласеше:

Процесът по диверсификация на свежо ядрено гориво да се осъществи чрез доставки и услуги от лица, които пряко и/или непряко не са свързани с Руската федерация, с цел постигане на диверсификационния резултат и подсигуряване на непрекъснатост на доставките за стратегическия енергиен обект, като при изпълнението се вземат предвид европейските политики и се цели намаляване зависимостта на българската енергетика от един доставчик и/или от доставчици, пряко и/или непряко свързани с политически решения на Руската федерация. 

Сега на опитите на служебния кабинет да запази под друга форма доставките на руско ядрено гориво се противопоставя парламентарно мнозинство – с приетото от Енергийната комисия решение. Ако то бъде подкрепено и в пленарната зала, отворената към „Фраматом“ врата ще се затвори. За френската компания ще е трудно и ще изгуби време да смени руските доставки с алтернативни. Дотогава бивш и настоящ енергиен министър ще се обвиняват взаимно – настоящият Румен Христов твърди, че предшественикът му Александър Николов работи за „Уестингхаус“ и че така се нарушава конкуренцията. Николов пък казва, че ако се допусне „Фраматом“, няма диверсификация.

Служебното правителство се зае да осигури и още печалби на най-голямата руска частна компания „Лукойл“ с решението си да отмени забраната за износ на горива от рафинерията в Бургас, приета от правителството на Кирил Петков. Тя трябва да влезе в сила на 5 декември т.г. В момента бургаската рафинерия изнася над половината от произведените горива и други нефтопродукти. Така след десетилетие на неплащане на данъци и издействаната от кабинета „Петков“ дерогация за България да продължи да получава руски петрол до 2024 г., и служебното управление се опитва да уреди нови облекчения. Европейската комисия обаче предупреди, че това не бива да се допуска, и ако наруши забраната, България е заплашена от наказателна процедура.

Страх

Противоборствата между мнозинствата в 48-мия парламент и служебното правителство ще се изострят. Независимо от решенията на Народното събрание, кабинетът може да протака и да провежда своя (президентска) политика – и никакви последици няма да произтекат от действията им. Отказът на служебното правителство да внесе бюджет за 2023 г. обаче е основателен – бюджетът е израз на политики и нека партиите не бягат от поемането на отговорност. Така, ако не искат да се изправят пред зимно недоволство от бизнес и граждани, политическите сили ще трябва да намерят начин да сформират кабинет. А зимният гняв няма да подмине и площада между Президентството и Министерския съвет.

Сериозни основания да се сформира правителство са налице – страхът е едното, другото са парите. Страх, че стадото избиратели може да се превърне в беснееща тълпа и последиците са непредвидими. Всички партии ще изгубят и отново ще спечели президентът. По Плана за възстановяване и устойчивост пък се очакват на първо време 1,2 млрд. евро, а след това – и вторият транш от над 740 млн. евро. Дали кабинетът ще е на база „eвро-атлантическа коалиция“, или на база „хартиена бюлетина“ – ще се договаря заедно със съдбата на главния прокурор.

Време е българските партии най-сетне да започнат да произвеждат политика. Иначе властта е на Царя.

Заглавна снимка: parliament.bg

Източник

По буквите: Мария Липискова, Зейди Смит, Роман Кисьов

Post Syndicated from Зорница Христова original https://toest.bg/po-bukvite-lipiskova-smith-kisyov/

В емблематичната си колонка, започната още през 2008 г. във в-к „Култура“, Марин Бодаков ни представяше нови литературни заглавия и питаше с какво точно тези книги ни променят. Вярваме, че е важно тази рубрика да продължи. От човек до човек, с нова книга в ръка.

„Пристанището на часовника“ от Мария Липискова

корица и оформление Капка Кънева, София: изд. „Същности“, 2022

В стихотворенията на Мария Липискова има една жена, която стои на ръба на живота, като град на ръба на Космоса. До нея се простира празнота и тя общува с нея. И общувайки с празнотата, общува със себе си.

Успява най-сетне да чуе това, което денят, другите, думите са заглушили.

Сега тя заглушава думите. Потапя се в мълчанието като в лечебна вода, последна вода.

Чуйте:

… тя отваря устата си беззвучно,
като прозрачна риба, оставена на повърхността
да диша. Почти не си спомня тези места…

Чуйте:

… Пак ще си припомня имената им ще гледа как изчезват като големи сиви облаци
Ще преброи големите дупки появили се в думите ѝ празнините
В които потъват цели кораби и години…

Чуйте:

… а зад гърба ѝ
някакво мълчаливо и тъмно животно
което прекосява стаята

Денем тя говори човешки. Нощем стълбовете и жиците са изтръгнати, връзката е изгубена, Азът е глухоням.

И тогава се събуждат други езици, думите се носят като огнени кълба. Тогава се чува пеенето на планетите. Половината от тези стихотворения се случват в съня, в онова пространство, което също е на ръба на живота, но парадоксално е изпълнено с живот. Само че вътрешен. Разпуква се времето, разпуква се детството, неочаквано посивяло (сивото впрочем се стеле над тези стихотворения ту като коси, ту като мъгла, ту просто като плъзнал цвят). И думите, които остават, са единствено вътрешни.

Ето го най-поразителното според мен изречение в тази стихосбирка:

тя не разбираше други думи
освен тези които изразяваха емоции

Каква е жената, която обитава тези стихотворения? Всички белези на принадлежност към тази или онази част от обществото са повехнали или изтръгнати. Дори това, че става въпрос за жена, а не за мъж, е някак второстепенно, защото за старостта и тишината това са подробности. Както е подробност, че в стихотворенията на Далчев говорещият е мъж.

Впрочем и тук навикът да проектираш себе си в „тя“ избледнява на два пъти – в описанието на човека, който стои накрая и чете на глас (неизбежно си представям човека от гравюрата на Фламарион, проврял глава през небесния свод), и в „Детство“, където спящият протагонист е положен на бръснарския стол и слуша звуците от детството си, силни като гласове от радио. И в двата случая не става въпрос за герой мъж, а по-скоро за връщане към нещо по-основно и по-важно, което не бива да бъде разсейвано с подробности. Темата за принадлежността към тази или онази група просто отпада, когато най-сетне трябва да принадлежиш на себе си.

„Време за суинг“ от Зейди Смит

превод Невена Дишлиева-Кръстева, оформление Люба Халева, Пловдив: ИК „Жанет 45“, 2022

„Време за суинг“ на Зейди Смит е книга, в която темите на принадлежността – раса, класа, пол – отекват като непрестанен ритъм, като тракане на обувки за степ. Ето как ги резюмира Клер Месуд в статията си „Танцьорката и танцът“ за The New York Review of Books:

Петият роман на Смит повдига много теми – танцът като идея и изкуство; приятелството и съперничеството между момичетата и жените; майки, дъщери, майчинство; расова и културна идентичност; творчество и успех; амбиция; любов. И докосва още много въпроси – съвременните форми на либералния западен културен империализъм; ефектът на социалните медии; връщането към религията в развиващите се страни (в този случай към исляма в Гамбия); културата на „знаменитостите“ и нейните ефекти; емиграционната криза в Европа.

Получава се нещо като оркестрация на шумовете и емоциите от разговорите в големия град, разговори, в които си потопен и не можеш да не участваш; героинята е дете (в едната сюжетна нишка) и млада жена (в другата); пред нея не се простира заглушаващата мъгла на старостта. И все пак Зейди Смит слуша внимателно думите, назоваващи емоции, слуша ги като музика, около която се случва цялата хореография на сюжета, и затова романът ѝ не е придатка към темите, а е пълен с живот.

Впрочем големият разказ на социалното (споменатите раса, класа и пр.) е погледнат отстрани, с любов и ирония, като нещо, което движи майката на героинята, но не и самата нея. Поне не по същия начин. Ефектът на „правилността“ буди смях и признателност – при това едновременно. И разбира се, те кара да насочиш този смях към себе си.

Майката на героинята има добър вкус – а детето ѝ преживява това като пълна трагедия, защото копнее за крещящите секси воланчета по рокличката на своята приятелка, съперница и алтер его Трейси; здравословните рецепти винаги завършват с фиаско, докато майката на Трейси тръгва с идеята да приготви полуфабрикат и той задължително ѝ се получава вкусно. Който е копнял за кичозна ученическа раница с анимационни герои, знае за какво иде реч.

Същата „правилна“ майка се записва да следва социология и разглежда хората неизменно като част от някаква колективна същност, от колективна съдба. Опитва се да накара дъщеря си да види тази по-голяма фабула – и успява, макар да плаща цената за това със своята глухота за другото, частното, човешкото. И въпреки това нейният подход, нейната правота изобщо не е отменена – напротив, тя е важна част от сложността на живота… макар да се опитва да я опрости.

Заглавието на романа идва от един филм с Фред Астер – „Време за суинг“. Специално си пуснах клипа, за който става въпрос в края на първа глава. Там Астер танцува безобразно добре (това, което забелязва героинята) с почернено със сажди лице (това, което забелязва нейният приятел). Тоест танцът е едновременно шедьовър и расова обида. В съвременния свят като че ли много трудно приемаме, че нещо може да бъде и двете, и или изискваме някой да бъде зачеркнат, или пък настояваме, че талантът извинява всичко (вж. последните спорове за Неруда). Романът на Зейди Смит успява да види и двете – и затова усещането е не за есе или социологически коментар, а за танц.

„Светът на думите“ от Роман Кисьов

оформление авторът, София: изд. „Ерго“, 2022

В стихосбирката на Роман Кисьов несъвпадането със себе си не е мъчителен парадокс, а състояние, което носи радост, усещане за богатство и свобода.

Стихът е стопкадър от карнавал (по Бахтин), в който горното и долното постоянно се преобръщат; стопкадърът е размазан, танцът е оставил следа, човекът е едновременно и двете – и спокойно приема парадокса за своя самоличност. Гений бездарник, хуманист диктатор, безног атлет (малко като плоскостъпата танцьорка у Зейди Смит). Има нещо пикаресково в този поглед към света, някакъв отглас от героя на Вийон, който умира от жажда край извора, гори и трака със зъби от студ, а своята мощ усеща най-добре в безсилието.

Героят на Кисьов пък усеща безсилието си да определи своята идентичност – и избира да приеме това безсилие като движеща сила, като мощ, която го тласка в движение. В изгнанието (включително и от себе си), което му дава свобода. Обратното на това изгнание – постоянното съвпадане със себе си – води до задушаване, до клетата съдба на един неслучен Одисей, който никога не е срещал циклопи и сирени, защото така и не е напуснал Итака, така и не е напуснал себе си.

В същото време изгнанието е пътешествие с осезаемо загатната чудовищност, доколкото етическото съображение в него е изпреварено от естетическото (деца подритват някаква загубена планета, чудодейни птици снасят палати и планини от злато) – но тази чудовищност е чудовищността на мита, на човешкото алтер его, тя е част от същото преобръщане. Тя също е проекция на човешкото, свързана е с него, както змеят е свързан със свети Георги, както Тиамат е свързана с Мардук. Тя е негова сянка.

Почти всичко в тази стихосбирка живее сдвоено със сянката си – като смъртта, която расте в човека, става бебе, дете, ученик; като думата, която се опитваш да затвориш в идея и значение, а се оказва, че тя те е затворила.

И все пак тази игра на светлини и сенки не е симетрична; интересното в нея са тъкмо изненадващите разминавания (погледнете отново клипа на Фред Астер – там, където сенките спират да повтарят движенията му, той ги гледа озадачено, а после сам панически ги имитира). В едно от най-загадъчните стихотворения в тази книга душата описва човека, чието тяло обитава, но далеч не съвпада с него. Когато той говори, тя мълчи. И когато той пише, тя го редактира. Така човекът се превръща в Платонова сянка на душата си – и е въпрос на време светлината да заглуши думите, а той да застане на ръба на света и да послуша как изчезват сенките.

Заглавно изображение: Колаж от кориците на книгите и снимка на Annie Spratt / Unsplash
Активните дарители на „Тоест“ получават постоянна отстъпка в размер на 20% от коричната цена на всички заглавия от каталога на „Жанет 45“ и „Ерго“, както и на няколко други български издателства в рамките на партньорската програма Читателски клуб „Тоест“. За повече информация прочетете на toest.bg/club.

Източник

Optimize your modern data architecture for sustainability: Part 1 – data ingestion and data lake

Post Syndicated from Sam Mokhtari original https://aws.amazon.com/blogs/architecture/optimize-your-modern-data-architecture-for-sustainability-part-1-data-ingestion-and-data-lake/

The modern data architecture on AWS focuses on integrating a data lake and purpose-built data services to efficiently build analytics workloads, which provide speed and agility at scale. Using the right service for the right purpose not only provides performance gains, but facilitates the right utilization of resources. Review Modern Data Analytics Reference Architecture on AWS, see Figure 1.

In this series of two blog posts, we will cover guidance from the Sustainability Pillar of the AWS Well-Architected Framework on optimizing your modern data architecture for sustainability. Sustainability in the cloud is an ongoing effort focused primarily on energy reduction and efficiency across all components of a workload. This will achieve the maximum benefit from the resources provisioned and minimize the total resources required.

Modern data architecture includes five pillars or capabilities: 1) data ingestion, 2) data lake, 3) unified data governance, 4) data movement, and 5) purpose-built analytics. In the first part of this blog series, we will focus on the data ingestion and data lake pillars of modern data architecture. We’ll discuss tips and best practices that can help you minimize resources and improve utilization.

Modern Data Analytics Reference Architecture on AWS

Figure 1. Modern Data Analytics Reference Architecture on AWS

1. Data ingestion

The data ingestion process in modern data architecture can be broadly divided into two main categories: batch, and real-time ingestion modes.

To improve the data ingestion process, see the following best practices:

Avoid unnecessary data ingestion

Work backwards from your business needs and establish the right datasets you’ll need. Evaluate if you can avoid ingesting data from source systems by using existing publicly available datasets in AWS Data Exchange or Open Data on AWS. Using these cleaned and curated datasets will help you to avoid duplicating the compute and storage resources needed to ingest this data.

Reduce the size of data before ingestion

When you design your data ingestion pipelines, use strategies such as compression, filtering, and aggregation to reduce the size of ingested data. This will permit smaller data sizes to be transferred over network and stored in the data lake.

To extract and ingest data from data sources such as databases, use change data capture (CDC) or date range strategies instead of full-extract ingestion. Use AWS Database Migration Service (DMS) transformation rules to selectively include and exclude the tables (from schema) and columns (from wide tables, for example) for ingestion.

Consider event-driven serverless data ingestion

Adopt an event-driven serverless architecture for your data ingestion so it only provisions resources when work needs to be done. For example, when you use AWS Glue jobs and AWS Step Functions for data ingestion and pre-processing, you pass the responsibility and work of infrastructure optimization to AWS.

2. Data lake

Amazon Simple Storage Service (S3) is an object storage service which customers use to store any type of data for different use cases as a foundation for a data lake. To optimize data lakes on Amazon S3, follow these best practices:

Understand data characteristics

Understand the characteristics, requirements, and access patterns of your workload data in order to optimally choose the right storage tier. You can classify your data into categories shown in Figure 2, based on their key characteristics.

Data Characteristics

Figure 2. Data Characteristics

Adopt sustainable storage options

Based on your workload data characteristics, use the appropriate storage tier to reduce the environmental impact of your workload, as shown in Figure 3.

Storage tiering on Amazon S3

Figure 3. Storage tiering on Amazon S3

Implement data lifecycle policies aligned with your sustainability goals

Based on your data classification information, you can move data to more energy-efficient storage or safely delete it. Manage the lifecycle of all your data automatically using Amazon S3 Lifecycle policies.

Amazon S3 Storage Lens delivers visibility into storage usage, activity trends, and even makes recommendations for improvements. This information can be used to lower the environmental impact of storing information on S3.

Select efficient file formats and compression algorithms

Use efficient file formats such as Parquet, where a columnar format provides opportunities for flexible compression options and encoding schemes. Parquet also enables more efficient aggregation queries, as you can skip over the non-relevant data. Using an efficient way of storage and accessing data is translated into higher performance with fewer resources.

Compress your data to reduce the storage size. Remember, you will need to trade off compression level (storage saved on disk) against the compute effort required to compress and decompress. Choosing the right compression algorithm can be beneficial as well. For instance, ZStandard (zstd) provides a better compression ratio compared with LZ4 or GZip.

Use data partitioning and bucketing

Partitioning and bucketing divides your data and keeps related data together. This can help reduce the amount of data scanned per query, which means less compute resources needed to service the workload.

Track and assess the improvement for environmental sustainability

The best way for customers to evaluate success in optimizing their workloads for sustainability is to use proxy measures and unit of work KPIs. For storage, this is GB per transaction, and for compute, it would be vCPU minutes per transaction. To use proxy measures to optimize workloads for energy efficiency, read Sustainability Well-Architected Lab on Turning the Cost and Usage Report into Efficiency Reports.

In Table 1, we have listed certain metrics to use as a proxy metric to measure specific improvements. These fall under each pillar of modern data architecture covered in this post. This is not an exhaustive list, you could use numerous other metrics to spot inefficiencies. Remember, just tracking one metric may not explain the impact on sustainability. Use an analytical exercise of combining the metric with data, type of attributes, type of workload, and other characteristics.

Pillar Metrics
Data ingestion
Data lake

Table 1. Metrics for the Modern data architecture pillars

Conclusion

In this post, we have provided guidance and best practices to help reduce the environmental impact of the data ingestion and data lake pillars of modern data architecture.

In the next post, we will cover best practices for sustainability for the unified governance, data movement, and purpose-built analytics and insights pillars.

Further reading:

The collective thoughts of the interwebz