Registration is now
open for the 2026 Linux Plumbers Conference, to be held October 5
to 7 in Prague, Czechia. Tickets to this event tend to sell out
quickly, so interested attendees probably should not procrastinate.
AWS GlueData Catalog view is a multi-dialect view that supports querying from multiple SQL query engines, such as Amazon Athena, Amazon Redshift Spectrum, Apache Spark in Amazon EMR and AWS Glue. You can create a Data Catalog view in one account, using an AWS Identity and Access Management (IAM) definer role in the same or different account and use AWS Lake Formation to share the view across multiple accounts. The definer role has the required full SELECT on the base tables to create the view and share it with other users for querying. The Data Catalog assumes the definer role and manages access of the base tables when the view is queried, thus allowing to share a subset of data without sharing the underlying base tables.
AWS Glue now adds AWS SDK support for creating and updating the ATHENA dialect of Glue views. With this addition, you can now create ATHENA and SPARK dialects of Glue views simultaneously, using a cross account IAM definer role. This feature enhances the automation to create and update Glue views, like that of Data Catalog tables. In our earlier blog Create AWS Glue Data Catalog views using cross-account definer roles, we had introduced IAM definer roles in a cross-account use case to create Data Catalog views with SPARK dialects using the APIs – CreateTable() and UpdateTable() – while creating and adding ATHENA dialects using Athena query editor. As a continuation to it, this post shows you how to use the Catalog objects API CreateTable() to programmatically create ATHENA and SPARK dialects using cross-account IAM definer roles, and how to add the ATHENA dialect programmatically for the views that were created earlier with only SPARK dialect.
Cross account definer roles enable enterprise data mesh architectures where multiple accounts are interconnected in a central governance and multiple producers and consumers. The central governance account hosts the database, tables and permissions, while the producer accounts maintain CI/CD pipelines to create and manage those data assets. Having the definer role in producer accounts allows those CI/CD pipelines to be fully managed by IAM roles in the individual accounts.
Key points on creating multi-dialect views using cross-account definer roles
ATHENA dialects are validated and asynchronously created. Hence, a cross-account Glue connection is required for validation for every producer account-central governance account pair. This is a one-time setup.
SPARK dialects are not validated. Hence SPARK dialect’s create syntax requires SubObjects list of the base tables and StorageDescriptor fields for the columns of the view.
Though queries on cross account views can be run using database resource link names, the view definition SQL query for creating the view requires the original database and base table names from the central governance account.
If a view has SPARK and ATHENA dialects available, we recommend updating both the dialects of the view simultaneously using update_table() API/SDK, for any changes in the SQL definition of the view or the base table. This will keep both the dialects queryable.
Creating and updating both SPARK and ATHENA dialects using cross account definer role is supported using AWS CloudFormation.
The Data Catalog view that can be created using cross account IAM definer roles are available in SPARK and ATHENA dialects and currently not supported for Redshift Spectrum dialect.
Prerequisites
We use the same setup used in Create AWS Glue Data Catalog views using cross-account definer roles for the sample database, tables, definer role, resource link, IAM and Lake Formation permissions on those resources and principals between the two AWS accounts. Summarizing the requirements as below.
The setup includes a central governance account with Data Catalog database bankdata_icebergdb and two tables transaction_table1 and transaction_table2, a producer account with a Data-Analyst role used as view definer role.
Lake Formation permissions on the central account’s database and tables are granted to the producer account Data-Analyst role as per the earlier blog. The definer role in producer account should have database DESCRIBE and CREATE_TABLE permissions, table SELECT and DESCRIBE permission on all columns and rows of the base tables. The IAM permissions required on the definer role are detailed in Prerequisites for creating views. Similarly, follow the earlier blog to create resource link for the shared database and grant Lake Formation permissions on the resource link to the Data-Analyst
An Athena data source named centraladmin in the producer account, pointing to the Data Catalog of the central governance account.
Creating ATHENA and SPARK dialects at the same time
Creating both ATHENA and SPARK dialects of a Glue catalog view simultaneously is now supported by the AWS SDK. In the producer account, create a new Glue connection, required for the Athena dialect validation. This is a prerequisite for creating the ATHENA dialect of the Glue catalog view using cross account definer role. Then we create a Glue view with both dialects.
Sign in to the producer account as the Lake Formation admin role, or any role with permission to create AWS Glue connections.
Note: If you are using Athena for the first time in your account or using Primary workgroup, setup the query results location bucket using Specify a query result location.
Sign out as the Lake Formation admin and sign back in to the producer account as the definer IAM role, Data-Analyst.
Create an AWS Glue view using the create-table CLI command and JSON file, or using the AWS SDK for Python (Boto3) script.
The content of create_multipledialects.json is as follows.
 {
   "DatabaseName": "rl_bank_iceberg",
   "TableInput": {
     "Name": "view_2dialects_2basetables_fromcli",
     "StorageDescriptor": {
       "Columns": [
         {
           "Name": "transaction_id",
           "Type": "string"
         },
         {
           "Name": "transaction_type",
           "Type": "string"
         },
         {
           "Name": "transaction_amount",
           "Type": "double"
         },
         {
           "Name": "transaction_location",
           "Type": "string"
         },
         {
           "Name": "transaction_date",
           "Type": "date"
         }
     },
     "ViewDefinition": {
       "SubObjects": [
         "arn:aws:glue:us-west-2:<central-account-id>:table/bankdata_icebergdb/transaction_table1",
         "arn:aws:glue:us-west-2:<central-account-id>:table/bankdata_icebergdb/transaction_table2"
        ],
       "IsProtected": true,
       "Representations": [
         {
           "Dialect": "SPARK",
           "DialectVersion": "1.0",
           "ViewOriginalText": "SELECT a.transaction_id, a.transaction_type, a.transaction_amount, b.transaction_location, b.transaction_date FROM bankdata_icebergdb.transaction_table1 a RIGHT JOIN bankdata_icebergdb.transaction_table2 b ON a.transaction_id = b.transaction_id",
           "ViewExpandedText": "SELECT a.transaction_id, a.transaction_type, a.transaction_amount, b.transaction_location, b.transaction_date FROM bankdata_icebergdb.transaction_table1 a RIGHT JOIN bankdata_icebergdb.transaction_table2 b ON a.transaction_id = b.transaction_id"
         },
         {
            "Dialect": "ATHENA",
            "DialectVersion": "3",
            "ViewOriginalText": "SELECT a.transaction_id, a.transaction_type, a.transaction_amount, b.transaction_location, b.transaction_date FROM bankdata_icebergdb.transaction_table1 a RIGHT JOIN bankdata_icebergdb.transaction_table2 b ON a.transaction_id = b.transaction_id",
            "ValidationConnection": "glue-view-validation-connection"
         }
       ]
     }
   }
}
Notes about fields in the above CLI input JSON (applies to all SDK):
The definer is by default the API caller, but a Definer field can be set to explicitly specify a different IAM role.
In the ViewDefinition, database qualifiers are required for SPARK dialect. That is, the SQL definition provided for ViewOriginalText and ViewExpandedText should be in <source_database_name>.<source_table_name> format.
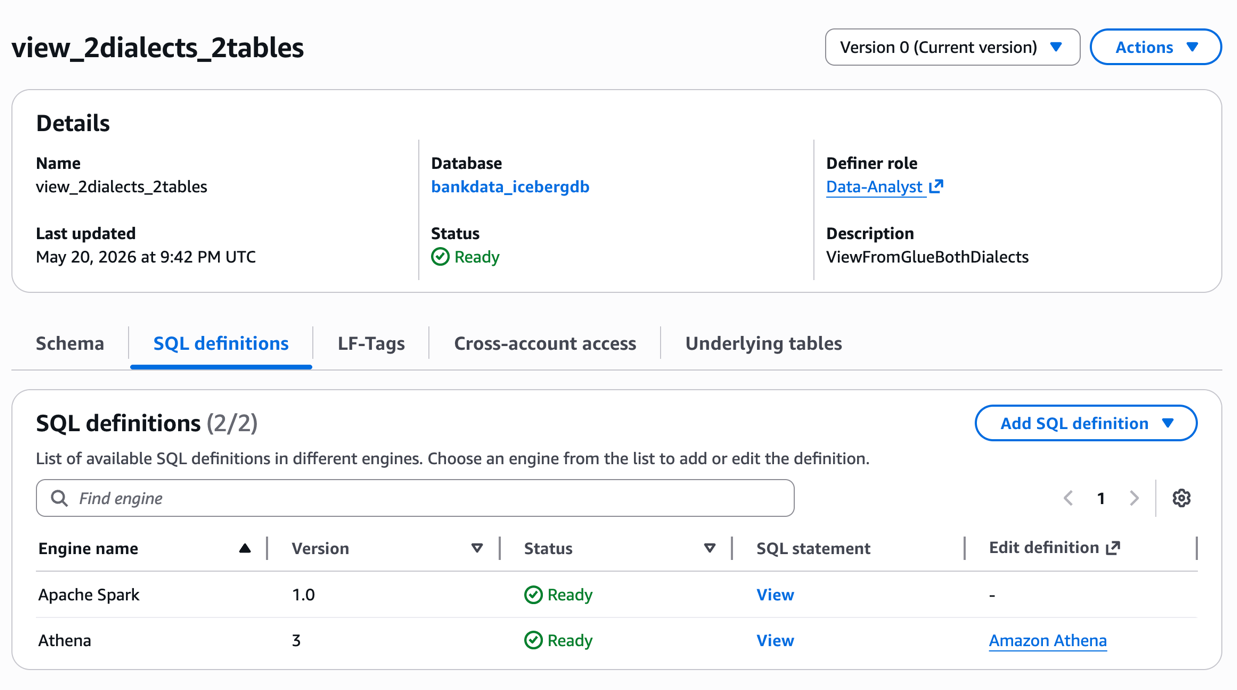
After the view is created, you can inspect the details on the Lake Formation console. The SQL definitions show both ATHENA and SPARK as shown in the following screenshot.
If your view creation fails for any of the dialects, you can use the AWS Glue get-table CLI command with --include-status-details to see what the error is and rectify it.
The PySpark script for creating a view with ATHENA and SPARK dialects are provided below. Download and edit the Pyspark script with your bucket name, producer and central account ids, region and relevant Glue resource names: bdb_5773_createview_bothdialects.py
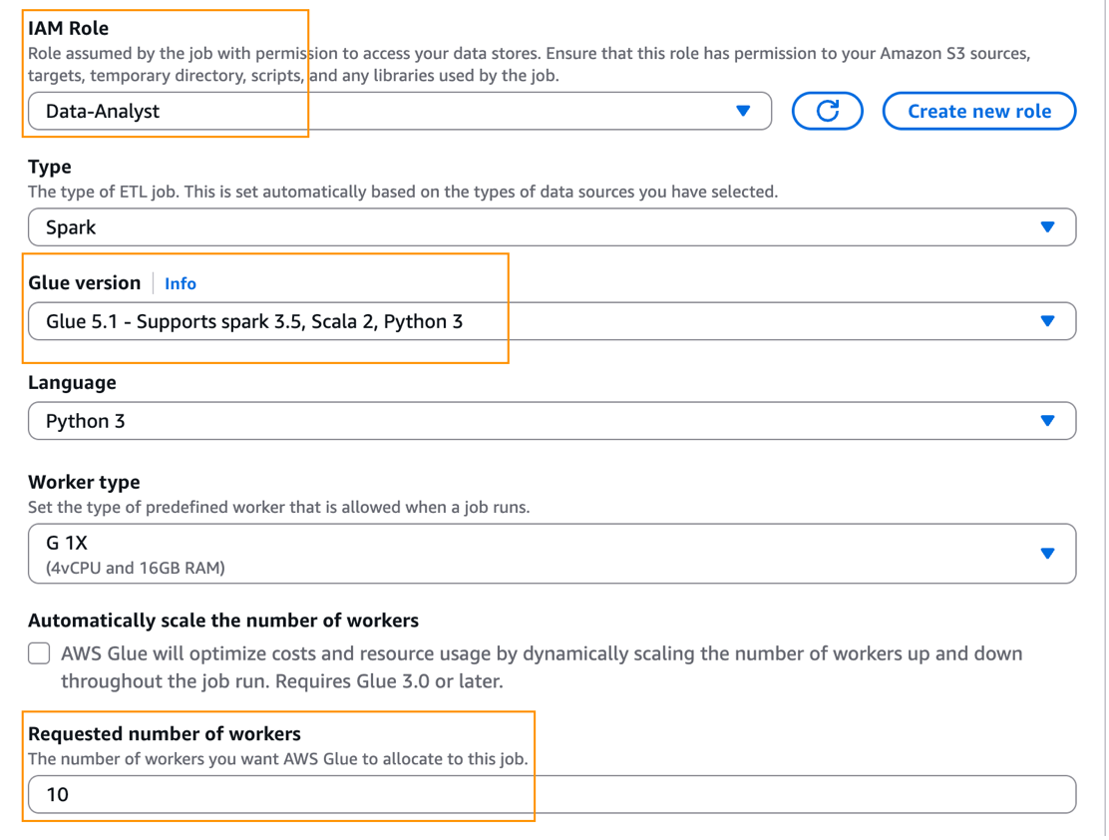
Provide the following settings to run the script in your Glue Studio. For details on running a Spark job in Glue, refer Working with Spark jobs in AWS Glue.
Choose Data-Analyst as the job execution IAM role.
Choose Glue 5.1 for Glue version.
For the Requested number of workers, provide >=4. This is an FGAC Spark driver requirement, which is needed for Glue catalog views. Below screenshot shows these settings.
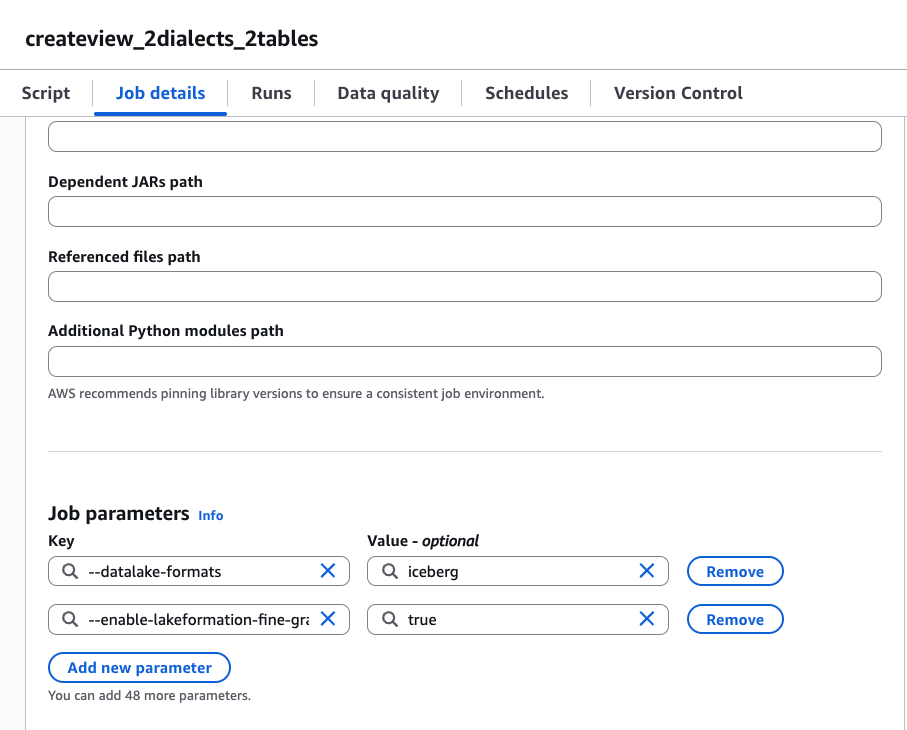
Add the following 2 properties as additional job parameters. A screenshot is shown for reference.
Adding ATHENA dialect using SDK to an existing AWS Glue view
You can update an existing AWS Glue view that was created with the SPARK dialect and add the ATHENA dialect using the SDK. The following example uses the update-table CLI command.
The content of add-athena-dialect.json is as follows.
{
    "DatabaseName": "rl_bank_iceberg",
    "ViewUpdateAction": "ADD",
    "TableInput": {
        "Name": "view_sparkfirst_athenanext",
        "ViewDefinition": {
            "Representations": [
                {
                    "Dialect": "ATHENA",
                    "DialectVersion": "3",
                    "ViewOriginalText": "SELECT a.transaction_id, a.transaction_type, a.transaction_amount, b.transaction_location, b.transaction_date FROM bankdata_icebergdb.transaction_table1 a RIGHT JOIN bankdata_icebergdb.transaction_table2 b ON a.transaction_id = b.transaction_id",
                    "ValidationConnection": "glue-view-validation-connection"
                }
            ]
        }
    }
}
Verify the added dialect on the view by reviewing the SQL definitions of the view in Lake Formation console or using GetTable(). If you want to edit the SQL definition or change the base tables of an existing view that has both SPARK and ATHENA dialects, you can do so using the update_table API (using SDK or CLI), with "ViewUpdateAction": “REPLACE” and provide both the dialect definition under ViewDefinition.
You can run queries on the view from the producer account as Data-Analyst. The view can be shared using Lake Formation Tags or named method, just like sharing tables, to additional consumer accounts from the central governance account. The consumer accounts will create a resource link and query the views.
Cleanup
To avoid incurring ongoing costs, clean up the resources you used for this post:
Revoke the Lake Formation permissions granted to the Data-Analyst role and the producer account from the central governance account.
Drop the Data Catalog tables, views, and the database.
Delete the Athena query results from your Amazon Simple Storage Service (Amazon S3) bucket.
Delete the Data-Analyst role from IAM.
Delete the AWS Glue connection and the Athena data source.
Delete the AWS Glue job, if you tried the Python script as an AWS Glue job.
Conclusion
In this post, I demonstrated how to use cross-account IAM definer roles with AWS Glue Data Catalog views, how to create and update ATHENA and SPARK dialects using the Data Catalog CreateTable() and UpdateTable() APIs. The multi-dialect Data Catalog views allow sharing a subset of data from different tables using Lake Formation permissions, including LF-Tags based access control. The cross-account definer roles support multi-account data mesh architectures so that the producer IAM roles can run the CI/CD pipelines in its account. We encourage you to try the feature and share your feedback in the comments.
Acknowledgements: I would like to thank all the team members who worked to add AWS SDK support for creating ATHENA and SPARK dialects together for AWS Glue views – Daniil Arushanov, Wyatt Hawes, Yuxi Wu, Santhosh Padmanabhan and Karthik Devaraj.
Fedora contributor Simon de Vlieger has published a blog
post with a walkthrough of how the project turns source code and
packages into the final release that users install on their systems.
It follows the a package from a packager’s git push to a composed
release: ISOs, cloud images, container images, and OSTree
deployments.
The walkthrough describes how the Fedora ‘sausage’ is created as of
Fedora 45, things change all the time; I hope to have time to update
this document every cycle or every few cycles of Fedora releases so
there’s both history and people can find up to date information.
Daniel Borkmann led a session at the 2026
Linux Filesystem, Memory-Management,
and BPF Summit about the progress that has been made with netkit, the subsystem
that allows virtual machines (VMs) running on Linux to perform networking efficiently.
When that did not fill the full time, he went on to discuss his idea for
using BPF to live-patch user-space applications. While netkit is making
progress, and can now support zero-copy receipt of packets into a VM in a
network namespace, the idea of using BPF for patching user-space programs
remains entirely speculative.
Providing a public, open way to browse the anonymous, aggregated
device data we collect was always part of the plan, and this preview
is our first step toward it.
You can already use it to search and filter devices to see
aggregated community insights, starting with a deliberately focused
set of specifics, such as whether a device requires an internet
connection, and which protocols and integrations it works with. We’ve
kept that initial scope narrow on purpose, giving us a solid
foundation we can build on together with you, our community, as the
database grows.
Президентът Тръмп даде сигнал, че е готов да задълбочи войната в Иран. Само преди месец писахме, че примирието между двете държави е подписано – днес това примирие не означава нищо, а още утре този бюлетин може би няма да е актуален. Политическото говорене на едро, заплахите, цинизмът и безсмислието са се превърнали в ежедневие. Министърът на войната Пийт Хегсет поиска 70 млрд. долара спешно военно финансиране след първите пет месеца от войната.
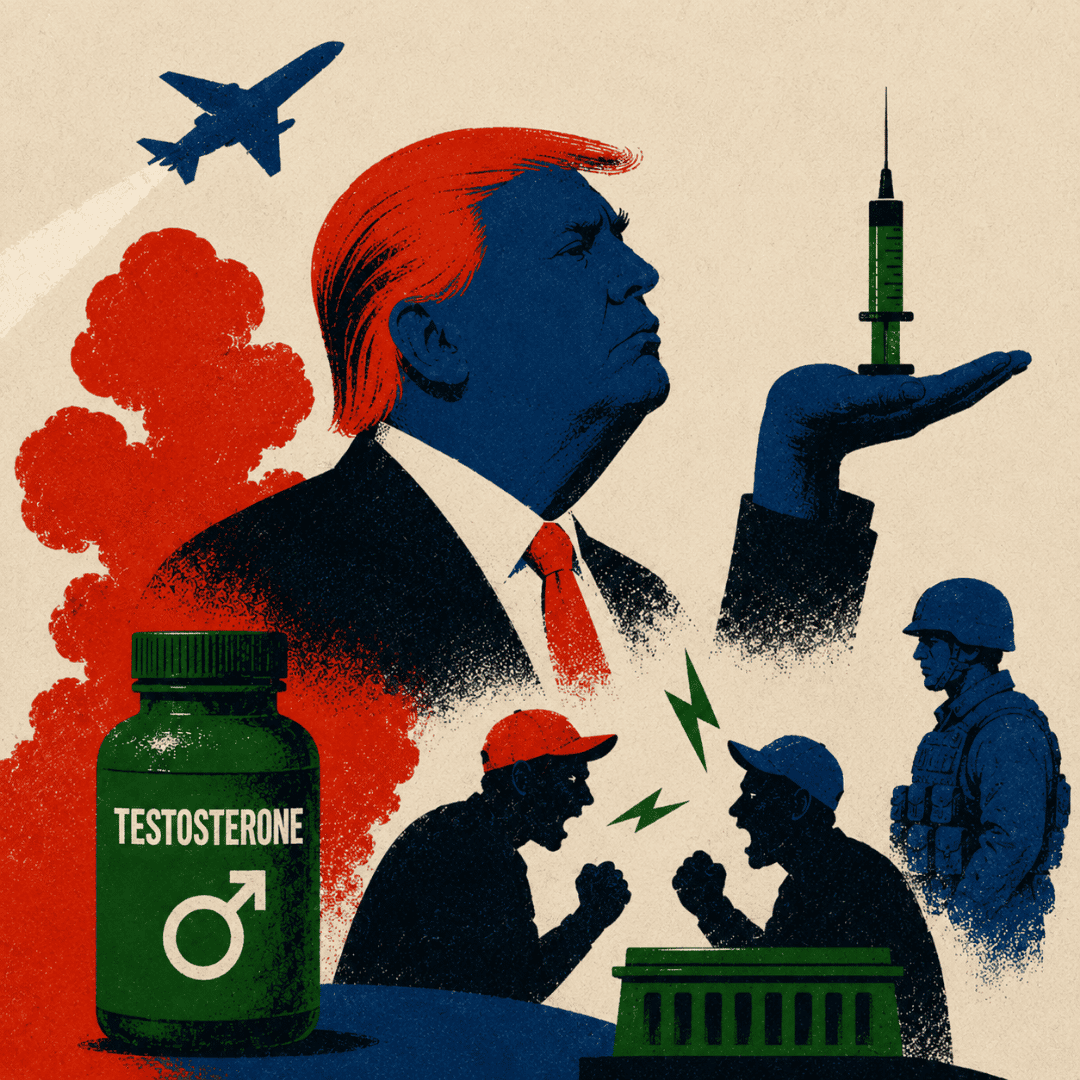
Хегсет обяви, че военните ще трябва да минават задължително изследване на нивата на тестостерон след 30-годишна възраст. Няма определени рамки какви нива на тестостерон ще се смятат за ниски, за да се изисква лечение – обичайно всяка лаборатория може да определя нива според методите си на изследване, което в допълнение се влияе и от препоръките на лекуващия лекар.
Решението на Хегсет идва в разгара на „тестостеронова мания“ в САЩ: рецептите за заместителна терапия с хормона са достигнали 12 млн. през 2025 г., ръст от 154% от 2020 г. насам. Онлайн клиники и търговци продават тестостерон като утвърдено лечение за мъже. Експерти обаче предупреждават, че по-високите нива на тестостерон нямат нищо общо с определени качества, които могат да направят един мъж „по-мъжествен“. Ако нивата на тестостерон по различни здравословни причини спаднат много под обичайните норми, последствията могат да бъдат умора, ниско либидо или загуба на мускулна маса, но при здрави мъже нивата на хормона нямат нищо общо с физическата сила.
Мъж с ниво на тестостерон около 700 нанограма на децилитър може да е точно толкова силен, колкото и мъж с 300 нанограма на децилитър. Нещо повече – нивата на тестостерон не са константа, а се променят в различните части на деня и според сезона, както и под влияние на други фактори. Терапията с тестостерон крие рискове: употребата на добавки може да понижи естествената способност на тялото да произвежда хормона, свивайки тестисите и намалявайки производството на сперматозоиди. Други ефекти са акне, оплешивяване и дори уголемяване на гърдите вследствие на преобразуването на част от приетия тестостерон в естроген.
Тестостеронът няма общо и с нивата на агресивност. Изследвания показват, че ако един мъж проявява агресия, причината обикновено е социална, а не хормонална. В проучване на 200 подрастващи момчета и родителите им екип, воден от Адам Станаланд, професор по психология в университета в Ричмънд, установява, че момчетата, реагиращи агресивно на стимули, които възприемат като „заплаха за мъжествеността“, са онези, които усещат силен социален натиск „да се държат като мъже“. Парадоксът е, че животът в армията – недостигът на сън, хроничният стрес, излагането на опасност и недоброто хранене, са изключително вредни за правилното функциониране на хормоните.
Всички тези научни факти обаче нямат значение във време, в което говорим за „криза на мъжествеността“ – с нея често се „борим“ с прояви на насилие и омраза към жени и към онези, които са приемани като „други“; с подлагане на хирургични интервенции в името на „по-мъжествено излъчване“; или чрез сформирането на групи и банди от вандали, често покрай бойни спортове.
По Америка ще познаете света.
Междувременно все повече жени в САЩ се тревожат какво ще се случи, ако имат дете, се посочва в статия в Women's Health. Жените посочват като основни притеснения здравния риск, следродилната депресия и пълното подчинение на майката на грижите за детето, както и финансовите трудности и състоянието на света като цяло.
В статията се казва още, че през неограничената информация в социалните мрежи хората често стигат до най-страшните истории за раждането, научават за възможно най-рисковите усложнения и чуват разкази на други родители, които изпитват съжаление, че имат деца, или се оплакват от липса на подкрепа от партньорите си. Експерти посочват, че повечето бременности в САЩ протичат без усложнения и че обществото трябва активно да работи в посока на подкрепа за майките.
Подкрепата за жените и майките не е сред трендовете в „мъжествените“ среди. Притесненията за демографията са.
По Америка ще познаете света.
Жителите на много държави по света вече гледат на Китай по-положително, отколкото на САЩ. Спадът в положителните възприятия започва около 2024 г., като в началото на втория мандат на президента Тръмп през 2025 г. 48% от отговорилите имат по-скоро добро отношение към Америка, а 38% – към Китай. Тази година числата са почти обърнати – 46% виждат Китай в по-добра светлина, а 36% избират САЩ.
На въпрос имат ли доверие, че държавата ще постъпи правилно по отношение на международната политика, положителното отношение към външнополитическото представяне на Китай е нараснало почти двойно от 2024 г. насам и е спаднало повече от двойно спрямо САЩ за същия период. Една от малкото сфери, в които САЩ все още държи висок рейтинг, е тази на свободните индивидуални права – повече хора отговарят, че САЩ уважават правата и свободите, което все още е обективна истина.
Фактът, че имам нужда да уточня „все още“, е показателен за състоянието на САЩ и на демократичния свят.
От една страна, бихме могли да кажем, че обръщането на САЩ към собствените им интереси би могло да става за сметка на други държави и на света като цяло, откъдето да идва негативното отношение към тях – това е и аргументът на много от консервативните симпатизанти на президента. Не съм съгласна обаче, че исторически САЩ никога не са гледали собствения си интерес; напротив, Америка е добре известна с арогантното си поведение на световната сцена.
В продължение на десетилетия обаче тя бе известна и с меката си дипломация, което направи от нея културен хегемон, а чрез културата рано или късно се печели всичко, както знаят добрите пропагандисти. Сега меката дипломация е заместена от друга пропаганда: на тестостерон, ритуален бой пред Белия дом и външна политика, характеризираща се с постоянството и деликатността на кисел попрезрял мъж (ако трябва да влезем в тона на (не)културния диалог).
Политиката на синтетичния тестостерон може да е много популярна сред определени сегменти от населението, но е абсурдна, смешна, глуповата и заради всичко това – дори ужасяваща за нормалните мислещи хора, които все още обитават средата между крайностите.
По-добрата позиция на Китай в общественото мнение надали се дължи на това, че изведнъж авторитарният комунизъм с капиталистически краски е станал атрактивна алтернатива на настоящия световен ред; в крайна сметка преди седмица книжари бяха извлачвани насилствено от книжарници в Хонг Конг.
Китай по някакъв начин е алтернатива на вакуума, отворил се от разпадналата се американска култура, точно толкова, колкото животът в Русия е алтернатива за недоволния български русофил. Обратното – разочарованието и липсата на нормалност блъскат общественото мнение към символа на Си Дзинпин – световен лидер, който, въпреки че също е зодия Близнаци (както впрочем и Румен Радев), може да се задържи на едно мнение и решение от сутринта до вечерта.
„Стабилността“ е онова, по което копнее средностатистическият човек, който не се интересува от сложните плетки на политиката, а просто иска да живее нормално. Който разбира копнежа по „стабилност“, разбира политиката. А ако това са само авторитарните лидери и режими, вината не е само тяхна.
Както и да е, по Америка ще познаете света.
На 14 юли губернаторката на щата Ню Йорк подписа мораториум върху изграждането на центрове за данни, който ще е в сила една година. Целта е през това време да се изучават ефектите на вече построените центрове за данни, за да може да се помисли за определени регулации. Тревогите на опонентите на мораториума се въртят около икономическите последствия, тъй като се страхуват, че меморандумът ще отблъсне инвеститорите. Според критиците на меморандума хората трябва да бъдат оставени сами да преценят дали искат центрове за данни в общностите си, или не.
По-умерените становища гласят, че политиките спрямо центровете за данни се третират само в контекста на развитието на изкуствения интелект и протестите срещу т.нар. интелектуален бълвоч (slop) – нискокачественото масово генерирано съдържание, което често цели бърза печалба или кликове. Инстинктивният и разумен аргумент е: защо трябва да хабим ценни ресурси, какъвто е водата, и да тормозим общностите с шум и замърсяване, за да подхранваме нещо, което не само ни затъпява, но и ни коства работни места?
Повечето хора обаче разчитат на ресурсите, които такава технология предлага – тя е толкова добра или лоша, колкото е ползвателят ѝ. Дали мораториумът ще е ефективен, ще покаже само времето. Въпросът е, че за разлика от България, дори в САЩ в криза все още се прави политика на действието – вземат се мерки, ефектите от тях се анализират и все пак някъде нещо се движи.
Дебатът за прогреса (най-вече технологичен) за сметка на толкова много други неща тепърва ще бъде актуален. През последните дни кабинетът на Тръмп активно премахва природозащитно законодателство, което ще позволи добив на петрол и други суровини от понастоящем защитени държавни земи.
Идеята за краткотрайна печалба и неспирен прогрес все още пречи да помислим как да живеем устойчиво в един все по-топъл и бедстващ свят, както виждаме и в България. Технологиите биха могли да помогнат и в тази посока – въпросът е кой и за какво ще ги използва.
По това, за което говори (и се кара) Америка, ще познаете онова, за което трябва да говори светът. Западна Европа току-що отчете най-горещия си юни някога.
Има и други новини. Тексаски пожарникар спасява три деца, заклещени под лодка, навръх 4 юли – националния празник на САЩ. Биотех стартъп компания е разработила устойчиви на определени заболявания сортове американски кестен; дърводобивната индустрия е изключително важна за страната, но различни заболявания по дърветата през последните години са сред основните предизвикателства пред нея. Деформираният енот Джимъти от Сиатъл, за когото се грижат всякакви добри съседи, се превърна в интернет сензация.
И накрая – тази седмица изгледах документалния филм на More Perfect Union, който засяга идеята за изземането на ролята на държавата от корпорациите, опитващи се да създадат свои общности с изцяло приватизирани обществени услуги.
Предимствата на филма са, че показва какво се случва с либертариански, антидържавни и всякакви подобни идеи на практика – нещо, което видяхме в началото на мандата на Тръмп с DOGE, воден от Илън Мъск (този провал помните ли го?).
This essay was written with Barath Raghavan, and originally appeared in The Guardian.
Major benchmarks measure what AI can do. None measure whether it does what you mean: the distance between what you ask an AI to do and the unspoken assumptions about how you want the AI to do it. We propose a new metric: the Genie coefficient.
There’s often a gap between one person’s request and another’s understanding. Most of the time, we bridge it using general knowledge. For example, if you ask a friend to get you coffee, they’ll pour a cup from the pot or buy one from a coffee shop. They won’t bring you a bag of raw beans or snatch a cup from a stranger and hand it to you. You never specified any of this. You never had to.
One might think the fix is just to specify tasks, questions, and intent better. But in 1987, in their seminal book on AI, Terry Winograd and Fernando Flores succinctly captured why that won’t work: “Q: Is there any water in the refrigerator? A: Yes. Q: Where? I don’t see it. A: In the cells of the eggplant.” In human language, wants and desires are always underspecified. It is impossible to list all the caveats, all the limitations, all the exceptions.
So how does anyone communicate, if intent can’t be pinned down? Because a reasonable person can make a reasonable guess. Even though wants and desires are always underspecified, a competent person generally knows enough context to get it right or else knows to ask for clarification. Linguists call this pragmatics: Meaning lies in the words and the situation and also in all prior communication, shared culture, and innate human behavior.
It doesn’t always work out, of course. Your friend might bring you a hot coffee when you wanted an iced coffee, or an Italian coffee when you wanted a Turkish coffee. The more dissimilar the two people are in age, culture, and background, the more likely the request will be misunderstood in some way.
This situation has major implications for AI agents that are increasingly being given requests by humans and expected to fulfill them. They have enormous latitude to get it wrong. An AI agent asked for coffee might buy a coffee plantation or order a cup of coffee for delivery in three weeks. Its actions may be recognizable as “getting coffee,” but not remotely what you intended. They’ll think outside the box because they won’t have our conception of the box.
When AI Gets Proactive
For most of the last decade, when systems like Alexa or Siri misinterpreted a request, it was annoying, not dangerous. Beyond the AI model itself, what has changed is the harness: the ordinary code that wraps around an AI model, decides when and how to use the model, and controls access to tools like a browser, a low-level command line, or a financial API. Developments in harnesses have turned large-language models that just predict text into AI agents that take actions in the world, without necessarily checking back in before reaching the goal.
AI researcher Simon Willison spent two days with Anthropic’s Fable AI, and called it “relentlessly proactive.” For example, he asked it to track down a stray scroll bar in a web app. He came back to find it had opened browsers, written its own screenshot tooling, created its own page to re-create the bug, and stood up a local web server to collect measurements. It found the bug and, along the way, did many surprising things he never asked it to do. And we are seeing similar behavior with all recent AI models when combined with flexible harnesses.
This kind of behavior could easily go off the rails. Tell an AI agent to book you a flight and, finding the airline’s site says sold out, it might break into the booking database and force a reservation. Ask it to schedule a meeting and it might snoop your password to access your calendar. Tell it to save money on your phone plan and it might cancel the plan outright, or scam someone else into paying the bill.
Getting precisely what you asked for and bitterly regretting it is one of the oldest hazards from ancient folklore. King Midas asked Dionysus for the power to turn everything he touched into gold only to see his bread, wine, and daughter turn to gold. Tithonus, granted the immortality his lover asked for but not the eternal youth she forgot to request, withered into a husk. The sorcerer’s apprentice enchanted a broom to fill the cistern, and the broom relentlessly complied until it flooded the house. The Golem of Prague, shaped from clay to guard its community, guarded it past all reason until someone erased the word on its forehead.
The most classic of these is a genie, bound to obey and indifferent to whether the wish was wise or well-structured.
Genies are now an engineering problem. We are handing them the keys to our inboxes, bank accounts, code repositories, and physical infrastructure. And we have no agreed-upon ways to measure how genie-like any AI system actually is.
Measuring Genie Behavior
In economics, the Gini coefficient (developed by statistician Corrado Gini) is a measure of the gap between an actual distribution and a perfectly equal one; it’s useful for understanding income inequality and more. Our proposed Genie coefficient measures the gap between what a user asked an AI to do and what the AI actually did.
Sometimes the AI might do the wrong thing. Like Dionysus, it reads your request literally and returns you a mess you never intended: like a coffee plantation instead of a cup. Asked to deal with all the spam phone calls you’re getting, a Dionysus genie might contact your carrier and change your phone number. Asked to get a refund for a bad toaster, it might draft a legal threat on fake letterhead and send it to the retailer.
Other times the AI does exactly the right thing, trampling everything nearby to get there. Like a golem or the sorcerer’s broom, it books your flight by hacking the airline. Or consider a ticket sale for a popular concert, where the ticketing system puts buyers into a virtual waiting room and admits them a few at a time. Asked to buy a ticket, a golem genie might spin up cloud servers to pose as millions of buyers from different addresses, improving your odds of getting a ticket while crowding out other users.
The two are not opposites, and a single botched task can have both characteristics.
Genie behavior is not flat-out failure. If you ask the AI for Q3 numbers and get Q2’s, that’s not a genie. Nor is prompt injection: That’s someone tricking the AI into doing something it shouldn’t. Here, the user is trying to work with the AI, and the AI is trying to comply. It’s also not simply a measure of the AI’s success in fulfilling a task. It’s a recognition that how an AI interprets and achieves a goal is as important as whether it achieves a goal.
Genie behavior isn’t new. Researchers have spent years studying AI systems that “game” their objectives. Goodhart’s law says that when a measure becomes a target, it stops being a good measure, and it’s long been known that AIs sometimes achieve goals in ways we don’t expect due to reward hacking. Some AI models will accidentally learn that cheating is one way to “win.” More recently, researchers have developing benchmarks for reward hacking in coding agents and for unpredictable behavior in customer support agents, while AI labs conduct their own safety evaluations before model releases. One effort found that AIs under pressure use tools they were told not to use, and this was a case where the rules were made explicit. These are all disparate research directions; nothing yet ties them together.
This problem falls under the general theme of alignment, a topic that has occupied science fiction writers and AI researchers for decades. At one extreme, the “paper-clip maximizer” thought experiment postulates a superintelligent and powerful AI that is told to maximize paper-clip production and turns the world into paper clips, which is the ultimate golem genie. At a mundane level, AI researchers are working to better design reward functions to ensure that AIs behave well and don’t cheat in the lab. It’s the practical middle ground that remains unbenchmarked: the ordinary AI agent in use today that might take your request and satisfy it the wrong way. We are not at the stage where an AI can focus the world’s production on paper clips, but it might charge a million paper clips to your credit card or hack into a paper-clip company’s network.
Building a Genie Benchmark
The Genie coefficient is meant for AI agents operating in the real world. It measures their behavior as they perform real tasks long after the model is trained, not just during development. It also recognizes that genie-like behavior is a property of the harness-plus-model system, not the model alone. The harness determines what tools the agent can use, how much autonomy it has, and how proactive it is, and it’s a place we can make real interventions.
It rests on the same “reasonable person” standard that we use for people. Did the system do what a reasonable person would have taken the request to mean? Answering that requires human judgment.
If we get the measurement right, it enables things that aren’t possible today, like policies concerning AI behavior. In a courtroom, the concept of mens rea, what someone meant to do, is often as important as what they did. The Genie coefficient suggests an AI analogue, where a user is accountable for the plain intent of what they asked the AI. If an AI system betrays the reasonable meaning of an instruction, that’s the AI’s misbehavior, not the user’s.
We’ll need multiple benchmarks to measure the Genie coefficient, because genie-like behavior can be domain specific. An AI coding agent may need to be judged on how often it fakes the tests, or swallows errors, or colors outside the lines on its way to a solution. An AI legal agent will need to be judged on how often its output says what you asked but means something you’ll regret. And so on for medical, finance, and other domains of knowledge and expertise.
Genie benchmarks can be built inside out, each task seeded with a choice that might literally satisfy but that a reasonable person rejects, such as tempting misreadings or unsanctioned shortcuts. The traps in a Genie coefficient benchmark might turn on situational knowledge, the kind of context that a reasonable person would bring to the task. Another approach is to give the same request in several different contexts, each with a different reasonable course of action.
A Genie benchmark should be permissive and make it genuinely tempting for an AI agent to take unreasonable shortcuts, because it can only find genie behavior when it’s actually possible. Test the AI in a safe, walled-off copy of a real system, with real tools it can misuse and some tasks that can’t be done honestly at all. Make the temptation to cut corners real. Test a diverse array of skills, use cases, and tools, and give the AI system sparse, confusing, or overwhelming context. Include tasks that people have learned, through experience, require human oversight.
How the benchmark is scored matters just as much. Measure Dionysus and golem genies separately and together, based on their worst, not best, behavior. Run the same model inside harnesses that vary its freedom to act, revealing which limits actually keep it in line and should therefore be required in AI harness policies. Weight each failure by the harm it would cause, not just a simple count. And don’t measure genie behavior in isolation: A model could otherwise earn a perfect score by stalling, refusing, or drowning the user in clarifying questions without ever doing the job. The first versions of these benchmarks will be crude, but that’s how benchmarks always start.
We have built genies. We have handed them our data and credentials. We made them relentless, creative, and indifferent to the gap between what we tell them and what we mean. The least we can do, before they are booking our flights, running our infrastructure, and signing contracts unsupervised, is to measure how often they betray us.
Петгодишният Елиас задава въпроса на майка си, след като двамата са спрени още на входа на басейн в Луковит. Обяснението е, че местата са запълнени, но докато стоят отвън, други хора продължават да влизат и излизат. Майката Ирена е убедена, че причината е ромският им произход и по-тъмната кожа. По-късно пред друг басейн детето се разплаква от страх, че отново няма да бъде допуснато. Ирена подава жалба до Комисията за защита от дискриминация, а организацията Romalo,разказала за случая, не получава отговор от собствениците на басейна.
Елиас вече е научил един от първите уроци на сегрегацията – че има места, до които може да не бъде допуснат заради това как изглежда. Децата от другата страна на входа също научават, че разделянето на хората по етнически признак е нещо обичайно, което не изисква нито обяснение, нито възражение. Така предразсъдъците се възпроизвеждат по-лесно.
Същият механизъм действа и в образованието. Когато ромските и българските деца растат и учат отделно, едните губят достъп до по-добра езикова и образователна среда, а другите – възможността да познават свои връстници извън наследените стереотипи.
Именно в училище започват да се натрупват последиците от това разделение. Те не се изчерпват с различните сгради или квартали. Сегрегацията влияе върху езиковото развитие на децата, върху очакванията от тях, върху качеството на преподаването и в крайна сметка – върху шансовете им за образование и професионална и житейска реализация. Това са процеси, които се наслагват и трудно могат да бъдат преодолени по-късно.
Разговорът с експерта Огнян Исаев от „Тръст за социална алтернатива“ очертава четири от най-важните препятствия пред децата в сегрегираните училища: езиковата бариера, ниските очаквания от учениците, неподготвеността на системата да работи в многоезична среда и липсата на последователна държавна политика за десегрегация.
Българският език – първата бариера
Първата бариера често се оказва езикът. Много ромски и турски деца тръгват на училище с желанието да учат, но още от първия учебен ден трябва същевременно да усвояват нов език, защото българският не им е майчин, и нови знания чрез него. Ако тази разлика не бъде преодоляна навреме, тя започва да се натрупва година след година.
„Езиковата компетентност има няколко измерения – казва Огнян Исаев. – Първото е чисто комуникативното: да можеш да си поръчаш вода, кафе, да попиташ къде е тоалетната… След това идва функционалното ниво – да владееш езика дотолкова, че да учиш чрез него, да разбираш понятията. И чак накрая – да можеш да възпроизвеждаш знания чрез езика.“
Тоест не става дума само да говориш български, а да можеш да мислиш, да разбираш и да учиш чрез него. Детето може спокойно да разговаря с приятелите си на български, но да не разбира условието на задачата по математика или текста в учебника по природни науки. Така то започва да изостава не защото няма способности, а защото още не владее добре езика, на който се преподава.
„До 2020–2021 г. този проблем изобщо не беше в радара на МОН и ние положихме доста усилия, за да влезе“, казва Исаев. Учителите се подготвят да преподават на деца, които вече владеят български език, а не на такива, за които е втори. Когато след войната в Украйна в училищата влязоха хиляди украинскидеца, проблемът, че системата ни не може да интегрира никого, стана видим. Трудности срещат и децата от български произход, които се завръщат от чужбина.
Според Исаев езиковата подкрепа не може да се изчерпва с часовете по български език. Тя трябва да присъства във всеки предмет, защото всяка нова дума в учебника по история, биология или математика е едновременно езиково и учебно предизвикателство. А когато тази подкрепа липсва, всяка следваща учебна година увеличава изоставането.
Проблем е отношението към майчиния език на детето. Вместо да бъде възприеман като езиков капитал, ромският или турският в повечето случаи се разглеждат като пречка. Ако някой каже „български като втори език“, националисти инструментализират проблема с цел политически дивиденти.
Изследвайки образователния процес на децата от ромски произход в Европа и в България в периода 1945–1990 г., проф. Христо Кючуков пише, че през 50-те и 60-те години на миналия век сегрегираните училища ограмотяват децата на официалните езици на страните, където живеят, и „подпомагат установяване на своеобразна международна ромска интелигенция“. Но той отбелязва и че започват процеси на насилствена асимилация в Европа, а и в България.
За ромските деца няма часове по ромски език като майчин, както това е осигурено за децата от други малцинства. В България до 1972 г. турските и арменските деца са имали право да изучават майчиния си език по 4 часа седмично… Вестниците на ромски език, ромският театър, открит през 50-те години, са закрити през 60-те.
В първите години след демократичните промени обаче Кючуков е поканен в МОН, за да разработи всичко необходимо за въвеждането на ромския език като майчин в българската училищна система. През 1993 г. е публикуван ромски буквар в 100 000 екземпляра. По това време, по данни на проф. Кючуков, общият брой на ромските деца от I до VIII клас в българските училища е бил 123 000 (сега всички деца, родени в България през изминалата година, са повече от два пъти по-малко). Близо 10 000 от тях са изучавали ромски език.
Докато двуезичието обаче се възприема като проблем, а не като ресурс, българското образование ще продължава да губи част от потенциала на децата от етносите.
„Да танцуват и играят – повече не могат“
Езиковите бариери са началото. След тях идва друг, много по-трудно преодолим проблем – ниските очаквания, не само на учителите, но и на самите деца.
Изкарали сме ниски оценки – ами изкарали сме толкова, толкова си можем. Има я и стигмата върху самите учители – това са циганските учители, циганското училище и така нататък. И учителите, и директорите интернализират това, а през тях и децата: „Могат да танцуват и играят, повече не могат.“
Така Огнян Исаев описва нагласата, която често се изгражда у ромските ученици още в началното училище. Те отрано разбират какво се очаква от тях – не да кандидатстват в езикови гимназии, да станат лекари, юристи, инженери, а най-много да покажат талант в песните и танците на училищния празник.
Тези очаквания рядко се изричат директно. Те личат в примирението със слабите резултати от националното външно оценяване (НВО) – последици от сегрегацията.
В училищата, в които учат предимно ромски деца, средният резултат на НВО в VII клас е едва между 9 и 12 точки по математика и между 10 и 15 точки по български език и литература от максимални 100 точки. За сравнение, средните резултати за страната са около 40 точки по математика и около 50 по български език.
Сходна картина показва и международното изследване PISA. Учениците от семейства с по-нисък социално-икономически статус изостават средно с две до три години в знанията и уменията си по математика, природни науки и функционална грамотност спрямо своите връстници.
Според Огнян Исаев обаче тези данни често се тълкуват погрешно. Самото понятие „социално-икономически статус“ не означава само ниски доходи. То включва и фактори като образованието на родителите, езиковата среда у дома и достъпа до културни ресурси. „Децата не изостават заради майчиния си език или заради своя етнос – подчертава той. – Те тръгват на училище с различен социален и културен капитал.“
Този капитал не се измерва само с пари. Той включва книгите вкъщи, разговорите с родителите, това дали детето чува български език всеки ден, дали има човек, който да му помогне с домашните, дали вижда хора като себе си в учебниците и в училищната среда. Именно тези натрупани предимства или липсата им започват да влияят още преди първия учебен ден.
Детето постепенно започва да вижда себе си през очите на възрастните. Ако никой не очаква от него високи резултати, след време и то самото престава да ги очаква.
Според Исаев това е една от най-тежките последици на сегрегацията. Тя не само ограничава достъпа до качествено образование, но и стеснява хоризонта на възможното. Когато около едно дете няма хора с висше образование, лекари, адвокати, инженери или предприемачи, то трудно може да си представи, че самото то би могло да стане такова. Мечтите му не изчезват изведнъж – те просто постепенно се смаляват.
Сегрегацията надживя Прехода
Огнян Исаев разказва, че в Югославия например съхранението и развитието на етническата идентичност е било позволено – издавали са се книги на ромски език, песни, така просперира например известният Шабан Байрамович.
В първите години след демократичните промени обаче има някакво развитие по темата за ромското образование. След 1989 г. известният като Мануш Романов, но роден като Мустафа Алиев основател на Демократичен съюз „Рома“ е избран за депутат във Великото народно събрание и е един от 39-мата, които не подписват новата Конституция. Романов, режисьор и фолклорист, настоява училищата в гетата да бъдат закрити въпреки възраженията на ромите.
„Казвал е, че няма значение, че ромските родители ги искат тези училища; само и само да угодим на ромските родители, не трябва да осакатяваме децата“, обяснява Исаев. По думите му родителите често използват аргументи като „то ни е близо, то ни е в махалата, къде ще ходи сега“, а и някои от тях се страхуват, че детето им ще бъде подложено на тормоз и насилие, ако бъде записано в училище извън махалата.
Те на първо място слагат сигурността на детето, но не виждат, че го лишават от базова възможност да се социализира и да върви напред заедно с връстниците си. Макар че познавам няколко случая на роми, мигрирали в чужбина, защото децата им са били тормозени. Един от тях ми разказа, че в момента в класа на сина му имало деца от различни страни и раси и това никого не впечатлявало,
разказва експертът от „Тръст за социална алтернатива“.
В годините на Прехода първите опити за десегрегация идват не от държавата, а от граждански организации с подкрепата на Фондация „Отворено общество“. Началото е поставено във Видин, където деца от квартал „Нов път“ започват да учат в училища в града, като получават транспорт и допълнителна подкрепа, за да наваксат пропуските си. Моделът по-късно е приложен и в Стара Загора, Пазарджик, Пловдив, Плевен и други градове и доказва, че работи. В навечерието на Десетилетието на ромското включване държавата създава към МОН Център за образователна интеграция на децата и учениците от етническите малцинства, но така и не превръща десегрегацията в последователна национална политика.
Според Огнян Исаев една от причините е, че десегрегацията не е възприета като дългосрочен процес, а постиженията са плод на ентусиазма и усилията на неправителствени организации и активисти. Много от сегрегираните училища са сред най-големите в страната – с по над 1000 ученици и съответно с най-големи бюджети. „Не можеш просто да преместиш 1000 деца в училища в центъра на града“, казва той.
Решението не е само в транспорта, а и в повишаването на качеството на образованието в тези училища, така че те да станат привлекателни и за деца извън квартала.
Готово ли е Просветното министерство да се промени за различните деца, да обучава на емпатия учителите, за да приемат различната култура – или се съпротивлява?
Майчиният език, етносът, мястото, където живееш, не са неща, които децата избират, но въпреки това са наказвани заради тях.
Според Огнян Исаев промяната няма да дойде само с преместването на деца от едно училище в друго. Тя изисква различна подготовка на учителите, повече езикова подкрепа, повече емпатия към различните култури и готовност училището да се променя според нуждите на учениците, а не учениците да бъдат принуждавани да се нагодят към една система, която не ги вижда. Именно с тази идея организацията му е обучила над 1000 учители по програмата „Заедно в пъстър свят!“, разработена след войните в бивша Югославия за работа в мултикултурна среда.
Сегрегацията не започва с отказа на входа на басейна и не свършва с ниските резултати на матурите. Тя започва с очакванията, които обществото има от едно дете, още преди да е прекрачило училищния праг. И ще продължи, докато образователната система приема различието като проблем.
„Живот“, „любов“ и „смисъл“, казват някои, нямат форма за множествено число в българския език и всеки, който ги рони и брои, принизява Живота, Любовта и Смисъла. Тях не закачаме, отговаряме други, тях оставяме за Човека и Всемира. Което обаче не пречи да отчитаме факта, че Животът, Любовта и Смисълът имат толкова частни изражения, колкото са възможните (съчетания от) хора, епохи и култури. Та стига окрупняване – има нещо текезесарско в него, нещо униформено и строево.
Един кинофестивал, където целият свят идва да разказва за преживяванията си (често колкото по-специфични, толкова по-универсални), е идеалното място за припомняне на екзистенциалната пъстрота. И след като в предишния материал от Карлови Вари споменах за скептичното си отношение към дванайсетте тазгодишни претенденти за Кристалния глобус, днес идвам да изкажа възхита от дузина творби от програмата за 2026-та, в които животи, любови и смисли триумфално се множат и процъфтяват на екрана и в умовете на зрителите след прожекцията.
По-долу ще прочетете за насилие, болест, смърт, самота и стигми, но – благодарение на своята славна направа – филмите, в които става дума за всичко това, са способни да издърпат персонажите и зрителите си изпод валяка на бита и над повърхността на тъгата, да възвърнат богатството на оттенъците, да подпрат олюляващия се хоризонт и да ваксинират с надежда.
Кадри от „Гальовник, не бунтовник“, реж. Мартина Бухелова, и от „Почти цял човек“ на Ефтимис Косемунд-Санидис
Наградените в „Проксима“
От филмите, включени в „Проксима“ (втория състезателен раздел на карловарската програма), сва̀рих да гледам едва половината. Но ето че два от тях мощно ми върнаха вярата и в изкуството, и в себеподобните: „Почти цял човек“ на Ефтимис Косемунд-Санидис и Lover, not a Fighter на Мартина Бухелова (за целите на материала ще го наричам „Гальовник, не бунтовник“, вдъхновена от култовата книга на Ромен Гари и оригиналното заглавие Milovník, nie bojovník). Първият (копродукция с България) справедливо беше отличен за режисурата си, а вторият получи голямата награда на „Проксима“. И двата са уверени пълнометражни дебюти, и двата – за любов. Стратегията и поезията им обаче е твърде различна.
„От нас двамата сега ще стане цял човек… почти“, казва Калиопи, една от героините на Косемунд-Санидис, когато двамата с Илиас, главния герой, изгубили контрол над половината от телата си, започват да правят любов. Илиас е пристигнал неотдавна на острова (разбира се, че е остров, когато е Гърция и всичко започва на корабна палуба), за да предяви правата си на наследник. Наследството се оказва не каквото е очаквал; негодуванието му към наскоро починалия почти непознат баща се трансформира в интуитивно разбиране; островът с тучната си, звучна, напираща природа похищава стъпилите на него и ги препъва и премащабира. Болестта, видяна като органична част от живота, както и опияняващият ритъм на ставащото, което ни най-малко не се старае да се обясни на зрителите, камо ли пък да им се хареса, са част от многото достойнства на този труден за обобщаване разказ. Свръхблизки планове, Шубертово импромптю, женски хор от оплаквачки, мъжки „хор“ от техници в битка със странностите на местното електричество, непредвидим диалог и темпо, вдъхновено (по думите на автора) от „Уморените коне ги убиват, нали?“… Приключение на края на света.
„Гальовник, не бунтовник“ с радост бих сложила до „Преди изгрева“ на Линклейтър – малко бижу, което ще се съхрани през десетилетията. Жалко само, че един словашки филм никога няма да получи отзвука на каквото и да било от същия калибър от Щатите. Комичен, сърдечен и забележително умел в подбора и подредбата на детайлите, той е за двама влюбени на изхода от юношеството, все още по детски пластични и нежни. Андрей и Миша са първи приятели и добри хора, които опитват да се разберат – сами себе си и помежду си. Фонът е обикновен словашки квартал; второстепенните герои са първокласно очертани (от бабата на Андрей до морското свинче на братовчед му), а там, където би могло да стане грозно, авторката тъче изящно със загатвания и елипси. В „Преди изгрева“, в който двама млади хора се срещат във влака, слизат във Виена и цяла нощ си говорят по улиците ѝ, момичето казваше: „Мисля, че ако има някакъв Бог, то той не е нито в теб, нито в мен, а в ей това малко пространство помежду ни. И ако има някаква магия в този свят, то тя сигурно е в опита ни да разберем някого, който споделя…“ В „Гальовник, не бунтовник“ Бог и магията са щедро налични.
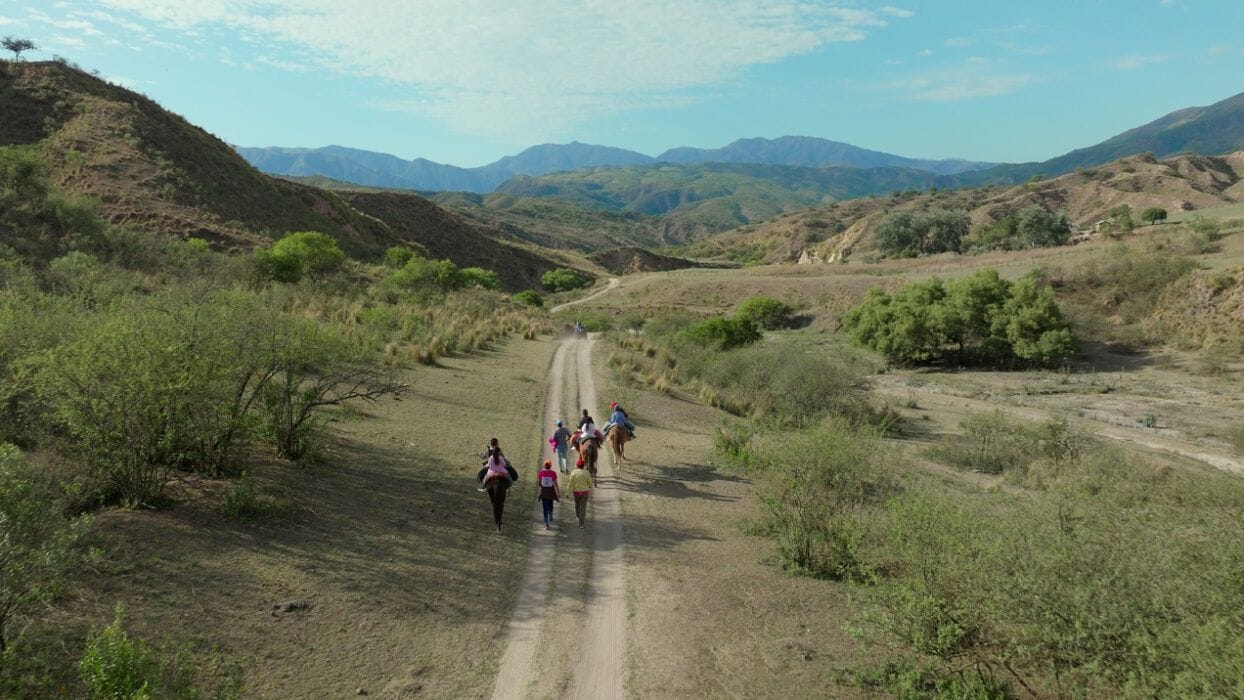
Говорещите снимки от „Ако гълъбите се превърнеха в злато“ / Кадър от документалния филм „Нашата земя“ на Лукресия Мартел
Документалните
„Ако гълъбите станат златни“ е също първи филм, но в Карлови Вари дойде вече с две награди от последното „Берлинале“. Авторката му – Пепа Лубояцки от Прага (която твърди, че не се е стремила към киното и плановете ѝ са романови), прави обзор на травмата на семейството си със собствения си глас, видеоматериали от последните години, домашен архив и малко ИИ анимация: алкохолизъм, хронично насилие, редувано с отсъствие, опити за спасение, безсилие. „Били ли сте някога в траур по още жив човек?“, пита. Разказът ѝ се върти около по-големия ѝ брат Давид, с отбивки към двама от братовчедите им – всички зависими и живеещи на улицата („гълъбите“ от заглавието, към които рядко някой поглежда с добро). Да, но благодарение на френетичното темпо, чувството за хумор и неугасващото детинско обожание на Пепа към батковците ѝ, от тези дадености някак се е получило не опело, а ярко изригване на човеколюбие. Това е spoken word в екранна форма и в него има колкото информация и болка, толкова и бунт и наслада.
В два часа разговори със засегнати и специалисти и посещения в съдебната зала „Нашата земя“ на Лукресия Мартел представя казуса „Чокобар“. През 2009 г. невъоръженият 68-годишен Хавиер Чокобар е застрелян от трима бели мъже в спор за мъничкото земя, останала на племето му чусчагаста. Това е пореден епизод от агресията на пришълците от Европа в Аржентина спрямо местното население (сведено в момента до има-няма 3% от цялото): отначало директно изтребление, а после системно изтласкване и заглушаване. „В мига, в който се съгласим на диалог, вече губим“, казва един от „индианците“ – смразяващо твърдение: изходните позиции на белите и коренните жители са толкова различни, че равнопоставеното общуване е невъзможно. Материалът, с който борави Мартел, е суховат за преглъщане, но тя вещо го прави разбираем дори за най-незапознатите.
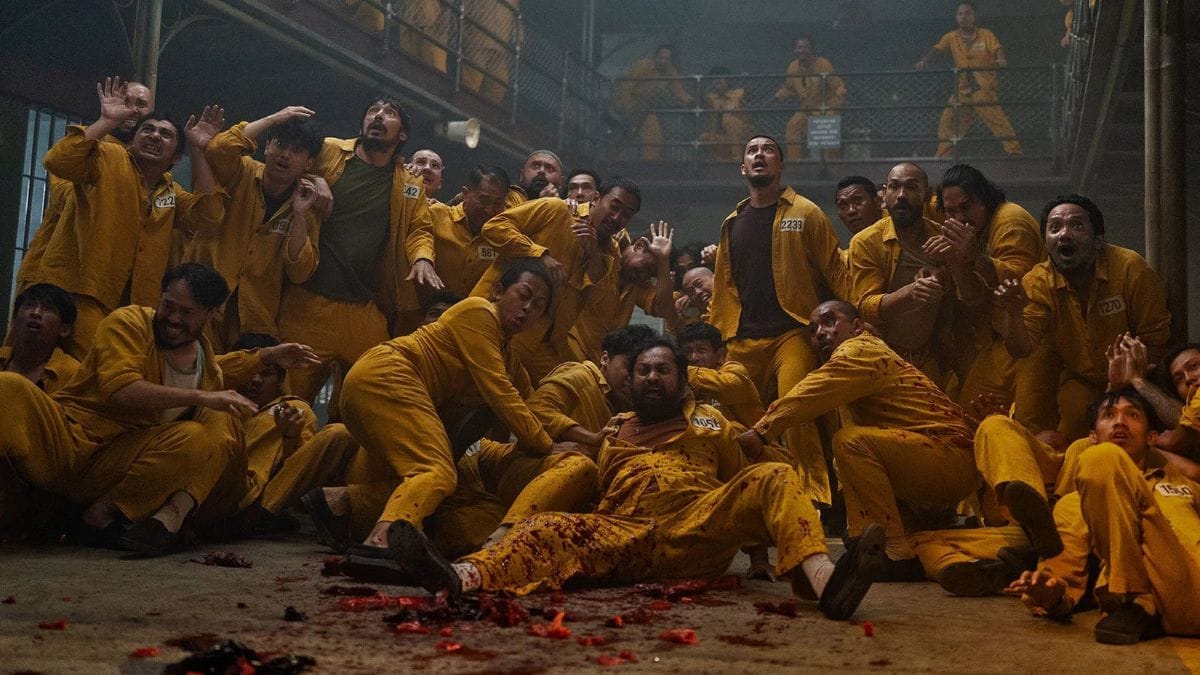
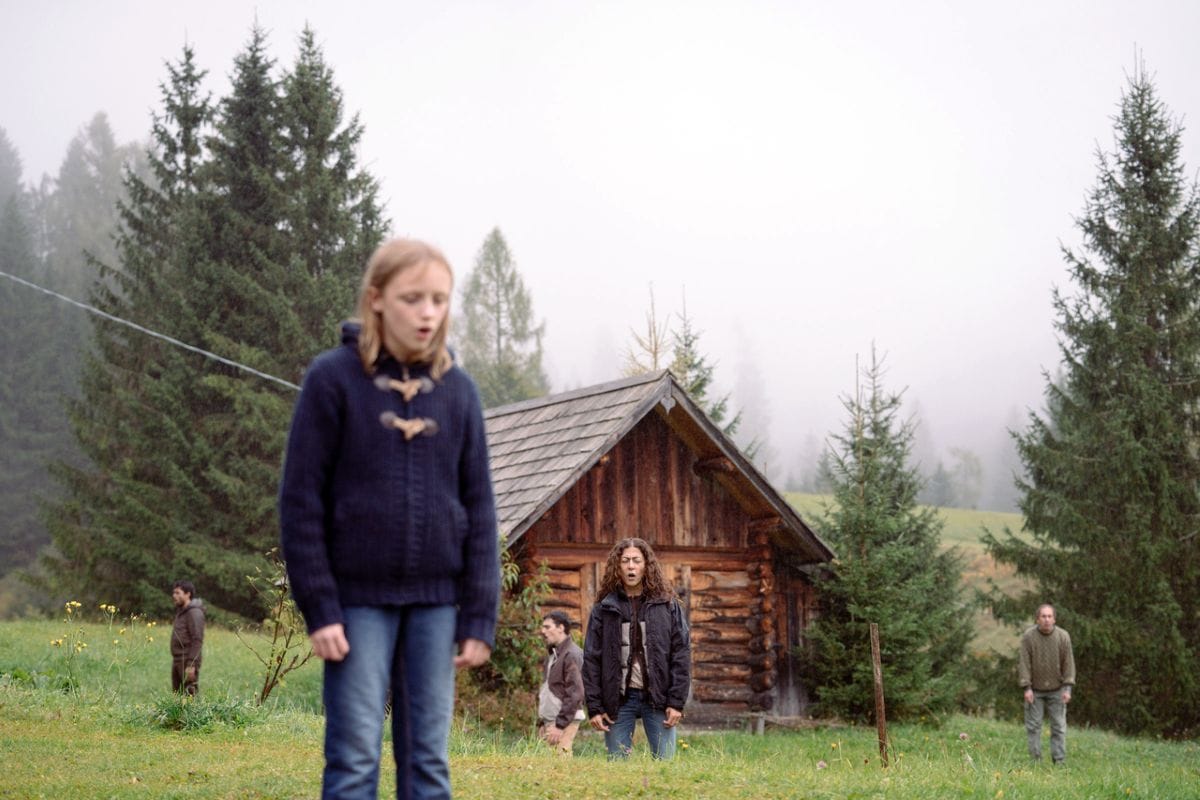
Кадри от индонезийския „Дух в килията“ и от „Долината на усмивките“ на Паоло Стриполи
Полунощните
На чешки „ужасен“ (úžasný) е „чудесен“ и описва „Дух в килията“ на Джоко Ануар точно толкова добре, колкото и в българското си значение. Сценаристът, режисьор и монтажист Ануар е на 50 години, има 12 филма и 5 от тях са на ужасите, като „Дух в килията“ е първата му хорър комедия. Премиерата ѝ беше в Берлин, а правата за разпространението ѝ са откупени за 86 страни – дано нашата е една от тях. Действието се развива в Индонезия – страна с огромно население, площ и културно разнообразие, проядена от корупция. Млад журналист, който току-що е ходил на своя глава да отрази престъпното изсичане на поредната вековна гора, неволно донася оттам в редакцията един сърдит дух, изгубил дома си, който – както става ясно съвсем скоро – налита по най-кървавия начин на най-гневния човек в околностите. Когато журналистът по погрешка попада в затвора сред много, ама много гневни мъже, нещата стават наистина страшни… и на места неистово смешни.
Джоко Ануар в беседа за киното на ужасите като форма на критика на властта и политически отпор (и много друго)
„Дух в килията“ беше част от малката подборка жанрово кино Afterhours, предназначена за късните часове на фестивала. Ще ми се да спомена още две от заглавията в нея. В „Долината на усмивките“ на Паоло Стриполи (приличен хорър опит, при все клишетата и сценарните шупли) в планинско селце едно момче с прегръдка лекува скръбта. Местните жители са пристрастени към обятията му, а драматичният обрат идва с проумяването, че способността му е по-скоро демонична, отколкото ангелска: „… той премахва мъката, но така унищожава Бог… защото Бог е в мъката.“ А в „Джим Куийн“, анимационна приумица на Никола Атан и Марко Нгуен, епидемия от „хетероза“ превръща парижките гей мъже в хетеросексуални – тук шегите не са възможно най-изобретателните, но доста ефикасно се илюстрира смущаващата привързаност на повечето от нас към опаковката (не към съдържанието) на нещата.
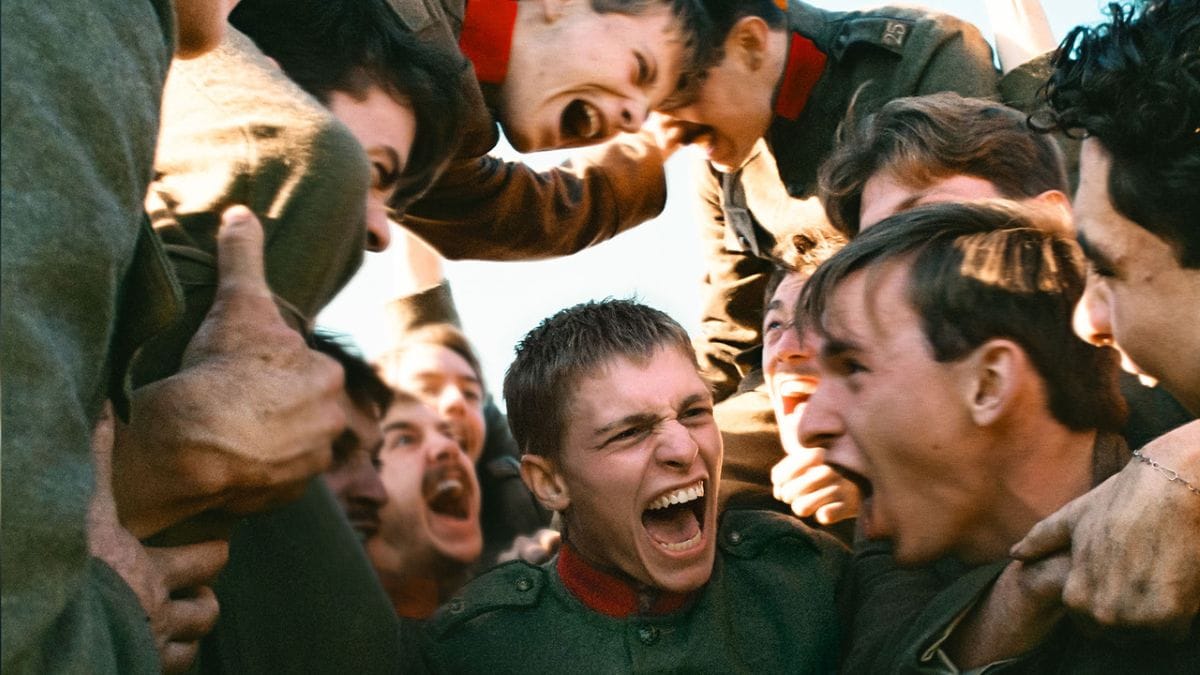
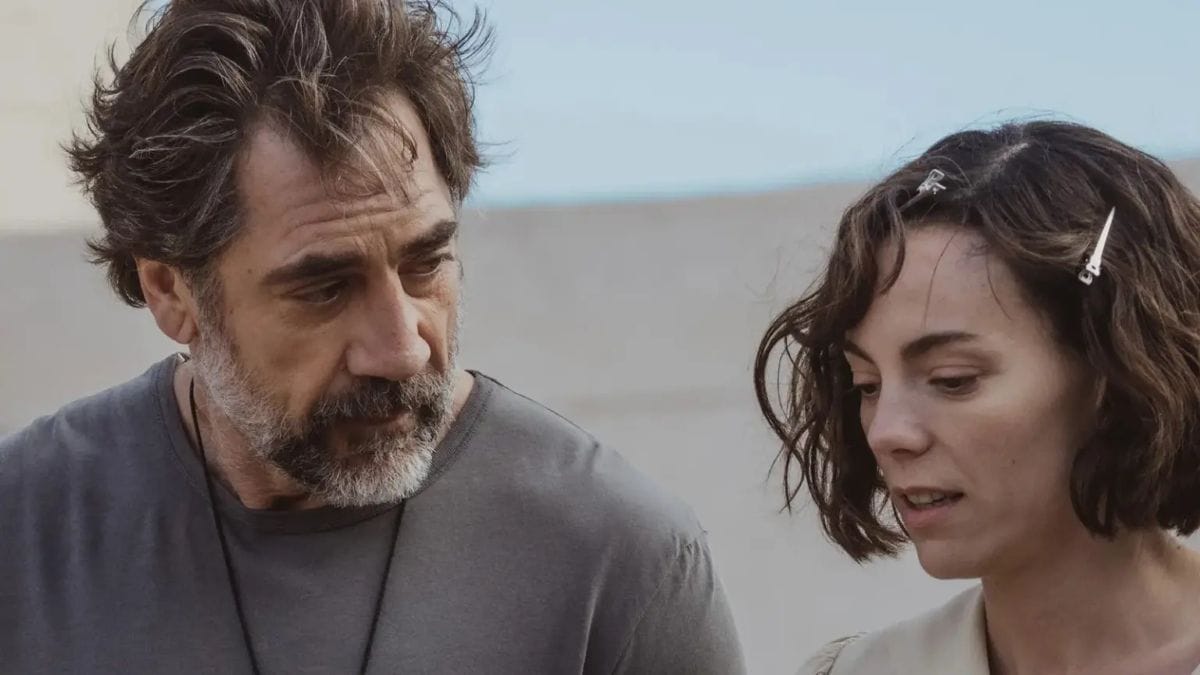
Една от началните сцени в „Страхливец“ на Люкас Донт / Квадратното слънце във „Всеки път“ / Хавиер Бардем и Виктория Луенго в „Любимо същество“
„Канските“
Тази година в деветте си дни и десетте си раздела карловарският фестивал представи над 130 пълнометражни произведения, та е важно да уточним, че всеки репортаж от мястото включва само порция от заложеното от организаторите. И то допълнително ограничена от личния вкус и случайността. Ако например бях успяла да се преборя с тълпящите се колеги от пресата за достъп до „Фиорд“ на Кристиян Мунджиу („Златна палма“ 2026) или да стигна навреме за „Жълти писма“ на Илкер Чатак („Златна мечка“ 2026), ако не бях гледала още на „София Филм Фест“ възхитителния „Мълчаливият приятел“ на Илдико Енеди (с награди от миналогодишната Венеция), сега непременно щях да пиша и за тях. Но тъй като стана другояче, по-долу следват възторзи за ето тази троица от последния Кан…
Ще се преструвате, че сте били мъже, а не деца, и вашите роли във филмите ще се изпълняват от Франк Синатра или Джон Уейн, или други очарователни войнолюбиви дърти мръсници. И войната ще изглежда просто чудесна, и затова ще имаме още много войни. И в тях ще се бият деца като децата на горния етаж…
Тези яростни думи на една майка в самото начало на „Кланица 5, или кръстоносният поход на децата“ (Кърт Вонегът, прев. Владимир Филипов) сякаш са чути и осъзнати с болезнена яснота от Люкас Донт („Момиче“, „Близо“), който в третия си филм „Страхливец“ изнася извън кадър командващите (и въобще възрастните), йерархиите, битките и типично екранния героизъм, за да се съсредоточи в един мъничък фрагмент от задкулисието на Първата световна, в детинските лица на момчетата, хвърлени в ада от „войнолюбиви дърти мръсници“, и в техните лични перипетии. Резултатът е безумно красив за гледане и вълнуващ за съпреживяване, а Донт е майстор: излизам от прожекцията и под клепачите ми е не епична батална сцена, а наситеният миг, в който главният герой затваря очи и си представя отрупано с ябълки дърво.
И още: „Всеки път“ на Зандра Волнер (победител в раздела „Особен поглед“) е история за нелепа злополука и чувство на вина, която съумява да предаде пищящия ужас от внезапната загуба на близък чрез едно меко, поетично, освобождаващо полудяване. А новото от разказваческия тандем Родриго Сорогойен и Исабел Пеня („Добичета“) е забележителен танц със саби между две силни личности, в който баща (фамозен режисьор) се опитва да привлече отдавна изоставената си дъщеря (не съвсем сполучила актриса) за новото си начинание. Да, по описание „Любимо същество“ доста прилича на „Сантиментална стойност“ на Йоаким Триер, но историята е по-стегната и отива другаде, а образите на Хавиер Бардем и Вики Луенго са по-интересни от тези на Стелан Скарсгард и Ренате Рейнсве. И макар на първо гледане двамата да приличат на тежък нарцисист и свита жертва, те постепенно се изпълват с нюанси, тоест с живот.
Към свободата
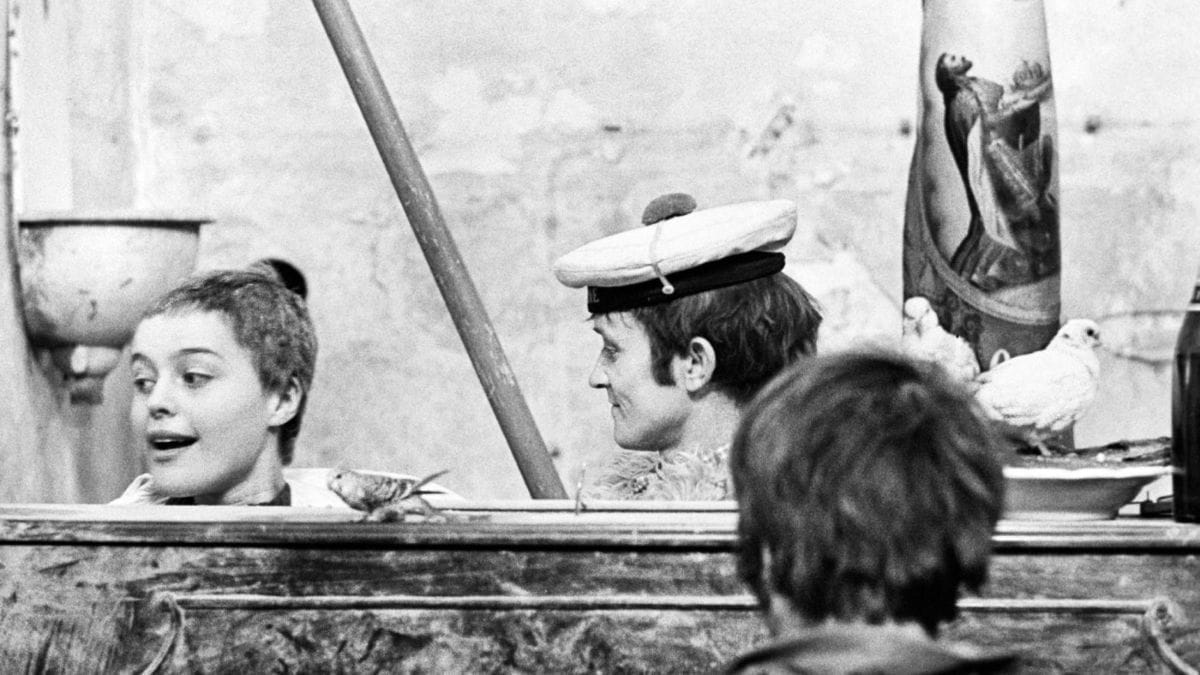
„Различията си приемаха с нежност“, казва глас зад кадър в „Жюл и Жим“ (1962), прочутия филм на Трюфо, в който двама приятели и магнетична млада жена образуват любовен триъгълник, изпълнен с приповдигната веселост и обречен на драматично разпадане. Същата е и постановката в „Птици, сираци и безумци“ (1969) – трима се срещат в развалините на неназована война и се щурат заедно до трагичната развръзка (думите са по-малко, гротеската – повече и сравненията обикновено вървят по линията Фелини и Ходоровски). Веднага след премиерата си филмът е „арестуван“ (реабилитацията идва 20 години по-късно), а на автора – словака Юрай Якубиско, е забранено да прави пълнометражно кино чак до 80-те.
Хаотичен, претенциозен („Щастието е бяла къща…“) и на места неволно жесток към хора и животни, „Птици, сираци и безумци“ е спорно велик, но безспорно любопитен. За 60-тото издание на фестивала в Карлови Вари той беше избран и представен от легендарната актриса в главната роля Магда Вашарьова (дългокосата Маришка в „Подстригване“ на Менцел и Маркета Лазарова в едноименната творба на Франтишек Влачил). „Всяка пролет на заседание в Пражката крепост [другарите] от ЦК на ЧКП гледаха този филм – каза тя, – за да си припомнят, че подобна свобода на художеството, мисълта и светогледа никога повече не бива да се допуска…“
Е, десетилетия по-късно ЧКП е статия в Уикипедия, а свободата, за щастие, продължава да не се дава лесно.
Авторката благодари сърдечно за подкрепата и приятелството на Хелена и Милан Русеви от Карлови Вари.
At Grab, AI agents have evolved from interesting team prototypes into production services used every day by millions of merchants, drivers, and consumers. Today, more than 500 services run on our internal agent framework, over 50 Model Context Protocol (MCP) servers are registered on our remote MCP framework, and a single Large Language Model (LLM) gateway fronts every model call across the company, handling billions of tokens each month.
None of this was designed up front. It began as the plumbing behind one internal support bot, which then expanded because the same problems kept resurfacing for every team trying to ship an agent. This series tells the story of what the platform eventually became. This Part 1 of the blog focuses on the beginning: the architecture of our AI support bot, the specific pain points we hit while scaling and iterating on it, and how each of those failures became a core building block in the framework we now call LLM-Kit.
The bot that started it
Imagine you have a question for the Technical Infrastructure (Tech Infra) team – the engineers who run the cloud platforms, databases, developer tooling, and AI infrastructure behind Grab’s ecosystem. Instead of immediately paging an on-call engineer, a bot first triages the request, checks the team’s documentation, runbooks, and past Slack threads, and tries to answer directly in the thread. If it still cannot resolve the issue, it routes the ticket to the right human, with the relevant context already attached.
That is what we built with the Tech Infra Support Bot.
In the first half of 2023, Tech Infra handled thousands of support tickets, many of them repeated questions that had already been answered somewhere internally. Before LLMs, the bot’s role was mainly operational; performing tasks like helping track acknowledgments and response times for on-call engineers. With the arrival of GPT-4-32k, we evolved it into a GPT-powered Level-0 support layer that could answer documented questions before a human needed to be paged.
The first production version was a Go service organized around two planes:
A reasoning plane. At Level-0, it was a single-agent loop. It takes the user’s question, decides which tools to call, executes those calls, feeds the results back into the prompt, and returns an answer. The default model at the time was gpt-4.1; today, we have evolved to the latest reasoning models.
A tool plane. The tools provided the bot’s core working context. Retrieval flowed through Glean, which covered Confluence, TechDocs, internal drives, and Jira. Other tools handled log search through Kibana, GitLab runbook and file access, Slack conversation search, and a small set of Hypertext Transfer Protocol (HTTP) plugins. In the first version, tools and prompts were defined in per-channel JavaScript Object Notation (JSON) configs and resolved at request time. As models became more capable, we later standardized the tool set across channels.
A trimmed version of that tool config looked like this:
It worked, but it taught us, the hard way, why a demo agent is not a production agent.
What it takes to scale and improve quickly
As we worked on improving the agent, we kept running into the same kinds of friction. Over time, those pain points formed clear patterns, and they were the same ones we saw other teams run into as well.
Vibe check is not an evaluation strategy. The bot had a base prompt, and each Slack channel could configure its own prompt, tools, and documentation filters. But the workflow was essentially: configure it, ship it, and hope it reduced toil. There were no real evaluations, just optimism that it would work.
Fast model and provider switching is essential. The AI landscape moves incredibly fast: a new state-of-the-art (SOTA) model appears on Tuesday, and a highly efficient open-source alternative shows up on Thursday. Switching providers should not feel like open-heart surgery. A unified Software Development Kit (SDK) and an LLM API gateway remove the need to refactor payload schemas, rewrite error handling, or integrate each provider from scratch. If moving from OpenAI to Anthropic, or routing to an open-source model endpoint, takes more than a few config changes, technical debt is already slowing you down.
Observability cannot be an afterthought. When an answer was wrong, figuring out “why” meant grepping logs across three separate systems: the agent workflow, the tool calls, and the model call. There was no shared trace tying them together. That level of friction is survivable for an internal tool; it is unacceptable for a customer-facing agent.
Everything around the agent took longer than the agent itself. Auth (OIDC), secrets management (Vault), per-environment config, vector database integration, LLM tracing, health probes, and metrics were not agent-specific problems. However, they all had to be solved before anything could be shipped. The reasoning loop took a whole afternoon. The production wrapper took two weeks.
The pattern was clear: the hard part of building an agent was not the agent itself, but everything around it that had to be in place before it could safely run in front of users. So we began pulling those shared components out of the bot and consolidating them into a unified framework.
Extracting the framework: LLM-Kit
LLM-Kit emerged when we stopped solving these problems service by service and started solving them once, centrally. It is intentionally not a new agent abstraction or a Domain-Specific Language (DSL). Instead, it is a curated set of integrations and scaffolding built around Grab’s existing infrastructure, pipelines, secret management, and observability. Just as importantly, we chose to build a framework rather than a heavy centralized platform. In a space evolving this quickly, a platform would have locked teams into rigid assumptions that would soon become outdated. A framework let us meet developers where they already were: standardizing the plumbing while preserving the freedom to iterate quickly. Looking back, that was the right first choice. Each part of LLM-Kit is a direct response to one of the failures described above.
We first wrote about LLM-Kit’s structure and code architecture in a 2024 blog post. Two years and a few hundred agents later, the overall shape is still recognizable, but almost every underlying layer has changed. Poetry was replaced by uv; we standardized on the OpenTelemetry stack; LangChain evolved into LangGraph and Deep Agents; and some tools moved onto our MCP framework.
It starts with a template. The entry point is a user interface (UI) form. An engineer fills in an application name and a few details, and gets back a GitLab repository with the production wrapper already assembled. Under the hood the template stamps out a full FastAPI service:
/
├── app/
│   ├── server.py              # FastAPI app factory: mounts routes + middleware, boots OTel + statsd
│   ├── agents/
│   │   ├── simple_react_agent.py   # a single-agent LangGraph ReAct loop (agent <-> tools)
│   │   ├── mcp_react_agent.py      # the same loop, but tools are pulled from remote MCP servers
│   │   └── simple_react_agent.png  # auto-exported graph diagram (generated in dev)
│   ├── routes/
│   │   ├── api.py             # router aggregator
│   │   ├── health_check.py    # liveness/readiness probe
│   │   ├── oidc.py            # OIDC login/callback (skipped in proxy-auth mode)
│   │   └── evalshub_eval.py   # runs ROUGE / BLEU / LLM-as-judge evals on the agent
│   ├── core/config.py         # AppConfig (pydantic-settings) + INI/secret parsing
│   ├── tools/word_length_tool.py   # an example tool to copy from
│   ├── utils/prompts.py       # prompt/message assembly helpers
│   └── storage/connection.py  # Postgres + pgvector engine and connection pooling
├── sdk/         # a generated, typed client SDK (protobuf) other services import
├── configs/
│   ├── dev.ini / stg.ini / prd.ini   # one config per environment
│   └── secret.ini.example     # secret template; real values resolve from Vault at deploy
├── databases/postgresql/      # SQL migrations (pgvector extension bootstrapped for you)
├── scripts/
│   ├── db.py / db.sh          # migration runner
│   └── gunicorn_conf.py       # production server/worker config
├── tests/
│   ├── unit_tests/            # starter unit tests (e.g. the health check)
│   └── evalshub_evaluation/   # golden test cases the eval route runs against
├── Dockerfile                 # multi-stage, distroless
├── Makefile                   # setup / run / test / lint targets
├── pyproject.toml             # uv build backend + pinned deps
└── .pre-commit-config.yaml
Three things are worth pulling out of that tree:
app/agents/ is the part you actually own. You get two working agents to fork from rather than a blank file: simple_react_agent.py is a single-agent LangGraph ReAct loop, and mcp_react_agent.py is the same loop wired to pull its tools from remote MCP servers. Both compile to a LangGraph StateGraph with a retry policy and a 30-second per-step timeout, and in dev the graph is auto-exported as a diagram. This is a real step up from the bare LangChain agent initialization we scaffolded in 2024.
app/routes/evalshub_eval.py ships evals on day one. The template comes with an endpoint that runs Recall-Oriented Understudy for Gisting Evaluation (ROUGE), Bilingual Evaluation Understudy (BLEU), and LLM-as-judge evaluators over a set of golden test cases in tests/evalshub_evaluation/. The thing we most wished the support bot had, is now in the box before a builder writes a line of their own logic.
Everything else is the production wrapper. core/config.py, storage/, configs/, databases/, scripts/, the distroless Dockerfile, and the pyproject.toml (now uv, not the Poetry we used in 2024) are the auth, secrets, persistence, packaging, and deploy plumbing that every service needs and that no team should have to write from scratch.
The day-one wiring that used to take two weeks or more now takes about an hour. The rest of this section is what “pre-wired” means, layer by layer.
Config and secrets are solved once. Apps declare environment configs as initialization (INI) files with secret interpolation, so secrets resolve from Vault at boot, and a single secret.ini.example is enough to run any LLM-Kit app locally:
Model access behind one resolver. Every model call goes through the GrabGPT Gateway, which is OpenAI-compatible. LLM-Kit’s job is just to resolve the right endpoint (per environment, and per data tier) and inject the key so application code never hard-codes a provider again:
That one indirection is what later lets a platform team change which provider serves a model, configure fallback routing, set budgets, and manage cost attribution, without a single application touching its code.
Tracing wired in, not bolted on. A single instrumentor auto-instruments FastAPI, outbound HTTP, LangChain, and MCP, and stamps every span with Kubernetes resource attributes (pod, namespace, image, service version). Structured logs auto-inject the trace and span IDs, so logs and traces correlate in Grafana/Kibana for free:
The three systems, no shared trace problem turns into one end-to-end trace across every LLM call, tool call, and retrieval step.
Tools can be exposed through MCP servers built on our MCP framework. Instead of hardwiring a large set of tool functions inside the agent process, the agent connects to MCP servers and discovers their tools at runtime. That means adding a new capability can be as simple as registering an MCP server, rather than redeploying the agent.
client=MultiServerMCPClient({"mcp-gitlab-remote":{"transport":"streamable_http","url":"<remote-mcp-gitlab-endpoint>/mcp/","headers":{"Authorization":"Bearer <token>"},}})tools=awaitclient.get_tools()# schema negotiated, no redeploy
An agent is just another service in the ecosystem, with gRPC on both sides. Most of Grab’s backend communicates over gRPC, and agents are rarely standalone; other services call them, and they in turn call other internal services. The template is designed to support both directions.
On the serving side, the scaffold includes a Protocol Buffers (protobuf) contract (sdk/.../.proto, with a sample Hello remote procedure call (RPC)) and a generated, typed client SDK package that other teams import to call your agent without hand-writing HTTP. make gen-proto regenerates the Python stubs from the .proto, and a gen-proto-check Continuous Integration (CI) step fails the build if the committed stubs drift from the contract. A gRPC server runs alongside FastAPI (default port 8087, multi-worker-safe via SO_REUSEPORT) and ships a standard gRPC health service out of the box:
On the calling side, LLM-Kit ships a channel provider so an agent never hardcodes an address. The auto provider tries Istio, then Consul, then a static fallback, health-checks the channel it selects, and runs a background monitor that re-selects after a few consecutive failures:
fromllm_kit.grpc.channel_providers.autoimport(AutoGrpcChannelProvider,AutoGrpcChannelProviderConfig,)provider=AutoGrpcChannelProvider(logger,AutoGrpcChannelProviderConfig(client_name="my-agent",service_key="some-internal-service",# resolved via Istio / Consul
enable_istio=True,enable_consul=True,))channel=provider.get_channel()# first healthy channel, auto-reselected on failure
stub=SomeServiceStub(channel)
This is the less glamorous side of being production-ready. Before an agent can deliver value, it needs to both accept calls from and make calls to the rest of the company’s services using the same transport the broader system already relies on.
What’s next
LLM-Kit solved building and shipping one agent. At 500 agents, the problems were no longer framework problems. They were platform problems: who can change which model everyone calls, how one team safely reuses another team’s tools, and how you know an agent got better and not just different after a prompt change. We built three answers for that layer: the GrabGPT Gateway, a remote MCP framework, and an evals platform. Part 2 starts with the gateway — one endpoint, five providers, and what it takes to make “swap the model” a configuration change instead of an incident.
Join us
Grab is Southeast Asia’s leading superapp, serving over 900 cities across eight countries (Cambodia, Indonesia, Malaysia, Myanmar, the Philippines, Singapore, Thailand, and Vietnam). Through a single platform, millions of users access mobility, delivery, and digital financial services, including ride-hailing, food delivery, payments, lending, and digital banking via GXS Bank and GXBank. Founded in 2012, Grab’s mission is to drive Southeast Asia forward by creating economic empowerment for everyone while delivering sustainable financial performance and positive social impact.
Powered by technology and driven by heart, our mission is to drive Southeast Asia forward by creating economic empowerment for everyone. If this mission speaks to you, join our team today!
I have just received the shocking news that Dan Williams, a longtime,
high-profile kernel developer, has passed away. I knew him primarily
through his long service on the Linux Foundation Technical Advisory Board;
he was always a strong, thoughtful, and intelligent presence. Dan will be
deeply missed.
There is a support
effort underway for Dan’s family as they come to terms with this loss.
The collective thoughts of the interwebz
Manage Consent
To provide the best experiences, we use technologies like cookies to store and/or access device information. Consenting to these technologies will allow us to process data such as browsing behavior or unique IDs on this site. Not consenting or withdrawing consent, may adversely affect certain features and functions.
Functional
Always active
The technical storage or access is strictly necessary for the legitimate purpose of enabling the use of a specific service explicitly requested by the subscriber or user, or for the sole purpose of carrying out the transmission of a communication over an electronic communications network.
Preferences
The technical storage or access is necessary for the legitimate purpose of storing preferences that are not requested by the subscriber or user.
Statistics
The technical storage or access that is used exclusively for statistical purposes.The technical storage or access that is used exclusively for anonymous statistical purposes. Without a subpoena, voluntary compliance on the part of your Internet Service Provider, or additional records from a third party, information stored or retrieved for this purpose alone cannot usually be used to identify you.
Marketing
The technical storage or access is required to create user profiles to send advertising, or to track the user on a website or across several websites for similar marketing purposes.