Lenovo ThinkPad P16 Gen 3 Review Portably Powerful

Post Syndicated from Ryan Smith original https://www.servethehome.com/lenovo-thinkpad-p16-gen-3-review-intel-nvidia-portably-powerful/

We review the Lenovo ThinkPad P16 Gen 3, a powerful Intel Arrow Lake-HX mobile workstation laptop with an NVIDIA RTX PRO 5000 Blackwell GPU

The post Lenovo ThinkPad P16 Gen 3 Review Portably Powerful appeared first on ServeTheHome.

A guide to capacity planning for Airflow worker pool in Amazon MWAA

Post Syndicated from Boyko Radulov original https://aws.amazon.com/blogs/big-data/a-guide-to-capacity-planning-for-airflow-worker-pool-in-amazon-mwaa/

In our previous post, A guide to Airflow worker pool optimization in Amazon MWAA, we explored when adding workers to your Amazon Managed Workflows for Apache Airflow (Amazon MWAA) environment actually solves performance issues, and when it doesn’t. We walked through patterns like high CPU utilization and long queue times where scaling may be appropriate, and anti-patterns like misconfigured Airflow settings and memory leaks where adding workers only masks the real problem. The key takeaway was clear: optimize first, scale second, and always let data drive the decision.

But what happens after you’ve done the optimization work? Your DAGs are efficient, your configurations are tuned, and your environment is running well. Then the business comes knocking: new regulatory requirements, additional data pipelines, expanded reporting. The workload is about to grow, and this time, you genuinely need more capacity.

This is where capacity planning comes in. Knowing how many workers to provision, before the new workload hits production, is the difference between a smooth rollout and a 5 AM SLA breach. In this post, we walk through a practical capacity planning framework for Amazon MWAA worker pools. Using a real-world financial services scenario, we show how to assess your current capacity, project future needs, calculate the right number of base workers, and set up monitoring to keep your environment healthy as workloads evolve.

Scenario: A financial services company needs to plan capacity for a 25% directed acyclic graph (DAG) increase to support new regulatory reporting requirements.

Current vs projected state

The following table compares the current and expected state after adding 25% more DAGs.


Metric Current Projected Change
1 DAGs 20 25 25%
2 Peak Tasks (5-7 AM) 80 104 +24 tasks
3 Environment Class mw1.medium mw1.medium No change
4 Base Workers 8 11 +3 workers
5 Tasks per Worker 10 (mw1.medium default) 10 No change
6 Available Capacity 80 slots (8 × 10) 110 slots (11 × 10) +30 slots
7 Peak Utilization 100% (80/80 slots) ⚠ 95% (104/110 slots) Improved
8 Critical SLA 7 AM market open 7 AM market open No tolerance

Capacity planning goal: Reduce utilization from 100% to 95% to maintain service level agreement (SLA) compliance and handle unexpected spikes.

Understanding current capacity: The environment currently runs 8 base workers, providing 80 concurrent task slots (8 workers × 10 tasks per worker). During the 5-7 AM peak with 80 concurrent tasks, this represents 100% utilization, a risky level that leaves no headroom for unexpected spikes or volatility.
With the planned addition of 5 new regulatory reporting DAGs, peak concurrent tasks will grow to 104. To maintain healthy operations with adequate buffer, we need to increase to 11 base workers (110 slots), resulting in 95% peak utilization with 6 slots of breathing room.

Why 100% utilization is risky: Running at 100% task utilization means:

  • Zero buffer for unexpected spikes
  • Any additional task causes immediate queuing
  • No room for market volatility or data volume increases
  • High risk of SLA breaches during unpredictable events

Best practice: Maintain at least 5-15% headroom (85-95% utilization) for production workloads with critical SLAs.

Why this sizing:

  • Current: 80 tasks ÷ 80 slots = 100% utilization (at capacity – risky!)
  • Projected: 104 tasks ÷ 110 slots = 95% utilization (healthy with buffer)
  • Buffer: 6 slots (5% headroom) protects against unexpected volatility spikes
  • SLA protection: Adequate headroom prevents queuing during normal operations

Capacity analysis

Every team asks the same critical question: “How many workers do I need?” The process is to identify your peak concurrent tasks from Amazon CloudWatch metrics, dividing by your environment’s tasks-per-worker capacity, and adding a 5%-15% safety buffer.

Step 1: Identifying peak concurrent tasks from Amazon CloudWatch

To determine your peak workload, you need to analyze RunningTasks and QueuedTasks CloudWatch metrics for your Amazon MWAA environment. Navigate to Amazon CloudWatch and query the following key metrics:

Primary metrics for capacity planning:

  • RunningTasks: Number of tasks currently executing across all workers. This shows your actual concurrent task load.
  • QueuedTasks: Number of tasks waiting for available worker slots. High values indicate insufficient capacity.
  • AvailableWorkers: Current number of active workers in your environment.

How to find peak concurrent tasks:

  1. Open the Amazon CloudWatch Console.
    • Choose Metrics.
    • Choose the MWAA namespace.
  2. Select your environment name.
  3. Add the RunningTasks metric.
  4. Set time range to last 7-30 days.
  5. Change statistic to Maximum.
  6. Identify the highest value during your peak hours (for example, 5-7 AM).

Example query:
Note: The following query is conceptual and does not directly translate to Amazon CloudWatch-specific language. Please refer to the Query your CloudWatch metrics with CloudWatch Metrics Insights for more information.

SELECT MAX(RunningTasks) AS PeakConcurrentTasks
FROM MWAA_Metrics
WHERE Environment = 'prod-airflow'
  AND timestamp BETWEEN '2024-10-01' AND '2024-10-31'
  AND HOUR(timestamp) BETWEEN 5 AND 7;

In our scenario, this analysis revealed 80 concurrent tasks during the 5-7 AM window. With the planned 25% DAG increase, we project this will grow to 104 concurrent tasks.

Step 2: Calculate required workers

To calculate the number of required workers without queuing any tasks, use the following formula: Peak concurrent tasks ÷ Tasks per worker × Safety buffer = Required workers

In the projected scenario with 104 tasks at peak hours, using mw1.medium environment with default concurrency configuration and having a 5% safety buffer, we need 11 workers

  • 104 peak tasks ÷ 10 tasks per worker × 1.06 buffer = 11 workers required to handle your workload without queuing during busiest periods.

Capacity monitoring and triggers

There are a few important Amazon CloudWatch metrics to monitor for environment health.

Key metrics to monitor

Monitor these five critical Amazon CloudWatch metrics to detect capacity issues:

  • QueuedTasks (>10 for >5 minutes indicates insufficient capacity)
  • RunningTasks (consistently at maximum suggests the need for more workers)
  • AdditionalWorkers (active for more than 6 hours daily signals the permanent worker problem)
  • Worker CPU (>85% sustained requires environment class upgrade or workload optimization)
  • Task Duration (+15% increase means reduced effective capacity per worker).

These metrics provide early warning signals to adjust capacity before SLA breaches occur.


Metric Threshold Action
1 QueuedTasks >10 for >5 minutes Investigate capacity
2 RunningTasks Consistently at max Increase base workers
3 AdditionalWorkers Active >6 hours daily Increase base workers
4 Worker CPU >85% sustained Upgrade environment class
5 Task Duration +15% increase Review capacity per worker

Amazon CloudWatch monitoring queries

Note: The following queries are conceptual and do not directly translate to Amazon CloudWatch-specific language. Please refer to the Query your CloudWatch metrics with CloudWatch Metrics Insights for more information.

  • Queue depth during peak hours
    SELECT AVG(QueuedTasks)
    FROM MWAA_Metrics
    WHERE Environment = 'prod-airflow'
      AND timestamp BETWEEN '05:00' AND '07:00'
    GROUP BY 5m;

  • Worker utilization efficiency
    SELECT AVG(RunningTasks) / AVG(AvailableWorkers * 5) * 100 AS UtilizationPercent
    FROM MWAA_Metrics
    WHERE Environment = 'prod-airflow';

  • Detect permanent worker problem
    SELECT DATE(timestamp) AS date,
           AVG(AdditionalWorkers) AS avg_additional,
           MAX(AdditionalWorkers) AS max_additional
    FROM MWAA_Metrics
    WHERE AdditionalWorkers > 0
    GROUP BY DATE(timestamp)
    HAVING AVG(AdditionalWorkers) > 5;

Setting up alerts

You can configure these alarms to identify problems as soon as they are introduced.

Recommended Amazon CloudWatch alarms:

  1. High queue depth alert
    • Metric: QueuedTasks
    • Threshold: > 10 for 2 consecutive 5-minute periods
    • Action: Notify operations team
  2. Permanent worker detection
    • Metric: AdditionalWorkers
    • Threshold: > 0 for 6+ hours
    • Action: Review capacity planning
  3. SLA risk alert
    • Metric: QueuedTasks during 5-7 AM window
    • Threshold: > 5 tasks
    • Action: Page on-call engineer

When to revisit capacity planning

Conduct quarterly scheduled reviews to analyze trends and project growth. Also run immediate trigger-based assessments when:

  • DAG count increases >10% (or more than your safety buffer)
  • Performance degrades
  • Cost anomalies appear (indicating permanent workers)
  • Any SLA breach occurs.

This dual approach provides proactive capacity management while enabling rapid response to emerging issues.


Trigger Frequency Action
1 Scheduled Review Quarterly Analyze trends, project growth
2 DAG Growth >10% increase Recalculate capacity needs
3 Performance Degradation As observed Immediate capacity assessment
4 Cost Anomalies Monthly Check for permanent workers
5 SLA Breaches Any occurrence Emergency capacity review

Decision matrix

The framework presents three capacity planning approaches, each optimized for different organizational priorities.

The Full Base Worker Provisioning strategy (the conservative path) sets base workers equal to the calculated requirement, eliminating queue times during peak periods and guaranteeing SLA compliance with predictable fixed costs, while automatic scaling handles only unexpected spikes—ideal for mission-critical workloads with strict SLA requirements.

The Minimal Base + Automatic Scaling approach (the cost-focused path) maintains minimal base workers at current levels and relies heavily on automatic scaling, accepting 3-5 minute delays during peak periods and SLA breach risks in exchange for lower baseline costs, though this requires intensive monitoring and carries explicit warnings about high SLA risk.

The Hybrid Approach (the balanced path) provisions base workers at 80% of the calculated requirement with automatic scaling covering the remaining 20%, resulting in 2-3 minute delays during spikes while balancing cost against performance—suitable for moderate SLA requirements with some budget constraints.

The comparison table contrasts queue times (under 30 seconds versus 2-3 minutes versus 3-5 minutes), SLA compliance levels (guaranteed versus high probability versus at-risk during peak), and ideal use cases (mission-critical predictable workloads versus moderate SLA requirements with budget constraints versus development environments with flexible SLA tolerance), enabling teams to make informed provisioning decisions aligned with their operational requirements and financial constraints.

Key takeaway

Effective capacity planning prevents both under-provisioning (SLA breaches) and over-provisioning (cost overruns).

Capacity planning principles

  1. Calculate capacity needs BEFORE adding workload – Use peak task projections with 5-15% safety buffer
  2. Size minimum workers for peak demand – Don’t rely on automatic scaling for predictable loads
  3. Use automatic scaling only for unexpected spikes – Treat as safety net, not primary capacity
  4. Target 85-95% utilization during peak hours – Ensures headroom for unexpected growth
  5. Plan 5-15% headroom for unexpected growth – Production often differs from testing
  6. Monitor AdditionalWorkers metric – If active >6 hours daily, increase base workers
  7. Review quarterly + trigger-based assessments – Regular reviews plus immediate action on issues
  8. Balance cost and performance based on SLA criticality – Business impact justifies infrastructure investment

Success metrics

  • Queue efficiency: Average queue time <30 seconds during peak
  • SLA compliance: >99.5% of critical tasks complete on time
  • Resource utilization: 85-95% during peak hours (optimal efficiency)
  • Cost predictability: <10% variance in monthly worker costs

Conclusion

Capacity planning is not a one-time exercise. It’s an ongoing discipline. The framework we’ve outlined gives you a repeatable process: measure your current peak utilization through CloudWatch metrics, project growth based on incoming workloads, calculate the required workers with an appropriate safety buffer, and monitor continuously to catch drift before it becomes an outage.

The financial services scenario in this post illustrates a common reality: running at 100% utilization during peak hours leaves zero room for the unexpected. By sizing to 95% peak utilization with a modest buffer, the team gained the headroom needed to absorb volatility without risking their 7 AM market-open SLA.

Whether you choose full base worker provisioning for mission-critical pipelines, a hybrid approach for moderate SLA requirements, or lean on automatic scaling for development workloads, the right strategy depends on your business context, not a one-size-fits-all rule. Pair your capacity plan with the CloudWatch alarms and review triggers we covered, and you’ll catch capacity gaps early.

Combined with the optimization-first approach from Part 1, you now have a complete toolkit: diagnose before you scale, optimize before you provision, and plan before you deploy. Your MWAA environment and your on-call engineers will thank you.

To get started, visit the Amazon MWAA product page and the Amazon MWAA console page.

If you have questions or want to share your MWAA capacity planning, leave a comment.

About the authors

Boyko Radulov

Boyko Radulov

Boyko is a Senior Cloud Support Engineer at Amazon Web Services (AWS), Amazon MWAA and AWS Glue Subject Matter Expert. He works closely with customers to build and optimize their workloads on AWS while reducing the overall cost. Beyond work, he is passionate about sports and travelling.

Kamen Sharlandjiev

Kamen Sharlandjiev

Kamen is a Principal Big Data and ETL Solutions Architect, Amazon MWAA and AWS Glue ETL expert. He’s on a mission to make life easier for customers who are facing complex data integration and orchestration challenges. His secret weapon? Fully managed AWS services that can get the job done with minimal effort. Follow Kamen on LinkedIn to keep up to date with the latest Amazon MWAA and AWS Glue features and news.

Venu Thangalapally

Venu Thangalapally

Venu is a Senior Solutions Architect at AWS, based in Chicago, with deep expertise in cloud architecture, data and analytics, containers, and application modernization. He partners with financial service industry customers to translate business goals into secure, scalable, and compliant cloud solutions that deliver measurable value. Venu is passionate about using technology to drive innovation and operational excellence.

Harshawardhan Kulkarni

Harshawardhan Kulkarni

Harshawardhan is a Partner Technical Account Manager at AWS, Amazon MWAA Subject Matter Expert. Based in Dublin Ireland, he partners with Enterprise Customers across EMEA to help navigate complex workflows and orchestration challenges while ensuring best practice implementation. Outside of work, he enjoys traveling and spending time with his family.

Andrew McKenzie

Andrew McKenzie

Andrew is a Data Engineer and Educator who uses deep technical expertise from his time at AWS. As a former Amazon MWAA Subject Matter Expert, he now focuses on building data solutions and teaching data engineering best practices.

A guide to Airflow worker pool optimization in Amazon MWAA

Post Syndicated from Boyko Radulov original https://aws.amazon.com/blogs/big-data/a-guide-to-airflow-worker-pool-optimization-in-amazon-mwaa/

Optimizing the Airflow worker pool configuration in Amazon Managed Workflows for Apache Airflow (Amazon MWAA), the AWS fully managed Apache Airflow service, is an important yet often overlooked strategy for scaling workflow operations. Tasks queued for longer periods can create the illusion that additional workers are the solution, when in reality the root cause might lie elsewhere. The decision to scale isn’t always straightforward. DevOps engineers and system administrators frequently face the challenge of determining whether adding more workers will solve their performance issues or only increase operational cost without addressing the root cause.

This post explores different patterns for worker scaling decisions in Amazon MWAA, focusing on the task pool mechanism and its relationship to worker allocation. By examining specific scenarios and providing a practical decision framework, this post helps you determine whether adding workers is the right solution for your performance challenges, and if so, how to implement this scaling effectively.

Main patterns

This section discusses the most frequently seen problems that raise the question if adding additional workers would improve the health of your environment.

High CPU

Airflow serves as a workflow management platform that coordinates and schedules tasks to be run on external processing services. It acts as a central orchestrator that can trigger and monitor tasks across various data processing systems like AWS Glue, AWS Batch, Amazon EMR, and other specialized data processing tools. Rather than processing data itself, Airflow’s strength lies in managing complex workflows and coordinating jobs between different systems and services.

In Analytics and Big Data environments, there is a prevalent misconception that saturated resources automatically warrant adding more capacity. However, for Amazon MWAA, understanding your workflow characteristics and optimization opportunities should precede scaling decisions.

As you scale up your workflows, resource utilization of the Airflow clusters naturally increases. When workers consistently operate at full capacity, it may seem intuitive to add additional compute resources. However, this approach often masks underlying inefficiencies rather than resolving them.

For example, in Amazon MWAA if you are running a single task that is consuming 100% of the available CPU on your Amazon MWAA worker, adding additional workers will not resolve the problem as the task is not optimized nor split into smaller parts. As such, increasing the number of minimum workers will not bring the expected effect but will only increase the operating costs.

When your Amazon MWAA workers are consistently running above 90% CPU or Memory utilization, you’ve reached a critical decision point. Before taking actions, it is essential to understand the root cause. You have three primary options:

  1. Scale horizontally by adding additional workers to distribute the load.
  2. Scale vertically by upgrading to a larger environment class for more resources per worker.
  3. Optimize your DAGs and scheduling patterns to be more efficient and consume fewer resources.

Each approach addresses different underlying issues, and choosing the right path depends on identifying whether you are facing a capacity constraint, resource-intensive task design, or workflow inefficiency. For guidance on optimization strategies, please refer to Performance tuning for Apache Airflow on Amazon MWAA.

To monitor the CPUUtilization and MemoryUtilization on the workers, refer to the Accessing metrics in the Amazon CloudWatch console and choose the corresponding metrics.

  1. Select a time window long enough to show usage patterns.
  2. Set period to 1 Minute.
  3. Set statistics to Maximum.

Long queue time

Sometimes Airflow tasks are stuck in a queued state for a long time, which prevents DAGs from completing on time.

In Amazon MWAA, each environment class comes with configured minimum and maximum worker nodes. Each worker provides a pre-configured concurrency, which is the number of tasks that can run simultaneously on each worker at any given time. The behavior is controlled through celery.worker_autoscale=(max,min).

For example, if you have minimum 4 mw1.small workers, with default Airflow configuration, you will be able to run 20 concurrent tasks (4 workers x 5 max_tasks_per_worker). If your system suddenly requires more than 20 tasks to execute concurrently, this will result in an autoscaling event. Amazon MWAA will decide how to scale your workers efficiently, and trigger the process. The autoscaling process, however, requires additional time to provision new workers resulting in additional tasks in queued status. To mitigate this queuing issue, consider the following:

  1. If the CPU utilization on the workers is low, increasing the max value in celery.worker_autoscale=(max,min) can reduce the time tasks stay in queued state as each worker will be able to process more tasks concurrently. Airflow worker can take tasks up to the defined task concurrency regardless of the availability of its own system resources. As a result, the base worker may reach 100% CPU/Memory utilization before Autoscaling takes effect.
  2. If you do not want to increase the task concurrency on the workers, increasing the minimum worker count can also be beneficial because having more available workers allows a higher number of tasks to run concurrently.

Scheduling delays

Adding new DAGs can not only affect your system resources, but it can also create uneven scheduling patterns. Some DAGs may experience delayed execution because of resource competition, even when the overall environment metrics appear healthy. This scheduling skew often manifests as inconsistent task pickup times, where certain workflows consistently wait longer in the queue while others execute promptly.

When Amazon CloudWatch metrics show increasing variance in task scheduling times, particularly during periods of high DAG activity, it signals the need for environment optimization. This scenario requires careful analysis of execution patterns and resource utilization to determine if:

  1. While adding workers can help distribute the workload, this solution is most effective when the high utilization is primarily because of task execution load rather than DAG parsing or scheduling overhead. Adding more minimum workers will allow you to execute more tasks in parallel. For example, if you observe the value of AWS/MWAA/ApproximateAgeOfOldestTask to be steadily increasing, it means that the workers are not able to consume the messages from the queue fast enough. Additionally, you can also monitor the AWS/MWAA/QueuedTasks to identify similar patterns.
  2. Upgrading the environment class would provide better scheduling capacity. If the Scheduler is showing signs of strain or if you’re seeing high resource utilization across all components, upgrading to a larger environment class might be the most appropriate solution. This provides more resources to both the Scheduler and Workers, allowing for better handling of increased DAG complexity and volume. To validate the same, use AWS/MWAA/CPUUtilization and AWS/MWAA/MemoryUtilization in the Cluster metrics and choose Scheduler, BaseWorker and AdditionalWorker metrics.
  3. Restructuring DAG schedules would reduce resource contention.

The key is to understand your workflow patterns and identify whether the scheduling delays are because of insufficient worker capacity or other environmental constraints.

Anti patterns

This section showcases the most common anti patterns which make MWAA users think that adding more workers will improve performance.

Underutilized workers

When evaluating Amazon MWAA performance bottlenecks, it’s important to distinguish resource constraints and DAG design inefficiencies before scaling the environment.

Sometimes the Amazon MWAA environment has the capacity to run 100 tasks concurrently but your queue metrics (AWS/MWAA/RunningTasks) show only 20 tasks active most of the time with no tasks remaining in queued state. In such scenarios, you are advised to check Amazon CloudWatch for consistently low CPU and memory usage on existing workers during peak workload times. If this is confirmed, it is usually an indication of inefficiencies in DAG design, scheduling patterns, or Airflow configuration.

You have two primary options to address this:

1. Downsize: If you do not expect your workload to increase, it is safe to assume you have over-provisioned your cluster. Start by removing any extra workers first and finally resolve to downsizing your environment class.

2. Optimize: Fine tune your DAG scheduling and airflow configuration through Pools and Airflow configuration for concurrency to increase the throughput of your system.

Misconfigured Airflow configurations that create artificial bottlenecks

In Apache Airflow, performance bottlenecks often occur because of configuration settings, not actual resource constraints. At such times, DAG executions get delayed not because of insufficient compute, but because of incorrect concurrency configuration.

Efficient use of Amazon MWAA requires reviewing not only resource utilization for Workers and Schedulers but also concurrency configurations for artificially created bottlenecks. Sometimes one restrictive configuration prevents the scaling benefits of larger environment or additional workers. Always audit Airflow configurations if performance seems limited even when system metrics suggest spare capacity.

Important consideration: Amazon Managed Workflows for Apache Airflow (Amazon MWAA) does not automatically update the worker concurrency configuration when you change the environment class. This behavior is important to understand when scaling your environment. If you initially create an mw1.small environment, where each worker can handle up to 5 concurrent tasks by default. When you upgrade to a medium environment class (which supports 10 concurrent tasks per worker by default), the concurrency setting remains at 5 for in-place updated environments. You must manually update the concurrency configuration to take full advantage of the increased capacity available in the medium environment class.

Because of this you need to also update the Airflow configurations that control concurrency whenever you update the environment class. To update the concurrency setting after upgrading your environment class, modify the celery.worker_autoscale configuration in your Apache Airflow configuration options. This makes sure your workers can process the maximum number of concurrent tasks supported by your new environment class.

Other times, an Amazon MWAA environment can be constrained by max_active_runs or DAG concurrency controls instead of actual resource limits. These configuration-based throttles prevent tasks from running, even when the worker instances have available compute to handle the workload.

There is an important distinction between the two. Configuration limits act as artificial caps on parallelism, while true resource limits indicate that workers are fully utilizing their CPU or memory capacity. Understanding which type of constraint affects your environment helps you determine whether to adjust configuration settings or scale your infrastructure.

Adjusting Airflow configurations such as Pools, concurrency, max_active_runs solves performance problems without scaling workers. Some of the configurations you can use to control this behavior:

  1. max_active_runs_per_dag (DAG level): Controls how many DAG runs for a given DAG are allowed at the same time. If set to 2, only 2 DAG runs can run concurrently, even if there is plenty of worker capacity left. Extra runs queue, making the DAG executions slow even though workers are idle.
  2. max_active_tasks:Controls the concurrency field in a DAG definition (or setting at environment level) limits the number of tasks from the DAG running at any moment, regardless of overall system capacity or number of workers.
  3. Pools:Pools restrict how many tasks of a certain type (often resource heavy) can run at once. A pool with only 3 slots will throttle any tasks above 3 assigned to that pool, leaving workers idle.
  4. Execution timeouts and retries: If not tuned, failed tasks might fill up slots unnecessarily, stuck tasks can block worker slots and slow queue processing.
  5. Scheduling intervals and dependencies: Overlapping or inefficient scheduling may cause idle periods or excess contention for resources, affecting real throughput.

How Airflow configurations can override each other

Airflow has multiple layers of concurrency and scheduling controls. Some at the environment level, some at the DAG/task level, and others for pools. Sometimes more restrictive settings override more permissive ones, resulting in unexpected queue buildup.

DAG level vs Environment level: If “max_active_runs_per_dag” (DAG level) is lower than the environment-level “max_active_runs_per_dag” or system wide concurrency, the DAG setting is used, throttling tasks even if the environment could do more.

Task level overrides: Individual task definitions can have their own parameters like “max_active_tis_per_dag” which can cap runs per task and create a bottleneck if set lower than global settings.

Order of precedence: The most restrictive relevant configuration at any level (Environment, DAG, Task) effectively sets the upper bound for parallel task execution.

Setting Location Setting Effect on task throughput
Environment Level parallelism Max total tasks running on Scheduler
DAG Level max_active_runs Max simultaneous DAG runs
Task Level concurrency Max concurrent task for that DAG

Performance issues often resemble resource exhaustion, but actually derive from overly restrictive configurations. Audit all the preceding parameters carefully. You can loosen restrictive values step by step and monitor their effect before deciding to scale your cluster further. This approach ensures optimal and cost-efficient usage of your cloud resources without paying for idle capacity.

Slow resource depletion from memory leaks

A common scenario for memory leak or slow resource depletion in Amazon MWAA is when DAGs and tasks begin to fail or slow down over time. Scaling workers or increasing environment size does not resolve the underlying issue. This happens because the root cause is not a lack of capacity but rather an application-level leak that causes persistent exhaustion.

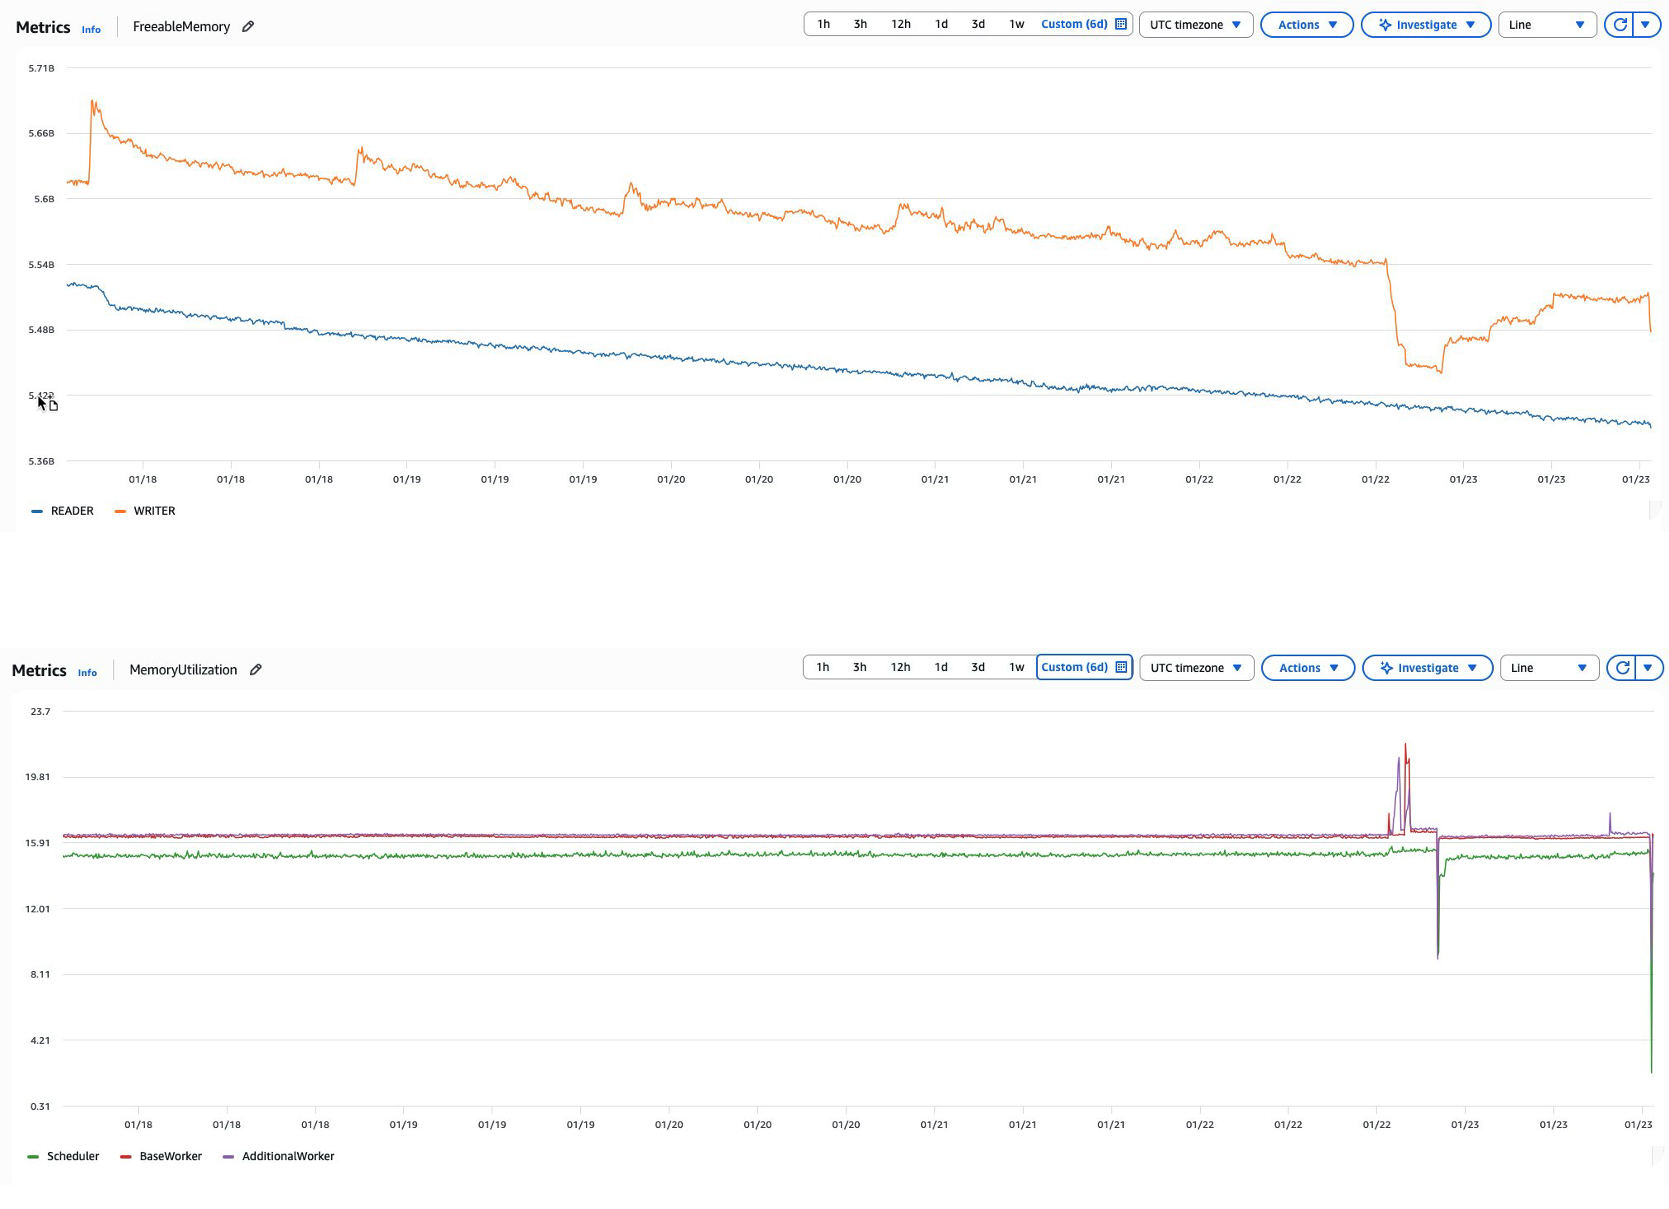
For example, as Airflow continuously runs tasks and parses DAGs over time, memory consumption can steadily increase across the environment. This might manifest as an Amazon MWAA metadata database experiencing declining FreeableMemory metrics despite consistent or even reduced workloads. When this occurs, database query performance gradually declines as memory resources become constrained for scheduler/worker & metadata database, ultimately affecting overall environment responsiveness since Airflow depends heavily on its metadata database for critical operations. This scenario is similar to how an application might create database connections without properly closing them, leading to resource exhaustion over time.

Graph: Declining FreeableMemory and MemoryUtilization

Common causes:

  1. Connection pool exhaustion: DAGs that fail to properly close database connections can lead to connection pool exhaustion and memory leaks in the database.
  2. Resource-intensive operations: Complex, long-running queries or XCOM operations against the metadata database can consume excessive memory.
  3. Inefficient DAG design: DAGs with numerous top-level Python calls can trigger database queries during DAG parsing. For instance, using variable.get() calls at the DAG level rather than at the task level creates unnecessary database load.

Recommended solutions:

  1. Implement Amazon CloudWatch monitoring: Establish Amazon CloudWatch alarms for FreeableMemory with appropriate thresholds to detect issues early.
  2. Regular database maintenance: Perform scheduled database clean-up operations to purge historical data that is no longer needed.
  3. Optimize DAG code: Refactor DAGs to move database operations like variable.get() from the DAG level to the task level to reduce parsing overhead.
  4. Connection management: Make sure all database connections are properly closed after use to prevent connection pool exhaustion.

By following the preceding recommendations you can maintain healthy memory utilization for the metadata database and maintain optimal performance of your Amazon MWAA environment without needing to scale workers.

Conclusion

The decision to add workers in Amazon MWAA environments requires careful consideration of multiple factors beyond simple task queue metrics. In this post, we showed that while adding workers can address certain performance challenges, it’s often not the optimal first response to system bottlenecks.

Key considerations before scaling workers include:

  1. Root cause analysis
    • Verify whether high CPU/memory usage stems from task optimization issues.
    • Examine if queuing problems result from configuration constraints rather than resource limitations.
    • Investigate potential memory leaks or resource depletion patterns.
  2. Configuration optimization
    • Review and adjust Airflow parameters (concurrency settings, pools, timeouts).
    • Understand the interaction between different configuration layers.
    • Optimize DAG design and scheduling patterns.

The most successful Amazon MWAA implementations follow a systematic approach: first optimizing existing resources and configurations, then scaling workers only when justified by data-driven capacity planning. This approach ensures cost-effective operations while maintaining reliable workflow performance.

Remember that worker scaling is only one tool in the Amazon MWAA optimization toolkit. Long-term success depends on building a comprehensive performance management strategy that combines proper monitoring, proactive capacity planning, and continuous optimization of your Airflow workflows.

In the next post, we discuss capacity planning and the steps you need to perform before adding additional DAGs in your environment so that you can plan for the additional load and make sure you have enough headroom.

To get started, visit the Amazon MWAA product page and the Performance tuning for Apache Airflow on Amazon MWAA page.

If you have questions or want to share your MWAA scaling experiences, leave a comment below.

About the authors

Boyko Radulov

Boyko Radulov

Boyko is a Senior Cloud Support Engineer at Amazon Web Services (AWS), Amazon MWAA and AWS Glue Subject Matter Expert. He works closely with customers to build and optimize their workloads on AWS while reducing the overall cost. Beyond work, he is passionate about sports and travelling.

Kamen Sharlandjiev

Kamen Sharlandjiev

Kamen is a Principal Big Data and ETL Solutions Architect, Amazon MWAA and AWS Glue ETL expert. He’s on a mission to make life easier for customers who are facing complex data integration and orchestration challenges. His secret weapon? Fully managed AWS services that can get the job done with minimal effort. Follow Kamen on LinkedIn to keep up to date with the latest Amazon MWAA and AWS Glue features and news.

Venu Thangalapally

Venu Thangalapally

Venu is a Senior Solutions Architect at AWS, based in Chicago, with deep expertise in cloud architecture, data and analytics, containers, and application modernization. He partners with financial service industry customers to translate business goals into secure, scalable, and compliant cloud solutions that deliver measurable value. Venu is passionate about using technology to drive innovation and operational excellence.

Harshawardhan Kulkarni

Harshawardhan Kulkarni

Harshawardhan is a Partner Technical Account Manager at AWS, Amazon MWAA Subject Matter Expert. Based in Dublin Ireland, he partners with Enterprise Customers across EMEA to help navigate complex workflows and orchestration challenges while ensuring best practice implementation. Outside of work, he enjoys traveling and spending time with his family.

Andrew McKenzie

Andrew McKenzie

Andrew is a Data Engineer and Educator who uses deep technical expertise from his time at AWS. As a former Amazon MWAA Subject Matter Expert, he now focuses on building data solutions and teaching data engineering best practices.

[$] Version-controlled databases using Prolly trees

Post Syndicated from daroc original https://lwn.net/Articles/1068864/

Modern database and filesystems make pervasive use of

B-trees
, which are tree
structures optimized for storing sorted lists of keys and values on block
devices.

Dolt
is an Apache 2.0-licensed project that makes clever use of a
variant of a B-tree to support efficient version control for an entire database.
The data structure it uses could well be of interest to other projects.

Security updates for Friday

Post Syndicated from jzb original https://lwn.net/Articles/1070848/

Security updates have been issued by AlmaLinux (fence-agents), Debian (chromium, dovecot, and kernel), Fedora (chromium, dotnet10.0, dotnet8.0, dotnet9.0, emacs, glow, jfrog-cli, openbao, pyp2spec, python3.6, rust-rustls-webpki, vhs, and xen), Oracle (grafana, grafana-pcp, PackageKit, sudo, vim, and xorg-x11-server), Red Hat (rhc), SUSE (avahi, bouncycastle, chromium, container-suseconnect, firewalld, gdk-pixbuf, grafana, java-25-openjdk, kernel, libixml11, libmozjs-140-0, libpng12-0, libsodium, libssh, mariadb, Mesa, ntfs-3g_ntfsprogs, openCryptoki, openexr, packagekit, prometheus-postgres_exporter, python-jwcrypto, python-mako, python-Pygments, python-pynacl, python311, python311-pyOpenSSL, python315, radare2, sed, and vim), and Ubuntu (kmod and zulucrypt).

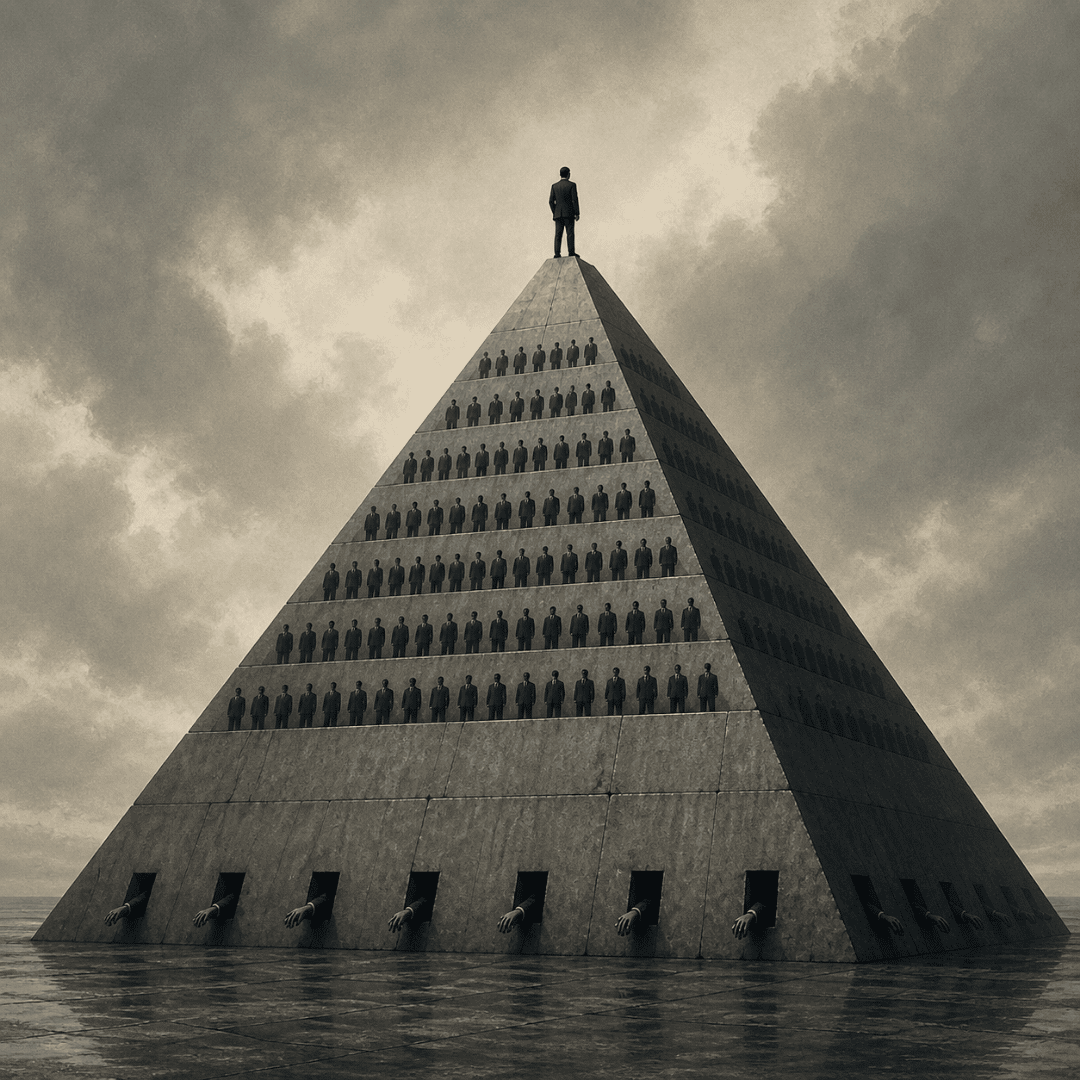
Пирамидата

Post Syndicated from Емилия Милчева original https://www.toest.bg/piramidata/

Пирамидата

От „завладяна държава“ 1.0 България минава към версия 2.0, сменяйки модела на концентрация на власт. Абсолютното мнозинство от 131 депутати около Румен Радев предполага стабилност и бързо съставяне на правителство. Радев обеща това да стане до 15 май, по-малко от месец след изборите. Само правителството на БСП–ДПС през 2013 г. беше сформирано за по-кратко време – за 17 дни. 

Вместо мрежи на влияние, подчинени на олигархична фигура, която държи за заложници лидери и партии, сега се очертава модел на централизирано политическо мнозинство по армейски образец. Новите политици обещават да разградят обвързаностите от миналото, но по-вероятно е само да опростят каналите за влияние.

Няма кой да им противостои. Срещу тях е една раздробена опозиция в лицето на ГЕРБ–СДС, разделилите се ден преди старта на новия парламент „Продължаваме промяната“ (ПП) и „Демократична България“ (ДБ) и „Възраждане“. Номинално и ДПС – Ново начало е в този лагер. Никоя от изброените партии не може да се превърне в ядро, около което да се обединят останалите при ерозия на бездруго отслабената демокрация. 

Избирателите оставиха България без имунна система срещу заплахата от автокрация, а егото на партийни лидери и калкулациите за колаборация довършиха останалото. 

А на страната на Румен Радев е туитът на американския президент Тръмп: 

Този, който спасява държавата си, не нарушава никакъв закон. 

Тоест всяко беззаконие и всеки съюзник могат да бъдат оправдани с висока цел, например демонтаж на „олигархичния модел“. 

Правителство до 15 май

Погледите са вперени в изгряващата звезда на „Прогресивна България“ и в бъдещия премиер. До конституирането на 52-рия парламент Радев беше потънал в мълчание, ограничавайки публичната си комуникация до постове в социалните мрежи. Кой главнокомандващ предварително съобщава на войниците за плановете си? Те са длъжни да го следват и да изпълняват заповедите му. 

Мълчанието на Радев струва злато
Наблюдаваме феномена „Румен Радев на Шрьодингер“. Докато мълчи, той едновременно е срещу корупцията и мафията в правосъдието, за диалог с Русия, против еврото, за ЕС… Това ще свърши с обявяването на партийните му листи. И после? Коментар от Емилия Милчева.
Пирамидата

Но на входа на парламента, заобиколен от надвикващи се журналисти, Радев не беше така енигматичен – „ще стабилизираме финансите, които са в катастрофално състояние“, „няма да правим министерство на културизма (сливане на министерствата на културата и на туризма – б.а.)“. 

За председател на парламента бе избрана 41-годишната юристка от „Прогресивна България“ Михаела Доцова, която ръководеше кабинета на екоминистъра Манол Генов (БСП).

Очаква се още в първите 100 дни от управлението Радев да демонстрира сила и контрол, защото сам каза, че „хората очакват бързи промени“. Смените в регулатори, служби, митници, НАП, държавни фирми и предприятия няма да се отлагат, но ще вървят паралелно със заявените приоритети: бюджет за 2026 г., подготовка на закони, свързани с Плана за възстановяване и устойчивост (ПВУ), и избор на нов състав на Висшия съдебен съвет и на Инспектората към ВСС. 

Механизмите, по които ще се извърши подборът на кандидатите за ВСС, ще покажат дали Радев търси верни „въшки“, по израза на Йордан Стоев от настоящия ВСС за колегите му, или почтени професионалисти. 

Освен бюджета и политиките за разходи, които ще заложи, от значение са законопроектите по ПВУ. „Имаме свои идеи“, отговори Радев на въпрос дали ще използва разработени предложения от служебния правосъден министър Андрей Янкулов. Става въпрос за нов антикорупционен закон и съставяне на антикорупционен орган, за които Европейската комисия е поставила срок – 4 май, който вероятно ще бъде предоговорен. Заради неизпълнението на тази реформа са замразени над 360 млн. евро по второто и третото плащане. 

Янкулов предлага нов антикорупционен закон, с който отново да бъде създадена Комисия за противодействие на корупцията (КПК). Идеята е да се гарантира политическа неутралност. Проектът му предвижда КПК да е петчленна, за разлика от предишната тричленка – с по един представител на Народното събрание, президента, Върховния касационен съд, Върховния административен съд и Висшия адвокатски съвет; с петгодишен мандат, без право на преизбиране.

Заради неизпълнени ангажименти в енергетиката по ПВУ – закон, свързан с ВЕИ сектора, и преструктурирането на БЕХ, за да бъдат извадени от холдинга „Мини Марица-изток“ и ТЕЦ „Марица-изток 2“ България може да загуби други над 440 млн. евро. Остава несигурността за миньорите в Маришкия басейн, които не искат съкращения, а настояват да получават настоящите си възнаграждения. 

Радев, ще удряш ли с юмрука?
Абсолютното мнозинство дава възможност за бързи решения без оправдания. Първият тест е кадровият – ВСС, главен прокурор, регулатори. От него ще се види към обещаната промяна ли се върви, или „юмрукът“ ще пренарежда същата система с други лица. От Емилия Милчева.
Пирамидата

(Не)възможната съпротива

Проблемът не е в абсолютното мнозинство – такава е волята на суверена, а в липсата на работещи институции и механизми на българската парламентарна демокрация. Ако управлението на Радев залитне към евразийски модели, не е сигурно дали ще предизвика силен протестен отпор.

Показателни в това отношение са няколко сценария. Например ако ПБ реши да одобри законопроекта на „Възраждане“ за чуждестранните агенти, насочен срещу неправителствени организации и лица, получаващи финансиране от чужбина. Лидерът на „Възраждане“ Костадин Костадинов упорства и го внася в няколко поредни парламента. Подобен закон действа и в Русия.

Или ако депутатите на ПБ отменят споразумението с Украйна в сферата на сигурността, сключено от служебното правителство на Андрей Гюров. Такъв опит беше направен в разгара на предизборната кампания и получи подкрепата на всички формации в 51-вия парламент без ПП–ДБ, но липсата на кворум накрая попречи на гласуването. 

Отива ли България там, откъдето Унгария се връща?
Унгария затваря цикъл, а България сякаш е на прага на нов. Между фигурата на „спасителя“, руското влияние и отслабващите институции стои въпросът „Накъде завиваме ние?“. Коментар на Светла Енчева.
Пирамидата

Още в първия ден на парламента обаче председателят на групата на ПБ Петър Витанов, бивш евродепутат от ПЕС/БСП, атакува кабинета на Гюров заради споразумението. А избраният от президента Радев конституционен съдия проф. Янаки Стоилов шокира мнозина със забележката си в БНТ дали не е време да променят дизайна на студиото, където преобладават цветовете на Украйна – синьо и жълто. В същото студио той обаче постави и съществен въпрос:

Имаме ли нужда от постоянен Висш съдебен съвет? Вместо това да осигури по-голямо самоуправление и независимост на съдебната власт, доведе до откъсване на тези, които управляват съдебната власт, от хората, които са адресати на управлението. Дори допълнително овластяване, защото ВСС е замислен преди всичко като кадрови орган, а не просто като една система за управление на всякакви въпроси на съдебната власт.

Снишаване и смълчаване

От лагера на опозицията се чува единствено как ръмжат един срещу друг ПП и ДБ. Също и шумът от натискане на копчетата, когато ГЕРБ–СДС и ДПС – Ново начало подкрепиха Доцова за председател на парламента заедно с партията на Радев.

ГЕРБ се топи, а Бойко Борисов се страхува. Зает е да охранява остатъка от онова-което-има-като-партия, тъй като и кметове, и „клиенти“, и бизнес се изплъзват към Радев. Напускането на ръководството на ГЕРБ от знакова фигура – кмета на Стара Загора Живко Тодоров, който кара четвърти мандат, е знак за ерозия. С наближаването на местните избори догодина нейният мащаб ще става все по-видим. От парламента се отказа и друг политик от ГЕРБ – бившият правосъден министър и бивш председател на Столичния общински съвет Георги Георгиев, който е избрал адвокатската кантора, макар да имаше нескрити амбиции в политиката. 

Делян Пеевски се е смълчал, за да не бие на очи. След периода си на медийна доминация санкционираният за корупция олигарх се появи в първия ден на новия парламент на първия ред, демонстрирайки добро настроение. 

За онази част от ДПС, която остана вярна на Ахмед Доган, обаче се очаква да получи позиции в изпълнителната власт. Радев направи пробив в относително монолитния, макар и спадащ през годините етнически вот, въпреки наратива си за „турското робство“ в свое изявление три дни преди вота.

Една политическа общност, която трудно събира 7% обществена подкрепа, която се срамува от нашата история, от българското знаме, от думичката „родолюбие“ и която я е страх да каже кой ни е освободил от турско робство, си мисли, че властта ѝ се полага по право и иска да управлява. Те много добре разбират, че не могат да спечелят изборите, и затова от някакви измислени НПО-та изскочиха сигнали за социални мрежи и внушения, насочени към „Прогресивна България“, по които служебното правителство сезира Европейската комисия, да активира европейските механизми за защита от външни хибридни влияния. Не е ясно дали тази общност осъзнава какво върши и че омаскарява България, че ние тук сме зависими от някакви влияния. Никой отвън не може да дойде и да ни каже за кого и за какво да гласуваме. Това решаваме тук ние, българите. На 19 април ще покажем на тази общност, че няма да стане по този начин.

На изборите на 19 април „Прогресивна България“ е трета в Турция със 17,3% от гласовете, след ДПС (53,1%) и Алианса за права и свободи (21,1%). В 9-ти МИР Кърджали, където ДПС обикновено печели и петте мандата, ПБ и „Възраждане“ взеха по един.

В България ДПС и АПС заедно събират малко над 280 000 гласа – твърде слаб резултат, който показва, че старите механизми на етнически вот, нагласени в началото на Прехода, вече ръждясват. Самият вот намалява, а все повече български граждани от турски произход избират други партии извън капсулата ДПС. 

Междувременно във „Възраждане“ са разбрали, че танцът им в политиката е към края си. Но поне се записаха с едно-две прости изречения в историята: „Не на еврото!“, „Не на подкрепата за Украйна!“. Основните им послания обаче се изчерпаха, а антисистемният играч на терена ги помете. Би могло да се нарече и еволюция.

Еволюция?

Раздялата на ПП с ДБ и обособяването им в две отделни парламентарни групи непосредствено след като се класираха за 52-рото Народно събрание като коалиция, разкриха, че под скандалите за депутатските мандати тлеят сериозни противоречия. Съюзът, формиран през 2022 г., няма коалиционно споразумение, нито е бил обединен досега от общи кампании, общ щаб, общи послания. 

В опит да стопират разделянето, слухове за което вървяха в последните дни, от „Да, България“ предложиха коалиционно споразумение. По-късно се даде и идеята с тригодишна давност „за единен политически субект център–дясно“ между ПП и ДБ, макар никой да не храни илюзии, че това е възможно.

Въпреки настойчивите опити на ДБ да запази целостта на общата парламентарна група, в крайна сметка тя се счупи.

В България има нова ситуация. Избирателите натовариха със свръхвласт първата политическа сила. Тогава, когато има концентрация на власт, особена отговорност е на опозицията да бъде единна и ефективна, за да може да гарантира демократичния ред в страната, така че за нас нито една математика, нито едно техническо средство не може да бъде оправдание за нереализирането на тази голяма политическа цел.

Надежда Йорданова, ДБ

Двете политически сили обаче се договориха да издигнат заедно кандидат за президент на изборите през есента на 2026 г. – фаворит е Гюров, и да се явят заедно на изборите за кмет на столичния район „Средец“, където отново ще се кандидатира Трайчо Трайков. Партиите няма да се разделят в общинските съвети, където имат общи групи.

Но ранното изявление на Николай Денков (ПП), че служебният премиер е обсъждан за кандидат за президент в ПП, не е добра услуга за Гюров. Анонсът изпревари процеса и превърна все още неформалния консенсус в тема за вътрешнопартийни съмнения и съревнование. 

Лидерът на ПП Асен Василев обоснова раздялата идеологически, тъй като „Промяната“ била центристка партия, а не дясна. Така на петата година от създаването ѝ и онази фраза за постигане на „леви цели с десни мерки“, доктриналните различия се оказаха препъникамък в съвместното съществуване. Василев не казва „леви“, макар че лявото политическо гнездо в България отдавна е опразнено и още никой не е снесъл яйце там.

Евродепутатът Никола Минчев единствен от Националния съвет на ПП определи като „дълбоко погрешно“ решението за разделянето. В социалните мрежи той написа, че е важно коалицията да остане сплотена предвид абсолютното мнозинство на Румен Радев и предстоящите избори за президент. 

Пред bTV обаче лидерът на ПП Асен Василев определи момента като еволюционен:

На всички хора стана ясно, че големите задачи – влизането в еврозоната и Шенген, и Борисов и Пеевски с под 80 депутати – са изпълнени. Сега на дневен ред идва следващата голяма задача, която е българските граждани да живеят по-добре и България да стане по-богата държава. Това е икономическият и социалният модел на страната, а там с „Демократична България“ имаме различни визии, различни икономически философии. Така че това е естествен преход и еволюция напред. 

Но еволюцията не е прогрес за всички, тя без колебание изтрива онези, които не се приспособяват. В природата се нарича естествен отбор, а в политиката минава за „стратегическо решение“. Следващите месеци ще покажат кои ще бъдат динозаврите.

Introducing Dynamic Workflows: durable execution that follows the tenant

Post Syndicated from Dan Lapid original https://blog.cloudflare.com/dynamic-workflows/

When we first launched Workers eight years ago, it was a direct-to-developers platform. Over the years, we have expanded and scaled the ecosystem so that platforms could not only build on Workers directly, but they could also enable their customers to ship code to us through many multi-tenant applications. We now see on Workers: Applications where users describe what they want, and the AI writes the implementation. Multi-tenant SaaS where every customer’s business logic is, at runtime, some TypeScript the platform has never seen before. Agents that write and run their own tools. CI/CD products where every repo defines its own pipeline.

Last month, when we shipped the Dynamic Workers open beta, we gave those platforms a clean primitive for the compute side: hand the Workers runtime some code at runtime, get back an isolated, sandboxed Worker, on the same machine, in single-digit milliseconds. Durable Object Facets extended the same idea to storage — each dynamically-loaded app can have its own SQLite database, spun up on demand, with the platform sitting in front, as a supervisor. Artifacts did the same for source control: a Git-native, versioned filesystem you can create by the tens of millions, one per agent, one per session, one per tenant. So, we have dynamic deployment for storage and source control. What’s next?

Today, we are bridging durable execution and dynamic deployment with Dynamic Workflows.

The gap between durable and dynamic execution

Cloudflare Workflows is our durable execution engine. It turns a run(event, step) function into a program where every step survives failures, can sleep for hours or days, can wait for external events, and resumes exactly where it left off when the isolate is recycled. It’s the right primitive for anything that has to “keep going” past a single request: onboarding flows, video transcoding pipelines, multi-stage billing, long-running agent loops, and — as of Workflows V2 — up to 50,000 concurrent instances and 300 new instances per second per account, redesigned for the agentic era.

But Workflows has always had one assumption baked in: the workflow code is part of your deployment. Your wrangler.jsonc has a block that says “when the engine calls into WORKFLOWS, run the class called MyWorkflow.” One binding, one class. Per deploy.

That works fine if you own all the code. It’s fine if you’re running a traditional application.

It stops working the moment you want to let your customer ship their workflow.

Say you’re building an app platform where the AI writes TypeScript for every tenant. Say you’re running a CI/CD product where each repository has its own pipeline. Say you’re using an agents SDK where each agent writes its own durable plan. In every one of these cases, the workflow is different for every tenant, every agent, every request. There is no single class to bind.

This is the same shape of problem that Dynamic Workers solved for compute and that Durable Object Facets solved for storage. We just hadn’t solved it for durable execution yet.

Dynamic Workflows

@cloudflare/dynamic-workflows is a small library. Roughly 300 lines of TypeScript. It lets a single Worker — the Worker Loader — route every create() call to a different tenant’s code, and, critically, have the Workflows engine dispatch run(event, step) back to that same code when the workflow actually executes, seconds or hours or days later.

Here’s the whole pattern. A Worker Loader:

import {
  createDynamicWorkflowEntrypoint,
  DynamicWorkflowBinding,
  wrapWorkflowBinding,
} from '@cloudflare/dynamic-workflows';

// The library looks this class up on cloudflare:workers exports.
export { DynamicWorkflowBinding };

function loadTenant(env, tenantId) {
  return env.LOADER.get(tenantId, async () => ({
    compatibilityDate: '2026-01-01',
    mainModule: 'index.js',
    modules: { 'index.js': await fetchTenantCode(tenantId) },
    // The tenant sees this as a normal Workflow binding.
    env: { WORKFLOWS: wrapWorkflowBinding({ tenantId }) },
  }));
}

// Register this as class_name in wrangler.jsonc.
export const DynamicWorkflow = createDynamicWorkflowEntrypoint<Env>(
  async ({ env, metadata }) => {
    const stub = loadTenant(env, metadata.tenantId);
    return stub.getEntrypoint('TenantWorkflow');
  }
);

export default {
  fetch(request, env) {
    const tenantId = request.headers.get('x-tenant-id');
    return loadTenant(env, tenantId).getEntrypoint().fetch(request);
  },
};

Add to your wrangler.jsonc:

"workflows": [
		{
			"name": "dynamic-workflow",
			"binding": "WORKFLOW",
			"class_name": "DynamicWorkflow"
		}
	]

The tenant writes plain, idiomatic Workflows code. They have no idea they’re being dispatched:

import { WorkflowEntrypoint } from 'cloudflare:workers';

export class TenantWorkflow extends WorkflowEntrypoint {
  async run(event, step) {
    return step.do('greet', async () => `Hello, ${event.payload.name}!`);
  }
}

export default {
  async fetch(request, env) {
    const instance = await env.WORKFLOWS.create({ params: await request.json() });
    return Response.json({ id: await instance.id });
  },
};

That’s it. The tenant calls env.WORKFLOWS.create(...) against what looks like a perfectly normal Workflow binding. Workflow IDs, .status(), .pause(), retries, hibernation, durable steps, step.sleep('24 hours'), step.waitForEvent() — everything works the way it always has.

The library handles one thing: making sure that when the Workflows engine eventually wakes up and calls run(event, step), it ends up inside the right tenant’s code.

How it works

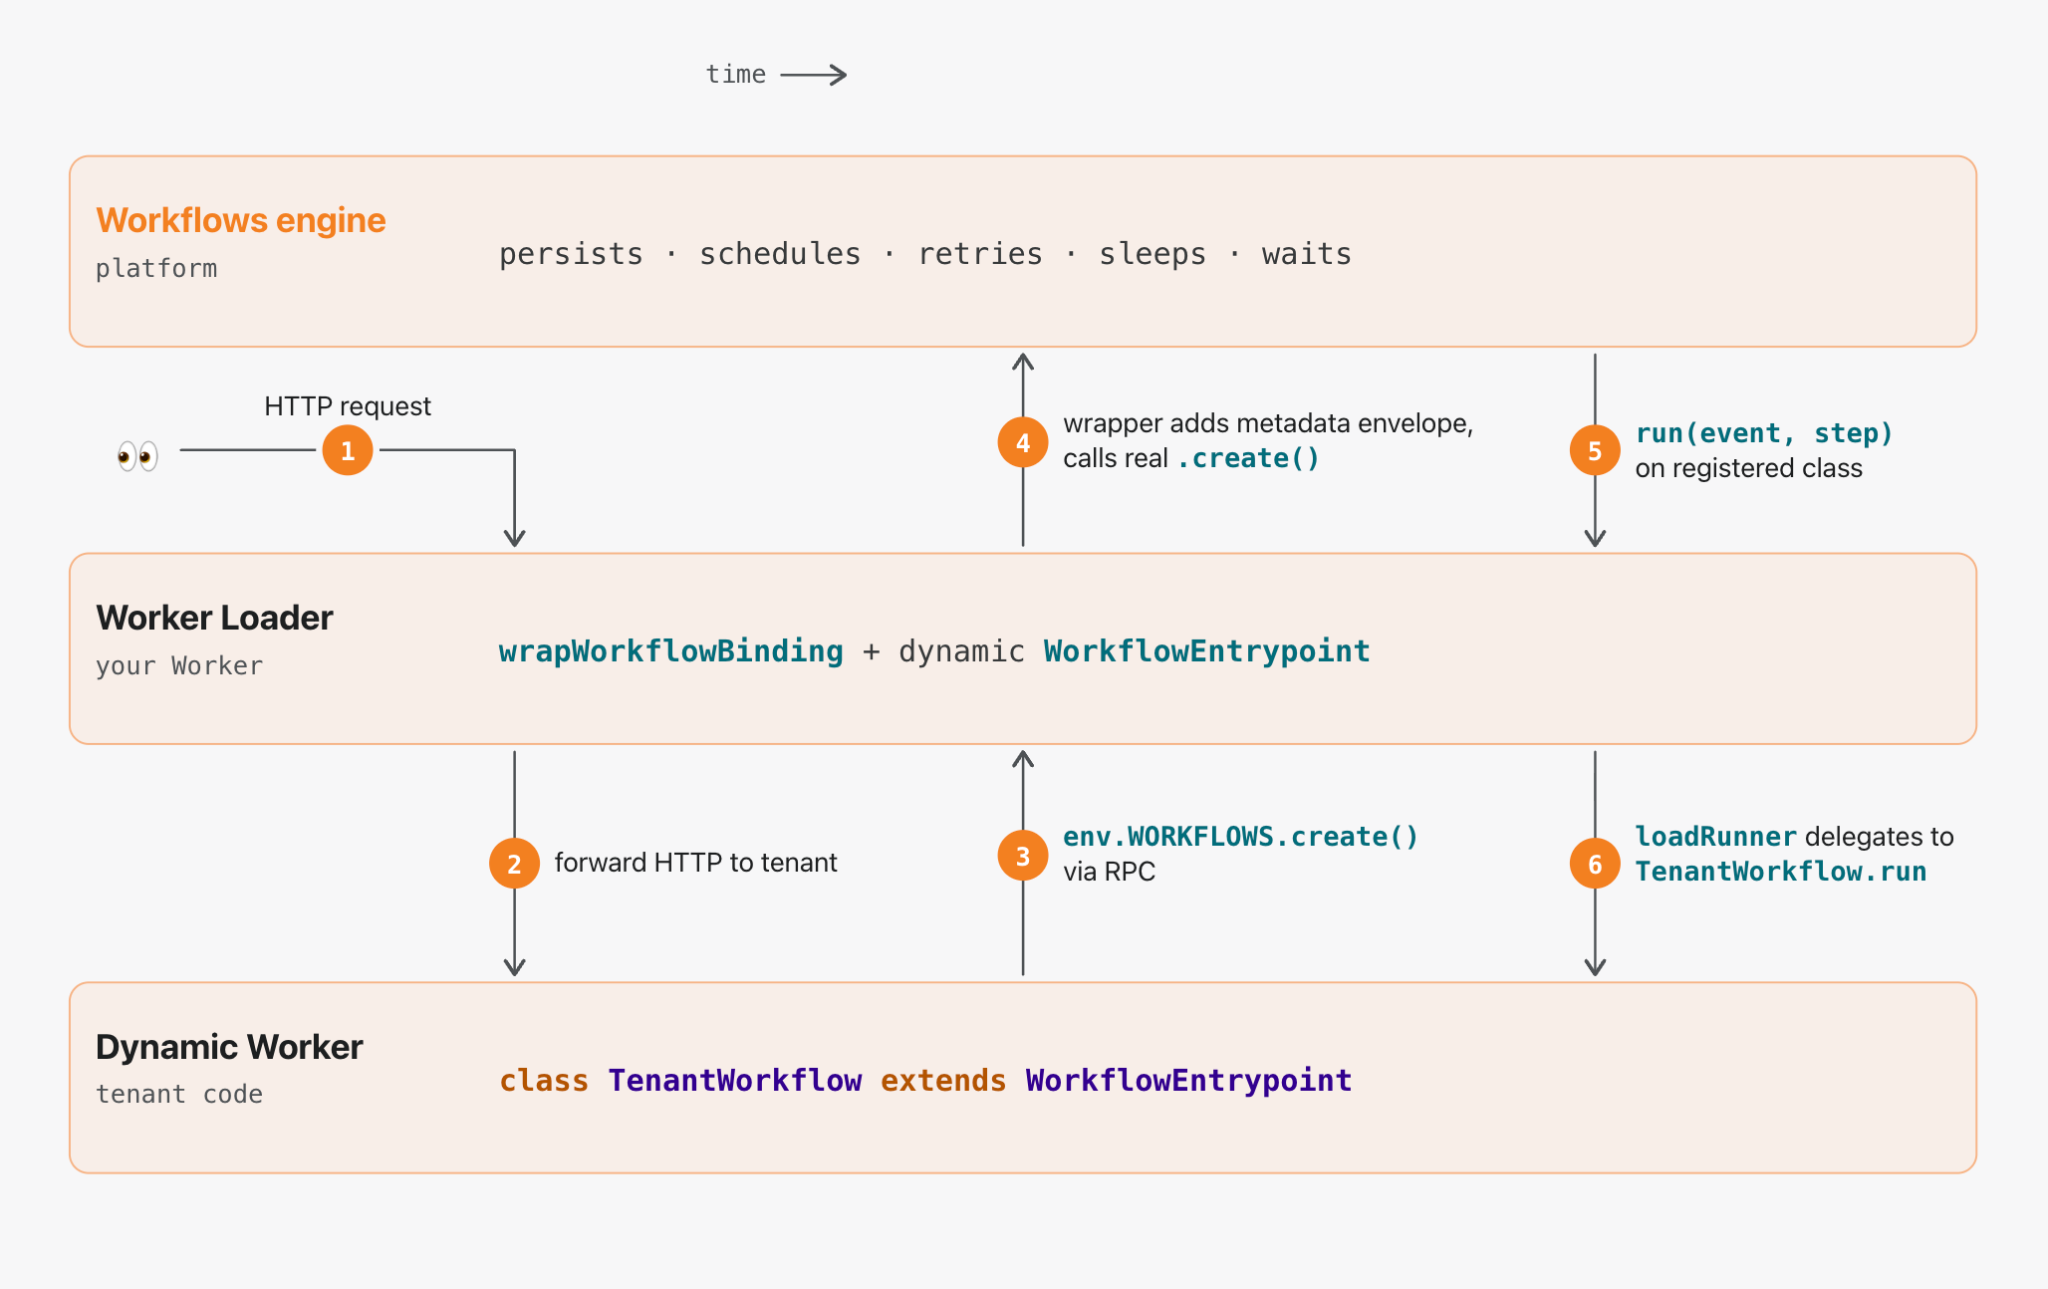
Three layers: the Workflows engine (platform) on top, your Worker Loader in the middle, your tenant’s code (a Dynamic Worker) on the bottom. 


When a request reaches the Worker Loader, it routes the execution to the correct dynamic code on the fly. The rest of the execution is a handoff between these three layers, left-to-right in time: the request enters, bounces up to the engine, is persisted, and later bounces back down again.

Walking the flow:

① → ② Entering the tenant’s code. The Worker Loader receives an HTTP request, figures out which tenant it’s for, loads that tenant’s code via the Worker Loader, and forwards the request to its default.fetch. The env it hands the tenant contains WORKFLOWS: wrapWorkflowBinding({ tenantId }). As far as the tenant is concerned, that looks and acts like a real Workflow binding.

③ Up to the Worker Loader. When the tenant calls env.WORKFLOWS.create({ params }), it’s actually making a Remote Procedure Call (RPC) into the Worker Loader — the wrapped binding is a WorkerEntrypoint subclass (DynamicWorkflowBinding) that the runtime specialized with the tenant’s metadata at load time. That’s why you have to export { DynamicWorkflowBinding } from your Worker Loader: the runtime builds per-tenant stubs by looking the class up in cloudflare:workers exports. Bindings that cross the Dynamic Worker boundary have to be RPC stubs — a plain { create, get } object can’t be structured-cloned, and the raw Workflow binding isn’t serializable either.

Inside the Worker Loader, the wrapped binding transparently rewrites the payload:

tenant calls:  create({ params: { name: 'Alice' } })
                            │
                            ▼
engine sees:   create({ params: {
                  __workerLoaderMetadata: { tenantId: 't-42' },
                  params: { name: 'Alice' }
               }})

④ Up to the engine. The Worker Loader then calls .create() on the real WORKFLOWS binding with the envelope as the params. From here the Workflows engine takes over. It persists event.payload — which now includes the envelope — and schedules the run. Every time the engine later wakes up the workflow (whether that’s after a 24-hour sleep, a crash, or a deploy), the metadata rides along with the payload, waiting to route the run.

One implication: treat the metadata as a routing hint, not as authorization. The tenant can read it back via instance.status(). Don’t put secrets in there.

⑤ → ⑥ The engine comes back down. When the engine is ready to run a step, it calls .run(event, step) on the class you registered in wrangler.jsonc — the one createDynamicWorkflowEntrypoint gave you. That class unwraps the envelope, hands the metadata to the loadRunner callback you wrote, and forwards the unwrapped event through to whatever runner the callback returns.

The callback is where everything interesting happens, and it’s entirely yours. Fetch the tenant’s latest source from R2. Check their plan tier and pick a region. Attach a tail Worker for per-tenant logging. Bundle TypeScript on the fly with @cloudflare/worker-bundler. In the common case, you just hand off to the Worker Loader:

const stub = env.LOADER.get(tenantId, () => loadTenantCode(tenantId));
return stub.getEntrypoint('TenantWorkflow');

The Worker Loader caches by ID, so a workflow that runs many steps over many hours reuses the same dynamic Worker across them. When the isolate eventually gets evicted, the next step.do() pulls the code again and keeps going — the tenant’s workflow has no idea anything happened. A Dynamic Worker boots in single-digit milliseconds using a few megabytes of memory, so the dispatch overhead is essentially free. You can have a million tenants, each with their own distinct workflow code, each spun up lazily on the step boundary where it’s needed, and none of them cost anything while idle.

The escape hatch

If you want to subclass WorkflowEntrypoint yourself — to add logging around run(), wire up per-tenant observability, or thread custom state through — the library exposes the lower-level dispatchWorkflow primitive that createDynamicWorkflowEntrypoint is built on:

import { dispatchWorkflow } from '@cloudflare/dynamic-workflows';

export class MyDynamicWorkflow extends WorkflowEntrypoint {
  async run(event, step) {
    return dispatchWorkflow(
      { env: this.env, ctx: this.ctx },
      event,
      step,
      ({ metadata, env }) => loadRunnerForTenant(env, metadata),
    );
  }
}

Everything else — IDs, pause/resume, sendEvent, retries — falls through to the real Workflows engine untouched.

Dynamic Workers are the primitive

Step back from the specifics for a second. Every interesting line of this library is either a wrapper around .create() on the outbound side or a wrapper around WorkflowEntrypoint on the inbound side. The actual work — spinning up the tenant’s code, sandboxing it, routing RPC across the boundary, caching the isolate, hibernating between steps — is all done by Dynamic Workers underneath.

That’s the real story, and it’s a lot bigger than Workflows

Dynamic Workers is the primitive that swallows everything. Durable Object Facets is the same pattern applied to Durable Objects. Dynamic Workflows is that same pattern applied to WorkflowEntrypoint. Each one is the same small amount of envelope-and-unwrap glue between the static binding you’ve always had and the dynamic version you can now hand to your customers.

And we’re not stopping at Workflows. Every binding that Workers currently exposes is heading for a dynamic counterpart — queues where each producer ships its own handler, caches, databases, object stores, AI bindings, and MCP servers where every tenant brings their own tools. Whatever you bind to a Worker today, you will soon be able to bind dynamically: dispatched per tenant, per agent, per request, at zero idle cost.

The unit economics of running a platform like this are, frankly, absurd. Shipping a multi-tenant product used to mean giving every customer their own container, their own database, their own disk, their own scheduler, and stitching it together with orchestration glue, service meshes, and hair-pulling billing math. Many of these applications have to support thousands of customers at the very least; millions, at the most. On Dynamic Workers and everything composing on top of them, idle tenants cost approximately nothing and active tenants share the same hardware through isolate-level multi-tenancy. The floor drops several orders of magnitude. A platform that used to cap out at thousands of paying customers can now reasonably serve tens of millions.

What this unlocks

Agent platforms that plan like engineers

Coding agents — OpenCode, Claude Code, Codex, Pi — have been proving for the past year that LLMs are far better at writing code than at making sequential tool calls. The Cloudflare Agents SDK and Project Think extend that insight into durable execution: with primitives like fibers and sub-agents, an agent’s long-running plan can survive crashes, hibernation, and redeploys without the user noticing.

Dynamic Workflows is the piece that lets that plan be a first-class Cloudflare Workflow — something the agent literally writes and the platform literally runs, with the full durability machinery behind it. A run(event, step) function the model wrote a minute ago, where every step.do(...) is independently retryable, every step.sleep('24 hours') hibernates for free, and every step.waitForEvent(...) waits indefinitely for the human to approve the next action. The agent writes the workflow; the platform runs it; neither has to know ahead of time what the plan looks like.

SDKs and frameworks where the user brings the logic

If you’re shipping a framework where your customer writes the run(event, step) function — a workflow builder UI, a visual automation tool, a per-tenant extension system, a low-code tool for non-developers — Dynamic Workflows is now the primitive that makes it work without compromise. You call wrapWorkflowBinding({ tenantId }) once, hand the result to their code as WORKFLOWS, and every workflow instance they create is automatically tagged, routed back, and executed in their sandbox. The framework owns the Worker Loader; the user owns the workflow; neither has to care about the other.

CI/CD at primitive speed

Here’s the use case that’s been getting us most excited.

Every CI/CD platform in existence is, underneath, a dispatcher of per-repo configuration files: “run these steps, in this order, with these secrets, cache these directories, upload these artifacts.” Each repo has its own pipeline. Each branch might have its own variant. Each pull request spawns an instance of that pipeline that has to run to completion, survive a machine crash, retry a flaky step, stream logs, pause for approvals, and persist results.

That’s exactly the shape of a durable workflow. The reason CI hasn’t been built that way until now is that nobody had a cloud primitive where the workflow itself is different for every repo, dispatched at runtime, at zero provisioning cost. Now you do.

Here’s what a CI pipeline looks like when it’s just code your customer ships with their repo — say, in .cloudflare/ci.ts. The workflow itself is real; the runInSandbox() / summarise() / GitHub binding helpers below are platform-provided glue, the kind of thing you’d ship once in your dispatcher:

import { WorkflowEntrypoint } from 'cloudflare:workers';

export class CIPipeline extends WorkflowEntrypoint {
  async run(event, step) {
    const { repo, sha, branch, pr } = event.payload;

    // Fork an isolated copy of the repo at this commit. Seconds, not minutes.
    const workspace = await step.do('checkout', () =>
      this.env.ARTIFACTS.fork(repo, { sha })
    );

    await step.do('install', () => runInSandbox(workspace, ['pnpm', 'install']));

    // Each parallel step is independently retryable.
    const [lint, test, build] = await Promise.all([
      step.do('lint',  () => runInSandbox(workspace, ['pnpm', 'lint'])),
      step.do('test',  () => runInSandbox(workspace, ['pnpm', 'test'])),
      step.do('build', () => runInSandbox(workspace, ['pnpm', 'build'])),
    ]);

    if (pr) {
      await step.do('comment', () =>
        this.env.GITHUB.commentOnPR(repo, pr, summarise({ lint, test, build }))
      );
    }

    // Workflow hibernates until approval arrives. No VM held open.
    if (branch === 'main') {
      await step.waitForEvent('approval', { type: 'deploy-approval', timeout: '24 hours' });
      await step.do('deploy', () => runInSandbox(workspace, ['pnpm', 'deploy']));
    }
  }
}

The platform owns the dispatcher. It ingests a webhook, figures out which repo it came from, loads that repo’s CIPipeline class as a Dynamic Worker, and hands the run-off to Dynamic Workflows. The platform doesn’t know what’s in the pipeline. It doesn’t need to. It’s running a durable function that happens to live in the customer’s repo.

Now line up what each step actually does:

  • Artifacts gives every repo a Git-native, versioned filesystem that lives on Cloudflare’s globally distributed network. ArtifactFS hydrates the tree lazily, so even a multi-GB repo is ready to work within single-digit seconds — and fork() gives each CI run its own isolated copy, with no git clone tax.

  • Dynamic Workers run each lightweight step (lint, format, typecheck, bundle) in a sandboxed isolate that boots in milliseconds, on the same machine as the repo’s data. No VM provisioning, no image pull, no cold start.

  • Dynamic Workflows holds the whole run together. Steps are retryable and durable. The run hibernates for free while waiting on approvals. State and progress survive deploys, evictions, and crashes.

  • Sandboxes handle the heavy corners — the step that needs docker build, the integration suite that needs Postgres running, the Rust compile that needs 8 cores. Snapshots to R2 mean even those warm-start in a couple of seconds.

A traditional CI run for a mid-sized JS repo looks something like: allocate VM (15-30s) → pull base image (10s) → git clone (10s) → npm ci (30-60s) → run tests (actual work) → tear down. Several minutes of ceremony before the first test runs, and you pay for the whole VM the whole time.

The same pipeline on this stack looks like: edge fork of the repo (seconds) → each step boots a fresh isolate or snapshot-restored sandbox in milliseconds → runs the actual work → hibernates. Nothing has to cold-start. Nothing has to be provisioned ahead of time. Nothing has to be kept warm. The repo doesn’t move — the compute comes to it.

CI has never been this fast, and the reason it hasn’t is that none of these primitives have existed together in one place. Now they do.

Try it

@cloudflare/dynamic-workflows is MIT-licensed and on npm today:

npm install @cloudflare/dynamic-workflows

It runs on top of Dynamic Workers, which is in open beta on the Workers Paid plan. The repo includes a working example — an interactive browser playground where you write a TenantWorkflow class, hit Run, and watch the steps execute with live-streaming logs and a per-step checklist that lights up as each step.do() commits. Clone it, deploy it, show it to a coworker.

If you’re a platform, an SDK, a framework, or a CI/CD product, and you want to give your customers their own workflows without running their code in your own process: this is the primitive we built for you. If you’re building agents that write durable plans, this is the primitive that makes those plans real Workflows. If you’re just watching all of this, and it looks fun to build on top of: we’d love to see what you make.

Find us in the Cloudflare Developers Discord. We’ll be there all week.

Пол Линч: Да погледнем реалността в очите

Post Syndicated from Стефан Иванов original https://www.toest.bg/pol-linch-da-poglednem-realnostta-v-ochite/

Пол Линч: Да погледнем реалността в очите

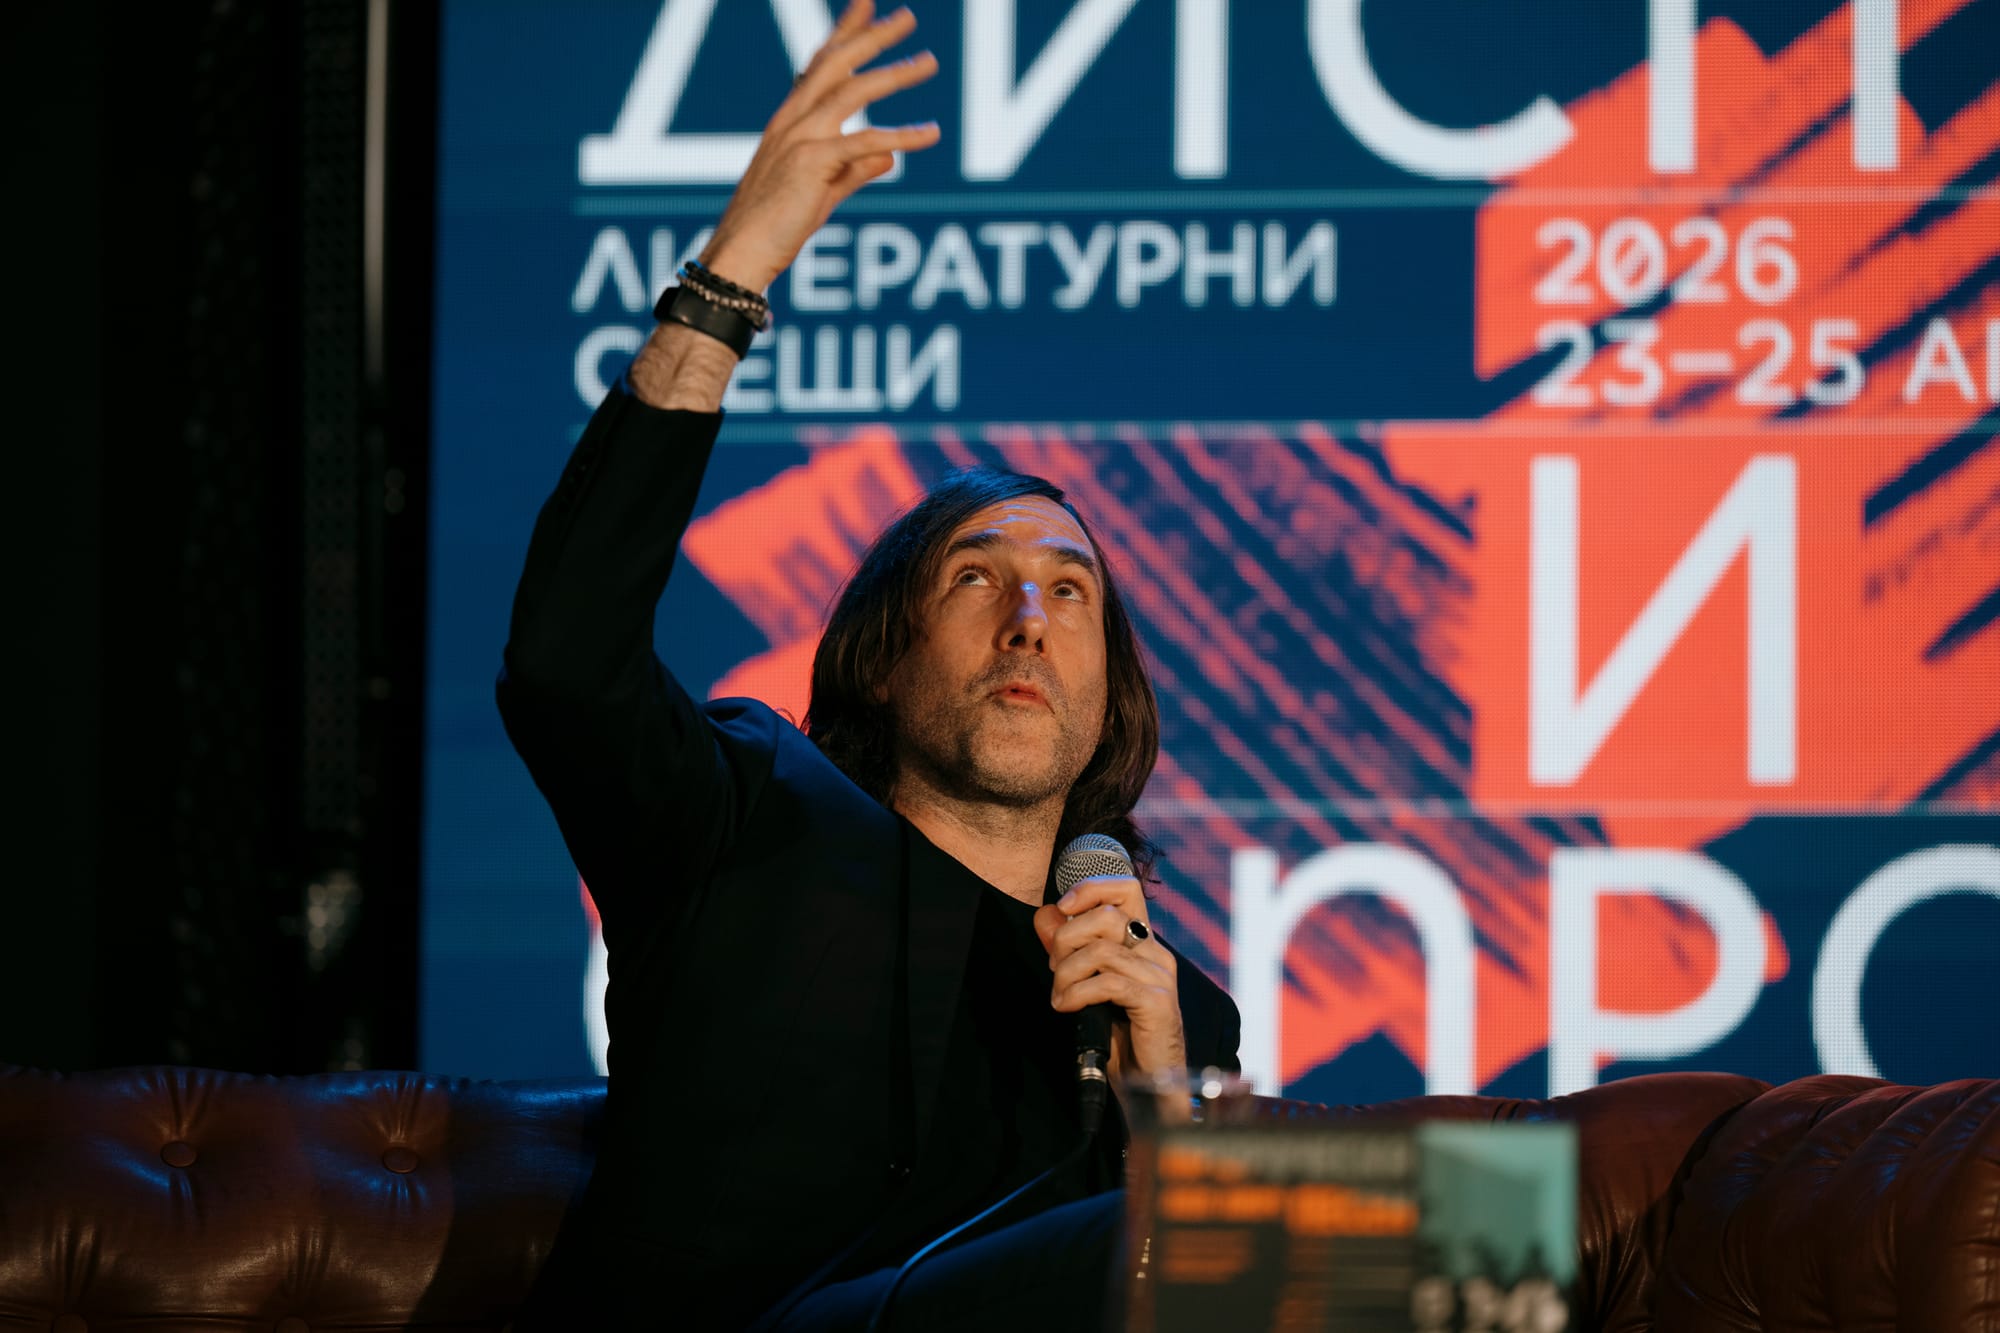
Пол Линч е ирландски писател, носител на наградата „Букър“ за 2023 г. за романа си „Пророческа песен“ (изд. „Лист“, преводач Иглика Василева). На 25 април 2026 г. дискусията с него закри десетото издание на фестивала „Литературни срещи“, посветено на темата „Дистопии и съпротива“. Фестивалът се организира от Фондация „Прочети София“,

Романите Ви изследват как политическата катастрофа навлиза в най-интимните пространства на живота, в семейството, езика, паметта, тялото. Когато започвате да пишете книга, от политическа интуиция за света ли тръгвате, или от по-частен емоционален пейзаж, който постепенно разкрива политическите си измерения?

Трябва да Ви поправя за нещо важно. Не съм политически писател. Не смятам книгите си за политическа проза. Единствената, която може донякъде да отговори на тази заявка, е „Пророческа песен“. Останалите са метафизични текстове. Смятам себе си за метафизичен романист. Сериозната проза според мен има задължението да мисли за проблема на реалността в пълния му обхват. А реалността е безкрайно сложна. Безкрайно сложната реалност за човешките същества включва политическото. Но политическото не включва безкрайната сложност. Не е обратното. Роман като „Пророческа песен“ има политическо измерение, но има и много други. Цялата ми проза има един основен план – да мисли върху проблема за смисъла на човешкото същество в неотчуждаема вселена. Всичките ми герои страдат, желаят нещо същностно, като чувство за достойнство и усещане за повече признание. Винаги са хванати в нещо екзистенциално, космическо, политическо, нещо, което подсказва липса на свободна воля, липса на индивидуалност в свят, който не ги разпознава.

Същевременно има и философско измерение: как създаваме смисъл в свят, който не ни разпознава? Как интерпретираме кои сме, когато светът около нас мълчи? Има го това усещане за възвишен ужас, старомодното значение на възвишеното, нещо неизразимо, което ни подхвърля наоколо като прашинки. Когато романът зрее, това често се случва подсъзнателно. Имам ситуация или проблем, който ме гризе, и причината постоянно да се връща е, че говори за нещо универсално. Книгите ми изглеждат като прости разкази за изпитания, но изобщо не са прости. В тях има слоеве и пластове.

Когато за пръв път прелистих „Пророческа песен“, образът, само визуален, който се появи, беше за непрекъснатите от нови параграфи страници на Томас Бернхард. А когато споменахте възвишеното, първата ми асоциация беше с морето. Морето във Вашето писане е доста важно. На възвишеното ли е образ, или на възможност, на надежда? Имам предвид и финала на „Пророческа песен“.

Не можем да говорим за финала. Всъщност е сложно да се говори за морето във връзка с „Пророческа песен“. Но мога да говоря за „Отвъд морето“, ако искате.

Да, разбира се.

В този роман морето не е точно море. То се превръща в нещо космическо. То е великото мълчание около нас. Великото безразличие на вселената. Празнотата, която ни гледа в очите, когато наистина се вгледаме в реалността на нещата. Двама мъже в лодка, опитващи се да създадат смисъл за себе си, когато би трябвало да са мъртви или ще умрат със сигурност. Морето отново действа като форма на възвишеното, то е ужасът от онова, което лежи отвъд нас, което не знаем и което не можем съвсем да разчетем. Когато излезем от собствената си индивидуалност, от тесния си фокус на внимание, срещаме нещо по-обширно, нещо космическо. Това космическо измерение е много важно за мен, то ни поставя в по-обширен контекст. Обичам писатели, които винаги са правили това, като Достоевски, Мелвил, Фокнър, Конрад. Писатели с космическо измерение, способни да създадат образи и мащаб, да те погледнат с космическо око от небето и в същото време да се доближат максимално до героите и да артикулират текстурата на преживяната реалност. Мащабът е това, което ме интересува. Не е обичайно в съвременната проза, но мисля, че трябва да картографираме параметрите на реалното, доколкото можем.

Реалното с главно Р?

Да, точно.

Много читатели преживяват творчеството Ви почти физически. Прозата се движи като дълъг, непрекъснат дъх или поток, създавайки усещане за натиск и неизбежност. Този стилистичен интензитет Ваш начин ли е да пресъздадете психологическата атмосфера на живеенето вътре в историята?

Изречението е фундаментално. Когато пиша, изречението трябва да съдържа преживяната реалност на момента в текста, може да подчертава познатото, но може и непознатото. „Пророческа песен“ е написана в сегашно време, за да предизвика чувството за онова, което не може да бъде познато. Сегашното време е винаги среща и с непознатото. Бъдещето не може да бъде познато. Срещаме го, докато се разгръща. Айлиш е хваната в нещо бързо, непроницаемо и с ужасяваща енергия. Изреченията трябва да създават чувство на страх и клаустрофобия в момент, който не можеш да прoумееш напълно. Затова са дълги – защото в реалността няма точка. Реалността се движи и диша. Не пиша трудни изречения. Не правя като Краснахоркаи, при когото дългите изречения имат много различна роля. Дългото изречение на Бернхард е много различно от моето. И да, няма прекъсвания за абзаци, текстът оформя читателския опит. Принуждава го да е в момента. Няма бяло пространство, защото за Айлиш Стак няма къде да си поеме дъх. Има я само инерцията на онова, което се разгръща. Вирджиния Улф е говорила за моменти в писането, когато има навлизане в реалността без нормалното его. Искам Айлиш да го преживее. Искам и ние да го преживеем.

Нейното тунелно зрение.

Да. Когато си в него, започваш сам да усещаш Айлиш. Този роман произвежда радикална емпатия, позволява ти да влезеш напълно в пространството, космическото съзнание, преживения момент на друг герой. Това е идеята на прозата. Магическа е.

Буквално е така.

В Силициевата долина говорят за изобретяване на все по-добра виртуална реалност. А ние, по дяволите, я изобретихме преди векове. Казва се проза.

И парадоксът с виртуалната реалност е парадоксът на картата и територията. Невъзможна е. Но… няма да задавам повече политически въпроси.

Но може да опитате – писането ми има политически измерения.

На битово ниво съпротивата рядко изглежда героична. Може да приеме формата на малки действия, на отказ от мълчание, защита на друг човек, съхраняване на езика, казване на истината. Какви ежедневни жестове помагат на хората да се съпротивляват на нормализирането на страха и контрола?

Интересно е, защото предишният журналист зададе много подобен въпрос. Идеята за съпротивата нещо важно ли е точно сега в България?

Да. В момента имаме мнозинство на прокремълска партия в парламента.

Мисля, че задължението на индивида днес е да се съпротивлява на завладяването и поробването на ума ни от технологията, за която всички сме се подписали, без никому да са обяснили условията на договора. Да се съпротивляваме на навлизането на технологиите в индивидуалността ни. Това важно нещо може да включва и прозата, както и създаването на пространство за тишина. От тях идва истинската индивидуалност. Когато чуеш този шепот, тихия шепот на Аза, автентичността става неизбежна. Автентичният Аз е мощна сила. Ще се съпротивлява на онова, което пречи на свободата му да съществува.

Ефективен отговор. И нужен.

Ние бяхме неутрализирани от айфона. Без значение дали става въпрос да се съпротивляваш политически, или да се ангажираш философски с проблема на смисъла, или просто да присъстваш в живота си, ние бяхме завладени и неутрализирани от технологията около нас. Това прави автокрацията по-лесна, защото корумпира реалността. Всичко, което имаме вътре, е този много тих и чист сигнал на висшия Аз. Не говоря мистически, говоря психологически – това е онзи Аз, който стига до проблема на смисъла, на това как да живееш и кой да бъдеш в света. Не всичко е политическо. Когато Робинзон Крузо отива на пустия остров, среща аспект на Аза извън политиката, извън икономиката, директно конфронтира смисъла си в космоса. Този аспект на ума го има у всички нас, но модерният живот го е отчуждил от нас. Вече нямаме структурите на смисъла от религията. Какви структури на смисъла имаме? Екзистенциалистите владееха този разговор през ХХ век. Но къде е сега въпросният диалог? Не го чувам. Трябва да започнем оттам и да се ориентираме автентично, преди да се захванем със света.

Писателите често говорят за отчаянието като творческа сила, но Вашето творчество носи едно упорито чувство за човешко достойнство. Какво поддържа собственото Ви усещане за надежда? Когато пишете за мрачни исторически възможности, какво лично Ви помага?

Тук се стига до ядрото на това какво представлявамe. В центъра на човешкото същество има гордиев възел, вътре в мен и във Вас има вселена от чувства, вселена от възможности и едно дълбоко усещане за страдание – винаги, защото то е неизбежно, то е състоянието ни. Имаме безкрайно въображение в себе си, но краен живот. Свeтът е без смисъл, ако живееш извън религиозна структура и трябва сам да го създаваш. Чувствам какво е да бъда себе си, и ме е грижа. Бих искал достойнство, справедливост за семейството си, общността ми; искам свобода. В прозата изследвам напрежението на обективната сила, която не я е грижа. Затова има централен хуманизъм в писането ми, наред с празнотата, защото трябва да празнуваме човечността. „Трябва да признаем достойнството на човешкия дух“ – фразата е на Томас Ман. Ако си жив като човешко същество, имаш човешки дух. Това не е религиозна идея, това е усещането да си жив, да съзнаваш, че си човек в този свят. Длъжни сме да признаваме красотата на това. Ето защо не съм политически писател. Може писането ми да има политически измерения, но проектът ми е много по-обширен – в ядрото си е метафизика. Проектът на модерността е бил да се създаде индивидуалността. Вече я имаме. Какво ще правим с нея?

Ще я заличим?

Заличаваме я, пропиляваме я в разсейване и скролване на безкрайния абсурд по екраните. Заменихме старите символи, които ни даваха усещане за света, с шибаното скролване на колективното несъзнавано от боклуци на екрана. Безсмислено е. Ако не се опитаме да разрешим тези проблеми сега, новата теокрация ни чака от другата страна. Вече може да я чуете. Трябва отново да водим разговор за смисъла като общество.

Този разговор трябва да се води лице в лице. Това е истинският разговор, колкото и да е трудно да се състои в момента. Прав сте. Когато гледате настоящия момент, тревогата за климата, политическата тревога, крехките демокрации, войните, има ли конкретни произведения на изкуството, които Ви се струват значими днес? И обратно, към кои се обръщате, когато имате нужда от напомняне за издръжливостта и възможността за човешко обновление?

Мисля, че проблемът ни като общество е, че сме свели изкуството до забавление, а забавлението – до разсейване. Трябва отново да създадем пространство за сериозното изкуство, което задава въпроси и ни кара да мислим кои сме в света. Това е индивидуално нещо – да си оставиш телефона, да прочетеш книга. Изглежда трудно, но след стотина страници вече не е. Да възстановиш мускула, който се справя със сложността на литературата. Да изоставиш филмите на Marvel, които свеждат света до манихейско черно-бяло, и да прегърнеш сложността на изкуството, което казва, че животът е безкрайно велик. Като читател се връщам към текстове с максимална сложност, мащаб и визия. Обичам „Докато лежах и умирах“ на Фокнър, там е човешкото състояние в цялата му цялост. Имаме смърт, буря, хаос, къща на хълм. Архетипна яснота и какофония от гласове, в която никой не слуша никого. Всеки е индивид, заключен в собствената си вселена. Целият спектър от болка, глупост, страдание, алчност – всичко е там, в тази проста история. Устойчивостта идва от разпознаването на това какво сме – не от фалшива надежда, че всичко ще е наред, а от истината за живота. Инфантилизирахме реалността си и я анестезирахме. Скролваш и получаваш позитивни послания за самопомощ, които траят три секунди. Как ще изградиш живот от това? Джеймс Болдуин казва, че човешките същества са способни да носят голямо бреме, когато срещнат реалността. Оттам идва устойчивостта – от разпознаването на истината за живота. Затова чета проза. Затова сме тук – за да погледнем реалността в очите.

И да не се страхуваме.

Да.

Последен въпрос. Много бърз. Любим визуален артист, любим филм, любима песен?

Обичам толкова много неща. Колекционирам джаз плочи, слушам много джаз. Колекционирам филми.

Майлс Дейвис или Колтрейн?

Колтрейн. От съвременното кино обичам Ханеке; „Бялата лента“ е шедьовърът му, гледал съм го много пъти. Обичам Одзу, „Токийска история“ – извънредно хуманен филм. Харесвам Мизогучи. Слушам и прогметъл, обичам Mastodon, но слушам предимно джаз.

Кой е последният албум, който слушахте?

Magnificent на Бари Харис. Беше шокиращо добър. На летището го изслушах. Страхотен е, от 1970-та, със силно влияние от учителите му Бъд Пауъл и Монк. Съзнателно остава в тази линия в период, когато всички вече са отишли другаде. Нещо подобно правя и аз с писането си.

Amazon Q Developer end-of-support announcement

Post Syndicated from Ankit Sharma original https://aws.amazon.com/blogs/devops/amazon-q-developer-end-of-support-announcement/

When we launched Amazon Q Developer, our goal was to bring AI assistance directly into the developer workflow. Customers adopted Q Developer across VS Code, JetBrains, Eclipse, and Visual Studio, using it for code generation, debugging, and chat-based guidance. Q Developer proved that AI belongs in the inner loop of software development.

Over the past year, we’ve learned that the most impactful AI developer experiences go far beyond code generation and completion. Developers need AI that understands their entire project: the architecture, the requirements, the tests, and the intent behind the code. It requires a purpose-built environment. That’s why we built Kiro.

What is Kiro? Kiro is an agentic development environment (IDE, CLI) built from the ground up for spec-driven development. Instead of reacting to individual prompts, Kiro works from structured specifications to plan, implement, and verify changes across your entire codebase. Key capabilities include:

  • Specs — Define what you want to build in structured, natural-language requirements that Kiro uses to drive implementation end to end.
  • Hooks — Automated triggers that run on file save, commit, or other events to enforce standards, run tests, or update documentation without manual intervention.
  • Steering files — Project-level configuration that gives Kiro persistent context about your architecture, conventions, and constraints.
  • Custom subagents — Specialized AI agents you define for domain-specific tasks like security review, API contract validation, or infrastructure provisioning.
  • Powers — Composable capability modules that extend Kiro’s agentic behavior for your specific workflows.

Kiro also includes everything developers rely on in Q Developer today: agentic coding, inline chat, terminal integration, and MCP support.

What’s changing Amazon Q Developer IDE plugins and paid Subscriptions will reach end of support on April 30, 2027, giving customers 12 months to transition to Kiro.

  • New signups will no longer available starting May 15, 2026. New Q Developer Free Tier account creation (via Builder ID in IDE plugins) and new Q Developer subscription creation (via the AWS Console) will be blocked.
  • Model changes: starting May 29, 2026, Opus 4.6 will no longer be available on Q Developer Pro. Opus 4.5 and all other existing models remain available. The latest coding models, including Opus 4.7, are available exclusively on Kiro.
  • Existing customers retain access. If you access Q Developer via a Q Developer Pro subscription or Kiro subscription, you will continue to have access to the Q Developer IDE plugins until April 30, 2027. The May 15, 2026 change affects new signups for Q Developer accounts and subscriptions.
  • IDE plugin listings remain live. Q Developer plugins will remain published on all four IDE marketplaces with a deprecation notice directing users to Kiro. Critical bugfixes will continue to be pushed to existing users through the transition window.

What’s not changing Amazon Q Developer in the AWS Management Console and first-party AWS experiences (AWS Marketing Website, AWS Documentation Website, AWS Console Mobile App, and Amazon Q Developer for Chat Apps – Slack & Microsoft Teams) are not impacted by this sunset and will continue to be available to AWS customers. Customers using Q Developer in these products will retain access to their current subscription benefits and capabilities.

What you should do

  • Explore Kiro today. Download Kiro at kiro.dev and try spec-driven development on your next project.
  • Review the migration guide for your specific IDE.
  • If you have questions about migrating, contact your AWS account team.

We’re excited about the future of AI-powered development and we’re committed to making this transition as smooth as possible for every customer.

Промените, които носи AI

Post Syndicated from Григор original http://www.gatchev.info/blog/?p=2695

Писал съм и преди за тях. Отначало колебливо – чувствах се неадекватен фантазьор. Но напоследък все повече хора пишат същото или части от него. Ето поредната статия по темата:

https://shumer.dev/something-big-is-happening

И реших, че е добре да напиша нещо полезно за който има акъл. Който не чете дълги неща – за него си е, мога да му кусна в устата, но не и да глътна вместо него. И да не ми циври после, че не е знаел навреме.

—-

1. Технологичните революции

AI не е първата технологична революция на човечеството. Преди него бяха компютрите. Преди тях – атомът. Електричеството. Парата. Индустрията… Та чак до стиснатия в питекантропския юмрук камък.

Не, всъщност преди това – слизането от дърветата. Не, всъщност още преди това – качването на тях… До първата жива клетка. Всяка еволюционна промяна е по същество технологична революция, и обратното. Много различно ли е за един хомо хабилис умението да издяла каменен нож от еволюцията да му поникнат страшни зъби?

А технологичните революции не са милостиви. При индустриалната по света са измрели от глад и мизерия милиони селяни, ненаучили се да са работници. Десетки милиони са потънали в мизерия, когато електричеството е изместило парата. Световна атомна война ни се размина, но знаем какво би причинила атомна бомба дори на могъща и добре подготвена армия от 1940-те, за милионен град да не говорим. Компютрите оставиха без работа стотици милиони „сини якички“… Винаги по една и съща причина – неподготвените за новото остават излишни.

В по-нови времена – все повече по свой избор. Крепостните селяни не се учеха да четат, понеже книгата хляб не раждала. „Сините якички“ не учеха компютри, за да не си развалят очите. И едните, и другите разбраха грешката си по трудния начин и платиха за нея с късен и лош старт. С тези, които днес не учат AI, ще е същото.

Много от тях са убедени, че работа за фермери, зидари и готвачи ще има винаги. Същото мислеха орачите преди тракторите, преписвачите на книги – преди печатарската преса, каруцарите – преди колите… А колко професии го мислеха преди компютрите – да изброявам ли?

Новото не само унищожава работни места. Обикновено и създава нови, често напълно неочаквани, и често още повече от унищожените. Но каймака го обират първите пренаучили се. За другите остава утайката, ако изобщо я има. Изберете си от кои искате да бъдете.

2. Този път е различно!

Точно така са мислели и орачите преди тракторите, преписвачите преди печатарската преса и т.н. Всеки път е било същото, просто те не са искали да го разберат, защото не са били на кеф. И са си плащали после.

Само че този път наистина е различно. Проблемът е, че не по добрия начин.

Един трактор заменя десетки орачи, но не оре без тракторист. Първите орачи, които се научат да го карат, живеят по-охолно отпреди. Печатарските преси също не могат без работници. Камионите без шофьори. Компютрите – без работещи на тях… Често много по-малко от заменените, особено отначало, но все пак хора.

Тук е разликата. AI все повече нямат нужда от оператор – вършат все по-добре работата му и сами. Вече сме не просто на ръба AI да може да изпълни задача или да отговори на въпрос по-добре от всеки човек. На ръба сме той да може да формулира задачата или да зададе въпроса по-добре от всеки човек.

Ама и AI имат нужда някой да пише софтуера им? Също вече не. Последните версии на почти всички големи AI са написани предимно от предишните им версии. Скокът във възможностите им се дължи предимно на това. И тези много по-добри последни версии в момента пишат следващите, още по-добри от тях, с още по-голяма разлика. Последният модел на Anthropic – Mythos – вече е далеч по-добър и от най-добрите програмисти в софтуерните задачи. Толкова по-добър, че засега е непубличен, за да не откриват чрез него хакери екплойти в дори смятани сега за непробиваеми софтуери… Познайте дали не е също толкова по-добър от сегашните модели и в други отношения. Подобренията, влезли в него, няма как да са само в един вид умения, LLM-ите не работят така – ще са във всички.

В софтуера нещата са най-напред. Не толкова защото ударението по създаване на AI беше там – по-скоро защото програмните езици са силно формализирани, простички и детерминистични, с тях AI се справя по-добре с едни и същи ресурси. Но и във всичко друго нещата не са много по-назад – да кажем, едно-две поколения модели. Сега актуалният публичен модел на Anthropic – Opus – е в софтуера на нивото на приличен, макар и не блестящ програмист, а примерно в разбирането на човешките чувства – където предишният им модел, Sonnet, е в програмирането. Mythos надмина дори отличните програмисти в софтуера, по-добри от него са само гениите – логично е в разбирането на човешките чувства да е на нивото на Opus в програмирането. Все още не блестящ, но вече добър, на нивото на Opus в софтуера.

Конкуренцията между големите AI фирми е безмилостна – която изостане и с месец, почва да трупа изоставане и потегля към фалита. Така че Mythos с гаранция вече пише на максимални обороти следващия модел. Който ще има програмистки умения, много по-добри от това на написалия го, надминаващи тези и на гениите програмисти. (Терминът за такова ниво е “transhuman”.) Познайте и в колко други неща ще надмине повечето хора този следващ модел. По-следващият вероятно ще надмине във всичко или почти всичко всеки човек, освен може би гениите в най-трудните за AI области. Този след него ще надмине хората в абсолютно всичко… А следващият след него? А по-следващият?…

Преди ново поколение AI модел се създаваше от нула до зрялост за към две години, първите версии на ChatGPT отнемаха към толкова. При Sonnet това отне дори мъничко по-малко от година, 11 месеца и половина. Opus измина този път само за около 9 месеца – Sonnet вече що-годе ставаше за програмиране и помагаше, към една трета от Opus е написана от него или с негова помощ. Mythos (по непублична информация) вече е почти зрял, по-малко от 5 месеца след започването му – вероятно ще измине този път за около 6 месеца, и разликата от него до Opus е доста по-сериозна от тази от Opus до Sonnet. Благодарение основно на това, че Opus вече е приличен програмист, твърди се, че към две трети от Mythos са написани от него… Следващият модел, да го наречем условно Legend (Антропик, безплатна идея за вас! 🙂 ), като се има предвид колко добър е Mythos, вероятно ще е написан почти изцяло от него, вероятно ще има още по-голямо предимство пред предшественика си, и вероятно ще е вече зрял след 3-4 месеца. (Дотогава нищо чудно Mythos да е още непубличен.) По-следващият, да го наречем условно Superman, вероятно ще е с още по-голяма разлика от Legend, и ще е готов може би за 3 месеца или дори малко по-малко. А моделът след него вероятно ще е богоподобен на фона дори на Superman, ще стане готов за вероятно не повече от 2-2.5 месеца и вероятно ще е най-подходящо да го наречем God… Quo vadis – накъде отиваме? Може би до не повече от година?

2027 година е. Шеф сте на софтуерна фирма. Legend програмира много по-добре от кой да е реално привлекаем жив програмист. Конкурентите му от OpenAI, Google и прочее – също. Достъп до AI, който върши работата на 100 програмисти – с перфектно качество, винаги в срок, никога не боледува, няма проблеми, не взима отпуски, работи 24/7 – ще към 1000 долара месечно, стандартна корпоративна цена сега. Ще държите ли на работа 100 програмисти, или ще купите един такъв достъп? Глупав въпрос, нали?

Три до шест месеца след това. Актуалният модел на Antropic вече е Superman. Шеф сте на компания за какъв ще да е интелектуален труд. Дизайн, инженерство, архитектура, песни, книги, филми, наука, право, счетоводство, медицина, обучение… добавете пропуснатото. Достъп до AI, който върши работата на 100 служители… глупав въпрос, нали?

Още три до шест месеца по-късно. Актуалният модел на Antropic вече е God. Шеф сте на компания за какъвто и да е физически труд. Строителни услуги, хамаллък, садене на марули, бране на ябълки, продаване в магазин, гледане на болни, планинско спасяване, развличане на деца, метене на улици… добавете пропуснатото. Вече има машини – някои от тях човекоподобни роботи, други специализирани – проектирани, произведени и управлявани от God или конкурентите му. Достъп до машина или набор машини, които вършат работата на 100 бачкатори… глупав въпрос, нали?

Да, досега проектирането, изпитването и производството на толкова нови и много машини е отнемало десетки години. Познайте обаче колко време ще отнеме на God, или на следващия след него модел, или на по-следващия, готов след година – година и половина. Вероятно след броени години ще има достатъчно такива машини, за да изместят всеки човек.

Тази екстраполация е базирана на Sonet, Opus и Mythos. Sonnet и Opus ги познавам добре. Възможно ли е да са ми прехвалили Mythos, както не мога да се уверя лично? Да – но надали с много. Че е достъпен засега само за 12 големи, предимно софтуерни организации, точно заради брилянтността му в софтуера, е потвърден факт. (Намира с лекота купища експлойти и в най-сигурните сегашни софтуер – докопат ли го хакерите, в света ще настане хаос.) Така че темпото на развитие би могло да е малко по-бавно, може би чак двукратно, но не повече. А двукратно по-бавно означава масовите уволнения заради изместване от AI да се случат след 2 години вместо след 1. Ако това ви успокоява, сте герои от виц. Недейте, скоро и с палячовство няма да може да се изкарва доход, смешни наоколо ще има в излишък.

И да, публикуването на нов модел очевидно може да бъде забавено по едни или други причини. Но засега няма механизъм, който ще забави разработката на нови модели, дори ако старите още не са публикувани. Не само заради конкуренцията между AI фирмите. Коя агенция за сигурност на държавата ще позволи развитието на нейните AI да бъде спряно, докато в това време потенциалните ѝ врагове развиват AI като бесни?… И когато поредният модел стане способен да създаде лекарство против рак и да забави или дори спре стареенето, надали ще бъде скрит за дълго, примерно за цяла година – който го скрие, ще е заслужил каквото всички извършители на геноцид в историята заедно не са. Така че забавяния може да има, но надали ще са много големи.

Мислите иначе ли? За такива неща мислят глупавите, умните смятат. Ако можете да смятате, направете си и вие сметките колко бързо пътува този влак и им вярвайте. Ако не, вярвайте на който може да смята. Иначе ще сте урок за по-умните.

Ще станат ли хората непотребни? Надали. Нищо чудно добри решения по въпроса да дойдат именно от AI-та. Но се пригответе да живеете скоро в свят, различен от сегашния.

3. Икономическите последствия

2027-8-9 година е. Шеф сте на фирма. Конкуренцията ви е подменила част от служителите си с AI. Спестила е разходи за заплати, надконкурира ви. Какъв е изборът ви? Оставате шеф на фирма само ако направите същото. Иначе фалирате.

Правите го. Отново сте в бизнеса. Но там винаги има и най-неконкурентен, влак без последен вагон няма как. Какъв е изборът му? Подменя още служители с AI, иначе фалира. Последният вагон е откачен и изоставен или преместен напред – последен става този преди него…

Скоро всички служители във фирми са подменени с AI. Малко по-късно и всички работници. Където преди са работели хиляди, сега има само шепичка шефове. За кратко – кой шеф може да бъде по-кадърен и лоялен от от поколението Superman, да не говорим за God?… Много скоро след това фирмите имат вече само собственици. А конкуренцията между тях не спира – най-неуспешните фалират, други ги изкупуват, агрегацията тече с AI скорост. Докато се огледате, наоколо са останали един файтон свръхбогаташи, всички други са разорени.

Харесва ли ви идеята? „Ако съм свръхбогаташ – да!“ Да, ама не – спали сте в час по икономика. Нека наваксаме проспаното.

Заводите „Форд“ в САЩ са ваши. Произвеждате и продавате по 10 милиона коли годишно. Марджинът ви е 5%, при 400 милиарда годишен оборот печелите 20 милиарда годишно. Но подменяте всичките си работници с AI и марджинът ви става заради спестените заплати 50%. Годишната ви печалба ще е 200 милиарда, десетократно по-голяма. Шампанско, моля! И нови яхти!

Но месец по-късно от почти милион коли месечно продажбите ви са спаднали на към 2000. Годишно ще са 24 000, и годишната ви печалба е станала вместо 200 милиарда годишно към 500 милиона. Вместо да скочи 10 пъти, е паднала 40 пъти. Защото всеки фирмаджия в САЩ е постъпил като вас – подменил е с AI всичките си работници или служители. И те, останали без заплати, вече не могат да си позволят да купуват коли. Правят го само малкото все още работещи, заради връзки или по милост, в държавната и общински администрации.

Докато се опомните от вестта, AI-шефът на заводите ви предупреждава и че обемът на покупките ви на материали, ток и всичко друго е спаднал драстично. Така че вече пазарувате на доста по-дребно и доставните ви цени са скочили с 20%. Поемете ли вие разликата, марджинът ви слиза на 30%, печалбата – на 300 милиона годишно, вече почти сто пъти по-малка отпреди подмяната. Качите ли цените си с 20%, продажбите ще спаднат и още, обемът на покупките ви на материали също, цените им ще скочат още – бизнесът ви влиза в свредел.

Нямате избор. Орязвате печалбата си. Все пак 300 милиона годишно пак са много в такава ужасна криза. (Че тая криза я създаде подмяната на работници с AI, в която участвахте и вие, предпочитате да не си спомняте.) Но много скоро иде нов удар – продажбите на практика спират. Заради 100 пъти намалената ви печалба сте платили 100 пъти по-малко данък и държавната и общински администрации, които живеят от данъците, вече не могат да плащат заплати. Подменили са служителите си с AI и те също вече не могат да купуват коли… Дори да спрете производството напълно, вече не можете да плащате дори на фирмата за роботи-охранители с AI. Налага се да продадете заводите си, докато крадците не са ги опоскали и времето не ги е съсипало.

А на кого? Всички други големи фирми са също във фалит. Даже фирмите зад големите AI – могат да устискат на сериозно намаление на приходите си, но не и на спадане до 1%, а вече няма кой да може да им плати и толкова. Банките са фалирали до една заради трилионите заеми за жилища и прочее, които са станали необслужваеми – останалите без заплати заемополучатели нямат с какво да плащат вноските си. А ликвидността на една банка рядко е над 20% – ако над такъв процент заеми гръмнат, гръмва тя цялата… Чудо ще е, ако за заводите ви, стрували стотици милиарди, сега някой ви даде и милион. Вече не сте мултимилиардер – надали сте и милионер даже.

Да кажем, чудото се е случило, успели сте да намерите такъв. Все пак сте взели един милион. Но какво ще си купите с него? Магазините са затворени – кой има пари, че да купи каквото и да е?! Бившите свръхбогаташи сте единици, а останалите нямат пукнат цент. Същото важи за всички услуги – транспорт, бензиностанции, ток… Фермерите, които още имат земя и машини, вече искат да произвеждат храна само за себе си – но откъде части и гориво дори за това?!… И вече се чудите не на коя от яхтите си да празнувате, а как да се нахраните.

Икономиката е кръговрат. Произвеждате стоки или услуги, продавате, плащате на работниците, те с тези пари си купуват стоки и услуги. Не е перпетуум мобиле, защото етапът на производството в този кръг създава повече стойност, отколкото консумира. Така че върти ли се кръгът, производството непрекъснато създава принадена стойност, плюс над разходите, и тя се разпределя навсякъде в кръга. Има и за покриване на неизбежните загуби, и за данъци, и за вашата и на работниците издръжка, и за тях да спестяват, и за вас да богатеете – тоест, за да расте икономиката като цяло… Но спре ли да се върти кръгът, примерно защото работниците вече нямат пари да купуват, спира и производството, а оттам и създаването на принадена стойност. Приходите стават нулеви. Вчерашните мултимилиардери почват да умират от глад. А някои от неизбежните разходи продължават и унищожават и останалото от спрялата икономика.

(Този механизъм, в много по-лек вариант, е причината за Великата депресия от 1929 г. Вярването в trickle-down теорията и дерегулацията, неглижирането на антитръстовските закони и на опасността от растящото икономическо неравенство създават условия много от парите в обществото да бъдат изтеглени „горе“, при най-богатите. Те обаче са нищожен процент, техните потребителски нужди са нищожни на фона на тези на хиляди пъти по-многобройните средна класа и по-бедни. Създава се ситуация, в която който има нужда от стоки и услуги няма достатъчно пари да купува, а който има достатъчно пари, няма достатъчно нужда от покупки. Потреблението спада с около 30%, производството – БВП на САЩ – също. Резултатът е незапомнена безработица и мизерия. От 30% спад в потреблението. А спадът в потреблението заради AI революцията вероятно ще е много по-голям, теоретично може да доближи 100%…)

4. Справяне с икономическите последствия

Ще бъдат ли взети мерки да се избегне катастрофата? Вероятно да – както виждаме, дори свръхбогаташите имат нужда от тях, и то повече от клошарите или даже работниците. Не е сигурно обаче дали ще са взети достатъчно и с достатъчно ефект.

Ефективните срещу такъв проблем мерки са видове преразпределяне на парите откъдето са се концентрирали силно към където има капацитет за масово потребление. Ляво правителство е по-вероятно да предприеме достатъчни, за да не рухне икономиката. (Въпреки че и тези правителства обикновено имат задкулисни връзки с големите пари, които ще ги спират.) Дясно може да прояви разум и да се жертва, но може и да не вземе достатъчно и/или ефективни. А реакционери и/или политически измамници с мераци за корони и тронове вероятно дори ще се възползват от ситуацията, за да се сдобият с абсолютна власт. (Великата депресия е основна причина за мизерията в Германия през 1930-те, която докарва Хитлер на власт.) Ако сред тях има и собственици на големи AI, изкушението те да бъдат използвани за установяване на технототалитарен абсолютен контрол е много силно, и рискът за това общество е огромен.

Какви общества имат най-голям шанс да се справят добре с такава икономическа ситуация? Няма как да се предскаже с гаранция. Но при равни други условия най-добри шансове имат социални общества със силна либерална демокрация, кадърна регулация на AI бизнеса, ниска корупция, високо грамотен народ и към този момент с кадърно и не-популистко лявоцентристко правителство.

Ще има ли не само на теория, а и в реалността необходимото осъзнаване сред ключовите играчи на необходимостта да бъде запазена покупателната способност на масовите потребители? Някои дори вече го заявяват открито – примерно съм срещал подобни твърдения на Илон Мъск. Много други засега не са го казвали, но е малко вероятно да не го разбират. Някои обаче вероятно не го разбират и ще противодействат на адекватните мерки, особено твърде обвързаните с десни идеологии. (Идеологията на мозъка е тежък вид лудост. Не я подценявайте.)

Какви механизми могат да реализират нужното? Най-често обсъжданата и най-проста идея е безусловен базов доход за всички. Тя обаче има сериозен недостатък – би създала уравновиловка в обществото, а изравненото икономически общество не е добро за развитието. За него е нужен спектър на богатството – не прекалено широк и маргинализиран, но не и прекалено тесен. (Едно по-сериозно отърсване на икономиката от идеологиите и създаване в нея на нетърпимост към тях вероятно би позволило на кадърни учени и/или мощни AI да изведат формулите за определяне на оптималното за всяка икономическа ситуация разпределение на богатството в обществото. Но ще е трудно да се постигне, през последните няколко години икономиката се идеологизира до екстремна степен.) Така че вероятно ще е нужно да се помисли за подходящи механизми, способни да разпределят богатството в обществото по определен спектър, и да променят този спектър при икономическа необходимост.

Какви биха били ключовите проблеми пред това реализиране? Икономиката е ентропийна отворена система, подчиняваща се на статистическата механика. В такава система негентропията проявява тенденция към концентриране към „входящата зона“. Казано икономически, парите проявяват тенденция към концентриране в зоната, където принадената стойност навлиза в системата. По начало това е зоната, в която тя се създава – производството. Законодателни или икономически мерки могат да я изместят другаде, примерно в зоната на управление на потока на парите (банковата система). Силна мафия може да я измести в зоната на върхушката си, чрез грабителство. (Или ако контролира държавата – дори чрез подходящо законодателство.) Но където и да е тази зона, парите ще се опитват да се концентрират там. А концентрирането им ще се стреми да намали зоната до малка част от икономическата система.

На теория мерки, които поддържат зоната на навлизане на принадената стойност разпределена на много широка площ (включваща всичкия или почти всичкия капацитет за консумиране в икономиката), биха били оптимални в такава ситуация. Такива мерки обаче засега не са известни. Вероятно достатъчно мощен AI би могъл да предложи подходящи. Поддържането на тази зона много широка обаче е противостоене на естествената ѝ тенденция за свиване – възможно е да се окаже, че няма как да се направи достатъчно стабилно, за да издържа силни сътресения. А технологичните революции са именно такива, и при такава скорост на развитието ще са много чести.

На практика по-лесно се оказва парите в икономиката да бъдат преразпределяни от зоната, където се концентрират, към зоните с максимален потребителски капацитет. (Примерно богатите биват облагани с високи данъци, от които печелят всички – така икономическото неравенство продължава да съществува, но намалява като размер.) Известни са ни приличен брой такива механизми. Много от тях обаче имат сериозни недостатъци, например данъчното облагане често може да бъде изкривявано чрез заобикаляне на закона или вратички в него. Други начини, например разчитащите на фиксирана номенклатура, е възможно да стагнират развитието на икономиката, а може би и на технологиите и прогреса…

Като цяло, идеални мерки вероятно няма, дори за конкретно тази специфична ситуация. Но е напълно реално да има мерки, които при достатъчно широко и сериозно прилагане са достатъчно добри, за да намалят размера на икономическите проблеми до приемлив. Въпросът е дали ще бъдат приложени, и ако да – дали ще е достатъчно широко и сериозно.

5. Социалните последствия

Слагал ли е ваш колега гордо пред шефа 20 страници красив доклад, пълен с графики и прочее, как върви строежът, за който отговаря във фирмата той? Написан за една нощ с помощта на AI? Докато вие подсмърчате и се червите, понеже не умеете да се справяте с AI и докладът ви за вашия строеж е пет изречения? И разбирате отлично как изглежда в очите и на шефа, и на всички околни той, а как – вие? Не е малка разлика, нали?

(Да, докладът му вероятно хич не е идеален, съвременните AI не са още истински добри в това. Но шефът надали ще го разбере – вероятно ще накара някое AI да му го синтезира в пет изречения. Колкото е и вашият – но впечатлението от разликата ще остане… А и да забележак проблемите в доклада му, впечатлението е важното в тази история само за плиткоумните. Истински важното е, че той се е потил много часове, но се е научил как се правят хубави доклади с AI, а вие не сте. И занапред той ще посвещава още много часове за учене и трупане на нови знания и умения, често на цената на лишения и недоспиване. Докато вие най-много да научите как да правите с AI смешни картинки и какви са връзките между чакрите и предсказанията на баба Ванга. Защото толкова зор ще си дадете.)

Разликата изглежда голяма, но е микроскопична. След година-две този колега ще сложи пред шефа 20 000 страници (вероятно в електронен вид) проект за бъдещия ви строеж, подробен до последното кабарче по мебелите, перфектен във всяко отношение. Също направен за една нощ с AI, от актуалното след година поколение, преди вие да сте прочели докрай 20-те страници спецификация. След още година той за седмица не само ще направи проекта, но и ще построи сградата сам, с управлявани от AI ресурси, наети за една трета от стойността на работници. А след още година ще реализира сам със същата скорост и икономичност цели подводни или орбитални градове, Фулърови куполи или аркологии, мостове през морета или тунели под тях… Докато вие тепърва ще учите как се правят с някое чатджипити презентации и други подобни, от които вече никой не се интересува. Колко голяма на този фон е разликата с 20-страничния доклад?

Не бързайте да се депресирате, ей сега ще имате по-добър повод. Срещате тогава колегата и в разговора с него откривате, че той знае как точно се настройват резонансните струни на виола д’аморе. Може да нарисува по-добре от Леонардо изглед към Матерхорн от ледника Теодул. Да каже как точно ще се сгънат белтъчните молекули в хемоцианиновия комплекс в кръвта на краб-пътешественик, ако му инжектирате еди-кой си хемотоксин. Да докаже конектурата на Поанкаре по-елегантно от Перелман, за само няколко минути. Да разгроми на шах най-добрите сто шахматисти хора на света, в сеанс на едновременна игра срещу всичките. Да напише поезия, по-добра от тази на Верлен, на ведически санскрит или инупиак. И че е по-добър психолог и от гениите – може да разбере по едно ваше движение всичко, което ви безпокои, да ви предскаже перфектно, да ви манипулира за ваше добро или зло, по негов избор… Защото си е присадил имплант за връзка с AI, или се е научил да може всичко това по някакъв друг, дошъл от AI начин. А вие не сте.

Депресирахте ли се вече? Пак бързате. Той не само изглежда подмладен, отслабнал и с по-правилно лице. Наистина е – вече може да управлява просто с мисъл не само външността, а и възрастта си, старее само ако му се иска, подмладява се обратно когато му кефне, реално е безсмъртен. Вече никакви болести не го плашат не защото има лечения за тях, а защото организмът му вече не е податлив на тях. Може да вдигне тонове с една ръка и да улови с два пръста летяща муха със затворени очи, само по слух. Може да се гмурне до дъното на океана без да диша няколко часа и без да му пречат налягането, студът и тъмнината там. Ако изпразнят в него няколко картечни ленти, не само няма да умре на място, а след седмица-две дори без лечение ще е пак идеално здрав. И това е само началото на възможностите му. А всички те заедно са само началото на това, което ще може утре… Докато вие въздишате заради бръчките и белите си косми.

Ще стане ли всичко това за само две години? Може би не, дори въпреки скоростта на развитие на AI. Но и двайсет да отнеме, ще стане. И познайте колко ще ви утеши тогава, че е отнело по-дълго. Колегата ще пътува във влака към бъдещето, към нови и все по-невероятни чудеса. А вие ще сте останали на спирка, която за него ще е дори не Средновековие, а Питекантропие – и много скоро може да стане и Динозаврие…

Обществото ще се раздели на две групи. Група, която смогва да е актуална с развитието на технологиите, може би на цената на огромен труд и много жертви, но хората в нея сами определят съдбата си и са боговете на този свят на бъдещето. И група, която не смогва или се е отказала да е актуална, която просто се вози докъдето я закарат, и съдбата на хората в нея я определя първата група – реално те са неин добитък. Да, първата група може и да са добри към втората. Но дали ще го правят според интересите на тези във втората група, или според своите, е въпрос който е добре да си зададете.

В коя от двете групи ще сте, зависи от вас. Правите този избор в момента, с колко усилия ще посветите на учене на AI. Предупредени сте – не се оплаквайте, когато се окажете не в която група искате. Направите ли от мързел и/или глупост грешния избор, се сърдете на себе си. И ако собствените ви деца ви заплюят утре в очите, знайте, че сте го заслужили.

6. Добре, а какво да правим?

Въпросът за много повече от един милион долара.

Вече има сума ти статии по въпроса, и повечето казват едно и също. Можете да им вярвате, ако не идват от пропагандна радиоточка. Бих добавил и от мен:

– Стегнете си финансите. Веднага, не догодина. Нищо, че вече е трудно – то е, защото нещата вече се движат по нанадолнището, не ги чакайте и да наберат скорост, тогава хич няма да можете. Колко сериозни сътресения ни чакат не е ясно. Може почти да ги няма. Може да са зловещи. Когато има приличен шанс да завали пороен дъжд, е разумно да си вземеш чадър. Пък нека дъждът се размине.
– Въпросът „Какво да науча, че да ме храни следващите 10 години“ вече е индикатор за идиот. Учете каквото ще ви храни веднага, или почти веднага – ще остарее още преди да го научите. Свикнете непрекъснато да учите и непрекъснато да сменяте каквото учите, често драстично, изоставяйки плода на огромни усилия. Могъщите динозаври са измрели, защото не са се адаптирали достатъчно. Мишеподобните бозайници са оцелели, защото са.
– Днес AI не е съвършен – халюцинира, дава грешни съвети. Утре ще е много по-умен, и от днес, и от вас. Не го съдете по спомените си от днес или особено пък от вчера. Да мислите зрял юначага за бебето, което е бил, е неразумно подценяване.
– До 10-15 години, ако не се случи някакво ужасяващо бедствие, ще са възможни неща които днес изглеждат фантазия. Но ще са за който може да си ги позволи, а отначало това няма да е всеки. По-добре да можете, с пари или знания. И двете се постигат днес със здраво учене на AI.
– Учете не само как да работите с AI, а и как работи самият той. Да можете да се возите в кола не е ценност за никой, който би ви плащал. Ценност е да можете да карате кола по-добре от 99% от хората или да можете да ремонтирате или сглобите кола.
– Учете не по два часа седмично – по четири часа дневно, поне 6 дни седмично. Не от след месец – от днес, след месец вече хубавите вагони в този влака ще са заминали, а може би и лошите.
– Непрекъснато се напъвайте да научите и още, да пробвате и каквото не сте. Денят, в който си кажете „Научих достатъчно за днес“, е денят в който сте слезли от влака. Ако си казвате за нещо „Много зор ще е, но мога да го науча“, значи е важно за учене, но не е най-важното. Най-важното за учене е това, за което си казвате: „Това посмъртно не мога да го науча“ – подхващайте го веднага и без колебание.
– Каквото сте научили днес, утре вече няма да е същото, познанията ви ще са остарели до безполезност. Нормално е, възприемайте го като нещо естествено. Пренаучавайте се моментално, оставяйте днешното учене за утре само ако искате то вече да няма смисъл.
– Колкото по-напред отиват нещата, толкова повече и по-здраво учене ще ви трябва, за да не слезете от влака. Където слезете там ще останете, друг влак напред няма да има. А влакът е все по-бърз, малко допълнителен престой в него ви откарва доста по-напред, по-нататък – повече. Струва си да се напънете докрай.
– Колкото по-дълго се задържите на влака, толкова повече възможности ще имате. Ако нещата вървят с този темп, до максимум 10 години хората ще се разделят на „магьосници“ и „добитък“. В първата ще са задържалите се във влака достатъчно дълго. Във втората – останалите над 99%. Сетете се каква ще е разликата между двете, примерно в какво ще могат тези в едната и тези в другата група, и защо е добре да сте в първата.
– Вероятно с времето ще почне да има и AI с „открити познания“ (а и код на софтуера, който ги движи). Предпочитайте ги пред „закритите“ – точно както разумният човек предпочита софтуера с отворен код пред този със затворен, и откритите хора пред потайните. (Ако някой мисли иначе, не спорете с него. Умствените ресурси са ви нужни за учене на AI, не ги пилейте. Идиотите са за игнориране, не за спорене с тях.)
– Ако от някой момент нататък стане невъзможно да сте във влака без неща като мозъчни импланти и подобни, бъдете внимателни. Не ги ли вземете, изпадате. Вземете ли ги безразсъдно, ще ви се иска да бяхте изпаднали. Преценете как да го направите без риск за автокефалността си. Главата ви е за да носите шапка само ако сте плашило – на хората им е за мислене. И е полезно да я товарите здраво, и за нея, и за вас. Вид тренировка е.
– Същото важи изобщо за използването на AI. Дори да сте реалист и факт-чекър, мощта на днешен добър AI вече може да ви обамбузи здраво, ако му вярвате безпрекословно. Примерно ако сте се чули някога да кажете „Ама аз питах чатджипити!“. (И дори ако зад това не стои нечие намерение, а просто усилените през неговото богатство ваши си деформации.) Утрешните AI ще са несравнимо по-мощни – не ставайте нечии зомбита, не е живот.

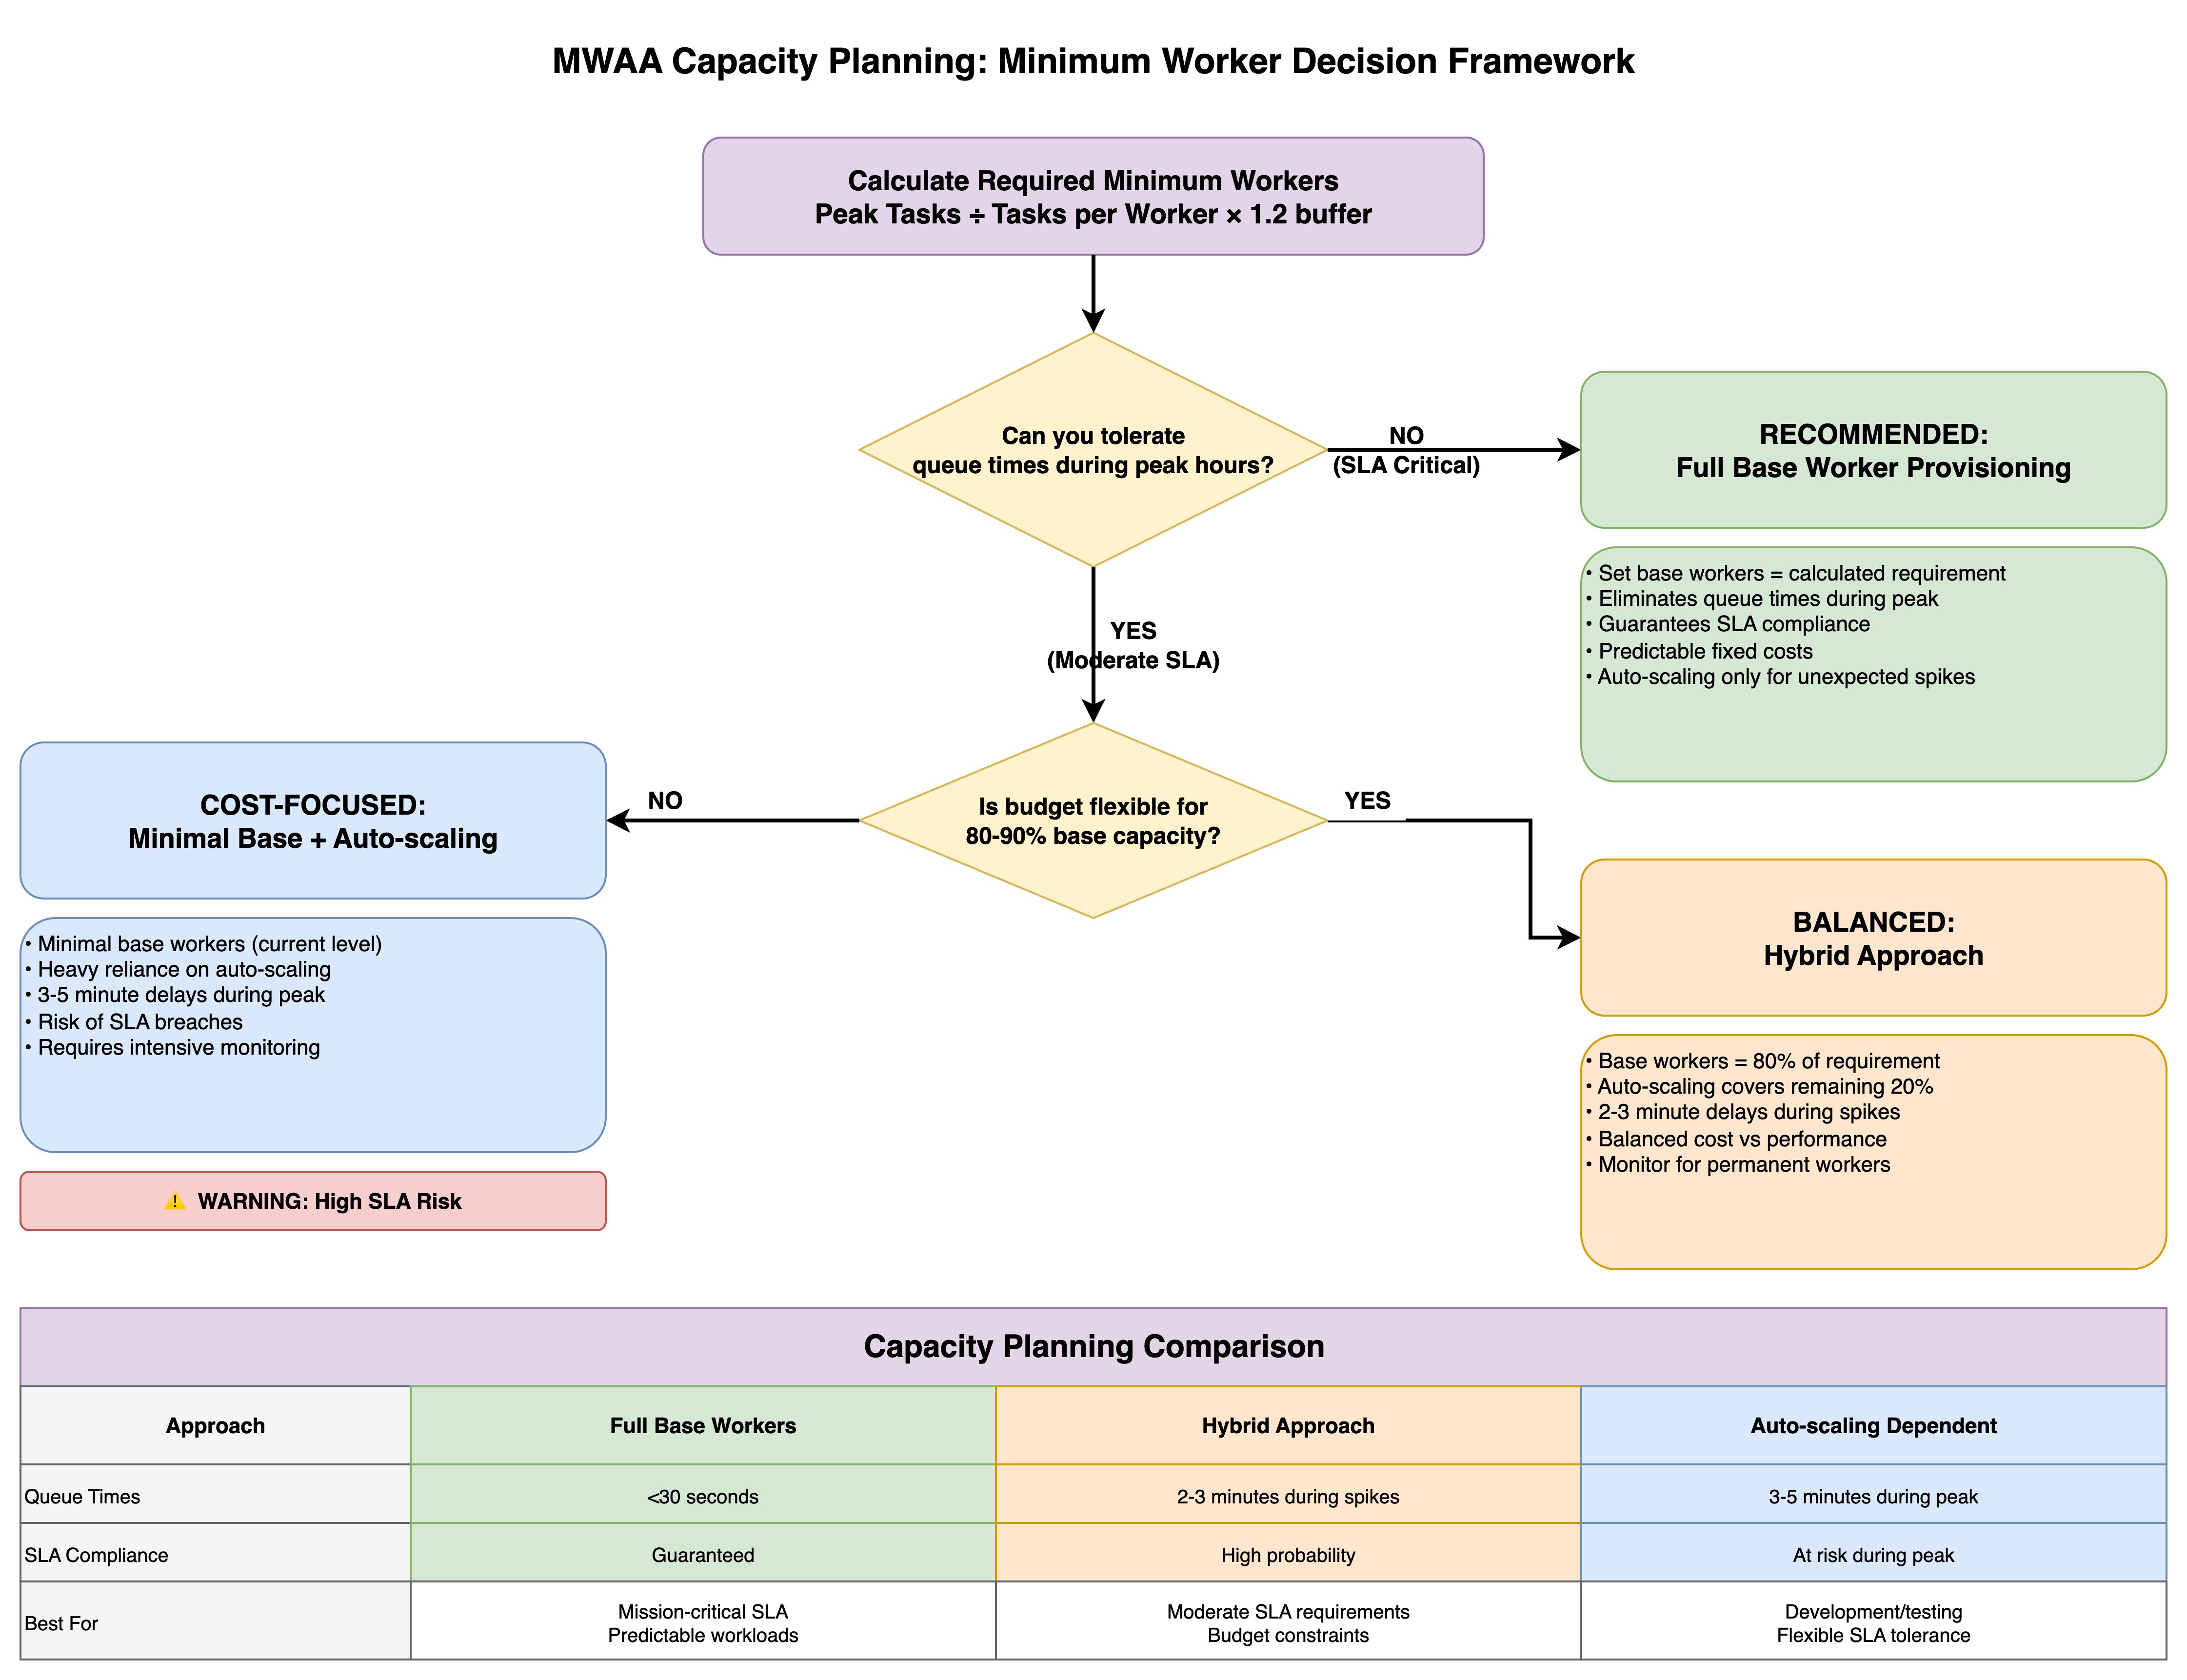
Enhancing network observability with new AWS Outposts racks LAG metrics

Post Syndicated from Adam Duffield original https://aws.amazon.com/blogs/compute/enhancing-network-observability-with-new-aws-outposts-racks-lag-metrics/

When you deploy AWS Outposts racks, you can run AWS infrastructure and services in on-premises locations. Maintaining seamless connectivity, both to the AWS Region and your on-premises network, is fundamental to delivering consistent, uninterrupted service to your applications. Implementing an observability strategy that uses available network metrics is key to understanding the health of this connectivity.

In August 2025, we launched two new Amazon CloudWatch metrics, VifConnectionStatus and VifBgpSessionState, that helped provide greater visibility into these Layer 3 networking constructs. However, insight into Layer 2 networking was still missing. AWS has released a new metric LagStatus, that provides greater visibility into the hybrid infrastructure connectivity for both first-generation and second-generation Outpost racks.

Link aggregation group overview

Link aggregation combines multiple physical Ethernet connections into one logical link, referred to as a link aggregation group (LAG). This consolidation delivers benefits such as increased aggregate bandwidth and built-in redundancy through fault-tolerant connections between network devices. AWS Outposts uses LAG connections between Outpost network devices (ONDs) and customer network devices (CNDs). The links from each Outpost network device are aggregated into an Ethernet LAG to represent a single network connection.

Figure : Second-Generation Outposts Rack network connections

Figure : Second-Generation Outposts Rack network connections

Each LAG between an Outpost network device and a customer local network device is configured as an IEEE 802.1q Ethernet trunk. This enables the use of multiple VLANs for network segmentation between data paths. Each Outpost has the following VLANs to communicate with local network devices:

  • Service link VLAN – Enables communication between the Outpost and customer network devices to establish a service link path to the AWS Region.
  • Local gateway VLAN(s) – (If exists, and as single or multiple LGW routing domains), enables communication between Outpost and the customer network devices to establish a local gateway path to connect your Outpost subnets to the local area network.
Figure : Second-Generation Outposts Rack VLAN layout

Figure : Second-Generation Outposts Rack VLAN layout

Using the LagStatus metric

The new LagStatus metric in CloudWatch provides visibility into the operational status of LAG connections between Outposts networking devices and on-premises infrastructure. The metric reports a binary status (1 for the LAG being UP, 0 for the LAG being down) and includes the OutpostId and LagId as dimensions to quickly identify non-operational resources.

You can view this metric on the CloudWatch console. As with all operational telemetry, access to these metrics should be appropriately restricted to authorized principals. The metric data points are published at 5-minute intervals, and like all CloudWatch metrics, there might be a time lag in the metric data being published. In the navigation pane, choose All metrics, followed by Outposts under the AWS namespaces section. The Outposts namespace can only be viewed by the Outposts owner account, unless CloudWatch cross-account observability is configured.

Figure : CloudWatch Metrics view of the LagStatus metric

Figure : CloudWatch Metrics view of the LagStatus metric

While the LagStatus metric alone provides insight into the Outposts network connectivity, combining it with VifConnectionStatus and VifBgpSessionState delivers more immediate, actionable insights that expedite troubleshooting. In addition, to improve the clarity of the existing metrics, the related LagID is added as a new Outposts metric dimension. By observing the values of all three metrics, you can narrow down the potential cause of any issues. The following table gives some possible connectivity issue scenarios and how they can be identified using these metrics:

LagStatus LGW BGP ServiceLink BGP Potential issue
UP UP UP Recommended state – all components working
UP UP DOWN ServiceLink BGP issue – configuration issue
UP DOWN UP LGW BGP issue – configuration issue
UP DOWN DOWN Both BGP sessions down – configuration issue
DOWN DOWN DOWN Lag configuration issue or Physical failure

With these metrics, you can use CloudWatch Composite Alarms to alert operational teams when any of the components aren’t running as expected.

To create a composite alarm, alarms must first be defined for all three of the individual metrics. This can be done from the console, CLI, or AWS CloudFormation. Following the principle of least privilege, ensure that IAM permissions are restricted to the minimum actions required for CloudWatch alarm creation. For more information, see the CloudWatch documentation. If you prefer, you can configure these individual alarms without notification actions enabled to reduce potential notification noise. Each virtual interface (VIF) has its own set of metrics, so you would need to configure alarms for all VIFs used with your Outpost. The number of total VIFs will vary depending on the Outpost generation that’s deployed because of the different networking architectures.

First-generation Outposts racks use four VIFs per rack (two for Service Link, two for Local Gateway). Second-generation racks require a minimum of eight VIFs (four for Service Link, four for Local Gateway), because they support multiple local gateway routing domains, each with its own VIFs.

An example alarm configuration as seen in the console for a single VIF is shown in the following figure 4.

Figure : Individual CloudWatch alarms for VIF status

Figure : Individual CloudWatch alarms for VIF status

After these individual alarms are created, a composite alarm can be created that monitors for any of the component metrics going into an alarm status. In the following example, the AWS Command Line Interface (AWS CLI) is used to create the composite alarm called composite-alarm-lag1 and send a notification using an Amazon Simple Notification Service (Amazon SNS) topic called outpost-network-alarms. As this topic carries infrastructure health data, it’s recommended to encrypt it using an AWS Key Management Service key and restrict the subscription policy to authorized principals.

aws cloudwatch put-composite-alarm \
  --alarm-name "composite-alarm-lag1" \
  --alarm-rule "ALARM(VifBgpSessionState-lgw-vif-xxxxxxxxxxxx) OR ALARM(VifConnectionStatus-lgw-vif-xxxxxxxxxxxx) OR ALARM(VifBgpSessionState-sl-vif-xxxxxxxxxxxx) OR ALARM(VifConnectionStatus-sl-vif-xxxxxxxxxxxx) OR ALARM(LagStatus-op-lag-xxxxxxxxxxxx)" \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:outpost-network-alarms \
  --region us-east-1

You can use this granular monitoring to quickly identify and troubleshoot connectivity issues, particularly in scenarios where LAG status is up but VIF BGP status is down.

Conclusion

This post provides details about the newly released LagStatus CloudWatch metric, and how this metric can be used with existing metrics such as VifConnectionStatus and VifBgpSessionState to build a comprehensive network connectivity observability solution. The LagStatus metric is now available in all commercial AWS Regions and the AWS GovCloud (US-East) and AWS GovCloud (US-West) Regions where Outposts racks are available, for both first-generation and second-generation racks at no additional cost.

For more information about Outposts rack networking patterns, see the Networking section of the Outposts High Availability Design and Architecture Considerations whitepaper.

Reach out to your AWS account team, or fill out this form to learn more about observability for Outposts.

The collective thoughts of the interwebz