Workers AI Update: Stable Diffusion, Code Llama + Workers AI in 100 cities

Post Syndicated from Phil Wittig original http://blog.cloudflare.com/workers-ai-update-stable-diffusion-code-llama-workers-ai-in-100-cities/


Workers AI Update: Stable Diffusion, Code Llama + Workers AI in 100 cities

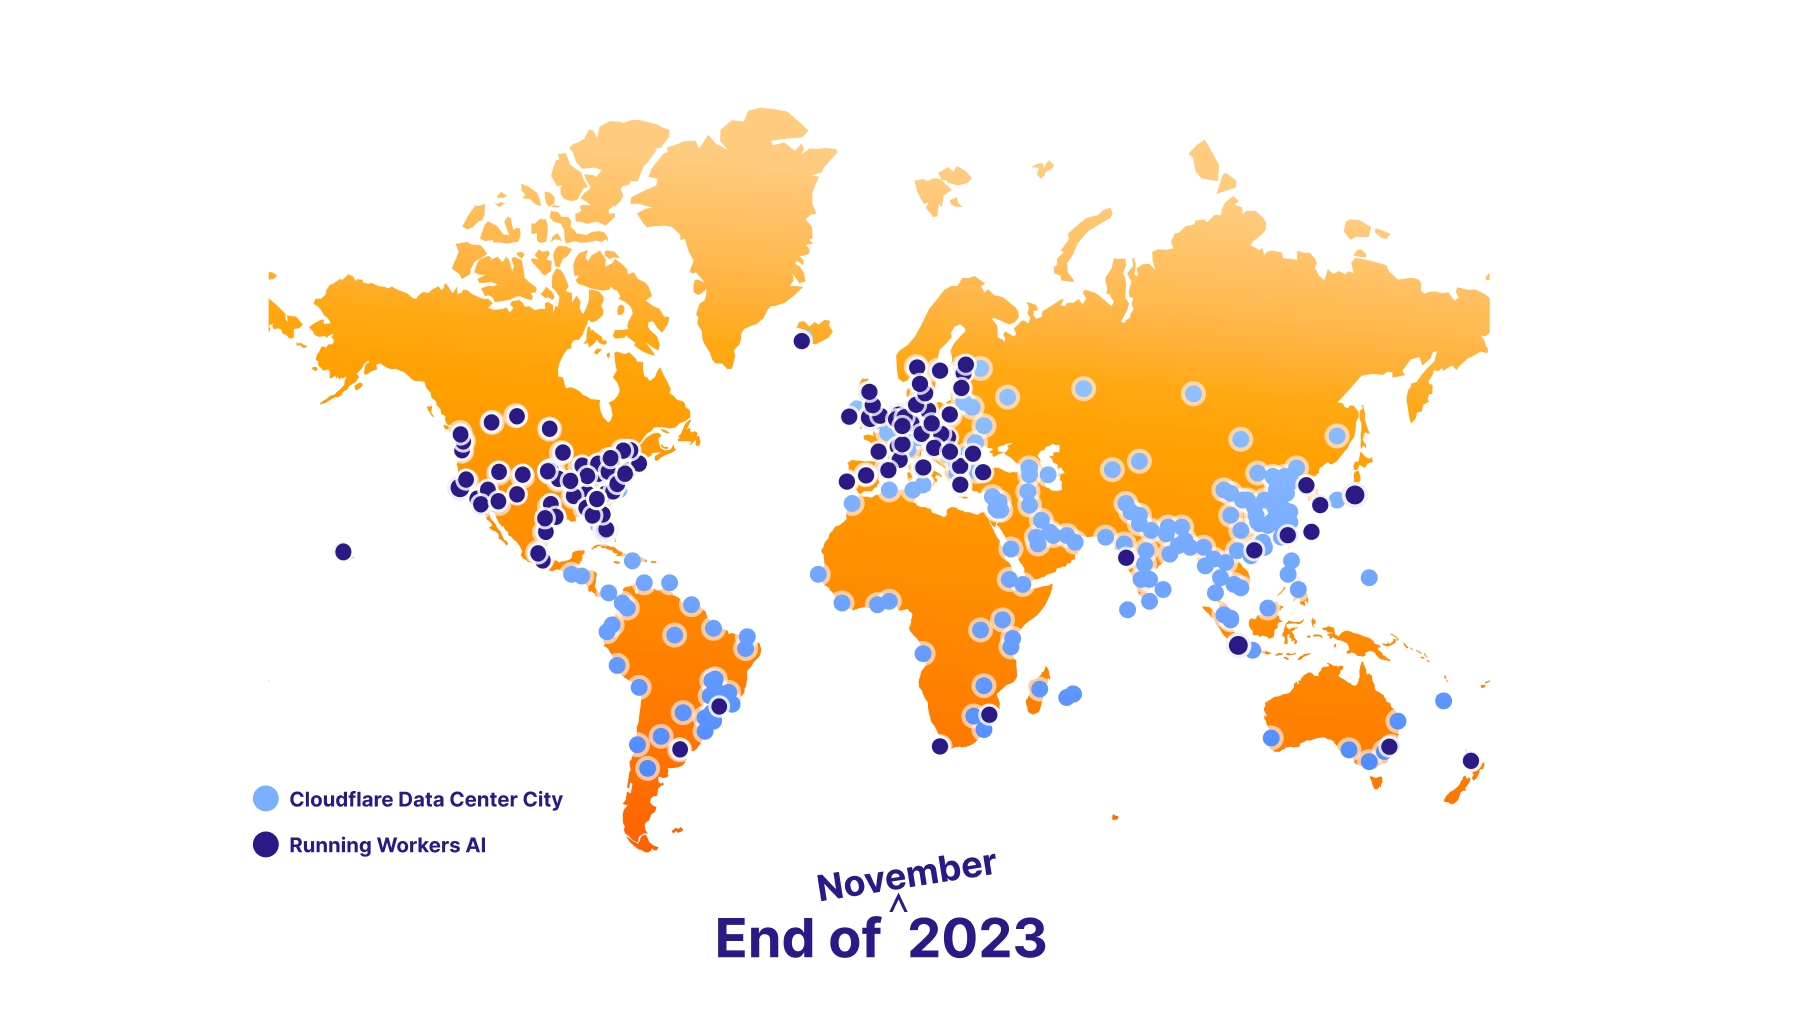
Thanksgiving might be a US holiday (and one of our favorites — we have many things to be thankful for!). Many people get excited about the food or deals, but for me as a developer, it’s also always been a nice quiet holiday to hack around and play with new tech. So in that spirit, we’re thrilled to announce that Stable Diffusion and Code Llama are now available as part of Workers AI, running in over 100 cities across Cloudflare’s global network.

As many AI fans are aware, Stable Diffusion is the groundbreaking image-generation model that can conjure images based on text input. Code Llama is a powerful language model optimized for generating programming code.

For more of the fun details, read on, or head over to the developer docs to get started!

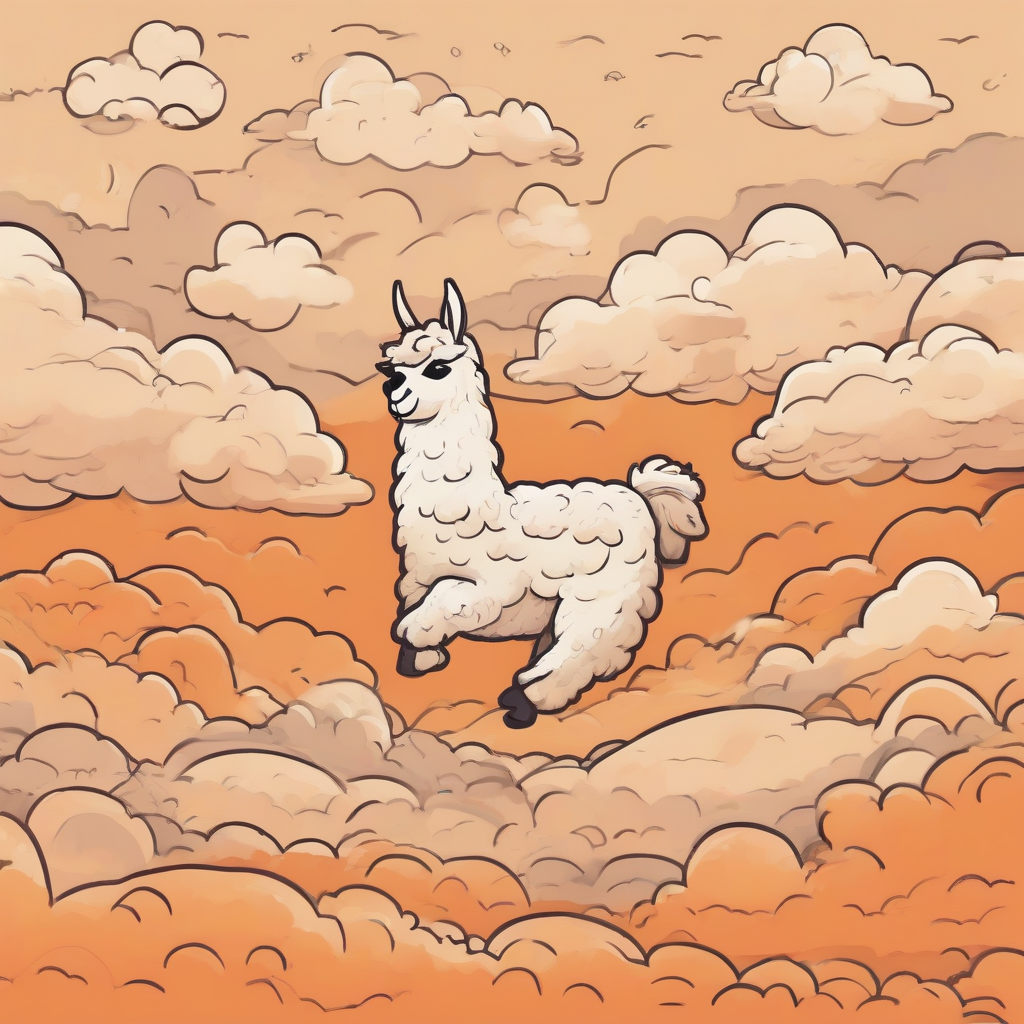
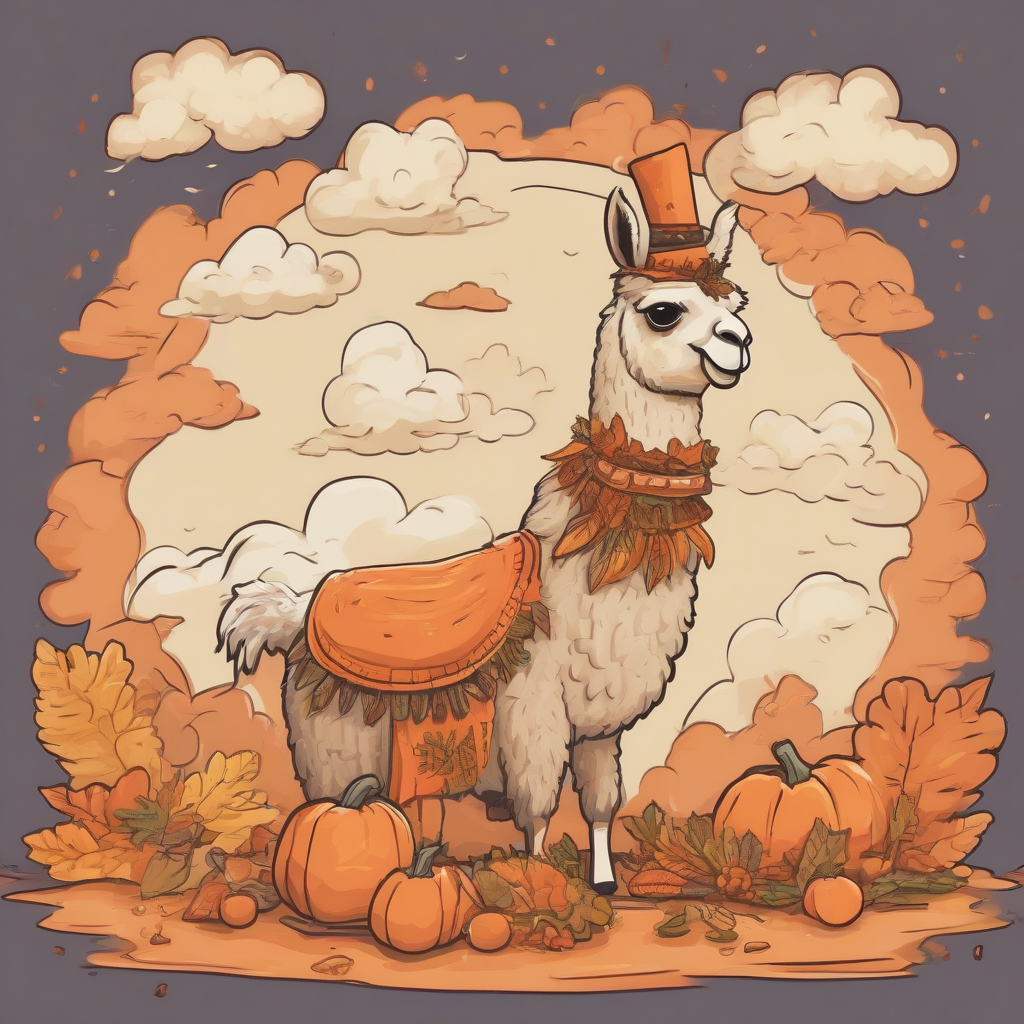
Generated by Stable Diffusion – “Happy llama in an orange cloud celebrating thanksgiving”

Generating images with Stable Diffusion

Stability AI launched Stable Diffusion XL 1.0 (SDXL) this past summer. You can read more about it here, but we’ll briefly mention some really cool aspects.

First off, “Distinct images can be prompted without having any particular ‘feel’ imparted by the model, ensuring absolute freedom of style”. This is great as it gives you a blank canvas as a developer, or should I say artist.

Additionally, it’s “particularly well-tuned for vibrant and accurate colors, with better contrast, lighting, and shadows than its predecessor, all in native 1024×1024 resolution.” With the advancements in today’s cameras (or phone cameras), quality images are table stakes, and it’s nice to see these models keeping up.

Getting started with Workers AI + SDXL (via API) couldn’t be easier. Check out the example below:

curl -X POST \
"https://api.cloudflare.com/client/v4/accounts/{account-id}/ai/run/@cf/stabilityai/stable-diffusion-xl-base-1.0" \
-H "Authorization: Bearer {api-token}" \
-H "Content-Type:application/json" \
-d '{ "prompt": "A happy llama running through an orange cloud" }'
-o 'happy-llama.png'

And here is our happy llama:

You can also do this in a Worker:

import { Ai } from '@cloudflare/ai';
export default {
  async fetch(request, env) {
    const ai = new Ai(env.AI);
    const response = await ai.run('@cf/stabilityai/stable-diffusion-xl-base-1.0', {
      prompt: 'A happy llama running through an orange cloud'
    });
    return new Response(response, {
      headers: {
          "content-type": "image/png",
      },
  });
  }
}

Generate code with Code Llama

If you’re not into generating art, then maybe you can have some fun with code. Code Llama, which was also released this last summer by Meta, is built on top of Llama 2, but optimized to understand and generate code in many popular languages (Python, C++, Java, PHP, Typescript / Javascript, C#, and Bash).

You can use it to help you generate code for a tough problem you’re faced with, or you can also use it to help you understand code — perfect if you are picking up an existing, unknown codebase.

And just like all the other models, generating code with Workers AI is really easy.

From a Worker:

import { Ai } from '@cloudflare/ai';

// Enable env.AI for your worker by adding the ai binding to your wrangler.toml file:
// [ai]
// binding = "AI"

export default {
  async fetch(request, env) {
    const ai = new Ai(env.AI);
    const response = await ai.run('@hf/thebloke/codellama-7b-instruct-awq', {
      prompt: 'In JavaScript, define a priority queue class. The constructor                must take a function that is called on each object to determine its   priority.'
    });
    return Response.json(response);
  }
}

Using curl:

curl -X POST \
"https://api.cloudflare.com/client/v4/accounts/{account-id}/ai/run/@hf/thebloke/codellama-7b-instruct-awq" \

-H "Authorization: Bearer {api-token}" \-H "Content-Type: application/json" \
-d '{ "prompt": "In JavaScript, define a priority queue class. The constructor must take a function that is called on each object to determine its priority." }

Using python:

#!/usr/bin/env python3

import json
import os
import requests

ACCOUNT_ID=os.environ["ACCOUNT_ID"]
API_TOKEN=os.environ["API_TOKEN"]
MODEL="@hf/thebloke/codellama-7b-instruct-awq"

prompt="""In JavaScript, define a priority queue class. The constructor must take a function that is called on each object to determine its priority."""
url = f"https://api.cloudflare.com/client/v4/accounts/{ACCOUNT_ID}/ai/run/{MODEL}"
headers = {
  "Authorization": f"Bearer {API_TOKEN}"
}
payload = json.dumps({
  "prompt": prompt
})

print(url)
r = requests.post(url, data=payload, headers=headers)

j = r.json()
if "result" in j and "response" in j["result"]:
   print(r.json()["result"]["response"])
else:
   print(json.dumps(j, indent=2))

Workers AI inference now available in 100 cities

When we first released Workers AI back in September we launched with inference running in seven cities, but set an ambitious target to support Workers AI inference in 100 cities by the end of the year, and nearly everywhere by the end of 2024. We’re proud to say that we’re ahead of schedule and now support Workers AI Inference in 100 cities thanks to some awesome, hard-working folks across multiple teams. For developers this means that your inference tasks are more likely to run near your users, and it will only continue to improve over the next 18 months.

Mistral, in case you missed it

Lastly, in case you didn’t see our other update earlier this week, we also launched Mistral 7B, a super capable and powerful language model that packs a punch for its size. You can read more about it here, or start building with it here.

Go forth and build something fun

Today we gave you images (art), code, and Workers AI inference running in more cities. Please go have fun, build something cool, and if you need help, want to give feedback, or want to share what you’re building just pop into our Developer Discord!

Happy Thanksgiving!

Additionally, if you’re just getting started with AI, we’ll be offering a series of developer workshops ranging from understanding the basics such as embeddings, models and vector databases, getting started with LLMs on Workers AI and more. We encourage you to sign up here.

Няма хора – няма бизнес

Post Syndicated from Александър Нуцов original https://www.toest.bg/nyama-hora-nyama-biznes/

Няма хора – няма бизнес

След като в предишните два текста от поредицата за предизвикателствата пред бизнеса в България разгледахме административните пречки и слабата дигитализация, както и проблемите с достъпа до капитал, днес ще говорим за недостига на кадри. И то на такива, които могат да вършат работата, за която са желани. 

С възходящото развитие на ИТ индустрията в България гладът за добре подготвени специалисти в сферата расте постоянно. Това важи и за много от модерните високотехнологични инженерни и научни области, в които все повече български предприемачи и компании развиват своята дейност. На този фон от разговорите ни с работодатели и HR компании разбираме, че в страната ни повсеместно се усеща недостиг на кадри и за нискоквалифициран труд. Тоест за такъв вид работа, която не изисква специални умения, опит или заложби. 

Тази картина създава съществени проблеми пред растежа на българската икономика – както на макро-, така и на микроравнище. Немалко работодатели в България са принудени да обучават „от нулата“ или да преквалифицират персонал, за да запълнят пробойните в собствената си компания. Това е свързано с ценен финансов, времеви и административен ресурс, който иначе може да се спести и вложи в растеж на компаниите. 

На макрониво големите български и чуждестранни инвеститори избягват страната ни заради липсата на висококвалифицирани специалисти – наред с други причини, като корупция, политически зависимости и липса на адекватна държавна помощ. 

Представете си например, че сте предприемач, който планира да направи многомилионна инвестиция в завод за части в областта на роботиката. За да произвежда обаче, заводът се нуждае от няколкостотин висококвалифицирани инженери, с които България не разполага. Съседните ни страни или държавите от Централна Европа, например Унгария, могат да осигурят подготвени специалисти. Дори при равни други условия (каквито те не са) ще изберете ли България за своята инвестиция? 

Войната и бизнесът

Проблемът с недостига на кадри не е нов, както и разбирането, че България не е способна сама да утоли глада на бизнеса. Затова дебатът се насочва все повече към възможностите да привличаме хора отвън. Тъй като разликата в стандарта на живот между България и останалите държави от Европейския съюз е твърде значителна, не можем да разчитаме на прилив на хора от тях. Логично, погледът ни е насочен основно към пазара на труда в трети страни. 

Съществува ли обаче целенасочена държавна политика в тази посока? Донякъде и отскоро. Донякъде, защото от 2011 г. и в България съществува механизъм за привличане на висококвалифицирани служители от страни извън ЕС, известен като синя карта. 

Отскоро, защото политиците приоритизираха сериозно темата едва през последните една-две години. Причината за това е проста – войната. Руската инвазия в Украйна създаде огромна несигурност сред предприемачите и работещите в региона. Това принуди както украинци, така и руснаци и беларуси да потърсят пристан и работа в други европейски държави. 

След разпалването на израелско-палестинския конфликт темата придобива все по-ключови измерения. По време на ноемврийския форум Powers Summit, който срещна представители на бизнеса с политиците, модераторът зададе въпрос на премиера Николай Денков относно възможностите на България да привлече и помогне на служители и предприемачи от горещите военни точки. И макар че Денков по-скоро заобиколи въпроса, важно е да отбележим, че страната ни разполага с такива инструменти – сините карти и т.нар. стартъп виза.

Сини карти

Тези удостоверения позволяват на висококвалифицирани специалисти от трети страни да работят и пребивават в държави от ЕС за определен период. Пътят за кандидатстване и одобрение стъпва на европейското законодателство, но механизмът за прилагането на сините карти е индивидуален за отделните страни членки. И понеже процедурата в България беше твърде тромава, под натиска на бизнеса през януари Народното събрание прие пакет от промени, целящи да улеснят издаването на сини карти. 

Най-важните подобрения са свързани със сериозното скъсяване на периода за вътрешноведомствени проверки между различните органи (включително МВР, ДАНС, Агенцията по заетостта, Изпълнителна агенция „Главна инспекция по труда“ и МВнР). Заради тях целият процес по издаване на синя карта отнемаше до осем месеца – време, което не съответства на бързо променящите се геополитически обстоятелства и нуждите на пазара на труда. Целта е цялата процедура по издаване на документа да се сведе до максимум два месеца. 

Срокът на давност на сините карти е удължен до пет години. Освен това на кандидатите вече се признават трудов стаж и професионален опит, а не само диплома, както преди. Те вече могат да работят и от разстояние, както и да сменят позицията и местоработата си на територията на страната, без да е необходимо преиздаване на самата пластика. С промените чуждестранните служители са здравноосигурени като българските си колеги, което пък спестява разходи на работодателите за допълнително здравно осигуряване. И още, целият процес трябва да се дигитализира, щом се изгради необходимата за това електронна инфраструктура. 

Тези промени обаче далеч не са достатъчни. От разговорите ни с бизнеса разбираме, че издаването на сини карти все още не е достатъчно бързо, гъвкаво и прозрачно. След като се подадат, документите се губят в институционалната бъркотия, а кандидатите често са в неведение докъде е стигнала процедурата. 

Това продължава да възпира голяма част от чуждестранните специалисти, поради което те се насочват към други европейски дестинации с много по-облекчени режими на кандидатстване. Предстои Народното събрание да разгледа втори пакет от мерки, чиято цел е да изгладят недостатъците, свързани с комуникацията и взаимодействието между институциите. В началото на ноември приключи общественото обсъждане на подготвените промени, а от мотивите разбираме, че подобряването на съвместната работа между компетентните органи е сред приоритетите.

По данни на Националния статистически институт издадените за 2022 г. сини карти възлизат на 1089, от които 922 са издадени за първи път, а 167 са подновени.

Стартъп виза

Войната в Украйна и конфликтът между Израел и Палестина изведоха на преден план въпроса за оцеляването на бизнесите в горещите зони. Принудени от обстоятелствата, много предприемачи търсят начин да преместят компаниите си в трети страни, за да продължат да съществуват. Резонен в случая е въпросът дали в България има механизъм, с който да се подаде ръка на тези предприемачи. 

Отскоро Министерството на иновациите и растежа издава т.нар. стартъп виза. Тя е чисто нов инструмент за привличане на предприемачи извън ЕС. Накратко, това е бърза писта за привличане на бизнеси от трети страни в България чрез издаване на разрешение за продължително пребиваване. Компаниите обаче трябва да отговарят на определени условия: преди всичко да са високотехнологични и да развиват иновативни продукти или услуги. Дали това е така, се определя по утвърдена точкова система от комисия, състояща се от представители на институциите и бизнеса. 

Тъкмо от тези представители научаваме, че одобрените компании към момента надвишават десет – сред тях има също от Украйна и Русия. Целта на стартъп визата е проста – да привлича в България бизнеси, развиващи иновации, които да плащат данъци тук и да осигуряват конкурентни заплати. Предстои процедурата да се усъвършенства в посока улесняване и обективизиране на критериите за одобрение. 

За бизнеса и хората

Докато образователната ни система, изглежда, се проваля в подготовката на ученици и студенти за съвременния пазар на труда, все повече компании и предприемачи основават собствени академии или помагат на училища и университети, като създават лаборатории и условия за качествено обучение. Обикновено го правят в сфери на икономиката с висока добавена стойност – инженерство, ИТ, модерно предприемачество и т.н. Ролята на държавата по отношение на образованието обаче трябва да се преосмисли из основи, особено на фона на очакваните лоши резултати от PISA – проучването за функционалната грамотност на учениците по света, което е разработено от Организацията за икономическо сътрудничество и развитие и се провежда веднъж на всеки три години.

Докато сините карти и стартъп визата са насочени към модернизация на икономиката, повече иновации и по-висока добавена стойност, в България назрява глад и за кадри в традиционни сфери, за които не са необходими специални умения и професионален опит. Работодатели и компании за подбор на персонал все по-настойчиво посочват нуждата от законодателни промени, които да улеснят достъпа до кадри от трети страни и в това направление. 

Едно е сигурно: на този етап България не може сама да задоволи нуждата от персонал на вътрешния си пазар. Затова е необходима целенасочена политика за привличане на работна ръка отвън и подобряване на модела и качеството на образованието отвътре. Това трябва да става във взаимодействие с бизнеса, който все по-явно компенсира несъвършенствата на образователната система, създавайки академии и обучителни центрове, отговарящи на съвременните пазарни изисквания.

Coolest Projects is back in 2024

Post Syndicated from Helen Gardner original https://www.raspberrypi.org/blog/coolest-projects-2024-dates/

Big news for young tech creators: Coolest Projects will return in 2024. The world’s leading showcase for young creators of digital tech will be open for registration in the online gallery, and we want young people worldwide to showcase their tech projects.

In 2024, we are hosting the Coolest Projects online showcase and livestream celebration for all young creators around the world, and also in-person events in the UK and Ireland for young creators who live there.

A girl presenting a digital making project

Key dates for Coolest Projects 2024

All young tech creators can take part — for free — in the Coolest Projects online showcase:

  • Registration opens: 14 February 2024
  • Registration closes: 22 May 2024
  • Celebratory livestream with announcement of the judges’ favourite projects: 26 June 2024
A young person using Raspberry Pi hardware and learning resources to do digital making

How does Coolest Projects work?

Coolest Projects is an opportunity for young tech creators to share what they have made with the world. Young people register their tech creations to show them the Coolest Projects online showcase gallery. Alongside mentors, parents, friends, and family members in their local and global communities, they can explore the gallery and celebrate what they and their peers have made.

Who can take part?

  • Coolest Projects is open to all tech creators up to age 18
  • Tech creators of all experience levels are encouraged to participate
  • Creators can take part individually or in teams of up to five
  • Creators can live in any place in the world
  • Participation is free
A boy participating in Coolest Projects shows off his tech project together with an adult.

What kinds of tech projects can be part of Coolest Projects?

  • All projects are welcome, whether they are beginner, advanced, or something in between
  • Projects can be registered in six categories: Scratch, games, web, mobile apps, hardware, and advanced programming
  • We love to see works in progress, so projects don’t need to be completed to be registered
  • Creators can choose any topic for their project, for example community, environment, health, fun, art, education, or identity
A group of young women present a robot buggy they have built.

What happens after registration?

  • The online gallery is open for young tech creators to explore to see what their peers all over the world have made
  • Judges evaluate projects based on their coolness, complexity, design, usability, and presentation, and give feedback to creators about their projects
  • Judges pick some of their favourite projects to highlight, and every participant gets a unique certificate and some fun digital swag
  • Participants and the whole global Coolest Projects community celebrates young tech creators’ ingenuity on our livestream on 26 June
Four young coders show off their tech project for Coolest Projects.

How can young people get started with their projects?

If your kids want to learn about creating with technology, check out our free guided coding project paths. These paths are designed to support all young people to learn how to make their own tech projects and develop their coding skills. For example:

  • For young people who are completely new to coding, our Introduction to Scratch path is a great place to start
  • If young people would like to create their own website, for example to share information about a cause they care about, they can follow our Intro to web path
  • The Introduction to Unity path is perfect for more experienced creators who are keen to build interactive 3D world

Young creators can take a look at the Coolest Projects 2023 online showcase gallery for inspiration if they are not sure what they want to make. You can also watch the story of Zaahra and Eesa, siblings who participated in Coolest Projects 2020.

Coolest Projects in-person events: Ireland and the UK

If you are a young creator in Northern Ireland, the Republic of Ireland, or the UK, then Coolest Projects is also coming to you in person in 2024. Participants will be able to meet other young tech creators, connect to their community, and celebrate each other’s creations. Young people are encouraged to take part in both the Coolest Projects global online showcase and their local in-person event.

Coolest Projects Ireland

  • Registration opens: 31 January 2024
  • Registration closes: 20 March 2024
  • Event day: 13 April 2024
The exhibition hall at Coolest Projects Ireland 2023.
Coolest Projects Ireland 2023

Coolest Projects Ireland will take place at DCU St Patrick’s College Campus, Drumcondra in Dublin. It’s open to young creators in Northern Ireland and the Republic of Ireland, and their families and friends are invited to come along to celebrate them and see all the incredible projects on show. Participants can apply for partial bursaries for the costs of attending the event.

Coolest Projects UK

Very soon we will announce the date and venue for Coolest Projects UK for all young creators in the UK. Sign up for email updates to be the first to hear about it. We will also share full details of each in-person event on the Coolest Projects website when registration opens.

A young person creating a project at a laptop. An adult is sat next to them.

If you live in another country…

If there’s not an in-person Coolest Projects event near you, you can still join in the fun: the Coolest Projects online showcase is open to any young creator aged up to 18, from anywhere in the world. We also work with brilliant partner organisations around the world to bring Coolest Projects events to their countries and communities. Sign up to the Coolest Projects newsletter to be the first to know about any in-person event in your country.

What’s next?

Coolest Projects registration opens soon in 2024, and young creators can start thinking of ideas and working on their projects now. Or if young people have already made something they are really proud of, they can showcase that creation once registration is open.

Coolest Projects logo.

Sign up for email updates to always get the latest news about all things Coolest Projects, from event updates to the fun swag coming for 2024.

The post Coolest Projects is back in 2024 appeared first on Raspberry Pi Foundation.

Ще чакаме рейса докато не разберем, че PR-a работа отчита, но работа не върши

Post Syndicated from VassilKendov original https://kendov.com/%D1%89%D0%B5-%D1%87%D0%B0%D0%BA%D0%B0%D0%BC%D0%B5-%D1%80%D0%B5%D0%B9%D1%81%D0%B0-%D0%B4%D0%BE%D0%BA%D0%B0%D1%82%D0%BE-%D0%BD%D0%B5-%D1%80%D0%B0%D0%B7%D0%B1%D0%B5%D1%80%D0%B5%D0%BC-%D1%87%D0%B5-pr-a/

Последните няколко дни транспортът в Община Родопи е обект на дискусии и манипулации.
Това е така, защото е нередовен и графикът не се спазва, а много жители на Община Родопи работят в Пловдив и не могат да се придвижват.

Както са казали мъдрите хора, един проблем не може да се реши, ако не се припознае като проблем и не се назове с истинското му име. В противен случай как ще бъде решен, ако не знаем, че точно това е проблема.

Подоно е положението в Община Родопи. Реалният проблем се неглежира, а вниманието на хората се отклонява с цел PR.
Нагледен пример за това са проблемите в село Първенец през последната седмица. От една страна имаше спукана тръба, което е често срещана ситуация във всяко населено място и доста отработена схема за отстраняване от ВиК. Кмета на Общината обаче скочи като лъв да отстрани проблема, направиха се няколко инспекции, пуснаха се снимки и изявления във Фейсбук… Изобщо ще речеш, че ако не беше този шум, ВиК нямаше да оправят проблема. Всички знаем, че това не е така, но как иначе да отчетеш дейност?

От друга страна пробемът с транспорта на хората за работа и на децата от училище си го имаше от преди изборите. Никой не се сети да зададе въпрос на стария нов кмет за нередовността на градския транспорт. Аз написах статия по въпроса, но ми беше обяснено как нищо не разбирам, защото тогава преблемът се решавал с искане за КВОТА ЗА ТРАНСПОРТ.
Както тогава, така и сега това не можеше да стане, но пък парира неудобните предизборни въпроси. Тръгнаха да решават друг проблем и ето резултата седмици след изборите. Преизбрахме си кмета и пак сме недоволни.

Сега на жителите на Община Родопи отново се внушават няколко много грешни тези, за  решаването на проблема с транспорта.

Първата и най-неправилна теза е, че проблемът може да се реши на парче. Говори се за проблем с траспорта само за селата Марково, Първенец и Храбрино.

Ами останалите села? Брестовциа също има този проблем. Златитрап също. Ами Бойково, Ситово, Лилково, Дедево… Те не са ли част от нашата община? И те имат същите проблеми, но явно не са толкова важни.

Втората теза е, че проблемът ще се реши със селски събрания на хората

Не няма да се реши със събрания на хората. Те избраха преди няколко седмици хора, които да им решават проблемите с превозвачите. Самите жители нямат договорки нито с Община Пловдив, нито с превозвача, а което е още по-странно очаква помощ от жителите при положение, че те нямат и правомощията да решат този проблем. Нямат и правомощията да преговарят с който и да е било, освен с общинската администрация на Родопи.

Решението на проблема само за 3 села – Марково, Първенец и Храбрино, обрича останалите на липса на транспорт. Кой е този превозвач, който ще поеме само далечните села, докато негов конкурент събира печалбата от най-близките и най-големите,м?

Третата теза е най-интересната. Тя е свързана с това, че се очаква проблемът да бъде решен с разговори.

Разговори с Областия управител, с кмета на Пловдив, с превозвача, с хората по места…
Аз смятам, че проблемът ще се реши с ПАРИ, а не с празни приказки. И колкото по-рано го осъзнаем, толкова по-бързо ще бъде решен.
Цялата Пловдивска преса гърми как Община Родопи и кметовете на трите села искали Пловдив да пусне своя транспорт до тези села.
А КОЙ ЩЕ ПЛАЩА?
Община Пловдив самата няма свестен транспорт, та камо ли да реши превоза на съседните села. Транспорта в Пловдив както и в Родопи е субсидиран от Общините.
Сега като знаете какво е предложението някъде да прочетохте кой ще субсидира новите линии? Или те ще го правят за сините ни очи, ей така благотворително?

Някой знае ли колко пари са се дали последната година от Община Родопи за субсидиране на транспорта?

Защото преди няколко дни на спешна сесия се прие новия бюджет на Община Родопи. Ако там няма заложени средства за събсидия на транспорта, остава бюджета на Община Пловдив да отдели тези пари, за да могат жителите на Родопи да имат транспорт. Хубаво пожелание, но наблюдебието ми е, че общинските съветници в Пловдив са някакси по-вчас от нашите. Надали ще посмеят да плащат за транспорта на Родопи. И тук идва четвъртата теза.

Четвъртата теза е, че Община Пловдив може и има правомощията да осъществява транспортни услуги на територията на Общиа Родопи.

В интерес на истината не съм проучил тази теза. Може и да е възможно юридически, макар да се съмнявам малко. При всички положения ако градския транспорт в Пловдив е субсидиран, то тогава Община Пловдив ще трябва да субсидира и транспорта на Родопи. А защо да не пуснат и междуградски линии по същата логика примерно до Варна?

С две думи добре е че общинарите пробват различни тактики, но е хубаво и да имат малко самооценка за проблема. А той си стои от преди изборите. Тогава не успяха с исканията за квоти за транспорт и САЛВА БОГУ.
Това би значело, че Общината ще има своя транспортна фирма. Това са инвестиции за автобуси, за изграждане на автогари, субсидии, плащане за автогара на територията на Пловдив… Изобщо най-лесни начин да фалирате Родопи е да започнете изграждане на собствена транспорта фирма.
Естествено има и друг начин – да се даде транспорта на външна фирма, но тогава работещите в Пловдив ще трябва да спрат д апътуват, защото цената на билета няма да е 1 лев.

Как си представяте цената на билета в Пловдив от Центъра до Коматево да бъде същата като цената от Центъра до Марково? И как кондуктора ще следи кой къде се качил и кой до къде е платил и трябва да слиза, ако се удължи линията на 20-ката от Коматево примерно?

А обществена поръчка нова трябва ли да се прави за тези линии или викате ей така просто им нареждаме на превозвачите и те почват да возят до Храбрино? А кой ще я прави тази поръчка – Пловдив или Родопи? От чий бюдет ще се плаща? Има ли ги тези разходи заложени в бюдета?

Докато не се научим да не вярваме на PR-а, ще си дремем по спирките или ще си плащаме скъпо и прескъпо за транспорт, ако и да сме на няколко километра от Пловдив.

И разберете едно – ЕДИНСТВЕНИЯ ОТ КОЙТО МОЖЕМ ДА ИЗИСКВАМЕ И ДА ИМАМЕ ПРЕТЕНЦИИ Е КМЕТА НА ОБЩИНА РОДОПИ!
Само той ни е длъжен с нещо, никой друг! Само той има правомощията да реши проблемите ни с транспорта, стига да знае как. Няма селски събрания, няма отправяне на неизпълними искания. Трябва си визия, но визия явно липсва. Затова ще си плащаме!

Васил Кендов – Финансист и жител на Община Родопи

Вижте също статията за транспорта в с. Марково

П.П. С нетърпение очаквам новите цени за транспорт, след изтичне на договора на Пловдив и Хеброс бус. Искам да видя и коя автогара ще се използва, следкато Родопи е собственост на Хеброс бус, а Филипово е от другата страна на града. Дали пък Община пловдив няма да изгради друга автогара за да обслужи Родопи или общинския съвет ще предпочете да затвори очи и да използва някоя последна спирка като автогара?
Следя с интерес как мерките на парче ще бръкнат в джобовите ни, а ние ще си научим урока или ще си плащаме!

Моля използвайте приложената форма за записване на час за среща
[contact-form-7]

The post Ще чакаме рейса докато не разберем, че PR-a работа отчита, но работа не върши appeared first on Kendov.com.

По буквите: Данова, Бенбасат

Post Syndicated from Зорница Христова original https://www.toest.bg/po-bukvite-danova-benbasat/

„Как е живяна и как е мислена детската възраст от българите (ХVII–ХIХ в.)“ от Надя Данова

По буквите: Данова, Бенбасат

София: изд. „Парадигма“, 2023

Родителите – дотук,

пише на входа на едно столично училище.

Никой от родителите на децата, които се нахождат в школата, да няма власт да дохожда в училището и да се оплаква, когато наказват или бият детето му. Защото за такива жалби няма место, ибо дете, когато види, че баща му дохожда да го оправдава, тогда детето му разваля се и не може да има никакъв страх,

пише в правилника не на друго, а на създаденото от Васил Априлов Габровско училище. Същото правило да не се допускат родители, за да не вземат нещо да се оплакват от побоя над децата си, е съвсем характерно за първите български училища. Така коментира Надя Данова и привежда изобилни примери.

Докато чета историческото ѝ изследване, неволно правя справки с опита си и като родител на ученици (вече 14 години), и като ветеран от разни срещи за образованието. Мисля си

колко дълбоки са корените на онази възпитателна нагласа, която от самото начало дефинира и декларира покорството като висша цел на работата с детето.

И тук не говорим само за изолирани назадничави случаи. Не говорим за тъмни векове, от които Възраждането успява радикално да се оттласне, а за самите възрожденци, поне за тези, за чиито възгледи по отношение на детската възраст има писмени свидетелства.

Повтарят се думи като „чинопочитание“, „повинение“ – и както отбелязва авторката, става въпрос за

едно възпитание, построено върху „страха от Бога“ като база за други видове страх

(неволно чувам отзвука у Ботев с „нему се кланя дивак учител / и с вестникарин зайдно мъдруват, / че страх от бога било начало на всяка мъдрост“). Общо взето, емпиричният материал показва, че тези редове са доста буквално описание на статуквото по онова време.

Разбира се, има и други повтарящи се ценности на възпитанието – родолюбие, учение (някак независимо от съдържанието), на някои места „постиженията на учена Европа“. Гражданските ценности обаче трудно си проправят път. Независимото мислене например се споменава единствено от Ботев. Когато детето е момиче, смисълът на неговото възпитание пък почти никога не стига отвъд подготовката му да служи на дома и семейството. И макар мнозина възрожденци да даряват пари за образование на девойки, никой освен Каравелов не вижда смисъл да се преподава нещо отвъд „женските“ умения.

По буквите: Данова, Бенбасат

Анахронично е, разбира се, да търсим под вола теле или да връзваме кусур на предците си, че не са създали традицията тъкмо такава, каквато би отговаряла на нашето време. И авторката съвсем не прави това. Тя само добросъвестно, методично, по всички правила на историческото изследване цитира и анализира източник след източник – без да пропуска нито контекста (например огромната роля на християнството за подобряване статута на детето или пък драстичната борба за физическо оцеляване, при която детската смъртност стигала 25%), нито забележителния принос на коментираните личности.

И все пак ми е трудно да забравя (с оглед на днешния, а не на вчерашния ден) образа на Петър Берон, който превежда и адаптира предполагаемо писмо на Филип Македонски до Аристотел.

Ценностите, към които трябва да се придържа възпитателният модел, […] налагат на Берон специфичен преводачески модел към Еклогариона на Димитриос Дарварис. […] В един от случаите става въпрос за писмо на Филип Македонски, който съобщава с радост на Аристотел, че му се е родил син Александър, но повече се радва, че този син се е родил именно по времето на философа. Тук Берон се опитва да напасне заложената в текста гръцка аретология, предполагаща доблест, храброст, мъжество, превъзходни качества, красота, благородство, величие, нравствено съвършенство и морално превъзходство, към изискванията на християнското благочестие. Така, докато в оригинала Филип благодари на езическите богове, в превода той е благодарен „Богу“, и то не защото синът му ще бъде обучен в системата на античните добродетели, а защото ще се научи да бъде „добър и смирен“. За нас остава въпросът дали самият Берон не се е усмихвал в момента, в който е манипулирал по този начин текста на Дарварис, представяйки си „добрия и смирен“ бъдещ завоевател Александър Македонски.

Който реши да се заема с образователни реформи днес, особено пък такива, които искат да поставят в центъра на образованието нуждите на детето (само по себе си и като бъдещ гражданин), трябва да бъде реалист. Да познава по-дълбоките корени на несъгласието, което ще срещне и сред институциите, и сред отделните учители, та и сред другите родители. На

липсата на отзивчивост към новото,

както се изразява авторката. И тази липса има своя традиция.
Отлична книга, тъжна констатация.

„Когато големите станат малки“ от Алберт Бенбасат

София: изд. „Колибри“, 2023

Учителят по физическо бе признат като пръв помощник на директора в областта на дисциплината, а по-късно – в гимназията – и морала. Физкултурникът олицетворяваше цялата строгост на законите, по които трябваше да се възпитаваме – не само уважение към институцията, а безусловно подчинение, казарменост, тъпо придържане към правилата, без оглед колко безумни могат да бъдат те,

пише Алберт Бенбасат. Но неговата книга, която е колкото „вехтошарски“, толкова и билдунгсроман, непрекъснато отбягва правилата, привидно неспособна да ги следва.

Също като своя протагонист, едва неостанал със счупен врат поради твърдата ръка на учителката, тази книга уж се приготвя да направи „кълбо напред“ в хронологията, но вместо това се катурва встрани в безбройните начини, по които животът убягва на правилата.

Какво само прави семейната история с политическата! Ту стъпва боса върху ескалатора в току-що построения ЦУМ, ту напротив, пристъпва из нея с лъснати с пионерска връзка обувки. Ту я подслажда със съблазнителното „локумико“ на анекдота, на пълнокръвните характери, на веселите идиосинкразии на персонажите, ту внезапно откроява нейната горчивина на фона на тяхната сладост.

Най-лесно е да прочетеш книгата носталгично,

защото обичта и тъгата по близките прави именно това – оживява света, в който и нашите близки негласно присъстват. Роден в същата година като баща ми, Алберт Бенбасат владее онова писане, което съхранява живота. То е близо до говора, до разказа между близки, в който предците не са паметници, а живи хора, които могат и да са смешни, и мили, и да грешат, да се ядосват, да се променят.

Разказ, в който отсенките са всичко – като „бонбоникото“ в ръката на баба Рашел („аз не ям, аз крада“), като побългарените еврейски имена на Ничко (Нисим), Вики (Вентура), Стерчето (Естер), като самия шпаньолски, в който испанският корен е като ядка в сърцевината на бонбон, обвит в сафарадска интерпретация, поръсен с български окончания и сервиран с турска думичка за гарнитура – като в чудния израз „терсене мужер“. Чета с благодарност за тези отсенки, които правят света отпреди раждането ми по-богат, пъстър и вкусен.

Но можеш да прочетеш тази книга и през смях, защото вътре има множество сюжети, готови за комедиен сценарий.

Например авторитетният международен коментатор Огнян Велков, който води два пъти седмично рубрика по радиото и получава писма от слушатели, покани за гостуване и т.н. Проблемът е, че Огнян Велков не съществува, а е измислица на трима души – сред които, освен бащата на автора, е и „чичо Шпетер“, Шпеко – дребен и надарен откъм глас и аромат персонаж с алпийски вид и комични навици. Или ефектната леля Жана от Израел с нейните тоалети и любовници, с пакета „Кент“, даден скришом на племенника. Или детската неумела рисунка на партизанска тематика, запазена от братовчедката Естер след толкова години…

От обратната страна на тези смешни и мили истории обаче стои нещо друго – нещо, което е било „обърнато на смях“ така, както костюмите са били „обръщани“, за да може да се носят още веднъж. Светът отсам желязната завеса, в който Шпеко се оказва шпионин, любовниците на Жана всъщност са пратени да я следят. А „партизанската“ детска рисунка напомня за чичото, загинал като партизанин, за да не носи жълта звезда.

По буквите: Данова, Бенбасат

Особена книга. Бих я подредила до „Баща ми бояджията“ на Васил Цонев, но и до спомените на Йовков за някогашния Добрич и неговите персонажи; и най-вече, струва ми се, до „Когато отново бъда малък“ на Януш Корчак, към която заглавието негласно препраща. Бих я препоръчала като библиотерапия на онези, които усещат миналото си безвъзвратно изгубено или подменено.


Активните дарители на „Тоест“ получават постоянна отстъпка в размер на 20% от коричната цена на всички заглавия от каталозите на „Колибри“, както и на няколко други български издателства в рамките на партньорската програма Читателски клуб „Тоест“. За повече информация прочетете на toest.bg/club.

В емблематичната си колонка, започната още през 2008 г. във в-к „Култура“, Марин Бодаков ни представяше нови литературни заглавия и питаше с какво точно тези книги ни променят. Вярваме, че е важно тази рубрика да продължи. От човек до човек, с нова книга в ръка.

Enhance query performance using AWS Glue Data Catalog column-level statistics

Post Syndicated from Sandeep Adwankar original https://aws.amazon.com/blogs/big-data/enhance-query-performance-using-aws-glue-data-catalog-column-level-statistics/

Today, we’re making available a new capability of AWS Glue Data Catalog that allows generating column-level statistics for AWS Glue tables. These statistics are now integrated with the cost-based optimizers (CBO) of Amazon Athena and Amazon Redshift Spectrum, resulting in improved query performance and potential cost savings.

Data lakes are designed for storing vast amounts of raw, unstructured, or semi-structured data at a low cost, and organizations share those datasets across multiple departments and teams. The queries on these large datasets read vast amounts of data and can perform complex join operations on multiple datasets. When talking with our customers, we learned that one the challenging aspect of data lake performance is how to optimize these analytics queries to execute faster.

The data lake performance optimization is especially important for queries with multiple joins and that is where cost-based optimizers helps the most. In order for CBO to work, column statistics need to be collected and updated based on changes in the data. We’re launching capability of generating column-level statistics such as number of distinct, number of nulls, max, and min on files such as Parquet, ORC, JSON, Amazon ION, CSV, XML on AWS Glue tables. With this launch, customers now have integrated end-to-end experience where statistics on Glue tables are collected and stored in the AWS Glue Catalog, and made available to analytics services for improved query planning and execution.

Using these statistics, cost-based optimizers improves query run plans and boosts the performance of queries run in Amazon Athena and Amazon Redshift Spectrum. For example, CBO can use column statistics such as number of distinct values and number of nulls to improve row prediction. Row prediction is the number of rows from a table that will be returned by a certain step during the query planning stage. The more accurate the row predictions are, the more efficient query execution steps are. This leads to faster query execution and potentially reduced cost. Some of the specific optimizations that CBO can employ include join reordering and push-down of aggregations based on the statistics available for each table and column.

For customers using data mesh with AWS Lake Formation permissions, tables from different data producers are cataloged in the centralized governance accounts. As they generate statistics on tables on centralized catalog and share those tables with consumers, queries on those tables in consumer accounts will see query performance improvements automatically. In this post, we’ll demonstrate the capability of AWS Glue Data Catalog to generate column statistics for our sample tables.

Solution overview

To demonstrate the effectiveness of this capability, we employ the industry-standard TPC-DS 3 TB dataset stored in an Amazon Simple Storage Service (Amazon S3) public bucket. We’ll compare the query performance before and after generating column statistics for the tables, by running queries in Amazon Athena and Amazon Redshift Spectrum. We are providing queries that we used in this post and we encourage to try out your own queries following workflow as illustrated in the following details.

The workflow consists of the following high level steps:

  1. Cataloging the Amazon S3 Bucket: Utilize AWS Glue Crawler to crawl the designated Amazon S3 bucket, extracting metadata, and seamlessly storing it in the AWS Glue data catalog. We’ll query these tables using Amazon Athena and Amazon Redshift Spectrum.
  2. Generating column statistics: Employ the enhanced capabilities of AWS Glue Data Catalog to generate comprehensive column statistics for the crawled data, thereby providing valuable insights into the dataset.
  3. Querying with Amazon Athena and Amazon Redshift Spectrum: Evaluate the impact of column statistics on query performance by utilizing Amazon Athena and Amazon Redshift Spectrum to execute queries on the dataset.

The following diagram illustrates the solution architecture.

Walkthrough

To implement the solution, we complete the following steps:

  1. Set up resources with AWS CloudFormation.
  2. Run AWS Glue Crawler on Public Amazon S3 bucket to list the 3TB TPC-DS dataset.
  3. Run queries on Amazon Athena and Amazon Redshift and note down query duration
  4. Generate statistics for AWS Glue Data Catalog tables
  5. Run queries on Amazon Athena and Amazon Redshift and compare query duration with previous run
  6. Optional: Schedule AWS Glue column statistics jobs using AWS Lambda and the Amazon EventBridge Scheduler

Set up resources with AWS CloudFormation

This post includes an AWS CloudFormation template for a quick setup. You can review and customize it to suit your needs. The template generates the following resources:

  • An Amazon Virtual Private Cloud (Amazon VPC), public subnet, private subnets and route tables.
  • An Amazon Redshift Serverless workgroup and namespace.
  • An AWS Glue crawler to crawl the public Amazon S3 bucket and create a table for the Glue Data Catalog for TPC-DS dataset
  • AWS Glue catalog databases and tables
  • An Amazon S3 bucket to store athena result.
  • AWS Identity and Access Management (AWS IAM) users and policies.
  • AWS Lambda and Amazon Event Bridge scheduler to schedule the AWS Glue Column statistics

To launch the AWS CloudFormation stack, complete the following steps:

Note: The AWS Glue data catalog tables are generated using the public bucket s3://blogpost-sparkoneks-us-east-1/blog/BLOG_TPCDS-TEST-3T-partitioned/, hosted in the us-east-1 region. If you intend to deploy this AWS CloudFormation template in a different region, it is necessary to either copy the data to the corresponding region or share the data within your deployed region for it to be accessible from Amazon Redshift.

  1. Log in to the AWS Management Console as AWS Identity and Access Management (AWS IAM) administrator.
  2. Choose Launch Stack to deploy a AWS CloudFormation template.
  3. Choose Next.
  4. On the next page, keep all the option as default or make appropriate changes based on your requirement choose Next.
  5. Review the details on the final page and select I acknowledge that AWS CloudFormation might create IAM resources.
  6. Choose Create.

This stack can take around 10 minutes to complete, after which you can view the deployed stack on the AWS CloudFormation console.

Run the AWS Glue Crawlers created by the AWS CloudFormation stack

To run your crawlers, complete the following steps:

  1. On the AWS Glue console to AWS Glue Console, choose Crawlers under Data Catalog in the navigation pane.
  2. Locate and run two crawlers tpcdsdb-without-stats and tpcdsdb-with-stats. It may take few mins to complete.

Once the crawler completes successfully, it would create two identical databases tpcdsdbnostats and tpcdsdbwithstats. The tables in tpcdsdbnostats will have No Stats and we’ll use them as reference. We generate statistics on tables in tpcdsdbwithstats. Please verify that you have those two databases and underlying tables from the AWS Glue Console. The tpcdsdbnostats database will look like below. At this time there are no statistics generated on these tables.

Run provided query using Amazon Athena on no-stats tables

To run your query in Amazon Athena on tables without statistics, complete the following steps:

  1. Download the athena queries from here.
  2. On the Amazon Athena Console, choose the provided query one at a time for tables in database tpcdsdbnostats.
  3. Run the query and note down the Run time for each query.

Run provided query using Amazon Redshift Spectrum on no-stats tables

To run your query in Amazon Redshift, complete the following steps:

  1. Download the Amazon Redshift queries from here.
  2. On the Redshift query editor v2, execute the Redshift Query for tables without stats section from downloaded query.
  3. Run the query and note down the query execution of each query.

Generate statistics on AWS Glue Catalog tables

To generate statistics on AWS Glue Catalog tables, complete the following steps:

  1. Navigate to the AWS Glue Console and choose the databases under Data Catalog.
  2. Click on tpcdsdbwithstats database and it will list all the available tables.
  3. Select any of these tables (e.g., call_center).
  4. Go to Column statistics – new tab and choose Generate statistics.
  5. Keep the default option. Under Choose columns keep Table (All columns) and Under Row sampling options Keep All rows, Under IAM role choose AWSGluestats-blog and select Generate statistics.

You’ll be able to see status of the statistics generation run as shown in the following illustration:

After generate statistics on AWS Glue Catalog tables, you should be able to see detailed column statistics for that table:

Reiterate steps 2–5 to generate statistics for all necessary tables, such as catalog_sales, catalog_returns, warehouse, item, date_dim, store_sales, customer, customer_address, web_sales, time_dim, ship_mode, web_site, web_returns. Alternatively, you can follow the “Schedule AWS Glue Statistics Runs” section near the end of this blog to generate statistics for all tables. Once done, assess query performance for each query.

Run provided query using Athena Console on stats tables

  1. On the Amazon Athena console, execute the Athena Query for tables with stats section from downloaded query.
  2. Run and note down the query execution of each query.

In our sample run of the queries on the tables, we observed the query execution time as per the below table. We saw clear improvement in the query performance, ranging from 13 to 55%.

Athena query time improvement

TPC-DS 3T Queries without glue stats (sec) with glue stats (sec) performance improvement (%)
Query 2 33.62 15.17 55%
Query 4 132.11 72.94 45%
Query 14 134.77 91.48 32%
Query 28 55.99 39.36 30%
Query 38 29.32 25.58 13%

Run the provided query using Amazon Redshift Spectrum on statistics tables

  1. On the Amazon Redshift query editor v2, execute the Redshift Query for tables with stats section from downloaded query.
  2. Run the query and note down the query execution of each query.

In our sample run of the queries on the tables, we observed the query execution time as per the below table. We saw clear improvement in the query performance, ranging from 13 to 89%.

Amazon Redshift Spectrum query time improvement

TPC-DS 3T Queries without glue stats (sec) with glue stats (sec) performance improvement (%)
Query 40 124.156 13.12 89%
Query 60 29.52 16.97 42%
Query 66 18.914 16.39 13%
Query 95 308.806 200 35%
Query 99 20.064 16 20%

Schedule AWS Glue statistics Runs

In this segment of the post, we’ll guide you through the steps of scheduling AWS Glue column statistics runs using AWS Lambda and the Amazon EventBridge Scheduler. To streamline this process, a AWS Lambda function and an Amazon EventBridge scheduler were created as part of the CloudFormation stack deployment.

  1. AWS Lambda function setup:

To begin, we utilize an AWS Lambda function to trigger the execution of the AWS Glue column statistics job. The AWS Lambda function invokes the start_column_statistics_task_run API through the boto3 (AWS SDK for Python) library. This sets the groundwork for automating the column statistics update.

Let’s explore the AWS Lambda function:

    • Go to the AWS Glue Lambda Console.
    • Select Functions and locate the GlueTableStatisticsFunctionv1.
    • For a clearer understanding of the AWS Lambda function, we recommend reviewing the code in the Code section and examining the environment variables under Configuration.
  1. Amazon EventBridge scheduler configuration

The next step involves scheduling the AWS Lambda function invocation using the Amazon EventBridge Scheduler. The scheduler is configured to trigger the AWS Lambda function daily at a specific time – in this case, 08:00 PM. This ensures that the AWS Glue column statistics job runs on a regular and predictable basis.

Now, let’s explore how you can update the schedule:

Cleaning up

To avoid unwanted charges to your AWS account, delete the AWS resources:

  1. Sign into the AWS CloudFormation console as the AWS IAM administrator used for creating the AWS CloudFormation stack.
  2. Delete the AWS CloudFormation stack you created.

Conclusion

In this post, we showed you how you can use AWS Glue Data Catalog to generate column-level statistics for AWS Glue tables. These statistics are now integrated with cost-based optimizer from Amazon Athena and Amazon Redshift Spectrum, resulting in improved query performance and potential costs savings. Refer to Docs for support for Glue Catalog Statistics across various AWS analytical services.

If you have questions or suggestions, submit them in the comments section.


About the Authors

Sandeep Adwankar is a Senior Technical Product Manager at AWS. Based in the California Bay Area, he works with customers around the globe to translate business and technical requirements into products that enable customers to improve how they manage, secure, and access data.

Navnit Shukla serves as an AWS Specialist Solution Architect with a focus on Analytics. He possesses a strong enthusiasm for assisting clients in discovering valuable insights from their data. Through his expertise, he constructs innovative solutions that empower businesses to arrive at informed, data-driven choices. Notably, Navnit Shukla is the accomplished author of the book titled Data Wrangling on AWS. He can be reached via LinkedIn.

Happy Thanksgiving

Post Syndicated from corbet original https://lwn.net/Articles/952354/

November 23 is the US Thanksgiving holiday; as is our tradition, we will
not be publishing an LWN Weekly Edition this week as we will be far too
busy eating. We wish a good holiday to all of our readers (whether they
celebrate it or not); the weekly edition will return on November 30.

[$] Committing to Rust for kernel code

Post Syndicated from corbet original https://lwn.net/Articles/952029/

Rust has been a prominent topic at the Kernel Maintainers Summit for the
last couple of years, and the 2023 meeting continued that tradition. As
Rust-for-Linux developer Miguel Ojeda noted at the beginning of the session
dedicated to the topic, the level of interest in using Rust for kernel
development has increased significantly over the last year. But Rust was
explicitly added to Linux as an experiment; is the kernel community now
ready to say that the experiment has succeeded?

Security updates for Wednesday

Post Syndicated from corbet original https://lwn.net/Articles/952312/

Security updates have been issued by Debian (gimp), Fedora (audiofile and firefox), Mageia (postgresql), Red Hat (binutils, c-ares, fence-agents, glibc, kernel, kernel-rt, kpatch-patch, libcap, libqb, linux-firmware, ncurses, pixman, python-setuptools, samba, and tigervnc), Slackware (kernel and mozilla), SUSE (apache2-mod_jk, avahi, container-suseconnect, java-1_8_0-openjdk, libxml2, openssl-1_0_0, openssl-1_1, openvswitch, python3-setuptools, strongswan, ucode-intel, and util-linux), and Ubuntu (frr, gnutls28, hibagent, linux, linux-aws, linux-aws-5.15, linux-hwe-5.15, linux-ibm,
linux-ibm-5.15, linux-kvm, linux-lowlatency, linux-lowlatency-hwe-5.15,
linux-nvidia, linux-oracle, linux-oracle-5.15, linux-raspi, linux, linux-aws, linux-aws-5.4, linux-bluefield, linux-hwe-5.4,
linux-ibm, linux-ibm-5.4, linux-iot, linux-kvm, linux-oracle,
linux-oracle-5.4, linux-raspi, linux-raspi-5.4, linux-xilinx-zynqmp, linux, linux-aws, linux-aws-6.2, linux-hwe-6.2, linux-kvm,
linux-lowlatency, linux-lowlatency-hwe-6.2, linux-raspi, linux-starfive, linux, linux-aws, linux-aws-hwe, linux-hwe, linux-kvm, linux-oracle, linux, linux-aws, linux-laptop, linux-lowlatency, linux-oem-6.5,
linux-oracle, linux-raspi, linux-starfive, linux-oem-6.1, mosquitto, rabbitmq-server, squid, and tracker-miners).

Introducing Apache Hudi support with AWS Glue crawlers

Post Syndicated from Noritaka Sekiyama original https://aws.amazon.com/blogs/big-data/introducing-apache-hudi-support-with-aws-glue-crawlers/

Apache Hudi is an open table format that brings database and data warehouse capabilities to data lakes. Apache Hudi helps data engineers manage complex challenges, such as managing continuously evolving datasets with transactions while maintaining query performance. Data engineers use Apache Hudi for streaming workloads as well as to create efficient incremental data pipelines. Hudi provides tables, transactions, efficient upserts and deletes, advanced indexes, streaming ingestion services, data clustering and compaction optimizations, and concurrency control, all while keeping your data in open source file formats. Hudi’s advanced performance optimizations make analytical workloads faster with any of the popular query engines including Apache Spark, Presto, Trino, Hive, and so on.

Many AWS customers adopted Apache Hudi on their data lakes built on top of Amazon S3 using AWS Glue, a serverless data integration service that makes it easier to discover, prepare, move, and integrate data from multiple sources for analytics, machine learning (ML), and application development. AWS Glue Crawler is a component of AWS Glue, which allows you to create table metadata from data content automatically without requiring manual definition of the metadata.

AWS Glue crawlers now support Apache Hudi tables, simplifying the adoption of AWS Glue Data Catalog as the catalog for Hudi tables. One typical use case is to register Hudi tables, which does not have catalog table definition. Another typical use case is migration from other Hudi catalogs, such as Hive metastore. When migrating from other Hudi Catalogs, you can create and schedule an AWS Glue crawler and provide one or more Amazon S3 paths where the Hudi table files are located. You have the option to provide the maximum depth of Amazon S3 paths that the AWS Glue crawler can traverse. With each run, AWS Glue crawlers will extract schema and partition information and update AWS Glue Data Catalog with the schema and partition changes. AWS Glue crawlers updates the latest metadata file location in the AWS Glue Data Catalog that AWS analytical engines can directly use.

With this launch, you can create and schedule an AWS Glue crawler to register Hudi tables in AWS Glue Data Catalog. You can then provide one or multiple Amazon S3 paths where the Hudi tables are located. You have the option to provide the maximum depth of Amazon S3 paths that crawlers can traverse. With each crawler run, the crawler inspects each of the S3 paths and catalogs the schema information, such as new tables, deletes, and updates to schemas in the AWS Glue Data Catalog. Crawlers inspect partition information and add newly added partitions to AWS Glue Data Catalog. Crawlers also update the latest metadata file location in the AWS Glue Data Catalog that AWS analytical engines can directly use.

This post demonstrates how this new capability to crawl Hudi tables works.

How AWS Glue crawler works with Hudi tables

Hudi tables have two categories, with specific implications for each:

  • Copy on write (CoW) – Data is stored in a columnar format (Parquet), and each update creates a new version of files during a write.
  • Merge on read (MoR) – Data is stored using a combination of columnar (Parquet) and row-based (Avro) formats. Updates are logged to row-based delta files and are compacted as needed to create new versions of the columnar files.

With CoW datasets, each time there is an update to a record, the file that contains the record is rewritten with the updated values. With a MoR dataset, each time there is an update, Hudi writes only the row for the changed record. MoR is better suited for write- or change-heavy workloads with fewer reads. CoW is better suited for read-heavy workloads on data that change less frequently.

Hudi provides three query types for accessing the data:

  • Snapshot queries – Queries that see the latest snapshot of the table as of a given commit or compaction action. For MoR tables, snapshot queries expose the most recent state of the table by merging the base and delta files of the latest file slice at the time of the query.
  • Incremental queries – Queries only see new data written to the table, since a given commit or compaction. This effectively provides change streams to enable incremental data pipelines.
  • Read optimized queries – For MoR tables, queries see the latest data compacted. For CoW tables, queries see the latest data committed.

For copy-on-write tables, crawlers create a single table in the AWS Glue Data Catalog with the ReadOptimized Serde  org.apache.hudi.hadoop.HoodieParquetInputFormat.

For merge-on-read tables, crawlers create two tables in AWS Glue Data Catalog for the same table location:

  • A table with suffix _ro, which uses the ReadOptimized Serde org.apache.hudi.hadoop.HoodieParquetInputFormat
  • A table with suffix _rt, which uses the RealTime Serde allowing for Snapshot queries: org.apache.hudi.hadoop.realtime.HoodieParquetRealtimeInputFormat

During each crawl, for each Hudi path provided, crawlers make an Amazon S3 list API call, filter based on the .hoodie folders, and find the most recent metadata file under that Hudi table metadata folder.

Crawl a Hudi CoW table using AWS Glue crawler

In this section, let’s go through how to crawl a Hudi CoW using AWS Glue crawlers.

Prerequisites

Here are the prerequisites for this tutorial:

  1. Install and configure AWS Command Line Interface (AWS CLI).
  2. Create your S3 bucket if you do not have it.
  3. Create your IAM role for AWS Glue if you do not have it. You need s3:GetObject for s3://your_s3_bucket/data/sample_hudi_cow_table/.
  4. Run the following command to copy the sample Hudi table into your S3 bucket. (Replace your_s3_bucket with your S3 bucket name.)
$ aws s3 sync s3://aws-bigdata-blog/artifacts/hudi-crawler/product_cow/ s3://your_s3_bucket/data/sample_hudi_cow_table/

This instruction guides you to copy sample data, but you can create any Hudi tables easily using AWS Glue. Learn more in Introducing native support for Apache Hudi, Delta Lake, and Apache Iceberg on AWS Glue for Apache Spark, Part 2: AWS Glue Studio Visual Editor.

Create a Hudi crawler

In this instruction, create the crawler through the console. Complete the following steps to create a Hudi crawler:

  1. On the AWS Glue console, choose Crawlers.
  2. Choose Create crawler.
  3. For Name, enter hudi_cow_crawler. Choose Next.
  4. Under Data source configuration,  choose Add data source.
    1. For Data source, choose Hudi.
    2. For Include hudi table paths, enter s3://your_s3_bucket/data/sample_hudi_cow_table/. (Replace your_s3_bucket with your S3 bucket name.)
    3. Choose Add Hudi data source.
  5. Choose Next.
  6. For Existing IAM role, choose your IAM role, then choose Next.
  7. For Target database, choose Add database, then the Add database dialog appears. For Database name, enter hudi_crawler_blog, then choose Create. Choose Next.
  8. Choose Create crawler.

Now a new Hudi crawler has been successfully created. The crawler can be triggered to run through the console or through the SDK or AWS CLI using the StartCrawl API. It could also be scheduled through the console to trigger the crawlers at specific times. In this instruction, run the crawler through the console.

  1. Choose Run crawler.
  2. Wait for the crawler to complete.

After the crawler has run, you can see the Hudi table definition in the AWS Glue console:

You have successfully crawled the Hudi CoR table with data on Amazon S3 and created an AWS Glue Data Catalog table with the schema populated. After you create the table definition on AWS Glue Data Catalog, AWS analytics services such as Amazon Athena are able to query the Hudi table.

Complete the following steps to start queries on Athena:

  1. Open the Amazon Athena console.
  2. Run the following query.
SELECT * FROM "hudi_crawler_blog"."sample_hudi_cow_table" limit 10;

The following screenshot shows our output:

Crawl a Hudi MoR table using AWS Glue crawler with AWS Lake Formation data permissions

In this section, let’s go through how to crawl a Hudi MoR table using AWS Glue. This time, you use AWS Lake Formation data permission for crawling Amazon S3 data sources instead of IAM and Amazon S3 permission. This is optional, but it simplifies permission configurations when your data lake is managed by AWS Lake Formation permissions.

Prerequisites

Here are the prerequisites for this tutorial:

  1. Install and configure AWS Command Line Interface (AWS CLI).
  2. Create your S3 bucket if you do not have it.
  3. Create your IAM role for AWS Glue if you do not have it. You need lakeformation:GetDataAccess. But you do not need s3:GetObject for s3://your_s3_bucket/data/sample_hudi_mor_table/ because we use Lake Formation data permission to access the files.
  4. Run the following command to copy the sample Hudi table into your S3 bucket. (Replace your_s3_bucket with your S3 bucket name.)
$ aws s3 sync s3://aws-bigdata-blog/artifacts/hudi-crawler/product_mor/ s3://your_s3_bucket/data/sample_hudi_mor_table/

In addition to the processing steps, complete the following steps to update the AWS Glue Data Catalog settings to use Lake Formation permissions to control catalog resources instead of IAM-based access control:

  1. Sign in to the Lake Formation console as a data lake administrator.
    1. If this is the first time accessing the Lake Formation console, add yourself as the data lake administrator.
  2. Under Administration, choose Data catalog settings.
  3. For Default permissions for newly created databases and tables, deselect Use only IAM access control for new databases and Use only IAM access control for new tables in new databases.
  4. For Cross account version setting, choose Version 3.
  5. Choose Save.

The next step is to register your S3 bucket in Lake Formation data lake locations:

  1. On the Lake Formation console, choose Data lake locations, and choose Register location.
  2. For Amazon S3 path, enter s3://your_s3_bucket/. (Replace your_s3_bucket with your S3 bucket name.)
  3. Choose Register location.

Then, grant Glue crawler role access to data location so that the crawler can use Lake Formation permission to access the data and create tables in the location:

  1. On the Lake Formation console, choose Data locations and choose Grant.
  2. For IAM users and roles, select the IAM role you used for the crawler.
  3. For Storage location, enter s3://your_s3_bucket/data/. (Replace your_s3_bucket with your S3 bucket name.)
  4. Choose Grant.

Then, grant crawler role to create tables under the database hudi_crawler_blog:

  1. On the Lake Formation console, choose Data lake permissions.
  2. Choose Grant.
  3. For Principals, choose IAM users and roles, and choose the crawler role.
  4. For LF tags or catalog resources, choose Named data catalog resources.
  5. For Database, choose the database hudi_crawler_blog.
  6. Under Database permissions, select Create table.
  7. Choose Grant.

Create a Hudi crawler with Lake Formation data permissions

Complete the following steps to create a Hudi crawler:

  1. On the AWS Glue console, choose Crawlers.
  2. Choose Create crawler.
  3. For Name, enter hudi_mor_crawler. Choose Next.
  4. Under Data source configuration,  choose Add data source.
    1. For Data source, choose Hudi.
    2. For Include hudi table paths, enter s3://your_s3_bucket/data/sample_hudi_mor_table/. (Replace your_s3_bucket with your S3 bucket name.)
    3. Choose Add Hudi data source.
  5. Choose Next.
  6. For Existing IAM role, choose your IAM role.
  7. Under Lake Formation configuration – optional, select Use Lake Formation credentials for crawling S3 data source.
  8. Choose Next.
  9. For Target database, choose hudi_crawler_blog. Choose Next.
  10. Choose Create crawler.

Now a new Hudi crawler has been successfully created. The crawler uses Lake Formation credentials for crawling Amazon S3 files. Let’s run the new crawler:

  1. Choose Run crawler.
  2. Wait for the crawler to complete.

After the crawler has run, you can see two tables of the Hudi table definition in the AWS Glue console:

  • sample_hudi_mor_table_ro (read optimized table)
  • sample_hudi_mor_table_rt (real time table)

You registered the data lake bucket with Lake Formation and enabled crawling access to the data lake using Lake Formation permissions. You have successfully crawled the Hudi MoR table with data on Amazon S3 and created an AWS Glue Data Catalog table with the schema populated. After you create the table definitions on AWS Glue Data Catalog, AWS analytics services such as Amazon Athena are able to query the Hudi table.

Complete the following steps to start queries on Athena:

  1. Open the Amazon Athena console.
  2. Run the following query.
    SELECT * FROM "hudi_crawler_blog"."sample_hudi_mor_table_rt" limit 10;

The following screenshot shows our output:

  1. Run the following query.
    SELECT * FROM "hudi_crawler_blog"."sample_hudi_mor_table_ro" limit 10;

The following screenshot shows our output:

Fine-grained access control using AWS Lake Formation permissions

To apply fine-grained access control on the Hudi table, you can benefit from AWS Lake Formation permissions. Lake Formation permissions allow you to restrict access to specific tables, columns, or rows and then query the Hudi tables through Amazon Athena with fine-grained access control. Let’s configure Lake Formation permission for the Hudi MoR table.

Prerequisites

Here are the prerequisites for this tutorial:

  1. Complete the previous section Crawl a Hudi MoR table using AWS Glue crawler with AWS Lake Formation data permissions.
  2. Create an IAM user DataAnalyst, who has AWS managed policy AmazonAthenaFullAccess.

Create a Lake Formation data cell filter

Let’s first set up a filter for the MoR read optimized table.

  1. Sign in to the Lake Formation console as a data lake administrator.
  2. Choose Data filters.
  3. Choose Create new filter.
  4. For Data filter name, enter exclude_product_price.
  5. For Target database, choose the database hudi_crawler_blog.
  6. For Target table, choose the table sample_hudi_mor_table_ro.
  7. For Column-level access, select Exclude columns, and choose the column price.
  8. For Row filter expression, enter true.
  9. Choose Create filter.

Grant Lake Formation permissions to the DataAnalyst user

Complete the following steps to grant Lake Formation permission to the DataAnalyst user

  1. On the Lake Formation console, choose Data lake permissions.
  2. Choose Grant.
  3. For Principals, choose IAM users and roles, and choose the user DataAnalyst.
  4. For LF tags or catalog resources, choose Named data catalog resources.
  5. For Database, choose the database hudi_crawler_blog.
  6. For Table – optional, choose the table sample_hudi_mor_table_ro.
  7. For Data filters – optional, select exclude_product_price.
  8. For Data filter permissions, select Select.
  9. Choose Grant.

You granted Lake Formation permission on the database hudi_crawler_blog and the table sample_hudi_mor_table_ro, excluding the column price to the DataAnalyst user. Now let’s validate user access to the data using Athena.

  1. Sign in to the Athena console as a DataAnalyst user.
  2. On the query editor, run the following query:
    SELECT * FROM "hudi_crawler_blog"."sample_hudi_mor_table_ro" limit 10;

The following screenshot shows our output:

Now you validated that the column price is not shown, but the other columns product_id, product_name, update_at, and category are shown.

Clean up

To avoid unwanted charges to your AWS account, delete the following AWS resources:

  1. Delete AWS Glue database hudi_crawler_blog.
  2. Delete AWS Glue crawlers hudi_cow_crawler and hudi_mor_crawler.
  3. Delete Amazon S3 files under s3://your_s3_bucket/data/sample_hudi_cow_table/ and s3://your_s3_bucket/data/sample_hudi_mor_table/.

Conclusion

This post demonstrated how AWS Glue crawlers work for Hudi tables. With the support for Hudi crawler, you can quickly move to using AWS Glue Data Catalog as your primary Hudi table catalog. You can start building your serverless transactional data lake using Hudi on AWS using AWS Glue, AWS Glue Data Catalog, and Lake Formation fine-grained access controls for tables and formats supported by AWS analytical engines.


About the authors

Noritaka Sekiyama is a Principal Big Data Architect on the AWS Glue team. He works based in Tokyo, Japan. He is responsible for building software artifacts to help customers. In his spare time, he enjoys cycling with his road bike.

Kyle Duong is a Software Development Engineer on the AWS Glue and Lake Formation team. He is passionate about building big data technologies and distributed systems.

Sandeep Adwankar is a Senior Technical Product Manager at AWS. Based in the California Bay Area, he works with customers around the globe to translate business and technical requirements into products that enable customers to improve how they manage, secure, and access data.
Apple to Add Manual Authentication to iMessage

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2023/11/apple-to-add-manual-authentication-to-imessage.html

Signal has had the ability to manually authenticate another account for years. iMessage is getting it:

The feature is called Contact Key Verification, and it does just what its name says: it lets you add a manual verification step in an iMessage conversation to confirm that the other person is who their device says they are. (SMS conversations lack any reliable method for verification­—sorry, green-bubble friends.) Instead of relying on Apple to verify the other person’s identity using information stored securely on Apple’s servers, you and the other party read a short verification code to each other, either in person or on a phone call. Once you’ve validated the conversation, your devices maintain a chain of trust in which neither you nor the other person has given any private encryption information to each other or Apple. If anything changes in the encryption keys each of you verified, the Messages app will notice and provide an alert or warning.

Чие е МВР?

Post Syndicated from Емилия Милчева original https://www.toest.bg/chie-e-mvr/

Чие е МВР?

Окървавеният протест на футболни фенове срещу БФС предизвика една изтраяла от ден до пладне дандания да подаде ли оставка вътрешният министър Калин Стоянов заради полицейската жестокост. Премиерът Николай Денков поиска от него да осъди насилието на униформените. Стоянов отговори, че по принцип не толерира насилието и че виновните, било то граждани или полицаи, „ще понесат отговорност“. И акад. Денков остана доволен от този знак.

… казах, че ако министърът продължава да си затваря очите и да замазва проблемите, щях да си тръгна. Министърът тръгна в правилната посока. Надявам се да извърви този път докрай.

Ерго няма да си тръгне, както беше обявил. Неуместно в политически план изявление на Денков, тъй като министър-председателят иска оставки от министрите си и си тръгва, когато политическата сила, която му е гласувала доверие, го оттегли. 

Но настоящата ситуация изкара наяве тайни на т.нар. сглобка, например че министърът на вътрешните работи не е номинация на ПП–ДБ, а на ГЕРБ. Досега публично известното беше, че представител на ГЕРБ в правителството е само Мария Габриел, която е вицепремиер и министър на външните работи, а след ротацията през март ще заеме поста министър-председател. 

Кой посочи Калин Стоянов?

Изборът на Калин Стоянов за министър на вътрешните работи в кабинета „Денков–Габриел“ изненада. Като директор на Главна дирекция „Борба с организираната престъпност“ (ГДБОП) през декември 2021 г. той беше обвинен, че е оказвал натиск върху една от прокурорките, наблюдаващи разследването за пране на пари, свързано с авансовите плащания за строителство на магистрала „Хемус“. Онези 53 млн. лв., теглени от оперативно интересни лица кеш на гише и прибирани в сакове. Според Софийската районна прокуратура Стоянов е искал да бъде смекчено обвинението на Борислав Колев, ако той даде обяснения по случая. Стоянов, тогава директор на ГДБОП, отрича, обяснявайки, че само се е интересувал защо не е бил разпитан Колев. В крайна сметка продължилото година разследване е прекратено няколко месеца преди Калин Стоянов да стане министър.

Към днешна дата и министърът на вътрешните работи, и съпредседателят на „Продължаваме промяната“ Кирил Петков в телевизионни интервюта открехват вратата към начина, по който са правени назначенията в кабинета, спестявайки каквото не им отърва. Но пък от премълчаното от единия и казано от другия може да се сглоби част от истината. Според Стоянов цели два дни Кирил Петков го увещавал – изразът е „ми се молеше аз да стана министър на вътрешните работи“, а с Петков го свързал настоящият заместник-шеф на ДАНС Петър Петров. Но по онова време Петров не заемаше този пост – беше избран за депутат от ПП–ДБ. Преди това е бил съветник в премиерския кабинет на Кирил Петков и има кариера в контраразузнаването. Неофициално е известно, че е номинацията на ПП–ДБ за шеф на ДАНС, ако настоящият – Пламен Тончев, бъде освободен.

Кирил Петков пък заяви, че Стоянов е кадър на ГЕРБ, с обяснението, че го е взел като експерт. „Номинациите на ПП–ДБ са ясните политически лица, които са бивши депутати. Зад тях заставаме чисто партийно на 100%“, каза той. Но бившите депутати са неколцина – строителният министър Андрей Цеков, правосъдният Атанас Славов, транспортният Георги Гвоздейков. След като прибавим към тях Денков, министъра на финансите Асен Василев, на туризма Зарица Динкова, на електронното управление Александър Йоловски, познати от предишния кабинет на Петков, за една част от членовете на правителството, които оглавяват ключови министерства, не е ясно кой е „подал“ експертните имена. Например за енергетиката, оглавявана от Румен Радев, за икономиката и индустрията, начело с Богдан Богданов, или за земеделието, което е ръководено от Кирил Вътев. 

За МВР беше много важно този човек да не бъде политически обвързан, защото идваха местни избори, трябваше да бъде максимално неутрален. И започнахме и от ПП–ДБ, и от ГЕРБ да се подават експертни имена… Калин Стоянов беше подаден като експерт от ГЕРБ [или от Мария Габриел, или от Борисов, Петков не помнел кой от двамата, но едва ли има съмнение, че го подава лидерът на ГЕРБ – б.а.], като ние обаче, преди да се вземе каквото и да е решение, отидохме да го интервюираме. Когато аз отидох да говоря с него, той казва, че аз съм първият човек, който говори с него… Защо ние решихме, че си заслужава да направим такова предложение? Защото видяхме, че той беше разследвал чувалите с магистралите и тази тема.

Това с магистралите не е много убедително – изглежда, че „интервюиращите“ не са разбрали какво точно е вършил Стоянов. Как иначе щяха да го подадат като експерт от ГЕРБ, ако се е заел да разследва „Хемус“, ключов обект на Бойко Борисов?!

Оплетените обяснения кой кого е посочил за пост в правителството, показаха, че ГЕРБ и ПП–ДБ са договаряли министри в правителството на Денков–Габриел, което не е само на ПП–ДБ, и така саможертвата на ГЕРБ, отказали се да правят кабинет с първия мандат, не изглежда толкова значима. Обществото пък не е наясно кой още освен Стоянов е министър на ГЕРБ – и дали е само на ГЕРБ, или и на ДПС. И двете политически сили защитиха Стоянов, а председателят на парламентарната група на ДПС Делян Пеевски даде да се разбере, че е имал и срещи с вътрешния министър и – в тон с ГЕРБ – че самият министър споделял за опити за влияние върху него. 

Каза, че има опит за влияние за назначаване на полицейски шефове.

Бойко Борисов пък заяви, че назначенията в МВР са експертни и са правени от ПП–ДБ, а не от ГЕРБ.

Когато дойде темата МВР, аз им казах, че трябва да е експерт, професионалист, отдалечен от всички. Предложих да се избира от наличните – назначени от тях по тяхно време години наред или от президента Радев служби. […] Казах да изберем между шефа на полицията, на БОП-а, на жандармерията. Той отиде, консултира се и след това предложиха Калин Стоянов. Аз се съгласих. Аз не съм говорил с него, не съм го убеждавал, не съм се срещал.“

Това сглобяване на кабинета, изяснило се на петия месец от дейността му, показва, че управлява коалиция, съвсем истинска, просто споразуменията не са публично известни. Липсата на разписано коалиционно споразумение ги улеснява. Ако протестът срещу БФС не се беше окървавил, нямаше и да се разбере за механизмите на сглобяването.

Негативната селекция

Проблемът с МВР обаче не е само в начина, по който е избран министърът, проблемът с МВР е много преди Стоянов, много преди Бойко Рашков, Цветан Цветанов и всички изредили се на ул. „Шести септември“. Проблемът е в начина, по който работи МВР, по който политиците употребяват МВР, а също и в негативната селекция на кадри за правоохранителните органи. 

Освен публично известното – че обслужва политическата сила на власт, – МВР функционира на кланов принцип: родово-семейните връзки оказват влияние при назначенията, а всяка управляваща партия е оставила свой кадрови отпечатък. При следващите на власт тези хора просто ги „скатават“, преназначавайки ги на други позиции в системата. Вътрешното министерство е пълно с такива назначения, довели със себе си и още „свои“ – подобно на политиците, и те се обграждат с лоялни подчинени. Повечето гледат да избутат до пенсия, за да получат заплатите накуп. Не странят от подкупите. Такава среда бързо деморализира – ако човек не иска неприятности, се примирява или просто напуска. 

Колко полезно за сигурността на гражданите и правовия ред е такова МВР… Отговорите на реторичния въпрос винаги са болезнени. Окървавеният протест срещу БФС разкри, освен лошия подбор, и брадясалия проблем на МВР – слабото или никакво обучение на кадрите в системата. Години наред, през куп правителства, бюджетът на Вътрешното министерство се изяжда от заплатите, които при това непрекъснато растат, а полицаите не спират да се оплакват от липса на добро облекло, качествена защита и др. В тазгодишния бюджет МВР получи 10% ръст на възнагражденията и допълнителни 100 лв. за някои длъжности. В бюджета за 2024 г. също са предвидени повишения на заплати в Министерството.

Какво толкова! Полицаите бият, политиците лъжат – това им е работата, нали? Банално утешение. Но червената линия, при която един полицай превишава правомощията си, за да наруши човешки права, е все по-проблемна и в развитите, и в неразвитите демокрации – защото протестите стават все по-силни и яростни.

Във Франция например за първите четири месеца на тази година се състояха над 3800 протеста – по изчисления на Bloomberg, срещу вдигането на възрастта за пенсиониране от 62 на 64 години. Демонстрациите и гражданското недоволство изкараха по улиците и площадите на Франция хиляди полицаи и доведоха до сериозни сблъсъци и дори до смъртта на 17-годишен младеж, застрелян от полицай. Но вътрешният министър Жералд Дарманен неизменно отхвърляше обвиненията в насилие. След остри критики от страна на Лигата за правата на човека (Ligue des droits de l’homme – LDH) и предприетите от нея съдебни действия срещу „несмъртоносните оръжия“, използвани от органите на реда, той дори я заплаши със спиране на държавното финансиране. На една от демонстрациите на земеделски производители и екоактивисти срещу изкуствени водоеми, които извличат подпочвените води, френското МВР е изпратило 3000 полицаи, 4 танка, 9 хеликоптера и водни оръдия.

Какво става с българските полицаи, разследвани за произвол след протеста срещу БФС? Образувани са дисциплинарни производства срещу трима служители за превишаване на полицейските правомощия и те са отстранени от длъжност. По информацията от СДВР срещу други двама тече проверка, която ще определи степента им на виновност. И понеже някой все пак трябваше да бъде уволнен, това беше заместник-министърът на вътрешните работи Стоян Темелакиев – не министърът, нито пък главният секретар на МВР Живко Коцев.

Протестът на футболните фенове се окървави, но недостатъчно, за да подаде оставка министърът на вътрешните работи. При смърт в резултат на полицейско насилие, креслото на Калин Стоянов щеше да изстине. И щеше да седне друг калинстоянов, подаден от някой бойкоборисов.

Отворен код и придобиване на софтуер от държавата

Post Syndicated from Bozho original https://blog.bozho.net/blog/4168

По покана на Европейската Комисия участвах на конференция за използването на софтуер с отворен код в обществения сектор, на която споделих следното:

България през 2016 г. прие закон, с който всички административни органи се задължават при възлагане на разработка на софтуер, в договорите и спецификациите си да включат клаузи, с които да изискват разработеният софтуер да е публичен (от първия ден на разработка) и да е с лиценз, който позволява безплатно използване от всеки.

Това е важна мярка, за чието спазване настоявам във всичките си качества оттогава, по следните причини:

  1. Преизползване – когато кодът на една система е публичен, всеки друг, разработващ сходна функционалност, може да го използва и развива. В системите в публичния сектор има много повтарящи се изисквания и е загуба на време и пари да се разработват всеки път от нулата.
  2. Прозрачност и доверие – след като системата е разработена с публични средства, на обществото се дължи кода на системата. Така ще знаем как точно работи дадена система (и че работи правилно, съгласно закона, а не съгласно нечии интерпретации, както се оказа наскоро със системата за мониторинг на наличностите на лекарствата), и ще имаме повече доверие в нея (неслучайно направих предложение да се изгради нов софтуер на машините за гласуване, който да бъде отворен, но за съжаление това предложение не се прие в миналия парламент)
  3. Качество – когато изпълнител на дадена поръчка знае, че кодът, който произведе, ще бъде публичен, внимава повече да спазва добрите практки, да прави кода по-четим и по-подреден. Не един път съм чувал, че „ще го публикуваме, ама чакай първо да го пооправим малко“. Включително на самата конференция, от колега от друга държава.
  4. Одитируемост – държавата трябва да може да одитира какво точно е получила и да гарантира, че е получила (и че в продукционна среда работи) правилният софтуер. Примерът с тол системата, чийто изходен код липсва, показва защо това е важно – АПИ в момента не може да одитира в дълбочина собствената си система.
  5. Ценова ефективност – има два аспекта на отворения код, свързан с цената за държавата, и по-точно за общата цена на притежаване (total cost of ownership). Първият е, че когато използваш готов продукт с отворен код, той е безплатен (спрямо цената на лицензите или абонамента за платен такъв). Но вторият аспект е, че когато нямаш кода да даден софтуер, или нямаш права да го модифицираш, си до голяма степен заключен за един доставчик. Ако лицензът на кода позволява модификации (каквото позволят всички open source лицензи), софтуерната компания, която го поддържа, може да бъде сменена, което пък означава конкуренция и съответно – по-ниска цена.

Имаме закона, имаме съответната наредба и шаблона за технически задания, имаме и правомощията за контрол по прилагането и съгласуване на заданията, така всички нормативни и процесни предпоставки са налице. Не е налице още културата и пълното разбиране у възллжителите защо това е важно (пример за това е моят въпрос до МВР защо по проекта за електронна идентификация все още няма публикуван изходен код, въпреки че се работи по него). Тук е моментът да отбележа, че мобилното приложение за електронна идентификация, която аз възложих като министър, също няма публикувана работната версия на код, защото проектът беше спрян в служебния кабинет и ключови негови части блокирани заради отказ от предоставяне на достъп до данни от МВР. Ако проектът беше продължил, щях да настоявам за работа именно в хранилището на МЕУ.

Освен честото неспазване на изискванията, имаме и притеснения от страна на службите за сигурност, които виждат риск в разкриването на изходния код. Аз не съм съгласен с тези притеснения, тъй като не се публикува нищо, свързани с оперирането на системата в продукционна среда – нито криптографски ключове, нито пароли, нито мрежови настройки. Да, съществува риск от наличие на уязвимости в кода, които да бъдат видени от хакери, но криенето на кода не означава, че уязвимостите не са там. Криенето, обаче, може да попречи на „белите хакери“ да ги докладват преди да бъде злоупотребено с тях.

Невинаги е възможно да се възлага разработка на софтуер с отворен код – понякога се придобива нещо готово, за което се купува лиценз или абонамент. Трябва предварително да е ясно на възложителя какво си поръчва – готов софтуер, разработка „на чисто“, или хибрид (готов софтуер с надграждане със специфични модули). Именно последното е случаят с тол системата, но държавата не е знаела какво поръчва, и вместо да получи кода на доработените за нея функционалности, е получила само лиценз.

Готовият софтуер е нещо хубаво и удобно, защото зад него стои производител и неговите партньори за внедряване. Но колкото и привлекателно да изглежда, трябва да се направи преценка дали са налични достатъчно добри алтернативи с отворен код. Понякога няма такива, или са твърде далеч като възможности. Понякога има, но няма достатъчно експерти с познания за тях.

Има и случаи, в които изпълнителят твърди (с право или не), че определени библиотеки, съдържащи основни функционалности, са си негови и той само дава лиценз за тях. Това е възможно, като в такива случаи (какъвто би следвало да бъде и този с тол системата), държавата може да поиска една от две опции. За предпочитане е т.нар. code available, вкл. с право на модификации. Т.е. кодът не се публикува, изпълнителят запазва авторските си права, но предоставя кода на възложителя, както и правото той да възложи надграждане на друг. Това е сложно за уреждане, и включва риск от „падане на гаранция“ („не знам какво сте му правили, при нас си работи“). Втората опция е т.нар. source code escrow – кодът се депозира в трета страна, която го предоставя на държавата в случай, че производителят фалира или спре работата по продукта. Това е по-малко желателният подход, тъй като обвързва държавата с един доставчик, но поне „фаталните“ сценарии са покрити.

Остава и казусът с т.нар. „софтуер като услуга“ (SaaS). Там държавата може да поиска достъп до кода, за да го одитира, но нито може да го публикува, нито да го надгражда (освен ако самата система няма plug-in архитектура). Много съвременни софтуерни компании предпочитат „софтуер като услуга“, защото това им дава повторяем приход, по-лесно управление на клиентите и по-добра видимост върху използването. Само че SaaS е оперативен разход, а не капиталов. SaaS представлява задължително заключване за един доставик. Ползите са удобството и нулевата инвестиция в хардуерна инфраструктура. В някои случаи SaaS е валиден подход, но според мен софтуерните компании могат да предоставят т.нар. self-hosted версии на своите продукти, което би било от полза за обществени организации.

Софтуерът с отворен код е най-силен в основните технологични решения – системи за управление на бази данни, операционни системи, уеб сървъри. При този тип софтуер много рядко има причина за комерсиални решения, особено ако има корпоративна поддръжка за софтуера с отворен код „на една ръка растояние“. Затова бих насърчил всички да използват напр. Linux, PostgreSQL, NginX.

При всички положения, когато държавата използва софтуер, който е с отворен код, трябва да дефинира процеси по неговото развитие и управление, напр. механизъм за предлагане на подобрения от участници, различни от избрания изпълнител. Всъщност, в наредбата, която подготвихме през 2016 г., в чл. 60 такъв процес е предвиден, но досега той не е реализиран.

Закупуването на софтуер, неговото управление и поддръжка, изчисляването на цената на собственост и всички останали аспекти са сложни. В един блогпост или няколко изказвания на конференция не могат да покрият всички тези сложности. За да не допуска държавата грешки, трябва да има достатъчно познание по тези въпроси в нейните структури. Министерство на електронното управление и структурите към него могат да бъдат център за такова познание, но не следва да са единствените. Затова обмисляме предлагането на фигурата на Chief information officer (CIO) за администрациите, които да са не просто ИТ директори, отговарящи за оперативните ИТ задачи, а които да имат директна комуникация с органа на власт и да изграждат стратегията и да водят дигиталната трансформация на администрацията.

С времето ще се формират добрите практики, ще се натрупа опит и няма да се допускат грешки, които струват на държавата скъпо, и от които понякога губим години в дадена сфера. А отвореният код ще бъде важен инструмент за дигиталната трансформация.

Материалът Отворен код и придобиване на софтуер от държавата е публикуван за пръв път на БЛОГодаря.

The collective thoughts of the interwebz