Post Syndicated from Talks at Google original https://www.youtube.com/watch?v=k0YYMa3tjzY
A few weekend stable kernels
Post Syndicated from original https://lwn.net/Articles/869746/rss
The relatively large
5.14.6,
5.13.19, and
5.10.67
stable kernel updates have been released; each contains another set of
important fixes. Note that this is the final update for the 5.13.x
series.
Cloudflare Pages is Lightning Fast
Post Syndicated from Nevi Shah original https://blog.cloudflare.com/cloudflare-pages-is-lightning-fast/
When we announced Cloudflare Pages in April, our goal wasn’t to bring just any web development tool to the table. As a front-end developer, it’s your responsibility to bring the ideas of your marketing, product and engineering teams to life by crafting a beautifully engaging experience for every customer. With all the hard work that goes into the development process — turning mock-ups to code, getting input from your team, staging and testing changes — you want the best performance possible for your site to showcase your work and optimize your customers’ experience.
Cloudflare Pages is the most secure and most scalable Jamstack platform to build and deploy your sites on the edge. But how is Pages so fast?
It comes down to three key reasons:
- Pages is built on one of the fastest networks in the world, putting us within 50 ms of 95% of the world’s Internet-connected population. Delivering Pages from this network is the basis of our speed.
- Cloudflare helps define and implement next generation standards, like QUIC + HTTP/3 and Early Hints, that push Pages performance to the next level.
- Pages has a killer developer experience that makes it easy to build the fastest websites on the planet.
Pages is delivered from one of the fastest networks in the world
After all the sweat, finger cramps, and facepalms you’ve managed to survive through development, the last thing you need is poor performance and load times for your site. This not only drives off frustrated customers, but if the site is a storefront, it can also have revenue implications.
We’ve got you covered! With Cloudflare’s extensive network, consisting of 250+ cities, your Pages site is deployed directly to the edge in seconds. With even more optimizations to our network routing, your customers are routed to the best data center, ensuring optimal loading and performance globally.
How does our performance compare?
Optimized routing, a giant CDN network, support for the latest standards, more performance enhancements — these all sound great! But let’s put them to the ultimate test: benchmarking. How do our Pages sites’ performance compare to those of our competitors?
The TTFB test
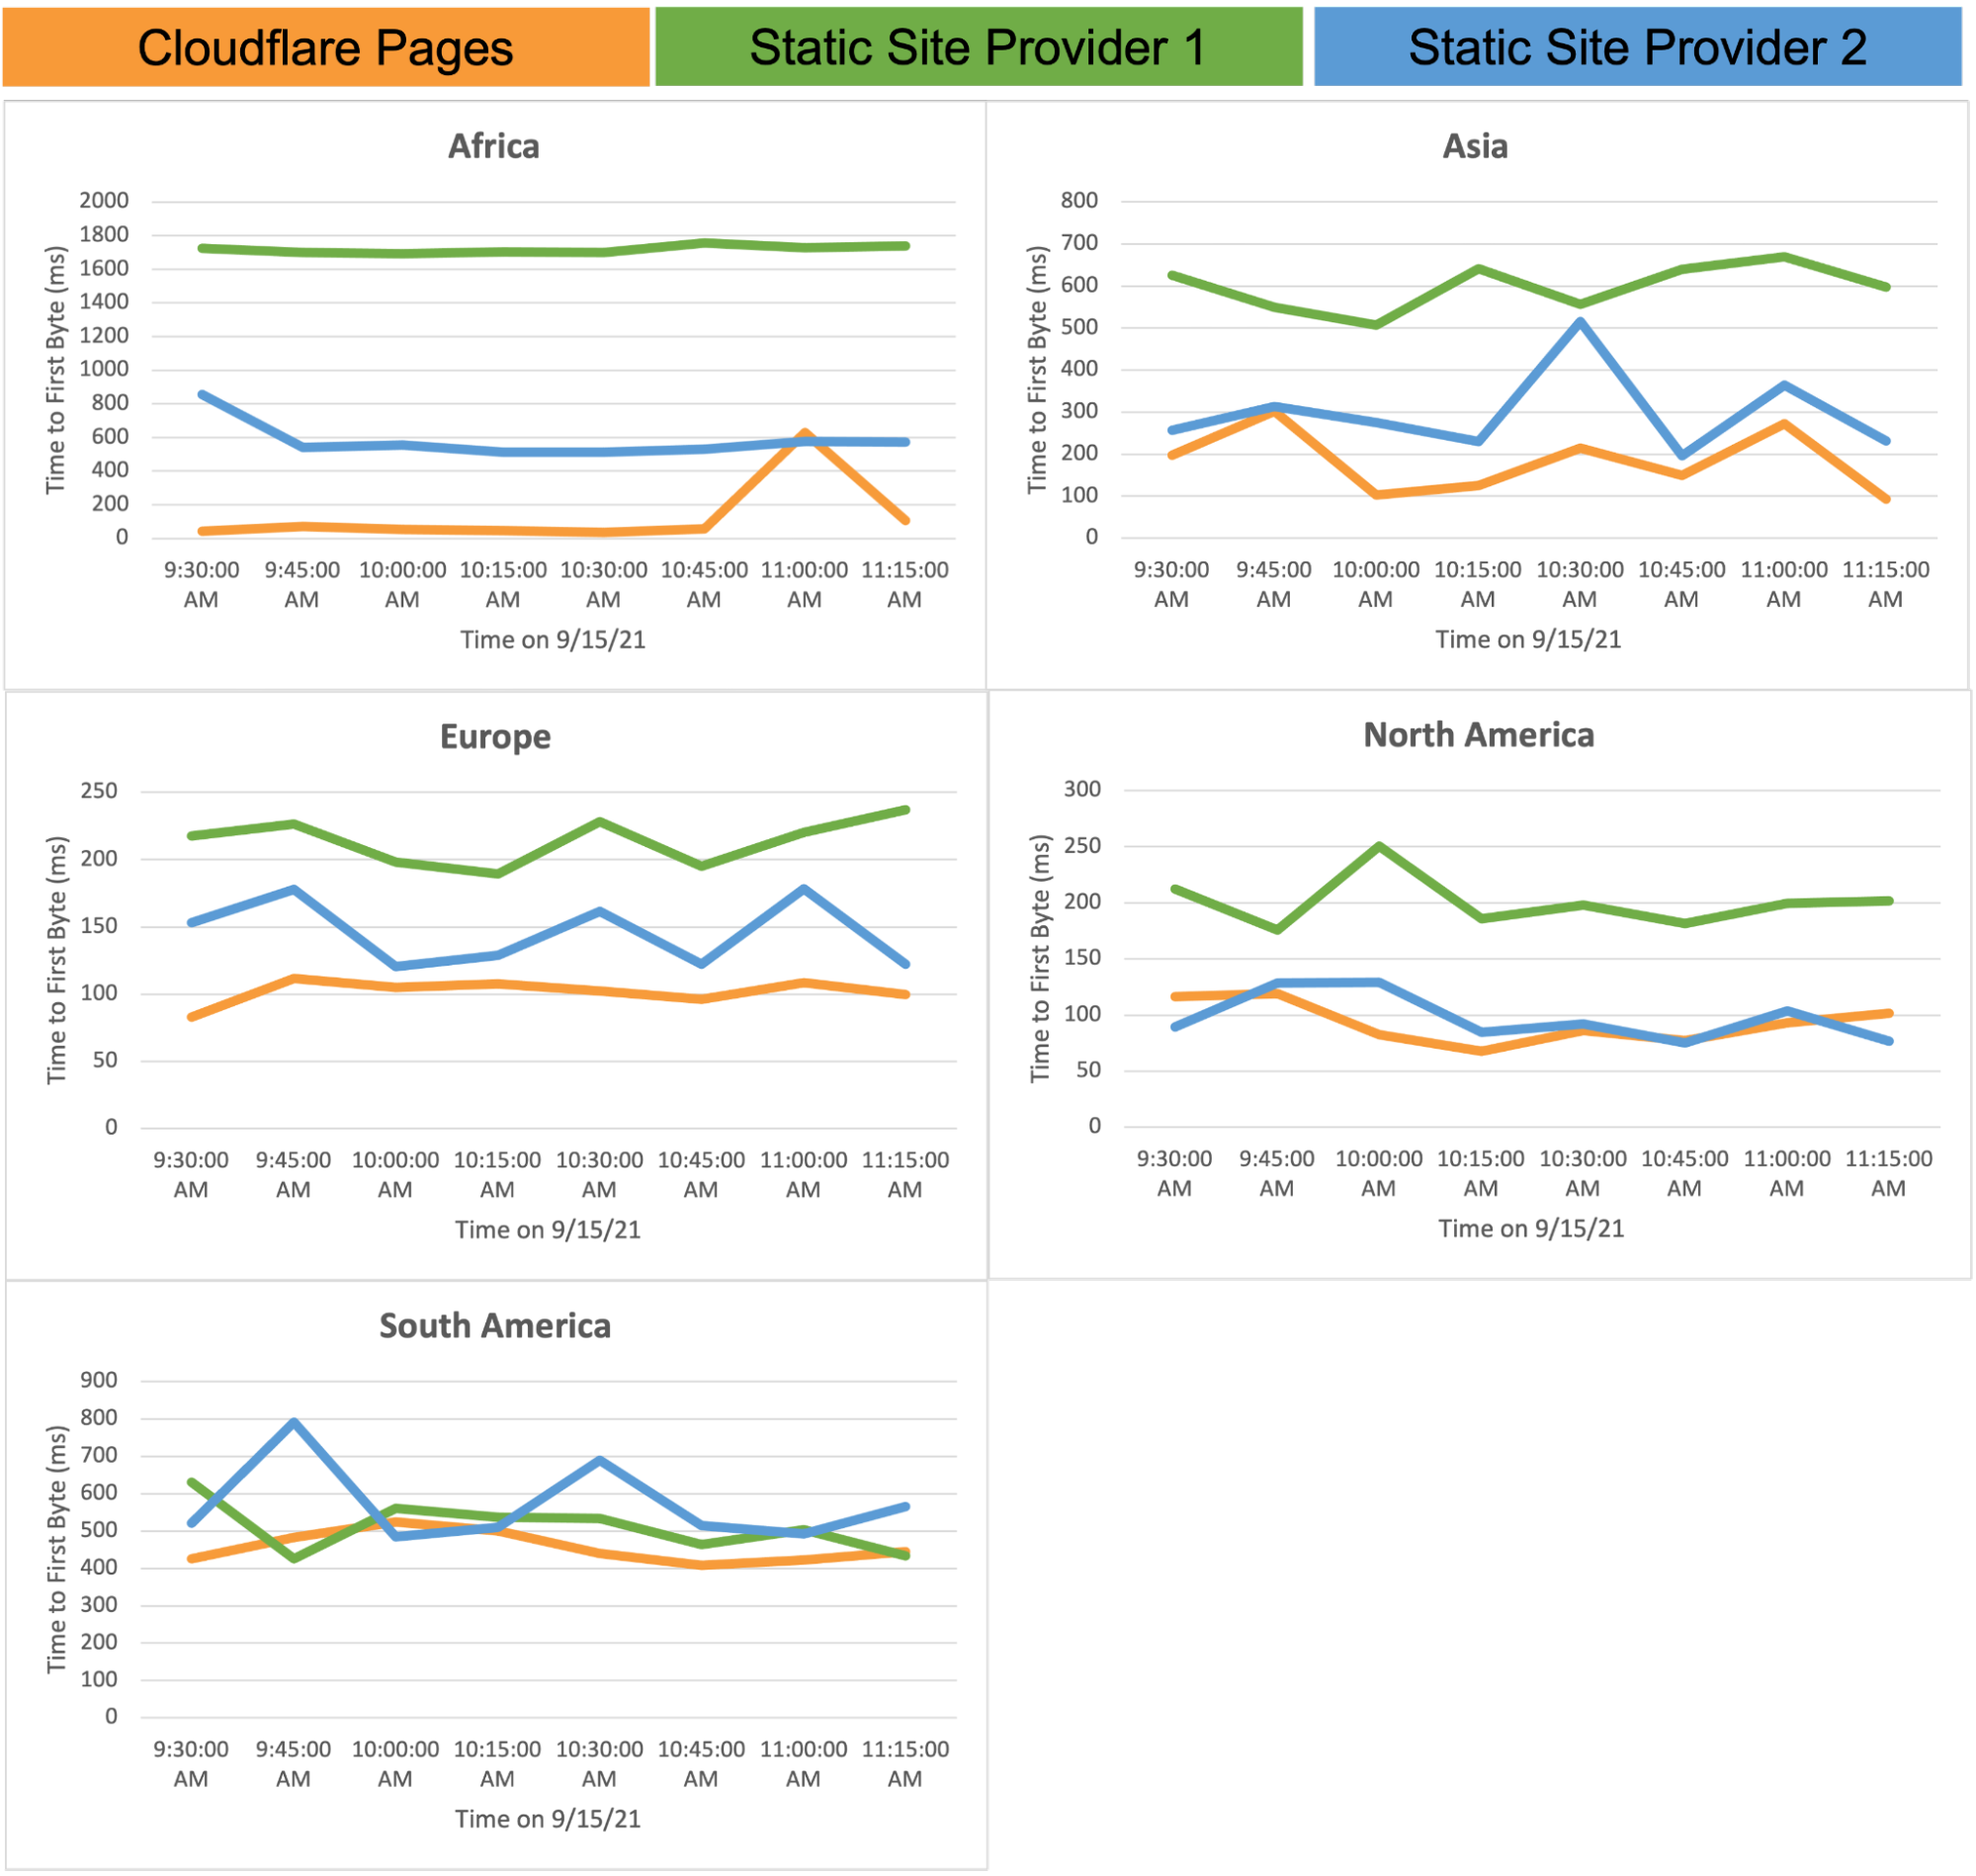
We deployed the same static site on Pages and on two other popular deployment platforms for comparison. We understand that benchmark tools like Google Lighthouse may introduce some geographic bias; performing a benchmarking analysis from San Francisco and hitting a local data center doesn’t tell us much about performance on a global scale. We wanted to create a simulation to run tests from different locations to give us a globally accurate representation. Using a tool called Catchpoint, we executed our test from 35 different cities around the world to measure the Time to First Byte (TTFB) for different providers. To give as accurate a reading as possible, we ran our test up to eight times, and averaged the result per city and per provider.
Around the world in 80ms
It’s common to see good performance in regions like the US and Europe, but at Cloudflare, we think even more globally. Cloudflare’s network allows you to reach a myriad of regions around the world without any additional effort or cost. Everytime our map grows, your global reach does too.
In our TTFB comparison, Cloudflare Pages is leading the race to your customers against two leading providers.
Pages gets early access to the latest, greatest, and fastest standards and network protocols
But it’s not just our network. We are proud of both driving and adopting the latest web standards. Our mission has always been to help build a better Internet, and collaborating on the latest standards is an essential part of that goal, especially when thinking about your Pages sites.
TLS 1.3: As the new encryption protocol, TLS 1.3 sets out to improve both speed and security for Internet users everywhere. With 1.3, during the course of that infamous “TLS handshake” you hear so much about, only one round trip, or back and forth communication, is required instead of two, thus shortening the process by milliseconds. A huge step forward for web security and performance, TLS 1.3 is available to all Pages users with no additional action required — let the client and server handle it all.
IPv6: Today it’s extremely common for every person to have more than one Internet connected device, making the shift to IPv6 extremely crucial, now more than ever. Not only is IPv6 the answer to the “no more addresses” issue, but is also another added layer for performance and security with its ability to handle packets more efficiently, getting faster and faster as adoption of the standard increases.
QUIC & HTTP/3: The new internet transport protocol, QUIC & HTTP/3, team up to enable faster, reliable and more secure connections for your customers to web endpoints like your Pages site. QUIC, a transport layer protocol, aims to reduce connection and transport latency and avoid congestion and runs underneath HTTP/3. Enabled by default on every pages.dev domain, QUIC & HTTP/3 work in tandem to provide improved performance and security so long as the client complies.
With support for the latest standards like HTTP/3 and IPv6, as we work on support for dynamic frameworks, we will be able to offer response streaming, a feature other platforms don’t provide.
“Pages gives us more confidence than other providers, making it easier to migrate our app over and build new products that can easily scale with growing traffic.” — David Simpson, COO at Designed.org
But we know that speed doesn’t just matter from a user perspective. It also matters from a developer perspective, too — and we’ve worked to make that just as great an experience.
A developer experience that we’d want to have
Generally speaking, performance of anything on the web is only as fast as the weakest link. A fast network, or support for the latest standards, doesn’t mean very much if we make it hard for a developer to do their job, or to optimize their code. So we knew the developer experience had to be a priority, too.
Fast for your users. Fast for you, too.
We set out to simplify every step of your developer experience by looking for ways to integrate into your existing publishing workflow. With Pages’ full git integration, grab your repo, tell us your framework and go! Collaborate with all members of your team — developers, PMs, marketers — quickly and efficiently with a protected preview URL per deployment to speed up the turnaround time for feedback. A simple Git commit and git push, and we’ll have your site up and running in seconds, and ready for you to share with your team or your customers.
Of course, even with lightning fast set-up and collaboration, we realize there’s more to the productivity of you and your team. From the time we launched Pages, we’ve been working on making our build times faster every day. Today, Pages builds are 3x faster than they were when we first launched the platform, but we’re not done yet. We’re aiming to have the fastest build times, so you can focus on what you do best — code, test, deploy, repeat — minus any wait.
Performance tuning, built in
In May of last year, Google announced a new program — Web Core Vitals — to provide unified guidance on how to measure the quality of a website, and to identify areas of improvement for developers, business owners, and marketers to deliver a better user experience. There are three key metrics as part of the program:
- Largest Contentful Paint: measures loading performance
- First Input Delay: measure interactivity
- Cumulative Layout Shift: measures visual stability
Fast-forward a year to 2021, Google officially announced that performance on these metrics will now be incorporated into Google Search results.
Performance is becoming an ever important aspect of the success of any site on the web.
We recognize this, and it’s part of why we’re so relentlessly focused on making sites hosted on Pages so fast. But you don’t need to just take our word for it. In addition to providing you with stellar performance across the globe, our Web Analytics tool is available to Pages customers with one click — so you can track your site’s Web Core Vitals and understand specific areas of improvement. As an example, here’s the Web Analytics on our very own Cloudflare Docs site.
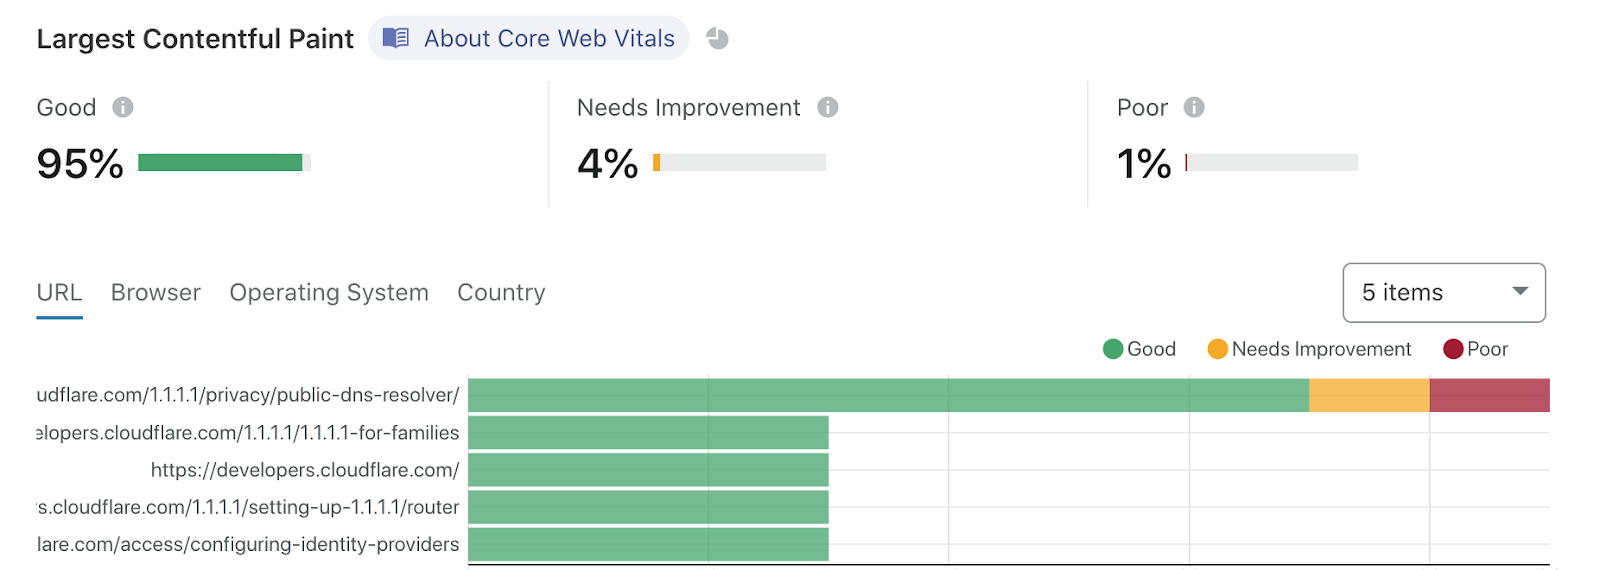
We’re big believers in dogfooding — running our Docs site on Pages, and then using our Web Analytics to identify areas of improvement. It’s a big part of the Cloudflare ethos, and it’s how we can be confident in recommending our products to you.
What’s Next
With the increasing momentum behind the Jamstack movement, it’s a great time to be in the field. With Pages, you can rest easy knowing you’re taken care of every step of the way. We are so excited about the future of Cloudflare Pages — integrating with Cloudflare Workers, supporting monorepos, enabling more sources of repo integration — and how it brings a fresh perspective on how you build and deploy your sites on the web.
Check our docs to get started on Cloudflare Pages today!
Profiling Your Workers with Wrangler
Post Syndicated from Joshua Nelson original https://blog.cloudflare.com/profiling-your-workers-with-wrangler/
In the year since Cloudflare’s launch of Workers Unbound, developers have unlocked the ability to run computationally intensive workloads on the Cloudflare edge network — like image processing, game logic, and other complex algorithms. With all that additional computing power comes a host of questions around performance. Our customers often ask us how they can profile or monitor their Workers to see where they spend the most CPU time, or to see whether their changes improve performance.
Here at Cloudflare, we not only want to build the fastest, most affordable, and most flexible compute platform at the edge; we also want to make the lives of our developers easier in building their applications. To do this, Cloudflare has begun to integrate with existing tools — places our developers feel comfortable and efficient in their day-to-day work. To help measure performance of our customers’ Workers, we’re beginning to integrate with the Chrome DevTools protocol. Just like you can use chrome://inspect to debug your Node backend, you can also use it to profile your Cloudflare Workers.
Introducing Chrome DevTools Integration (Beta)
We’re starting off this integration with beta support for local CPU profiling, using Wrangler. To show off how to use this feature, I’m going to be optimizing a simple JavaScript program which outputs the first thousand integers separated by a space. Let’s start by installing the latest version of Wrangler. We’ll also need a Worker cloned down to your local machine. I’ll be using Workers Profiling Example, but feel free to use any CPU intensive Worker for this tutorial.
For reference, my sample code is below. You’ll notice this code is intentionally performing a computation that will slow down our Worker.
addEventListener("fetch", event => {
  event.respondWith(handleRequest(event.request));
});

async function handleRequest(request) {
  let body = '';
  for (let i = 0; i < 1000; ++i) {
    body = body + ' ' + i;
  }

  return new Response(body, {
    headers: { 'content-type': 'text/plain' },
  });
}
To confirm this, we’ll run Chrome DevTools and profile our Worker locally. In the directory of your sample project, run wrangler dev --inspect. To launch the DevTools, open chrome://inspect in Chrome or Chromium. You’ll see Chrome’s DevTools homepage pop up:

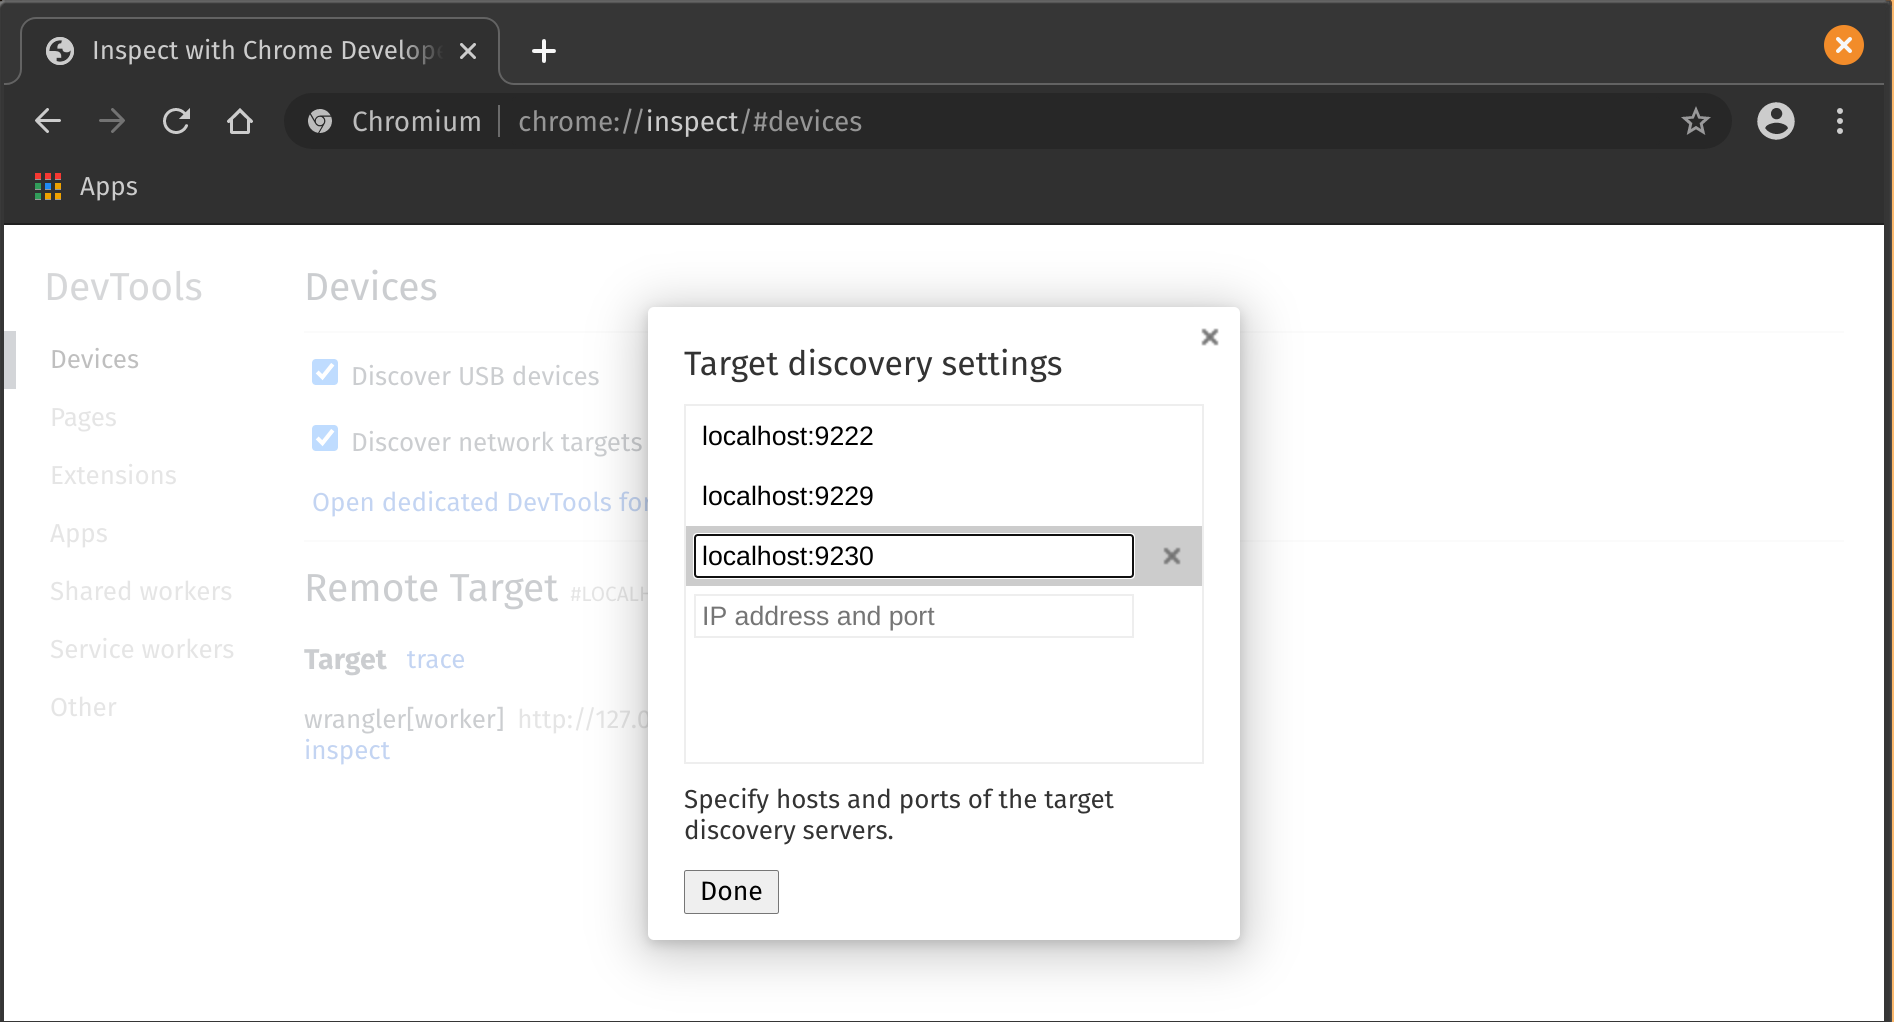
Click ‘Configure’ and add localhost://9230 as one of the targets. You should see wrangler[{Worker name}] appear under “Remote Targets”, where {Worker name} is the name of your project.
Click ‘inspect’, then in the popup, ‘Profiler’.
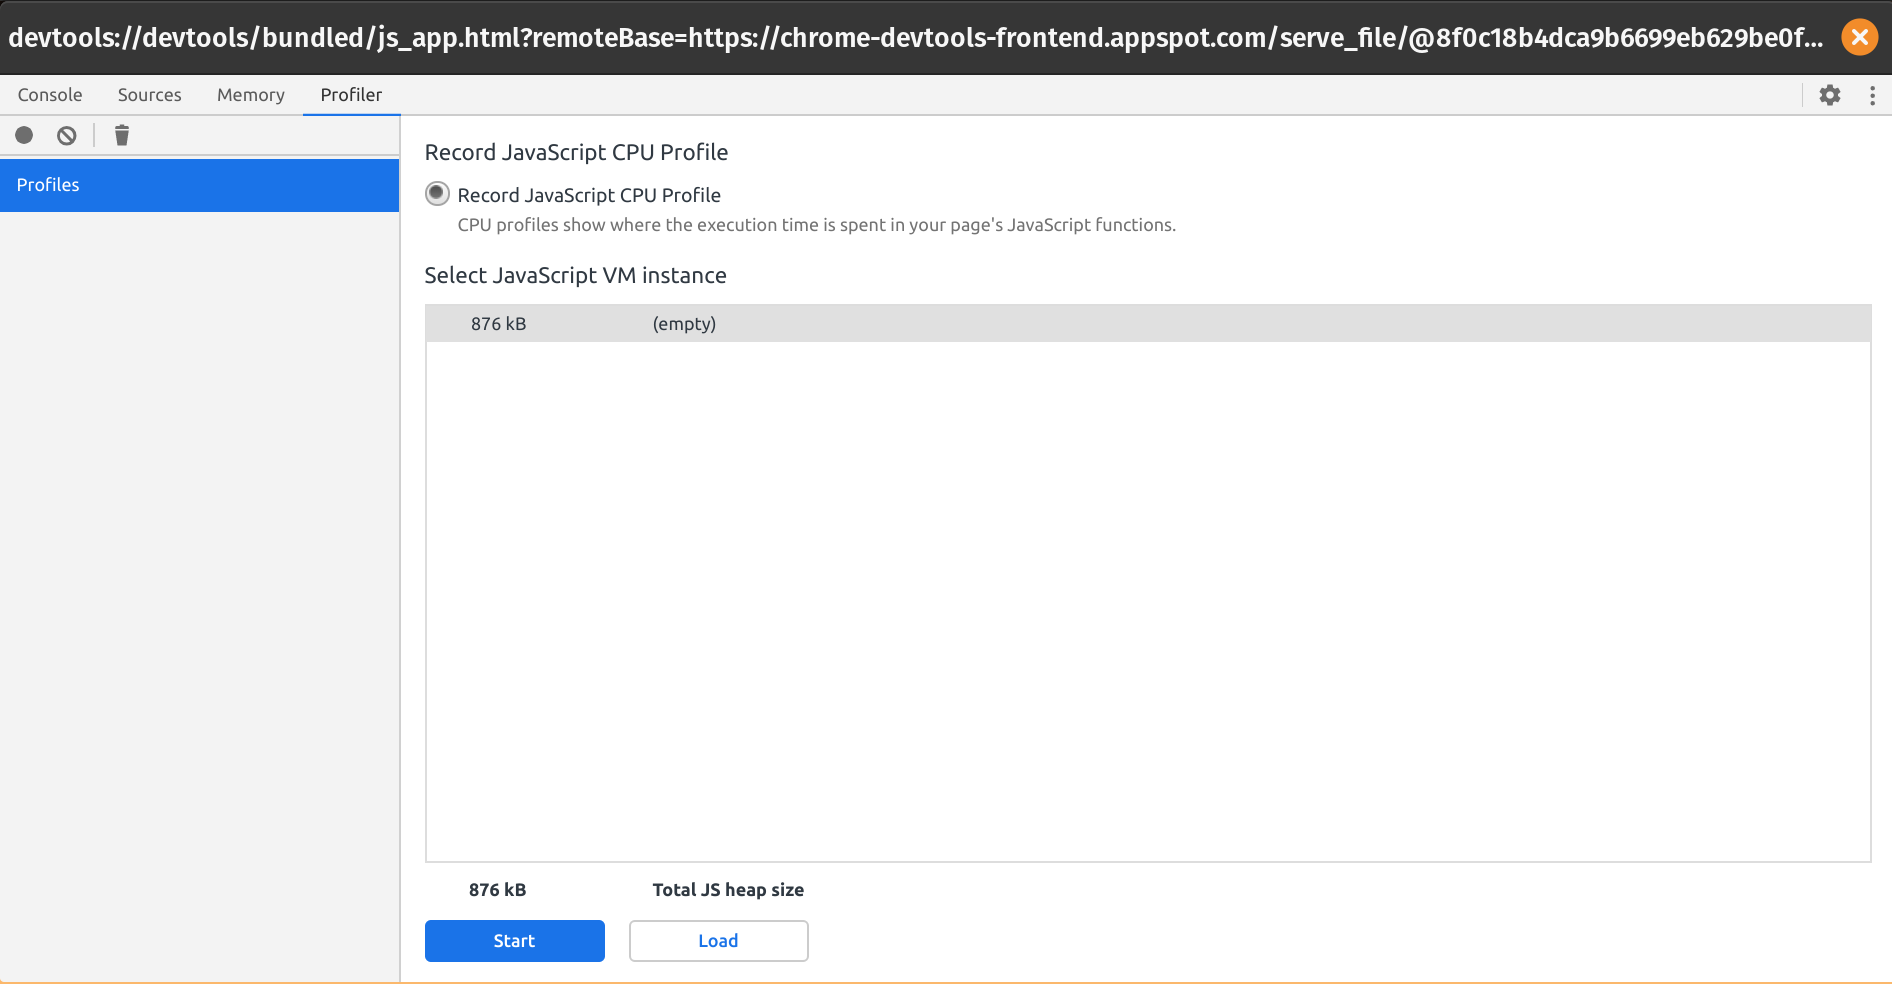
Click ‘Start’ and, in a different browser tab, make a few requests to your site, then click ‘Stop’. It should be available locally on localhost:8787.
Analyze the flame graph. For my Slow Worker, I see the following graph:
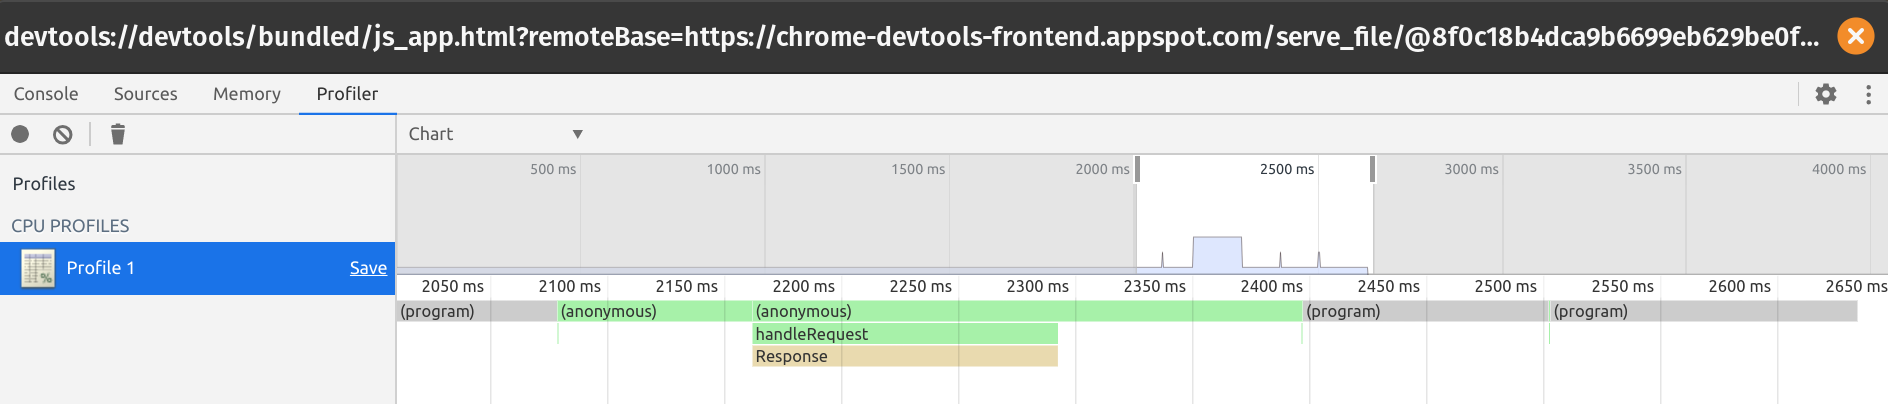
When I click on handleRequest, I see the following annotated source of my Worker:
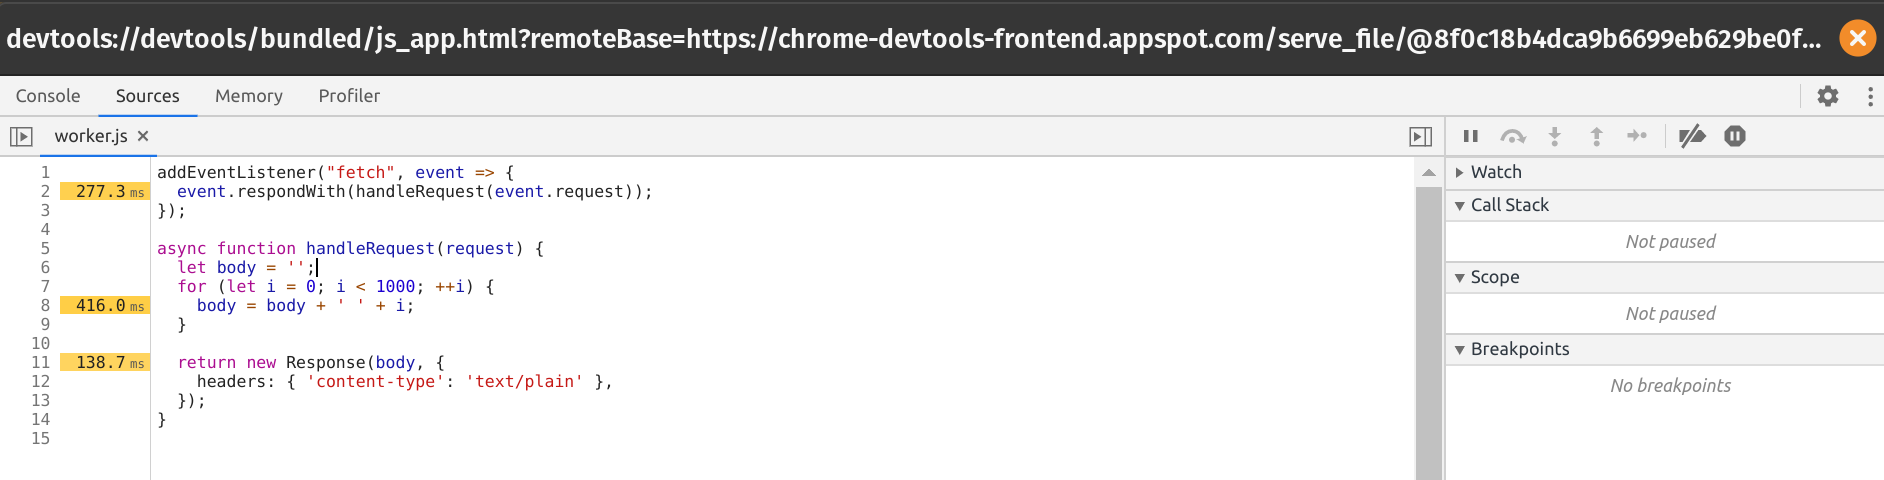
In particular, it shows that, unsurprisingly, most of the time is being spent on memory allocations in the body of the loop. Note that the profiler is not always accurate with regard to exact timing, but does paint a picture of your largest bottlenecks.
Understanding the Profile
The profiler works by gathering a stack trace of your program at a sampled rate, so remember that the profile is an approximation of where your code tends to spend the majority of its execution time, and is not meant to be perfectly accurate. In fact, functions that execute in less than 100 microseconds have a chance to not appear in the profile at all.
What’s Next?
With the Workers platform, we’re striving to build in the observability our users expect out of a robust compute platform. We’d love to hear more from the community about ways we can improve visibility into the code you’re writing on the edge. If you haven’t already, please join the Cloudflare Workers Discord community at https://discord.gg/PX8s2TmJ7s. Happy building!
Too many MDs?
Post Syndicated from Techmoan original https://www.youtube.com/watch?v=FD_-vLoJ9EM
Comic for 2021.09.18
Post Syndicated from Explosm.net original http://explosm.net/comics/5979/
New Cyanide and Happiness Comic
Field Notes: Tracking Overall Equipment Effectiveness with AWS IoT Analytics and Amazon QuickSight
Post Syndicated from Shailaja Suresh original https://aws.amazon.com/blogs/architecture/field-notes-tracking-overall-equipment-effectiveness-with-aws-iot-analytics-and-amazon-quicksight/
This post was co-written with Michael Brown, Senior Solutions Architect, Manufacturing at AWS.
Overall equipment effectiveness (OEE) is a measure of how well a manufacturing operation is utilized (facilities, time and material) compared to its full potential, during the periods when it is scheduled to run. Measuring OEE provides a way to obtain actionable insights into manufacturing processes to increase the overall productivity along with reduction in waste.
In order to drive process efficiencies and optimize costs, manufacturing organizations need a scalable approach to accessing data across disparate silos across their organization. In this blog post, we will demonstrate how OEE can be calculated, monitored, and scaled out using two key services: AWS IoT Analytics and Amazon QuickSight.
Overview of solution
We will use the standard OEE formulas for this example:
| Availability = Actual Time / Planned Time (in minutes) |
| Performance = (Total Units/Actual Time) / Ideal Run Rate |
| Quality = Good Units Produced / Total Units Produced |
| OEE = Availability * Performance * Quality |
To calculate OEE, identify the following data for the calculation and its source:
| Supporting Data | Method of Ingest |
| Total Planned Scheduled Production Time | Manufacturing Execution Systems (MES) |
| Ideal Production Rate of Machine in Units | MES |
| Total Production for the Scheduled time | Programmable Logic Controller (PLC), MES |
| Total Number of Off-Quality units produced | PLC, Quality DB |
| Total Unplanned Downtime in minutes | PLC |
For the purpose of this exercise, we assume that the supporting data is ingested as an MQTT message.
As indicated in Figure 1, the data is ingested into AWS IoT Core and then sent to AWS IoT Analytics by an IoT rule to calculate the OEE metrics. These IoT data insights can then be viewed from a QuickSight dashboard. Specific machine states, like machine idling, could be notified to the technicians through email or SMS by Amazon Simple Notification Service (Amazon SNS). All OEE metrics can then be republished to AWS IoT Core so any other processes can consume them.
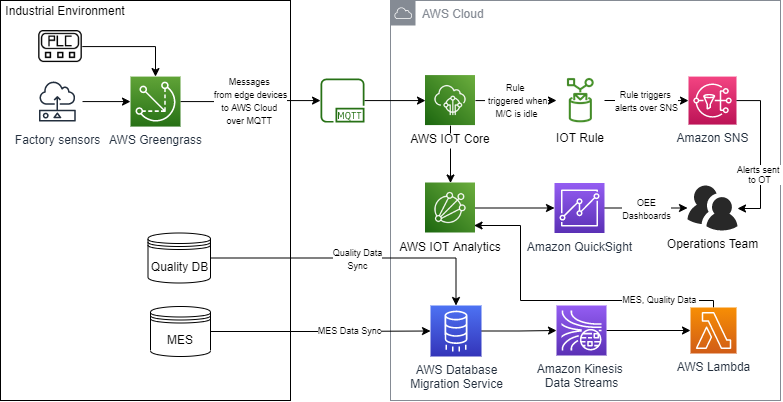
Figure 1. Tracking OEE using PLCs with AWS IoT Analytics and QuickSight
Walkthrough
The components of this solution are:
- PLC – An industrial computer that has been ruggedized and adapted for the control of manufacturing processes, such as assembly lines, robotic devices, or any activity that requires high reliability, ease of programming, and process fault diagnosis.
- AWS IoT Greengrass – Provides a secure way to seamlessly connect your edge devices to any AWS service and to third-party services.
- AWS IoT Core – Subscribes to the IoT topics and ingests data into the AWS Cloud for analysis.
- AWS IoT rule – Rules give your devices the ability to interact with AWS services. Rules are analyzed and actions are performed based on the MQTT topic stream.
- Amazon SNS – Sends notifications to the operations team when the machine downtime is greater than the rule threshold.
- AWS IoT Analytics – Filters, transforms, and enriches IoT data before storing it in a time-series data store for analysis. You can set up the service to collect only the data you need from your PLC and sensors and apply mathematical transforms to process the data.
- QuickSight – Helps you to visualize the OEE data across multiple shifts from AWS IoT Analytics.
- Amazon Kinesis Data Streams – Enables you to build custom applications that process and analyze streaming data for specialized needs.
- AWS Lambda – Lets you run code without provisioning or managing servers. In this example, it gets the JSON data records from Kinesis Data Streams and passes it to AWS IOT Analytics.
- AWS Database Migration Service (AWS DMS) – Helps migrate your databases to AWS with nearly no downtime. All data changes to the source database (MES, Quality Databases) that occur during the data sync are continuously replicated to the target, allowing the source database to be fully operational during the migration process.
Follow these steps to build an AWS infrastructure to track OEE:
- Collect data from the factory floor using PLCs and sensors.
Here is a sample of the JSON data which will be ingested into AWS IoT Core.
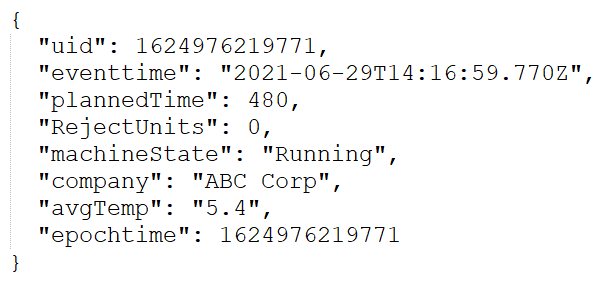
In AWS IoT Analytics, a data store needs to be created which is needed to query and gather insights for OEE calculation. Refer to Getting started with AWS IoT Analytics to create a channel, pipeline, and data store. Note that AWS IoT Analytics receives data from the factory sensors and PLCs, as well as through Kinesis Data Streams from AWS DMS. In this blog post, we focus on how the data from AWS IoT Analytics is integrated with QuickSight to calculate OEE.
- Create a dataset in AWS IoT Analytics.In this example, one of our targets is to determine the total number of good units produced per shift to calculate the OEE over a one-day time period across shifts. For this purpose, only the necessary data is stored in AWS IoT Analytics as datasets and partitioned for performant analysis. Because the ingested data includes data across all machine states, we want to selectively collect data only when the machine is in a running state. AWS IoT Analytics helps to gather this specific data through SQL queries as shown in Figure 2.
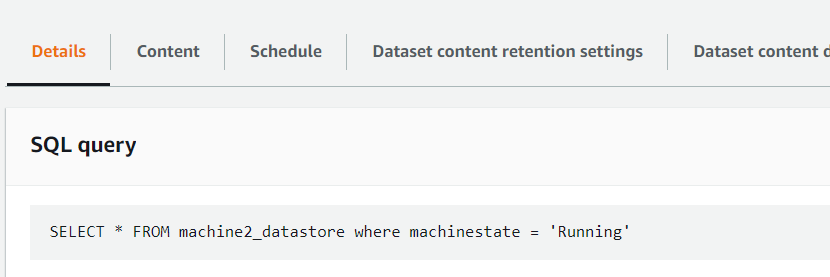
Figure 2. SQL query in IoT Analytics to create a dataset
Cron expressions are expressions that indicate a schedule such that the tasks can be run automatically based on a schedule and frequency. AWS IoT Analytics provides options to query for the datasets at a frequency based on cron expressions.
Because we want to produce daily reports in QuickSight, set the Cron expression as shown in Figure 3.

Figure 3. Cron expression to query data daily
- Create an Amazon QuickSight dashboard to analyze the AWS IOT Analytics data.
To connect the AWS IoT Analytics dataset in this example to QuickSight, follow the steps contained in Visualizing AWS IoT Analytics data. After you have created a dataset under QuickSight, you can add calculated fields (Figure 4) as needed. We are creating the following fields to enable the dashboard to show the sum of units produced across shifts.
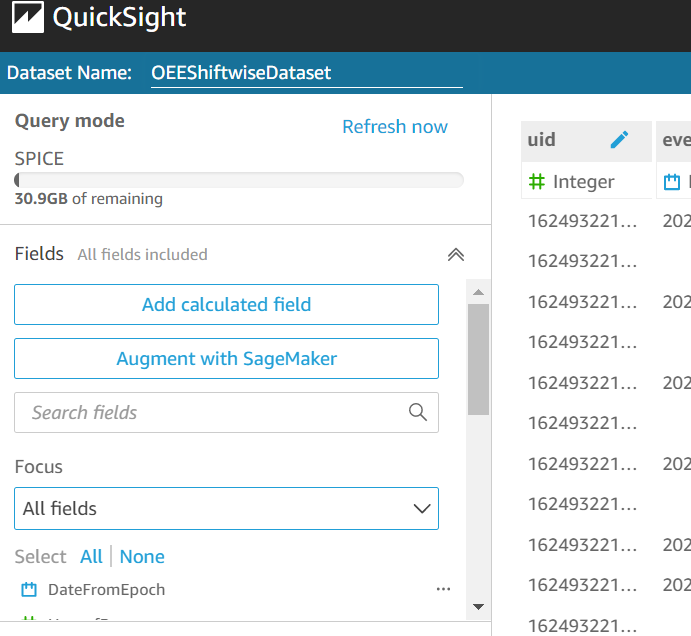
Figure 4. Adding calculated fields in Amazon QuickSight
We first add a calculated field as DateFromEpoch to produce a date from the ‘epochtime’ key of the JSON as shown in Figure 5.
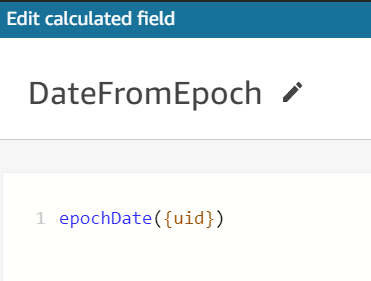
Figure 5. DateFromEpoch calculated field
Similarly, you can create the following fields using the built-in functions available in QuickSight dataset as shown in Figures 6, 7, and 8.
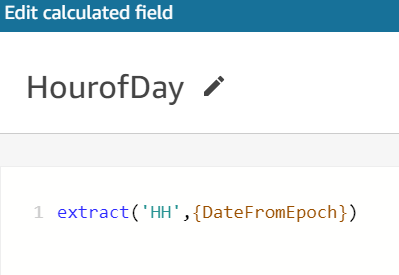
Figure 6. HourofDay calculated field
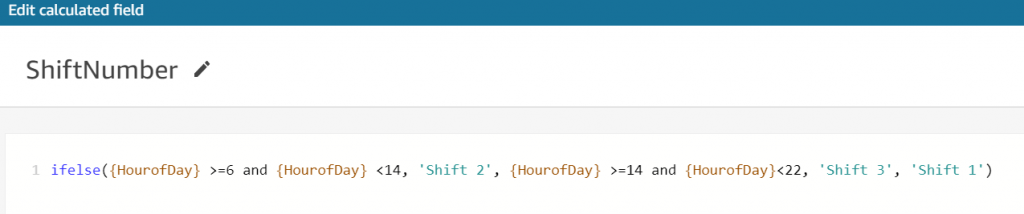
Figure 7. ShiftNumber calculated field
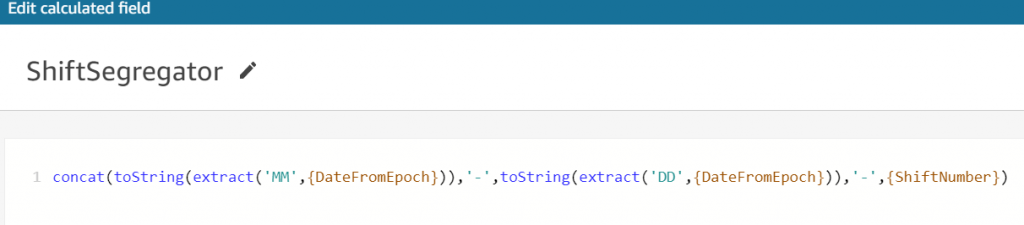
Figure 8. ShiftSegregator calculated field
To determine the total number of good units produced, use the formula shown in Figure 9.
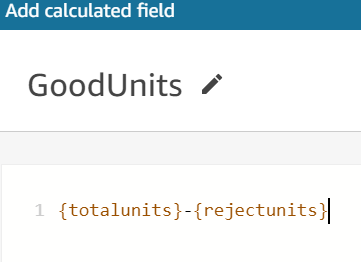
Figure 9. Formula for total number of good units produced
After the fields are calculated, save the dataset and create a new analysis with this dataset. Choose the stacked bar combo chart and add the dimensions and measures from Figure 10 to produce the visualization. This analysis shows the sum of good units produced across shifts using the calculated field GoodUnits.
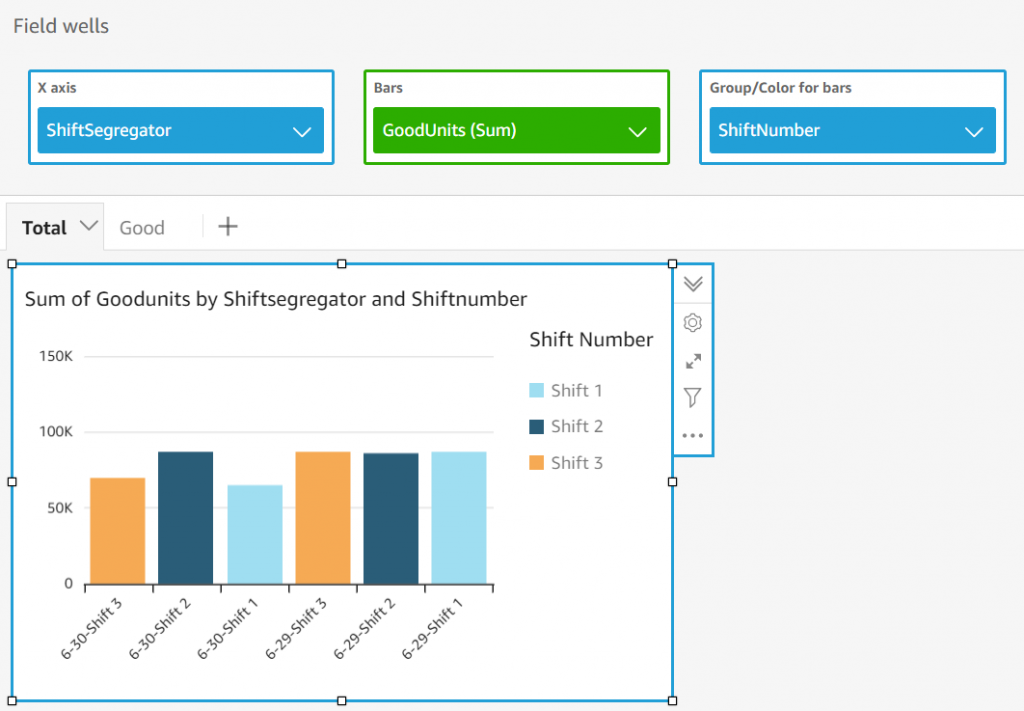
Figure 10. Good units across shifts on Amazon QuickSight dashboard
- Calculate OEE.To calculate OEE across shifts, we need to determine the values stated in Table 1. For the sake of simplicity, determine the OEE for Shift 1 and Shift 2 on 6/30.
Let us introduce the calculated field ShiftQuality as in Figure 11.
-
- Calculate Quality
Good Units Produced / Total Units Produced
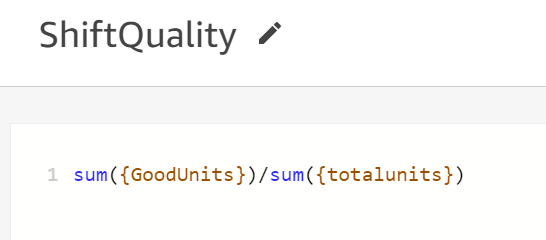
Figure 11. Quality calculation
Add a filter to include only Shift 1 and 2 on 6/30. Change the Range value for the bar to be from .90 to .95 to see the differences in Quality across shifts as in Figure 12.
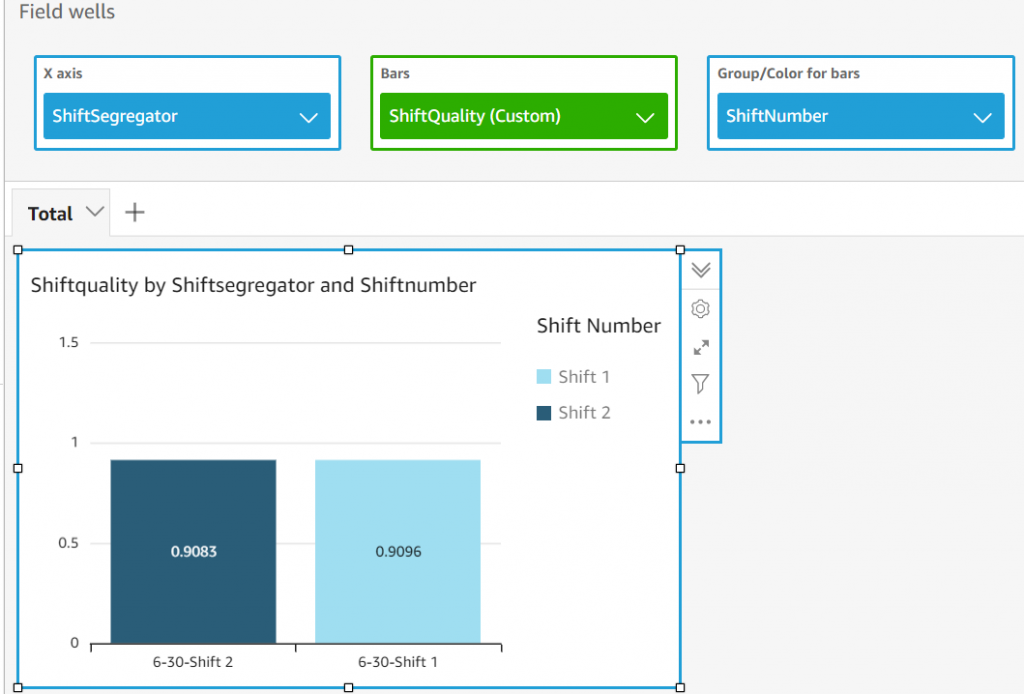
Figure 12. Quality differences across shifts
-
- Calculate Performance
(Total Units/Actual Time) / Ideal Run Rate
For this factory, we know the Ideal Production Rate is 203 units per minute per shift (100,000 units/480 minutes). We already know the actual run time for each shift by excluding the idle and stopped state times. We add a calculated field for ShiftPerformance using the previous formula. Change the range of the bar in the visual to be able to see the differences in performances across the shifts as in Figure 13.
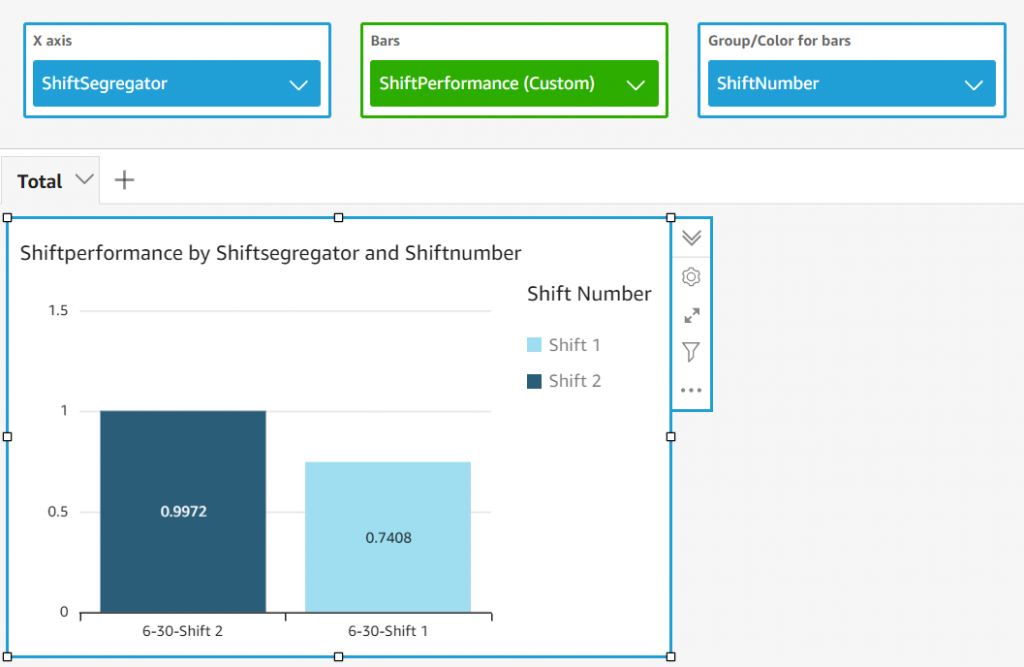
Figure 13. Performance calculation
-
- Calculate Availability
Actual Time / Planned Time (in minutes)
The planned time for a shift is 480 minutes. Add a calculated field using the previous formula.
-
- Calculate OEE
OEE = Performance * Availability * Quality
Finally, add a calculated field for ShiftOEE as in Figure 14. Include this field as the Bar to be able to see the OEE differences across shifts as in Figure 15.
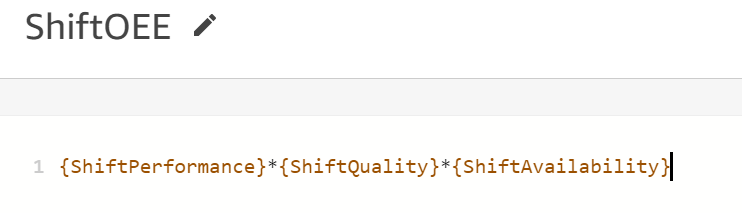
Figure 14. OEE calculation
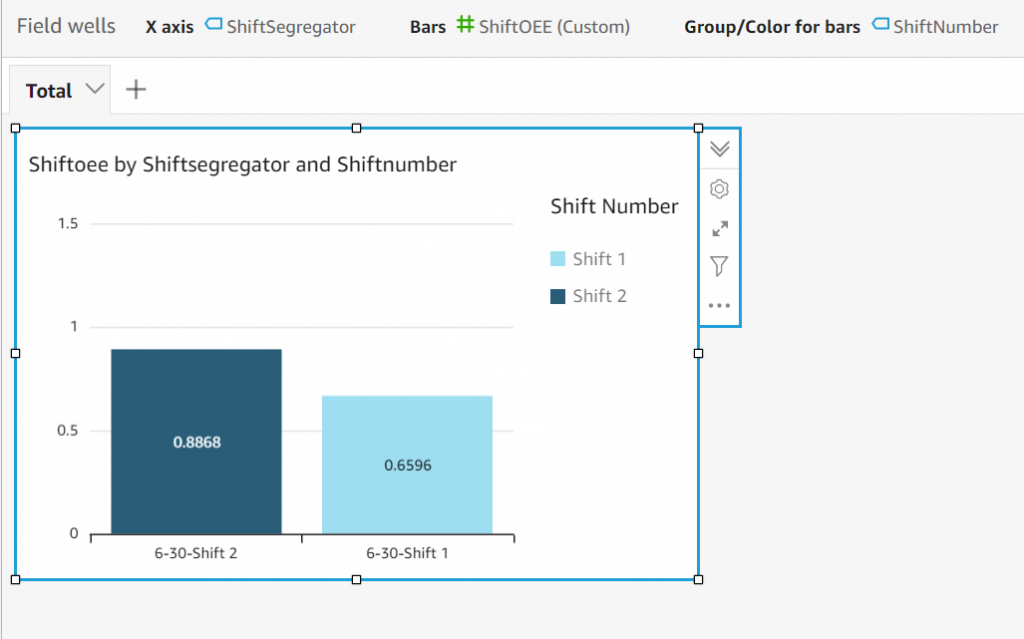
Figure 15. OEE across shifts
Shift 3 on 6/28 has the higher of the two OEEs compared in this example.
Note that you can schedule a dataset refresh in QuickSight for everyday as shown in Figure 16. This way you get to see the dataset and the visuals with the most recent data.
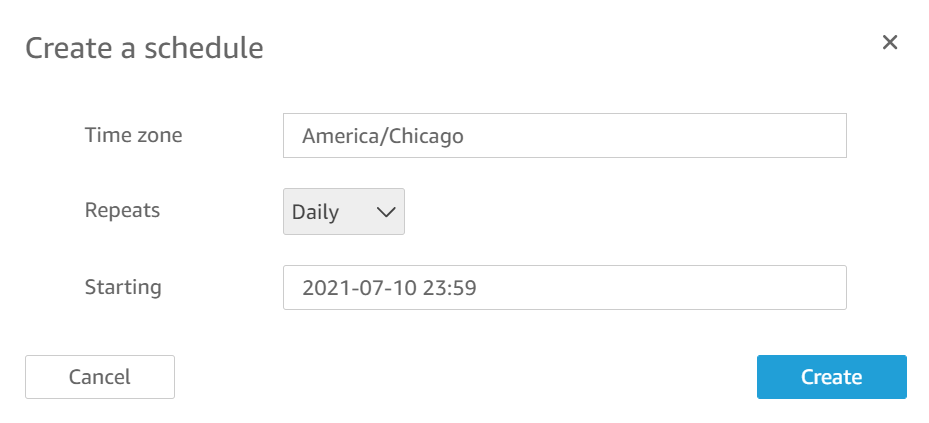
Figure 16. Dataset refresh schedule
All the above is a one-time setup to calculate OEE.
- Enable an AWS IoT rule to invoke Amazon SNS notifications when a machine is idle beyond the threshold time using AWS IoT rule.
You can create rules to invoke alerts over an Amazon SNS topic by adding an action under AWS IoT core as shown in Figures 17 and 18. In our example, we can invoke alerts to the factory operations team whenever a machine is in idle state. Refer to AWS IoT SQL reference for more information on creating rules through AWS IoT Core rule query statement.
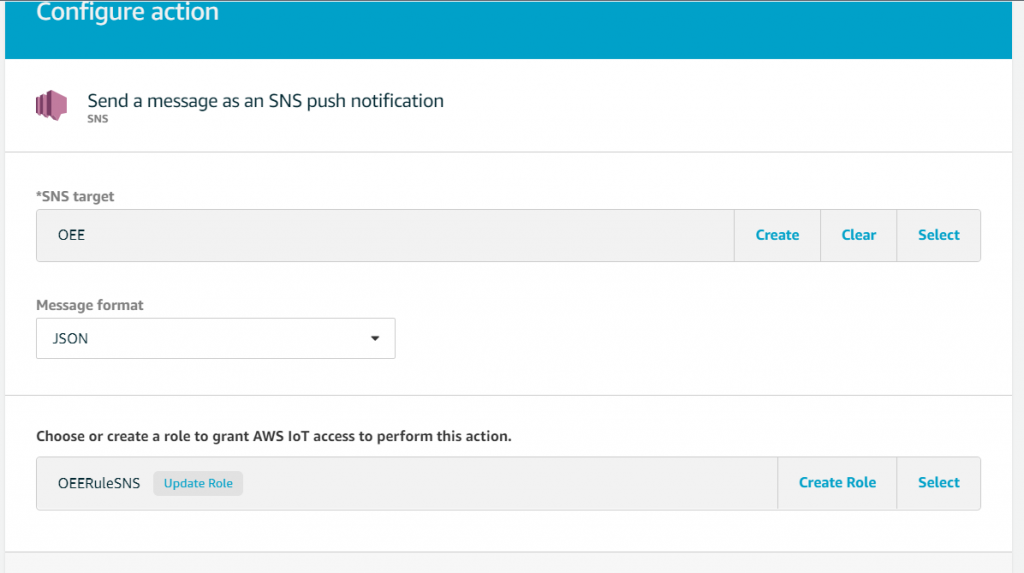
Figure 17. Send messages through SNS
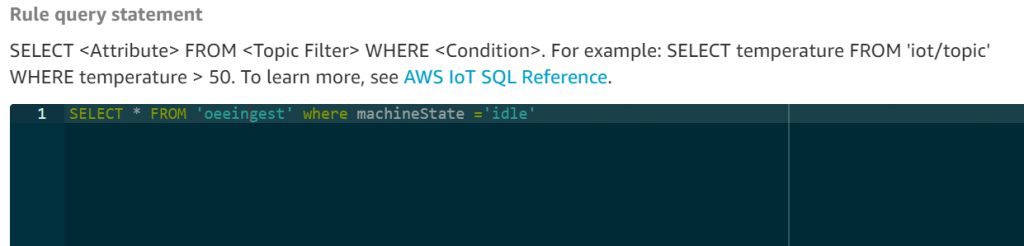
Figure 18. Set up IoT rules
Conclusion
In this blog post, we showed you how to calculate the OEE on factory IoT data by using two AWS IoT services: AWS IoT Core and AWS IoT Analytics. We used the seamless integration of QuickSight with AWS IoT Analytics and also the calculated fields feature of QuickSight to run calculations on industry data with field level formulas.
Field Notes provides hands-on technical guidance from AWS Solutions Architects, consultants, and technical account managers, based on their experiences in the field solving real-world business problems for customers.
Friday Squid Blogging: Ram’s Horn Squid Shells
Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2021/09/friday-squid-blogging-rams-horn-squid-shells.html
You can find ram’s horn squid shells on beaches in Texas (and presumably elsewhere).
As usual, you can also use this squid post to talk about the security stories in the news that I haven’t covered.
Read my blog posting guidelines here.
Свърши вече хубавото време на служебната власт
Post Syndicated from Емилия Милчева original https://toest.bg/svurshi-veche-hubavoto-vreme-na-sluzhebnata-vlast/
Розовият период на служебното управление свърши. Не защото двамата министри с най-висок рейтинг Кирил Петков и Асен Василев напускат по собствено желание, за да се пробват на терена на политическото. Служебният кабинет, който продължава да управлява, остава в почти същия състав – ако не броим и отстранения заради липса на активност в „изчегъртването“ транспортен министър и замяната му с друг. Но задачите са различни, настроенията също – настъпва есента, а не отпускарско лято.
Разкритията, громящи модела на ГЕРБ, и уволненията, предизвикващи аплодисменти, няма да се повторят. Протестите на пътните работници затъмниха порочния, но законов формат на „инхаус“ поръчките и авансовите плащания, стигащи до 100% за определени фирми. Както се разбра, те ще трябва да се платят – защото договорите са си договори.
И при Ангелов, и при Кацаров – провал с ваксинациите
Когато председателката на Европейската комисия Урсула фон дер Лайен обяви в речта си „За състоянието на Съюза“ на 15 септември, че темпът на ваксиниране срещу COVID-19 трябва да се ускори, никой в България не откликна. В България чакаха новия служебен кабинет, който да поеме властта за следващите (поне) два месеца. А в този кабинет министърът на здравеопазването си е същият – д-р Стойчо Кацаров.
След като пое поста през май, Кацаров заяви в ефира на bTV, че няма да принуждава никого, няма да агитира за ваксинация: „Само ще информирам хората, че ваксините са безопасни и спасяват човешки живот.“ Въпреки създадената от него организация и логистични центрове, България все така остава последна по ваксинации в Европейския съюз. А в края на август отново беше с най-висока смъртност от COVID-19 в ЕС.
Ваксинационната кампания стартира през януари т.г. В първите четири месеца и половина до 11 май, когато властта бе поета от служебно правителство, този процес беше управляван от правителството на ГЕРБ и неговия здравен министър проф. Костадин Ангелов. В последващите 4 месеца – и най-вероятно до края на годината – тя е в ръцете на служебния кабинет и д-р Кацаров. Съществени резултати обаче няма нито при ГЕРБ, нито при кабинета, назначен от президента Радев. С малко над 18% напълно ваксинирано население България продължава да е последна при достигнати над 60% в ЕС; Румъния е предпоследна с 27,3%.
Непопулярни мерки? Никога преди избори
Никой не вярва, че служебното правителство ще се осмели да въведе каквито и да било непопулярни мерки, за да насърчи ваксинирането. Първо, предстоят избори. Второ, ще ги остави на редовния кабинет, очакван след вота на 14 ноември. С призива си Европейският съюз да се намеси заради ниския процент ваксинирани срещу COVID-19 в България евродепутатът Радан Кънев („Демократична България“) предизвика и упрекна политиците, че стават заложници на предизборен популизъм.
Второ правителство и трети парламент в България се провалят в организацията на ваксинационна кампания, в пресичането на антинаучната пропаганда […], в провеждането на политики, които да насърчат ваксинацията и които да защитят гражданите. Провалят се, защото политическата криза и постоянната предизборна кампания ги превръщат в заложници на страхлив популизъм. […] Така че отговорът е, че правомощията на Европа стигат дотам, докъдето е нужно, ако националните правителства се провалят да защитят нашите граждани.
Повишаване на темповете на ваксинация изобщо не беше споменато от премиера Стефан Янев като една от непосредствените задачи, след като за втори път оглави служебно правителство. Той открои други – подготовката на честни избори, проблемите в енергетиката, където били нужни „фундаментални структурни промени“, и разплащанията в пътния бранш.
Първото обаче си е задължение по закон на служебната власт. В енергетиката служебният кабинет не може да извърши никакви сериозни промени без парламент – например не може да смени членовете на КЕВР, чиито мандати са изтекли отдавна. Странно е, че министърът на енергетиката Андрей Живков запази поста си и във втория служебен кабинет въпреки липсата на активна позиция по който и да било от проблемите в енергийния бранш, в т.ч. енергийните проекти в Националния план за възстановяване и устойчивост и свързаното с тях затваряне на въглищните централи, които неминуемо ще трябва да се спрат. Не е сигурно дали някой все още търси изгубената пътна карта за развитие на газопреносната мрежа, подписана между българската страна и руската компания „Газпром“ – абсурдно твърдение, че държавната власт не може да открие толкова важен документ, а не може да посочи и виновник за това.
Малка част от разплащанията в пътния бранш се уредиха с гласуваната актуализация на бюджета – общо 320 млн. лв.; за другите 1,2 милиарда ще му мисли следващата власт. Така че за парливите проблеми тази есен служебното правителство няма инструменти за въздействие, но по отношение на ваксинацията има възможности.
Бягство от проблема
Изглежда обаче, че ще се заобикалят каквито и да било опити за задължителна ваксинация за някои професионални гилдии. Българските власти са далеч от решимостта на гръцките. След като през юли т.г. гръцкият парламент задължи медиците да се ваксинират, Атина даде срок до 1 септември на здравните работници да го направят. Въпреки бурните протести, след тази дата 7000 медици бяха уволнени от работа.
През април т.г. Европейският съд по правата на човека в Страсбург се произнесе, че държавите могат да въвеждат задължителна ваксинация и да налагат санкции при отказ, „в интерес на общественото здраве и правата на всички хора и при спазване на пропорционалността на тези мерки“. Политическа воля за втвърдяване на мерките в България липсва и заради липсата на активност от страна на почти всички политически партии изобщо по темата.
Протести на собственици на заведения бяха предизвикани от мерките, които влязоха в сила от 7 септември със заповед на здравния министър. Те ограничиха до 30% използвания капацитет на помещения за различни цели, а посещенията в заведенията за хранене и развлечения, игралните зали и казина се допускат само в часовия интервал от 7 до 23 при спазване на отстояние 1,5 м между облегалките на столовете на съседните маси, допускане на не повече от 6 души на една маса и носене на защитни маски от персонала.
Напук на данните
Антиваксърските настроения са превзели българското общество и всякакви фалшиви новини намират добра почва. Освен в социалните мрежи, те се разпространяват и от публични личности като доц. Атанас Мангъров, съобщил в ефира на bTV, че в Инфекциозната болница има починали хора, ваксинирани срещу COVID-19 – впоследствие твърдението е опровергано от лечебното заведение.
Според данни, разпространени от Министерството на здравеопазването за последния 14-дневен период – от 1 до 14 септември, ваксинираните са били 7,2% от всички хоспитализирани с COVID-19. Относителният дял на ваксинираните, постъпили за интензивно лечение, е 0,3% от всички 6488, приети в лечебни заведения с COVID-19. В този период са починали 64 души със завършен ваксинационен курс от общо 9494 – или 0,67%. Въпреки това не бяха отделени повече средства за информационна кампания за ваксиниране и мерки в тази посока, но служебното управление реши НЗОК да заплаща домашното лечение на болни от COVID-19. Изискването е преди това да са преминали през консултация в някоя от 50-те обособени ковид зони по места.
В действителност работата на този служебен кабинет ще се ограничи до организацията на изборите 2 в 1 (първи тур на президентските заедно с парламентарни, чрез машини) – достатъчно голямо предизвикателство; изплащане на компенсации и преговори с едни или други протестиращи за намиране на временни решения на проблеми.
Какво още
Разбира се, очакваме от новия служебен министър на транспорта, информационните технологии и съобщенията Христо Алексиев да разкрие схемите около Пристанище „Варна“ и участието на бизнес кръгове, свързани с почетния председател на ДПС Ахмед Доган. Предшественикът му Георги Тодоров така и не се осмели да разрови. Това винаги върши работа в предизборна кампания.
Иначе, служебната власт да се моли да не падне сняг през ноември. При неразплатените сметки с пътните фирми въпросът кой ще излезе да чисти, е особено труден.
Заглавна снимка: Първото заседание на новия служебен кабинет на 16 септември 2021 г. Източник: government.bg
Поредните спасители
Post Syndicated from Венелина Попова original https://toest.bg/porednite-spasiteli/
Кирил Петков и Асен Василев влизат в политиката. Тази новина, предизвестена и очаквана, разпали страсти и коментари още преди двамата министри от служебния кабинет на президента Радев да обявят своето намерение. Как ще изглежда бъдещата партия, още не знаем, обаче чухме от конструкторите ѝ малко, но важни неща.
Според Петков тя няма да се позиционира по оста „ляво–дясно“, защото с десни инструменти в политиката можело да се постигат и леви цели. Хората в нея щели да бъдат избирани по нивото си на почтеност, кариера и успешно битие извън политиката. Финансова помощ от „едни политически инвеститори, които после очакват инвестираните средства да им бъдат върнати през обществени поръчки“, няма да бъде приемана. Бившият икономически министър се зарече да не играят по този начин и да прекратят порочния модел, който винаги ражда корупция.
Асен Василев беше още по-лаконичен: „България не е бедна държава, но е безобразно крадена!“
Да се опитаме да разчетем първите послания.
Новата партия няма да има идеология
Без идеология обаче е невъзможно целеполагането, което е основна функция на всяко управление. Идеологията съдържа идеи за формата на едно управление, за неговата политика по отношение на икономиката, здравеопазването, съдебната система и пр. Като твърдят, че с десни инструменти е възможно постигането на леви цели, Петков и Василев трябва да посочат и примери – поне от тяхната кратка управленска практика, защото всеки политолог ще каже, че подобно твърдение е най-малкото нелепо.
За почтеността в политиката
Това морално качество е задължително условие за всеки, който иска да става политик, но рядко постижимо не само в българската политическа среда. И юпитата в царската партия също се завърнаха от чужбина, където имаха кариера и успешно битие извън политиката. Само че почтеността на мнозина от тях не издържа на изпитанията на времето и на съблазните на властта.
И още: ако човек поиска да влезе в новата партия (все още безименна и безформена), но има опитност в политиката, това ще бъде ли пречка за неговото членство? Защото как се създава политически проект без политически опит? Не е ли тъкмо той най-ценен в една многопартийна система, каквато е демокрацията? Или става дума просто за популистка заигравка с общественото мнение, което преобладаващо смята, че политиката е мръсна работа и че всички политици са маскари…
Очаквания и цели
Огромните очаквания към новата формация на двамата бивши министри са прибързани и може дори да доведат до неприятни изненади. Една от публичните групи във Facebook, която издига Кирил Петков за министър-председател, има вече над 110 000 членове. Ако всички те отидат до избирателните секции на 14 ноември, мястото на бъдещата партия в следващия парламент е гарантирано.
Само че заветната цел на Петков и Василев не е просто прескачането на 4-процентната бариера и създаването на малка парламентарна група с влияние, която ще седне на задните редици в Народното събрание – някои вече им предрекоха такава съдба. Тяхната цел вероятно е много по-голяма и амбициозна от това да бъдат партньор в една бъдеща управленска коалиция. Те искат партията им да се превърне в двигател на промените, за които гражданите месеци наред скандираха по улици и площади. Но за това трябва да овладеят разпиляната енергия на протестиращите през лятото на 2020 г.
Прогнози за отношенията на новата формация с партиите на статуквото и на протеста
Според вече появили се коментари новият политически проект на Петков и Василев ще води битка за лидерство в пространството на център–лявото, където се настани доста комфортно популистката партия на Слави Трифонов „Има такъв народ“. Но след провалите на шоумена и неговите сценаристи, шумните им скандали с партиите на протеста и очевидната идеологическа несъстоятелност на обявилата се за антисистемна партия ИТН, шансовете ѝ да получи първия мандат за съставяне на кабинет в следващото Народно събрание силно намаляха. Още повече в съперничеството с новата, още неродена партия, която заплашва да отнеме част от избирателите им.
ИТН реагира остро, когато служебният кабинет спря пари по обществени поръчки към фирми, свързани с ГЕРБ и ДПС, с което даде лош сигнал към симпатизантите си. Какви ще са отношенията обаче между партията на Слави Трифонов и новата формация, е твърде рано да се прогнозира.
Видимо изнервени изглеждат и от БСП. Социалистите посрещнаха враждебно още идеята за нов политически проект и заподозряха, че президентът е негов вдъхновител и идеолог. Затова поискаха Румен Радев да препотвърди своята лоялност към тях. А Георги Свиленски заканително напомни, че през годините всички опити да се правят политически проекти на гърба на партията им или покрай нея са се проваляли.
Но истината е, че БСП панически се страхува от перспективата на една модерна европейска социалдемократическа партия, която би я маргинализирала и избутала в политическата периферия. Защото и без конкуренция доскоро вляво, подкрепата за социалистите бавно се стопяваше. И причината не е в лидера, както се опитват да внушат опонентите на Корнелия Нинова, а в нежеланието на столетницата да се откаже от комунистическото си минало и наследство, в неспособността ѝ да предложи ясна и адекватна на времето програма за развитието на държавата и в шизофренното ѝ раздвоение по отношение на евро-атлантическата ориентация на страната ни.
Основания за безпокойство от проекта на Петков–Василев е логично да има и в средите на коалицията „Изправи се БГ! Ние идваме!“, на която социолозите не гарантират присъствие в следващия парламент. На предстоящите избори тя може да се яви „под вънкашност чужда и под име ново“, а някои от досегашните партньори в нея може да си опитат късмета с партии, които ще им донесат по-богата зестра – практика, позната в българската политика.
Чисто хипотетично поддръжници на „Демократична България“ може да се изкушат да гласуват за новата партия, но това е малко вероятно и е възможно да се случи с избиратели от периферията, а не от твърдото ядро на ДБ. Първо, защото става дума за хора с последователни и трайни убеждения, а в случая няма нито една сериозна причина, заради която да ги променят. Второ, те не могат да възприемат Кирил Петков и Асен Василев като ренегати, защото двамата бивши министри се самоопределят като десни хора и дават ясни знаци за възможно сътрудничество в бъдещия парламент с бившите си съмишленици.
По-скоро определени среди се опитват да вбият клин между лидерите на ДБ и на създателите на новата политическа партия. Както правеха досега с внушението, че единственият виновник за провала на усилията да се създаде кабинет в двата последни парламента, е Христо Иванов. Интересно как винаги виновниците за проваления Преход и несъстоялата се демокрация в България са все лидери на партии вдясно и в центъра – като почнем от началото на Прехода и Филип Димитров, минем през Иван Костов и стигнем днес до Христо Иванов.
От ДПС както винаги не бързат с оценки и реакции. Мустафа Карадайъ каза само, че „Движението за права и свободи не би се притеснило от каквито и да е политически проекти“, както и че плурализмът е защитен в една парламентарна република, каквато все още е България. Така на практика изрази подозрение, че президентът Радев е вдъхновител на новия политически проект, замислен с цел да се търси конституционно мнозинство за промяна на формата на управление на държавата.
Eдинствено доволни от появата на новия играч на политическия терен са май в ГЕРБ. Борисов, който не обича да тича по игрището, а само чака мързеливо да му подадат топка пред вратата на съперника, сега се чувства в удобна позиция. Партията на тандема Петков–Василев ще доведе до още по-голямо фрагментиране на новия парламент, в който не е изключено място да намери и „Възраждане“. За Борисов няма особено значение гласове от кои партии ще се прелеят към бъдещата формация, която за него също е безспорно президентска. Важното е да се консолидира вотът за ГЕРБ, а това ще се случи.
В изследване на „Галъп интернешънъл“, проведено в първите дни на септември, партията на бившия премиер е първа политическа сила, а „Има такъв народ“ се нарежда едва на четвърто място. Проучването не измерва електоралните нагласи спрямо бъдещата политическа формация на двамата служебни министри, която навярно би променила сегашната класация на агенцията. Но и без помощта на социологията е ясно, че ГЕРБ ще защитават не Борисов, а собствените си места във всички нива на централната и местната администрация от заканата да бъдат „изчегъртани“ заедно с техния лидер и неговата клика.
Влизането на новата политическа формация в предизборната надпревара за парламент ще обърка сметките на всички играчи.
Президентският вот е мажоритарен, но ще активизира и парламентарния, защото посланията на един силен кандидат за държавен глава ще донесат гласове и за партията, която го номинира. Това придава още по-голяма тежест на президентските избори, особено в ситуация като сегашната, в която доверието към партиите и парламента е толкова ниско.
Днес Румен Радев се оказва в най-силна позиция при предварително заявена подкрепа от три партии, макар че вероятно има избиратели и сред останалите. Все пак основният ресурс на бившия пилот на изтребител е в БСП. Ако Корнелия Нинова и нейните подгласници сред социалистите, водени от реваншистки настроения, решат да издигнат друг кандидат за държавен глава, те не само ще изгубят драматично президентските избори, но ще свият рязко и електоралната си подкрепа за парламентарните. А това току-виж свършило добра работа на Румен Радев, който ще се освободи от задушаващата го прегръдка на Нинова. И ще отвори път на бъдещата партия на Петков и Василев да заеме лидерската позиция в център-лявото политическо пространство. Както се казва, с един куршум – два заека!
Заглавен колаж: „Тоест“. Източник снимки: government.bg
Ние според преброяването
Post Syndicated from Светла Енчева original https://toest.bg/nie-spored-prebroyavaneto/
На 7 септември започна 18-тото поред преброяване на населението и жилищния фонд в България. Преброяванията у нас водят началото си от 1881 г. – отпреди 140 години. За новосъздадената българска държава е било от съществено значение да е наясно колко и какви хора живеят на нейната територия. През годините въпросите, включени в анкетните карти за преброяването, са се променяли в съответствие с държавните приоритети, юридическите норми, спецификата на човешките отношения и господстващите идеологии.
Какво включват въпросите в преброяването, как са структурирани те и дали изобщо да има преброяване, зависи от множество фактори. В Германия например от десетилетия преброяването не включва цялото население, а е комбинация между интегриране на данни, събирани от различни институции, и доброволна извадка от населението.
Как нашата държава (в лицето на Националния статистически институт) възприема хората, които живеят в България през 2021 г.? Каква е представата за човека и човешките отношения, въплътена в актуалната анкетна карта за преброяване на населението?
Отделният човек е не на първо, а на последно място във въпросника.
Въпреки че въпросът колко хора живеят в България е далеч по-важен от въпроса в колко сгради се разпределят те, структурата на анкетната карта се разгръща от общото към частното. Мястото на хората идва след описанието на сградите, жилищата и домакинствата. Логиката на въпросника (и съответно софтуерът на онлайн варианта му) изисква такъв подход: има сгради, в тях – жилища, в жилищата – домакинства, в домакинствата – хора.
Тази подредба може да се възприеме и като чисто формална, но е показателна за светогледа в една държава, за която е естествено в ценностно отношение да поставя човека на последно място – след институциите и формалните правила. У нас училището е по-важно от учениците, клиничните пътеки – от болните, семейството – от членовете му и т.н.
Като плюс може да се отбележи, че НСИ все пак взема под внимание в анкетата съществуването на бездомни хора. Също и на хора с увреждания – в анкетата са включени въпроси, свързани с достъпната среда до жилището.
Тъй като ни интересува как е представен човекът във въпросника, ще преминем директно към раздела „Домакинства“. В самото му начало се набива на очи инструкция към преброителите, онагледена с лазещо бебе:

Ако не беше акцентът, човек би могъл да си помисли, че смисълът на това предупреждение е да не се вписват в картата бебета, родени след 6 септември 2021 г. Ала не, идеята е просто да не се забравят децата и бебетата. Може би такава инструкция не е излишна в общество, в което децата не се смятат за „истински“ хора, следователно е логично просто да бъдат пропуснати – като несъществени подробности. Да си припомним, че кампанията, довела до отмяната на Стратегията за детето, изхождаше от предпоставката, че детето не е личност и няма права.
Най-важно е обаче в какъв ред се броят членовете на домакинството. Задължително е да се започне от неговият „глава“. Въпреки че като домакинство се дефинират хората, които живеят заедно и споделят общи разходи, независимо дали са юридическо/фактическо семейство, или не. Ако съквартиранти решат да поделят помежду си разходите си за храна и средства от първа необходимост, те пак се водят домакинство и трябва да изберат кой от тях е главата. Ако пък човек живее сам, трябва да посочи себе си като глава на едночленното си домакинство.
Без глава не може.
Кой е „главата на домакинството“? Тук от НСИ дават два възможни отговора, които не е задължително да съвпадат: това е или „лицето, което членовете на домакинството определят за такова“, или „което осигурява основните средства за съществуване“. Ако например дъщерята носи най-много пари вкъщи, това не я прави автоматично „глава“.
НСИ обаче очевидно изхожда от патриархални стереотипи, затова си представя нещата простичко и ги обяснява с картинка: ако Иван е мъжът в семейството, Мария е неговата съпруга, а Анна – общата им дъщеря, от само себе си е ясно, че Иван е главата на домакинството.

Може би официалната ни статистика наследява „главата на домакинството“ от времето, когато жените в България не са имали право да гласуват. Метафората за главата всъщност идва от Библията. В Посланията си към коринтяните и ефесяните апостол Павел скицира своеобразна йерархия на главите – мъжът е главата на жената, Христос е главата на мъжа, Бог-Отец е главата на Христос. Жената не само не е глава на никого, а трябва да покрива (поне с косата си) и собствената си глава.
В съвременното българско право няма антропоморфни метафори като глави, вратове и други телесни части – нито на домакинствата, нито на семействата, нито на жените. Нещо повече – според Конституцията „съпрузите имат равни права и задължения в брака и семейството“ (чл. 46, ал. 2). Така че докато Конституционният съд търси аргументи да отговори на въпроса дали само биологичният пол е конституционен, много по-лесно е да се докаже, че
изискването на НСИ за глава на домакинството е противоконституционно.
Ако сте сключили в чужбина брак с лице от същия пол, не може да отбележите това в анкетната карта. Преброяващите се електронно виждат съобщение, че в България бракът е само между мъж и жена. Възможно е обаче да впишете еднополово партньорство, ако живеете с партньора си. Тъй като това е засега единственият начин поне част от ЛГБТИ хората у нас официално да се заявят като такива, Фондация GLAS разработи сайт и засне клип, посредством които да убеждава съжителстващите с хора от същия пол да посочат връзките си.
Когато стигаме до описанието на конкретните лица в раздела „Население“ обаче, става ясно, че хората са или мъже, или жени. Не се допуска дори възможността да се затрудняват да отговорят. Ако се преброявате електронно и вече сте посочили ЕГН-то си, не може да се впишете с пол, различен от този по документи – системата отправя предупреждение, че полът не отговаря на ЕГН-то ви.
Семейното положение според анкетната карта бива юридическо и фактическо. И докато юридическото е ясно, фактическото буди въпроси. Възможните варианти са: да не сте в брак или в съжителство, да сте в брак или да сте в съжителство без брак. Няма опция обаче да сте във връзка с човек, с когото не съжителствате.

Бракът си е брак обаче, независимо дали брачният ви партньор примерно работи в чужбина, или пък сте фактически разделени. Така че целта на описването на „фактическото семейно положение“ остава неясна. Ако става дума за съжителство, то вече е описано в частта за домакинството. Но ако от НСИ се опитват да установят действителния статус на обвързаност на преброяваните, предложените алтернативи са крайно недостатъчни.
Патриархалните стереотипи на авторите на анкетната карта проличават и в това, че
въпросът „Имате ли живородени и/или осиновени деца?“ се задава само на жени.
Вероятно целта на този въпрос е да се проследи най-вече раждаемостта на жените. Но дори не се допуска възможността (която поне на теория в България съществува, макар на практика рядко да се допуска) мъж да осинови дете или сам да отглежда осиновено дете. (Възможността трансмъж да роди е твърде екзотична идея за нашите ширини, която едва ли би хрумнала на екипа на НСИ, работил по анкетната карта.) Другият любопитен детайл в този въпрос е, че той се отнася само за жени на 12 и повече години. Ако момиче под 12 години има живородено дете, защо статистиката да не отчете този факт?
Въпросите, свързани с етническата принадлежност и майчиния език, допускат само един вариант за отговор. От какъв етнос са децата, чиито родители имат различна етническа принадлежност? В анкетната карта се уточнява: „Етническата група е общност от лица, близки по произход, бит, култура и език.“ Това обаче не ти помага да определиш етноса си, ако си примерно с баща етнически българин и майка нигерийка. Същият е проблемът с майчиния език. В България има не само деца от етнически смесени връзки, но и деца от традиционни за страната ни етнически общности, които проговарят едновременно и български, и езика на другата етническа група.

Във вариантите за отговор на въпросите за етноса и майчиния език, както и в тези за религията, се забелязва една на пръв поглед козметична, но всъщност много съществена промяна – опцията „не се самоопределям“ е заменена с „не мога да определя“.
Възможно е човек да не се самоопредели не защото не може, а защото не иска. Който например е агностик, съзнателно не определя дали е религиозен, или не. Ала според логиката на въпросника самоопределението очевидно не съществува – има еднозначни обективни факти за всеки човек, които той може или не може да определи.
На въпроса за грамотността дори няма вариант „не мога да определя“, макар че в конкретния случай не би било излишно. В хартиената карта не се дава дефиниция за грамотност, но онлайн анкетата обяснява пространно:
Грамотен е всеки, който може да пише, да чете текст и да извършва прости аритметически операции – събиране, изваждане, умножение и деление.
За неграмотно се счита лице, което не може да чете и да разбира смисъла на написаното и не може да напише кратко изложение на ежедневните си дейности. Лице, което умее да чете и пише само цифри и собственото си име, трябва да се счита за неграмотно. Също така неграмотно е лице, което умее да чете, но не може да пише, и лице, което умее да прочете и напише само няколко заучени фрази.
При такава формулировка някои преброявани биха се запитали дали самите те са грамотни, ако не схващат изцяло смисъла на разяснението на този въпрос или ако не могат да разделят наум 23569 на 27. Отделен въпрос е, че така и хората с дислексия се приравняват с неграмотните.
Начинът, по който се установява миграционното поведение на преброяваните, също не е безвъпросен.
Според анкетната карта временно присъстващи лица са тези, които пребивават в жилището, където са преброени, по-малко от една година. С такъв изследователски инструментариум няма как да се „уловят“ хората, завърнали се в България, докато трае пандемията, защото са имали възможност да работят онлайн. За много от тях това е продължило повече от година, което не означава, че няма да се върнат в момента, в който от тях се поиска да упражняват професията си присъствено. Не могат да се „уловят“ и онези, които са се прибрали за постоянно, но преди по-малко от година. Също и работещите и учещите в България за няколко години, след което ще се върнат в родната си страна (същото важи и за българи в чужбина).
През септември и в началото на октомври, когато се провежда преброяването, много сезонни работници не са се прибрали и съответно няма да могат да бъдат преброени. Както и хора, които са извън страната поради командировка, гостуване и т.н. Те не могат да се преброят и електронно, защото това е възможно само от България. Затруднение представлява и кодът от електронното преброяване, който физически трябва да се предаде на преброителите – още едно „чудо“ на електронното ни управление.
Да обобщим.
Според въпросника за преброяването през 2021 г. човек е или мъж, или жена дори ако е интерсекс, тоест ако биологичният му пол не може да се определи еднозначно. Мъжът е главата на домакинството, но пък децата са си на жената. Мъжете не осиновяват, а момичетата под 12-годишна възраст не могат да раждат. Детето е нещо, което е лесно да бъде пропуснато в качеството му на част от населението. Не съществуват хора със смесена етническа принадлежност, нито билингви (хора с два първи езика). Самоопределение не съществува – ако не се определяте еднозначно, значи не сте способни да схванете обективната истина за себе си. Ако по-малко от една година живеете някъде, значи сте „временно присъстващи“, а ако периодът е повече от година, сте за постоянно.
Некоректно формулираните въпроси и варианти за отговор неизбежно ще доведат до неточни резултати. И след преброяването пак няма да сме наясно от колко и какви хора се състои населението на България. По-сериозният проблем е, че на базата на тези резултати ще се правят анализи, ще се изработват политики и ще се вземат решения, от които ще има практически последствия. А накрая ще се чудим откъде ни е дошло.
Криворазбраната демокрация
Post Syndicated from Йоанна Елми original https://toest.bg/krivorazbranata-demokratisiya/
Марийка: Но тази днес цивилизация аз май… не разбирам накъде стои.
Димитраки (като я тупка по рамото): Не бой са, аз ще ти дам да я разбереш, стига да вярваш на мене като на твой брат… да, като на твой брат; защото аз та обичам като сестра и искам да та запозная с цивилизацията.
Марийка: Благодаря, но мене ма някак страх от тази цивилизация.
Из „Криворазбраната цивилизация“ от Добри Войников
Хагската конвенция. Хартата за основните права. Конвенцията за защита на правата на човека. Дискриминация, равенство, свобода. Това са само част от понятията, които се използват в дискусиите за ваксинирането срещу COVID-19 като начин да се овладее една вече предотвратима здравна криза и да се върнем към сравнително нормален живот. В по-прозаичен вариант може да ги срещнем като „всеки сам си преценя(ва)“ и „всеки има право на мнение“. Това означава, разбира се, че всеки сам упражнява свободата си, независимо от последствията за останалите. В крайна сметка обаче нито той е свободен, нито останалите. Как е възможно? Демокрация, отговарят отсреща.
Знаем ли какво всъщност е демокрация?
Направете си експеримент: затворете очи (не сега, след края на изречението) и помислете дали можете да разкажете историята на демокрацията кратичко и да обясните защо организираме обществата си именно така – с разделение на властите, свободни медии, разделение между църквата и държавата и т.н. Думичката „демокрация“ и идеалите, свързани с нея – свобода, равенство и пр., са като всички други ежедневни неща, с които сме свикнали: говорим за тях, познаваме ги, но много рядко можем да отговорим защо са такива, каквито са, и как всъщност работят.
Вероятно сте се сетили за Древна Гърция. Макар да я наричаме „люлката на демокрацията“, страните, които днес се определят като демократични, имат малко общо с древногръцката идея. В древната форма на демокрацията много малка част от населението изобщо е имала право на глас (основно богати мъже), робството се е смятало за напълно естествена практика, а всички налични исторически източници сочат, че е било доста трудно всеки гражданин сам да си преценява, без да го грози прокуждане или поставяне на репички в ануса, каквото например е било наказанието за изневяра или промискуитет (по Аристофан).
Съвременната демокрация дължи произхода си на комбинация от (скучни) фактори в контекста на Западна Европа и Северна Америка: обособяването на европейските монархии и обществото от хватката на Църквата, борбите за религиозна свобода, упадъка на европейските империи, философските идеи на Просвещението и процъфтяването на икономиката вследствие на колонизацията. След като новата търговска класа се превръща в основен двигател на икономическия прогрес за сметка на короната и аристокрацията, пред гражданите стои въпросът как по-добре да управляват обществото си в новата реалност. Идеите на четирима ключови философи – Лок, Русо, Хобс и Монтескьо, са в основата на съвременната демокрация.
В своя „Първи трактат“ от 1689 г. английският философ Джон Лок пише, че в абсолютната си свобода, дадена по природа, човекът има право да се разпорежда със себе си и вещите си така, както прецени, без да иска разрешение и да зависи от волята на друг. Това звучи чудесно и съвсем по вкуса на възмутените граждани, които споменахме по-горе.
Но възможно ли е хората да съществуват в състояние на абсолютна свобода, без интересите им постоянно да влизат в конфликт с интересите на другите?
Според философите на ранната демокрация (и всеки, който се е редил на опашка в супермаркет или е пътувал в градския транспорт в час пик) това е невъзможно. Именно поради тази причина, казва Лок, хората дават съгласието си да се лишат от нея в името на едно мирно общество. Плюсовете са много – общността предлага не само компания и обмен на ресурси, но и ред и защита. Също така се живее по-приятно, когато си спокоен, че никой няма да те убие или да ти вземе къщата просто защото има абсолютната свобода и желание да го направи.
В този ред на мисли философът Томас Хобс е доста по-мрачен относно човешката природа. За него естественото състояние на човека е да бъде във война с всеки и да се ръководи от собствения си разум. В състояние на абсолютна свобода имаме права над каквото си пожелаем – включително над тялото на друг. Тоест ако всеки има право на всичко, никой не може да има сигурност (независимо колко е мъдър или силен). Поради това човекът търси съюзници и мирно съществуване със споделени ресурси в общество.
От всичко дотук следва, че демокрацията като форма на организация на обществото означава не пълна свобода, а компромис между хората. Това е и т.нар. обществен договор, залегнал в основата на модерната демокрация.
За човека и правата интимно
Демокрацията почива именно на съгласието на гражданите да бъдат водени от общи правила, определяни и налагани от държавата. Томас Хобс използва метафората на митичното чудовище Левиатан и върху корицата на книгата му със същото име суверенът се извисява като великан, съставен от множеството свои поданици. Да, макар думичката „суверен“ да е позната на българския читател и гражданин в друг смисъл, всъщност това означава избраният лидер, на когото е делегирана властта да управлява във и от името на обществото.

Всички тези идеи невероятно се харесват на някои французи и най-вече на новоизлюпената френска буржоазия, която пък, за разлика от английската, не успява хитро да се разбере с краля, благородниците и църквата кой всъщност трябва да управлява и мирно и тихо да си поделят богатствата. На фона на блясъка на Версай повечето хора са недоволни от високите данъци, лошата реколта, продължителните войни, глада и епидемиите, което спомага за разпространението на новите идеи сред населението. Останалото е история.
Разбира се, с края на монархията и установяването на демокрацията нищо не се променя кой знае колко – суверенът отново е богат възрастен мъж, просто не е със синя кръв или посочен от Бога. Съвременната демокрация е плод на десетилетни битки (понякога кървави) за придобиване на множество права, които днес приемаме за даденост. Добавяме това, че държавите съседки на Франция изобщо не приемат тези промени добре и им отнема около стотина години и много войни след Революцията, за да посвикнат.
Междувременно в бъдещите САЩ (както винаги) текат пререкания за пари. Американските поданици дотолкова не харесват английския крал, че обявяват независимост от Английската империя през 1776 г. и с Устава на конфедерацията създават държава, която се сгромолясва незабавно, тъй като централизираната власт е плачевно слаба и не може дори да събира данъци. Така дори най-свободните хора на света (по техни думи) разбират, че ефективната централна власт е необходима, когато човек иска да има функциониращо общество. Затова решават да организират Конституционния конвент, който уж трябва да попромени ужасния Устав на конфедерацията, но всъщност решава, че просто няма смисъл, и написва нова конституция, чиито знакови първи думи днес се печатат върху тениски, анцузи и калъфи за телефони в най-различни азиатски страни.
Основното притеснение на американските бащи на нацията е, че силна централизирана власт ще доведе до авторитарна власт. И поради това малко след Конституцията се появяват и конституционните поправки. Простичко казано, ако Конституцията урежда правата на държавата, то поправките уреждат правата на гражданина. Иронично, поправките са базирани на британския Закон за правата. Така се постига баланс между държава и граждани, който гарантира известна свобода и на двете страни. Този баланс е под постоянно напрежение и подлежи на промяна – особено в наши дни, когато свободният американски гражданин живее в държава, в която има повече пушки, отколкото хора.
Не всички права са равни
Към днешна дата повечето държави разполагат с конституция и някакъв вид официално уреждане на граждански права по подобие на гореописаните исторически документи. Какво се случва обаче, ако едно гарантирано право противоречи на друго? Пример за такъв случай е решението на Върховния съд на САЩ от 1905 г., в което се отсъжда, че ограничаването на работния ден до 10 часа дневно и 60 часа седмично противоречи на правото за свободно сключване на договори. Макар това решение да е отхвърлено отдавна, конкретното право се използва и в наши дни като аргумент срещу законодателни мерки, които определят минимална работна заплата или целят да предотвратят монополите и концентрацията на капитали.
Ограничаването на правото на личен живот е мислимо, възможно, но при спазването на определени критерии. Тези ограничения трябва да са законоустановени, пропорционални и да преследват легитимна цел.
Това заяви неотдавна специалистката по медицинско право д-р Мария Шаркова пред „Капитал“. Правата ни не съществуват като абсолютна стойност или във вакуум, а в процес на постоянно взаимодействие не само едно с друго, а и със задълженията ни. Те не бива да се ограничават с лека ръка, но и не може да се използват за налагане над другия в негов ущърб.
Просвещението, в което се корени демокрацията, съдържа и друг ключов принцип – съществуване според разума и логиката, отвъд човешката емоционална първосигналност. Или преход от вендетата към справедливия процес, от вярата в магии към емпирично обясняване на природните процеси.
Демокрацията, с две думи, произлиза от усилията ни през последните двеста и нещо години да живеем в мир, ред и сговор, чрез логика отвъд емоциите. През това време понякога сме се справяли добре, а понякога – не чак толкова. Най-големите си колективни провали сме преживявали, когато сме забравяли, че демокрацията е изкуството да постигнеш свобода, спазвайки задълженията си към другите. Че Левиатанът на демокрацията всъщност е съставен от всеки от нас и от разбирането ни за правилата, които споделяме.
От едно общество зависи дали и в кой момент ще постави правото на живот над правото на собственост, или правото на сдружаване над правото на свобода от дискриминация. Дали ще се води от факти, или от емоции. Как ще се проведе този разговор, е въпрос на колективно възпитание. Но когато колективното възпитание и други неща – като образование и здрава информационна среда – липсват, всеки сам ще си преценява. За сметка на всички, включително на себе си.
Заглавна снимка: „Криворазбраната цивилизация“, постановка на Станчо Станчев в Драматичния театър „Васил Друмев“ в Шумен през 1958–1959 г. Източник: Архивите на режисьора Станчо Станчев
Театър „София“ и битката за ново архитектурно наследство
Post Syndicated from Анета Василева original https://toest.bg/teatur-sofia-i-bitkata-za-novo-arhitekturno-nasledstvo/
На 9 септември 2021 г. неправителствената организация „Спаси София“, активни критици на Йорданка Фандъкова, алармираха, че Столичната община възнамерява „да съсипе“ емблематичния театър „София“ в парка „Заимов“ за 10 млн. лв., като замени варовика от фасадата с пресован ламинат (HPL). Сигналът беше илюстриран със сочен колаж, който показваше характерната фасада на театъра, облепена с вестници, на фона на фойерверки и една усмихната Фандъкова под ръка със заместник-кмета по културата Мирослав Боршош.
Постът бързо стана вайръл, беше препубликуван стотици пъти както в социалните мрежи, така и в стандартни медии. Ден по-късно Столичната община опроверга информацията и обясни, че всички детайли и елементи по фасадата на театъра ще бъдат запазени, а „орнаментите и барелефите ще бъдат основно почистени, не заменени“.
Медийната престрелка се ожесточи. На 13 септември „Спаси София“ обори Столичната община с извадка от идеен архитектурен проект, при която чрез цветна легенда на материалите е показано как сериозна част от настоящата каменна облицовка на театъра действително се заменя с HPL. В обясненията се включиха и националните медии. Разбра се, че въпреки запазването на фасадните орнаменти се налага сградата да бъде цялостно топлоизолирана, а това ще стане след сваляне на лепения камък и връщането му обратно (с неясен детайл).
Гражданското общество, поне в един определен балон, избухна възмутено.
Казусът
Всъщност идеята за ремонт на театъра е отдавнашна. Още през 2019 г. Столичната община обяви намеренията си за цялостна реконструкция на сградата, илюстрирани със същия този проект с HPL фасадите, предвиждащ енергоспестяващи мерки и цялостно преустройство. Оказа се, че проектът е от 2015 г., изменян и допълван през 2019 и 2020 г. В началото на юни 2021 г. Комисията по образование и култура към СОС одобри финансиране на ремонта с дългосрочен заем от Фонда за градско развитие.
В понеделник пък (20 септември) изтича срокът на обявената на 23 август обществена поръчка за основен ремонт/реконструкция на театър „София“. Вероятно именно този срок е предизвикал реакцията на „Спаси София“, която извади темата от незабележими съобщения в по-специализирани медии и я направи достояние на шумното публично пространство.
Реакцията е логична. И макар и закъсняла, не е редно да заглъхва. Театър „София“ е истински забележителна сграда и въпросът не е само във фасадата.
Първо, интересна е историята
Театър „София“ е най-старият и най-голям общински театър в столицата. Проектът е резултат от конкурс, спечелен през 1969 г. от архитект Жеко Жеков. Строителството продължава до 1977 г., когато театърът е официално открит като нова сграда на бившия „Театър на поезията и естрадата“ в София.


Важно е да се подчертае, че нуждата от подобна сграда и от такъв театър биха били немислими преди Априлското размразяване (1956) и са част от културната ситуация през 60-те години на ХХ в. у нас. Тогава се създава мрежа от нови театри в София, алтернативни на официалната сцена на Народния театър „Иван Вазов“ – Сатиричният театър (1957), Театър „199“ (1965), Театър „Сълза и смях“ (1967) и др. В тези театрални пространства става възможно да се експериментира с нови театрални форми и актьорски техники.
Именно част от тази алтернативна мрежа е и общинският „Театър на поезията и естрадата“, създаден през 1965 г. и преименуван на Театър „София“ през 1969 г. Трупата е с пръв художествен ръководител Андрей Чапразов и режисьор Леон Даниел и започва да прави експериментални спектакли, в които актьорите рецитират, танцуват, пеят рок песни. Съответно новата сграда на театър „София“ е проектирана да отговори на търсенията на времето си.


Много важна в общата композиция е ролята на главната зала за 520 места и нейната сцена. Залата е решена с малка дълбочина и по-голяма широчина с оглед на изискванията и спецификата на алтернативните театрални форми. При покриване на оркестрината актьорите могат да осъществяват близък контакт с публиката на широк фронт. Самата сцена е много дълбока и висока, със сложна механизация и възможност да се трансформира в рампа.
Архитектурният образ също е ключова част от експеримента.
Театър „София“ е сложна асиметрична композиция, сглобена от различни по мащаб ортогонални каменни обеми. Да се оприличава просто на „средновековна крепост“ е твърде елементарно.
Сградата само привидно е разположена в надлъжната ос на симетрия на парка „Заимов“. Обемно тя деконструира и нарушава оста, създавайки поредица от разнообразни модули, обеми, както и протичащи, преливащи се публични пространства – фоайета, вътрешен двор, коридори, които дават възможност за движение в непрекъсната връзка с околната паркова среда.


Сложната обемна структура на театър „София“ е обединена екстериорно от използването на един материал – варовикови каменни облицовки плюс последователно приложена система от декоративни релефни пластики с разнообразна форма, сюжети и фактура. Автори на пластиките са Благой Илиев, Емилия Николова-Байер и Аглика Илиева. С тази скулптурна намеса са решени както високите тела на театралната сграда, така и ниски стени, маркиращи входове, промяна на формата или преливане на пространствата.
В резултат сградата стои забележително добре в парковата среда. Голяма е, но не дразни. Замислена е да се обикаля и възприема от всички страни – подобно на кой да е монумент в градското пространство. Така със своите драматични обеми, с визуално обединяващата роля на светлата каменна облицовка, както и с фасадните пластики, театър „София“ въздейства по-скоро като монументално изкуство в публичната среда, отколкото като външно привнесено и чуждо архитектурно тяло.
С две думи: това е сграда, която има отчетлива архитектурна ценност и със сигурност не е редно да бъде подлагана просто на „ремонт“. Такава сграда трябва да бъде внимателно анализирана и осмислена и чак след това – променяна. С предлагания в момента ремонт именно нейната комплексна архитектурна ценност е застрашена от заличаване.
Ето защо обществените реакции са важни.
Галерията в Търново, площадът в Карлово, летището в Русе
Обществото впрочем се скъсва да реагира при куп подобни случаи. Ето няколко само от последната една година – все на сгради и ансамбли, строени след 1944 г., които нямат официално статут като културно наследство.
През декември 2020 г. ремонтът на Художествената галерия „Борис Денев“ във Велико Търново възмути хората, когато осъзнаха, че оригиналната дървена дограма на сградата се сменя с бяло PVC по проект за енергийна ефективност. Сградата е една от важните реконструкции на късния соц, правена от архитект Никола Николов и открита в средата на 80-те години. Направиха се петиция и обществени дискусии, местната власт влезе в обяснения, но в крайна сметка ремонтът беше успешно приключен в началото на септември т.г. Дограмата, разбира се, беше сменена, но поне камъкът по фасадата на търновската галерия остана (в интерес на истината, ремонтът тук изобщо не предвиждаше поставяне на външна топлоизолация – за разлика от проекта за театър „София“).
В средата на юли 2021 г. граждани в Карлово протестираха срещу планираната реконструкция на централния площад „20 юли“, открит в края на 80-те години на ХХ век. Те оспорваха събарянето на сцената, както и подмяната на оригиналната каменна настилка с бетонна.
От януари 2021 г. архитекти и експертни организации, като „ДОКОМОМО България“ (част от международната организация за документиране и опазване на архитектурата на модерното движение), се опитват да спасят приемната сграда на летището в с. Щръклево до Русе от събаряне или пагубен ремонт. Сградата е ярък пример за български следвоенен модернизъм, дело на местния архитект Йордан Бояджиев.


Още примери от Видин, Кюстендил и Варна
Какво може да се направи и как, ако винаги вече е късно и винаги има задействана някоя обществена поръчка за инженеринг, финансирана по европейска програма и защитена от куп процедури? Посоката, разбира се, е една.
Ново архитектурно наследство
Театър „София“ е един от 20-те финални обекта в проекта „Ново архитектурно наследство“, чието начало беше поставено от общинското предприятие „Софияплан“ през 2020 г. в партньорство с Центъра за научни изследвания и проектиране към УАСГ и „ИКОМОС България“. Проектът цели да открои ценни образци на българската архитектура, построени в София след Втората световна война и притежаващи потенциал за културно наследство.
Първоначалният дълъг списък с потенциални „кандидати“ за статут надвишаваше 120 обекта, които след прилагане на система от критерии за селекция бяха редуцирани до 20. Театър „София“ е класиран на челното трето място, веднага след резиденция „Бояна“ и хотел „Витоша“ („Ню Отани“, впоследствие „Кемпински“ и „Маринела“). Именно тези 20 обекта са предложени за конкретна защита като културни ценности по смисъла на Закона за културното наследство.
Дали статутът за културно наследство ще спаси тези сгради – тепърва предстои да видим. Но това е най-големият масив от фишове за защита на образци от най-новата ни архитектурна история, внасян някога в Националния институт за недвижимо културно наследство (НИНКН).


Трябва да се има предвид едно. Периодът на централизирано строителство променя драстично голяма част от българската обитаема среда. Така именно архитектурата от периода на социализма формира облика на повечето публични пространства в България и произвежда сериозна част от застроената среда и до днес. Всички тези музеи, галерии, административни сгради, училища и детски градини, хотели и площади, театри и библиотеки са част от ежедневието ни, постоянно обитавани и
някак си все още далеч от патината на „истинското“ наследство –
като античните мозайки, средновековните крепости и възрожденските къщи например. Ето защо, бидейки „по-нови“, те не се възприемат като потенциално ценни и затова лесно и напоследък твърде често са застрашени от необратими реконструкции. През последните години, с усилията за масово усвояване на евросредства и принципно резонния устрем към енергоефективни решения и достъпна среда, те са подложени на безжалостни ремонти, които унищожават естествени материали, модернистични пространства, ценни детайли и ги унифицират с един и същ набор от евтини системни ремонтни решения.
За финал
„Новият европейски Баухаус“ е набираща популярност инициатива на Европейския съюз, която цели да предложи модел на устойчиво архитектурно бъдеще, съчетаващо иновативност, отговорност към околната среда, социална ангажираност и локално занаятчийство. Какво общо има тази лъскава и все още неясна европейска инициатива със столичния театър „София?
Проблемът на всички гореспоменати сгради и пространства, в т.ч. и на театър „София“, е, че не притежават този официален статут на културно наследство, който да върви заедно с анализ на ценността, предписания и режими за опазване, ограничаващи неадекватни съвременни намеси. Във времена на климатични промени и нови приоритети нормално е архитектурата да се промени. Неуместни стават огромните сгради с бетонни конструкции и чутовен въглероден отпечатък. Но също толкова неуместно става и събарянето им.
Бъдещето на архитектурата е в реконструкциите и преизползването. И всички трябва да сме наясно, че, да, за съжаление, повече няма да можем да правим сгради от видим бетон, сгради с огромни, трудни за отопляване вътрешни пространства или сгради – „пространствени експерименти“, които не отговарят на нито един от съвременните стандарти за енергоефективност. Затова толкова по-важно е да пазим, докато е време, онези, които вече са построени и си струват. Те са част от една друга цивилизация.
А за здания като театър „София“ трябва да се правят проекти за консервация и реставрация. Не за ремонт.
Забележка: Авторката е ангажирана от години в изучаването и опазването на българската архитектура след Втората световна война, съответно е пределно наясно със своята пристрастност. Тя е част от екипа на проекта „Ново архитектурно наследство“, член и секретар е на „ДОКОМОМО България“ и преподава история на българската следвоенна архитектура в УАСГ. В този текст са използвани данни от предварителната оценка за предоставяне на статут на недвижима културна ценност за обект театър „София“, с автори Анета Василева, Емилия Кълева, Виктория Димитрова и Ива Хасъмска, изготвен в рамките на проекта „Ново архитектурно наследство“.
Заглавна снимка: © Арх. Виктория Димитрова
На второ четене: „Бивалици“ и „Небивалици“
Post Syndicated from Стефан Иванов original https://toest.bg/na-vtoro-chetene-bivalitsi-i-nebivalitsi/
Никой от нас не чете единствено най-новите книги. Тогава защо само за тях се пише? „На второ четене“ е рубрика, в която отваряме списъците с книги, публикувани преди поне година, четем ги и препоръчваме любимите си от тях. Рубриката е част от партньорската програма Читателски клуб „Тоест“. Изборът на заглавия обаче е единствено на авторите – Стефан Иванов и Севда Семер, които биха ви препоръчали тези книги и ако имаше как веднъж на две седмици да се разходите с тях в книжарницата.
„Бивалици“ и „Небивалици“ от Вера Мутафчиева
„Избрани произведения“, том 11 и 12, изд. „Жанет 45“, 2009
 Сигурен съм, че Вера Мутафчиева не се нуждае от представяне, но мемоарите ѝ заслужават да бъдат четени и препрочитани. Попаднах на тях едновременно случайно и закономерно. Благодарен съм за това си откритие от изложбата за Борис и Славка Деневи на Свобода Цекова и Антон Стайков. Там имаше цитат от „Бивалици“ за Славка Денева, с която Вера Мутафчиева е била близка.
Безспорно това е най-важната ми читателска среща тази година. Подобно откровено и спонтанно възхищение изпитвам към Константин Павлов, Георги Рупчев и Димитър Воев. Намерих това, което съм търсил и откривал в толкова много чужди автори и литература – честност, интересен език, дълбочина, непосредственост, хубави истории и изчерпателност. А да открия нещо, към което да почувствам безрезервна и безусловна симпатия и любов, ми се е случвало няма и пет пъти…
Шок е за мен наличието на тези мемоари. Впечатляваща е смелостта, с която Мутафчиева обяснява себе си. Чел съм множество дневници и автобиографии на писатели от това време и случаят с тях не е такъв. Не мога да скрия, че от месеци наред препоръчвам тези два тома на всеки, когото срещам на живо или онлайн.
В писането на Вера Мутафчиева има мащаб, детайли и най-вече всекидневие. Не е метафорично, абстрактно и мътно, а конкретно. Централно е това, което принципно остава заметено или премълчано – българската помийна яма от тайни и травми. Тук тя е извадена на преден план и на показ – в цялата си сложност и противоречивост. В цялата си нищета и мизерия – материална, морална и духовна. В цялата си красота на съпротива чрез работа и устойчивост.
 Близо хиляда страници с болезнени прозрения. Ако някой иска да разбере какво е било тогава и защо е такова днес – нека ги прочете. Майсторски и човешки книги от историк и писател. От всички десетки хиляди мемоарни, лични и интимни страници за паметта и живота, които съм прелиствал, тези са сред най-ценните. В личната си библиотека ги поставям редом до Кнаусгор и Пруст.
„Бивалици“ ме отвя още от началото. С безкомпромисност към себе си и към епохата. С толкова хубавия и сочен език – и хумор. Хабер си нямах, че това ще ми се случи. След целия потоп от литература, която няма общо с реалността, камо ли с българската, камо ли с преживяваната от живи хора, освен номинално – това беше експлозия. Тежък естетически и социален симптом е, когато литературата и писателите са разкачени от реалност, правдоподобност и честност. А те, донякъде поне, са базата, фундаментът и предпоставките за изкуство. Все по-масово обаче те отсъстват от книгите. Но в мемоарите на Вера Мутафчиева – с лопата да ги ринеш.
Спомените ѝ са изповедно честни. Те покриват времето от запознанството на родителите ѝ до деня, в който Мутафчиева пише последните страници. В тях са силата на духа ѝ; ужасът от януарските бомби от Втората световна война; бедното ѝ детство; професорското ѝ семейство; собствените ѝ бракове, раждането на децата ѝ; личните и работните ѝ малки и големи трагедии, болести, посрещани с ирония; признанието, че винаги е била невътрешен човек и „царица на автогола“; борбата до края със системата и с безкрайната злонамереност, посредственост и наглост.
На всеки, за когото фактът, че Вера Мутафчиева е вербувана от Държавна сигурност, би представлявал проблем да прочете книгите или да се съмнява в качествата им, бих казал, че именно заради това не ги четох толкова години. Прочитът ми беше и през призмата на този биографичен факт – книгите отговарят и на тези въпроси. Ужасно съжалих, че не съм ги чел по-рано. Най-малкото защото това писане слага в малкия си джоб цялата съвременна българска литература.
Рядко използвам суперлативи, по-скоро никога, но защо точно в този случай? Защото показва как се е живяло преди и след 9 септември и преди и след 10 ноември в света на университета и на академичния, литературния и филмовия елит. Разказва какви са били структурите и безумието на тези осакатяващо лоши среди. И защо са такива и днес.
Едва като прочетох томовете на Мутафчиева, се потвърдиха почти всичките ми интуиции за тези елити. Споделях с Марин Бодаков как ми влияят те и че се усещам още по-категорично на страната на бачкаторите в културата, към които се числя и за които говори и Мутафчиева. Марин ми каза: „Прав си. Там ни е мястото. И Радичков беше там.“ Тогава осъзнах и че нямаме интелектуалци с аршина на Вера Мутафчиева.
Попитах Марин защо никой не е писал за тези книги, освен Ани Илков, който прочете на представянето им кратък текст, публикуван след това във вестник „Култура“. Отговори ми лаконично: „Аз ще ги препрочета. Тогава четях ръкописа ѝ. И да, тя е световна писателка. Тя, Радичков, Коста [Павлов]… Несвойствени за нашите места. Тя беше удрян човек и здрав човек. Обясняваше ми, че само работата я спасява. Тя беше много умна жена. И нещастна.“
Преди време, на представянето на „История на българското изобразително изкуство“ на Кирил Кръстев, Иво Милев сподели, че у нас елитът се подменя на 30–40 години, но общото между всички е отказът от обобщения и от поемане на отговорност. Вера Мутафчиева разказва като писател, обобщава като историк и поема отговорност.
През тази седмица беше 15 септември и още по-силно усетих мисията в сърцевината на „Бивалици“. Чисто учителска, даже по-скоро даскалска. Да разкаже неразказана история, да държи за ръката и да казва: „Няма страшно, колкото можеш…“ и така неусетно да тръгнеш по своя път. Поне за мен тези книги учат на самообладание, вдъхват кураж и даряват много познание. На всеки, който вече ги е прочел, бих препоръчал „Доколкото си спомням“ на Георги Данаилов, „Дървото на живота“ на Станка Пенчева, „Ние – негероите“ на Рада Москова и „Мир на страха ни“ на Георги Мишев, за да може да види приликите и разликите.
Към края си пестях страниците. Не исках да свършват. Ако някой се чуди защо в този текст няма цитати от книгите, отговарям: когато чета на хартия, си прегъвам страниците, където има нещо изключително, някакъв ценен къс от думи и фрази; в този случай прегънах почти изцяло и двата тома. Трудно ми е да цитирам, защото спокойно бих преписал целите книги.
Заглавна илюстрация: © Елена и Лина Кривошиеви
Активните дарители на „Тоест“ получават постоянна отстъпка в размер на 20% от коричната цена на всички заглавия от каталога на ИК „Жанет 45“, както и на няколко други български издателства в рамките на партньорската програма Читателски клуб „Тоест“. За повече информация прочетете на toest.bg/club.
Седмицата в „Тоест“ (13–17 септември)
Post Syndicated from Тоест original https://toest.bg/editorial-13-17-september-2021/

И 46-тото Народно събрание е вече история. На 14 ноември за трети път през тази година ще гласуваме за нов парламент, като този път ще избираме и президент. Формално имаме и второ служебно правителство, но в действителност съставът му е почти същият. Голямата разлика според Емилия Милчева е, че с настъпването на есента и зимата нагласите и очакванията към кабинета ще са вече доста различни. Прочетете повече в анализа ѝ „Свърши вече хубавото време на служебната власт“.

Другата забележима разлика е отсъствието на служебните министри Кирил Петков и Асен Василев от новия състав на правителството, които потвърдиха намеренията си да се явят на изборите през ноември, оглавявайки нов политически проект. Венелина Попова е по-скоро скептична за евентуалното благоприятно въздействие на поредната нова партия върху политическия живот у нас. Това личи и от заглавието на тазседмичния ѝ коментар „Поредните спасители“.

След шумно скърцане и друсане дигиталната каручка на „Преброяване 2021“ успя да се придвижи донякъде по трасето на очакванията. За всеки случай срокът на онлайн процедурата беше удължен до края на септември. Светла Енчева обаче се вглежда в някои детайли от въпросника, които предпоставят неточни финални резултати. А те водят до практически последствия за поне десетилетие напред. Прочетете статията ѝ „Ние според преброяването“.

Знаем ли какво всъщност е демокрация? И осъзнаваме ли, че т.нар. обществен договор е баланс от компромиси между хората и техните права и задължения спрямо останалите. Това е темата на статията на Йоанна Елми „Криворазбраната демокрация“, която ще ни разходи от Древна Гърция до модерна Европа и Северна Америка и от философските идеи на Просвещението до крайъгълните документи, които формират съвременната рамка на човешките права.

 „Създатели и мечтатели“ е заглавието на нова поредица, която ще бъде част от подкаста ни „Мястото“ на Николета Атанасова. В нея Николета и нейните събеседници ще разказват за хора, за които се знае малко, но са важни с началото, което са поставили в науката и знанието в България и по света. Първият епизод, озаглавен „Да бръкнеш в Земята“, е за първия български геолог проф. Георги Златарски.
Посвещаваме тази подкаст поредица на Марин Бодаков. Епизодите в нея не са за литература или поезия, но символично ги докосват във всяка своя дума и емоция.

Намеренията за ремонт, рискуващ да компрометира каменната облицовка на театър „София“, разбуниха духовете в столицата. Или поне сред тези, които милеят за опазването на стойностната българска архитектура, създадена след световните войни. Арх. Анета Василева е активен глас в тези среди и не крие своята пристрастност. Прочетете статията ѝ „Театър „София“ и битката за ново архитектурно наследство“.

Нека завършим с избрано от Стефан Иванов заглавие в рубриката ни „На второ четене“ – в нея припомняме за издадени преди години книги, които още могат да бъдат намерени в книжарниците и заслужават специално внимание. Стефан е силно впечатлен от мемоарите на Вера Мутафчиева, издадени в том 11 и 12 от нейните „Избрани съчинения“. Ще разберете защо, като прочетете неговата препоръка за „Бивалици“ и „Небивалици“.
Приятно четене и слушане!
Metasploit Wrap-Up
Post Syndicated from Brendan Watters original https://blog.rapid7.com/2021/09/17/metasploit-wrap-up-130/
Clone your way to code execution
We’ve had a busy week bringing you exploits, features, enhancements, and fixes. Exploit modules for Git and El Finder lead the pack this week with an information disclosure against Jira and a post exploitation module targeting Geutebruck white-labelled cameras to freeze them like every movie ever!
Git push upstream git-lfs:payload
Our own Jack Hysel and Shelby Pace had some fun creating an exploit module targeting Github, originally discovered by Dawid Golunski. The exploit requires a user to clone an infected Github repository to gain remote code execution, and before you ask, we promise it is safe to clone ours.
Jira users
Brian Halbach and Mikhail Klyuchnikov sent us a nice module exploiting CVE-2020-14181 to get a list of Jira users, helping those social engineers among us to get more targets or login scanners more data. Unfortunately, it does not track my tickets and keep them up to date.
New module content (4)
- Jira Users Enumeration by Brian Halbach and Mikhail Klyuchnikov, which exploits CVE-2020-14181 – This obtains user names on Jira Server by exploiting an information disclosure vulnerability that exists at the
/ViewUserHover.jspaendpoint. - elFinder Archive Command Injection by Shelby Pace and Thomas Chauchefoin, which exploits CVE-2021-32682 – This adds an exploit for CVE-2021-32682 which is an unauthenticated RCE in the elFinder PHP application. The vulnerability is due to a flaw that allows a malicious argument to be passed to the zip command when an archive action is performed.
- Git Remote Code Execution via git-lfs (CVE-2020-27955) by Dawid Golunski, jheysel-r7, and space-r7, which exploits CVE-2020-27955 – This adds an exploit for CVE-2020-27955 which is a vulnerability in the Git version control system. The module can be used to execute code in the context of a user that can be convinced to clone a malicious repository.
- Geutebruck Camera Deface by Ibrahim Ayadhi and Sébastien Charbonnier – A new post exploitation module has been added which allows one to take a session on a Geutebruck Camera shell and either freeze the current display stream, replace the current display stream with a static image, or restore the display stream such that it will display the current live feed from the camera.
Enhancements and features
- #15609 from adfoster-r7 – Adds additional metadata to exploit modules to specify Meterpreter command requirements. This information is used to add a descriptive warning when running modules with a Meterpreter implementation that doesn’t support the required command functionality.
- #15674 from digininja – Updates the Apache Tomcat Ghostcat module to correctly handle a larger range of possible success status codes when verifying if the module has succeeded
Bugs fixed
- #15667 from bwatters-r7 – Fix powershell_reverse_tcp file operations and update the file operations test module
Get it
As always, you can update to the latest Metasploit Framework with msfupdate
and you can get more details on the changes since the last blog post from
GitHub:
If you are a git user, you can clone the Metasploit Framework repo (master branch) for the latest.
To install fresh without using git, you can use the open-source-only Nightly Installers or the
binary installers (which also include the commercial edition).
- Image credit: Toni Barros from São Paulo, Brasil – Hello, Dolly!, CC BY-SA 2.0 https://creativecommons.org/licenses/by-sa/2.0, via Wikimedia Commons
Optimizing Cloud Infrastructure Cost and Performance with Starburst on AWS
Post Syndicated from Kinnar Kumar Sen original https://aws.amazon.com/blogs/architecture/optimizing-cloud-infrastructure-cost-and-performance-with-starburst-on-aws/
Amazon Web Services (AWS) Cloud is elastic, convenient to use, easy to consume, and makes it simple to onboard workloads. Because of this simplicity, the cost associated with onboarding workloads is sometimes overlooked.
There is a notion that when an organization moves its workload to the cloud, agility, scalability, performance, and cost issues will disappear. While this may be true for agility and scalability, you must optimize your workload. You can do this with services like Amazon EC2 Auto Scaling via Amazon Elastic Compute Cloud (Amazon EC2) and Amazon EC2 Spot Instances to realize the performance and cost benefits the cloud offers.
In this blog post, we show you how Starburst Enterprise (Starburst) addressed a sudden increase in cost for their data analytics platform as they grew their internal teams and scaled out their infrastructure. After reviewing their architecture and deployments with AWS specialist architects, Starburst and AWS concluded that they could take the following steps to greatly reduce costs:
- Use Spot Instances to run workloads.
- Add Amazon EC2 Auto Scaling into their training and demonstration environments, because the Starburst platform is designed to elastically scale up and down.
For analytics workloads, when you rein in costs, you typically rein in performance. Starburst and AWS worked together to balance the cost and performance of Starburst’s data analytics platform while also harnessing the flexibility, scalability, security, and performance of the cloud.
What is Starburst Enterprise?
Starburst provides a Massively Parallel Processing SQL (MPPSQL) engine based on open source Trino. It is an analytics platform that provides the cornerstone in customers’ intelligent data mesh and offers the following benefits and services:
- The platform gives you a single point to access, monitor, and secure your data mesh.
- The platform gives you options for your data compute. You no longer have to wait on data migrations or extract, transform, and load (ETL), there is no vendor lock-in, and there is no need to swap out your existing analytics tools.
- Starburst Stargate (Stargate) ensures that large jobs are completed within each data domain of your data mesh. Only the result set is retrieved from the domain.
- Stargate reduces data output, which reduces costs and increases performance.
- Data governance policies can also be applied uniquely in each data domain, ensuring security compliance and federation.
As shown in Figure 1, there are many connectors for input and output that ensure you experience improved performance and security.

Figure 1. Starburst platform
Integrating Starburst Enterprise with AWS
As shown in Figure 2, Starburst Enterprise uses AWS services to deliver elastic scaling and optimize cost. The platform is architected with decoupled storage and compute. This allows the platform to scale as needed to analyze petabytes of data.
The platform can be deployed via AWS CloudFormation or Amazon Elastic Kubernetes Service (Amazon EKS). Starburst on AWS allows you to run analytic queries across AWS data sources and on-premises systems such as Teradata and Oracle.

Figure 2. Deployment architecture of Starburst platform on AWS
Amazon EC2 Auto Scaling
Enterprises have diverse analytic workloads; their compute and memory requirements vary with time. Starburst uses Amazon EKS and Amazon EC2 Auto Scaling to elastically scale compute resources to meet the demands of their analytics workloads.
- Amazon EC2 Auto Scaling ensures that you have the compute capacity for your workloads to handle the load elastically. It is used to architect sophisticated, elastic, and resilient applications on the AWS Cloud.
- Starburst uses the scheduled scaling feature of Amazon EC2 Auto Scaling to scale the cluster up/down based on time. Thus, they incur no costs when the cluster is not in use.
- Amazon EKS is a fully managed Kubernetes service that allows you to run Kubernetes on AWS without needing to install, operate, and maintain your own Kubernetes control plane.
Scaling cloud resource consumption on demand has a major impact on controlling cloud costs. Starburst supports scaling down elastically, which means removing compute resources doesn’t impact the underlying processes.
Amazon EC2 Spot Instances
Spot Instances let you take advantage of unused EC2 capacity in the AWS Cloud. They are available at up to a 90% discount compared to On-Demand Instance prices. If EC2 needs capacity for On-Demand Instance usage, Spot Instances can be interrupted by Amazon EC2 with a two-minute notification. There are many ways to handle the interruption to ensure that the application is well architected for resilience and fault tolerance.
Starburst has integrated Spot Instances as a part of the Amazon EKS managed node groups to cost optimize the analytics workloads. This best practice of instance diversification is implemented by using the integration eksctl and instance selector with dry-run flag. This creates a list of instances of same size (vCPU/Mem ratio) and uses them in the underlying node groups.
Same size instances are required to make best use of Kubernetes Cluster Autoscaler, which is used to manage the size of the cluster.
Scaling down, handling interruptions, and provisioning compute
“Scaling in” an active application is tricky, but Starburst was built with resiliency in mind, and it can effectively manage shut downs.
Spot Instances are an ideal compute option because Starburst can handle potential interruptions natively. Starburst also uses Amazon EKS managed node groups to provision nodes in the cluster. This requires significantly less operational effort compared to using self-managed node groups. It allows Starburst to enforce best practices like capacity optimized allocation strategy, capacity rebalancing, and instance diversification.
When you need to “scale out” the deployment, Amazon EKS and Amazon EC2 Auto Scaling help to provision capacity, as depicted in Figure 3.
Figure 3. Depicting “scale out” in a Starburst deployment
Benefits realized from using AWS services
In a short period, Starburst was able to increase the number of people working on AWS. They added five times the number of Solutions Architects, they have previously. Additionally, in their initial tests of their new deployment architecture, their Solutions Architects were able to complete up to three times the amount of work than they had been able to previously. Even after the workload increased more than 15 times, with two simple changes they only had a slight increase in total cost.
This cost and performance optimization allows Starburst to be more productive internally and realize value for each dollar spent. This further justified investing more into building out infrastructure footprint.
Conclusion
In building their architecture with AWS, Starburst realized the importance of having a robust and comprehensive cloud administration plan that they can implement and manage going forward. They are now able to balance the cloud costs with performance and stability, even after considering the SLA requirements. Starburst is planning to teach their customers about the Spot Instance and Amazon EC2 Auto Scaling best practices to ensure they maintain a cost and performance optimized cloud architecture.
If you want to see the Starburst data analytics platform in action, you can get a free trial in the AWS Marketplace: Starburst Data Free Trial.
Reduce costs and increase resource utilization of Apache Spark jobs on Kubernetes with Amazon EMR on Amazon EKS
Post Syndicated from Saurabh Bhutyani original https://aws.amazon.com/blogs/big-data/reduce-costs-and-increase-resource-utilization-of-apache-spark-jobs-on-kubernetes-with-amazon-emr-on-amazon-eks/
Amazon EMR on Amazon EKS is a deployment option for Amazon EMR that allows you to run Apache Spark on Amazon Elastic Kubernetes Service (Amazon EKS). If you run open-source Apache Spark on Amazon EKS, you can now use Amazon EMR to automate provisioning and management, and run Apache Spark up to three times faster. If you already use Amazon EMR, you can run Amazon EMR-based Apache Spark applications with other types of applications on the same Amazon EKS cluster to improve resource utilization and simplify infrastructure management.
Earlier this year, we launched support for pod templates in Amazon EMR on Amazon EKS to make it simpler to run Spark jobs on shared Amazon EKS clusters. A pod is a group of one or more containers, with shared storage and network resources, and a specification for how to run the containers. Pod templates are specifications that determine how each pod runs.
When you submit analytics jobs to a virtual cluster on Amazon EMR on EKS, Amazon EKS schedules the pods to execute the jobs. Your Amazon EKS cluster may have multiple node groups and instance types attached to it, and these pods could get scheduled on any of those Amazon Elastic Compute Cloud (Amazon EC2) instances. Organizations today have requirements to have better resource utilization, running jobs on specific instances based on instance type, amount of disk, disk IOPS, and more, and also control costs when jobs are submitted by multiple teams to a virtual cluster on Amazon EMR on EKS.
In this post, we look at support in Amazon EMR on EKS for Spark’s pod template feature and how to use that for resource isolation and controlling costs.
Pod templates have many uses cases:
- Cost reduction – To reduce costs, you can schedule Spark driver pods to run on EC2 On-Demand Instances while scheduling Spark executor pods to run on EC2 Spot Instances.
- Resource utilization – To increase resource utilization, you can support multiple teams running their workloads on the same Amazon EKS cluster. Each team gets a designated Amazon EC2 node group to run their workloads on. You can use pod templates to enforce scheduling on the relevant node groups.
- Logging and monitoring – To improve monitoring, you can run a separate sidecar container to forward logs to your existing monitoring application.
- Initialization – To run initialization steps, you can run a separate init container that is run before the Spark main container starts. You can have your init container run initialization steps, such as downloading dependencies or generating input data. Then the Spark main container consumes the data.
Prerequisites
To follow along with the walkthrough, ensure that you have the following resources created:
- An AWS account that provides access to AWS services
- An AWS Identity and Access Management User (IAM) user with an access key and secret key to configure the AWS Command Line Interface (AWS CLI), and permissions to create IAM roles, IAM policies, and AWS CloudFormation stacks
- An Amazon Simple Storage Service (Amazon S3) bucket to store your pod templates
- The AWS CLI, eksctl, and kubectl. Instructions for installation of these tools are given in Step 1
Solution overview
We look at a common use in organizations where multiple teams want to submit jobs and need resource isolation and cost reduction. In this post, we simulate two teams trying to submit jobs to the Amazon EMR on EKS cluster and see how to isolate the resources between them when running jobs. We also look at cost reduction by having the Spark driver run on EC2 On-Demand Instances while using Spark executors to run on EC2 Spot Instances. The following diagram illustrates this architecture.

To implement the solution, we complete the following high-level steps:
- Create an Amazon EKS cluster.
- Create an Amazon EMR virtual cluster.
- Set up IAM roles.
- Create pod templates.
- Submit Spark jobs.
Create an Amazon EKS cluster
To create your Amazon EKS cluster, complete the following steps:
- Create a new file (
create-cluster.yaml) with the following contents:
- Install the AWS CLI.
You can use version 1.18.157 or later, or version 2.0.56 or later. The following command is for Linux OS:
For other operating systems, see Installing, updating, and uninstalling the AWS CLI version.
- Install eksctl (you must have eksctl 0.34.0 version or later):
- Install kubectl:
- Create the Amazon EKS cluster using the create-cluster.yaml config file created in earlier steps:
This step launches an Amazon EKS cluster with five managed node groups: two node groups each for team-1 and team-2, one node group for Spark drivers using EC2 On-Demand capacity, while another one for Spark executors using EC2 Spot capacity.
After the Amazon EKS cluster is created, run the following command to check the node groups:
You should see a response similar to the following screenshot.

Create an Amazon EMR virtual cluster
We launch the EMR virtual cluster in the default namespace:
The command creates an EMR virtual cluster in the Amazon EKS default namespace and outputs the virtual cluster ID:
Note the ID of the EMR virtual cluster to use to run the jobs.
Set up an IAM role
In this step, we create an Amazon EMR Spark job execution role with the following IAM policy:
Navigate to the IAM console to create the role. Let’s call the role EMR_EKS_Job_Execution_Role. For more information, see Creating IAM roles and Creating IAM Policies.
Set up the trust policy for the role with the following command:
Enable IAM roles for service accounts (IRSA) on the Amazon EKS cluster:
Create pod templates with node selectors and taints
In this step, we create pod templates for the Team-1 Spark driver pods and Spark executor pods, and templates for the Team-2 Spark driver pods and Spark executor pods.
Run the following commands to view the nodes corresponding to team-1 for the label team=team-1-spark-driver:
Similarly, you can view the nodes corresponding to team-1 for the label team=team-1-spark-executor. You can repeat the same commands to view the nodes corresponding to team-2 by changing the role labels:
You can constrain a pod so that it can only run on particular set of nodes. There are several ways to do this and the recommended approaches all use label selectors to facilitate the selection. In some circumstances, you may want to control which node the pod deploys to; for example, to ensure that a pod ends up on a machine with an SSD attached to it, or to co-locate pods from two different services that communicate a lot into the same availability zone.
nodeSelector is the simplest recommended form of node selection constraint. nodeSelector is a field of PodSpec. It specifies a map of key-value pairs. For the pod to be eligible to run on a node, the node must have each of the indicated key-value pairs as labels.
Taints are used to repel pods from specific nodes. Taints and tolerations work together to ensure that pods aren’t scheduled onto inappropriate nodes. One or more taints are applied to a node; this marks that the node shouldn’t accept any pods that don’t tolerate the taints. Amazon EKS supports configuring Kubernetes taints through managed node groups. Taints and tolerations are a flexible way to steer pods away from nodes or evict pods that shouldn’t be running. A few of the use cases are dedicated nodes: If you want to dedicate a set of nodes, such as GPU instances for exclusive use by a particular group of users, you can add a taint to those nodes, and then add a corresponding toleration to their pods.
nodeSelector provides a very simple way to attract pods to nodes with particular labels. Taints on the other hand are used to repel pods from specific nodes. You can apply taints to a team’s node group and use pod templates to apply a corresponding toleration to their workload. This ensures that only the designated team can schedule jobs to their node group. The label, using affinity, directs the application to the team’s designated node group and a toleration enables it to schedule over the taint. During the Amazon EKS cluster creation, we provided taints for each of the managed node groups. We create pod templates to specify both nodeSelector and tolerations to schedule work to a team’s node group.
- Create a new file
team-1-driver-pod-template.yamlwith the following contents:
Here, we specify nodeSelector as team: team-1-spark-driver. This makes sure that Spark driver pods are running on nodes created as part of node group team-1-spark-driver, which we created for Team-1. At the same time, we have a toleration for nodes tainted as team-1.
- Create a new file
team-1-executor-pod-template.yamlwith the following contents:
Here, we specify nodeSelector as team: team-1-spark-executor. This makes sure that Spark executor pods are running on nodes created as part of node group team-1-spark-executor, which we created for Team-1. At the same time, we have a toleration for nodes tainted as team-1.
- Create a new file
team-2-driver-pod-template.yamlwith the following contents:
Here, we specify nodeSelector as team: team-2-spark-driver. This makes sure that Spark driver pods are running on nodes created as part of node group team-2-spark-driver, which we created for Team-2. At the same time, we have a toleration for nodes tainted as team-2.
- Create a new file
team-2-executor-pod-template.yamlwith the following contents.
Here, we specify nodeSelector as team: team-2-spark-executor. This makes sure that Spark executor pods are running on nodes created as part of node group team-2-spark-executor, which we created for Team-2. At the same time, we have a toleration for nodes tainted as team-2.
Save the preceding pod template files to your S3 bucket or refer to them using the following links:
s3://aws-data-analytics-workshops/emr-eks-workshop/scripts/team-1-driver-template.yamls3://aws-data-analytics-workshops/emr-eks-workshop/scripts/team-1-executor-template.yamls3://aws-data-analytics-workshops/emr-eks-workshop/scripts/team-2-driver-template.yamls3://aws-data-analytics-workshops/emr-eks-workshop/scripts/team-2-executor-template.yaml
Submit Spark jobs
In this step, we submit the Spark jobs and observe the output.
Substitute the values of the EMR virtual cluster ID, EMR_EKS_Job_Execution_Role ARN, and S3_Bucket:
Submit the Spark job:
After submitting the job, run the following command to check if the Spark driver and executor pods are created and running:
You should see output similar to the following:
Let’s check the pods deployed on team-1’s On-Demand Instances:
Let’s check the pods deployed on team-1’s Spot Instances:
When the executor pods are running, you should see output similar to the following:
To check the status of the jobs on Amazon EMR console, choose the cluster on the Virtual Clusters page. You can also check the Spark History Server by choosing View logs.

When the job is complete, go to Amazon CloudWatch Logs and check the output by choosing the log (/emr-containers/jobs/<<xxx-driver>>/stdout) on the Log groups page. You should see output similar to the following screenshot.
Now submit the Spark job as team-2 and specify the pod template files pointing to team-2’s driver and executor pod specifications and observe where the pods are created:
We can check the status of the job on the Amazon EMR console and also by checking the CloudWatch logs.
Now, let’s run a use case where Team-1 doesn’t specify the correct toleration in the Spark driver’s pod template. We use the following pod template. As per the toleration specification, Team-1 is trying to schedule a Spark driver pod on nodes with label team-1-spark-driver and also wants it to get scheduled over nodes tainted as team-2. Because team-1 doesn’t have any nodes with that specification, we should see an error.
Submit the Spark job using this new pod template:
Run the following command to check the status of the Spark driver pod:
Let’s describe the driver pod to check the details. You should notice a failed event similar to Warning FailedScheduling 28s (x3 over 31s) default-scheduler 0/17 nodes are available: 8 node(s) had taint {team-1: general-purpose}, that the pod didn't tolerate, 9 node(s) didn't match Pod's node affinity
This shows that if the pod template doesn’t have the right tolerations, the tainted nodes don’t tolerate the pod and don’t schedule over those nodes.
Clean up
Don’t forget to clean up the resources you created to avoid any unnecessary charges.
- Delete all the virtual clusters that you created:
- Delete the Amazon EKS cluster:
- Delete the
EMR_EKS_Job_Execution_Rolerole and policies.
Summary
In this post, we saw how to create an Amazon EKS cluster, configure Amazon EKS managed node groups, create an EMR virtual cluster on Amazon EKS, and submit Spark jobs. With pod templates, we saw how to manage resource isolation between various teams when submitting jobs and also learned how to reduce cost by running Spark driver pods on EC2 On-Demand Instances and Spark executor pods on EC2 Spot Instances.
To get started with pod templates, try out the Amazon EMR on EKS workshop or see the following resources:
- Use Kubernetes Pod Templates with Amazon EMR on Amazon EKS to simplify running Spark workloads and control costs
- Using pod templates
- Pyspark Job submission
About the Author
 Saurabh Bhutyani is a Senior Big Data specialist solutions architect at Amazon Web Services. He is an early adopter of open source Big Data technologies. At AWS, he works with customers to provide architectural guidance for running analytics solutions on Amazon EMR, Amazon Athena, AWS Glue, and AWS Lake Formation
Schaller: Cool happenings in Fedora Workstation land
Post Syndicated from original https://lwn.net/Articles/869561/rss
Here’s a
post from Christian Schaller describing a number of the
desktop-oriented improvements that can be expected in the Fedora 35
release.
And I know some people will wonder why we spent so much time
working with NVidia around their binary driver, but the reality is
that NVidia is the market leader, especially in the professional
Linux workstation space, and there are lot of people who either
would end up not using Linux or using Linux with X without it,
including a lot of Red Hat customers and Fedora users. And that is
what I and my team are here for at the end of the day, to make sure
Red Hat customers are able to get their job done using their Linux
systems.
Conill: The long-term consequences of maintainers’ actions
Post Syndicated from original https://lwn.net/Articles/869557/rss
Ariadne Conill looks
at the difficulties caused by the OpenSSL 3 transition in the
context of Alpine Linux.
For distributions, however, the story is different:
cryptography moved to using Rust, because they wanted to
leverage all of the static analysis capabilities built into the
language. This, too, is a reasonable decision, from a development
perspective. From the ecosystem perspective, however, it is
problematic, as the Rust ecosystem is still rapidly evolving, and
so we cannot support a single branch of the Rust compiler for an
entire 2 year lifecycle, which means it exists in community. Our
solution, historically, has been to hold cryptography at
the latest version that did not require Rust to build. However,
that version is not compatible with OpenSSL 3, and so it will
eventually need to be upgraded to a new version which is. And so,
since cryptography has to move to community, so does
paramiko and Ansible.