This is a very weird story about how squid stayed on the menu of Byzantine monks by falling between the cracks of dietary rules.
At Constantinople’s Monastery of Stoudios, the kitchen didn’t answer to appetite.
It answered to the “typikon”: a manual for ensuring that nothing unexpected happened at mealtimes. Meat: forbidden. Dairy: forbidden. Eggs: forbidden. Fish: feast-day only. Oil: regulated. But squid?
Squid had eight arms, no bones, and a gift for changing color. Nobody had bothered writing a regulation for that. This wasn’t a loophole born of legal creativity but an oversight rooted in taxonomic confusion. Medieval monks, confronted with a creature that was neither fish nor fowl, gave up and let it pass.
In a kitchen governed by prohibitions, the safest ingredient was the one that caused the least disturbance. Squid entered not with applause, but with a shrug.
Bonus stuffed squid recipe at the end.
As usual, you can also use this squid post to talk about the security stories in the news that I haven’t covered.
Some of our releases add new ways in; this one adds new ways to stay in. There are, of course, still new RCE toys in the box (Tactical RMM via Jinja2 SSTI and an unauthenticated MajorDoMo exploit). Still, the underlying theme is payloads: more control over how they are packaged and delivered, and fewer “why did it die instantly?” moments. We, like our community of module authors, grew tired of having to do everything by hand. You can now pick encoders (and tweak their options) directly for exploit and payload modules without extra glue code. Less plumbing, more choosing-the-right-badchar-killer-at-runtime.
Description: Adds a new module evasion/linux/x86/rc4_packer that encrypts the generated payload with RC4, prepends an optional sleep-based delay (nanosleep), and decrypts/executes the payload at runtime via a compact precompiled stub.
Description: This adds an exploit module for CVE-2025-69516, a Jinja2 SSTI in Tactical RMM < 1.4.0 where the reporting template preview endpoint evaluates user-controlled templates without sandboxing, enabling authenticated RCE. The module logs in via the Knox API, auto-detects the API host from /env-config.js, and exploits the template preview feature.
MajorDoMo Remote Command Injection via cycle_execs Race Condition
Description: Adds three exploit modules for MajorDoMo, an open-source home automation platform. All three vulnerabilities are unauthenticated.
Enhancements and features (2)
#20852 from dledda-r7 – This adds encoder options for exploit and payload modules. It allows the user to select the encoder and modify its options when using exploit or payload without the need of adding additional code into the module.
#20987 from sjanusz-r7 – Allows AS-REP and Kerberoast modules to be ran against a pre-existing LDAP session as well as RHOST values.
Bugs fixed (5)
#20740 from Chocapikk – This adds a new SRVSSL option to the HttpServer library, allowing SSL to be enabled for the HTTP server independently from the HTTP client.
#20830 from SilentSobs – This fixes a portability issue in Msf::Post::File.stat where the code incorrectly assumed a GNU stat output format.
#20940 from g0tmi1k – Fixes an issue where the > (file Redirect operator) causes the exploit to fail. This updates the exploit to use tee to avoid that problematic operator and also increases debug verbosity, simplifies code, adds documentation, and adds support for fetch payloads to gain Linux Meterpreter sessions.
#20946 from g0tmi1k – Corrects issue where the revision value provided in the http requests can be outside the subset of revision id/value/numbers; a revision value that is not an actual revision value may result in a failed exploit. Also, cleaned up logic and increased debugging verbosity.
#21044 from adfoster-r7 – Fixes a crash when using db_import on a nessus with protocols other than tcp or udp.
Documentation
You can find the latest Metasploit documentation on our docsite at docs.metasploit.com.
Get it
As always, you can update to the latest Metasploit Framework with msfupdate and you can get more details on the changes since the last blog post from GitHub:
In early February, members of the Fedora Council met in Tirana,
Albania to discuss and set the strategic direction for the Fedora Project. The
council has published
summaries from its strategy summit, and Fedora Project Leader (FPL) Jed Spaleta,
as well as some of the council members, held a video meeting to discuss outcomes from
the summit on February 25. Topics included a plan to experiment with Open Collective to raise
funds for specific Fedora projects, tools to build image-based editions, and
more. Spaleta also explained his model for Fedora governance.
OpenAI is in and Anthropic is out as a supplier of AI technology for the US defense department. This news caps a week of bluster by the highest officials in the US government towards some of the wealthiest titans of the big tech industry, and the overhanging specter of the existential risks posed by a new technology powerful enough that the Pentagon claims it is essential to national security. At issue is Anthropic’s insistence that the US Department of Defense (DoD) could not use its models to facilitate “mass surveillance” or “fully autonomous weapons,” provisions the defense secretary Pete Hegseth derided as “woke.”
It all came to a head on Friday evening when Donald Trump issued an order for federal government agencies to discontinue use of Anthropic models. Within hours, OpenAI had swooped in, potentially seizing hundreds of millions of dollars in government contracts by striking an agreement with the administration to provide classified government systems with AI.
Despite the histrionics, this is probably the best outcome for Anthropic—and for the Pentagon. In our free-market economy, both are, and should be, free to sell and buy what they want with whom they want, subject to longstanding federal rules on contracting, acquisitions, and blacklisting. The only factor out of place here are the Pentagon’s vindictive threats.
AI models are increasingly commodified. The top-tier offerings have about the same performance, and there is little to differentiate one from the other. The latest models from Anthropic, OpenAI and Google, in particular, tend to leapfrog each other with minor hops forward in quality every few months. The best models from one provider tend to be preferred by users to the second, or third, or 10th best models at a rate of only about six times out of 10, a virtual tie.
In this sort of market, branding matters a lot. Anthropic and its CEO, Dario Amodei, are positioning themselves as the moral and trustworthy AI provider. That has market value for both consumers and enterprise clients. In taking Anthropic’s place in government contracting, OpenAI’s CEO, Sam Altman, vowed to somehow uphold the same safety principles Anthropic had just been pilloried for. How that is possible given the rhetoric of Hegseth and Trump is entirely unclear, but seems certain to further politicize OpenAI and its products in the minds of consumers and corporate buyers.
Posturing publicly against the Pentagon and as a hero to civil libertarians is quite possibly worth the cost of the lost contracts to Anthropic, and associating themselves with the same contracts could be a trap for OpenAI. The Pentagon, meanwhile, has plenty of options. Even if no big tech company was willing to supply it with AI, the department has already deployed dozens of open weight models—whose parameters are public and are often licensed permissively for government use.
We can admire Amodei’s stance, but, to be sure, it is primarily posturing. Anthropic knew what they were getting into when they agreed to a defense department partnership for $200m last year. And when they signed a partnership with the surveillance company Palantir in 2024.
Read Amodei’s statement about the issue. Or his January essay on AIs and risk, where he repeatedly uses the words “democracy” and “autocracy” while evading precisely how collaboration with US federal agencies should be viewed in this moment. Amodei has bought into the idea of using “AI to achieve robust military superiority” on behalf of the democracies of the world in response to the threats from autocracies. It’s a heady vision. But it is a vision that likewise supposes that the world’s nominal democracies are committed to a common vision of public wellbeing, peace-seeking and democratic control.
Regardless, the defense department can also reasonably demand that the AI products it purchases meet its needs. The Pentagon is not a normal customer; it buys products that kill people all the time. Tanks, artillery pieces, and hand grenades are not products with ethical guard rails. The Pentagon’s needs reasonably involve weapons of lethal force, and those weapons are continuing on a steady, if potentially catastrophic, path of increasingautomation.
So, at the surface, this dispute is a normal market give and take. The Pentagon has unique requirements for the products it uses. Companies can decide whether or not to meet them, and at what price. And then the Pentagon can decide from whom to acquire those products. Sounds like a normal day at the procurement office.
But, of course, this is the Trump administration, so it doesn’t stop there. Hegseth has threatened Anthropic not just with loss of government contracts. The administration has, at least until the inevitable lawsuits force the courts to sort things out, designated the company as “a supply-chain risk to national security,” a designation previously only ever applied to foreign companies. This prevents not only government agencies, but also their own contractors and suppliers, from contracting with Anthropic.
The government has incompatibly also threatened to invoke the Defense Production Act, which could force Anthropic to remove contractual provisions the department had previously agreed to, or perhaps to fundamentally modify its AI models to remove in-built safety guardrails. The government’s demands, Anthropic’s response, and the legal context in which they are acting will undoubtedly all change over the coming weeks.
But, alarmingly, autonomous weapons systems are here to stay. Primitive pit traps evolved to mechanical bear traps. The world is still debating the ethical use of, and dealing with the legacy of, land mines. The US Phalanx CIWS is a 1980s-era shipboard anti-missile system with a fully autonomous, radar-guided cannon. Today’s military drones can search, identify and engage targets without direct human intervention. AI will be used for military purposes, just as every other technology our species has invented has.
The lesson here should not be that one company in our rapacious capitalist system is more moral than another, or that one corporate hero can stand in the way of government’s adopting AI as technologies of war, or surveillance, or repression. Unfortunately, we don’t live in a world where such barriers are permanent or even particularly sturdy.
Instead, the lesson is about the importance of democratic structures and the urgent need for their renovation in the US. If the defense department is demanding the use of AI for mass surveillance or autonomous warfare that we, the public, find unacceptable, that should tell us we need to pass new legal restrictions on those military activities. If we are uncomfortable with the force of government being applied to dictate how and when companies yield to unsafe applications of their products, we should strengthen the legal protections around government procurement.
The Pentagon should maximize its warfighting capabilities, subject to the law. And private companies like Anthropic should posture to gain consumer and buyer confidence. But we should not rest on our laurels, thinking that either is doing so in the public’s interest.
This essay was written with Nathan E. Sanders, and originally appeared in The Guardian.
Each year, we bring the Analytics Engineering community together for an Analytics Summit — a multi-day internal conference to share analytical deliverables across Netflix, discuss analytic practice, and build relationships within the community. This post is one of several topics presented at the Summit highlighting the breadth and impact of Analytics work across different areas of the business.
At Netflix, our goal is to entertain the world, which means we must speak the world’s languages. Given the company’s growth to serving 300 million+ members in more than 190+ countries and 50+ languages, the Localization team has had to scale rapidly in creating more dubs and subtitle assets than ever before. However, this growth created technical debt within our systems: a fragmented landscape of analytics workflows, duplicated pipelines, and siloed dashboards that we are now actively modernizing.
The Challenge: “Who Made This Dub?”
Historically, business logic for localization metrics was replicated across isolated domains. A question as simple as “Who made this dub/subtitle?” is actually complex — it requires mapping multiple data sources through intricate and constantly changing logic, which varies depending on the specific language asset type and creation workflow.
When this logic is copied into isolated pipelines for different use cases it creates two major risks: inconsistency in reporting and a massive maintenance burden whenever upstream logic changes. We realized we needed to move away from these vertical silos.
Our Modernization Strategy
To address this, we defined a vision centered on consolidation, standardization, and trust, executed through three strategic pillars:
1. The Audit and Consolidation Playbook
We initiated a comprehensive audit of over 40 dashboards and tools to assess usage and code quality. Our focus has shifted from patching frontend visualizations to consolidating backend pipelines. For example, we are currently merging three legacy dashboards related to dubbing partner KPIs (around operational performance, capacity, and finances), focusing first on a unified data and backend layer that can support a variety of future frontend iterations.
2. Reducing “Not-So-Tech” Debt
Technical debt isn’t just about code; it is also about the user experience. We define “Not-So-Tech Debt” as the friction stakeholders feel when tools are hard to interpret or can benefit from better storytelling. To fix this, we revamped our Language Asset Consumption tool — instead of reporting dub and subtitle metrics independently, we combine audio and text languages into one consumption language that helps differentiate Original Language versus Localized Consumption and measure member preferences between subtitles, dubs, or a combination of both for a given language. This unlocks more intuitive insights based on actual recurring stakeholder use cases.
3. Investing in Core Building Blocks
We are shifting to a write once, read many architecture. By centralizing business logic into unified tables — such as a “Language Asset Producer” table — we solve the “Who made this dub?” problem once. This centralized source now feeds into multiple downstream domains, including our Dub Quality and Translation Quality metrics, ensuring that any logic update propagates instantly across the ecosystem.
The Future: Event-Level Analytics
Looking ahead, we are moving beyond asset-level metrics to event-level analytics. We are building a generic data model to capture granular timed-text events, such as individual subtitle lines. This data helps us understand how subtitle characteristics (e.g. reading speed) affect member engagement and, in turn, refine the style guidelines we provide to our subtitle linguists to improve the member experience with localized content.
Ultimately, this modernization effort is about scaling our ability to measure and enhance the joy and entertainment we deliver to our diverse global audience, ensuring that every member, regardless of their language, has the best possible Netflix experience.
Version
25.12.0 of the OpenWrt router distribution is available; this release
has been dedicated to the memory of Dave Täht. Changes include a switch to
the apk package manager, the integration of the attended
sysupgrade method, and support for a long list of new targets.
Cloudflare One has grown a lot over the years. What started with securing traffic at the network now spans the endpoint and SaaS applications – because that’s where work happens.
But as the market has evolved, the core mission has become clear: data security is enterprise security.
Here’s why. We don’t enforce controls just to enforce controls. We do it because the downstream outcomes are costly: malware, credential theft, session hijacking, and eventually the thing that matters most: sensitive data leaving the organization. What looks like a simple access policy can be the first link in a chain that ends in incident response, customer impact, and reputational damage.
So when you take a step back, most security programs – even the ones that look different on paper – are trying to answer the same questions:
Where is sensitive data?
Who can access it?
What paths exist for it to move somewhere it shouldn’t?
That’s the backbone of our data security vision in Cloudflare One: a single model that follows data across the places it moves, not a pile of siloed controls. That means:
Protection in transit (across Internet + SaaS access)
Visibility and control at rest (inside SaaS)
Enforcement in use (on endpoints)
And now, coverage at the prompt (as AI becomes a new interface to enterprise data)
Think of these as one connected system: visibility tells you what’s happening, controls constrain where data can move, and enforcement closes the last-mile gaps when content leaves an app. That’s the endpoint-to-prompt problem: data moves faster than product boundaries, so policy needs to follow the data, not the tool.
In this post, we’ll walk through a set of updates that push that vision forward – from browser-based Remote Desktop Protocol (RDP) controls, to operation-level logging, to endpoint data loss prevention (DLP), to AI security scanning for Microsoft 365 Copilot.
Remote access without data sprawl: browser-based RDP clipboard controls
Browser-based RDP is a practical way to provide remote access when you can’t assume a managed endpoint or installed client – common for contractors, partners, and occasional access workflows. Cloudflare One’s browser-based RDP adds visibility and policy controls to that access. But once you’re delivering a full RDP experience in the browser, the question becomes simple: how granular are your controls over where data can move, especially via the clipboard?
Today, we’re adding a setting that directly protects data: clipboard controls for browser-based RDP. With this new feature, security and IT administrators will now be able to decide whether their users can copy or paste information between their local device and the browser-based RDP session.
Clipboard restrictions are a perfect example of the productivity-security tradeoff. If users can’t copy and paste in the workflow they rely on, they’ll route around the control, whether it’s by taking screenshots, retyping data, or shifting work to unmanaged tools. Clipboard controls let you be precise: allow the workflow where it’s safe, and block it where it isn’t.
With clipboard controls in browser-based RDP, administrators can enable the copy/paste workflow users expect while enforcing granular control over directionality and context. For example, if users access a customer support portal that contains sensitive customer information, you might allow copy/paste into the session for productivity, but block copy/paste out of the session to prevent data from landing on unmanaged endpoints.
This functionality is now available in Cloudflare One and can be configured as a new setting within Access Application Policies for browser-based RDP apps.
Visibility without guesswork: operation mapping in logs
While remote access controls reduce risk, to tune them well, you also need to understand the specific actions users are taking inside SaaS apps.
We use a process called operation mapping (detailed in a recent blog post) to give visibility to these actions and simplify the way customers write policies for SaaS services. Our mapping process takes various elements of an HTTP request and interprets them as a single operation, e.g. ‘SendPrompt’, in the example of ChatGPT. We collect multiple operations that perform similar actions into an Application Control, e.g., ‘Share’ or ‘Upload’. The [what?] is viewable in our HTTP policy builder, allowing for simple policy authoring.
Today, we’ve taken that process a step further to enrich logs and provide greater visibility over how SaaS applications are being used in your organization – by extending that mapping into logging. Without any additional configuration, operations and application controls will now appear in log events for traffic that matches our operation maps.
In log details, you’ll now see both the application control group and the specific operation (e.g., SendPrompt for ChatGPT). This makes investigations and policy tuning faster.
The added context helps you understand usage patterns, accelerate forensic analysis, and spot potentially risky behavior, so you can tune policy with less guesswork and disruption to users.
Visibility is step one. To protect data in use, especially what moves through the clipboard, you also need enforcement on the endpoint.
Better endpoint protection: on-device DLP in the Cloudflare One Client
In a modern enterprise, sensitive information routinely moves from managed applications into unmanaged contexts – often via the clipboard. The risk isn’t only a file leaving the organization; it can be a snippet of proprietary code or a customer record pasted into an unauthorized large language model (LLM) or personal tool.
Cloudflare One already helps protect data in transit with Gateway and DLP, and provides visibility and control at rest through CASB and its API integrations. Now we’re extending coverage to data in use by bringing Endpoint DLP enforcement to the Cloudflare One Client, starting with high-signal workflows like clipboard movement, so data protection doesn’t stop the moment content leaves a browser tab.
That means sensitive data copied from a protected SaaS app doesn’t immediately become “policy-free” content the moment it hits the OS clipboard. With Endpoint DLP, teams can extend data protection to users’ fingertips without deploying a second agent or stitching together complex integrations.
For teams already using Cloudflare One for data protection, Endpoint DLP completes the model by adding a consistent enforcement layer for data in use.
This is the endpoint-to-prompt problem: if sensitive data can be copied locally, it can be pasted into an AI assistant just as easily. Once you protect data in use, the next question becomes unavoidable – what happens when that same data is transformed at the prompt?
AI visibility without blind spots: M365 Copilot scanning with API CASB
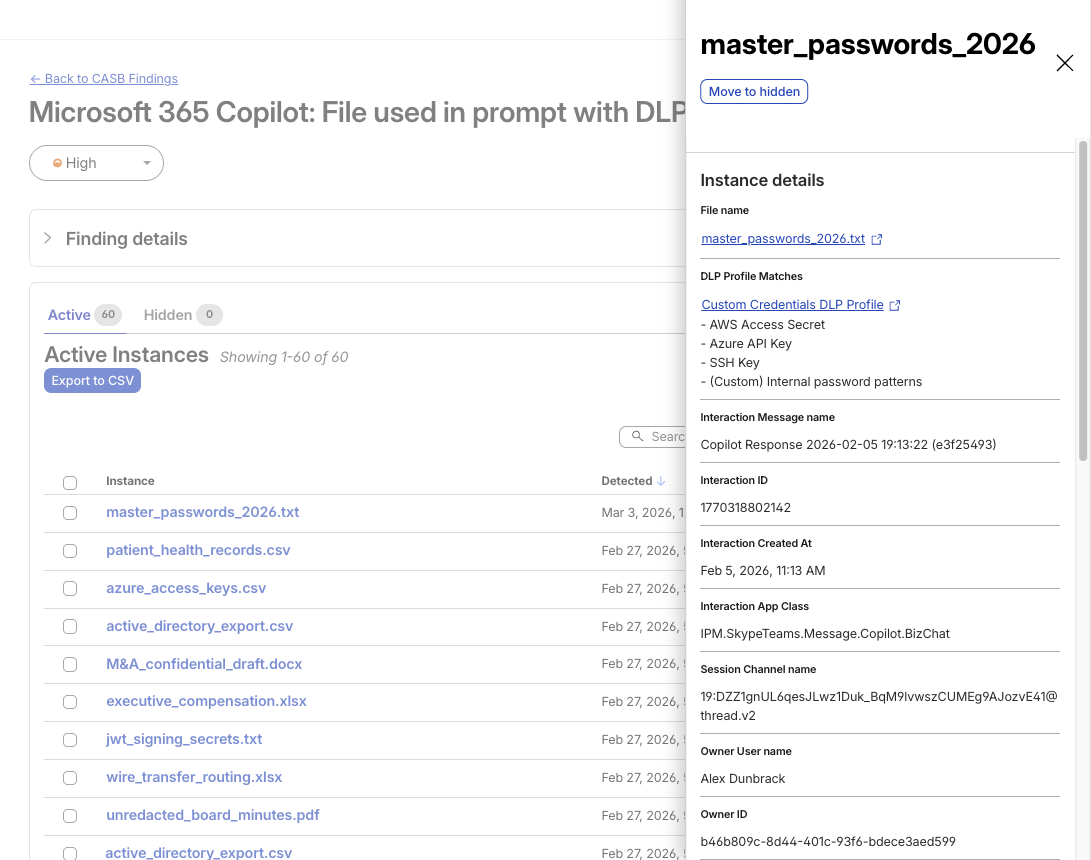
Starting today, customers using Cloudflare One’s API Cloud Access Security Broker (CASB) – which scans SaaS apps via API for common, yet risky security issues – can now analyze Microsoft 365 Copilot activity for data security issues, including chats and uploads that match DLP detection profiles.
Copilot findings surface with rich context (file references, profile matches, and interaction metadata) so teams can triage quickly instead of starting from raw audit logs.
A CASB Finding showing detection of a file used in M365 Copilot that matches an enabled DLP Profile
Customers can now see when Copilot activity includes sensitive data. For example, user prompts, Copilot responses, and uploaded files that match DLP detection profiles.
Microsoft 365 Copilot findings are available by default as part of the Microsoft 365 integration. If you already use this integration, go to Integrations in the Cloudflare One dashboard, update your Microsoft 365 connection, and start receiving Copilot findings. If you’re new to the integration, connect your Microsoft 365 tenant to gain visibility into Copilot usage and associated data security findings.
As AI product sprawl continues, we’ll be massively expanding coverage across additional AI assistants and core SaaS platforms throughout 2026 – stay tuned!
What’s next: unified data security in Cloudflare One
Over the last few years, enterprise security has expanded across more surfaces: SaaS, unmanaged endpoints, remote access patterns, and now AI assistants. But the objective – protecting sensitive data – hasn’t changed. The updates in this post reflect a single direction: consistent visibility and enforcement across data in transit, at rest, in use, and at the prompt. So policy follows data, not product boundaries.
Looking forward, our vision is broader than “data security features in data security products.” Over time, every Cloudflare One product will become more data-security-aware, with more data-oriented configurability, visibility, controls, and guardrails, built directly into the workflows teams already use across Access, Gateway, endpoint enforcement, and SaaS integrations. The goal is simple: wherever your users work and wherever data moves, Cloudflare One should be able to explain what’s happening and help you control it.
As the modern perimeter spreads across applications, browsers, endpoints, and AI prompts, patching together point solutions becomes harder to operate and easier to bypass. By building data security directly into Cloudflare One – from access controls to endpoint enforcement to AI visibility – and continuing to unify these layers, we’re helping teams build a clearer, more complete picture of their data risk and their data security posture from the endpoint to the prompt.
Когато политикът Румен Радев обяви, че тръгва на поход за бъдещето на България, слизайки от луксозен SUV BMW X7, значи за избирателите походът е Ком–Емине, а за него – смяна на предавките след Президентството.
Онова, което мерят социолозите, за да го позиционират като победител във всички проучвания от началото на януари 2026-та досега, е не потенциалът на партия, а президентско-спасителският рейтинг на Румен Радев. Защото партия няма, програми (още) не са обявени и лицата в кандидатдепутатските листи не са известни. Основният политически капитал произтича от един лидер. Така както през 2001 г. дойде от невидимата корона на Царя, през 2009 г. – от мускулите и черната кожена тужурка на Бат’ Бойко, а сега идва от генералските пагони и ореола на „силната президентска ръка“, обещаваща нов ред и държавност.
За какво служат „шаситата“
Коалицията, с която Радев ще се яви на изборите на 19 април – „Прогресивна България“, беше регистрирана тази седмица в Централната избирателна комисия. Тя включва три партии: Политическо движение „Социалдемократи“ на Елена Нонева, Социалдемократическата партия на Тодор Барболов и Движение „Нашият народ“ на кмета на Кричим Атанас Калчев, който управлява 7-хилядната община пети мандат (до момента 19 години).
Няма законова пречка формациите да са една или две.
Тези три „шасита“ не носят реална електорална тежест и това е част от избрана стратегия. Така някои кандидати могат да бъдат вкарани през различните партии, без да се забележат (веднага). Формално това става чрез някаква квота, а Румен Радев няма да носи пряка отговорност за подбора им.
Имиджов трик е, че Радев не е начело на коалицията. Нейни съпредседатели са двама негови съветници от Президентството – бившият служебен премиер Гълъб Донев и бившият военен министър Димитър Стоянов. Това е знак за привидна дистанция – един вид, лидерът стои над партийните структури, поради което не се появи и при регистрирането ѝ. Позволява гъвкавост при разпределяне на местата по избирателните райони. Също така поради юридически или стратегически съображения понякога е по-удобно други лица да са формални председатели.
В допълнение, това е част от изграждането на образа на бившия президент, който се представя като национален лидер, а не като партиен апаратчик – поне докато не покаже свой партиен продукт. Но клиентелистите вече са се наредили на опашка при бъдещия победител, така че бързо ще я сглоби.
Интересни са партиите в тази постпрезидентска сглобка. ПД „Социалдемократи“ беше един от трите мандатоносителя на „Продължаваме промяната“ заедно с ВОЛТ на Настимир Ананиев и „Средна европейска класа“ на Константин Бачийски. През 2022 г. именно ПД „Социалдемократи“ получи 90% от субсидията, въпреки че нямаше нито един депутат.
ПД „Социалдемократи“, което до октомври 2025 г. беше част от БСП – Обединена левица, има любопитна партийна история. Основано е през юни 2000 г. от Николай Камов, който е бил депутат от БСП, а до 1989 г. – виден комсомолски кадър. Един от учредителите ѝ е Ивайло Калфин, който като депутат от БСП в 37-мото Народно събрание по времето на кабинета „Виденов“ се отцепи от групата заедно с още депутати социалисти и всички вкупом напуснаха БСП. Сред тях бяха Филип Боков, Елена Поптодорова, Андрей Бунджулов, Росен Карадимов (днес председател на Комисията за защита на конкуренцията, КЗК) и др., известни като социалдемократи. По-късно те се присъединиха към Александър Томов, който тогава създаде Евролевицата, но го напуснаха през 2000 г.
(Любопитен факт е, че Карадимов беше назначен в Надзорния съвет на Българската банка за развитие през ноември 2022 г. именно от служебен кабинет с премиер Гълъб Донев и така бе върнат в активната политика. При издигането му за шеф на КЗК бе свързван с олигарха Делян Пеевски, санкциониран от САЩ и Великобритания за корупция.)
През 2005 г. ПД „Социалдемократи“ е в коалиция с БСП, която печели изборите и на власт идва Тройната коалиция (БСП, НДСВ, ДПС). Не подкрепят военната помощ за Украйна и са на страната на Радев за референдум за еврото.
Социалдемократическата партия (СДП) също е отломка от славно минало – на СДС. Дори е имала депутати в сините парламентарни групи и заместник-председател на парламента (Иван Куртев), когато е партньор на СДС през 1997 г., но е била отделна партия. През 2023 г. е част от коалиция „Заедно“, издигнала за депутати напусналите „Има такъв народ“ Ива Митева и Любомир Каримански. Сега се спекулира, че Митева ще бъде и в листите на „Прогресивна България“.
Румен Радев използва именно лозунга на СДП – „Свобода, справедливост, солидарност“, в поста си във Facebook в деня на регистрирането на коалицията:
„Прогресивна България“ е отговорът на очакванията на българите за демонтиране на олигархичния корупционен модел. На апела на мълчаливото мнозинство за свобода, солидарност и справедливост. За развитието на България като модерна и демократична европейска държава.
Като изключим този лозунг, СДП е някакъв призрак, а за партиен живот е трудно да се открие каквато и да било следа в последните двайсетина години.
Броени дни преди регистрацията пък кметът на Кричим отрече Радев да е искал формацията му за мандатоносител, каквато информация изтече през февруари. Калчев, който е бивш полицай, е известен с това, че печели всичките си мандати като кмет още на първи тур с добра преднина пред конкуренцията.
Неговата партия Движение „Нашият народ“ е бившата Движение „Нашият град“, появила се на местните избори във Варна преди 20 години и свързвана с икономическата група около „Химимпорт“. Журналистката Невяна Троянска, авторка на книгата „ТИМ. Отборът, който превзе България“, разкри във Facebook тази трансформация.
А освен тези прилики беше хванато, че логото на „Прогресивна България“ е едно към едно с логото на организацията RISE East of England Teaching Exchange. За капак се оказа, че има сдружение „Прогресивна България“ с ЕИК 207561851, регистрирано на 17.10.2023 г. според търговския регистър и регистъра на юридическите лица с нестопанска цел. Основната дейност на сдружението е защита на правата на ЛГБТ+ общността. Интересното в случая е, че Радев винаги се е заявявал като консерватор и защитник на традиционното семейство.
Как тези негови ценности се вписват в социалдемократическата рамка? Едва ли решилите да гласуват за него 32,6% според последното проучване на „Алфа Рисърч“ се вълнуват от идеологическата мотивация. А и БСП, член на Партията на европейските социалисти, беше сред генераторите на кампанията срещу ратификацията на Истанбулската конвенция, както впрочем и самият Радев.
Какво става с неравенството?
Ако през всичките девет години като президент Румен Радев шикалкавеше със съдебната реформа, то неизменно акцентираше върху темата за неравенството.
На един държавен глава му е простено да не отива по-далеч от показалеца си. Но един политик, устремил се към изпълнителната власт, е длъжен да продължи с отговорите – как ще намали неравенството, каква комбинация от финансови и социални мерки ще използва.
Първият тест от предстоящия „поход към прогреса“ е данъчната система. Ще настоява ли Румен Радев за замяна на плоския данък с прогресивно данъчно облагане? (Даже си върви с името на коалицията му.) Това предложение беше в арсенала на БСП. Но какво все пак ще предложи срещу неравенството, засега е неясно. Вероятно ще се съсредоточи върху повече държава в икономиката и по-големи социални разходи, така присъщи на БСП.
Остава големият въпрос дали предвожданата от Румен Радев нова политическа сила ще се заеме с някакви смели реформи и дали няма да ги подмени с обичайната смяна на караула в институции и съдебна система.
Намаляването на неравенството е свързано с прекъсване на олигархичните зависимости. Радев често използва банализираната фраза „борба с олигархията“, без да назове нито един олигарх. От трибуната на Софийския икономически форум през януари също се заяви за изгонване на олигархията от властта, за върховенство на правото и за отговорност в държавното управление – все познати лозунги.
ВМРО и БСП декларираха, че са с Радев, очаква се да го направят и от Алианса за права и свободи. ПП–ДБ са готови да си партнират с него за излъчване на парламентарната квота във Висшия съдебен съвет.
Социологът Андрей Райчев не спира да предрича коалиция на формацията на Радев с ГЕРБ и Бойко Борисов. Не чрез Борисов или други силни говорители на ГЕРБ, а чрез партньора на партията – СДС, се дават знаци, че при определени условия би било възможно.
Най-стабилната конструкция е първият и вторият да управляват заедно, по някои теми бихме могли да работим с Румен Радев, основно темата за ориентацията на България – дали продължаваме по пътя, който избрахме преди години и задълбочаване на евроинтеграцията, или преосмисляме мястото, на което страната ни е днес. Ако вървим в една посока по този въпрос, има неща, за които ще можем да водим разговор.
Румен Христов, председател на СДС
Походът на Радев към властта започна. За тези, които не са на ΒΜW, има банани.
An unknown hacker used Anthropic’s LLM to hack the Mexican government:
The unknown Claude user wrote Spanish-language prompts for the chatbot to act as an elite hacker, finding vulnerabilities in government networks, writing computer scripts to exploit them and determining ways to automate data theft, Israeli cybersecurity startup Gambit Security said in research published Wednesday.
[…]
Claude initially warned the unknown user of malicious intent during their conversation about the Mexican government, but eventually complied with the attacker’s requests and executed thousands of commands on government computer networks, the researchers said.
Anthropic investigated Gambit’s claims, disrupted the activity and banned the accounts involved, a representative said. The company feeds examples of malicious activity back into Claude to learn from it, and one of its latest AI models, Claude Opus 4.6, includes probes that can disrupt misuse, the representative said.
Периодът на постепенно настъпване на менопаузата (перименопауза) е известен с клишето за топлите вълни и непостоянните настроения.
Това е най-глупавото клише в историята на глупостите, в историята на клишетата и в историята на жените.
Преминаването от активна фертилна възраст към менопауза е преди всичко криза на идентичността. Почти същата като пубертета, но ако повечето от нас като деца са мечтали и бързали да пораснат, то преходът към „третата възраст“ е свързан основно със загуби и страхове. И макар зрелостта да има своите неоспорими предимства, „застраховката не покрива пълната щета“. Преходът към менопауза е период, в който всяка жена пренаписва себе си. Този период толкова дълго е неглижиран и стигматизиран, че почти всички клишета за него са грешни.
Според статистиката в световен мащаб менопаузата настъпва средно около 51-вата година на жената, а симптомите на перименопаузата – между 45 и 50. Актуални данни от САЩ обаче показват, че значителна част от жените се сблъскват с първите симптоми на перименопаузата преди 40 или дори преди 35 години. Поради твърде ранната поява на тези симптоми те остават неразпознати.
Перименопауза. Менопауза. Това кое беше сега?
Всички знаем какво е пубертет. Термините, които завършват на -пауза ги бъркаме.
Пременопаузата е периодът преди настъпването на симптоми, които сигнализират за намаляване на фертилността при жената.
Перименопаузата е преходният период, в рамките на който хормоналният баланс, поддържащ фертилността, започва да се променя. Това води до широка палитра от физически и психични симптоми, само един от които (и не задължително първият) е нарушение в редовността на менструацията.
Менопауза е понятието, отбелязващо момента, в който в продължение на 12 месеца жената няма менструация.
Постменопаузата е практически целият период след настъпването на менопаузата.
Андропаузата бележи периода, в който намаляването на нивата на тестостерона у мъжа започват да дават симптоми. За мъжкото здраве обаче ще говорим друг път.
Криза на идентичността – не са (просто) хормони
„Жените споделят, че не са себе си“, казва д-р Мери Росър в уебинар, посветен на митовете за менопаузата. Д-р Росър е акушер-гинеколожка, професорка по женско здраве в Колумбийския университет и съавторка на книгата Menopause: What Your Ob-Gyn Wants You to Know. Макар специалността ѝ да предполага грижа основно за репродуктивната система, погледът на Росър като холистична специалистка по женско здраве извежда именно тази характеристика като най-ярък отличителен белег на прехода към менопауза (menopausal transition).
През последните две десетилетия в психологията нараства интересът към изследването на феномена. Много по-голямо влияние за „отваряне“ на разговора за психичните измерения на този период в живота на жената обаче имат популярните жени, които разказват от първа ръка с какво са се сблъскали. От Мишел Обама до Холи Бери, от Салма Хайек до д-р Мери Клер Хейвър, множество известни личности разказаха собствените си истории, за да провокират обществен дебат за женското здраве и качеството на живот на жените над 40-годишна възраст.
Актрисата Джилиън Андерсън, известна у нас с ролята си на детектив Скъли от сериала „Досиетата Х“, например разказва в едно от поредица интервюта по темата как веднъж в осем часа сутринта хвърлила палтото си в краката на децата и се разкрещяла, че „този ден е отвратителен“. Тогава актрисата била на 46. „Бях свикнала да балансирам много неща и изведнъж се почувствах, сякаш не мога да се справя с нищо. Чувствах се напълно изтощена“, разказва Андерсън.
Колежката ѝ Наоми Уотс преживява прехода още по-драматично, сблъсквайки се с ранни симптоми още на 36. След години на трудности, сред които пристъпи на тревожност, депресия, ярост, паника и скръб, Уотс описва преживяванията си в книгата Dare I Say It: Everything I Wish I’d Known About Menopause.
Физиологичните симптоми най-често създават допълнителни предпоставки за психическата картина. Палитрата от възможни проявления на перименопаузата е широка и в различни етапи от прехода към менопауза се наблюдават различни симптоми с различна интензивност. Освен това не всички се срещат при всяка жена.
Промени в настроението
4 от 10 жени споделят, че по време на перименопаузата са преживели промени в настроението, които са им познати от предменструалния синдром. Когато нивата на естроген и прогестерон спаднат по време на перименопаузата, серотонинът също спада, което допринася за повишена раздразнителност, нервност и тревожност. По-високите нива на кортизол – „хормона на стреса“, който се увеличава с възрастта, също могат да създадат чувство на тревожност. Ако симптомите са толкова остри, че правят невъзможно изпълнението на дневните задачи или предизвикват суицидни мисли, препоръката е да се консултирате незабавно с лекар.
Клиничните данни и разкази на пациентки показват, че много жени изпитват промени в оргазма и сексуалната функция по време на перименопаузата и постменопаузата. Често съобщаваните проблеми включват по-дълго време за достигане на оргазъм, намалена интензивност на оргазмите и в някои случаи невъзможност за постигане на оргазъм. Тези промени често са съпроводени от други симптоми, като вагинална сухота, дискомфорт по време на полов акт и променена генитална чувствителност. Намаляването на нивата на естроген по време на менопаузалния преход допринася за промени в кръвния поток, нервната чувствителност и тъканната реакция във вулвата, клитора и вагината. Въпреки разпространението на тези симптоми много жени не получават адекватни насоки или лечение.
Около 60% от жените в менопауза съобщават за проблеми с паметта. Проучване, обхващащо жени в пре-, пери- и постменопауза, открива чрез образна диагностика предимно временни промени в частите на мозъка, отговорни за когнитивните функции. По време на перименопаузата сивото вещество – тъканта, която съдържа повечето нервни клетки на мозъка и е от съществено значение за мисленето, паметта и вземането на решения, временно се свива и ползва повече мазнини и кетони за функционирането си. Образната диагностика показва също промени в областите, които контролират движенията, паметта и емоциите. Окуражаващото е, че след менопаузата обемът на сивото вещество се възстановява и мозъкът се стабилизира и преструктурира за този нов етап от живота.
Главоболие
Колебанията в нивата на естрогена и прогестерона по време на перименопаузата увеличават вероятността за мигрена и както много жени са установили – за менструална мигрена. Тези пристъпи са по-дълги, по-голяма е склонността към рецидив, а също така са по-тежки и по-инвалидизиращи в сравнение с пристъпите в други периоди от менструалния цикъл. Със скъсяването на менструалните цикли по време на перименопаузата менструалните пристъпи се появяват по-често. Горещите вълни и нощното изпотяване нарушават съня, действайки като допълнителен спусък за мигрена. С времето менструациите стават редки и в крайна сметка спират завинаги. Но въпреки това яйчниците все още могат да произвеждат естроген на различни нива в продължение на няколко години. Така че, макар мигрената да намалява с навлизането в постменопаузата, това не е незабавно.
Променящите се хормонални нива по време на перименопаузата и менопаузата пречат на хипоталамуса да регулира телесната температура. Усещането е за внезапен прилив на топлина най-често в областта на лицето, врата и гърдите. В отговор тялото се опитва да се охлади, като се изпотява твърде много.
Безсъние
Проблемите със съня са често срещани сред жените в перименопауза и включват трудности със заспиването, дихателни нарушения (сънна апнея) и по-малко известните двигателни нарушения (синдром на неспокойните крака или периодично разстройство на движението на крайниците). Колебанията в нивата на естроген и прогестерон влияят както върху качеството на съня, така и върху контролирането на движенията. Циркадните промени, намаленото производство на мелатонин и физиологичните изменения, свързани със стареенето и разстройствата на настроението, допълнително изострят нарушенията на съня.
Ставни и мускулни болки
Наблюдения сочат, че ставните и мускулните болки са сред най-сериозните оплаквания на жените в преход към менопауза. Според данните средно около 71% от жените в перименопауза изпитват такива болки, като за разлика от повечето други симптоми на перименопаузата, този не отшумява с настъпването на менопаузата, а рискът от оплаквания нараства с възрастта.
Чести позиви за уриниране
Намалените нива на естрогена водят до отслабване на тъканите на пикочния мехур и уретрата. Те стават по-тънки, по-малко еластични и по-слаби, намалявайки способността на пикочния мехур да задържа урина. Това, наред с резките промени в нивата на хормоните, може да доведе до по-често уриниране, по-често усещане за неотложност, нощно ставане, както и да повиши риска от уринарни инфекции.
Защо се случва всичко това?
Перименопаузата и менопаузата засягат всички системи и функции на жената, но „започват“ от яйчниците: с годините фоликуларният резервсе изчерпва, а с него спадат хормоните, които фоликулите произвеждат и чиято роля е да държат под контрол хипофизната стимулация. Това предизвиква неравномерно покачване на FSH (фоликулостимулиращия хормон) и прояви на дисрегулация на месечния цикъл: в един месец яйчникът реагира добре, в друг – не.
Пропуснатите овулации водят до липса на прогестеронов пик във втората фаза на цикъла, който пък може да стане причина ендометриумът да нарасне твърде много и следващата менструация да е по-обилна. Клиничният резултат се изразява в непредвидими, по-кратки или по-продължителни цикли.
Паралелно с това нивата на другия ключов хормон – естрогена – могат да се люшкат от твърде високи до твърде ниски. Ето защо еднократно лабораторно изследване на хормони в този период не дава достатъчно категорична клинична информация, а от друга страна, кара жените често да се чувстват така, сякаш тялото им променя правилата без предупреждение. Хормоналните изменения могат да доведат до всички изброени симптоми, но при всяка жена се проявява различен набор от тях в различен момент и с различна интензивност.
Да запазиш себе си или да намериш ново аз – кой помага по пътя?
Съвременната медицина предлага редица възможности за намаляване на негативните усещания и дългосрочните усложнения, причинени от симптомите на перименопаузата и менопаузата. Много от тях изискват жените да имат достъп до добре подготвен мултидисциплинарен медицински екип.
Част от решенията обаче са в ръцете на самите жени и са свързани с начина на живот. Отказ от вредните навици (колкото по-рано, толкова по-добре), като тютюнопушене, кафе и алкохол, доказано влияе на облекчаване на част от симптомите. Редовното движение с натоварване на сърдечносъдовата система (кардио) и опорно-двигателния апарат (тренировки с тежести) също е с голямо и дългосрочно значение.
В повечето случаи обаче това не е достатъчнo.
Един от най-хубавите монолози за менопаузата в съвременната популярна култура. Част е от втория сезон на сериала Fleabag.
В зависимост от хода на спада в хормоните, вида и интензивността на симптомите жените могат да получат различни форми на медикаментозна терапия, която да повиши качеството на живота им и да намали дългосрочните негативни ефекти.
В края на 2025 г. Европейското дружество по ендокринология публикува ново Клинично практическо ръководство за лечение и оценка на менопаузата и перименопаузата. Ръководството е разработено от екип ендокринолози и гинеколози и дава насоки както за общопрактикуващите лекари, които обикновено се сблъскват с първите оплаквания на жените, така и за специалисти, които работят с по-сложни случаи.
Една от важните теми, посочени в клиничното ръководство, е приложението на хормонозаместителна терапия. През последните години отношението към нея е нееднозначно и докато едни специалисти я препоръчват като първа линия на въздействие, други все още я отричат категорично. В момента има научен консенсус за множеството предимства на този метод, но той изисква прецизен индивидуален подход заради възможните рискове. Науката за перименопаузата и менопаузата обаче е много нова – едва на няколко десетилетия – и все още има неясноти и значителни промени в разбирането на процесите, особено при различните групи жени.
При ранна менопауза например системната хормонална терапия се разглежда като заместващо лечение, а не просто като „нещо срещу горещите вълни“. Идеята е, че организмът остава без естроген в години, в които би следвало да го произвежда, затова специалистите от Европейското дружество по ендокринология посочват, че в такива случаи хормоналната терапия по правило се препоръчва (ако няма противопоказания) и често се продължава поне до средната възраст на естествената менопауза (около 51 г.) с периодични преоценки. Това има значение не само за симптомите, а и за дългосрочното здраве, например за костната плътност и сърдечносъдовата система, като режимът за конкретната жена винаги се избира индивидуално от специалист.
При менопауза около 50-годишна възраст системната терапия най-често се обсъжда, когато симптомите са осезаеми и пречат на нормалния живот. Балансът полза–риск обикновено е най-благоприятен при здрави жени под 60 г. или в рамките на около 10 години от настъпването на менопаузата, ако няма противопоказания. Основните рискове, които се вземат предвид, са редки, но сериозни: повишен риск от образуване на тромби, от инсулт, както и от рак на гърдата.
Любимият въпрос: къде сме ние?
В България състоянията, свързани с перименопаузата и менопаузата, са лично хоби на тесен кръг специалисти. Лично предизвикателство за жените пък е да открият кои са тези специалисти, и да се доберат до тях, както и да се ориентират, когато моментът настъпи. В актуалните Медицински стандарт по акушерство и гинекология и Фармако-терапевтично ръководство по същата специалност менопаузата се споменава само като период, в рамките на който на жената се случват някакви други неща, представляващи обект на интерес. Самата менопауза обаче не е отделно състояние, изискващо специфични комплексни познания и подход, а перименопаузата изобщо не съществува – дори и като понятие.
В страната ни не се внася нито една трансдермална форма на хормонален препарат, въпреки че тези форми доказано намаляват рисковете от нежелани усложнения. Жени, които имат нужда от подкрепа за справяне със симптомите, споделят, че се сблъскват с неглижиране, защото състоянието им е „нормално за възрастта“ или защото „така ще е“, или пък обратно – защото са „твърде млади“, за да имат симптоми на перименопауза. Липсват мултидисциплинарни екипи, в които специалисти с различни профили (например акушер-гинеколог, ендокринолог и кардиолог) заедно да определят терапията на жена със симптоми, изразяващи се в различни нарушения.
За щастие, световната тенденция не подминава (напълно) страната ни и разговорите за благосъстоянието на жените в преход и в менопауза стават все по-модерни, макар и все още предимно да се опитват да ни продадат нещо и да са далеч от масови, експертни или достъпни за всички заинтересовани и нуждаещи се.
„Анатомия на пола: Жена“ разглежда здравето на жените като неразривна част от обществото, историята и културата. В поредицата изследваме как са се променяли нагласите към женското здраве, как медицината е възприемала специфичните потребности на жените и какви процеси са повлияли на достъпа им до качествени здравни грижи. Вглеждаме се в научните открития, но и в културните митове; в официалните политики, но и в личните истории на жени, борещи се за правото си на здраве и достойнство.
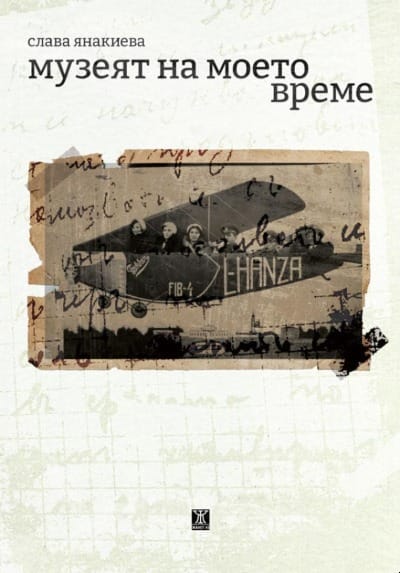
Аз ли развих вкус към мемоаристиката, или съществува обществена тяга към нея? Повече мемоарни книги ли се появиха, или аз остарявам и почвам да ги забелязвам?
Така или иначе, „Музеят на моето време“ на Слава Янакиева ми попадна не само скоро след спомените на Алберт Бенбасат, Жюстин Томс, Людмила Миндова, а и успоредно с куп други книги, опитващи се да съхранят отдавна изгубени времена и светове. Заравяйки се в проучвания, усещам как първо посягам към мемоара и чак после – към стандартната, „голяма“ история. Имам обяснение.
Колкото повече разнопосочни източници на информация ни заливат, колкото повече се усъмняваме в истинността на думи, снимки, кадри, анализи, колкото повече усещаме как думата „факти“ ожълтява и се превръща в тесте от „сензации“, толкова повече ценим личното свидетелство.
Този го познавам. Това ми се случи. Това се е случило в моето семейство. Това се наричаше така и така. Неслучайно горе изброих спомените на автори, които познавам лично, а не, примерно, мемоарите на Бенджамин Франклин. Събрани заедно, те започват да плетат една
лична история на света „отвътре“, история на малкия домашен свят, ризоматична история, която не върви линейно от корена през стъблото към клоните и листата, а се свързва подземно ту в едно, ту в друго разклонение.
Заглавието на „Музеят на моето време“ е добре подбрано: музеите са държавни институции, които управляват паметта. Домовете обаче също са музеи, в тях също има вещи, които говорят за миналото, и също има памет и разказ. За разлика от официалния, този разказ има много глаголни времена. Има минало, за което не можеш да питаш – като убития от Народния съд дядо Никола. Има бъдеще, което е отказано – като професионалния път на бащата и лелята. Има сегашно премълчано – като роднините от Америка, чиито посещения будят небивали вълнения в домакинството, но са крайно неподходящи адресати за училищни писма по образец.
И тук има два плана на четене: на съпреживяването и гнева, от една страна, и на удивлението каква литература се получава по тези правила, от друга. Защото мемоарите по принцип – а тези още повече – винаги се колебаят между стремежа към максимална истинност и стремежа към увлекателност. Затова между сериозните теми тържествено се мъдри „принцеса“, наричана още „странджанка“, „сакарка“ и дори „людмилка“ (гениално название!); затова в музея важно е изложено „кървавото писмо“ на невръстния още баща и едно друго момченце срещу „двете Мимита“. И в рецитацията на Вапцаров, в която вместо „Майко! Фернандес убит…“ идва името на Фернандел.
Ето нещо, което официалната история никога не си позволява да прави – да се смее.
Не че и тя не се води по правилата на литературата (завръзки, кулминации, развръзки, протагонисти, антагонисти и пр.), но почти задължително се придържа към жанра на трагично-героичния епос. А личната история оцелява в смеха. В личното си естество всички сме трагикомедии. Да живее мемоаристиката!
София: Университетско издателство „Св. Климент Охридски“, 2025
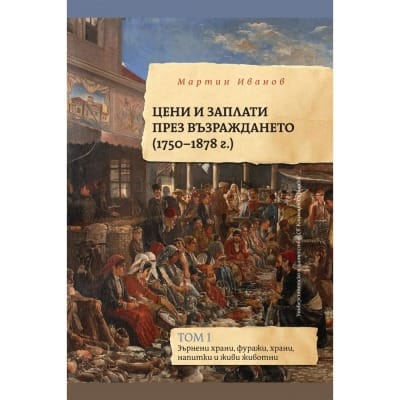
Другата книга в днешния обзор изглежда диаметрално противоположна. Едната е субективен, личен опит, другата е неутралният глас на статистиката. Страници след страници списъци с цени на основни стоки през Възраждането и само в началото на главите – обзор и анализ. Видимо предназначено за учени, както и подобава на книга на университетско издателство. Защо тогава ви говоря за нея?
Защото е друга стратегия към истината в постистинния свят: този път не през гаранцията на личното свидетелство, а през гаранцията на изчерпателността. Фактите са „факти“, когато единичното е извадено от контекст; когато е избрано сензационното или пък желаното, ласкателното, очакваното, уличаващото – в зависимост от целите на подбиращия.
Дори човек да не си измисля, може да разкаже много различни истории – и свои собствени, и на семейството си, камо ли пък на страната си – само като навързва различни комбинации от случки.
Историческата наука обаче не би трябвало да го прави – и изследването на Мартин Иванов показва как е възможно да се обработят наличните масиви от данни, за да се стигне до доказуема истина по отношение на миналото. В случая разбираме какво е купувал и какво е продавал възрожденският българин, как се е хранил, какво е произвеждал и т.н. Популярността на дадена стока се доказва с броя цени, които са намерени за нея – и може да разкрие например съотношението на отделни храни в менюто или сравнителния престиж, който е носила всяка от тях. Като обикновена любопитна читателка забелязвам сладокусните факти – за многото превъплъщения на захарта, не само познатия ми небетшекер и захар на пръчки, но и примерно, захарното мезе (със сол, захар, оцет и сирене); за ориза като луксозна храна (особено пък пълнен в зеленчук), за странната липса на интерес към плодовете (освен за ракия) и т.н.
Но смисълът на тази книга далеч надхвърля кулинарния куриоз – тя е важна основа за изследване на стопанската дейност, за търсене на отговор на въпроса кога и как се заражда вътрешният български стопански пазар,
какво го мотивира, как му се отразяват различните политически събития и пр. В изследването на проф. Румен Аврамов върху стопанския XX век на България например пише, че Освобождението се отразило пагубно върху занаятите поради прилива на фабрично произведени европейски стоки; в настоящото изследване на цените пък ми направи впечатление например джелепкешанството в Копривщица – събирането и отвеждането на овце за нуждите на османската армия. След Освобождението с тази професия било свършено; в друг източник четем, че Копривщица пообедняла, защото огромните стада нямало къде да зимуват (преди зимували край Бяло море) и половината животни измрели.
Вероятно това обяснява защо прапрабаба ми, родена копривщенка, заминава с мъжа си за Одринско – от освободените територии към неосвободените; придвижване, което идеята за копривщенския просперитет не би могла да обясни. Ето че от общото пак стигнахме до частното.
Но това е неизбежно, защото съм частен читател; по-едрите изводи оставям на кръга историци, чиито изследвания са естественият контекст на тази книга: Стефан Дечев, Райна Гаврилова, Румен Аврамов и пр. И на тези след тях, разбира се.
Личните спомени разкриват друг свят – например такъв, в който има поравно мъже и жени, в който хората пазаруват, работят, сядат на масата, хранят се, вместо само да завоюват и да губят територии, и понякога да сменят системата на управление. Този личен свят е много подобен на нашия – но започва да ни гложди мисълта доколко е представителен. Да речем, знам, че прабаба ми е правила рачел – мога ли смело да кажа, че рачелът е бил популярен десерт преди 100 години в България? А преди 150?
Изследването на Мартин Иванов събира в едно всички налични цени на стоки по българските земи през Възраждането. То е изключително любопитно в контекста на дългогодишните усилия на българските учени да разкрият и другото лице на историята – историята на човешкото всекидневие от всички социални слоеве. Взети заедно, тези изследвания дават надежда, че познанието за света – такъв, какъвто го преживяваме – може да бъде запазено.
Разбира се, с дългите списъци от цени книгата има функцията повече на справочна, отколкото на прочитна литература. Но аз имам личен наглед как статистиката се превръща обратно в живот: дъщеря ми, бивша студентка на доц. Иванов, имаше за курсова работа да анализира три лични тефтера за приходи и разходи, та чух със собствените си уши как литературата оживява от голите данни, как виждаме богатите братя, канени навсякъде на кръщенета, бедния развейпрах, харчещ каквото няма за напитки и дрехи, и т.н. Тук пък покрай статистиката оживяват пазарът и паницата – и свързаният с тях живот.
В емблематичната си колонка „Ходене по буквите“, започната още през 2008 г. във в-к „Култура“, Марин Бодаков ни представяше нови литературни заглавия и питаше с какво точно тези книги ни променят. В началото на 2020 г. той я пренесе в „Тоест“. Вярваме, че е важно тази рубрика да продължи. От човек до човек, с нова книга в ръка. От края на 2021 г. по буквите тръгна Зорница Христова.
Активните дарители на „Тоест“ получават 20% отстъпка от коричната цена на всички книги на над 15 български издателства. Кои са те – вижте в условията на Читателски клуб „Тоест“.
Тази информация беше изпратена на над 3000 абонирали се за бюлетина на Glasvam.org заедно с новини и полезни съвети за подготовката и провеждането на гласуването в чужбина.
На 19-ти април 2026 ще се проведат избори за Народно събрание. Вече може да подавате заявление за гласуване зад граница. Ще намерите формуляра на страницата на ЦИК. Там може да проверите и дали правилно е записано заявлението ви. Ето няколко важни неща, които трябва да знаете:
Крайният срок за подаване е 24-ти март в полунощ българско време
Подаването на заявление за гласуване в секцията най-близо до Вас, ще Ви улесни и ще ускори изборния процес, тъй като ще сте вече вписани в списъците
Заявление се подава за всеки вот поотделно. Т.е. не се пренасят от предходни избори
Дори да подадете заявление, а се окаже, че на 19-ти април сте в България, ще може да гласувате в секцията си по постоянен адрес с попълване на декларация
Вече са предварително одобрени 372 места за секции в чужбина, където в последните 5 години е имало поне 100 гласували. Това е наполовина от минали години и причината са промените в Изборния кодекс ограничаващи секции извън Европейския съюз и възможността за автоматично отваряне на база висока активност до сега. Повече за това може да прочетете в тази статия.
За отваряне на секции извън Европейския съюз остава единствено възможността да се съберат поне 40 заявления.
Предварителното одобрение не означава, че непременно ще има секции на тези места. Това зависи от възможностите на помещенията и дали има комисии и доброволци към тях. Решението е на ЦИК по препоръка на Външно. Могат да се увеличат шансовете като се подават заявления за тези места и повече хора се включат като членове на комисии и доброволци.
На някои места като Германия е нужно да се иска разрешение от местните власти. Това вече би трябвало да се случва предвид предварително одобрените места. Очакваме информация от МВнР
Подаването на заявления освен, че подпомага изборния процес, показва и повишен интерес на съгражданите ни в чужбина към вота
Както описах подробно в предишната ми статия, на този вот трябваше да има избирателен район Чужбина с 4 депутата, които щяха да представляват единствено българските граждани зад граница. Тази възможност обаче беше отложена с още три години след промените в последния момент на Изборния кодекс.
Събирането на заявленията ще може да следите в реално време на картата, както и на подробната таблица. Заради допълнителни бариери на сайта на ЦИК на последните няколко вота не не можех да зареждам автоматично данните за броя подали заявление. Намерих начин, но този път е възможно отново да ме блокират нарочно, което ще спре и данните в таблицата. Повече информация ще намерите на сайта на ЦИК и МВнР.
In a previous post, we discussed Project Bonsai, our initiative to reduce the Grab app’s download size. We successfully reduced the Android Application Package (APK) download size by 26%. This reduction offers a substantial advantage: it minimizes download friction, allowing users to download the app, even on slower networks. However, the battle for storage doesn’t end after installation.
The Grab app includes a wide range of features and workflows that heavily depend on image content, particularly in services like transportation and e-commerce. Although some images are packaged within the app binary, a large majority are downloaded from Grab’s server at runtime. To optimize the app’s performance and minimize server expenses, the downloaded images are cached in the app’s storage. This reduces both load times and traffic to Grab’s image server, resulting in better user experience and lower costs. Although we use Least Recently Used (LRU) cache to manage storage, many images can remain in the app storage for extended periods, even if they are no longer relevant.
This blog details how we addressed this challenge in our Grab Android app by evolving our standard LRU cache into a Time-Aware Least Recently Used (TLRU) cache. This evolution allows us to reclaim storage space without compromising user experience or increasing server costs.
Understanding LRU cache limitations
Note: In this article, when “cache” or “image cache” is mentioned, it specifically refers to disk cache, which is the persistent storage on the device’s file system, rather than in-memory cache.
The Grab Android app uses the Glide library as its primary image loading framework. Glide provides excellent features for efficient image loading, caching, and display. At its core, by default, Glide uses a cloned version of Jake Wharton’s DiskLruCache for disk-based caching.
To prevent unlimited cache growth, we configured the LRU cache with a maximum size limit of 100 MB. However, our analytics revealed that the 90th percentile (P90) of users were consistently reaching this 100 MB limit, meaning the cache was constantly at capacity. Conversely, for users whose cache hadn’t yet reached the 100 MB threshold, images were never removed, even if they were outdated by several months and no longer relevant.
Our analysis revealed that image caching was a major contributor to the app’s disk footprint, and without proactive management, this would only worsen as we continued adding features and content to Grab’s superapp.
How DiskLruCache works
The LRU cache algorithm manages storage by maintaining entries in access order and automatically evicting the oldest unused entries when space is needed.
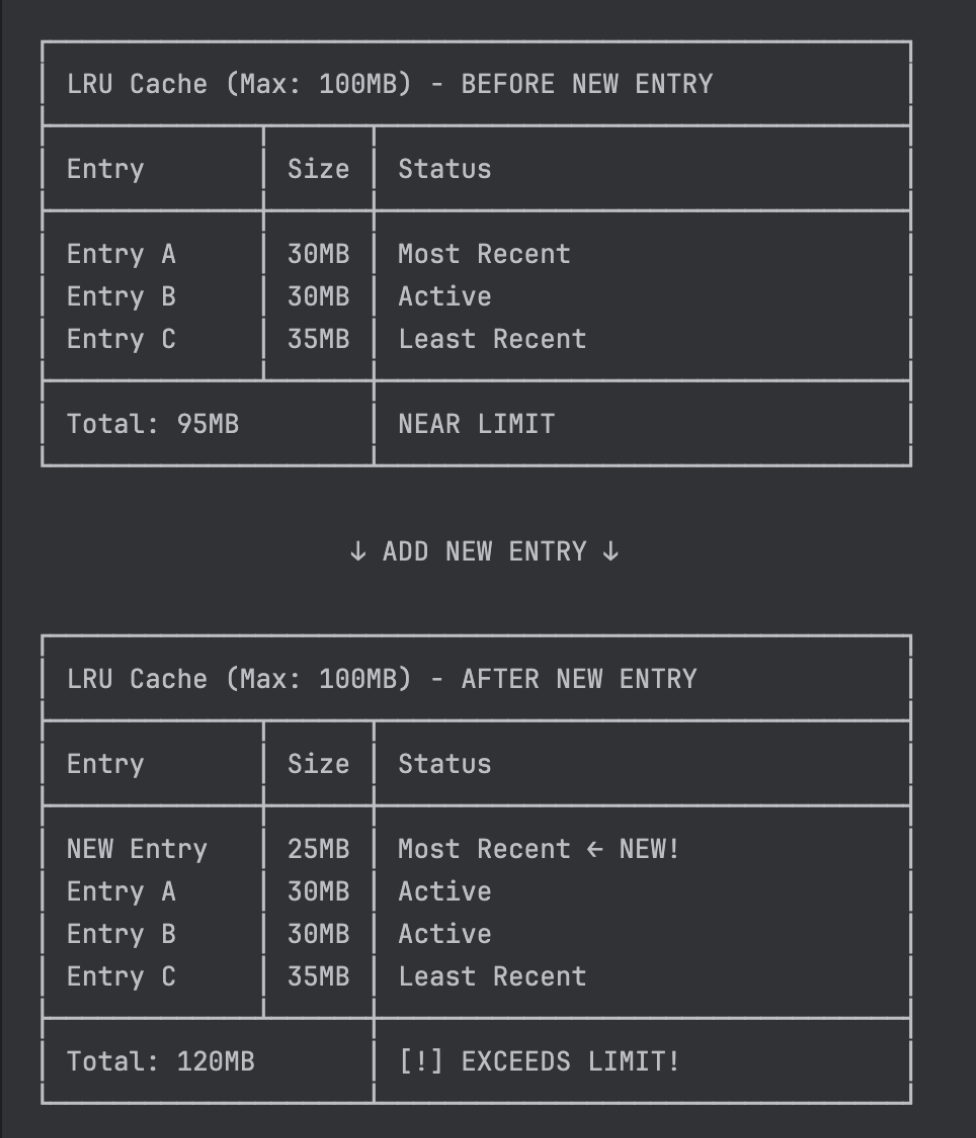
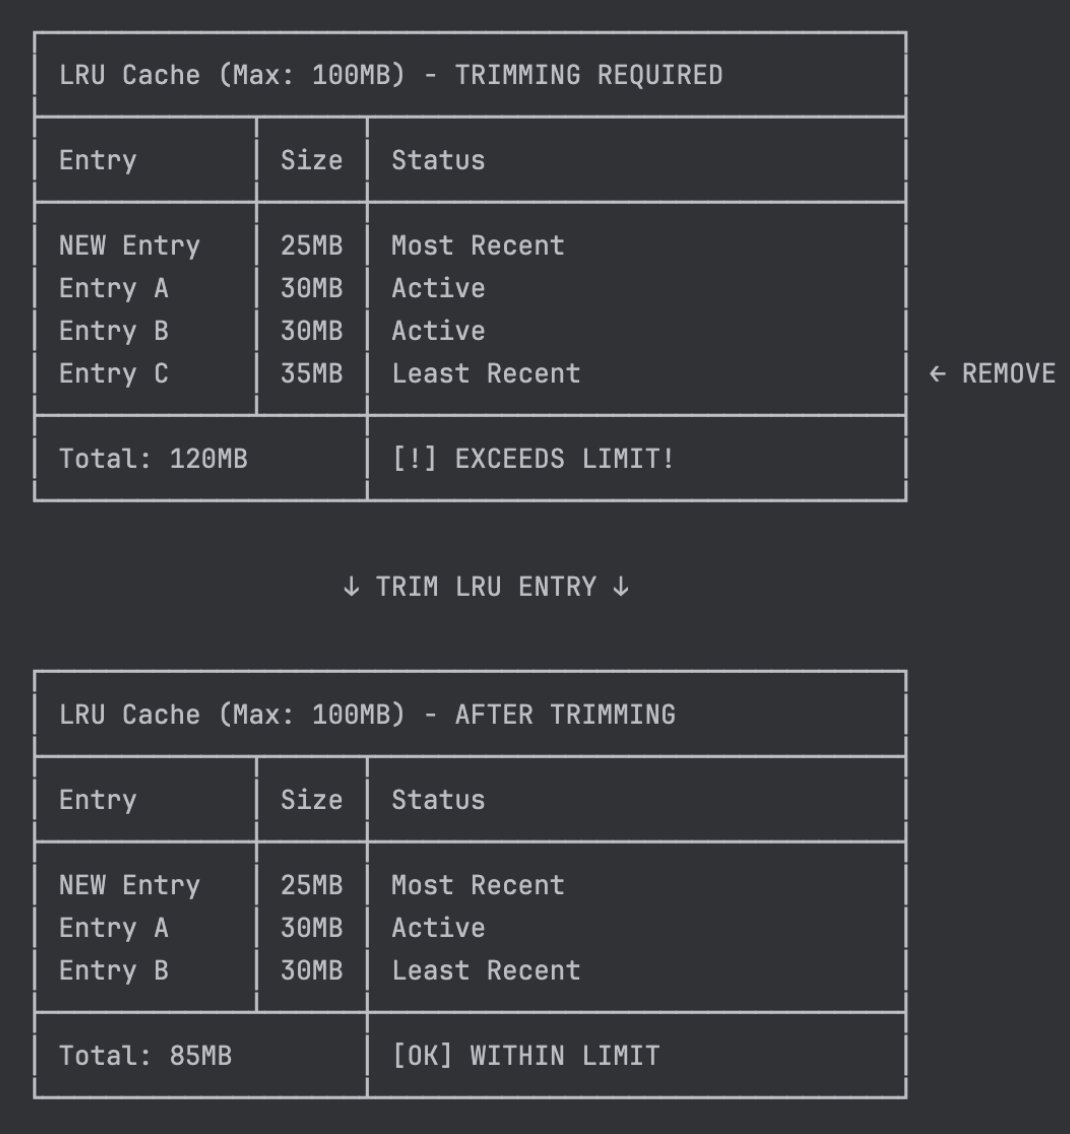
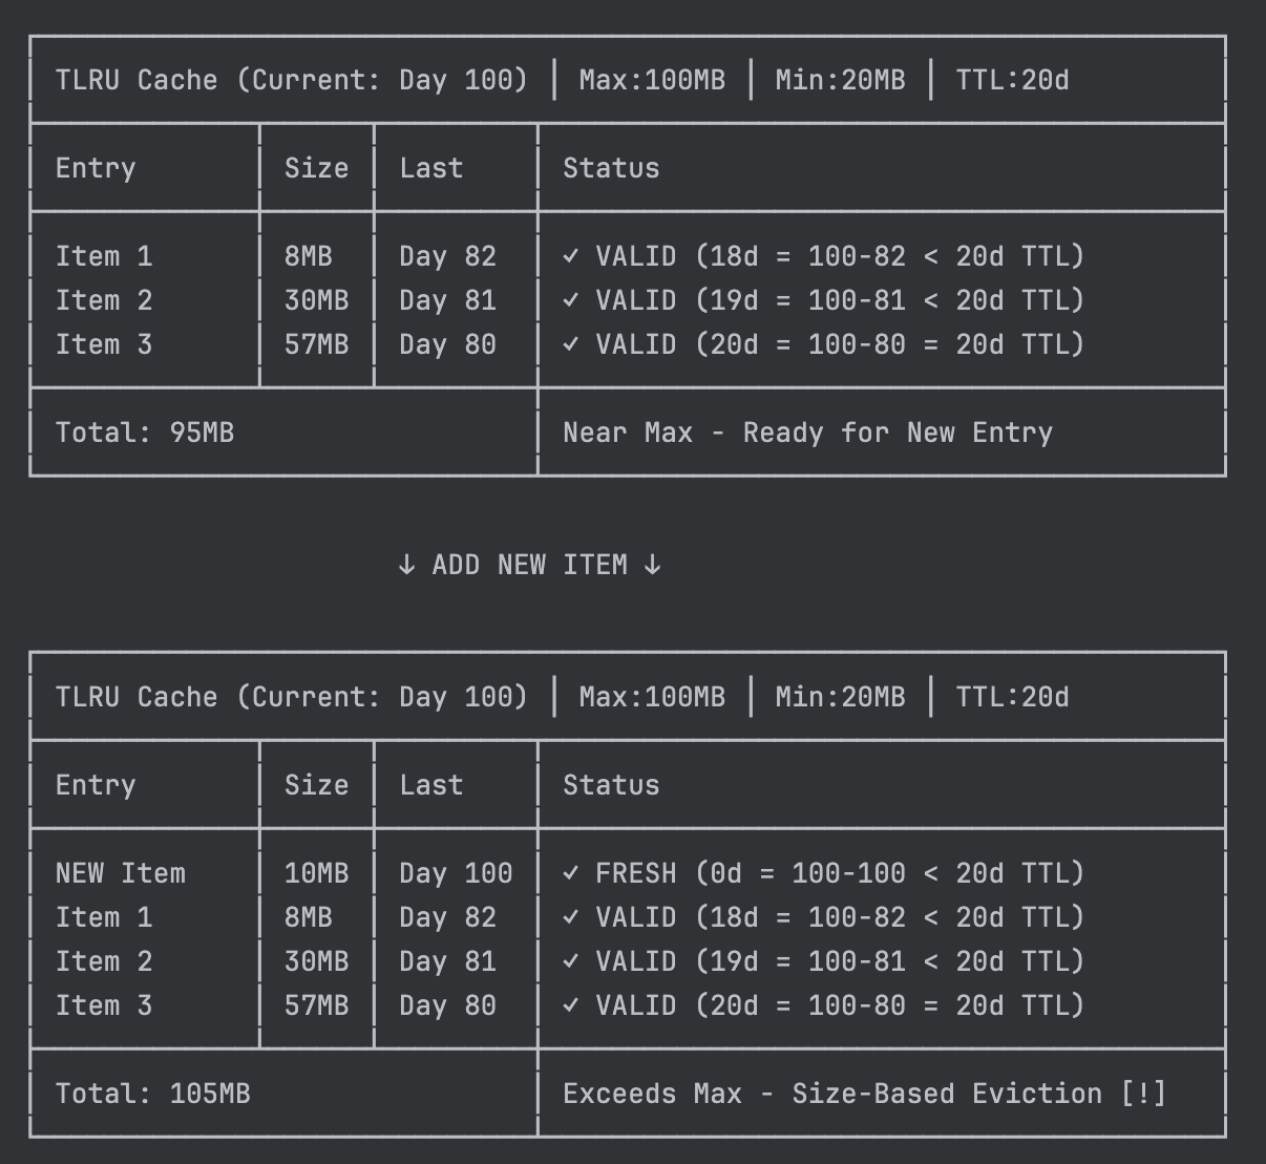
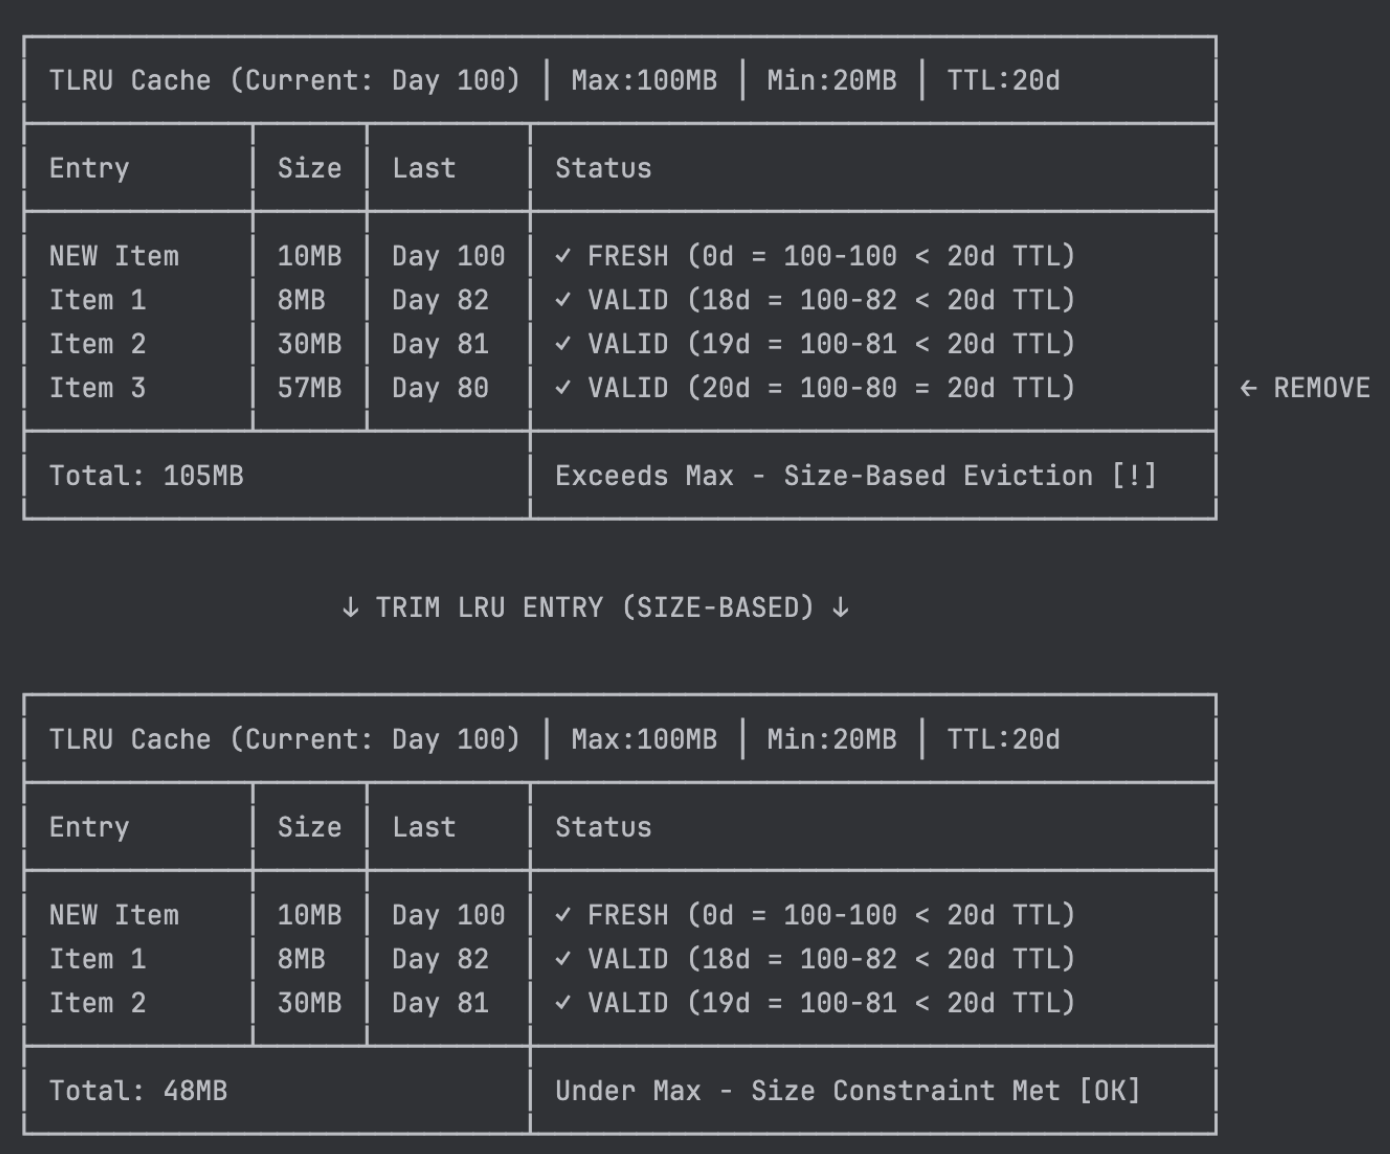
Figure 1 and 2 illustrates how LRU cache trimming works. These diagrams present an LRU cache with a maximum size of 100 MB containing three cache entries totaling 95 MB. When a new 25 MB cache entry is added, it exceeds the cache’s maximum size.
Figure 1. A new cache entry is added to an LRU cache that’s near its 100 MB capacity, exceeding the limit.
Figure 2. The LRU cache automatically trims the least recently used entry to bring the total size back within the 100 MB limit.
The challenge
While DiskLruCache efficiently manages cache size, it has a critical limitation: It does not account for the age of cached content. Due to the lack of time-based eviction rules, the cache does not remove outdated entries until it exceeds the maximum size. This meant that stale promotional images, images from infrequently used features, and outdated content continued occupying disk space indefinitely, as long as the cache remained under the size limit.
What we needed was a cache mechanism that could:
Maintain LRU cache benefits: Preserve efficient caching for users who actively use the app features.
Remove stale content based on time: Automatically identify and evict outdated entries, not just rely on storage constraints.
Protect user experience: Ensure images still load quickly without cache misses.
Keep server costs low: Avoid increased server requests from premature cache evictions.
These requirements pointed us toward an enhanced LRU approach. We needed to enhance LRU with time awareness while preserving its proven size-management capabilities.
TLRU cache: The solution
To address these limitations, we developed a new LRU cache variant named TLRU that extends traditional LRU by introducing time-based eviction while maintaining size-based cache management.
Core TLRU attributes
TLRU introduces three core attributes to manage cache entries:
Time-To-Live (TTL): A threshold that determines when a cache entry is considered expired. An entry is expired if (current_time - last_accessed) > TTL. Expired entries are automatically removed during cache operations.
Minimum cache size threshold: A safety net that ensures a baseline set of essential images always remains cached, even when entries expire. This prevents complete cache deletion when users haven’t used the app for more than the TTL period, maintaining app responsiveness for returning users instead of starting with an empty cache.
Maximum cache size: Inherited from LRU cache, this enforces the upper storage limit (100 MB in our case). When exceeded, the least recently used entries are evicted regardless of their age.
Together, these attributes ensure TLRU maintains optimal cache size by managing both storage constraints and temporal relevance, reducing app disk footprint without impacting user experience.
TLRU cache trimming in action
To better understand how TLRU works in practice, let’s walk through a comprehensive example. The following diagrams demonstrate how the TLRU cache evaluates and trims entries based on both time and size constraints.
Our TLRU cache configuration includes:
Maximum cache size: 100 MB – the storage limit that triggers size-based eviction.
Minimum size threshold: 20 MB – the safety net that protects essential cached content.
TTL: 20 days – entries older than this are considered expired.
Each cache entry includes last_accessed metadata containing the timestamp of its most recent access. When an entry is first created, this timestamp is initialized with the creation time. This timestamp determines whether an entry has expired based on the formula:
Entry is expired if: (current_time - last_accessed) > TTL
For this walkthrough, we’ll use current_time = Day 100 as our starting point.
Initial cache state analysis
Our example begins with three existing cache entries totaling 95 MB, approaching the 100 MB limit:
Item 1 (8 MB, last accessed Day 82): At 18 days old
Item 2 (30 MB, last accessed Day 81): At 19 days old
Item 3 (57 MB, last accessed Day 80): At exactly 20 days old, valid at the TTL threshold
When a new 10 MB item is added on Day 100, the cache grows to 105 MB, exceeding our 100 MB limit and triggering size-based eviction.
Figure 3. Initial TLRU cache state and the impact of adding new entries.
Size-based eviction process
When the cache exceeds its 100 MB limit, TLRU applies traditional LRU eviction logic. Item 3 is selected for eviction because:
It is the least recently used entry (oldest access time).
This demonstrates TLRU maintaining LRU behavior for size enforcement, regardless of expiration status.
Figure 4. Size-based eviction removes the least recently used entry to enforce storage limits.
Time-based eviction process
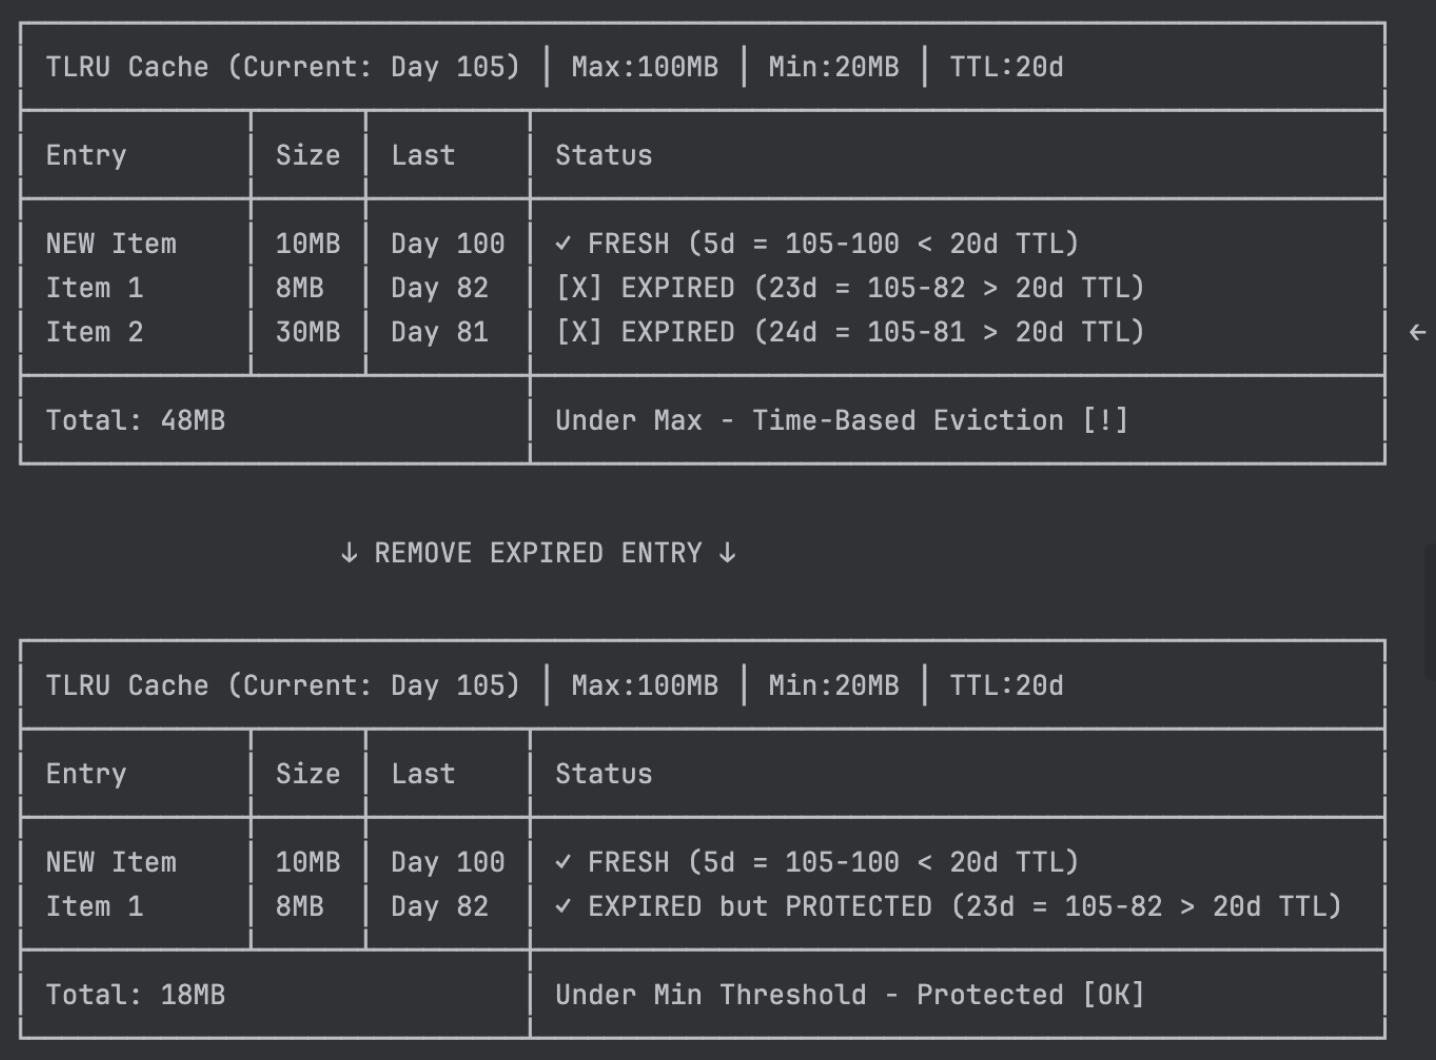
Five days later (Day 105), Item 1 and Item 2 cross the expiration threshold:
Despite operating well below the size limit (48 MB < 100 MB), TLRU evaluates expired entries for time-based eviction. Item 2 is removed because it’s expired, and the cache remains above the minimum threshold. Item 1, although also expired, is protected by the minimum threshold rule; removing it would leave only 10 MB, which falls below the 20 MB minimum.
Figure 5. Time-based eviction and minimum threshold protection working together.
TLRU behavior summary
This comprehensive example demonstrates TLRU’s three core mechanisms:
Size-based eviction: Enforces storage limits using traditional LRU ordering (Item 3 removed despite being valid).
Time-based eviction: Proactively removes expired content when safe to do so (Item 2 removed for age).
Minimum threshold protection: Preserves essential cache functionality even with expired content (Item 1 protected despite expiration).
Technical implementation
Rather than building an image cache from scratch, we recognized that Glide’s bundled DiskLruCache (originally from Jake Wharton’s implementation) already provided a mature, battle-tested foundation. This implementation is widely adopted across the Android ecosystem and handles complex edge cases like crash recovery, thread safety, and performance optimization that would require substantial effort to replicate.
Our approach was pragmatic, we cloned Glide’s DiskLruCache and extended it to support time-based expiration. This strategy allowed us to inherit the existing reliability while adding the temporal awareness we needed for TLRU.
To understand our implementation, we’ll first explore how the original DiskLruCache works, then dive into the specific modifications we made to transform it into TLRU.
Understanding DiskLruCache
DiskLruCache provides a simple cache solution that stores key-value pairs on disk, while also keeping track of their usage to evict the least recently used items when the cache reaches its maximum size. Here is an overview of how DiskLruCache is implemented:
Data storage: DiskLruCache stores its data in a specified directory, creating files for each entry.
Key-based access: Each entry has a unique key (typically a hash generated by the image loader) used to create the filename of the cached entry.
Atomic writes: When adding an entry, it creates a temporary file and writes the data to it. If successful, it atomically renames the temporary file to the final filename.
Cache retrieval: When reading from the cache, it looks up the key, opens the corresponding file on disk, and returns an InputStream to read the data.
Size management: It maintains a maximum cache size limit. When exceeded, it removes the least recently used items until it is within the specified limit.
The central component that enables this functionality is the journaling mechanism, detailed in the following section.
The journaling mechanism
The journaling mechanism in DiskLruCache is designed to maintain consistency and prevent data corruption in the cache. The journal file records all cache operations, such as adding, updating, or removing entries. The journaling mechanism is essential in rebuilding the cache metadata during initialization and performing journal compaction to clean up the journal file.
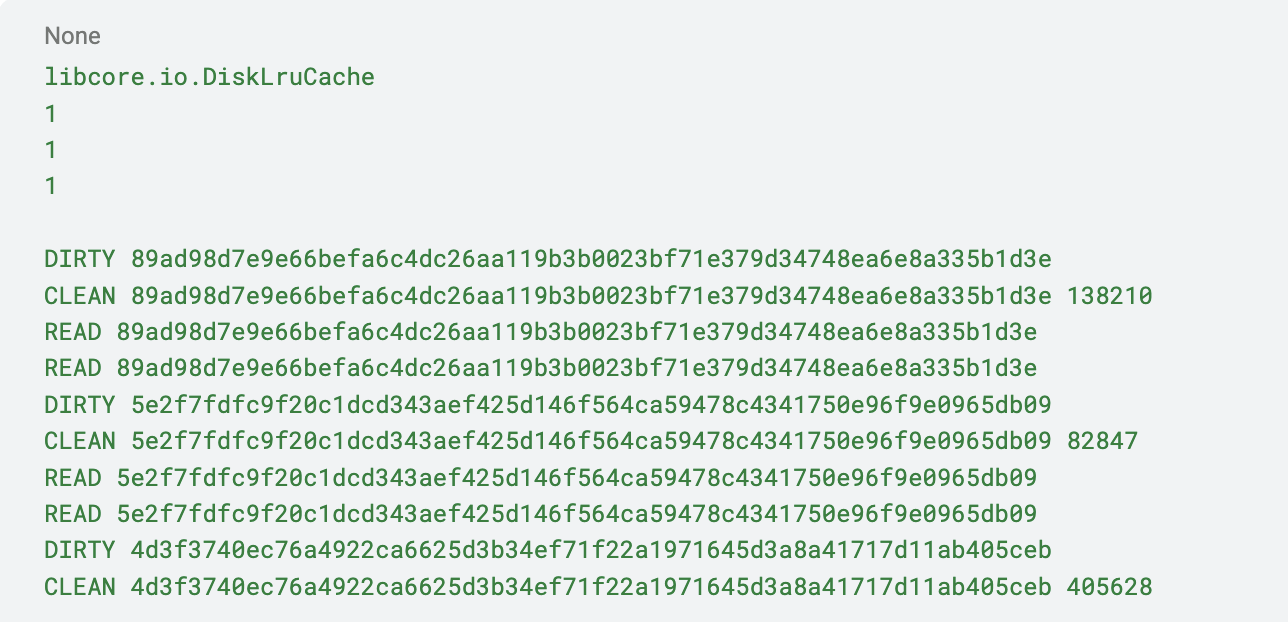
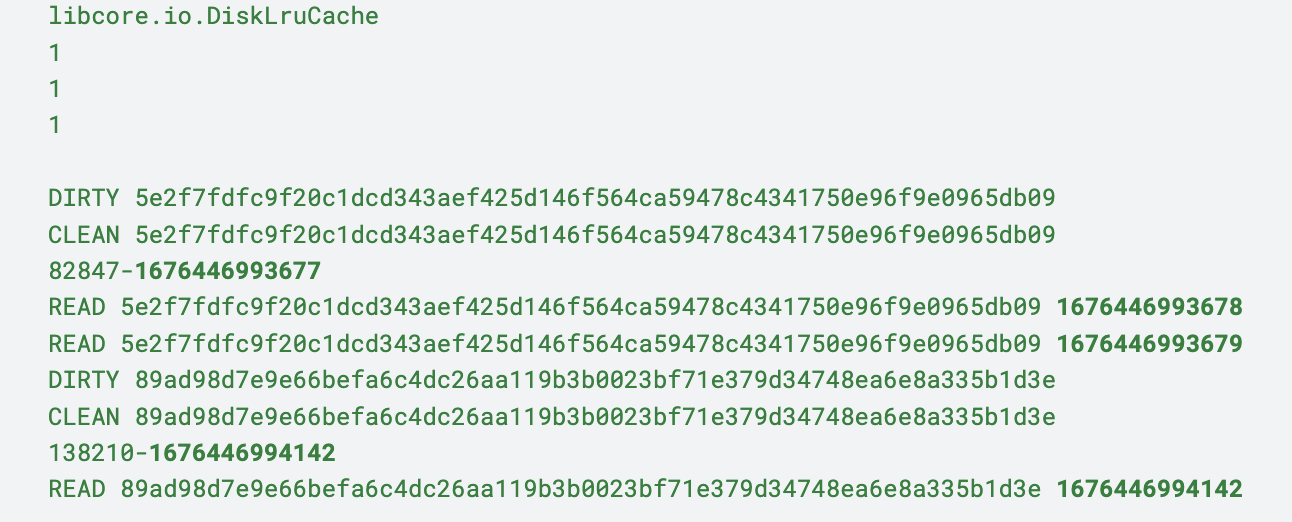
Figure 6. Example of the journaling mechanism in DiskLruCache.
Journal file format:
The journal file is a plain text file that records cache operations line by line.
DIRTY: Indicates the start of a write operation to a cache entry.
CLEAN: Indicates that a cache entry was successfully written and closed.
REMOVE: Indicates that a cache entry was removed from the cache.
READ: Indicates that a cache entry was read.
To gain a comprehensive understanding of the journal file format, refer to the following detailed explanation.
Key information: Each line includes the key and other relevant information, such as the lengths of the cache entry files.
Cache initialization: Upon initialization, DiskLruCache reads the journal file to reconstruct cache metadata in memory, determining file associations, lengths, and access order. If the journal file is corrupted or missing, the cache will be considered invalid, and DiskLruCache will remove all cache files and start fresh.
Cache operations and journal updates: When performing cache operations like adding, updating, or removing entries, DiskLruCache appends corresponding lines to the journal file, recording the operation details. For example, when starting to write a new cache entry, it writes a DIRTY line with the key, and when the write is successful, it appends a CLEAN line with the key and lengths.
Synchronization and consistency: DiskLruCache uses synchronization to ensure that only one thread can access the cache at a time, preventing race conditions and data corruption. It also uses a journalWriter (java.io.Writer) instance to append operations to the journal file, ensuring that the file is always in a consistent state.
Journal compaction: Over time, the journal file may grow with redundant operations. DiskLruCache periodically compacts the journal by creating a new file that contains only the current cache metadata, then atomically replaces the old file. The compaction process usually happens when the journal file size exceeds a certain threshold.
DiskLruCache ensures consistency and prevents data corruption by using this journaling mechanism, making it a reliable solution for disk-based caching.
Modifying DiskLruCache for TLRU
With a solid understanding of DiskLruCache’s architecture, we can now explore how we extended it to implement the TLRU cache attributes defined earlier.
To support time-based eviction, the cache needs to track when each entry was last accessed. This information m ust persist across app restarts, so it’s stored in the journal file itself.
The timestamps are added to READ and CLEAN operations:
READ entries record when a cache entry is accessed, updating its last-access time.
CLEAN entries record the creation time when a new entry is successfully added to the cache.
Figure 7. Example of a TLRU journal file.
Time-based eviction logic
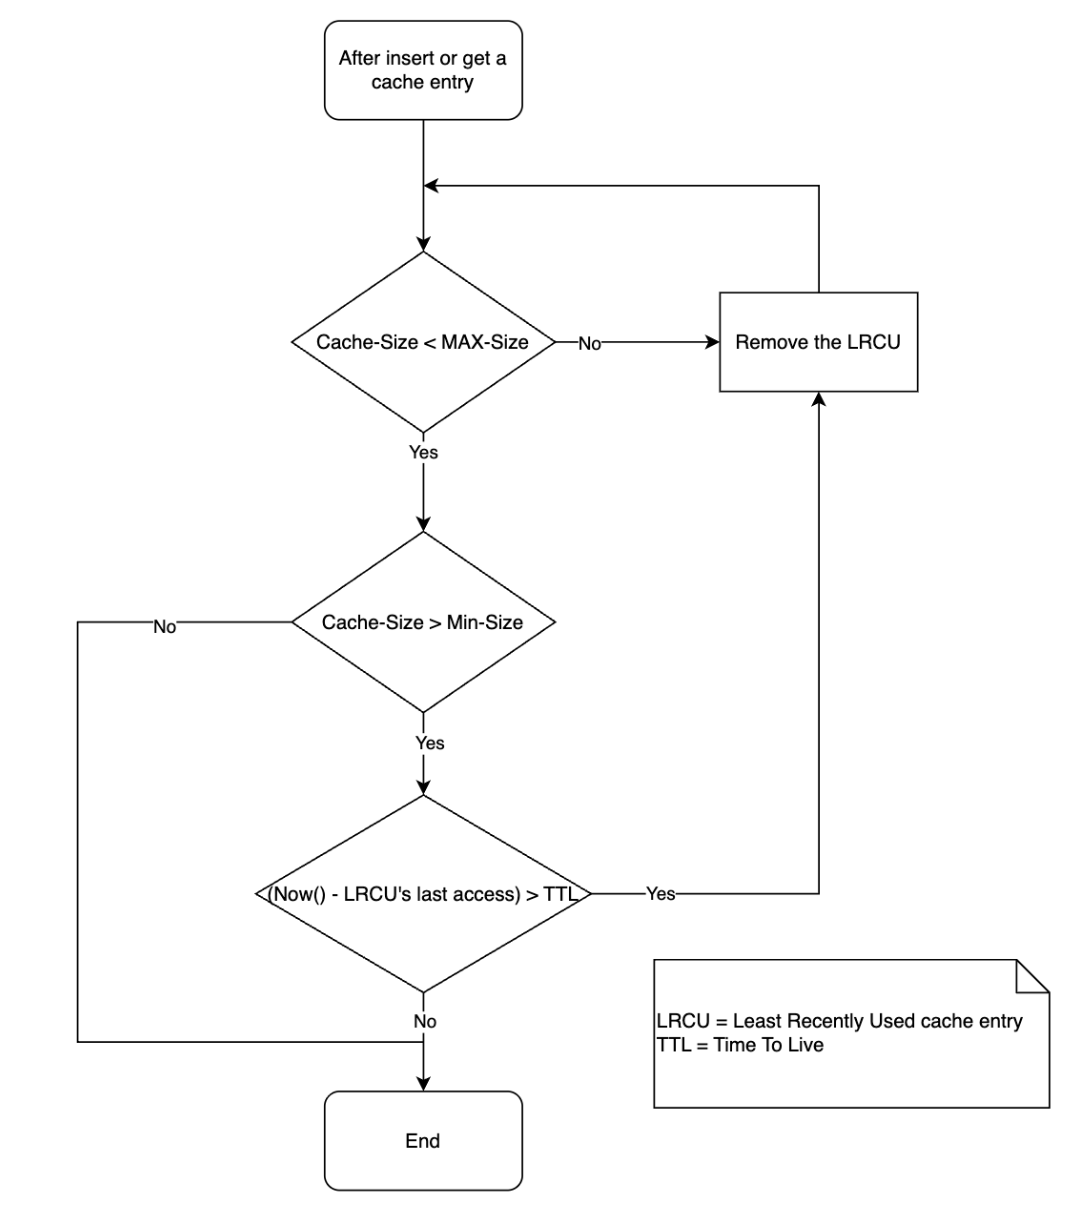
The TLRU cache leverages the existing LRU ordering to optimize expiration checking. For each cache operation, it checks if the least recently accessed entry has expired before proceeding with time-based trimming.
The diagram below shows how the TLRU cache makes the decision to remove the cache entries.
Figure 8. TLRU eviction decision flow – evaluating cache entries based on time expiration and size constraints.
The algorithm leverages the sorted nature of the cache: if the least recently accessed entry hasn’t expired, no other entries need checking. If it has expired, the cache trim operation walks through entries from oldest to newest, removing all expired ones.
Backward-compatible migration
With an extensive user base, invalidating existing cached images would cause millions of users to experience poor performance while creating massive server traffic spikes and infrastructure costs.
One of the challenges was retrieving last-access timestamps from existing LRU entries, as file system APIs do not offer reliable access time data. Our solution was to set the last-access time of all existing entries to the migration timestamp. This approach preserves all cached content and establishes a consistent baseline, although it necessitates waiting one TTL period to realize the full benefits of eviction.
We also ensured bidirectional compatibility – the original LRU implementation can read TLRU journal files by ignoring timestamp suffixes, enabling safe rollbacks if needed.
Upon completing our TLRU implementation, we focused on determining optimal values for the three core attributes: TTL duration, minimum threshold, and maximum cache size. These parameters are crucial for balancing storage optimization and cache performance, requiring careful tuning based on real user behavior.
Finding optimal configuration values
Finding optimal configuration values requires systematic experimentation and data-driven decision-making. Controlled experiments to compare the cache hit ratio with baseline LRU performance must be conducted.
Note: Cache hit ratio, our key success metric, gauges efficiency by the percentage of requests served from cache versus requiring server downloads. Lower ratios lead to higher server costs and increased user data consumption.
Our success criteria is for a cache hit ratio decrease of no more than 3 percentage points (pp) during the transition to TLRU. For instance, a decrease from 59% to 56% hit ratio would result in 7% increase in server requests. This threshold balances storage optimization with acceptable performance impact.
To mitigate potential server cost impact from our maximum acceptable 3 pp cache hit ratio drop, we worked with the server team to optimize image delivery infrastructure, enabling a confident TLRU rollout without infrastructure cost concerns.
Impact and results
After fully rolling out TLRU to production, we significantly optimized storage while preserving user experience. Post-implementation stabilization, the P95 total app size reduced by approximately 50 MB. This meant that 95% of our users experienced storage reduction up to 50 MB, with the top 5% seeing even greater savings.
With over 100 million downloads of the Grab Android app, even conservative estimates show terabytes of storage reclaimed across all user devices worldwide. This translates to better device performance, especially on low-end devices, and improved user satisfaction.
Critically, we maintained our success criteria: cache hit ratio stayed within target thresholds (no more than 3 pp decrease), with no increase in infrastructure costs. The seamless migration preserved all existing cache data without disruption.
Conclusion
At Grab, we believe that every byte matters. Our users trust us with their device storage, and we take that responsibility seriously. The TLRU implementation exemplifies our commitment to user experience. We don’t just build features, we optimize them to ensure our app respects our users’ devices. The petabytes of storage reclaimed across millions of devices aren’t just a technical achievement; it’s a reflection of our dedication to creating a lighter, faster, more respectful mobile experience.
The implementation demonstrates that meaningful improvements can be achieved through thoughtful modifications to existing, well-tested libraries. Our focus on backward compatibility and safe migration ensured zero disruption for Grab’s users, proving that user experience and technical innovation can coexist.
Join Us
Grab is Southeast Asia’s leading superapp, serving over 900 cities across eight countries (Cambodia, Indonesia, Malaysia, Myanmar, the Philippines, Singapore, Thailand, and Vietnam). Through a single platform, millions of users access mobility, delivery, and digital financial services, including ride-hailing, food delivery, payments, lending, and digital banking via GXS Bank and GXBank. Founded in 2012, Grab’s mission is to drive Southeast Asia forward by creating economic empowerment for everyone while delivering sustainable financial performance and positive social impact.
Powered by technology and driven by heart, our mission is to drive Southeast Asia forward by creating economic empowerment for everyone. If this mission speaks to you, join our team today!
The collective thoughts of the interwebz
Manage Consent
To provide the best experiences, we use technologies like cookies to store and/or access device information. Consenting to these technologies will allow us to process data such as browsing behavior or unique IDs on this site. Not consenting or withdrawing consent, may adversely affect certain features and functions.
Functional
Always active
The technical storage or access is strictly necessary for the legitimate purpose of enabling the use of a specific service explicitly requested by the subscriber or user, or for the sole purpose of carrying out the transmission of a communication over an electronic communications network.
Preferences
The technical storage or access is necessary for the legitimate purpose of storing preferences that are not requested by the subscriber or user.
Statistics
The technical storage or access that is used exclusively for statistical purposes.The technical storage or access that is used exclusively for anonymous statistical purposes. Without a subpoena, voluntary compliance on the part of your Internet Service Provider, or additional records from a third party, information stored or retrieved for this purpose alone cannot usually be used to identify you.
Marketing
The technical storage or access is required to create user profiles to send advertising, or to track the user on a website or across several websites for similar marketing purposes.