За данните на градския транспорт на Пловдив в Google Maps

Post Syndicated from Йовко Ламбрев original https://yovko.net/plovdiv-google-maps/

За данните на градския транспорт на Пловдив в Google Maps

От лятото на 2019 г. в блога ми стои чернова, която така и не публикувах. Идеята ми зад въпросната статия беше да разкажа как се появи разписанието на градския транспорт на Пловдив в Google Maps. Но това сега няма никакво значение, защото от тази седмица там вече няма такива данни.

Съвсем кратка предистория: Преди вече пет години трима приятели предложихме на Община Пловдив да свършим необходимото, за да се появят маршрутите и разписанията на градския транспорт в Google Maps. Напълно безвъзмездно. Речено – сторено. Общината не трябваше да прави нищо друго, освен от време на време да ни уведомява за промените в маршрутите и разписанията, за да поддържаме нещата актуални и коректни. Това обаче не се случи. В началото на 2022 г. се уморихме да се борим с вятърни мелници и преустановихме поддръжката, като маркирахме, че данните не са актуални и няма да се обновяват.

Преди няколко дни човек от екипа на Google Transit (така се нарича услугата, която добавя информация за обществения транспорт в Maps) се свърза с мен да провери защо вече две години не сме актуализирали данните за Пловдив. Отговорих му, че за съжаление, няма как да го направим, тъй като разчитахме да получаваме тези данни от Община Пловдив, но се оказва, че всеки път трябва да им се молим за данните или да си ги събираме, както намерим за добре. Което определено не е начинът, по който трябва да се прави това. Нито може да гарантира нужната прецизност. Колегата от Google сподели, че разбира ситуацията, и ще преценят как да постъпят. След още два дни ми писа, че са взели решение да прекратят услугата за Пловдив.

Днес в Общинския съвет е имало дискусия по темата, провокирана от публикация в „Капитал“. Журналистите от медията писаха и преди година по темата и дори заедно прогнозирахме това развитие, но тишината откъм Община Пловдив си остана все така оглушителна.

Пиша това, защото сегашната ресорна кметица, г-жа Савина Петкова, е казала пред общинските съветници няколко изречения, които от стремеж към акуратност не мога да отмина без коментар. Позовавам се на публикации в регионалната преса, тъй като не съм присъствал лично.

Започвам с нейното твърдение, че градският транспорт на Пловдив има далеч по-важни проблеми, с което няма как да не се съглася. Аз самият съм се питал какви данни се опитваме да събираме и предоставяме на хората, когато ситуацията с обществения транспорт в града е толкова безобразна.

Вярно е и че общината никога не е имала договор с Google Maps. Просто защото няма как да има договор. Google не подписва такива. Платформата предоставя напълно безплатно възможността да визуализира данни за обществен или частен транспорт, ако те са предоставени от достоверен източник и в изисквания от тях формат. Иначе казано, Община Пловдив може сама да обобщава такива данни и да ги изпраща към Google. Това могат да правят и самите транспортни фирми. И има няколко в България, чиито разписания са в Google Maps, включително и БДЖ.

Проблемите тук са два. Първо, Google да се довери, че източникът на данни е достоверен. И второ, тези данни да бъдат в изисквания от тях формат – което не е задача с грандиозна трудност, но не е и тривиално начинание. През 2019 г. се наложи част от информацията да събираме от сканирани PDF-и, MS Word документи с вградени в тях таблици, които всъщност бяха растерни картинки. А данните за маршрутите, по които се движат автобусите, рисувахме точка по точка на ръка, защото „Организация и контрол по транспорта“ (ОКТ) разполагаше с GPS координати на спирките, но не и на пътя, по който автобусите се движат между тези спирки. Имаше още купчина технически засади, за които не подозирахме и в най-песимистичните си очаквания. Но някак ги разрешихме.

Иначе по темата защо Google все пак реши да публикува данни за Пловдив, това стана възможно, след като не общината, а ние, доброволците, се ангажирахме да съберем всичко и да го подредим. За да направим нещо полезно за града и гостите му. И защото ни е грижа за средата, в която живеем.

Община Пловдив потвърди с официално писмо пред Google, че ние ще вършим тази работа с подреждането и преобразуването на данните от нейно име.

За последвалите две години и половина, през които поддържахме данните живи, само веднъж получихме актуализация от общината. След двукратни мои настоявания пред тогавашния ресорен кмет Тодор Чонов, на които и до днес нямам отговор, в крайна сметка просто загубих търпение, обадих се на колегите в ОКТ по телефона и си изпросих нови данни. Те, между другото, винаги са откликвали, но така и никой не им възложи да изпращат промените, когато има такива, или примерно веднъж на три или дори шест месеца. Това щеше да е повече от достатъчно.

Не отговаря на истината обаче твърдението на г-жа Петкова, че данните, които са показвани досега от Google, са идвали от системата на „Индра“. Те не бяха особено полезни, защото в тях имаше грешки и ги получихме едва след като вече се бяхме преборили с дигитализацията на множество „хартиени данни“, които впрочем също бяха само частично полезни. Единственото улеснение на двата комплекта данни беше, че можехме да ги съпоставим и така да проследим къде се разминават, което помогна да отстраним някакво количество грешки.

Би било чудесно, ако системата на „Индра“ изобщо работеше и имаше как да интегрираме данните от нея за информация в реално време с Google. Това беше в плановете ни за бъдещето, когато градският транспорт на Пловдив евентуално щеше да има адекватна информационна система.

А приложението, което г-жа Петкова съжалява, че не е достатъчно популярно, е ето това. Моля, проследете линка и ще си отговорите сами защо „не е достатъчно популярно“. То работи (слава богу, нещо работи!), но е кошмарно остаряло и е адски неудобно за ползване, особено в движение и от мобилен телефон. Честно, г-жо Петкова, Вие колко пъти сте го ползвала?

И в заключение: искрено се надявам, че колегите от „Тикси“, които правят поредната за Пловдив нова система за управление на градския транспорт, ще имат добрата воля да предоставят отворено API или друг публично достъпен и документиран начин за интеграция с външни системи. Това ще позволи не само нова и по-лесна интеграция с Google Maps (защо не и в реално време този път?), но и създаването на други мобилни приложения и дигитални удобства за Пловдив. Защото ние още продължаваме да живеем в този град и да ни пука за него.
За данните на градския транспорт на Пловдив в Google Maps

Post Syndicated from Йовко Ламбрев original https://yovko.net/plovdiv-google-maps/

За данните на градския транспорт на Пловдив в Google Maps

От лятото на 2019 г. в блога ми стои чернова, която така и не публикувах. Идеята ми зад въпросната статия беше да разкажа как се появи разписанието на градския транспорт на Пловдив в Google Maps. Но това сега няма никакво значение, защото от тази седмица там вече няма такива данни.

Съвсем кратка предистория: Преди вече пет години трима приятели предложихме на Община Пловдив да свършим необходимото, за да се появят маршрутите и разписанията на градския транспорт в Google Maps. Напълно безвъзмездно. Речено – сторено. Общината не трябваше да прави нищо друго, освен от време на време да ни уведомява за промените в маршрутите и разписанията, за да поддържаме нещата актуални и коректни. Това обаче не се случи. В началото на 2022 г. се уморихме да се борим с вятърни мелници и преустановихме поддръжката, като маркирахме, че данните не са актуални и няма да се обновяват.

Преди няколко дни човек от екипа на Google Transit (така се нарича услугата, която добавя информация за обществения транспорт в Maps) се свърза с мен да провери защо вече две години не сме актуализирали данните за Пловдив. Отговорих му, че за съжаление, няма как да го направим, тъй като разчитахме да получаваме тези данни от Община Пловдив, но се оказва, че всеки път трябва да им се молим за това или да си ги събираме, както намерим за добре. Което определено не е начинът, по който трябва да се прави това. Нито може да гарантира нужната прецизност. Колегата от Google сподели, че разбира ситуацията, и ще преценят как да постъпят. След още два дни ми писа, че са взели решение да прекратят услугата за Пловдив.

Днес в Общинския съвет е имало дискусия по темата, провокирана от публикация в „Капитал“. Журналистите от медията писаха и преди година по темата и дори заедно прогнозирахме това развитие, но тишината откъм Община Пловдив си остана все така оглушителна.

Пиша това, защото сегашната ресорна кметица, г-жа Савина Петкова, е казала пред общинските съветници няколко изречения, които от стремеж към прецизност не мога да отмина без коментар. Позовавам се на публикации в регионалната преса, тъй като не съм присъствал лично.

Започвам с нейното твърдение, че градският транспорт на Пловдив има далеч по-важни проблеми, с което няма как да не се съглася. Аз самият съм се питал какви данни се опитваме да събираме и предоставяме на хората, когато ситуацията с обществения транспорт в града е толкова безобразна.

Вярно е и че общината никога не е имала договор с Google Maps. Просто защото няма как да има такъв договор. Google не подписва такива. Платформата предоставя напълно безплатно възможността да визуализира данни за обществен или частен транспорт, ако те са предоставени от достоверен източник и в изисквания от тях формат. Иначе казано, Община Пловдив може сама да обобщава такива данни и да ги изпраща към Google. Това могат да правят и самите транспортни фирми. И има няколко в България, чиито разписания са в Google Maps, включително и БДЖ.

Проблемите тук са два. Първо, Google да се довери, че източникът на данни е достоверен. И второ, тези данни да бъдат в изисквания от тях формат – което не е задача с грандиозна трудност, но не е и тривиално начинание. През 2019 г. се наложи част от информацията да събираме от сканирани PDF-и, MS Word документи с вградени в тях таблици, които всъщност бяха растерни картинки. А данните за маршрутите, по които се движат автобусите, рисувахме точка по точка на ръка, защото „Организация и контрол по транспорта“ (ОКТ) разполагаше с GPS координати на спирките, но не и на пътя, по който автобусите се движат между тези спирки. Имаше още купчина технически засади, за които не подозирахме и в най-песимистичните си очаквания. Но някак ги разрешихме.

Иначе по темата защо Google все пак реши да публикува данни за Пловдив, това стана възможно, след като не общината, а ние, доброволците, се ангажирахме да съберем всичко и да го подредим. За да направим нещо полезно за града и гостите му. И защото ни е грижа за средата, в която живеем.

Община Пловдив потвърди с официално писмо пред Google, че ние ще вършим тази работа с подреждането и преобразуването на данните от нейно име.

За последвалите две години и половина, през които поддържахме данните живи, само веднъж получихме актуализация от общината. След двукратни мои настоявания пред тогавашния ресорен кмет Тодор Чонов, на които и до днес нямам отговор, в крайна сметка просто загубих търпение, обадих се на колегите в ОКТ по телефона и си изпросих нови данни. Те, между другото, винаги са откликвали, но така и никой не им възложи да изпращат промените, когато има такива, или примерно веднъж на три или дори шест месеца. Това щеше да е повече от достатъчно.

Не отговаря на истината обаче твърдението на г-жа Петкова, че данните, които са показвани досега от Google, са идвали от системата на „Индра“. Те не бяха особено полезни, защото в тях имаше грешки и ги получихме едва след като вече се бяхме преборили с дигитализацията на множество „хартиени данни“, които впрочем също бяха само частично полезни. Единственото улеснение на двата комплекта данни беше, че можехме да ги съпоставим и така да проследим къде се разминават, което помогна да отстраним някакво количество грешки.

Би било чудесно, ако системата на „Индра“ изобщо работеше и имаше как да интегрираме данните от нея за информация в реално време с Google. Това беше в плановете ни за бъдещето, когато градският транспорт на Пловдив евентуално щеше да има адекватна информационна система.

А приложението, което г-жа Петкова съжалява, че не е достатъчно популярно, е ето това. Моля, проследете линка и ще си отговорите сами защо „не е достатъчно популярно“. То работи (слава богу, нещо работи!), но е кошмарно остаряло и е адски неудобно за ползване, особено в движение и от мобилен телефон. Честно, г-жо Петкова, Вие колко пъти сте го ползвала?

И в заключение: искрено се надявам, че колегите от „Тикси“, които правят поредната за Пловдив нова система за управление на градския транспорт, ще имат добрата воля да предоставят API или друг публично достъпен начин за интеграция с външни системи. Това ще позволи не само интеграция с Google Maps (защо не и в реално време този път?), но и създаването на други мобилни приложения и дигитални удобства за Пловдив. Защото ние още продължаваме да живеем в този град и да ни пука за него.

How Volkswagen streamlined access to data across multiple data lakes using Amazon DataZone – Part 1

Post Syndicated from Bandana Das original https://aws.amazon.com/blogs/big-data/how-volkswagen-streamlined-access-to-data-across-multiple-data-lakes-using-amazon-datazone-part-1/

Over the years, organizations have invested in creating purpose-built, cloud-based data lakes that are siloed from one another. A major challenge is enabling cross-organization discovery and access to data across these multiple data lakes, each built on different technology stacks. A data mesh addresses these issues with four principles: domain-oriented decentralized data ownership and architecture, treating data as a product, providing self-serve data infrastructure as a platform, and implementing federated governance. Data mesh enables organizations to organize around data domains with a focus on delivering data as a product.

In 2019, Volkswagen AG (VW) and Amazon Web Services (AWS) formed a strategic partnership to co-develop the Digital Production Platform (DPP), aiming to enhance production and logistics efficiency by 30 percent while reducing production costs by the same margin. The DPP was developed to streamline access to data from shop-floor devices and manufacturing systems by handling integrations and providing standardized interfaces. However, as applications evolved on the platform, a significant challenge emerged: sharing data across applications stored in multiple isolated data lakes in Amazon Simple Storage Service (Amazon S3) buckets in individual AWS accounts without having to consolidate data into a central data lake. Another challenge is discovering available data stored across multiple data lakes and facilitating a workflow to request data access across business domains within each plant. The current method is largely manual, relying on emails and general communication, which not only increases overhead but also varies from one use case to another in terms of data governance. This blog post introduces Amazon DataZone and explores how VW used it to build their data mesh to enable streamlined data access across multiple data lakes. It focuses on the key aspect of the solution, which was enabling data providers to automatically publish data assets to Amazon DataZone, which served as the central data mesh for enhanced data discoverability. Additionally, the post provides code to guide you through the implementation.

Introduction to Amazon DataZone

Amazon DataZone is a data management service that makes it faster and easier for customers to catalog, discover, share, and govern data stored across AWS, on premises, and third-party sources. Key features of Amazon DataZone include a business data catalog that allows users to search for published data, request access, and start working on data in days instead of weeks. Amazon DataZone projects enable collaboration with teams through data assets and the ability to manage and monitor data assets across projects. It also includes the Amazon DataZone portal, which offers a personalized analytics experience for data assets through a web-based application or API. Lastly, Amazon DataZone governed data sharing ensures that the right data is accessed by the right user for the right purpose with a governed workflow.

Architecture for Data Management with Amazon DataZone

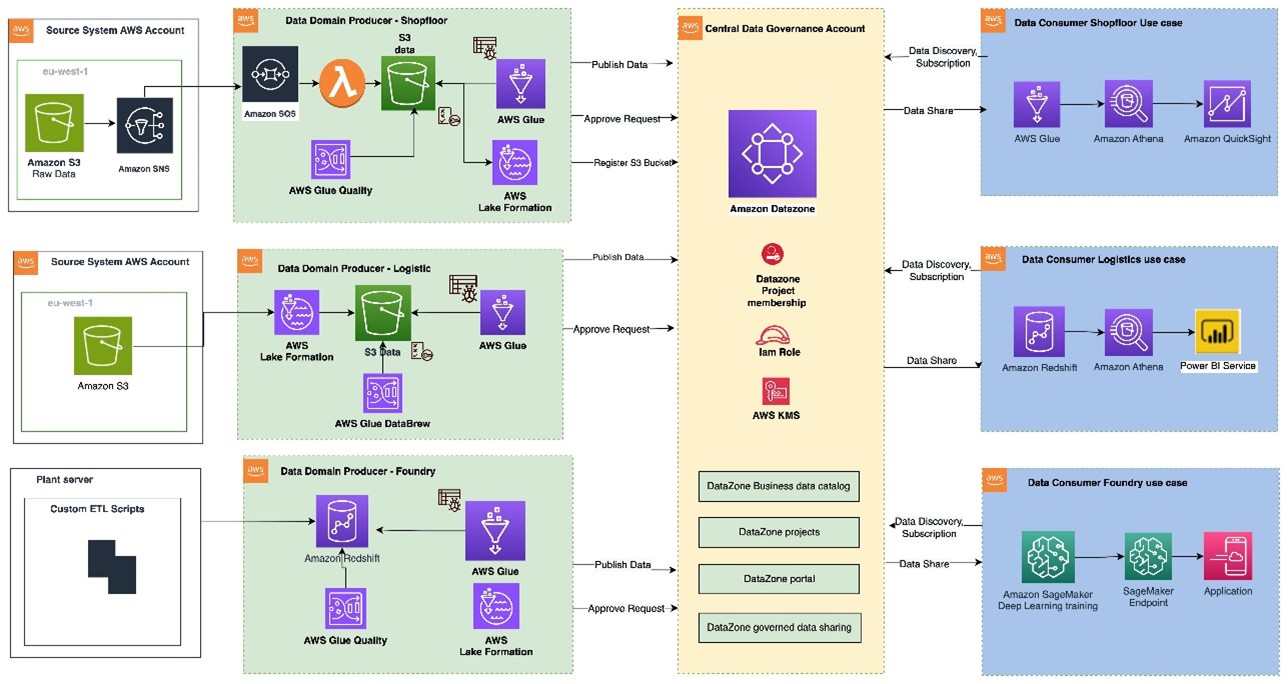
Figure 1: Data mesh pattern implementation on AWS using Amazon DataZone

The architecture diagram (Figure 1) represents a high-level design based on the data mesh pattern. It separates source systems, data domain producers (data publishers), data domain consumers (data subscribers), and central governance to highlight key aspects. This cross-account data mesh architecture aims to create a scalable foundation for data platforms, supporting producers and consumers with consistent governance.

  1. A data domain producer resides in an AWS account and uses Amazon S3 buckets to store raw and transformed data. Producers ingest data into their S3 buckets through pipelines they manage, own, and operate. They are responsible for the full lifecycle of the data, from raw capture to a form suitable for external consumption.
  2. A data domain producer maintains its own ETL stack using AWS Glue, AWS Lambda to process, AWS Glue Databrew to profile the data and prepare the data asset (data product) before cataloguing it into AWS Glue Data Catalog in their account.
  3. A second pattern could be that a data domain producer prepares and stores the data asset as table within Amazon Redshift using AWS S3 Copy.
  4. Data domain producers publish data assets using datasource run to Amazon DataZone in the Central Governance account. This populates the technical metadata in the business data catalog for each data asset. The business metadata, can be added by business users to provide business context, tags, and data classification for the datasets. Producers control what to share, for how long, and how consumers interact with it.
  5. Producers can register and create catalog entries with AWS Glue from all their S3 buckets. The central governance account securely shares datasets between producers and consumers via metadata linking, with no data (except logs) existing in this account. Data ownership remains with the producer.
  6. With Amazon DataZone, once data is cataloged and published into the DataZone domain, it can be shared with multiple consumer accounts.
  7. The Amazon DataZone Data portal provides a personalized view for users to discover/search and submit requests for subscription of data assets using a web-based application. The data domain producer receives the notification of subscription requests in the Data portal and can approve/reject the requests.
  8. Once approved, the consumer account can read and further process data assets to implement various use cases with AWS Lambda, AWS Glue, Amazon Athena, Amazon Redshift query editor v2, Amazon QuickSight (Analytics use cases) and with Amazon Sagemaker (Machine learning use cases).

Manual process to publish data assets to Amazon DataZone

To publish a data asset from the producer account, each asset must be registered in Amazon DataZone as a data source for consumer subscription. The Amazon DataZone User Guide provides detailed steps to achieve this. In the absence of an automated registration process, all required tasks must be completed manually for each data asset.

How to automate publishing data assets from AWS Glue Data Catalog from the producer account to Amazon DataZone

Using the automated registration workflow, the manual steps can be automated for any new data asset that needs to be published in an Amazon DataZone domain or when there’s a schema change in an already published data asset.

The automated solution reduces the repetitive manual steps to publish the data sources (AWS Glue tables) into an Amazon DataZone domain.

Architecture for automated data asset publish

Figure 2 Architecture for automated data publish to Amazon DataZone

To automate publishing data assets:

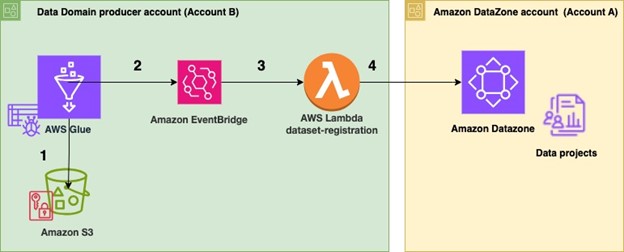
  1. In the producer account (Account B), the data to be shared resides in an Amazon S3 bucket (Figure 2). An AWS Glue crawler is configured for the dataset to automatically create the schema using AWS Cloud Development Kit (AWS CDK).
  2. Once configured, the AWS Glue crawler crawls the Amazon S3 bucket and updates the metadata in the AWS Glue Data Catalog. The successful completion of the AWS Glue crawler generates an event in the default event bus of Amazon EventBridge.
  3. An EventBridge rule is configured to detect this event and invoke a dataset-registration AWS Lambda function.
  4. The AWS Lambda function performs all the steps to automatically register and publish the dataset in Amazon Datazone.

Steps performed in the dataset-registration AWS Lambda function

    • The AWS Lambda function retrieves the AWS Glue database and Amazon S3 information for the dataset from the Amazon Eventbridge event triggered by the successful run of the AWS Glue crawler.
    • It obtains the Amazon DataZone Datalake blueprint ID from the producer account and the Amazon DataZone domain ID and project ID by assuming an IAM role in the central governance account where the Amazon Datazone domain exists.
    • It enables the Amazon DataZone Datalake blueprint in the producer account.
    • It checks if the Amazon Datazone environment already exists within the Amazon DataZone project. If it does not, then it initiates the environment creation process. If the environment exists, it proceeds to the next step.
    • It registers the Amazon S3 location of the dataset in Lake Formation in the producer account.
    • The function creates a data source within the Amazon DataZone project and monitors the completion of the data source creation.
    • Finally, it checks whether the data source sync job in Amazon DataZone needs to be started. If new AWS Glue tables or metadata is created or updated, then it starts the data source sync job.

Prerequisites

As part of this solution, you will publish data assets from an existing AWS Glue database in a producer account into an Amazon DataZone domain for which the following prerequisites need to be performed.

  1. You need two AWS accounts to deploy the solution.
    • One AWS account will act as the data domain producer account (Account B) which will contain the AWS Glue dataset to be shared.
    • The second AWS account is the central governance account (Account A), which will have the Amazon DataZone domain and project deployed. This is the Amazon DataZone account.
    • Ensure that both the AWS accounts belong to the same AWS Organization
  2. Remove the IAMAllowedPrincipals permissions from the AWS Lake Formation tables for which Amazon DataZone handles permissions.
  3. Make sure in both AWS accounts that you have cleared the checkbox for Default permissions for newly created databases and tables under the Data Catalog settings in Lake Formation (Figure 3).

    Figure 3: Clear default permissions in AWS Lake Formation

  4. Sign in to Account A (central governance account) and make sure you have created an Amazon DataZone domain and a project within the domain.
  5. If your Amazon DataZone domain is encrypted with an AWS Key Management Service (AWS KMS) key, add Account B (producer account) to the key policy with the following actions:
    {
      "Sid": "Allow use of the key",
      "Effect": "Allow",
      "Principal": {
        "AWS": "arn:aws:iam::<Account B>:root"
      },
      "Action": [
        "kms:Encrypt",
        "kms:Decrypt",
        "kms:ReEncrypt*",
        "kms:GenerateDataKey*",
        "kms:DescribeKey"
      ],
      "Resource": "*"
    }

  6. Ensure you have created an AWS Identity and Access Management (IAM) role that Account B (producer account) can assume and this IAM role is added as a member (as contributor) of your Amazon DataZone project. The role should have the following permissions:
    • This IAM role is called dz-assumable-env-dataset-registration-role in this example. Adding this role will enable you to successfully run the dataset-registration Lambda function. Replace the account-region, account id, and DataZonekmsKey in the following policy with your information. These values correspond to where your Amazon DataZone domain is created and the AWS KMS key Amazon Resource Name (ARN) used to encrypt the Amazon DataZone domain.
      {
          "Version": "2012-10-17",
          "Statement": [
               {
                  "Action": [
                      "DataZone:CreateDataSource",
                     "DataZone:CreateEnvironment",
                     "DataZone:CreateEnvironmentProfile",
                     "DataZone:GetDataSource",
                     "DataZone:GetEnvironment",
                     "DataZone:GetEnvironmentProfile",
                     "DataZone:GetIamPortalLoginUrl",
                     "DataZone:ListDataSources",
                      "DataZone:ListDomains",
                      "DataZone:ListEnvironmentProfiles",
                      "DataZone:ListEnvironments",
                      "DataZone:ListProjectMemberships",
                     "DataZone:ListProjects",
                      "DataZone:StartDataSourceRun"
                  ],
                  "Resource": "*",
                  "Effect": "Allow"
              },
              {
                  "Action": [
                       "kms:Decrypt",
                      "kms:DescribeKey",
                      "kms:GenerateDataKey"
                  ],
                 "Resource": "arn:aws:kms:${account_region}:${account_id}:key/${DataZonekmsKey}",
                  "Effect": "Allow"
              }
          ]
      }

    • Add the AWS account in the trust relationship of this role with the following trust relationship. Replace ProducerAccountId with the AWS account ID of Account B (data domain producer account).
      {
          "Version": "2012-10-17",
          "Statement": [
              {
                  "Effect": "Allow",
                  "Principal": {
                      "AWS": [
                          "arn:aws:iam::${ProducerAccountId}:root",
                      ]
                  },
                  "Action": "sts:AssumeRole"
              }
          ]
      } }

  7. The following tools are needed to deploy the solution using AWS CDK:

Deployment Steps

After completing the pre-requisites, use the AWS CDK stack provided on GitHub to deploy the solution for automatic registration of data assets into DataZone domain

  1. Clone the repository from GitHub to your preferred IDE using the following commands.
    git clone https://github.com/aws-samples/automate-and-simplify-aws-glue-data-asset-publish-to-amazon-datazone.git
    
    cd automate-and-simplify-aws-glue-data-asset-publish-to-amazon-datazone

  2. At the base of the repository folder, run the following commands to build and deploy resources to AWS.
    npm install 
    npm run lint

  3. Sign in to the AWS account B (the data domain producer account) using AWS Command Line Interface (AWS CLI) with your profile name.
  4. Ensure you have configured the AWS Region in your credential’s configuration file.
  5. Bootstrap the CDK environment with the following commands at the base of the repository folder. Replace <PROFILE_NAME> with the profile name of your deployment account (Account B). Bootstrapping is a one-time activity and is not needed if your AWS account is already bootstrapped.
    export AWS_PROFILE=<PROFILE_NAME>
    npm run cdk bootstrap

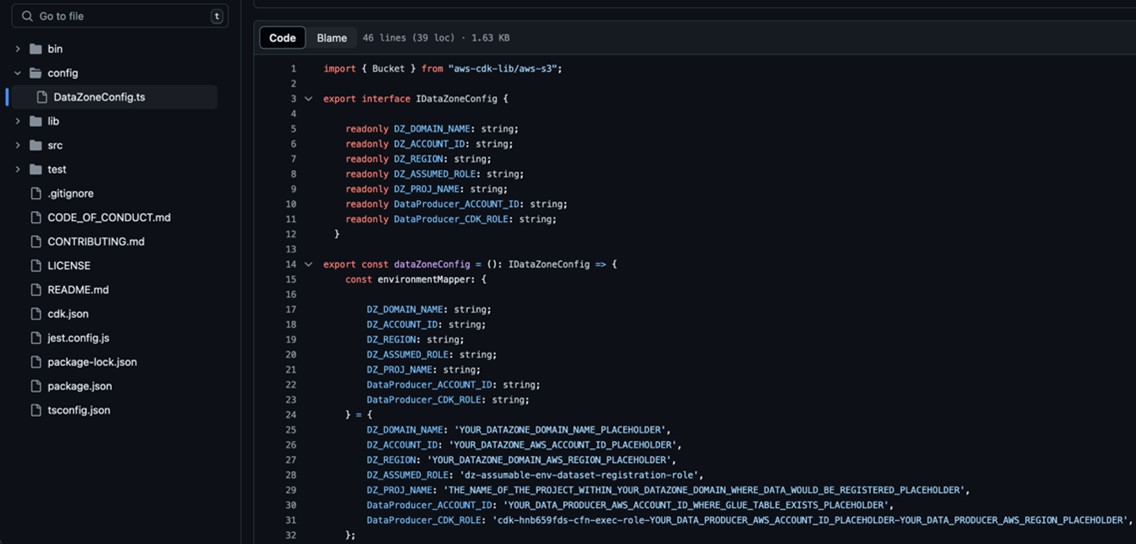
  6. Replace the placeholder parameters (marked with the suffix _PLACEHOLDER) in the file config/DataZoneConfig.ts (Figure 4).
    • Amazon DataZone domain and project name of your Amazon DataZone instance. Make sure all names are in lowercase.
    • The AWS account ID and Region.
    • The assumable IAM role from the prerequisites.
    • The deployment role starting with cfn-xxxxxx-cdk-exec-role-.

Figure 4: Edit the DataZoneConfig file

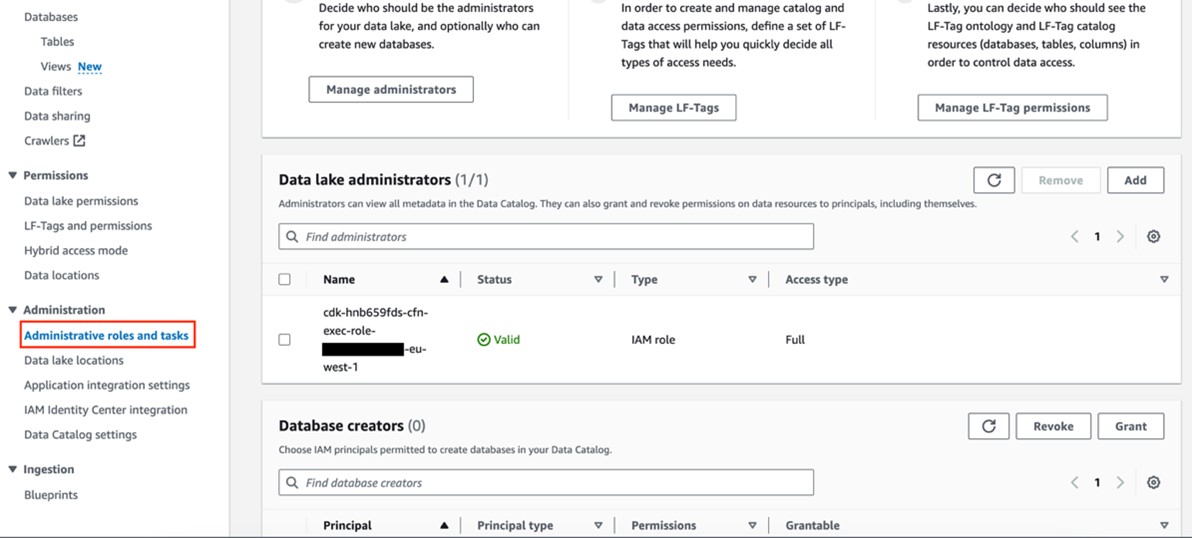
  1. In the AWS Management Console for Lake Formation, select Administrative roles and tasks from the navigation pane (Figure 5) and make sure the IAM role for AWS CDK deployment that starts with cfn-xxxxxx-cdk-exec-role- is selected as an administrator in Data lake administrators. This IAM role needs permissions in Lake Formation to create resources, such as an AWS Glue database. Without these permissions, the AWS CDK stack deployment will fail.

Figure 5: Add cfn-xxxxxx-cdk-exec-role- as a Data Lake administrator

  1. Use the following command in the base folder to deploy the AWS CDK solution
    npm run cdk deploy --all

During deployment, enter y if you want to deploy the changes for some stacks when you see the prompt Do you wish to deploy these changes (y/n)?

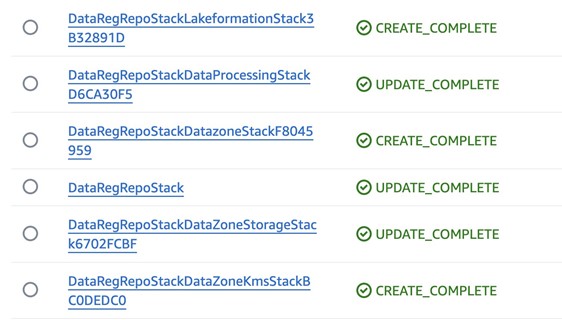
  1. After the deployment is complete, sign in to your AWS account B (producer account) and navigate to the AWS CloudFormation console to verify that the infrastructure deployed. You should see a list of the deployed CloudFormation stacks as shown in Figure 6.

Figure 6: Deployed CloudFormation stacks

Test automatic data registration to Amazon DataZone

To test, we use the Online Retail Transactions dataset from Kaggle as a sample dataset to demonstrate the automatic data registration.

  1. Download the Online Retail.csv file from Kaggle dataset.
  2. Login to AWS Account B (producer account) and navigate to the Amazon S3 console, find the DataZone-test-datasource S3 bucket, and upload the csv file there (Figure 7).

Figure 7: Upload the dataset CSV file

  1. The AWS Glue crawler is scheduled to run at a specific time each day. However for testing, you can manually run the crawler by going to the AWS Glue console and selecting Crawlers from the navigation pane. Run the on-demand crawler starting with DataZone-. After the crawler has run, verify that a new table has been created.
  2. Go to the Amazon DataZone console in AWS account A (central governance account) where you deployed the resources. Select Domains in the navigation pane (Figure 8), then Select and open your domain.

    Figure 8: Amazon DataZone domains

  3. After you open the Datazone Domain, you can find the Amazon Datazone data portal URL in the Summary section (Figure 9). Select and open data portal.

    Figure 9: Amazon DataZone data portal URL

  4. In the data portal find your project (Figure 10). Then select the Data tab at the top of the window.

    Figure 10: Amazon DataZone Project overview

  5. Select the section Data Sources (Figure 11) and find the newly created data source DataZone-testdata-db.

    Figure 11:  Select Data sources in the Amazon Datazone Domain Data portal

  6. Verify that the data source has been successfully published (Figure 12).

    Figure 12:  The data sources are visible in the Published data section

  7. After the data sources are published, users can discover the published data and can submit a subscription request. The data producer can approve or reject requests. Upon approval, users can consume the data by querying data in Amazon Athena. Figure 13 illustrates data discovery in the Amazon DataZone data portal.

    Figure 13: Example data discovery in the Amazon DataZone portal

Clean up

Use the following steps to clean up the resources deployed through the CDK.

  1. Empty the two S3 buckets that were created as part of this deployment.
  2. Go to the Amazon DataZone domain portal and delete the published data assets that were created in the Amazon DataZone project by the dataset-registration Lambda function.
  3. Delete the remaining resources created using the following command in the base folder:
    npm run cdk destroy --all

Conclusion

By using AWS Glue and Amazon DataZone, organizations can make their data management easier and allow teams to share and collaborate on data smoothly. Automatically sending AWS Glue data to Amazon DataZone not only makes the process simple but also keeps the data consistent, secure, and well-governed. Simplify and standardize publishing data assets to Amazon DataZone and streamline data management with Amazon DataZone. For guidance on establishing your organization’s data mesh with Amazon DataZone, contact your AWS team today.


About the Authors

Bandana Das is a Senior Data Architect at Amazon Web Services and specializes in data and analytics. She builds event-driven data architectures to support customers in data management and data-driven decision-making. She is also passionate about enabling customers on their data management journey to the cloud.

Anirban Saha is a DevOps Architect at AWS, specializing in architecting and implementation of solutions for customer challenges in the automotive domain. He is passionate about well-architected infrastructures, automation, data-driven solutions and helping make the customer’s cloud journey as seamless as possible. Personally, he likes to keep himself engaged with reading, painting, language learning and traveling.

Chandana Keswarkar is a Senior Solutions Architect at AWS, who specializes in guiding automotive customers through their digital transformation journeys by using cloud technology. She helps organizations develop and refine their platform and product architectures and make well-informed design decisions. In her free time, she enjoys traveling, reading, and practicing yoga.

Sindi Cali is a ProServe Associate Consultant with AWS Professional Services. She supports customers in building data driven applications in AWS.

За данните на градския транспорт на Пловдив в Google Maps

Post Syndicated from Yovko Lambrev original https://yovko.net/plovdiv-google-maps/

За данните на градския транспорт на Пловдив в Google Maps

От лятото на 2019 г. в блога ми стои чернова, която така и не публикувах. Идеята ми зад въпросната статия беше да разкажа как се появи разписанието на градския транспорт на Пловдив в Google Maps. Но това сега няма никакво значение, защото от тази седмица там вече няма такива данни.

Съвсем кратка предистория: Преди вече пет години трима приятели предложихме на Община Пловдив да свършим необходимото, за да се появят маршрутите и разписанията на градския транспорт в Google Maps. Напълно безвъзмездно. Речено – сторено. Общината не трябваше да прави нищо друго, освен от време на време да ни уведомява за промените в маршрутите и разписанията, за да поддържаме нещата актуални и коректни. Това обаче не се случи. В началото на 2022 г. се уморихме да се борим с вятърни мелници и преустановихме поддръжката, като маркирахме, че данните не са актуални и няма да се обновяват.

Преди няколко дни човек от екипа на Google Transit (така се нарича услугата, която добавя информация за обществения транспорт в Maps) се свърза с мен да провери защо вече две години не сме актуализирали данните за Пловдив. Отговорих му, че за съжаление, няма как да го направим, тъй като разчитахме да получаваме тези данни от Община Пловдив, но се оказва, че всеки път трябва да им се молим за данните или да си ги събираме, както намерим за добре. Което определено не е начинът, по който трябва да се прави това. Нито може да гарантира нужната прецизност. Колегата от Google сподели, че разбира ситуацията, и ще преценят как да постъпят. След още два дни ми писа, че са взели решение да прекратят услугата за Пловдив.

Днес в Общинския съвет е имало дискусия по темата, провокирана от публикация в „Капитал“. Журналистите от медията писаха и преди година по темата и дори заедно прогнозирахме това развитие, но тишината откъм Община Пловдив си остана все така оглушителна.

Пиша това, защото сегашната ресорна кметица, г-жа Савина Петкова, е казала пред общинските съветници няколко изречения, които от стремеж към акуратност не мога да отмина без коментар. Позовавам се на публикации в регионалната преса, тъй като не съм присъствал лично.

Започвам с нейното твърдение, че градският транспорт на Пловдив има далеч по-важни проблеми, с което няма как да не се съглася. Аз самият съм се питал какви данни се опитваме да събираме и предоставяме на хората, когато ситуацията с обществения транспорт в града е толкова безобразна.

Вярно е и че общината никога не е имала договор с Google Maps. Просто защото няма как да има договор. Google не подписва такива. Платформата предоставя напълно безплатно възможността да визуализира данни за обществен или частен транспорт, ако те са предоставени от достоверен източник и в изисквания от тях формат. Иначе казано, Община Пловдив може сама да обобщава такива данни и да ги изпраща към Google. Това могат да правят и самите транспортни фирми. И има няколко в България, чиито разписания са в Google Maps, включително и БДЖ.

Проблемите тук са два. Първо, Google да се довери, че източникът на данни е достоверен. И второ, тези данни да бъдат в изисквания от тях формат – което не е задача с грандиозна трудност, но не е и тривиално начинание. През 2019 г. се наложи част от информацията да събираме от сканирани PDF-и, MS Word документи с вградени в тях таблици, които всъщност бяха растерни картинки. А данните за маршрутите, по които се движат автобусите, рисувахме точка по точка на ръка, защото „Организация и контрол по транспорта“ (ОКТ) разполагаше с GPS координати на спирките, но не и на пътя, по който автобусите се движат между тези спирки. Имаше още купчина технически засади, за които не подозирахме и в най-песимистичните си очаквания. Но някак ги разрешихме.

Иначе по темата защо Google все пак реши да публикува данни за Пловдив, това стана възможно, след като не общината, а ние, доброволците, се ангажирахме да съберем всичко и да го подредим. За да направим нещо полезно за града и гостите му. И защото ни е грижа за средата, в която живеем.

Община Пловдив потвърди с официално писмо пред Google, че ние ще вършим тази работа с подреждането и преобразуването на данните от нейно име.

За последвалите две години и половина, през които поддържахме данните живи, само веднъж получихме актуализация от общината. След двукратни мои настоявания пред тогавашния ресорен кмет Тодор Чонов, на които и до днес нямам отговор, в крайна сметка просто загубих търпение, обадих се на колегите в ОКТ по телефона и си изпросих нови данни. Те, между другото, винаги са откликвали, но така и никой не им възложи да изпращат промените, когато има такива, или примерно веднъж на три или дори шест месеца. Това щеше да е повече от достатъчно.

Не отговаря на истината обаче твърдението на г-жа Петкова, че данните, които са показвани досега от Google, са идвали от системата на „Индра“. Те не бяха особено полезни, защото в тях имаше грешки и ги получихме едва след като вече се бяхме преборили с дигитализацията на множество „хартиени данни“, които впрочем също бяха само частично полезни. Единственото улеснение на двата комплекта данни беше, че можехме да ги съпоставим и така да проследим къде се разминават, което помогна да отстраним някакво количество грешки.

Би било чудесно, ако системата на „Индра“ изобщо работеше и имаше как да интегрираме данните от нея за информация в реално време с Google. Това беше в плановете ни за бъдещето, когато градският транспорт на Пловдив евентуално щеше да има адекватна информационна система.

А приложението, което г-жа Петкова съжалява, че не е достатъчно популярно, е ето това. Моля, проследете линка и ще си отговорите сами защо „не е достатъчно популярно“. То работи (слава богу, нещо работи!), но е кошмарно остаряло и е адски неудобно за ползване, особено в движение и от мобилен телефон. Честно, г-жо Петкова, Вие колко пъти сте го ползвала?

И в заключение: искрено се надявам, че колегите от „Тикси“, които правят поредната за Пловдив нова система за управление на градския транспорт, ще имат добрата воля да предоставят отворено API или друг публично достъпен и документиран начин за интеграция с външни системи. Това ще позволи не само нова и по-лесна интеграция с Google Maps (защо не и в реално време този път?), но и създаването на други мобилни приложения и дигитални удобства за Пловдив. Защото ние още продължаваме да живеем в този град и да ни пука за него.
За данните на градския транспорт на Пловдив в Google Maps

Post Syndicated from Yovko Lambrev original https://yovko.net/plovdiv-google-maps/

За данните на градския транспорт на Пловдив в Google Maps

От лятото на 2019 г. в блога ми стои чернова, която така и не публикувах. Идеята ми зад въпросната статия беше да разкажа как се появи разписанието на градския транспорт на Пловдив в Google Maps. Но това сега няма никакво значение, защото от тази седмица там вече няма такива данни.

Съвсем кратка предистория: Преди вече пет години трима приятели предложихме на Община Пловдив да свършим необходимото, за да се появят маршрутите и разписанията на градския транспорт в Google Maps. Напълно безвъзмездно. Речено – сторено. Общината не трябваше да прави нищо друго, освен от време на време да ни уведомява за промените в маршрутите и разписанията, за да поддържаме нещата актуални и коректни. Това обаче не се случи. В началото на 2022 г. се уморихме да се борим с вятърни мелници и преустановихме поддръжката, като маркирахме, че данните не са актуални и няма да се обновяват.

Преди няколко дни човек от екипа на Google Transit (така се нарича услугата, която добавя информация за обществения транспорт в Maps) се свърза с мен да провери защо вече две години не сме актуализирали данните за Пловдив. Отговорих му, че за съжаление, няма как да го направим, тъй като разчитахме да получаваме тези данни от Община Пловдив, но се оказва, че всеки път трябва да им се молим за данните или да си ги събираме, както намерим за добре. Което определено не е начинът, по който трябва да се прави това. Нито може да гарантира нужната прецизност. Колегата от Google сподели, че разбира ситуацията, и ще преценят как да постъпят. След още два дни ми писа, че са взели решение да прекратят услугата за Пловдив.

Днес в Общинския съвет е имало дискусия по темата, провокирана от публикация в „Капитал“. Журналистите от медията писаха и преди година по темата и дори заедно прогнозирахме това развитие, но тишината откъм Община Пловдив си остана все така оглушителна.

Пиша това, защото сегашната ресорна кметица, г-жа Савина Петкова, е казала пред общинските съветници няколко изречения, които от стремеж към акуратност не мога да отмина без коментар. Позовавам се на публикации в регионалната преса, тъй като не съм присъствал лично.

Започвам с нейното твърдение, че градският транспорт на Пловдив има далеч по-важни проблеми, с което няма как да не се съглася. Аз самият съм се питал какви данни се опитваме да събираме и предоставяме на хората, когато ситуацията с обществения транспорт в града е толкова безобразна.

Вярно е и че общината никога не е имала договор с Google Maps. Просто защото няма как да има договор. Google не подписва такива. Платформата предоставя напълно безплатно възможността да визуализира данни за обществен или частен транспорт, ако те са предоставени от достоверен източник и в изисквания от тях формат. Иначе казано, Община Пловдив може сама да обобщава такива данни и да ги изпраща към Google. Това могат да правят и самите транспортни фирми. И има няколко в България, чиито разписания са в Google Maps, включително и БДЖ.

Проблемите тук са два. Първо, Google да се довери, че източникът на данни е достоверен. И второ, тези данни да бъдат в изисквания от тях формат – което не е задача с грандиозна трудност, но не е и тривиално начинание. През 2019 г. се наложи част от информацията да събираме от сканирани PDF-и, MS Word документи с вградени в тях таблици, които всъщност бяха растерни картинки. А данните за маршрутите, по които се движат автобусите, рисувахме точка по точка на ръка, защото „Организация и контрол по транспорта“ (ОКТ) разполагаше с GPS координати на спирките, но не и на пътя, по който автобусите се движат между тези спирки. Имаше още купчина технически засади, за които не подозирахме и в най-песимистичните си очаквания. Но някак ги разрешихме.

Иначе по темата защо Google все пак реши да публикува данни за Пловдив, това стана възможно, след като не общината, а ние, доброволците, се ангажирахме да съберем всичко и да го подредим. За да направим нещо полезно за града и гостите му. И защото ни е грижа за средата, в която живеем.

Община Пловдив потвърди с официално писмо пред Google, че ние ще вършим тази работа с подреждането и преобразуването на данните от нейно име.

За последвалите две години и половина, през които поддържахме данните живи, само веднъж получихме актуализация от общината. След двукратни мои настоявания пред тогавашния ресорен кмет Тодор Чонов, на които и до днес нямам отговор, в крайна сметка просто загубих търпение, обадих се на колегите в ОКТ по телефона и си изпросих нови данни. Те, между другото, винаги са откликвали, но така и никой не им възложи да изпращат промените, когато има такива, или примерно веднъж на три или дори шест месеца. Това щеше да е повече от достатъчно.

Не отговаря на истината обаче твърдението на г-жа Петкова, че данните, които са показвани досега от Google, са идвали от системата на „Индра“. Те не бяха особено полезни, защото в тях имаше грешки и ги получихме едва след като вече се бяхме преборили с дигитализацията на множество „хартиени данни“, които впрочем също бяха само частично полезни. Единственото улеснение на двата комплекта данни беше, че можехме да ги съпоставим и така да проследим къде се разминават, което помогна да отстраним някакво количество грешки.

Би било чудесно, ако системата на „Индра“ изобщо работеше и имаше как да интегрираме данните от нея за информация в реално време с Google. Това беше в плановете ни за бъдещето, когато градският транспорт на Пловдив евентуално щеше да има адекватна информационна система.

А приложението, което г-жа Петкова съжалява, че не е достатъчно популярно, е ето това. Моля, проследете линка и ще си отговорите сами защо „не е достатъчно популярно“. То работи (слава богу, нещо работи!), но е кошмарно остаряло и е адски неудобно за ползване, особено в движение и от мобилен телефон. Честно, г-жо Петкова, Вие колко пъти сте го ползвала?

И в заключение: искрено се надявам, че колегите от „Тикси“, които правят поредната за Пловдив нова система за управление на градския транспорт, ще имат добрата воля да предоставят отворено API или друг публично достъпен и документиран начин за интеграция с външни системи. Това ще позволи не само нова и по-лесна интеграция с Google Maps (защо не и в реално време този път?), но и създаването на други мобилни приложения и дигитални удобства за Пловдив. Защото ние още продължаваме да живеем в този град и да ни пука за него.
Unveiling Key Insights from the 2024 Take Command Summit

Post Syndicated from Emma Burdett original https://blog.rapid7.com/2024/07/18/unveiling-key-insights-from-the-2024-take-command-summit/

Unveiling Key Insights from the 2024 Take Command Summit

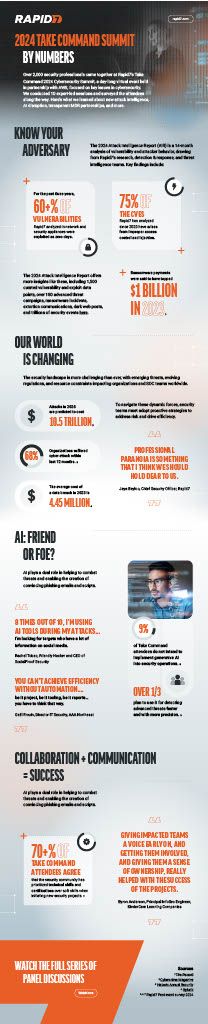
The 2024 Take Command Summit, held virtually in partnership with AWS, united over 2,000 security professionals to delve into critical cybersecurity issues. Our infographic captures the essence of the summit, showcasing expert insights from 10 sessions on topics like new attack intelligence, AI disruptions, and transparent MDR partnerships.

We also highlight attendees’ thoughts on various subject matters, from AI’s role in security to the importance of collaboration and communication. Check out the key highlights, stand out stats, and engaging stories can inform your security strategies and keep your organization ahead of emerging threats.

Unveiling Key Insights from the 2024 Take Command Summit

Evolving the ASF Brand (Apache Software Foundation blog)

Post Syndicated from jake original https://lwn.net/Articles/982392/

The Apache Software Foundation (ASF)
has announced
that it will be changing its logo to remove the feather that has been part
of its brand since 1997. ASF members will have input on the rebranding process and be
able to vote on the new logo, which will be unveiled at the Community Over Code conference in October.

The feather is a well-loved and iconic part of the ASF brand. We know of community members who have ASF feather tattoos. People love taking photos with the feather at our flagship event each year.

So why would we change it? As a non-Indigenous entity, we acknowledge that it is inappropriate for the Foundation to use Indigenous themes or language. We thank Natives in Tech and other members of the broader open source community for bringing this issue to the forefront. Today we are announcing we will be retiring the feather icon and logo and replacing it with a new logo that embodies the Foundation’s rich history of providing software for the public good.

Why We Use Native Code in Backblaze Computer Backup

Post Syndicated from Natasha Rabinov original https://www.backblaze.com/blog/why-we-use-native-code-in-backblaze-computer-backup/

A decorative image showing icons of file types superimposed over a cloud.

There’s a lot that goes into building a user-friendly, robust backup utility. When Backblaze set out to create one back in 2007, our goal was to make sure that users of all skill levels would have automatic, nearly continuous backups that could be restored on command. There were plenty of design decisions to be made, and one of the biggest was whether to implement our client in native code. 

You might have seen us talk about this on our website and elsewhere, and we felt it was high time to dive into what that decision meant for our development, how it affected the way the Backblaze client works, and why we think it was an important decision and inflection point for Backblaze Computer Backup and our customers. 

What is native code?

Each kind of computer central processing unit (CPU), such as Intel/AMD or Apple Silicon, has its own “machine language,” which is the set of instructions the CPU can understand and follow. These instructions are encoded in binary, and aren’t something people can read or write without great effort. When folks talk about using native code, they’re typically talking about a computer program that’s written in machine language, so a computer’s CPU can “natively” understand what the program needs the CPU to do.  

Compiled languages

To use a compiled language, developers write instructions into source code that’s easy for humans to read and edit. Then, they use a program aptly called a compiler to convert the source code into machine language for a particular kind of CPU. Examples of compiled languages are assembly (ASM), C, C++, Rust, Go, Swift, and Haskell.

Interpreted languages

Like with compiled languages, developers write programs in interpreted languages by writing instructions into source code files. But instead of converting those instructions into machine language, another program called an interpreter reads the source code and follows the instructions it contains without converting them to machine language. Common interpreted languages are things like Python, Ruby, BASIC, and PHP. 

There is a bit of a slippery slope between a compiled vs. interpreted language. For example, some modern Java implementations mix an interpreter and a compiler. But, the difference when it comes to programming is about picking a language that’s suitable to a task’s requirements. 

When and how do you use which type of code language(s)?

Well, pretty much anything anyone does on computers these days will take a combination of code languages. In some ways, the whole challenge of working with computers is bridging how humans communicate vs. how computers can process things. 

If you were using a metaphor for the above, a compiled code language would represent someone who was raised to natively speak two languages, and could fluently curse in both languages. 

By contrast, interpreted language is like this: You’ve moved to a country where you’re not fluent in the language, but someone needs a thorough dressing-down. An interpreted language would let you write in your native language, take your words and literally translate the idiom you were intending to use—then the computer would take your literal translation, and, executing the program, would be supplied with a dictionary to then give you an effective, similarly meaningful, insult. If you didn’t have your translator, your attempt at offense (in this metaphor, a program!), would likely fail because no one can understand you. 

To wit: While they mean similar things, “when pigs fly,” and “quand les poules auront des dents,” do not literally translate. 

What are the benefits of using native code in a backup application?

Using native code in a backup application is, in our opinion, better for several reasons.

Permissions

When you’re writing in native code, you’re plugging in your program at a lower level than most applications. That gives you access to the kinds of APIs the native operating system (OS) uses. Because you’re in that level of integration with the operating system, it means that users have to update permissions less frequently, have access to more robust build possibilities for your client, and their backup client can seamlessly run in the background.   

Efficiency: Build once, run everywhere

By building our backup client lower in the chain of command, so to speak, it allows us to use the same work for different situations, and there are some interpreted languages that have been built for this purpose, like Java VM. Using those solutions, however, would sacrifice some of the other benefits we’re outlining in this article. 

Being fully in control of our common code, we can do this without interpreted language and still have the other advantages listed here. So, we can use the same base code for both our Mac and Windows clients, but then add modifications to the code on top of each to refine the clients. There may be slight differences between the operating system (OS) environments, but coding at the level of a compiled language like C++ means that we can adjust for those differences effectively.

Performance

Running native code typically results in better performance. That’s because there are fewer steps (for your computer) between understanding a program and running a program.

Backup programs run all the time in the background, and have to keep track of a lot of information. Backblaze’s native code does that using half to a tenth of the computing resources that a backup program written in an interpreted language would use. So, Backblaze won’t slow down or interrupt the other activities you’re doing with your computer.

Reducing software bloat and size of software

Also, since you don’t have to install interpreters (you know, your insult dictionary), native code applications are usually leaner and more performant on the system. 

Eliminating risky third-party dependencies

Since they’re software, computer language interpreters have bugs and get new features, so they’re frequently updated. Sometimes an updated interpreter won’t run programs written for an older version of the language, or will cause a program to behave differently in an unexpected (read: “buggy”) way. Also, vendors have even changed licensing terms and started charging money for interpreters that had been free. Backblaze’s native code doesn’t have those problems.

Platform-standard user interface

Operating system vendors like Microsoft and Apple strongly encourage developers to write programs that use a platform-standard user interface “look-and-feel.” Programs that do that help users feel comfortable, minimize surprises, and support accessibility features like text-to-speech.

The most effective way to ensure a program’s user interface matches a platform’s standard look-and-feel is to use features built into the operating system, and those are typically only available to native code like Backblaze’s client.

What are the challenges of using native code in a backup application?

Nothing is perfect. What are the downsides to this approach?

Industry preference moving towards interpreted language/web apps

Has anyone else noticed that the world of development has changed recently? (No need to qualify that statement—it will be true tomorrow, tomorrow, and tomorrow again.) 

As with any industry, tech’s (and developers’) favorite strategies for creating things and solving problems have changed over time. 

There are various players in this space, including platforms (Mac, Windows, Linux), software (Adobe, Office), applications (Slack, the latest mobile game, your headphone utility client), and frankly, many things that skirt the boundaries of the above buckets. Executing any program, and particularly third-party applications, is a negotiation between operating systems’ publishers and the program/application’s developers. 

Over time, those who sell computers and manage OSes have grown to prefer the lightweight development of application ecosystems. It lets them have more control over their platforms, and it gives developers a shorter time to deployment—as long as they play within the sandbox the OS has made available. OS publishers are attempting to anticipate the needs of program and app developers, but there are some types of utilities—and backup is one of them—that justifiably break standard rules. Giving access to all your files by default, for example, isn’t something you’d do for a social media application. However, in order to get a full and complete backup, a program does justifiably require that level of access. 

Limited dev libraries

Given the preference of developers to move to web applications and interpreted languages (for good reason in some cases), many OSes are releasing less detailed support and/or technical documentation for some of their deeper-level tools. If you’re implementing in native code in today’s environment, you need both historical knowledge and ingenuity in house. Which leads us to our next point…

Expertise

We’re on board with the evolution of development—innovation is at the heart of our company—but for aspects of our backup client, we need developers with a deep understanding of compiled code languages and our supported ecosystems. And luckily, in any sufficiently large tech company, you’ll find folks specializing in different code languages and parts of the tech stack. That means we can spend more time nurturing and developing our internal talent rather than seeking it externally. 

Hybrid approaches?

Hey, we’ve spent a whole article telling you why native code matters. But, many folks agree that the future requires a hybrid approach, largely because of that gray area between compiled and interpreted languages we mentioned above. You can certainly see that in our style as well—our Mac client uses a combination of Objective C, SwiftUI and C++, for example. 

The now and future Backblaze

The core functionality of our client depends on native code for very good design reasons, and they’re ultimately all about making things easier for our end users. 

Overall, our design ideas are all centered on what it means to use Backblaze every day, regardless of an end user’s skill level. We want things to be simpler, and sometimes the questions we need to answer (how do I make sure the Backblaze client backs everything up?) are actually a tad more complicated upfront (the Backblaze client needs system permissions—and that means implementing it in native code), in that they require forethought and an investment of time and resources. But, we also prioritize the kind of thinking we can use over and over—so, even if we spend a little more time building native code, it’s an investment that has longevity. Put another way: Build once, run everywhere. 

The post Why We Use Native Code in Backblaze Computer Backup appeared first on Backblaze Blog | Cloud Storage & Cloud Backup

Criminal Gang Physically Assaulting People for Their Cryptocurrency

Post Syndicated from Bruce Schneier original https://www.schneier.com/blog/archives/2024/07/criminal-gang-physically-assaulting-people-for-their-cryptocurrency.html

This is pretty horrific:

…a group of men behind a violent crime spree designed to compel victims to hand over access to their cryptocurrency savings. That announcement and the criminal complaint laying out charges against St. Felix focused largely on a single theft of cryptocurrency from an elderly North Carolina couple, whose home St. Felix and one of his accomplices broke into before physically assaulting the two victims—­both in their seventies—­and forcing them to transfer more than $150,000 in Bitcoin and Ether to the thieves’ crypto wallets.

I think cryptocurrencies are more susceptible to this kind of real-world attack because they are largely outside the conventional banking system. Yet another reason to stay away from them.

Моята голяма странна гръцка дума

Post Syndicated from original https://www.toest.bg/moyata-golyama-stranna-grutska-duma/

Моята голяма странна гръцка дума

След сезона на липите настъпва сезонът за ходене на море в Гърция, а заедно с него, поне за мен, и сезонът на „хармолипи“. Макар и самото усещане да ми е познато отдавна, точното му наименование научих наскоро, разглеждайки пореден списък с „непреводими“ думи за иначе познати емоции на различни езици. В него редом с португалското saudade, турското hüzün, немското Lebensmüde и други понятия без директен еквивалент фигурираше и

гръцкото χαρμολύπη, което означава усещането едновременно на радост и тъга.

Думата добре описва противоречивите чувства, които вече от доста години изпитвам при всяко посещение на южната ни съседка. От една стана, това е радостта от всички удоволствия, които Гърция щедро предлага. От друга обаче, е растящата с всяка година тегоба, че въпреки иначе добрите ми намерения така и не успявам да науча дори и елементарен гръцки и си оставам с едни голи „ясас“ и „ямас“, „калимера“ и „калиспера“, „паракало“ и „евхаристо“. Всичко останало – с малки (и не особено полезни) изключения от рода на χαρμολύπη – продължава да ми бъде напълно чуждо и непонятно. С други думи, или както се казва на английски,

it’s all Greek to me.

Усещането за непонятна чуждост се заражда още при вида на гръцката азбука – въпреки редовния ми допир с нея и очевидните ѝ сходства с добре познатите ми кирилица и латиница, разчитането на ελληνικό αλφάβητο за мен се състои в едно безкрайно, често неуспешно налучкване, а изписването даже на елементарни думи (като гореизброените) ми е немислимо.

Дори и азбуката да не представляваше предизвикателство, гръцкият устоява на лесно разшифроване и на лексикално ниво, тъй като изобилства от неразбираеми или подвеждащи думи – особено за понятия, които иначе имат универсални и разбираеми наименования дори и на иначе непознати ми езици. Надписът ΜΕΤΑΦΟΡΆ например не спира да ме стъписва всеки път, щом го видя на автобуси, тирове и всякакъв вид транспортни средства по гръцките пътища – макар добре да знам, че оригиналното значение на термина си е съвсем пряко, а не преносно.

Или пък думата „хотел“, която в точно тази или сходни форми срещаме на английски, чешки, полски, сръбски, нидерландски, немски, френски, естонски, даже и на японски като ホテル (hoteru). На гръцки „хотел“ обаче е ξενοδοχεíο, което дори да можех да разчета и произнеса, щеше да ми бъде точно толкова разбираемо, колкото ако беше на патагонски.

Всъщност, ако беше „на патагонски“ – като имаме предвид, че в Патагония се говори главно на испански, – думата щеше да ми е значително по-понятна. (И без да разчитам на трите семестъра испански, който съм учила в университета, а просто защото на испански „хотел“ си е hotel.)

Така или иначе, изразът „все едно е на патагонски“ се е установил и продължава да се използва на български, като определение за (говорим или писмен) език, който е непознат, неясен или неразбираем.

Сайтът bgjargon.com предлага следното обяснение:

Вероятно асоциацията идва от това, че областта Патагония, която се намира в най-южния край на континента Южна Америка, е и най-отдалечената южно от екватора суша […], поради което се е наложила в хорските представи (поне в България) като еквивалент на „края на света“.

Според моята лична представа обаче, поради гореизброените причини, оприличаването на неразбираем език с гръцки – макар и той да се говори не на края на света, а току от другата страна на южната граница на България – ми се струва много по-намясто, така да се каже.

Историческите корени на идеята за гръцкия като неразбираем език могат да бъдат проследени до Средновековието. През този период, когато писарите в Западна Европа превеждали ръкописи от латински, те изписвали фразата Graecum est, non legitur („Гръцки е, [следователно] нечетимо“) като бележка в полетата до непонятни за тях пасажи и цитати¹.

Както много други идиоми, които се използват и до днес, изразът It’s (all) Greek to me също навлиза в английския благодарение на Шекспир, които през 1599 г. го използва в трагедията „Юлий Цезар“, в диалог между две от ключовите фигури в заговора срещу великия римлянин. В българския превод на Валери Петров от 1973 г. споменаването на гръцкия е съхранено, но изразът така и не придобива популярност, нито влиза в употреба във всекидневната ни реч.

КАСИЙ
А Цицерон? Не каза ли той нещо?

КАСКА
Да, на гръцки.

КАСИЙ
В какъв смисъл?

КАСКА
Ако мога да го кажа, слънце да не видя! Тези, дето го разбраха, се захилиха помежду си и заклатиха глави, но за мене беше гръцки език.

Освен в езика на Шекспир (и латинския), гръцкият служи като определение за нечленоразделна реч или писменост и в няколко други езика – нидерландски, африканс, шведски, норвежки, португалски и испански.

Самият испански – макар и не като език, а като част от фразата „испанско село“ – пък се използва като определение за объркващ или неразбираем изказ, и то не на някакви екзотични езици, а на близките на българския славянски езици – македонски, сръбски, хърватски, словенски, чешки и словашки.

Фразата всъщност произлиза от немски – и то не от друг, а от Гьоте, който първи я използва в „Страданията на младия Вертер“ (1774 г.). В пълния си вид тя гласи:

Das waren dem Gehirne spanische Dörfer, und ich empfahl mich, um nicht über ein weiteres Deraisonnement noch mehr Galle zu schlucken.²

Когато Бранко Мушицки превежда романа на сръбски през 1905 г., той предава въпросната фраза буквално („To су била за послаников мозак шпанска села, и ја се препоручим да се не бих морао још више мучити због даљег неразумног говора“), а впоследствие изразът „шпанска села“ навлиза в разговорния сръбски и добива популярност и на другите славянски езици. 

В българския си превод от 1929 г. Асен Разцветников обаче решава да предаде фразата с по-малко маркиран израз, като

Това бяха странни неща за тоя мозък и аз се оттеглих, за да не бъда принуден при по-нататъшни брътвежи да погълна още повече.

В резултат идеята за „испанските села“ така и не навлиза в българския.

На сръбски като синонимен израз на „шпaнска села“ се използва и фразата „К’о да кинески причаш“. Всъщност китайският, вероятно благодарение на „благодатната“ комбинация от нечленоразделни (особено за западното ухо и око) говор и писменост се използва като определение на непонятна реч на най-много езици, и то далеч не само западни. Любопитно е, че освен албански, арабски, естонски, филипински, френски, немски³, унгарски, италиански, сред тях е и японският⁴, та дори и гръцкият – както древният, така и съвременният.

Китайският на свой ред определя нечетими и непонятни езици като „призрачно писмо“, „книга от небесата“, „птичи език“, или „пилешки черва“. По този начин той се оказва един от малкото езици, които в опита си да обозначат неразбираемост, не проявяват ксенофобия към реално съществуващи чужди езици, народи или места.

И като стана дума за „ксенофобия“… въпреки първоначалната паника, която чуждостта на гръцкия поражда у мен, все по-често откривам, че множество понякога съвсем неочаквани думи на езиците, които знам, всъщност произлизат от гръцки. Само някои, особено забавни примери за това включват: „динозавър“, от δεινός (deinós ‘ужасен, страховит’) + σαῦρος (saûros ‘гущер, влечуго’); „гинеколог“, от γυνή (gunḗ ‘жена’), „планета“, от πλανήτης (planḗtēs ‘скитник’, съкращение на πλάνητες ἀστέρες (plánētes astéres ‘скитащи звезди’); шизофрения, от σχίζω (skhízō ‘разцепване, разделение’) +‎ φρήν (phrḗn ‘ум, сърце’); „маратон“, от древеногръцкия град Μαραθών; „акробат“, от ἄκρον (ákron ‘най-високата или най-отдалечената точка, планински връх, връх’) + βαίνω (baínō ‘ходя, стъпвам’), и т.н., и т.н.

А, разбира се, и „ксенофобия“, която произлиза от старогръцките ξένος (xénos ‘чужд’) + φοβία (phobía ‘страх’). Първата ѝ част също така е корен и на споменатата в началото на този текст на пръв поглед непонятна дума ξενοδοχεíο, съставенa от ξένος + δοχεῖον (dokheîon, тоест ‘съд’ или ‘контейнер’). Та какво друго е хотелът, ако не контейнер за чужденци?

В заключение, с риск да прозвуча като г-н Портокалос, бащата от „Моята голяма луда гръцка сватба“, няма как да не отбележа, че е доста вероятно дори и наименованието Патагония да идва от гръцкия. Според аржентинския изследовател Мигел Дура топонимът Патагония вероятно произлиза от древногръцкия регион в днешна Турция, наречен Paphlagonia и смятан за родното място на рицарския персонаж Patagón, на когото според една от теориите Магелан кръщава южната част на Южна Америка през 1520 г.

И ето как по неведоми етимологични пътища може да се окаже, че „говори ми на патагонски“ всъщност е просто друг начин да се каже it’s Greek to me.

1 Особено забавно ми се струва, че широко разпространената практика сред дизайнери и страньори да наливат макетен текст, преди истинският текст да е готов, за да покажат как биха изглеждали шрифтът и цялостната подредба на страницата, се нарича Greeking. Въпреки че наименованието на практиката идва от израза Greek to me, много често пълнежният текст всъщност е нарочно грешна версия на латинския текст De finibus bonorum et malorum на Цицерон, чиито първи две думи dolorem ipsum („самата болка“) са скъсени на Lorem ipsum.

2 Смята се, че измислената от Гьоте фраза spanische Dörfer е комбинация от два отделни израза. Първият – böhmische Dörfer, или „бохемски села“, се появява по време на Трийсетгодишната война (1618–1648) в резултат на неспособността на немските войници, минаващи през територията на Бохемското кралство, да разберат речта и писмеността на местните жители. Вторият израз – das kommt mir spanisch vor, или „това ми се струва на испански“, се появява, след като испанският възпитаник Карл V, става император на Свещената Римска империя на германската нация и въвежда непознати и неразбираеми за Германия традиции и обичаи. По-късно в немския се появява още един синонимен израз с близко значение, но с коренно различно съдържание, а именно Ich verstehe nur Bahnhof („Разбирам само гара“). За него се смята, че се е зародил в края на Първата световна война, когато думата „гара“ е била единственото нещо, което войниците – в желанието си да се приберат у дома – са искали или можели да разберат.

3 Названията „немски“ и „немец“ също се появяват като резултат от езикова неразбираемост, а именно от това, че за славянските народи говорът на германското население е бил непонятен, поради което представителите на това население стават известни като „немци“ – от праславянската дума *němьcь ‘чужденец’, която е морфологично свързана с думата „ням“. Още по-ранен пример за това, разбира се, е думата „варварин“, зародила се от имитацията на неразбираемия за древните гърци говор на чужденци (нещо като „бъра-бъра“).

4 Изразът за непонятен език на японски е 珍紛漢紛 (Chinpunkanpun), което имитира звученето на непознати китайски думи. Любопитно е, че когато фразата се сложи в Google Translate, преводът ѝ на български гласи „рядко объркване между китайски и китайски“, а на английски се превежда просто като strange confusion.

Помогнете ни да научим какви са читателските ви възприятия и отношението ви към „Тоест“, като попълните нашата анкета.


В рубриката „От дума на дума“ Екатерина Петрова търси актуални, интересни или новопоявили се думи от нашето ежедневие и проследява често изненадващия им произход, развитието на значенията им във времето и взаимовръзките им с близки и далечни езици.

[$] Filesystem testing for stable kernels

Post Syndicated from jake original https://lwn.net/Articles/982099/

Leah Rumancik led a filesystem-track session at
the 2024 Linux Storage,
Filesystem, Memory Management, and BPF Summit
on the testing needed to
qualify
XFS patches for the stable kernels. At last year’s summit,
Rumancik, Amir Goldstein, and Chandan Babu Rajendra presented on their efforts to test and
backport fixes for the XFS filesystem to three separate stable kernels.
There has been some longstanding unhappiness in
the XFS-development community
with the stable-kernel process
, which led to
backports ceasing for that filesystem until Goldstein started working on XFS testing for the stable
trees a few years ago. In this year’s session, Rumancik updated
attendees on how things had gone over the last year and wanted to discuss some
remaining pain points for the process.

[$] The first half of the 6.11 merge window

Post Syndicated from corbet original https://lwn.net/Articles/982034/

The merge window for the 6.11 kernel release opened on July 14; as of
this writing, 4,072 non-merge changesets have been pulled into the mainline
repository since then. This merge window, in other words, is just now
beginning. Still, there has been enough time for a number of interesting
changes to land for the next kernel release; read on for a summary of what
has been merged so far.

Security updates for Thursday

Post Syndicated from jake original https://lwn.net/Articles/982378/

Security updates have been issued by Debian (chromium), Fedora (freeradius), Red Hat (firefox, java-1.8.0-openjdk, and java-17-openjdk), Slackware (openssl), SUSE (ghostscript, gnutls, podman, and python-Django), and Ubuntu (linux-hwe-6.5, linux-ibm-5.15, linux-lowlatency, linux-lowlatency-hwe-5.15, linux-oracle-5.15, linux-oracle, linux-xilinx-zynqmp, and stunnel).

Four key learnings from teaching Experience AI lessons

Post Syndicated from Tracy Mayhead original https://www.raspberrypi.org/blog/four-key-learnings-from-teaching-experience-ai-lessons/

Developed by us and Google DeepMind, Experience AI provides teachers with free resources to help them confidently deliver lessons that inspire and educate young people about artificial intelligence (AI) and the role it could play in their lives.

Tracy Mayhead is a computer science teacher at Arthur Mellows Village College in Cambridgeshire. She recently taught Experience AI to her KS3 pupils. In this blog post, she shares 4 key learnings from this experience.

A photo of Tracy Mayhead in a classroom.

1. Preparation saves time

The Experience AI lesson plans provided a clear guide on how to structure our lessons.

Each lesson includes teacher-facing intro videos, a lesson plan, a slide deck, activity worksheets, and student-facing videos that help to introduce each new AI concept. 

It was handy to know in advance which websites needed unblocking so students could access them. 

You can find a unit overview on the Experience AI website to get an idea of what is included in each lesson.

“My favourite bit was making my own model, and choosing the training data. I enjoyed seeing how the amount of data affected the accuracy of the AI and testing the model.” – Student, Arthur Mellows Village College, UK 

2. The lessons can be adapted to meet student’s needs 

It was clear from the start that I could adapt the lessons to make them work for myself and my students.

Having estimated times and corresponding slides for activities was beneficial for adjusting the lesson duration. The balance between learning and hands-on tasks was just right.

A group of students at a desk in a classroom.

I felt fairly comfortable with my understanding of AI basics. However, teaching it was a learning experience, especially in tailoring the lessons to cater to students with varying knowledge. Their misconceptions sometimes caught me off guard, like their belief that AI is never wrong. Adapting to their needs and expectations was a learning curve. 

“It has definitely changed my outlook on AI. I went from knowing nothing about it to understanding how it works, why it acts in certain ways, and how to actually create my own AI models and what data I would need for that.” – Student, Arthur Mellows Village College, UK 

3. Young people are curious about AI and how it works

My students enjoyed the practical aspects of the lessons, like categorising apples and tomatoes. They found it intriguing how AI could sometimes misidentify objects, sparking discussions on its limitations. They also expressed concerns about AI bias, which these lessons helped raise awareness about. I didn’t always have all the answers, but it was clear they were curious about AI’s implications for their future.

It’s important to acknowledge that as a teacher you won’t always have all the answers especially when teaching AI literacy, which is such a new area. This is something that can be explored in a class alongside students.

There is an online course you can use that can help get you started teaching about AI if you are at all nervous.

“I learned a lot about AI and the possibilities it holds to better our futures as well as how to train it and problems that may arise when training it.” – Student, Arthur Mellows Village College, UK

4. Engaging young people with AI is important

Students are fascinated by AI and they recognise its significance in their future. It is important to equip them with the knowledge and skills to fully engage with AI.

Experience AI provides a valuable opportunity to explore these concepts and empower students to shape and question the technology that will undoubtedly impact their lives.

“It has changed my outlook on AI because I now understand it better and feel better equipped to work with AI in my working life.” – Student, Arthur Mellows Village College, UK 

A group of Year 10 students in a classroom.

What is your experience of teaching Experience AI lessons?

We completely agree with Tracy. AI literacy empowers people to critically evaluate AI applications and how they are being used. Our Experience AI resources help to foster critical thinking skills, allowing learners to use AI tools to address challenges they are passionate about. 

We’re also really interested to learn what misconceptions students have about AI and how teachers are addressing them. If you come across misconceptions that surprise you while you’re teaching with the Experience AI lesson materials, please let us know via the feedback form linked in the final lesson of the six-lesson unit.

If you would like to teach Experience AI lessons to your students, download the free resources from experience-ai.org

The post Four key learnings from teaching Experience AI lessons appeared first on Raspberry Pi Foundation.

Case Study: Enhancing Security with Zabbix and fTLD Registry

Post Syndicated from Michael Kammer original https://blog.zabbix.com/case-study-enhancing-security-with-zabbix-and-ftld-registry/28415/

A top-level domain (TLD) is the part of a URL that comes after the last dot in a domain name. While most are familiar with the first TLDs of .com, .net, and .org, there are more than 1,400 TLDs. fTLD Registry (fTLD) is a global coalition of banks, insurance companies, and financial services trade associations who ensure the .Bank and .Insurance TLDs are governed in the best interests of the financial sector and their customers.

The challenge

In 2011, fTLD was formed to secure and manage .Bank and .Insurance. Due to the high risk of fraud in the financial sector, keeping domains (websites and email) secure and out of the hands of malicious actors was paramount – and that can’t be done without close, careful security monitoring. Unfortunately, fTLD was initially dependent on a monitoring solution that required manual compliance work, which made it difficult to get actionable information to its customers and partners. When they began to seek out a replacement solution, fTLD realized that Zabbix promised exactly the features they required, which prompted them to make the switch.

The solution

For every domain in .Bank and .Insurance that meets minimum technical requirements, Zabbix’s system performs multiple security compliance checks. These checks cover a range of domain security features to ensure .Bank and .Insurance websites and email services have implemented a multi-layered domain defense by way of the Security Requirements required by fTLD. Specifically, Zabbix checks and monitors for:

  • Authoritative name servers, which guarantee that the name servers for .Bank and .Insurance websites have the required security features.
  • Enhanced DNS security, which involves the proper validation of DNS Security Extensions (DNSSEC) with strong cryptographic algorithms to prevent unauthorized changes to domain data and cyberattacks, including domain spoofing and domain hijacking.
  • Digital identity and robust encryption, which confirm TLS certificates and TLS version requirements for secure web connections and encrypts all communications for the safe and secure transmission of personal information and financial transactions.
  • Email security, which increases the deliverability of email and checks for the deployment of DMARC and SPF to protect against phishing and spoofing.

When Zabbix detects an issue, it automatically notifies involved parties, including the registrar and the customer using the domain. As a client, fTLD has access to all the security monitoring data via a custom dashboard. Zabbix puts critical compliance security monitoring information at fTLD’s fingertips, helping them make good on their promise of airtight security for banks, insurers, and producers and their customers through .Bank and .Insurance domains.

The results

Heather Diaz, Vice President, Compliance and Policy, leads the security function for fTLD and attests that:

“With Zabbix as a partner, we have peace of mind knowing that domain security is closely monitored. We can then focus on engaging with customers to help them get the full cyber benefits of using .Bank and .Insurance to protect their brand and their customer data.”

By entrusting Zabbix with security monitoring, fTLD has seen a variety of benefits, including:

  • Considerable growth in overall security compliance, as Zabbix monitoring has provided better, more accessible, and more reliable security information.
  • A tangible boost in productivity, thanks to automated customer and partner notifications.
  • A bird’s-eye view of stats across all domains as well as detailed information for individual domains.
  • Adaptive compliance security monitoring through daily checks, which help maintain a proactive defense against cyberattacks.
  • Security expertise from Zabbix to ensure that fTLD’s Security Requirements represent best practices and security measures to ensure the security of .Bank and .Insurance domains and their customers’ well-placed trust.

In conclusion

fTLD is changing the way banks, insurers, and producers around the world interact with their customers by offering trusted, verified, more secure domains. They trust Zabbix to guarantee a multi-layered domain defense strategy by alerting fTLD and its customers to detected anomalies or security issues.

To learn more about what Zabbix can do for customers in banking and finance, visit us here.

The post Case Study: Enhancing Security with Zabbix and fTLD Registry appeared first on Zabbix Blog.

The collective thoughts of the interwebz